

データ設定
データ設定では、プロットに表示するメトリクスと、データポイントのサンプリング、スムージング、集計方法を制御します。X軸
wandb.Run.log() でログした任意の整数値または浮動小数点値に設定します。
時間に基づくX軸のオプションは次のとおりです。
- ステップ:
wandb.Run.log()が呼び出されるたびに増加します。モデルからログしたトレーニングステップ数を反映します。 (デフォルト) - 相対時間 (実時間): プロセスの開始からの実経過時間です。run を開始し、1日間一時停止してから再開してログすると、そのポイントは24時間の位置に表示されます。
- 相対時間 (プロセス): プロセスが実行されていた時間です。run を開始して10秒間実行し、1日間一時停止してから再開すると、そのポイントは10秒の位置に表示されます。
- 実時間: グラフ上の最初の run の開始からの経過時間 (分) です。
- X軸の範囲: デフォルトでは、X軸の最小値から最大値までです。最小値と最大値はカスタマイズできます。
Y 軸
Y 軸の変数を、wandb.Run.log() でログした任意の整数値または浮動小数点値に設定します。単一の値、値の配列、または値のヒストグラムを指定します。変数に対して 1,500 ポイントを超えるポイントをログした場合、W&B はサンプリングして 1,500 ポイントに減らします。
run テーブルで run の色を変更することで、Y 軸の線の色をカスタマイズできます。
Point aggregation method
データポイントの表示に使用するサンプリングモードを選択します。- Full fidelity (デフォルト) : Full fidelity を参照してください。
- Random sampling: Random sampling を参照してください。
スムージング
スムージング係数を 0 から 1 の間に設定します。0 はスムージングなし、1 は最大のスムージングを表します。 使用できるスムージング方法:- 時間加重 EMA (デフォルト): 過去のポイントの重みを指数関数的に減衰させることで時系列データをスムージングする、指数移動平均 (EMA) の手法です。
- 移動平均: ポイントを、指定された x 値の前後のウィンドウ内にあるポイントの平均で置き換えます。
- ガウシアン: スムージングパラメーターで指定された標準偏差を持つガウス分布に従う重みを使用して、ポイントの加重平均を計算します。
- スムージングなし
外れ値を無視
プロットのスケールを調整し、デフォルトのプロットの最小値・最大値のスケールから外れ値を除外します。この設定の効果は、プロットのサンプリングモードによって異なります。- Random samplingモード: 外れ値を無視すると、5%未満および95%を超えるポイントがプロットから除外されます。
- フルフィデリティモード: 外れ値を無視すると、すべてのポイントが各バケットの最後の値に集約されて表示され、5%未満および95%を超える領域に網掛けが適用されます。
最大 run 数またはグループ数
デフォルトでは、プロットには run リストまたは run set 内の最初の 10 個の run または run のグループのみが表示されます。表示する run またはグループを指定するには、並べ替えの順序を変更してください。Workspace で表示できる run は、設定にかかわらず最大 1,000 個です。
run のグループ化
run テーブルがグループ化されている場合、各折れ線グラフはグループ内の run を1本の線にまとめます。このグループ化をグラフに適用する方法を設定します。- Use grouping from the runs table in charts: run テーブルのグループ化を折れ線グラフに適用します。デフォルトでオンになっています。オフにすると、run テーブルのグループ化の有無にかかわらず、各 run を個別に描画します。
- Use only latest run per group: グループ内の run をまとめる代わりに、各グループから1つの run を描画します。デフォルトでオフになっています。Workspaceレベルでのみ使用できます。
- 集約: 各グループをまとめた線の値です。選択肢は Mean、最小値、Max です。Use only latest run per group がオンの場合は使用できません。
Use only latest run per group は、Point aggregation method がデフォルトの Full fidelity の場合にのみ有効です。Random sampling モードでは効果がありません。
チャート タイプ
グラフのスタイルを選択します。- 折れ線グラフ
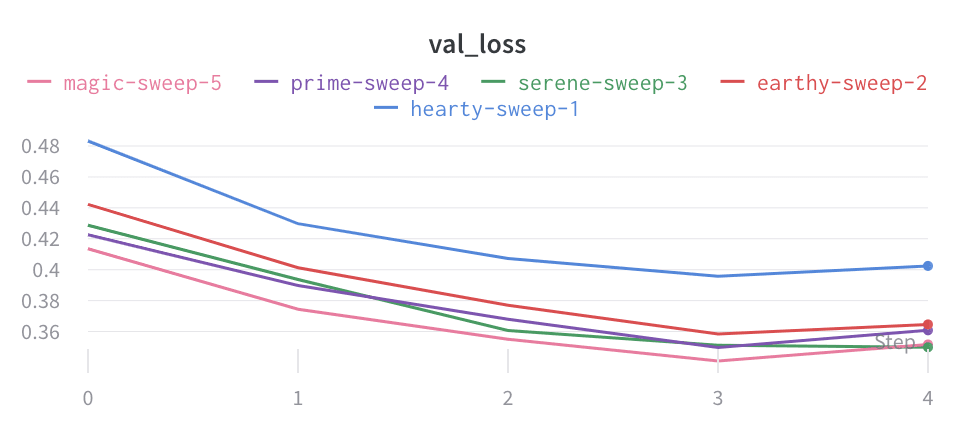
- 面グラフ
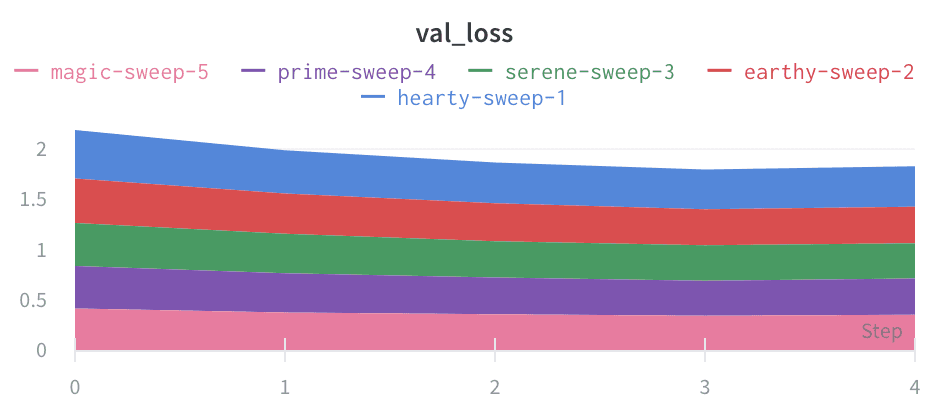
- 100% 積み上げ面グラフ
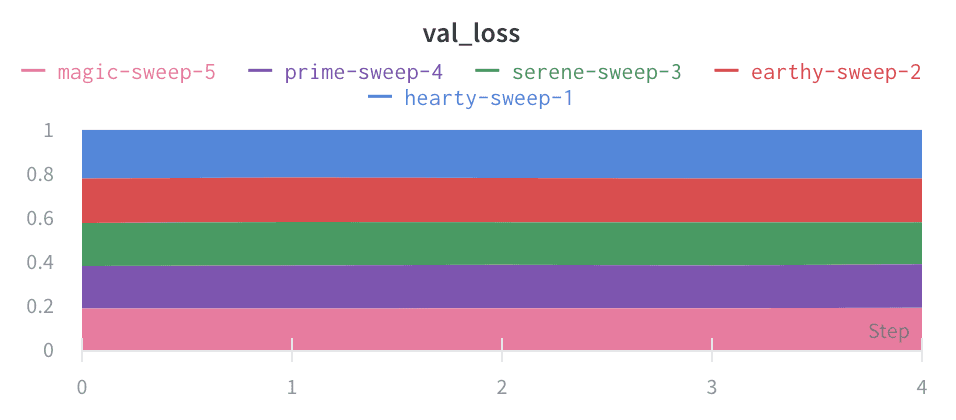
グループ化の設定
グループ化を有効にすることで全 run を集約するか、個別の変数でグループ化します。run テーブルでグループ化を有効にすると、グループは自動的にグラフに反映されます。- Group runs: プロットで run のグループ化を有効にします。プロットのシェーディング範囲を設定するには必須です。run を 1 本の線に集約しないようにするには、これをオフにしてください。グループ化を有効にしたまま集約を無効にするための別スイッチはありません。
- Group by: オプションで列を選択します。その列で同じ値を持つ run はまとめてグループ化されます。
- 集約: グラフ上の線の値です。グループの mean、median、min、max から選択できます。このコントロールは Group runs がオンの場合のみ適用されます。
- Range: full-fidelity 折れ線グラフのシェーディング領域を設定します。Min/Max、Std Dev、Std Err、または None を選択できます。
チャート設定
タイトルと凡例の表示を設定します。- パネルタイトル: パネルの上部に表示されるタイトルです。
- X 軸タイトル: X 軸のラベルです。
- Y 軸タイトル: Y 軸のラベルです。
- 凡例: 凡例の表示・非表示を切り替え、その位置を設定します。
凡例の設定
凡例をカスタマイズすると、ログした任意の設定値や、run の作成日時や作成したユーザーなどの run のメタデータを表示できます。凡例テンプレート
凡例名のテンプレートを定義します。- 歯車アイコンをクリックして、プロットの設定を開きます。
- Display preferencesタブに移動します。
- Advanced legendを展開し、凡例テンプレートを指定します。
- Applyをクリックします。
ポイント固有の値
[[ ]] 内に値を設定すると、チャートにマウスポインターを合わせたときに、十字線にポイント固有の値が表示されます。
- 歯車アイコンをクリックしてプロットの設定を開きます。
- Display preferences タブに移動します。
- タブの下部で、プロットのメトリクスを 1 つ以上選び、ポイント固有の値を設定します。
- Apply をクリックします。
[[ ]] 内でサポートされる値:
式
数式を作成して、ログしたメトリクス、設定値、サマリー統計から折れ線グラフを作成または変換します。たとえば、2 つのメトリクスの差を計算したり、設定値でメトリクスのスケールを変更したり、メトリクスの対数をプロットしたりできます。式は、ログする各ステップで評価されます。 以下のセクションでは、式で値を参照する方法と、カスタム式で使用できるオペレーターおよび関数について説明します。折れ線グラフでは、X 軸、Y 軸、または両方に式を使用できます。 一般的な使用例と式のサンプルについては、式のサンプルを参照してください。式を使用して新しい折れ線グラフを作成する
- project の Workspace にアクセスします。
- + Add panel ボタンをクリックし、折れ線グラフ を選択します。
- Data タブをクリックします。折れ線グラフにプロットするデータを、x 軸と y 軸それぞれについて選択します。
- 式 タブをクリックします。
- Y 軸 フィールドまたは X 軸 フィールドに式を入力します。
- Apply をクリックして設定を保存し、折れ線グラフを表示します。
式を使って既存の折れ線グラフを変換する
- 変換する折れ線グラフを開きます。
- グラフの右上にある歯車アイコンをクリックして、パネルを編集します。
- 式タブをクリックします。
- Y 軸フィールドまたは X 軸フィールドに式を入力します。
- Apply をクリックして設定を保存し、更新された折れ線グラフを表示します。
値の参照
次の表は、折れ線グラフの式でログしたメトリクス、設定パラメーター、サマリー統計を参照する方法を示しています。
メトリクス名、設定パラメーター、サマリーフィールドに
/ や - などの特殊文字やスペースが含まれる場合は、${...} を使用してエスケープします。
たとえば、val/accuracy という名前のメトリクスをログした場合は、除算オペレーターと区別するために ${val/accuracy} として参照します。dropout-rate という名前の設定パラメーターをログした場合は、${config:dropout-rate} として参照します。best loss という名前のサマリーフィールドをログした場合は、${summary:best loss} として参照します。
ネストされた設定
ドット表記と次の構文を使用して、ネストされた設定値にアクセスします。parent、child、grandchild は、ネストされた設定の辞書のキーです。
たとえば、以下のようなネストされた辞書を持つ設定をログするとします:
${config:model.type} で参照できます。バッチサイズは ${config:training.batch_size} で参照できます。
別の例として、辞書がネストされた次の設定を考えてみます。
Config parameters
${config:optimizer.value.lr}、モデルの隠れ層のサイズは ${config:model.value.hidden_size}、重み減衰は ${config:optimizer.value.weight_decay} で参照します。
利用可能なオペレーター
W&B は折れ線グラフの式で次のオペレーターをサポートします:数学定数と関数
JavaScript のすべての数学関数と定数がサポートされています。詳細については、MDN Math ドキュメントを参照してください。以下の表に、折れ線グラフの式でよく使用される関数と定数をまとめます。数学定数
算術関数と統計関数
次の表では、利用可能な算術関数と統計関数について説明します:対数関数と指数関数
次の表では、利用可能な対数関数と指数関数について説明します。三角関数
以下の表で、利用可能な三角関数について説明します。双曲線関数
次の表では、利用可能な双曲線関数について説明します。式のサンプル
以下は、折れ線グラフの軸に使用する式のサンプルです。これらのサンプルは説明を目的としています。前のセクションで説明したオペレーターと関数を任意に組み合わせて、ニーズに合った複雑な式を作成できます。 以下のサンプルでは、サマリー メトリクスに以下の値を持つaccuracy と loss が含まれていると仮定します:
Summary metrics
Config parameters
lr)) で垂直方向にシフトします。
batch_size という名の設定パラメーターで精度メトリクスを再スケーリングします:
式では
${summary:metric_name} 構文を使用してサマリー メトリクスの値を参照することもできます。例:複数メトリクスのパネルの式
正規表現を使用して、複数のメトリクスをまとめて表示する単一の折れ線グラフを作成します (今後ログされる一致するメトリクスも含まれます) 。詳しい手順は、折れ線グラフを追加するを参照してください。 例:- 各層のメトリクス用に個別のパネルを作成する代わりに、単一のパネルにまとめて表示できます。たとえば、
layer_0_loss、layer_1_loss、layer_2_lossのように一貫した命名規則でメトリクスをログする場合、layer_\d+_lossのような正規表現を使用して、すべての層の損失を1つのグラフに表示できます。 - 共通の命名パターンを持つすべてのメトリクスに一致させます。例:
train_.*は、train_loss、train_accuracy、train_f1_scoreなどのすべてのトレーニングメトリクスに一致します.*_accuracyは、train_accuracy、val_accuracy、test_accuracyなど、異なるデータセットの精度メトリクスに一致します
- 選択を使用して、必要なメトリクスだけに一致させます。たとえば、非キャプチャグループ
(?:layer_0|layer_10)_lossは、中間の層を除外して、最初と10番目の層の損失だけに一致します。
キャプチャグループ
正規表現内のキャプチャグループは、複数メトリクスパネルの作成方法を制御します。この動作は、予期していない場合に混乱を招く可能性があります。-
キャプチャグループは複数のパネルを作成します
正規表現にキャプチャグループを形成する括弧が含まれている場合、UI はそのグループによって取得された一意の値ごとに別のパネルを作成します。
たとえば、式
(layer_0|layer_10)_lossにはキャプチャグループが含まれており、2 つの別のパネルを作成します。layer_0に一致するメトリクス用のパネル。layer_10に一致するメトリクス用のパネル。
-
非キャプチャグループはメトリクスを一緒に保持します
別のパネルを作成せずに複数の代替案に一致させるには、
?:構文を使用した非キャプチャグループを使用します。式(?:layer_0|layer_10)_lossは前の例と同じメトリクスに一致しますが、単一のパネルにまとめて表示します。
(layer_0|layer_10)_loss- 各レイヤーごとに 2 つのパネルを作成します。(?:layer_0|layer_10)_loss- 両方のレイヤーをまとめて表示する 1 つのパネルを作成します。