Weave suit et journalise automatiquement les appels LLM effectués avec le SDK Cerebras Cloud.
Traces
Le suivi des appels LLM est essentiel pour le débogage et la surveillance des performances. Weave vous facilite la tâche en capturant automatiquement les traces du SDK Cerebras Cloud.
Voici un exemple d’utilisation de Weave avec Cerebras :
Weave suit et journalise désormais tous les appels LLM effectués via le SDK Cerebras. Vous pouvez consulter les traces dans l’interface web de Weave, avec des détails tels que l’utilisation des jetons et le temps de réponse.
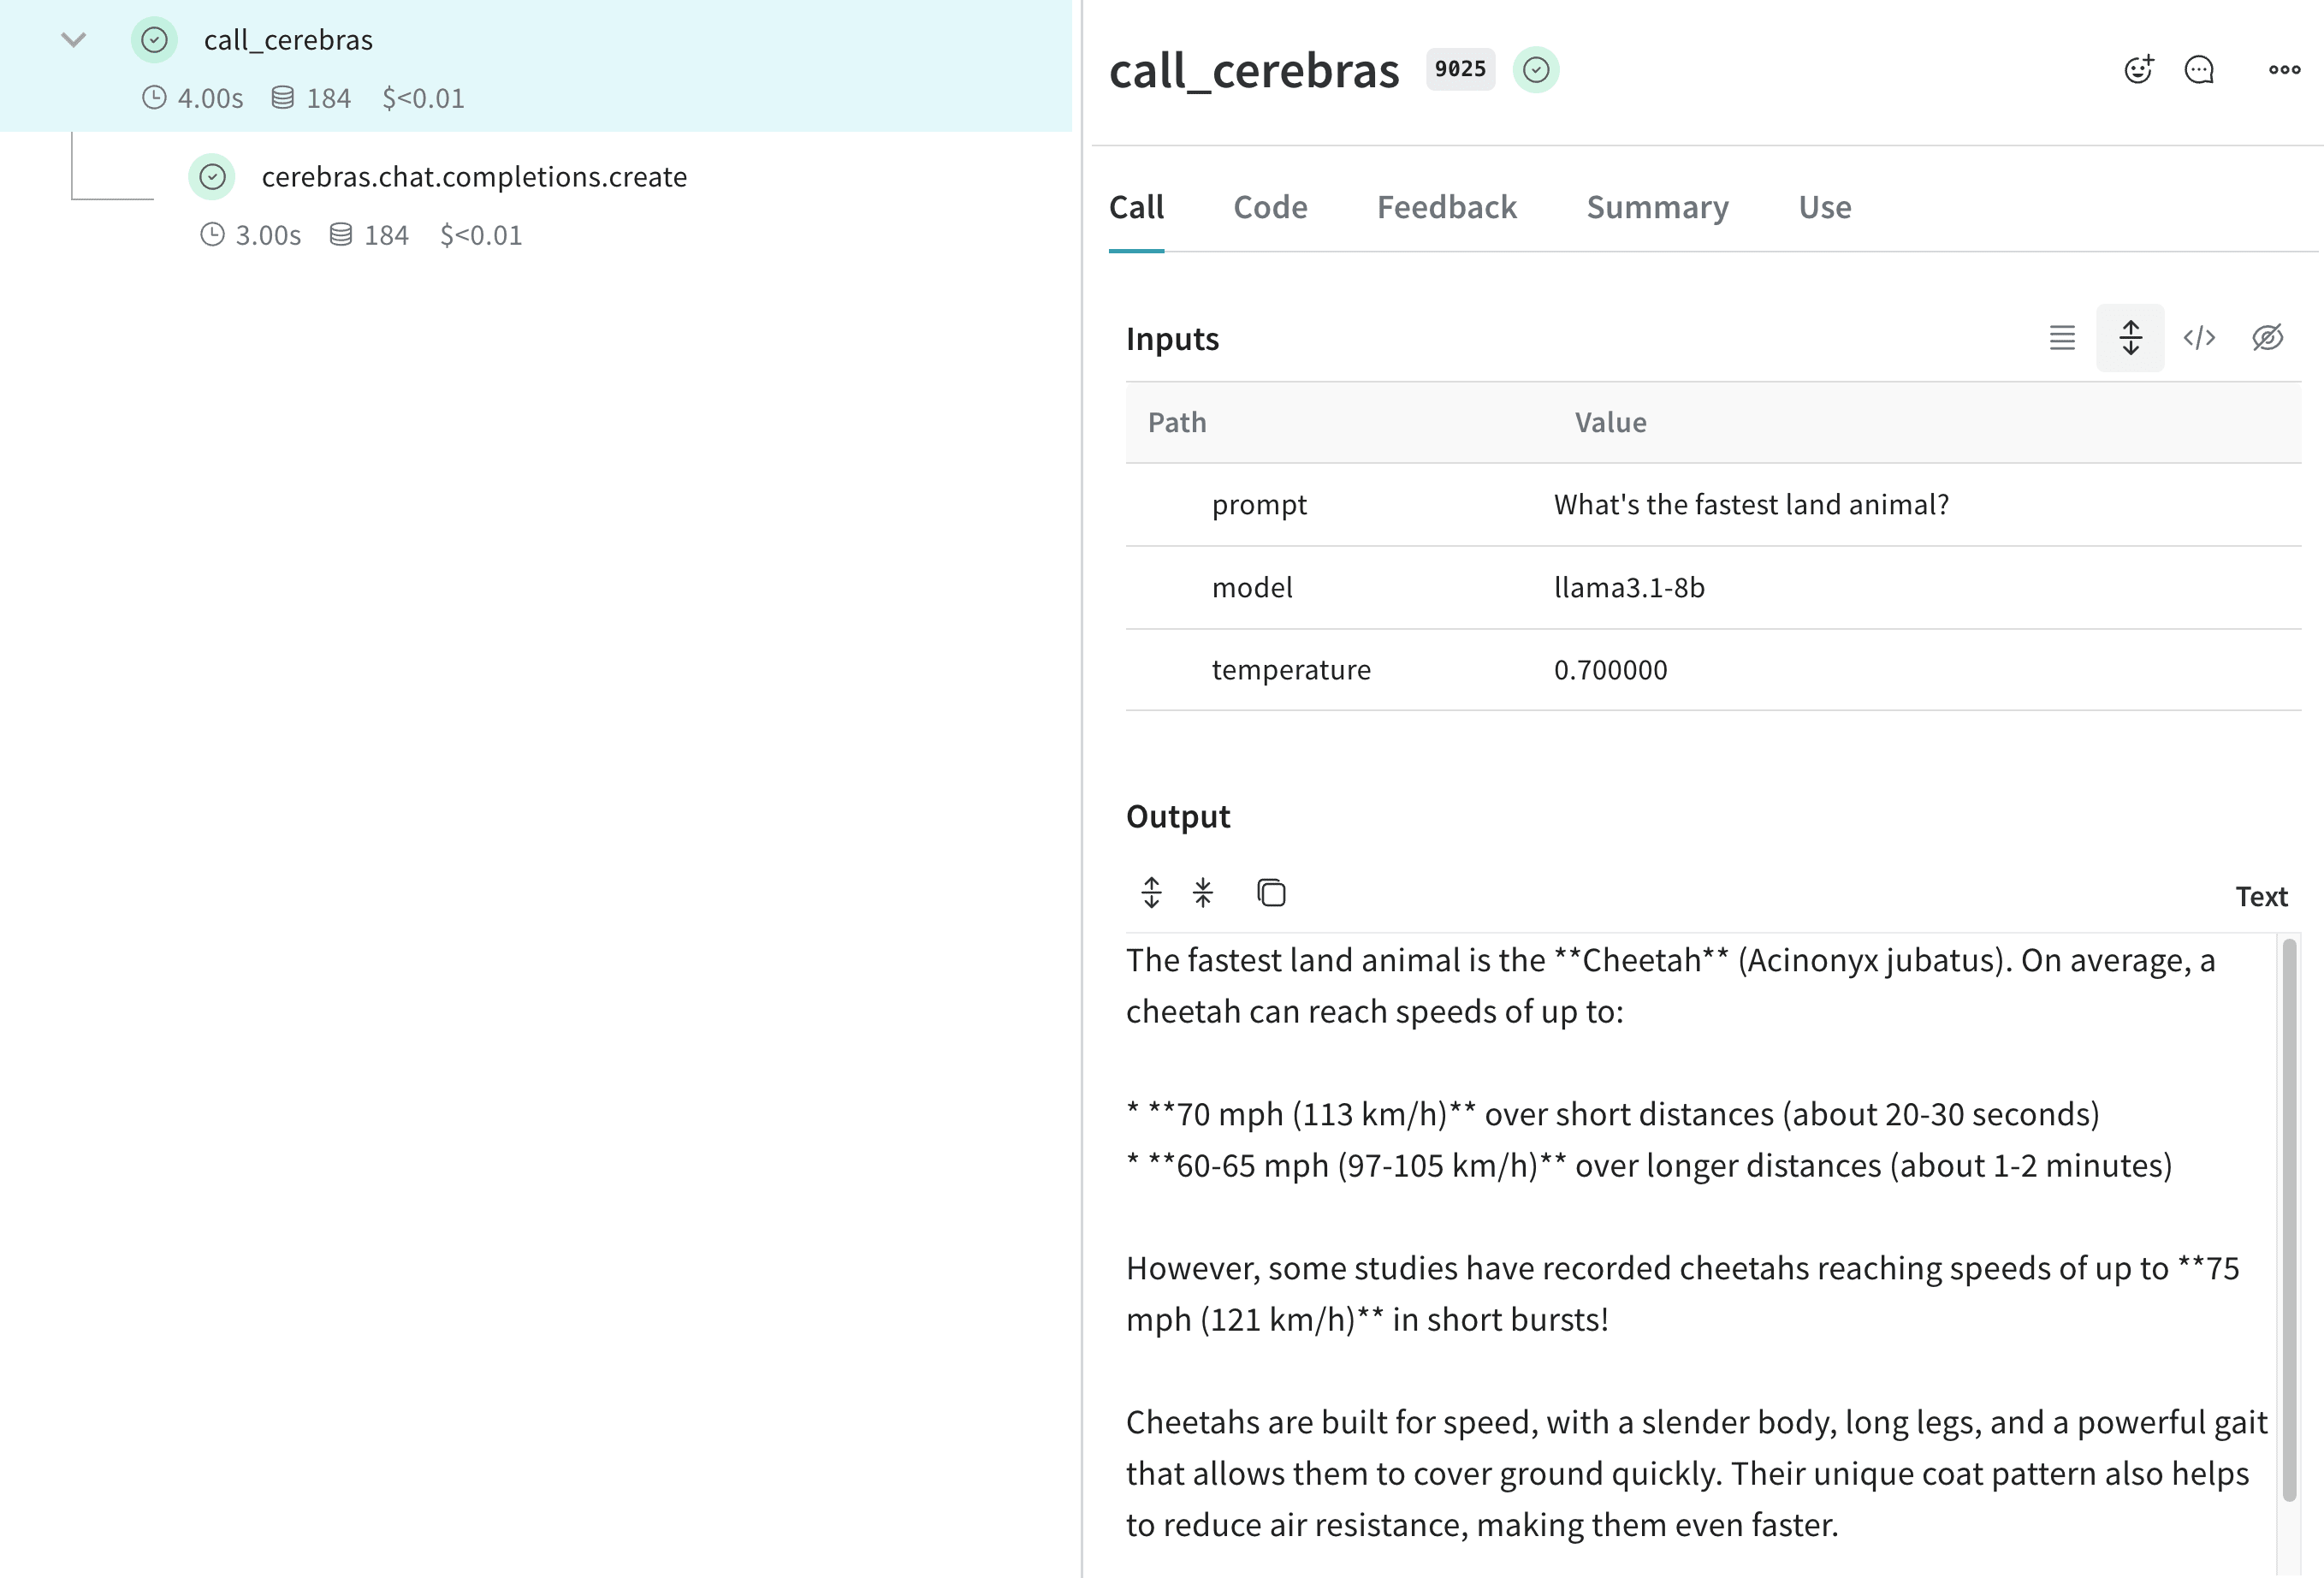
Encapsuler avec vos propres ops
Les ops Weave améliorent la reproductibilité et la traçabilité de vos expériences en gérant automatiquement les versions de votre code et en capturant les entrées et les sorties. Voici un exemple d’utilisation des ops Weave avec le SDK Cerebras :
Créer un Model pour faciliter l’expérimentation
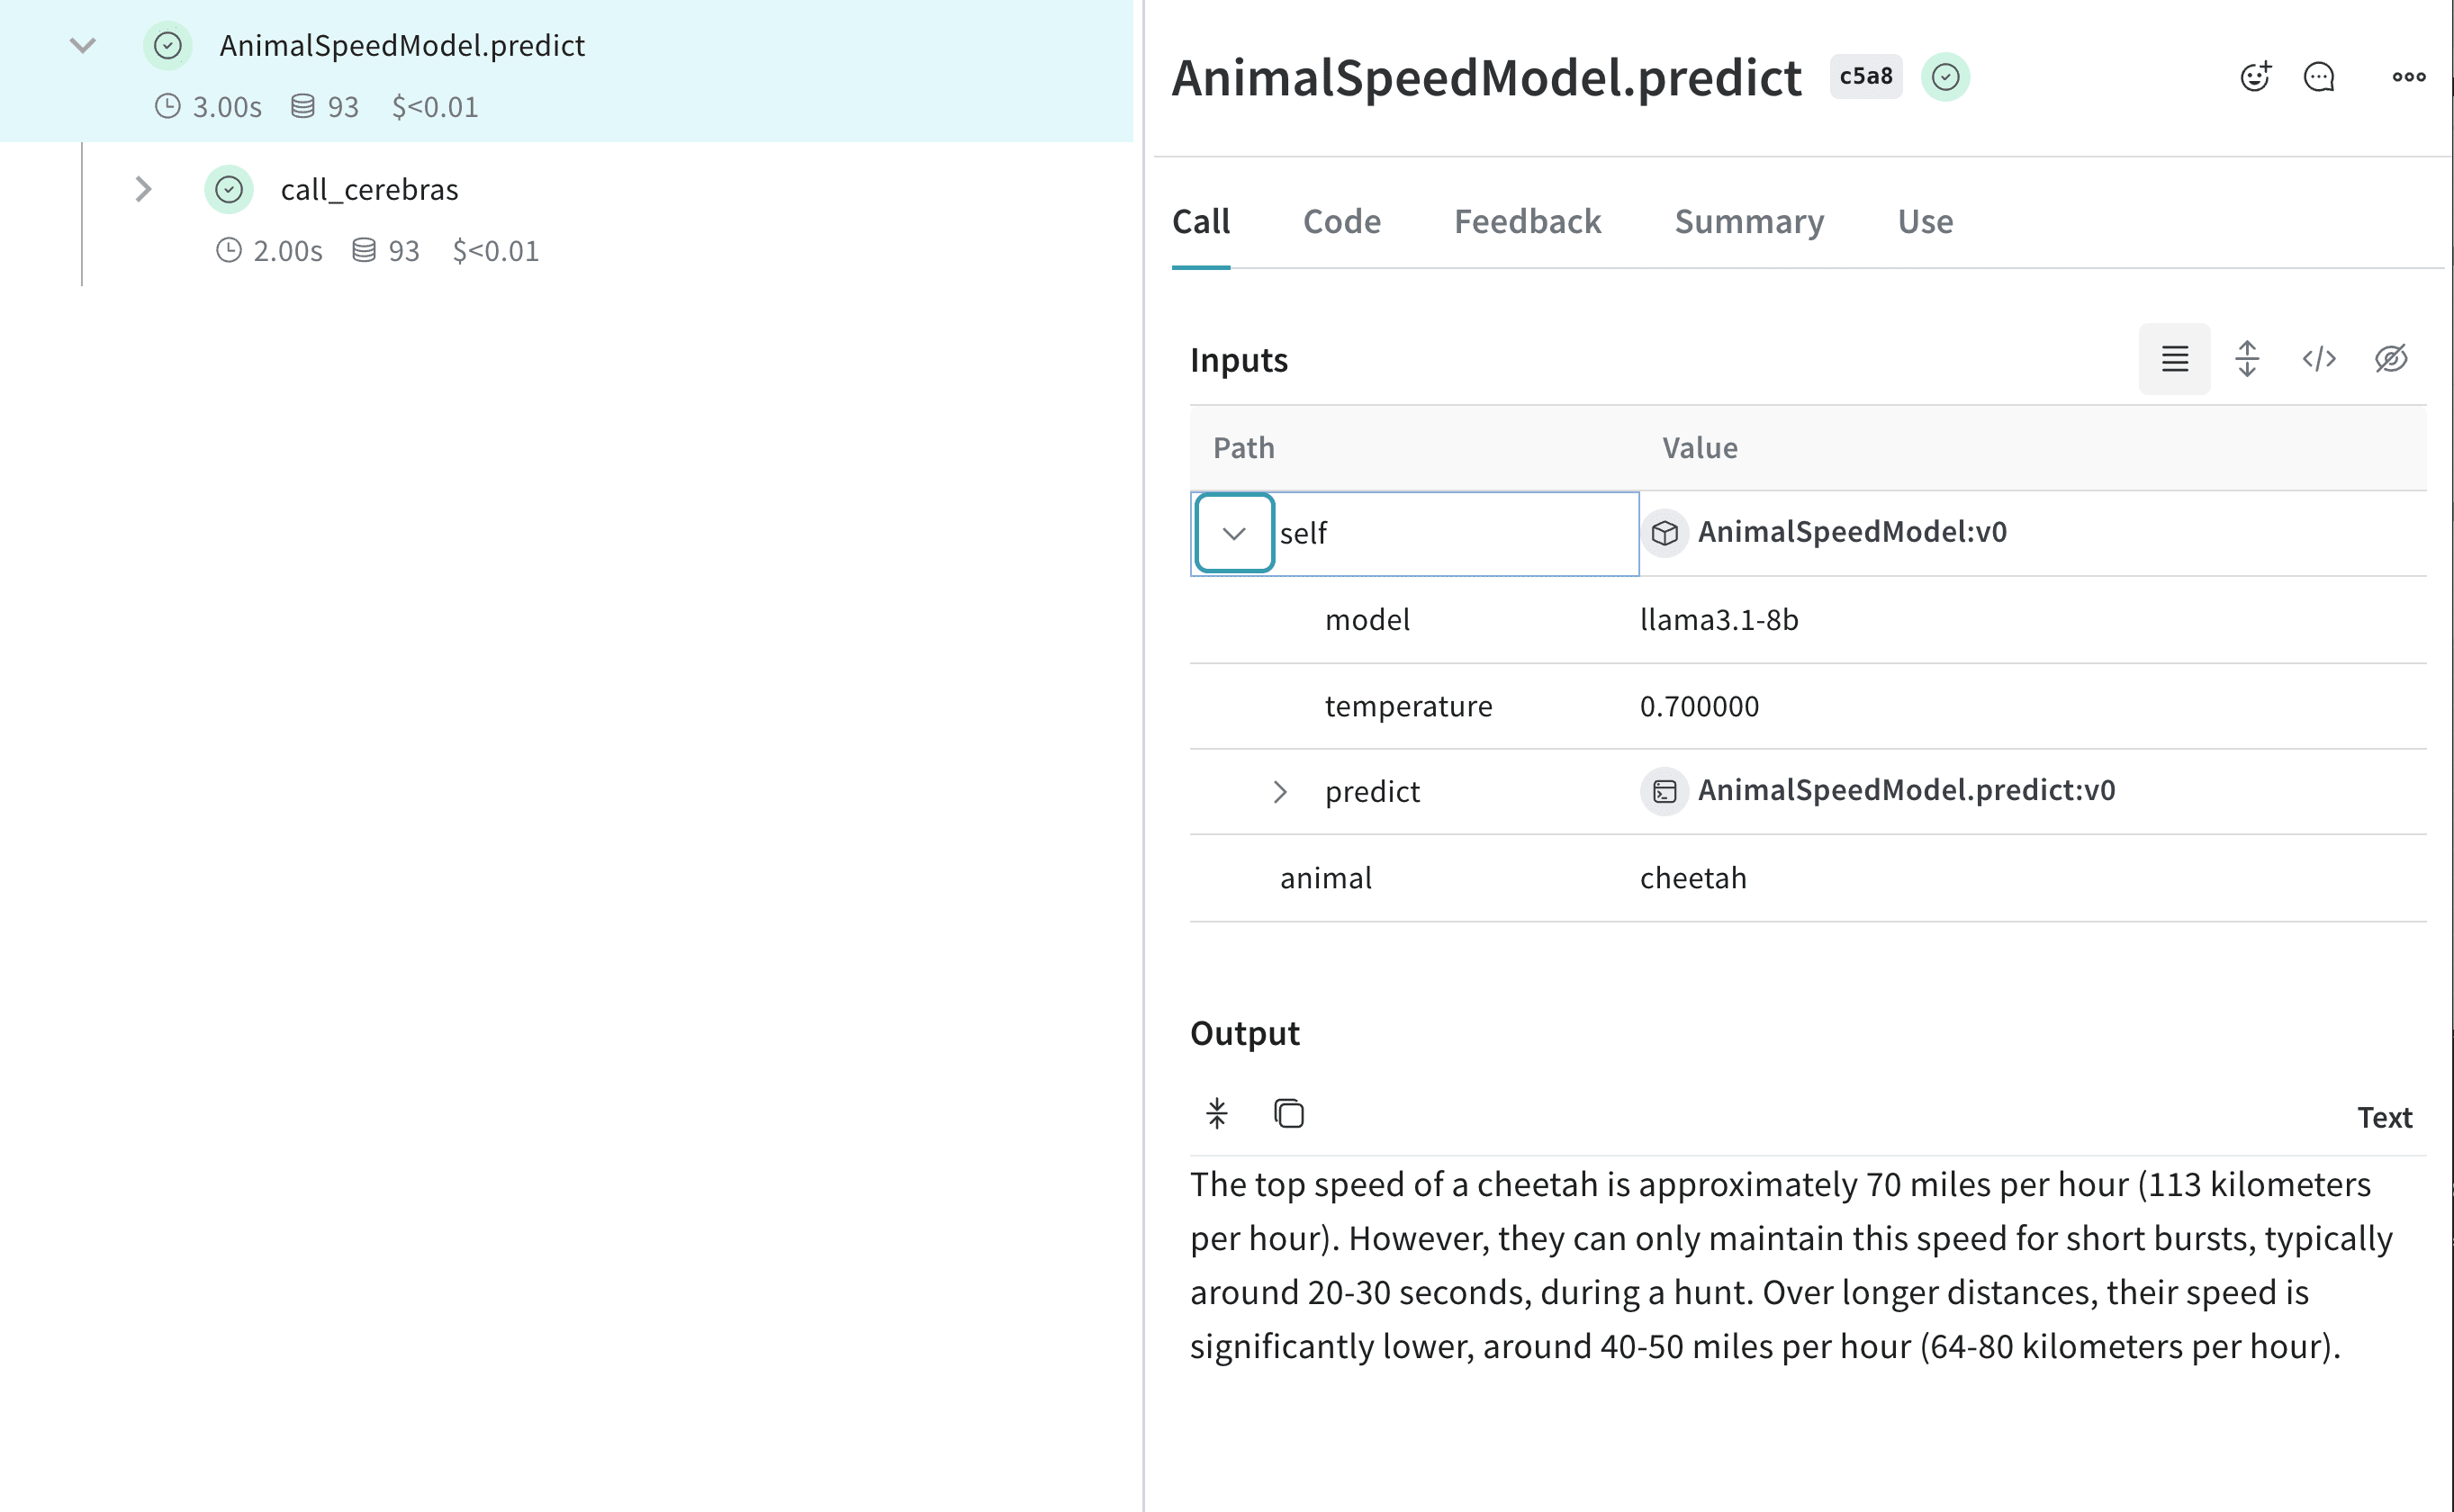
La classe Model de Weave vous aide à organiser et à comparer les différentes itérations de votre application. Elle s’avère utile lorsque vous expérimentez avec des modèles Cerebras. Voici un exemple :
Grâce à cette configuration, vous pouvez tester différents modèles et paramètres tout en assurant le suivi de vos inférences exécutées sur Cerebras.
Dernière modification le 30 septembre 2026

