Tous les exemples de code présentés sur cette page sont en Python.
Essayez Hugging Face Hub avec Weave dans Google Colab
Vous souhaitez expérimenter Hugging Face Hub et Weave sans rien configurer ? Vous pouvez essayer les exemples de code présentés ici sous forme de Jupyter Notebook dans Google Colab.
Aperçu
Hugging Face Hub est une plateforme de machine learning destinée aux créateurs et aux collaborateurs, qui propose une vaste collection de modèles pré-entraînés et de datasets pour de nombreux types de projets. La bibliothèque Pythonhuggingface_hub fournit une interface unifiée pour exécuter l’inférence sur plusieurs services avec les modèles hébergés sur le Hub. Vous pouvez appeler ces modèles à l’aide de InferenceClient.
Weave capture automatiquement les traces d’InferenceClient. Pour commencer à suivre vos appels, appelez weave.init() et utilisez la bibliothèque comme d’habitude.
Prérequis
Avant de commencer, effectuez les étapes de configuration suivantes pour installer les bibliothèques requises et configurer l’accès au Hugging Face Hub :-
Avant de pouvoir utiliser
huggingface_hubavec Weave, vous devez installer les bibliothèques nécessaires ou les mettre à niveau vers leurs dernières versions. La commande suivante installehuggingface_hubetweave, ou les met à niveau vers la dernière version s’ils sont déjà installés, tout en limitant la sortie de l’installation. -
Pour utiliser l’inférence avec un modèle du Hugging Face Hub, définissez votre jeton d’accès utilisateur. Vous pouvez définir le jeton depuis la page des paramètres de votre compte Hugging Face Hub ou par programmation. L’exemple de code suivant vous invite à saisir votre
HUGGINGFACE_TOKEN, puis le définit comme variable d’environnement.
Traçage de base
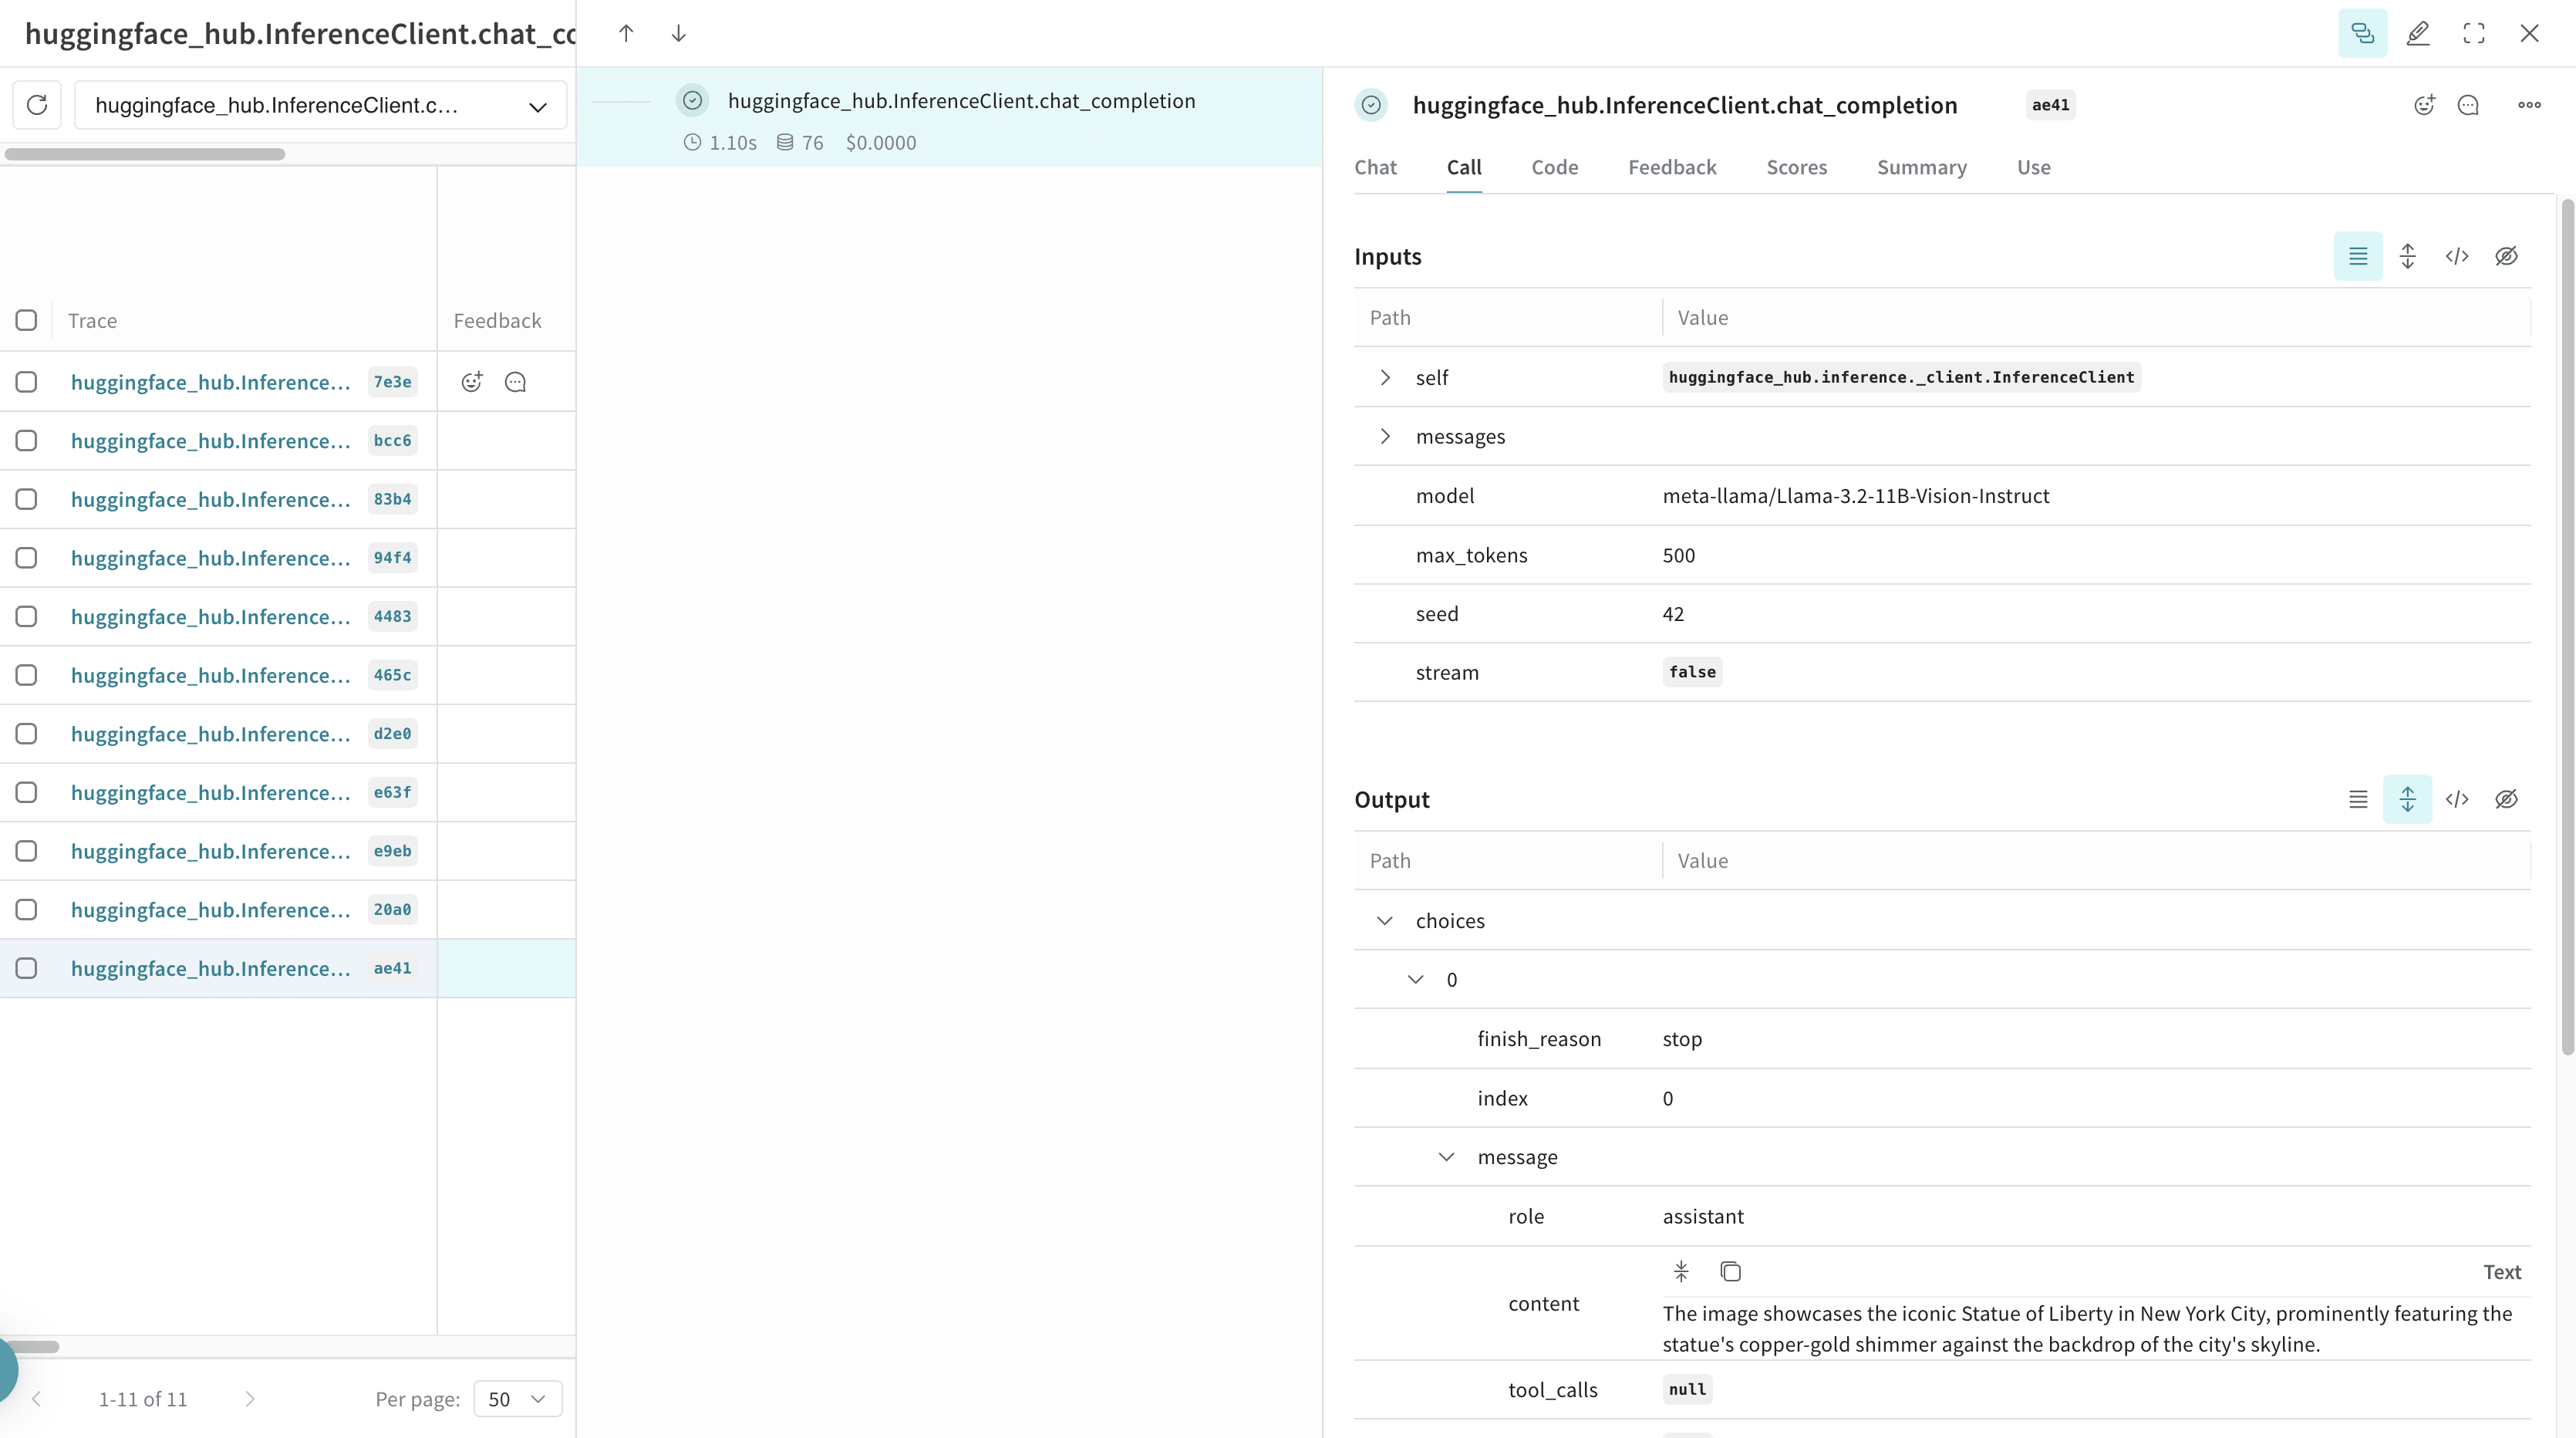
Il est essentiel de stocker les traces des applications de modèles de langage dans un emplacement centralisé, aussi bien en développement qu’en production. Ces traces facilitent le débogage et servent de datasets pour améliorer votre application. Weave capture automatiquement les traces deInferenceClient. Pour commencer à suivre, initialisez Weave en appelant weave.init(), puis utilisez la bibliothèque comme d’habitude.
L’exemple suivant montre comment journaliser avec Weave les appels d’inférence vers le Hugging Face Hub :
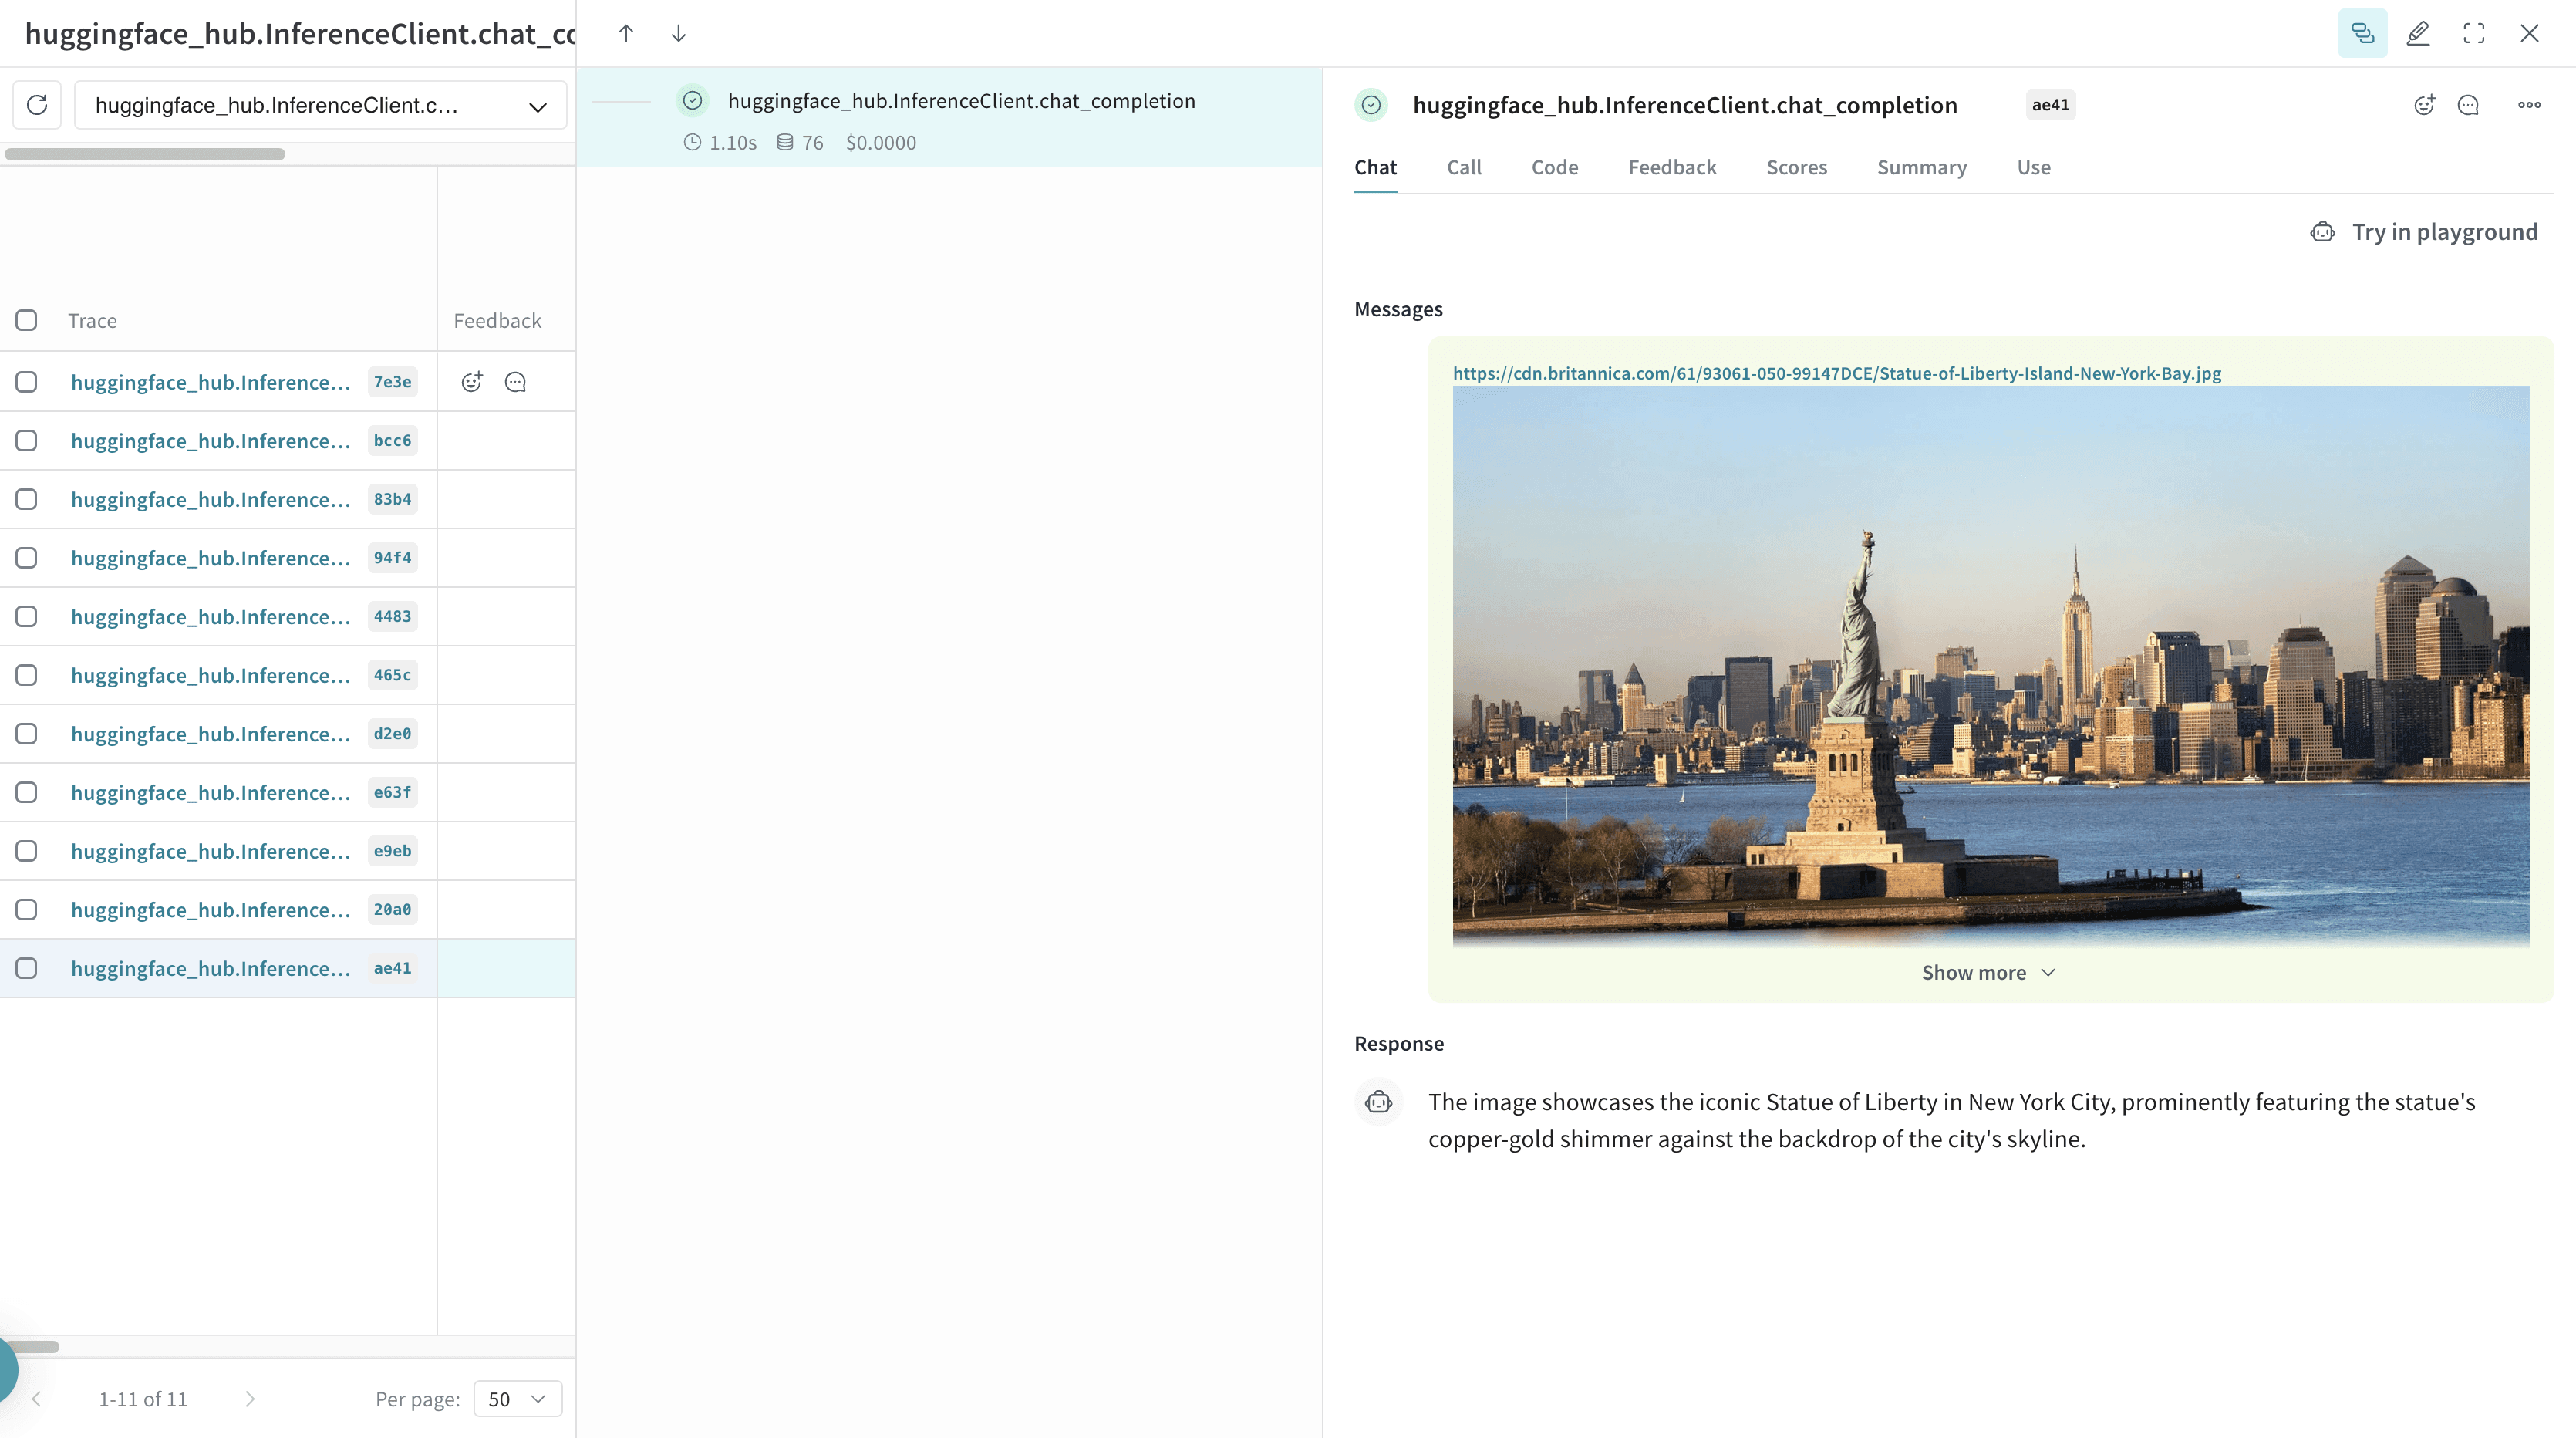 Weave affiche également l’appel sous forme de vue chat dans l’interface utilisateur, avec l’historique de conversation complet avec le modèle.
Tracer une fonction
Pour mieux comprendre la circulation des données dans votre application, vous pouvez utiliser@weave.op afin de suivre les appels de fonctions. Les entrées, les sorties et la logique d’exécution sont ainsi capturées, ce qui facilite le débogage et l’analyse des performances.
En imbriquant plusieurs ops, vous pouvez construire une arborescence structurée de fonctions suivies. Weave versionne également votre code automatiquement et conserve les états intermédiaires au fil de vos expériences, avant même que vous ne validiez vos modifications dans Git.
Pour commencer à suivre vos fonctions, décorez celles que vous souhaitez suivre avec @weave.op.
Dans l’exemple suivant, Weave suit trois fonctions : generate_image, check_image_correctness et generate_image_and_check_correctness. Ces fonctions génèrent une image et vérifient si elle correspond à un prompt donné.
@weave.op, ce qui vous permet d’analyser le détail de leur exécution dans l’interface Weights & Biases.
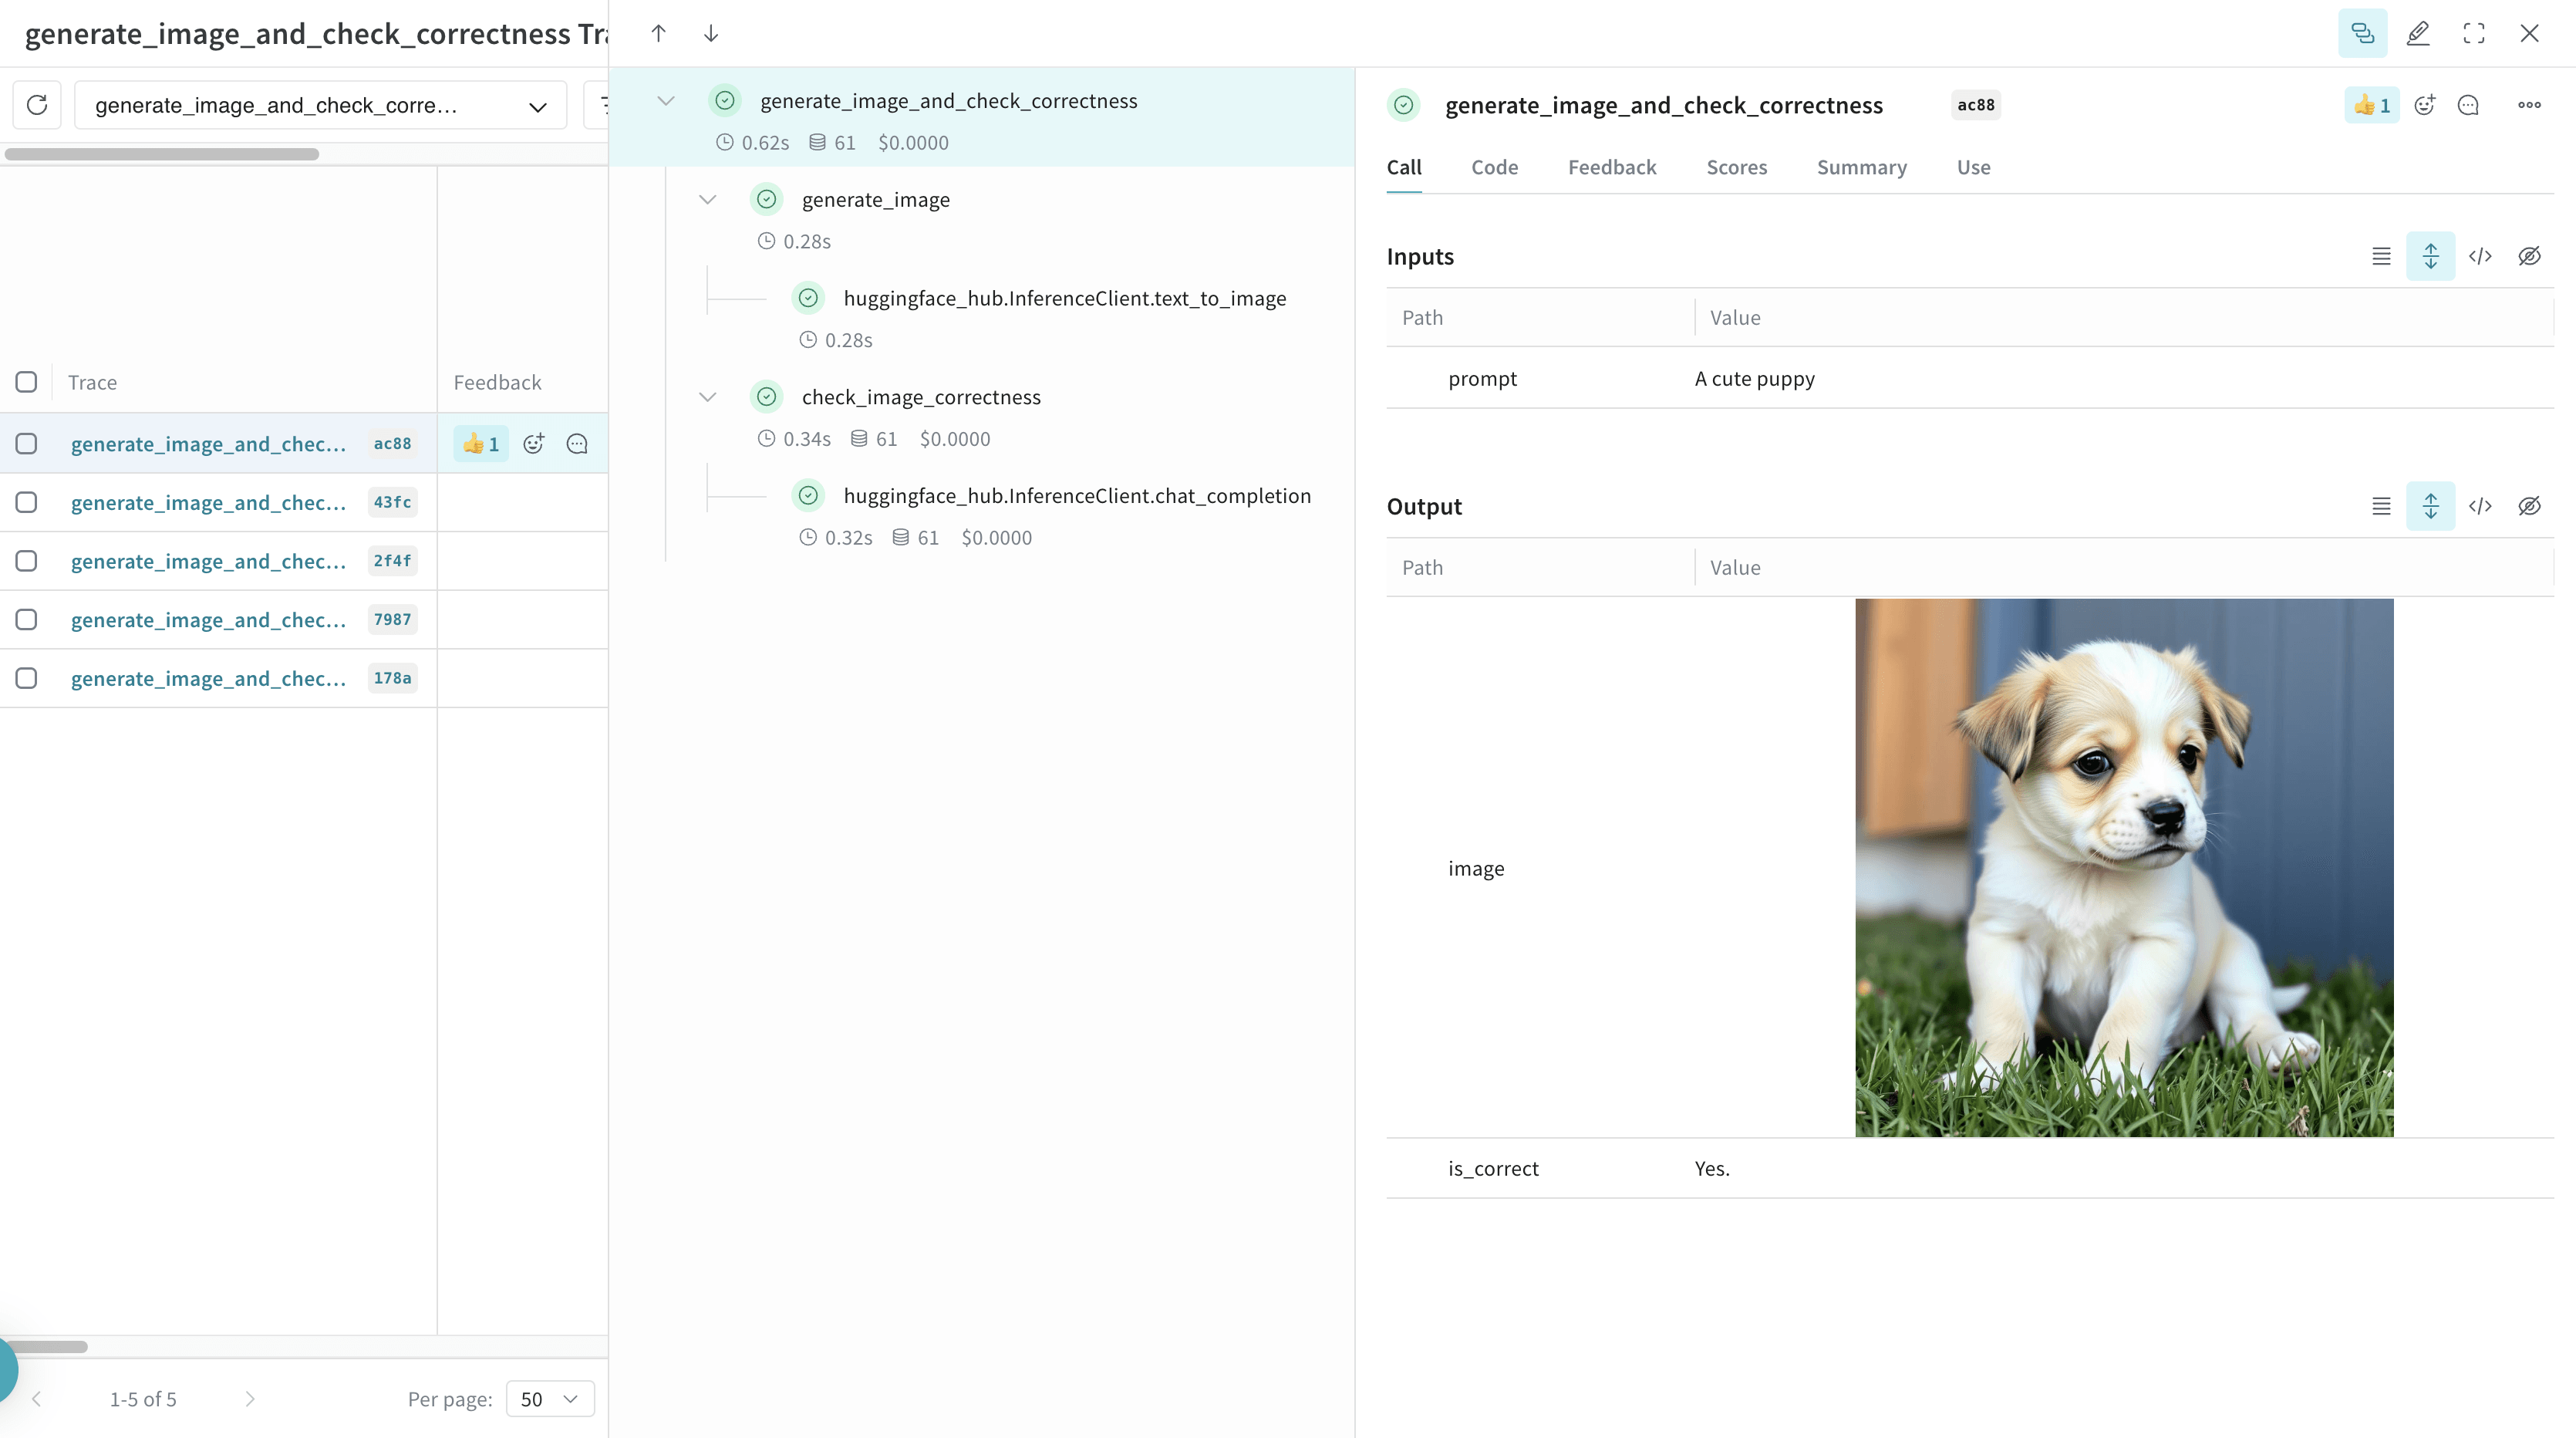 Weave capture et visualise également l’exécution des fonctions, pour vous aider à comprendre le flux de données et la logique de votre application.
Utiliser les Model pour l’expérimentation
La gestion des expériences LLM peut s’avérer complexe lorsque plusieurs composants entrent en jeu. La classe Model de Weave permet de capturer et d’organiser les détails de vos expériences, tels que les prompts système et les configurations de modèle, afin de comparer différentes itérations.
En plus de gérer les versions du code et de capturer les entrées et les sorties, un Model stocke des paramètres structurés qui contrôlent le comportement de l’application. Vous pouvez ainsi identifier les configurations qui ont produit les meilleurs résultats. Vous pouvez également intégrer un Model Weave à Weave Serve et aux Évaluations pour approfondir votre analyse.
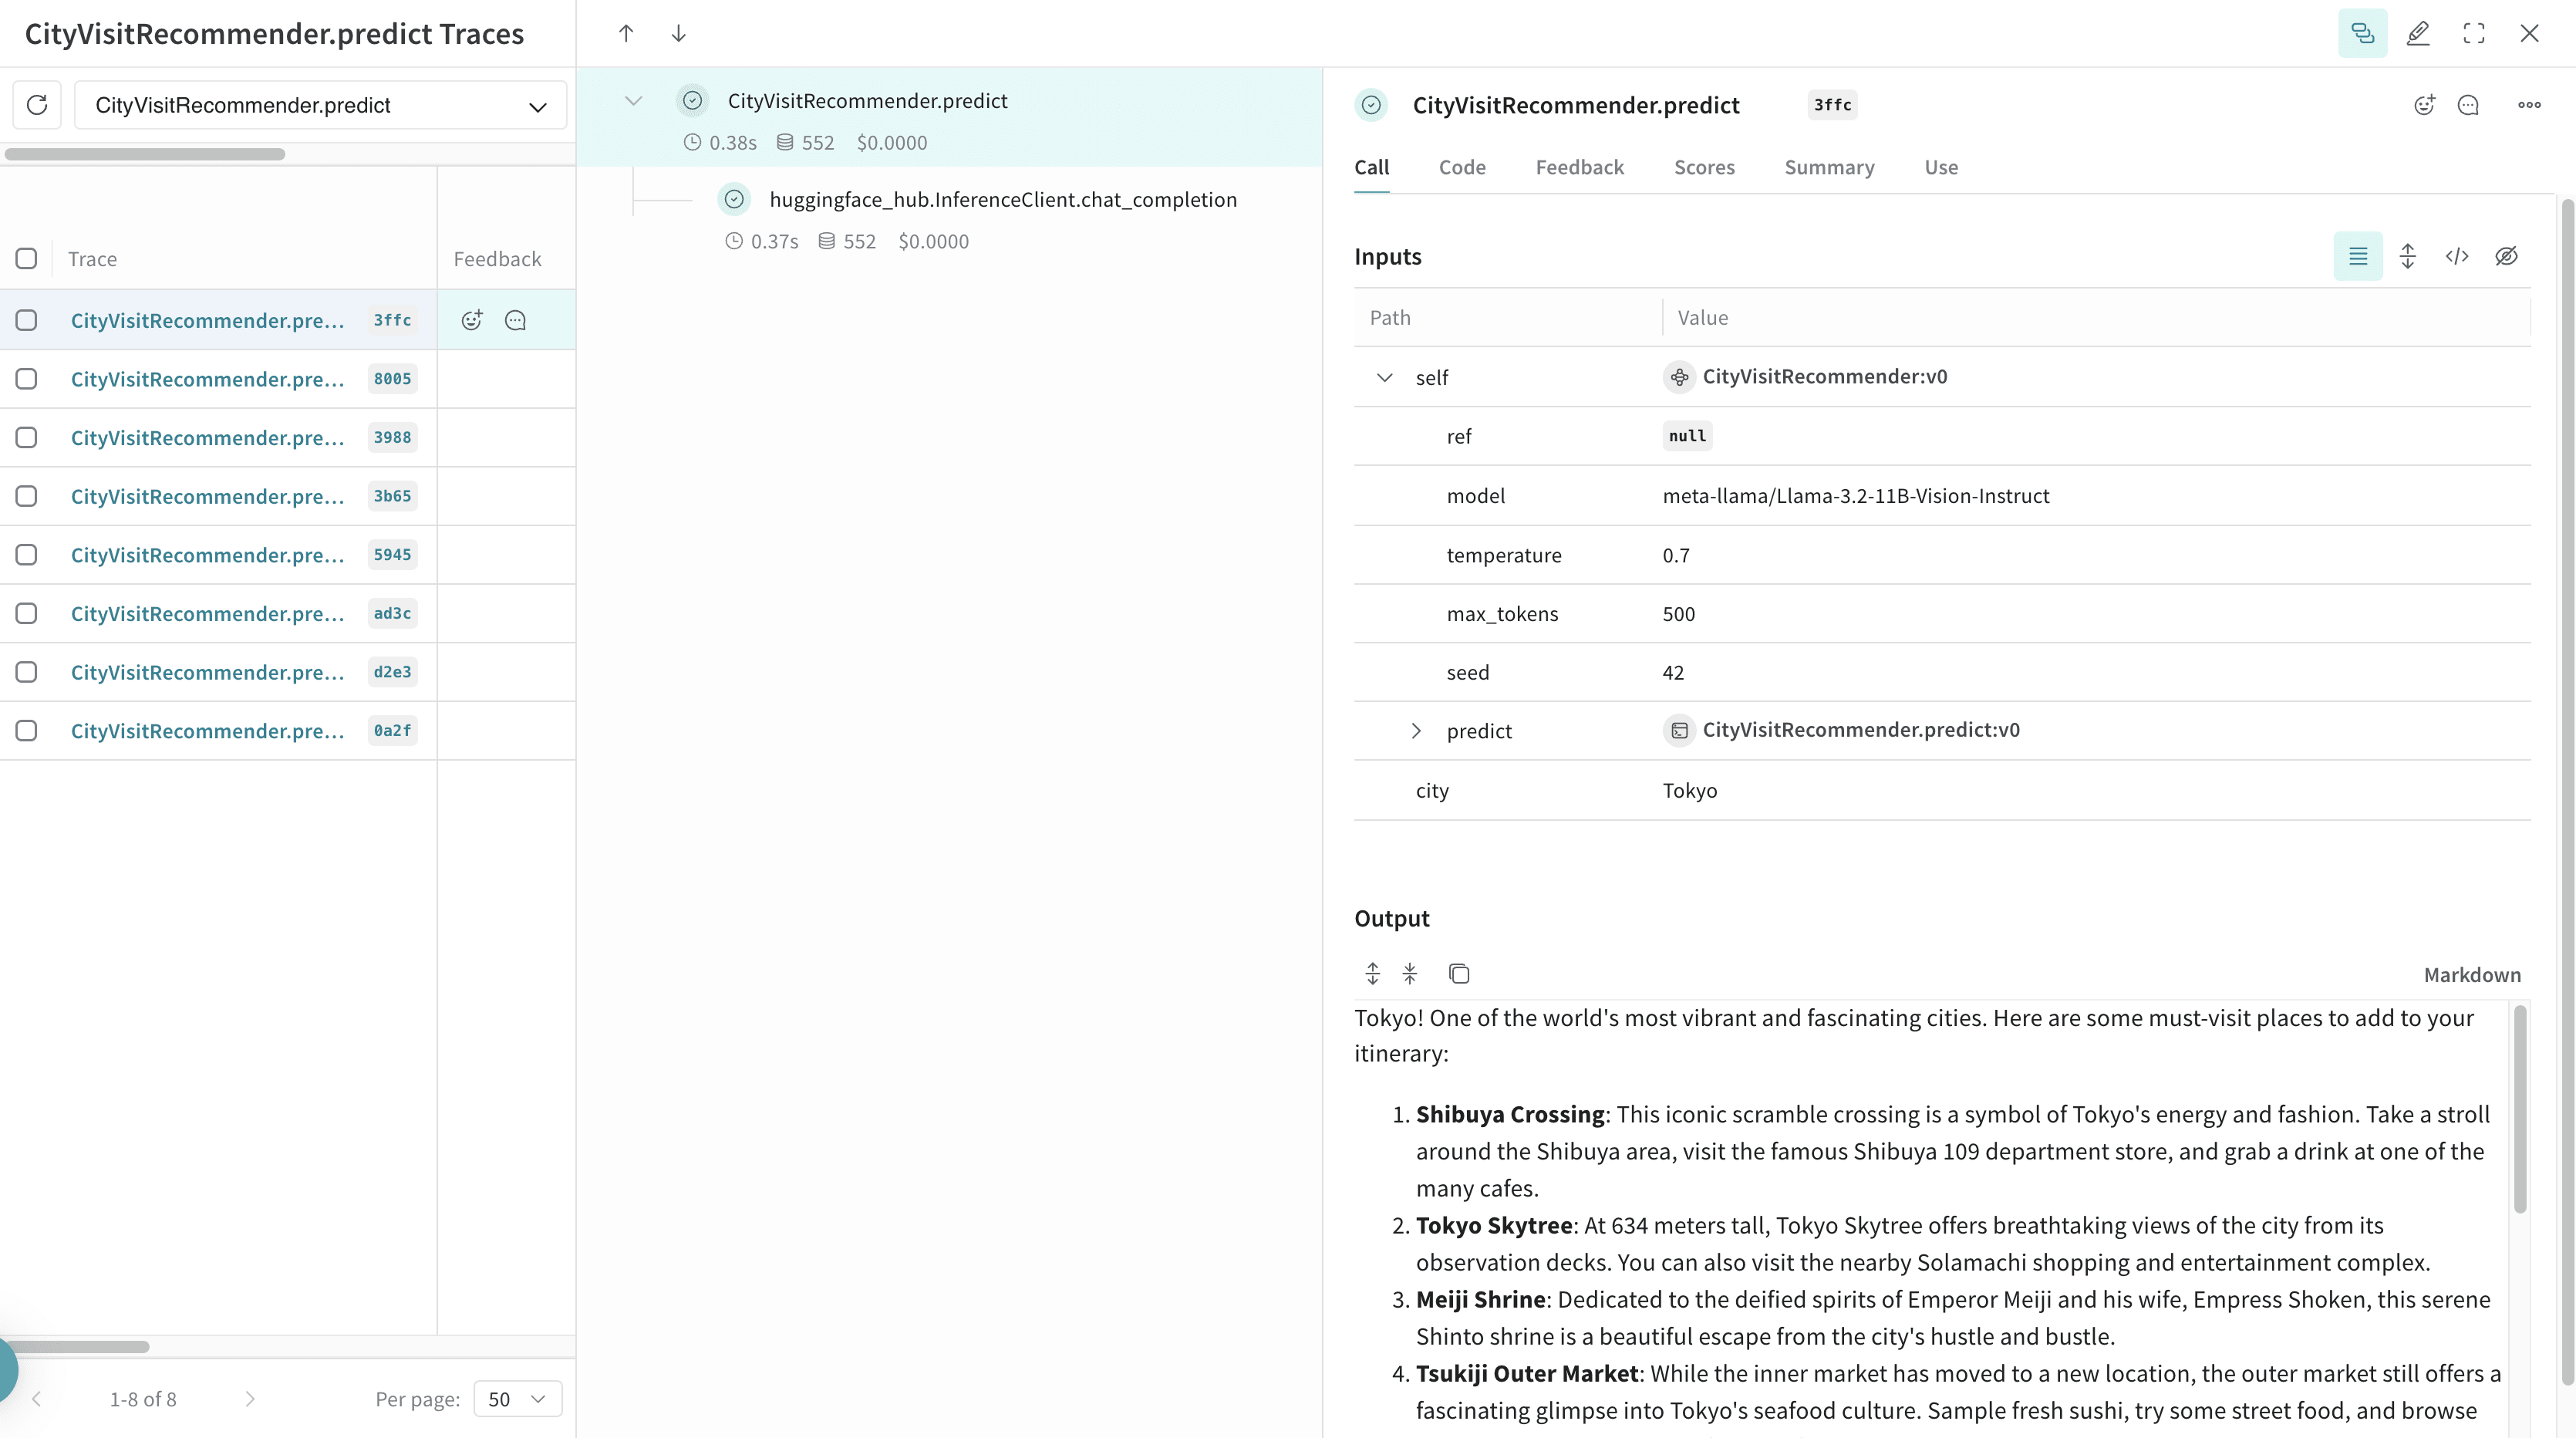
L’exemple suivant définit un modèle CityVisitRecommender destiné aux recommandations de voyage. Chaque modification de ses paramètres génère une nouvelle version, ce qui facilite l’expérimentation itérative.