

weave.init() appelé, Weave suit et journalise automatiquement les appels LLM effectués via la bibliothèque ChatNVIDIA. Ce guide explique aux développeurs Python qui utilisent ChatNVIDIA comment capturer les traces, encapsuler leurs propres fonctions sous forme d’ops et organiser leurs expériences avec la classe Model de Weave, afin de déboguer et comparer plus efficacement leurs applications LLM, et d’itérer plus rapidement sur celles-ci.
Traçage
Stocker les traces de vos applications LLM dans une base de données centrale, aussi bien pendant le développement qu’en production, vous aide à déboguer les problèmes et à constituer un jeu de données d’exemples difficiles sur lesquels évaluer votre application au fil de ses améliorations. La section suivante explique comment activer le traçage automatique des appels ChatNVIDIA.- Python
- TypeScript
Weave peut capturer automatiquement les traces de la bibliothèque Python ChatNVIDIA.Pour lancer la capture, appelez Une fois ce code exécuté, Weave capture l’appel ChatNVIDIA dans le projet que vous avez indiqué. Vous pouvez alors y examiner les entrées, les sorties et les métadonnées.
weave.init([PROJECT-NAME]) avec le nom de projet de votre choix.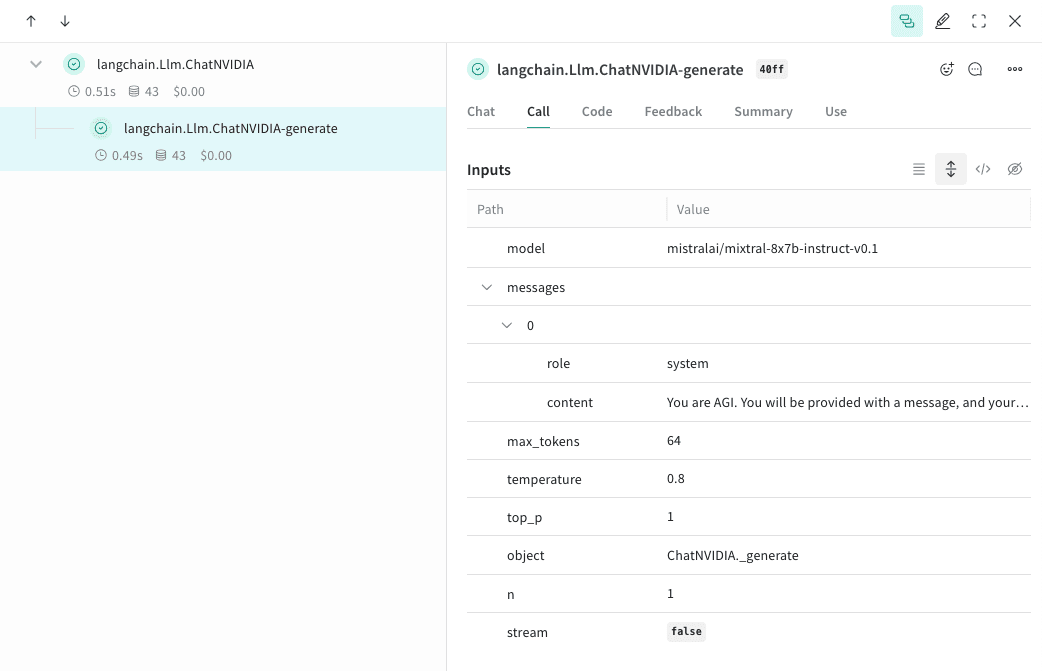
Suivre vos propres ops
- Python
- TypeScript
Encapsuler une fonction avec Accédez à Weave et cliquez sur
@weave.op permet de capturer les entrées, les sorties et la logique de l’application, afin de déboguer le parcours des données dans votre application. Vous pouvez imbriquer les ops sur plusieurs niveaux et construire une arborescence des fonctions que vous souhaitez suivre. Cela active également la gestion automatique des versions du code au fil de vos expériences, pour capturer les modifications ponctuelles que vous n’avez pas encore commitées dans Git.Créez une fonction décorée avec @weave.op qui appelle la bibliothèque Python ChatNVIDIA.Dans l’exemple suivant, deux fonctions sont encapsulées avec op. Vous pouvez ainsi observer comment les étapes intermédiaires, comme l’étape de récupération dans une application RAG, influent sur le comportement de votre application.get_pokemon_data dans l’interface utilisateur pour afficher les entrées et les sorties de cette étape.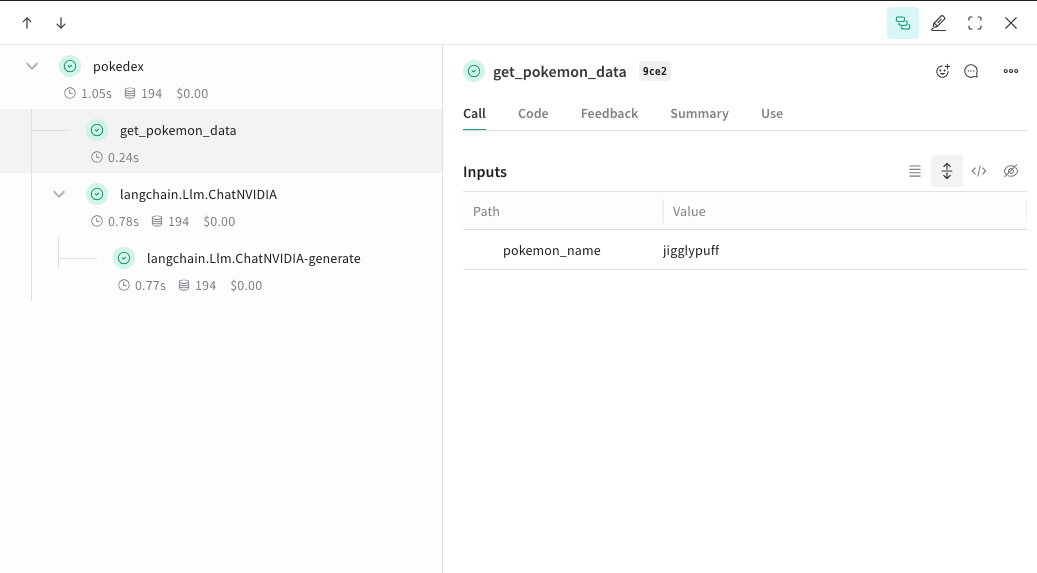
Créer un Model pour faciliter l’expérimentation
- Python
- TypeScript
Il est difficile d’organiser ses expériences lorsque de nombreux éléments évoluent en même temps. La classe
Model vous permet de capturer et d’organiser les détails expérimentaux de votre application, comme votre prompt système ou le modèle que vous utilisez. Vous pouvez ainsi organiser et comparer plus facilement les différentes itérations de votre application.En plus de gérer les versions du code et de capturer les entrées et les sorties, les Models capturent des paramètres structurés qui contrôlent le comportement de votre application, ce qui permet de trouver facilement les paramètres les plus efficaces. Vous pouvez également utiliser les Weave Models avec serve et les Evaluations.Dans l’exemple suivant, vous pouvez expérimenter avec model et system_message. Chaque fois que vous modifiez l’un de ces éléments, vous obtenez une nouvelle version de GrammarCorrectorModel.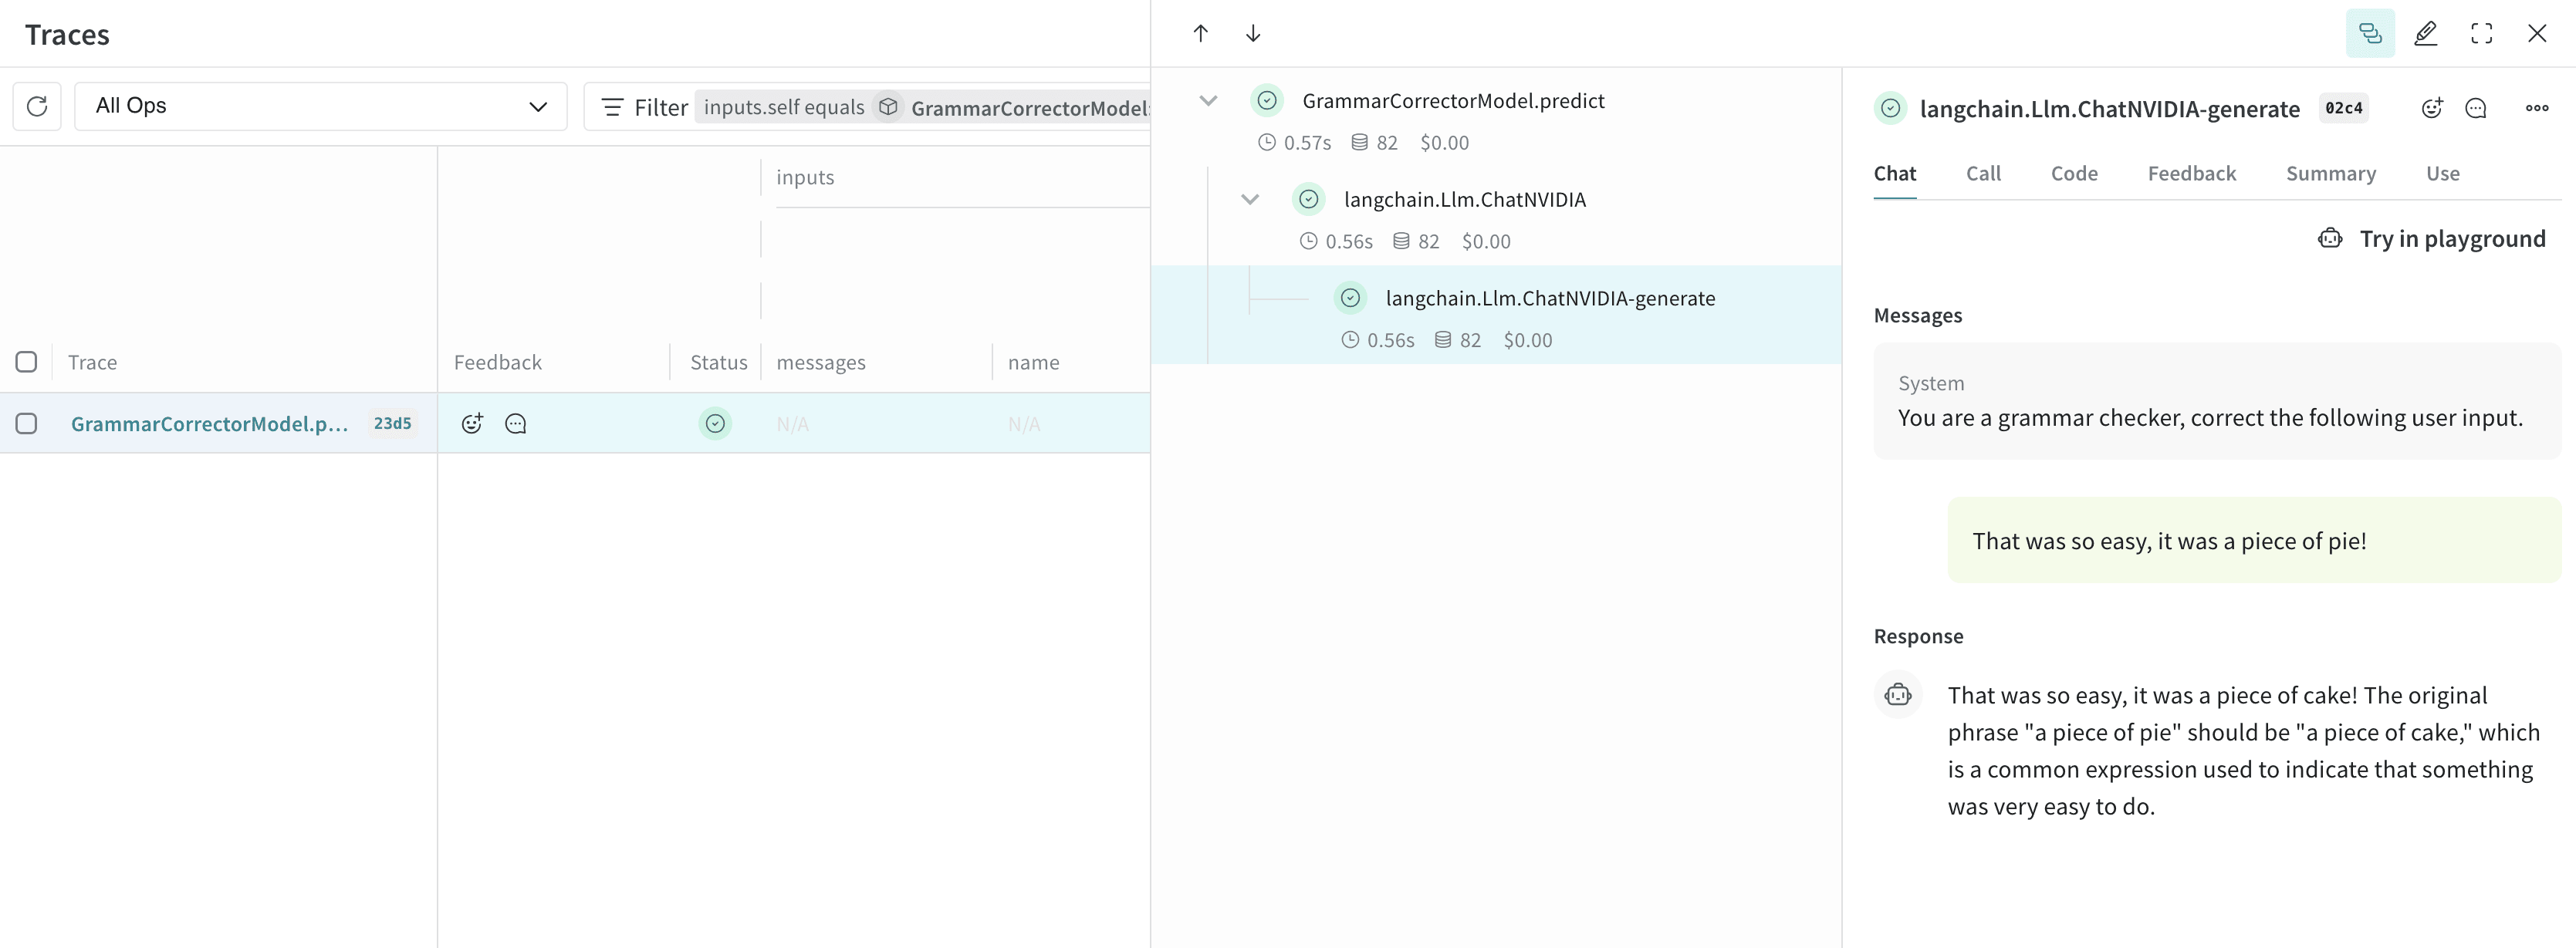
Informations d’utilisation
Les remarques suivantes décrivent les fonctionnalités prises en charge par l’intégration ChatNVIDIA. L’intégration ChatNVIDIA prend en chargeinvoke, stream et leurs variantes asynchrones. Elle prend également en charge l’utilisation d’outils.
ChatNVIDIA étant conçu pour fonctionner avec de nombreux types de modèles, il ne prend pas en charge l’appel de fonctions.