これはインタラクティブなノートブックです。ローカルで実行するか、以下のリンクを使用できます:
前提条件
始める前に、必須のライブラリをインストールしてインポートし、W&B APIキーを取得して、Weave プロジェクトを初期化してください。このステップを完了すると、環境で W&B の認証を行い、Weave プロジェクトにトレースをログできるようになります。Weave でプロンプトを作成して反復処理する
モデルがエンティティを正しく抽出できるようにするには、適切なプロンプトエンジニアリングが重要です。このセクションでは、最初のプロンプトを作成して Weave にパブリッシュし、変更履歴をトラッキングできるようにしたうえで、より厳格な検証ルールを加えてプロンプトを改良します。 まず、画像データから何を抽出し、どのような形式で出力するかをモデルに指示する基本的なプロンプトを作成します。次に、トラッキングと反復処理のためにプロンプトを Weave に保存します。データセットを取得する
プロンプトを用意したら、次にパイプラインで処理する入力データが必要です。OCR パイプラインへの入力となる手書きメモのデータセットを取得します。 データセット内の画像はすでにbase64 でエンコードされているため、LLM は前処理なしでデータを使用できます。
NER パイプラインを構築する
プロンプトとデータセットを用意したら、それらを VLM に接続する NER パイプラインを構築します。パイプラインは次の 2 つの関数で構成されます。encode_image関数は、データセットから PIL 画像を受け取り、VLM に渡すことができるbase64でエンコードされた画像の文字列表現を返します。extract_named_entities_from_image関数は、画像とシステムプロンプトを受け取り、システムプロンプトで説明されているようにその画像から抽出されたエンティティを返します。
named_entity_recognation という関数を作成します。
- 画像データを NER パイプラインに渡します。
- 結果を正しく整形された JSON として返します。
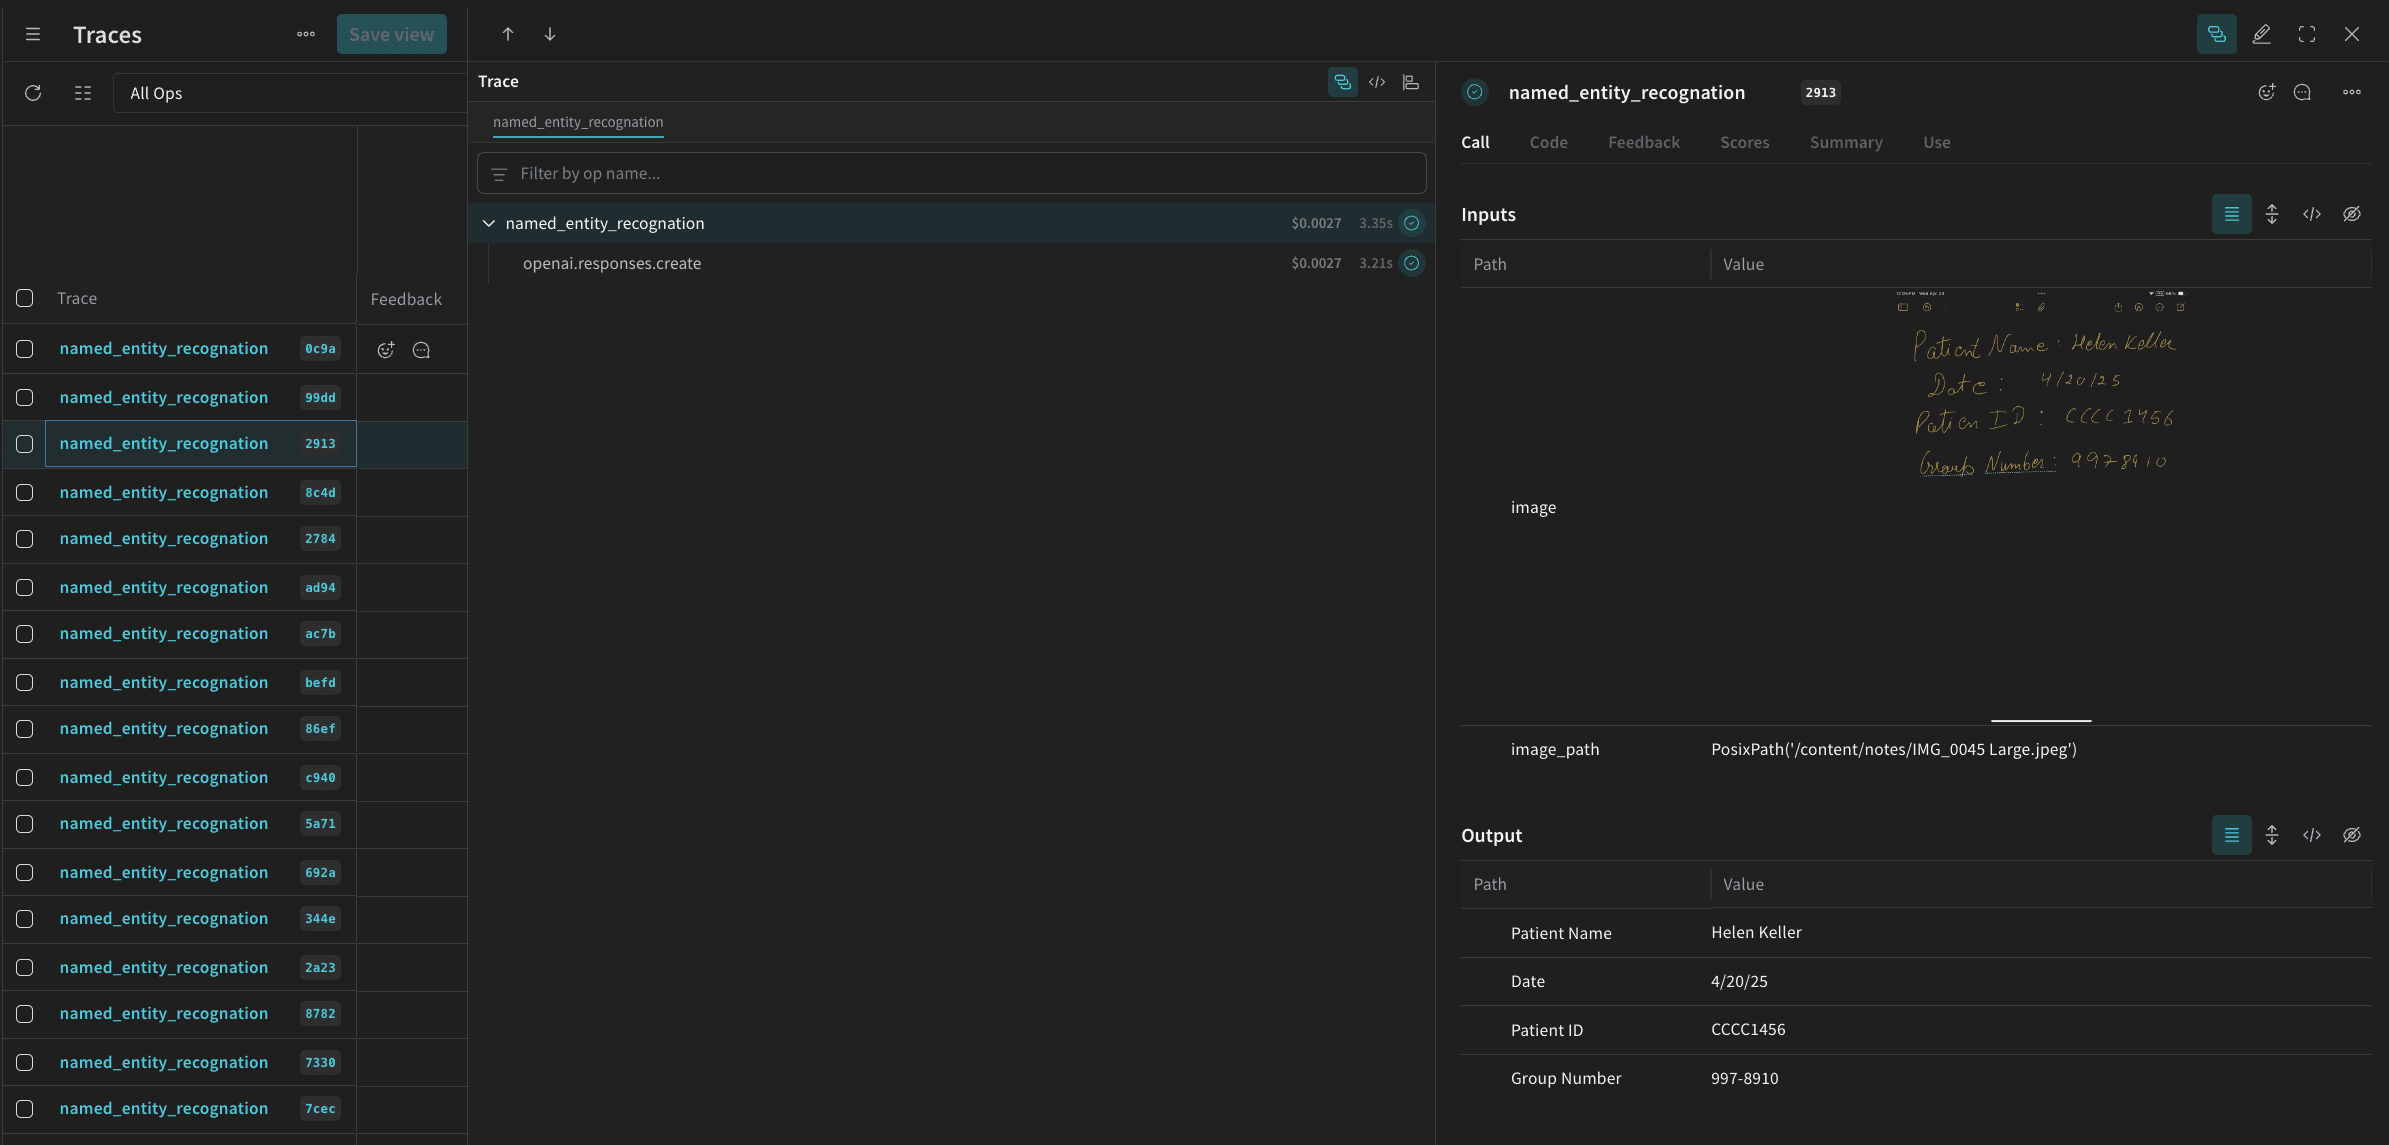
@weave.op() デコレーターを使用して、Weights & Biases UI で関数の実行を自動的にトラッキングし、トレースします。
named_entity_recognation が実行されるたびに、トレース結果全体が Weights & Biases UI に表示されます。トレースを表示するには、Weave プロジェクトの Traces タブにアクセスします。
processing_results.json に保存します。結果は Weights & Biases の UI でも確認できます。
Weave を使用してパイプラインを評価する
VLM を使用して NER を実行するパイプラインを作成したので、Weave を使用して体系的に評価し、その性能を確認できます。パイプラインを評価することで、抜き取り確認に頼らず、データセット全体にわたって抽出品質を測定できます。Weave の評価の詳細については、評価の概要を参照してください。 Weave の評価の基本となる要素が Scorer です。Scorer は AI の出力を評価し、評価メトリクスを返します。AI の出力を受け取って分析し、結果を辞書として返します。Scorer は必要に応じて入力データを参照として使用でき、評価に伴う説明や推論などの追加情報も出力できます。 このセクションでは、パイプラインを評価するために 2 つの Scorer を作成します。- プログラムによる Scorer。
- LLM-as-a-judge scorer。
プログラムによるScorer
最初の Scorer は、LLM を使用せずに実行する決定論的なチェックです。プログラムによるScorercheck_for_missing_fields_programatically は、モデル出力 (named_entity_recognition 関数の出力) を受け取り、結果内で欠落している、または空になっている keys を特定します。
このチェックは、モデルがいずれかのフィールドを取得し損ねたサンプルを特定するのに役立ちます。
LLM-as-a-judge Scorer
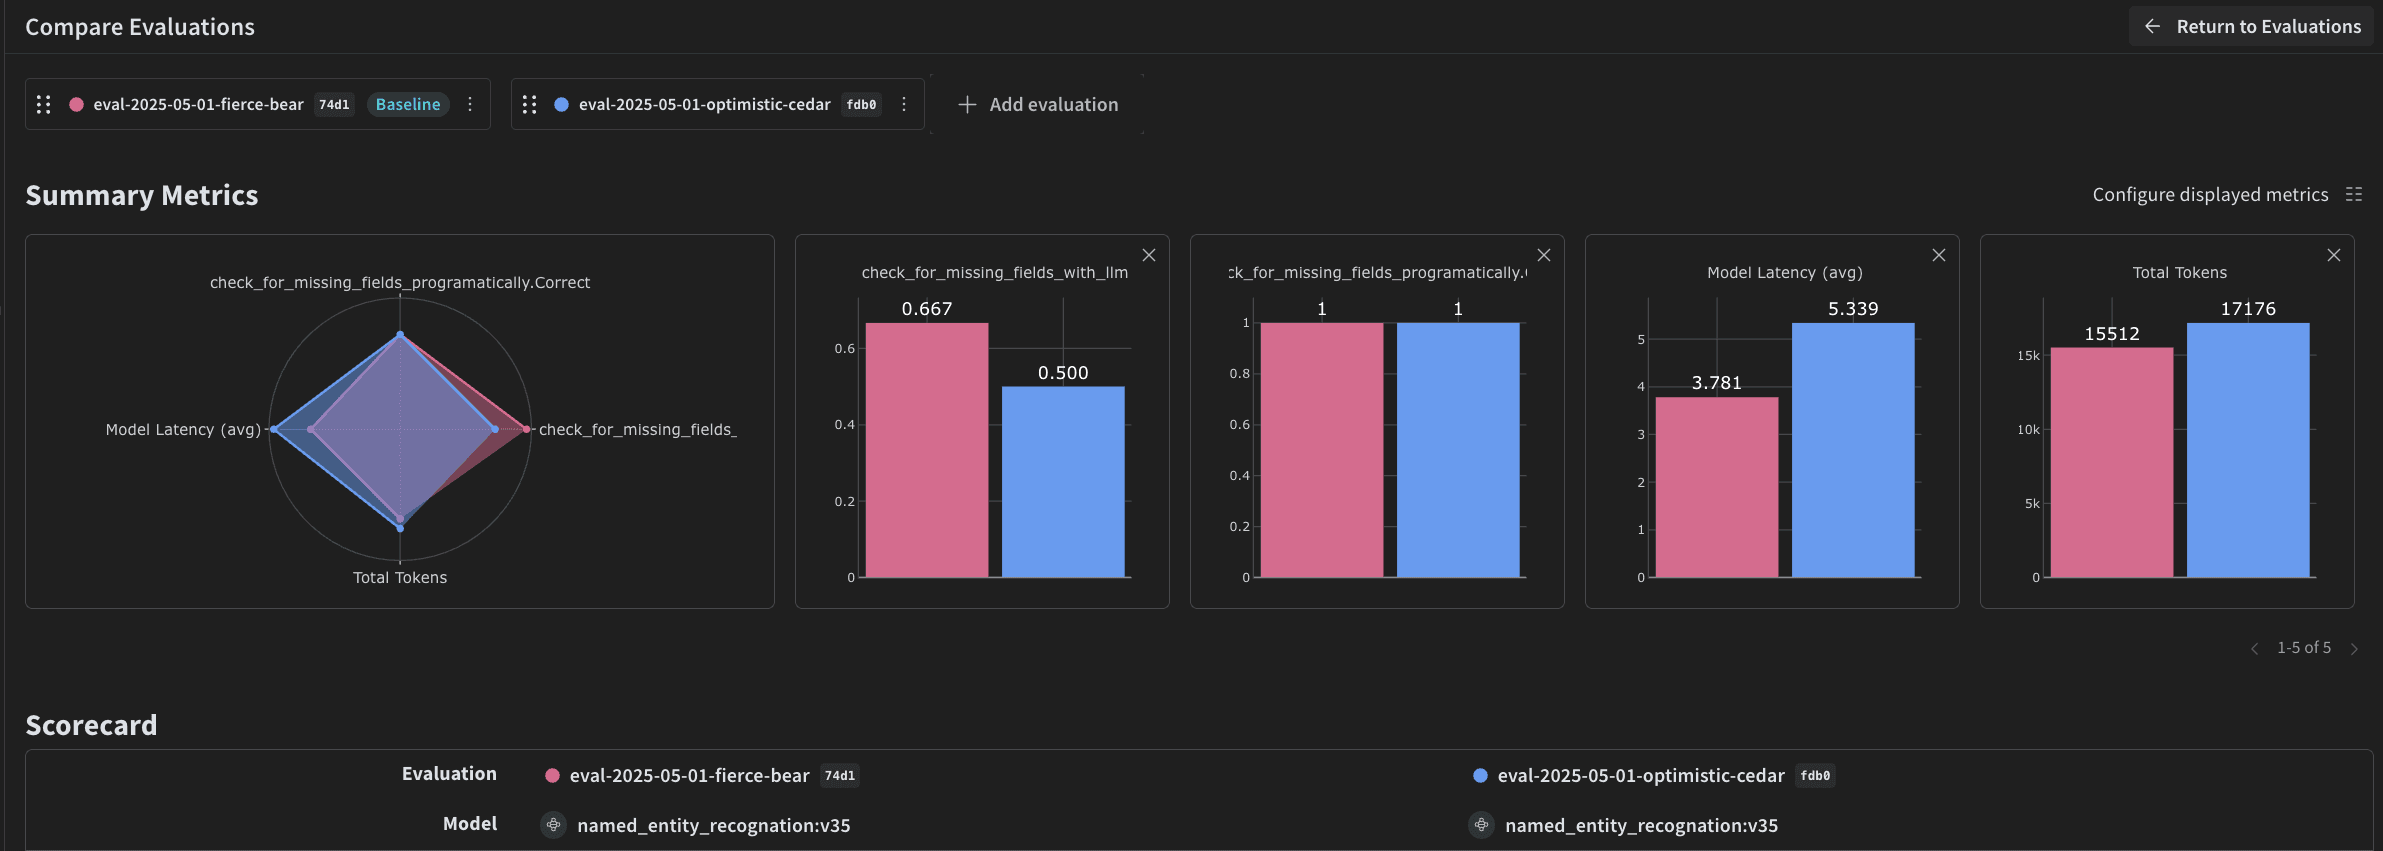
プログラムによるScorerは欠落したフィールドや空のフィールドしか検出しないため、抽出された値が画像内の情報と一致するかを確認するには、2 つ目のScorerが必要です。評価のこのステップでは、画像データとモデル出力の両方を提供し、評価が実際の NER パフォーマンスを反映するようにします。モデル出力だけでなく、画像の内容も明示的に参照します。 このステップで使用するScorercheck_for_missing_fields_with_llm は、LLM (具体的には OpenAI の gpt-4o) を使用して採点します。eval_prompt の内容で指定されているとおり、check_for_missing_fields_with_llm は Boolean 値を出力します。すべてのフィールドが画像内の情報と一致し、書式が正しい場合、Scorerは true を返します。いずれかのフィールドが欠落している、空である、誤っている、または一致しない場合、結果は false となり、Scorerは問題を説明するメッセージも返します。
評価を実行する
2 つの Scorer を定義したので、評価を実行できます。渡されたdataset を自動的にループ処理し、結果をまとめて Weights & Biases UI にログする評価 Call を定義します。
次のコードで評価を開始し、NER パイプラインのすべての出力に 2 つの Scorer を適用します。結果は Weights & Biases UI の Evals タブで確認できます。