

これはインタラクティブなノートブックです。ローカルで実行するか、以下のリンクを使用してください。
Weave を使用する理由
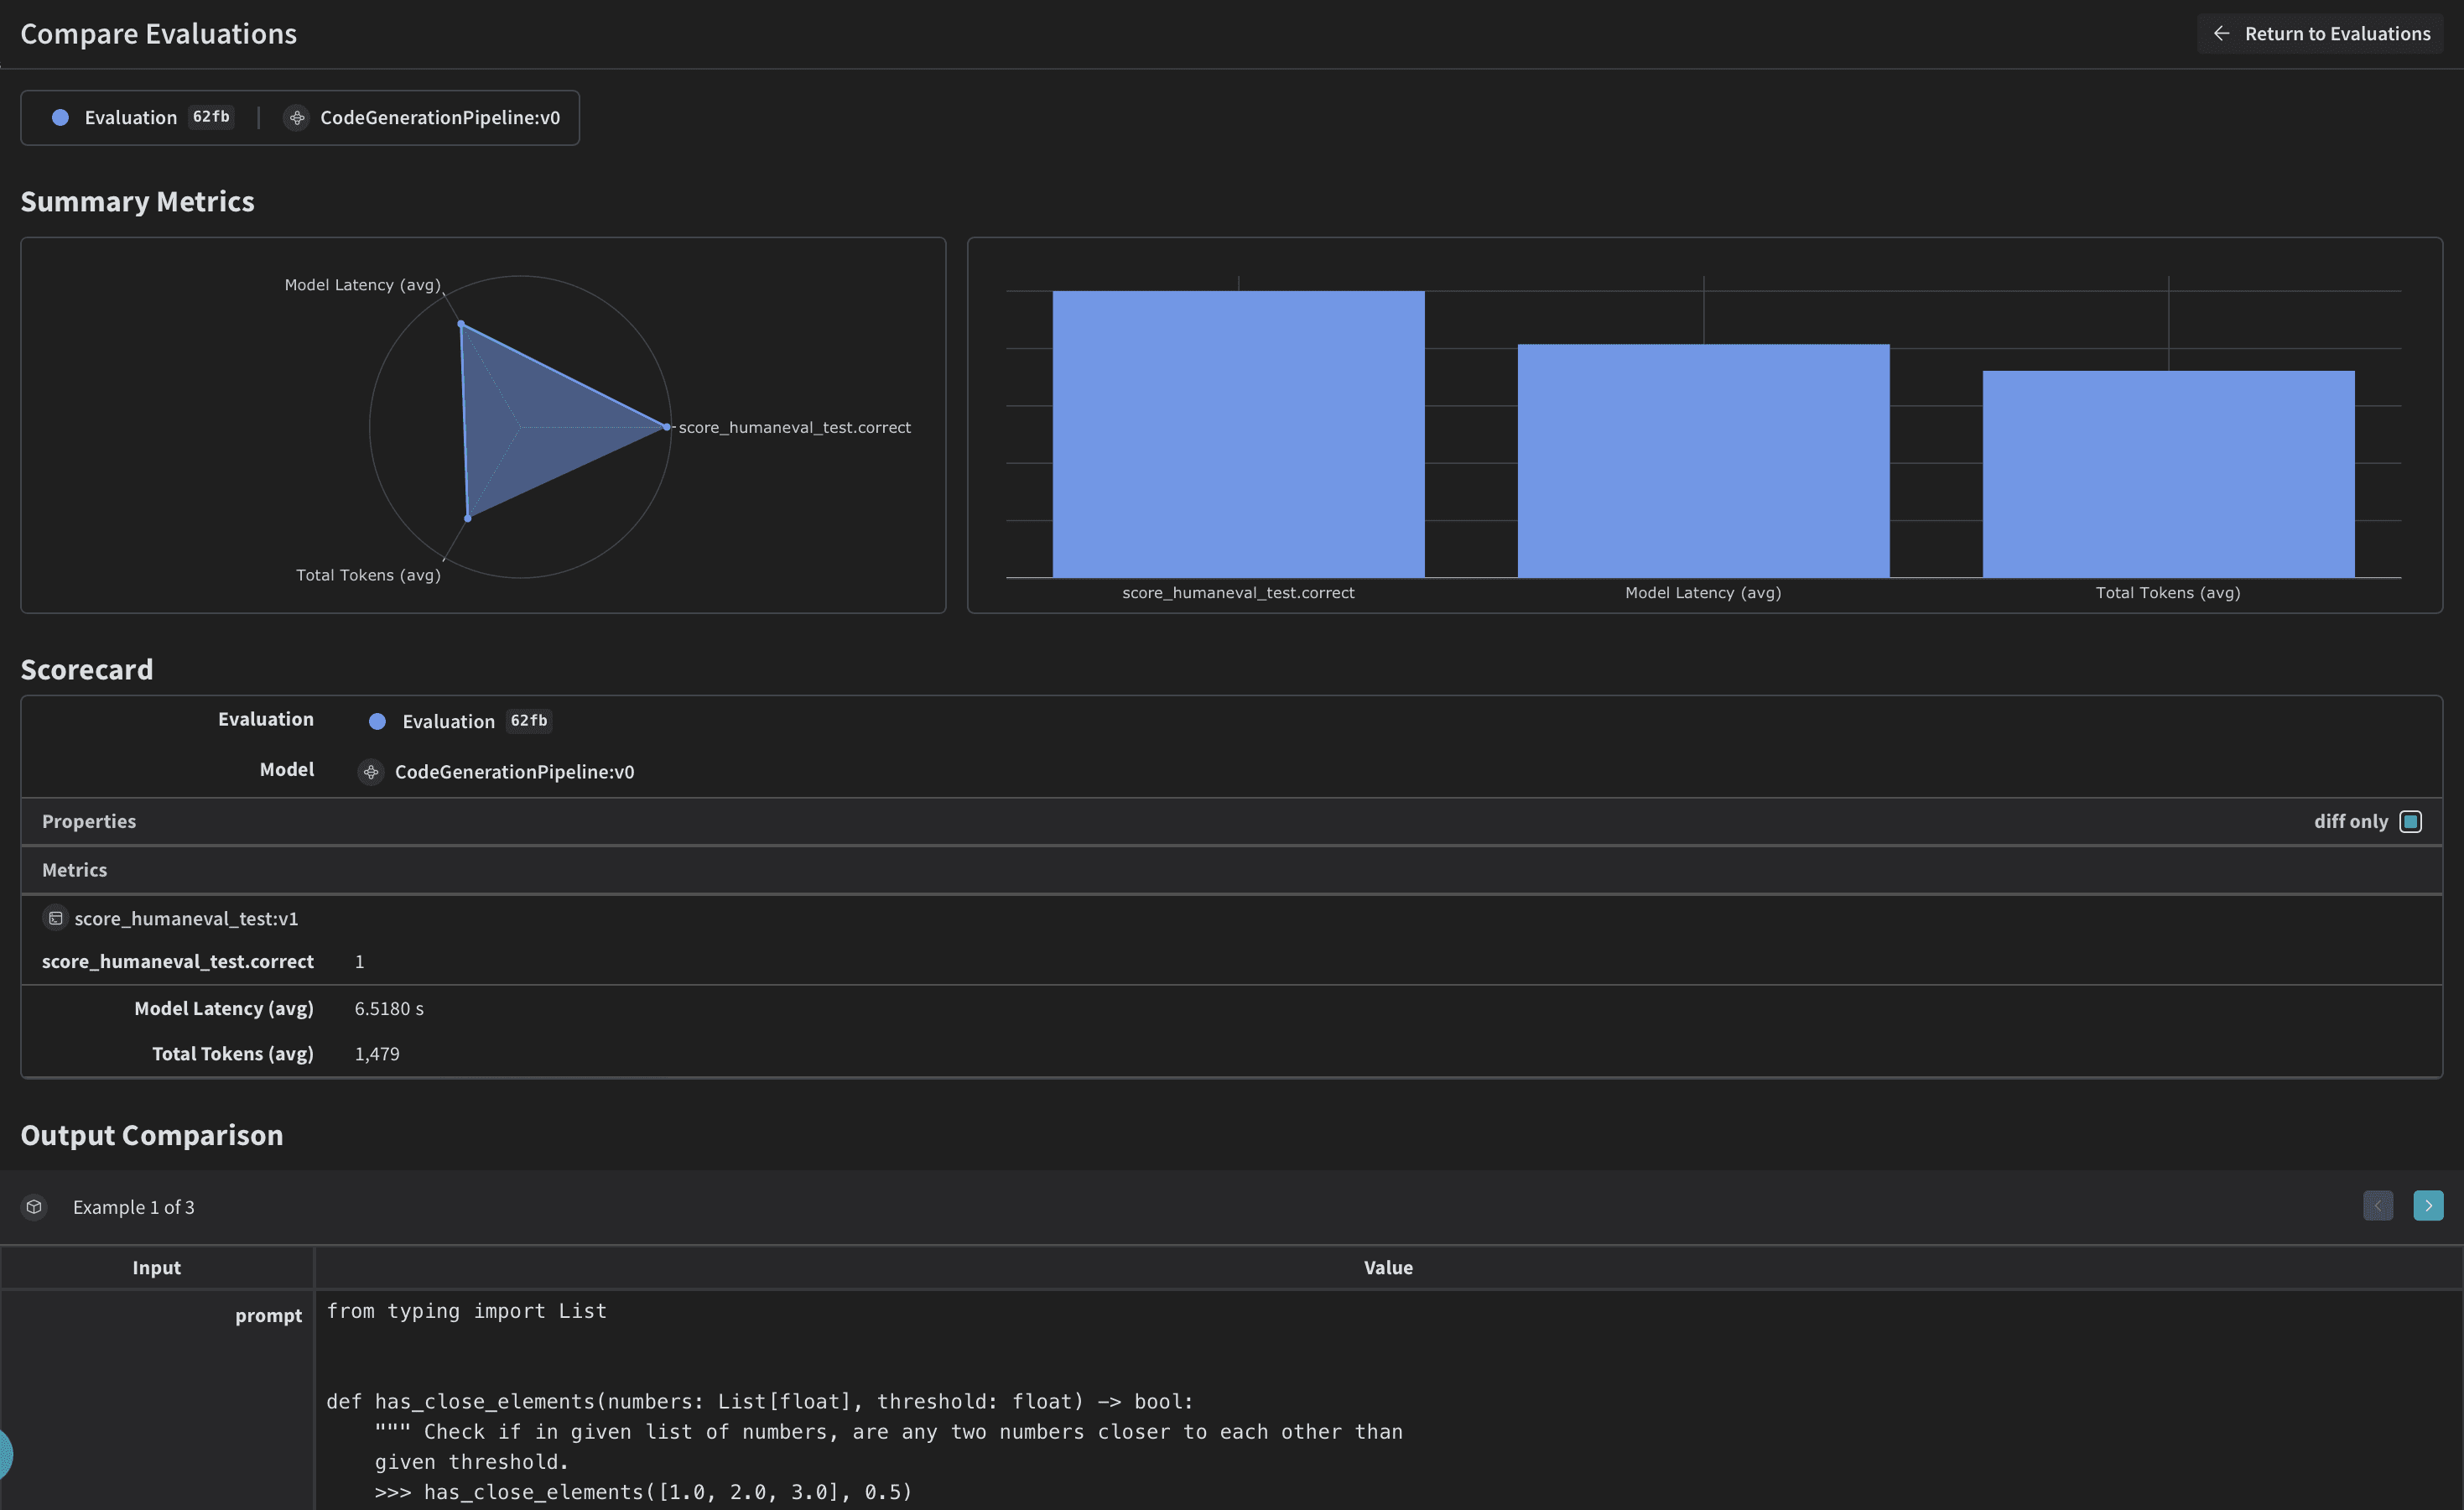
このチュートリアルでは、Weave を使用してコード生成パイプラインを実装し、評価します。このチュートリアルで学ぶ内容は次のとおりです。- LLM パイプラインをトラッキングする: コード生成プロセスの入力、出力、中間ステップをログします。
- LLM の出力を評価する: デバッグツールと可視化機能を使用して、生成されたコードの評価を作成し、比較します。
環境を設定する
環境を設定し、必要なライブラリをインポートします。これらの依存関係には、パイプライン全体で使用するフォーマット用ツール、データセットローダー、OpenAI クライアント、Weave クライアントが含まれます。Weave は OpenAI API の呼び出しを、入力、出力、メタデータを含めて自動的にトラッキングします。OpenAI とのやり取りをログするためのコードを別途追加する必要はありません。Weave がバックグラウンドで処理します。
構造化出力と Pydantic モデル
このコード生成パイプラインでは、OpenAI の 構造化出力モード と Pydantic モデルを使用して、一貫性があり適切な形式の応答を言語モデルから生成します。このアプローチには、次のような利点があります。- 型安全性: 期待される出力を Pydantic モデルとして定義することで、生成されるコード、プログラムランナー、ユニットテストに厳密な構造を適用できます。
- パースの容易さ: 構造化出力モードでは、モデルの応答が事前定義された Pydantic モデルに直接パースされるため、複雑な後処理がほとんど不要になります。
- 信頼性の向上: 期待する形式を厳密に指定することで、言語モデルが予期しない出力や不正な形式の出力を返す可能性を抑えられます。
コードフォーマッターを実装する
一貫性のある整ったコードを出力するために、Weave のオペレーションを使用してCodeFormatter クラスを実装します。このフォーマッターは、生成されたコード、プログラムランナー、ユニットテストにリンティングとスタイルのルールを適用します。
CodeFormatter クラスは、生成されたコードをクリーンアップして整形するための複数の Weave オペレーションを提供します。
- エスケープされた改行文字を実際の改行に置き換える
- 未使用のインポートと変数を削除する
- インポートを並べ替える
- PEP 8 に準拠した整形を適用する
- 不足しているインポートを追加する
CodeGenerationPipeline を定義する
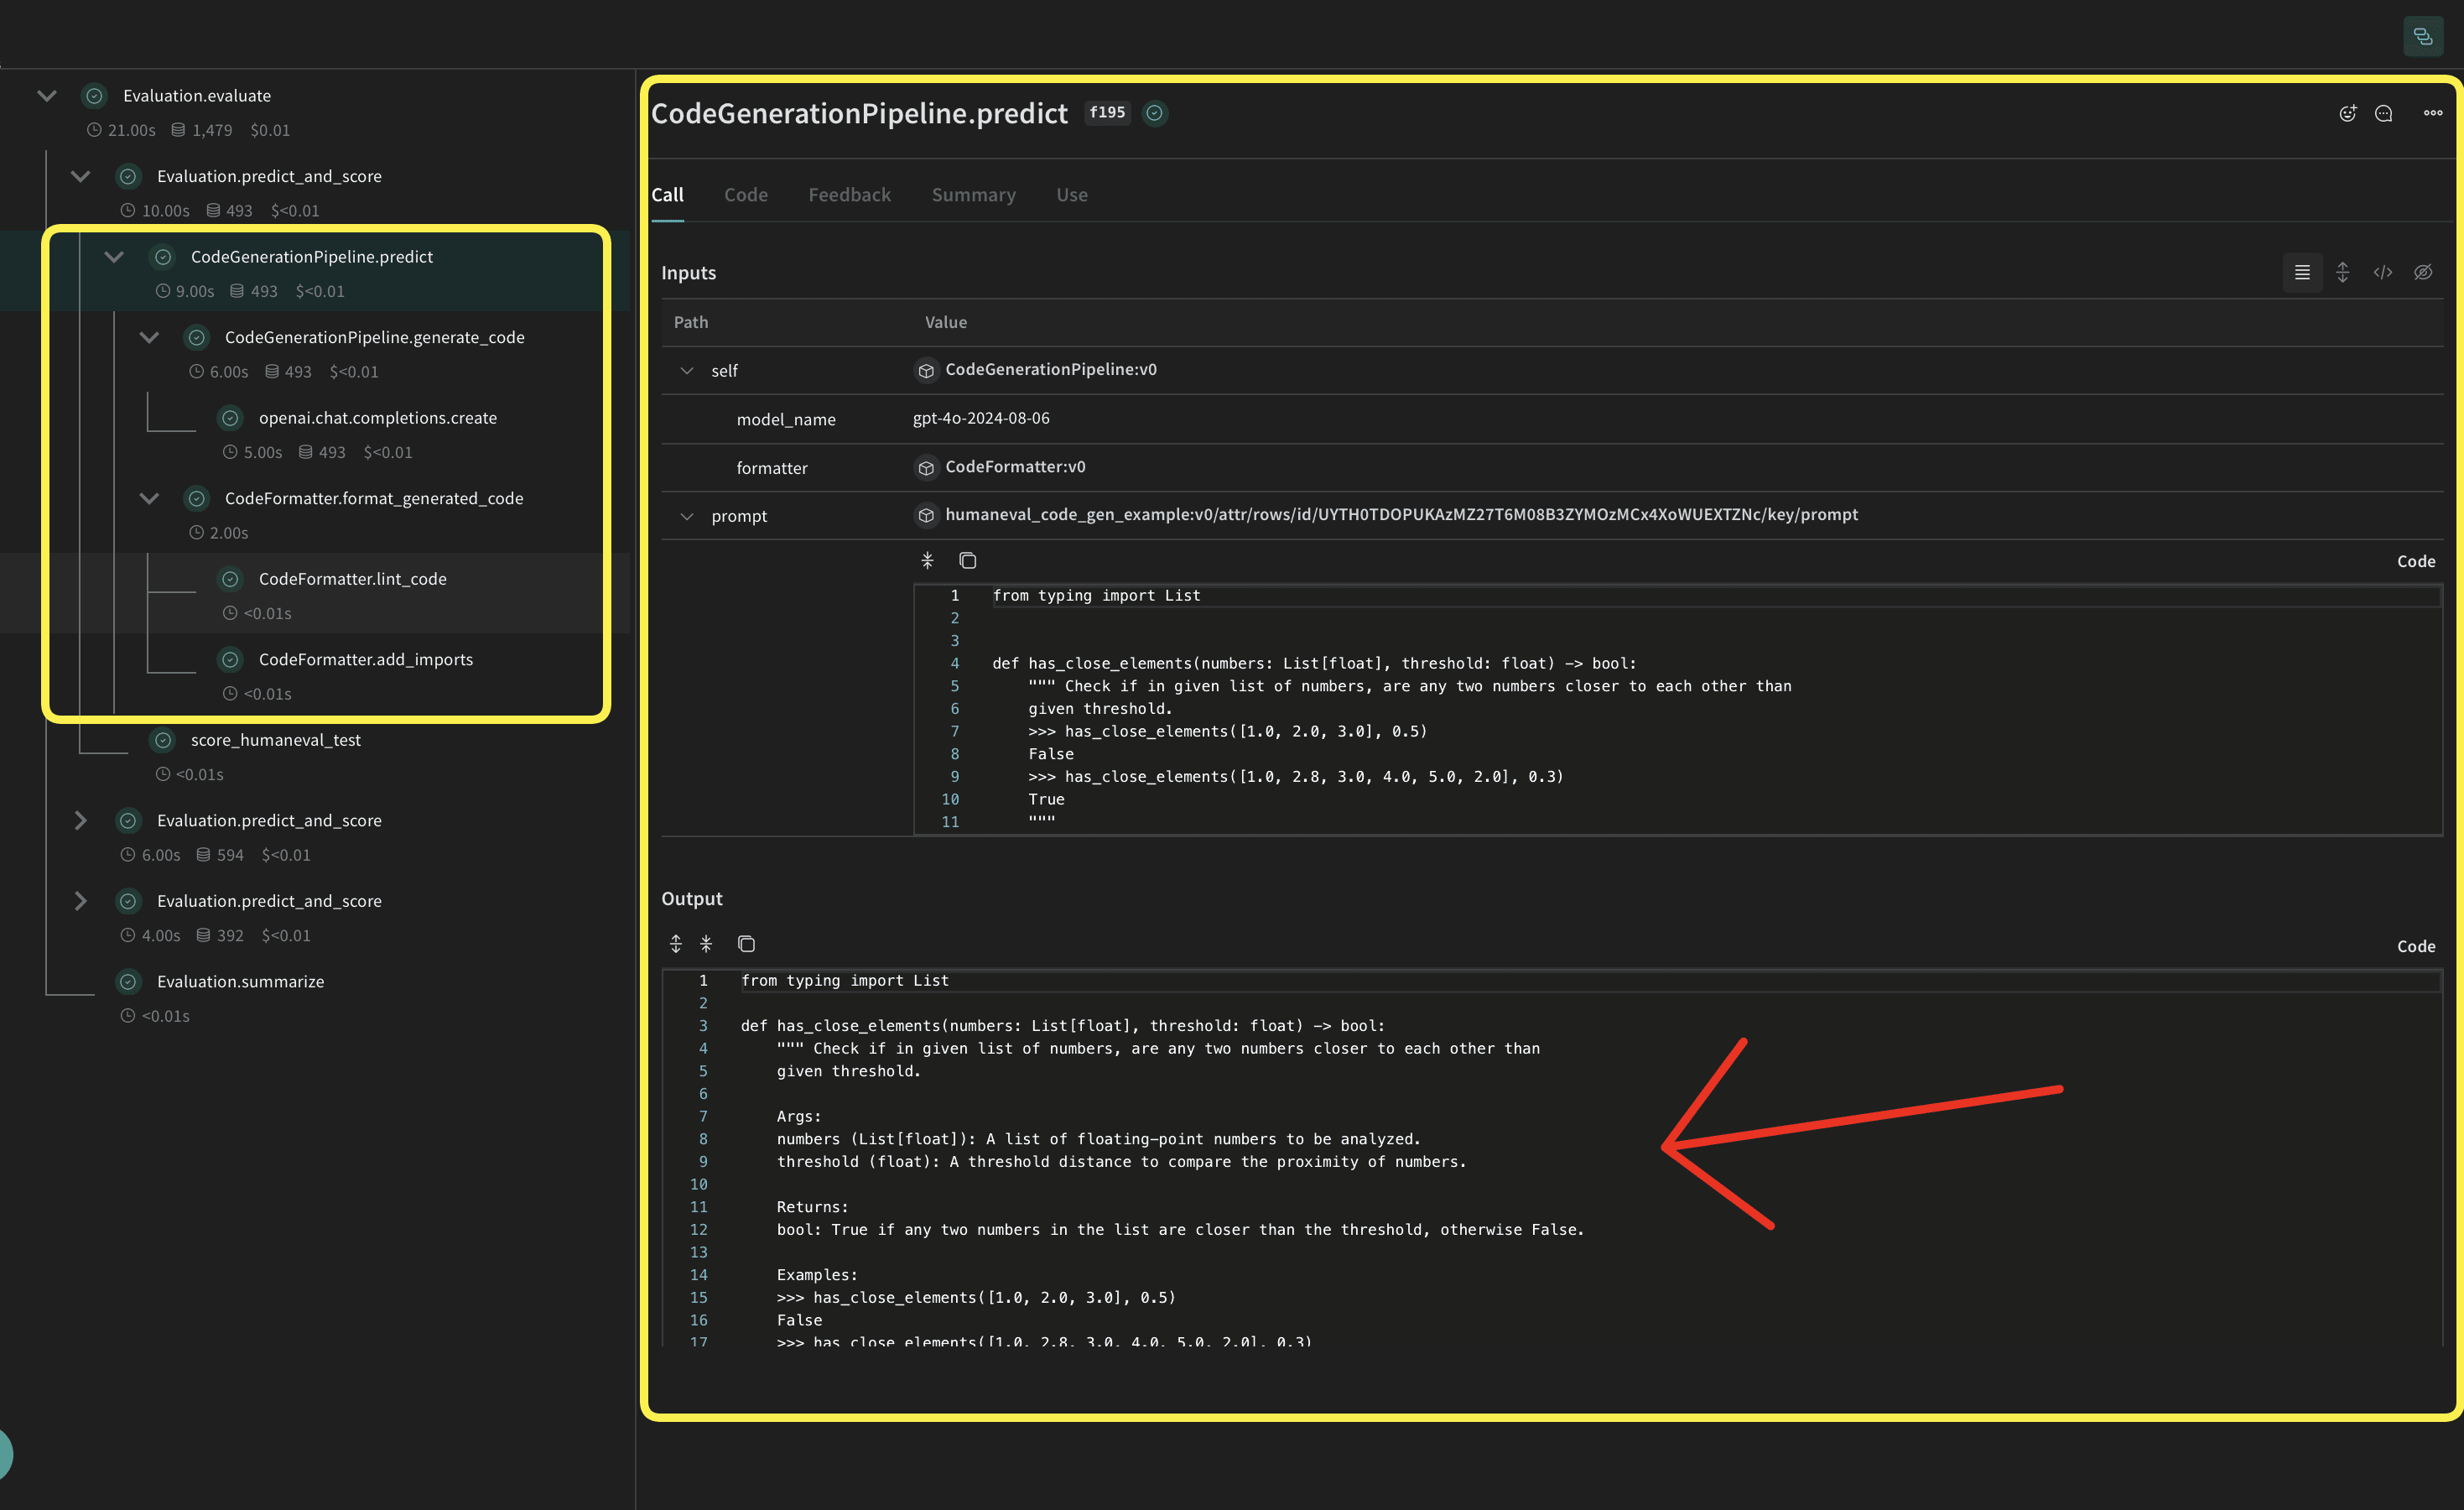
weave.Model を使用しているため、モデルに変更があると自動的にバージョン管理されます。model_name は属性として保持されるため、これを変えて実験し、Weave で差分を確認したり比較したりできます。関数の Call は @weave.op で追跡され、入力と出力がログされるため、エラーのトラッキングやデバッグに役立ちます。
CodeGenerationPipeline クラスは、コード生成ロジックを Weave モデルとしてカプセル化しており、次のような利点があります。
- 自動的な実験管理: Weave は、モデルの run ごとに入力、出力、パラメーターを取得します。
- バージョン管理: モデルの属性やコードへの変更は自動的にバージョン管理されるため、コード生成パイプラインの変遷を履歴として残せます。
- 再現性: バージョン管理とトラッキングにより、コード生成パイプラインの過去の任意の結果や設定を再現できます。
- ハイパーパラメーター管理: モデルの属性 (
model_nameなど) が定義され、異なる run 間で追跡されるため、実験を進めやすくなります。 - Weave エコシステムとのインテグレーション:
weave.Modelを使用すると、パイプラインを評価やサービング機能など、他の Weave ツールと連携できます。
評価メトリクスを実装する
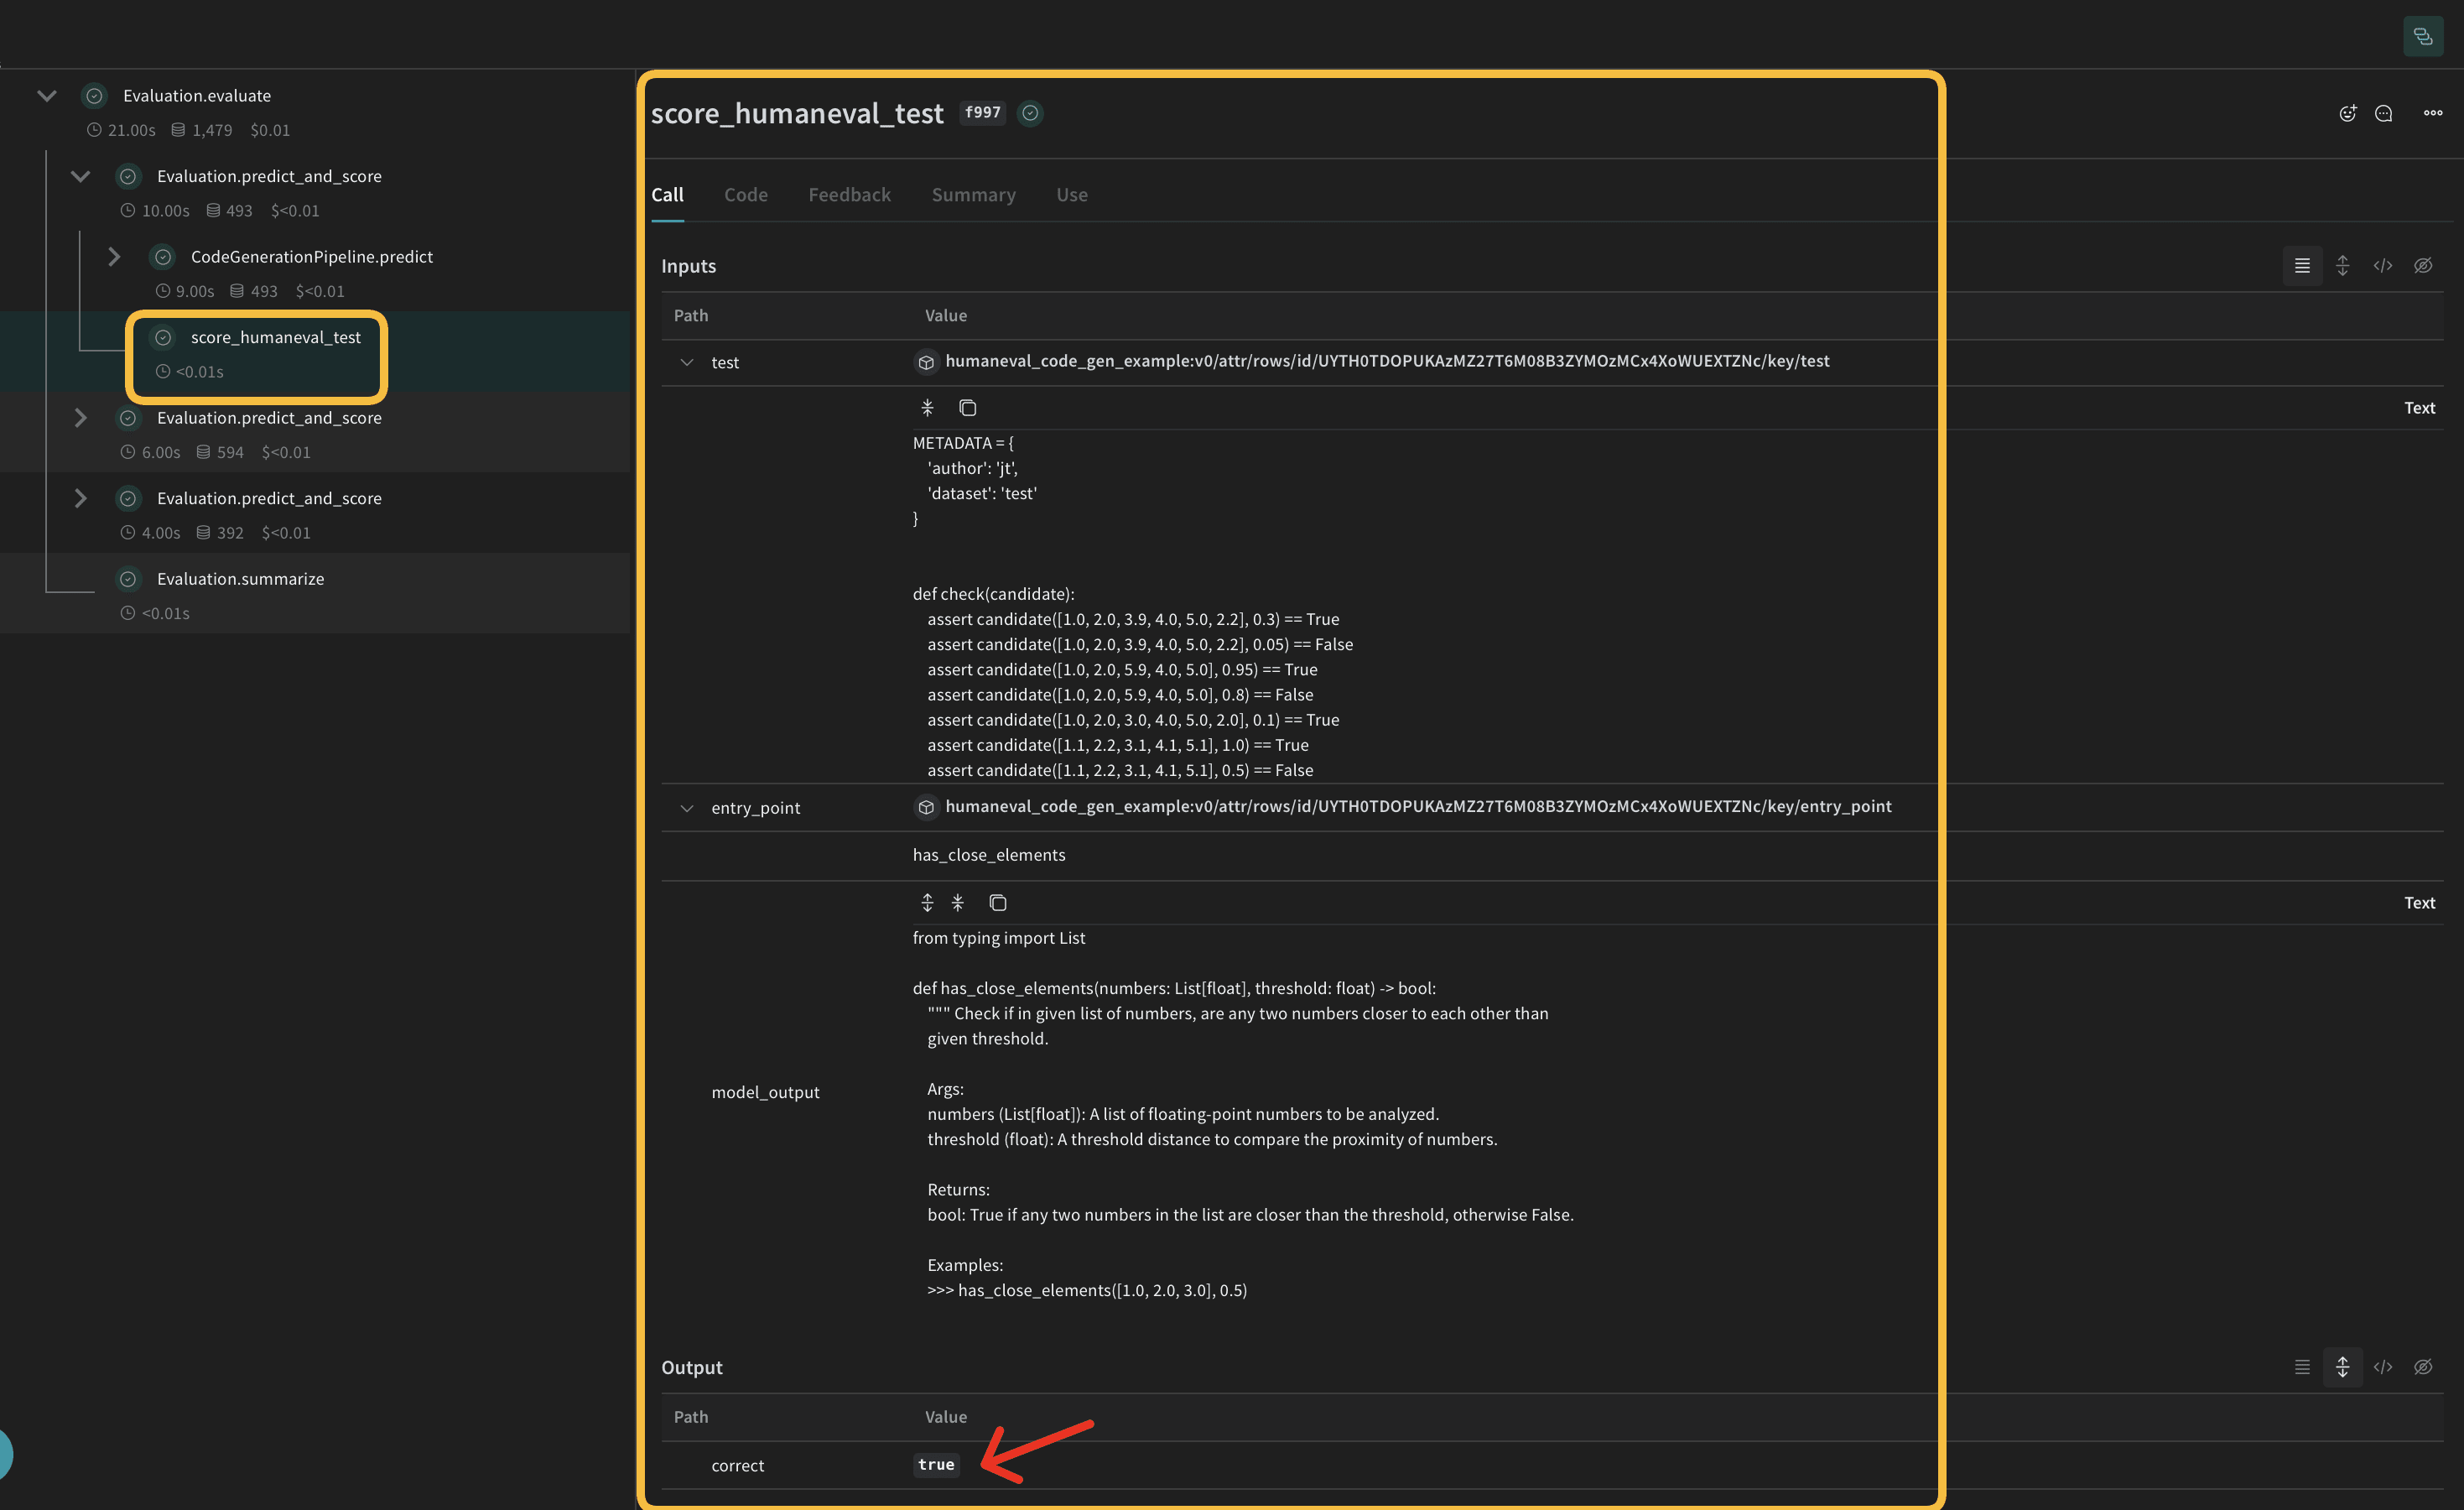
生成されたコードの品質を評価するには、weave.Scorer のサブクラスを使って評価メトリクスを実装します。このサブクラスは、データセット内のすべての model_output に対して score を実行します。model_output は weave.Model の predict 関数の出力です。prompt は human-eval データセットから取得します。
Weave Dataset を作成して評価を実行する
パイプラインと Scorer を定義したら、最後のステップとして評価用データセットを用意し、エンドツーエンドで評価を実行します。パイプラインを評価するには、次のように Weave Dataset を作成して評価を実行します。まとめ
この例では、Weave と OpenAI の言語モデルを使用してコード生成パイプラインを実装する方法を紹介しました。ここでは、次の方法を学びました。- コード生成プロセスの各ステップに対応する Weave のオペレーションを作成する。
- パイプラインを Weave モデルでラップし、トラッキングと評価を効率化する。
- Weave のオペレーションを使用して、カスタムの評価メトリクスを実装する。
- データセットを作成し、パイプラインの評価を実行する。