

- クイックアクセス: 新しいセッションの場合は Weave サイドバーメニューから プレイグラウンド を開き、既存の project の Call ページから開いてテストします。
- メッセージ操作: チャット内で直接メッセージを編集、再試行、または削除します。
- 柔軟なメッセージング: 新しいメッセージをユーザーまたはシステム入力として追加し、LLM に送信します。
- カスタマイズ可能な設定: 希望の LLM プロバイダを設定し、モデル設定を調整します。
- マルチ LLM サポート: モデルを切り替え、チームレベルの API キー管理を行います。
- モデルの比較: 異なるモデルがプロンプトにどのように応答するかを比較します。
- カスタムランタイム: カスタムモデルの OpenAI 互換 API エンドポイントをテストします。
- 保存済みモデル: ワークフロー用の再利用可能なモデルプリセットを作成および設定します。
- プロバイダーの認証情報と情報を追加する
- プレイグラウンド にアクセスする
- LLM を選択する
- Playground の Settings をカスタマイズする
- メッセージ操作
- LLM を比較する
- カスタムランタイム
- 保存済みモデル
プロバイダーの認証情報と情報を追加する
プレイグラウンドを使用する前に、プロバイダーの認証情報を追加する必要があります。これにより、プレイグラウンドは各モデルプロバイダーへのリクエストを代わりに認証できます。プレイグラウンドは多くのプロバイダーのモデルをサポートします。利用可能なモデルのいずれかを使用するには、W&B 設定のチームシークレットに適切な情報を追加する必要があります。- Amazon Bedrock:
AWS_ACCESS_KEY_IDAWS_SECRET_ACCESS_KEYAWS_REGION_NAME
- Anthropic:
ANTHROPIC_API_KEY - Azure:
AZURE_API_KEYAZURE_API_BASEAZURE_API_VERSION
- Deepseek:
DEEPSEEK_API_KEY - Google:
GEMINI_API_KEY - Groq:
GROQ_API_KEY - Mistral:
MISTRAL_API_KEY - OpenAI:
OPENAI_API_KEY - X.AI:
XAI_API_KEY
プレイグラウンドにアクセスする
プレイグラウンドには、2つの方法でアクセスできます。- デフォルトのシステムプロンプトで新しいプレイグラウンドページを開く: Weave プロジェクトのサイドバーで プレイグラウンド を選択します。プレイグラウンドが同じタブで開きます。
- 特定の Call のプレイグラウンドを開く:
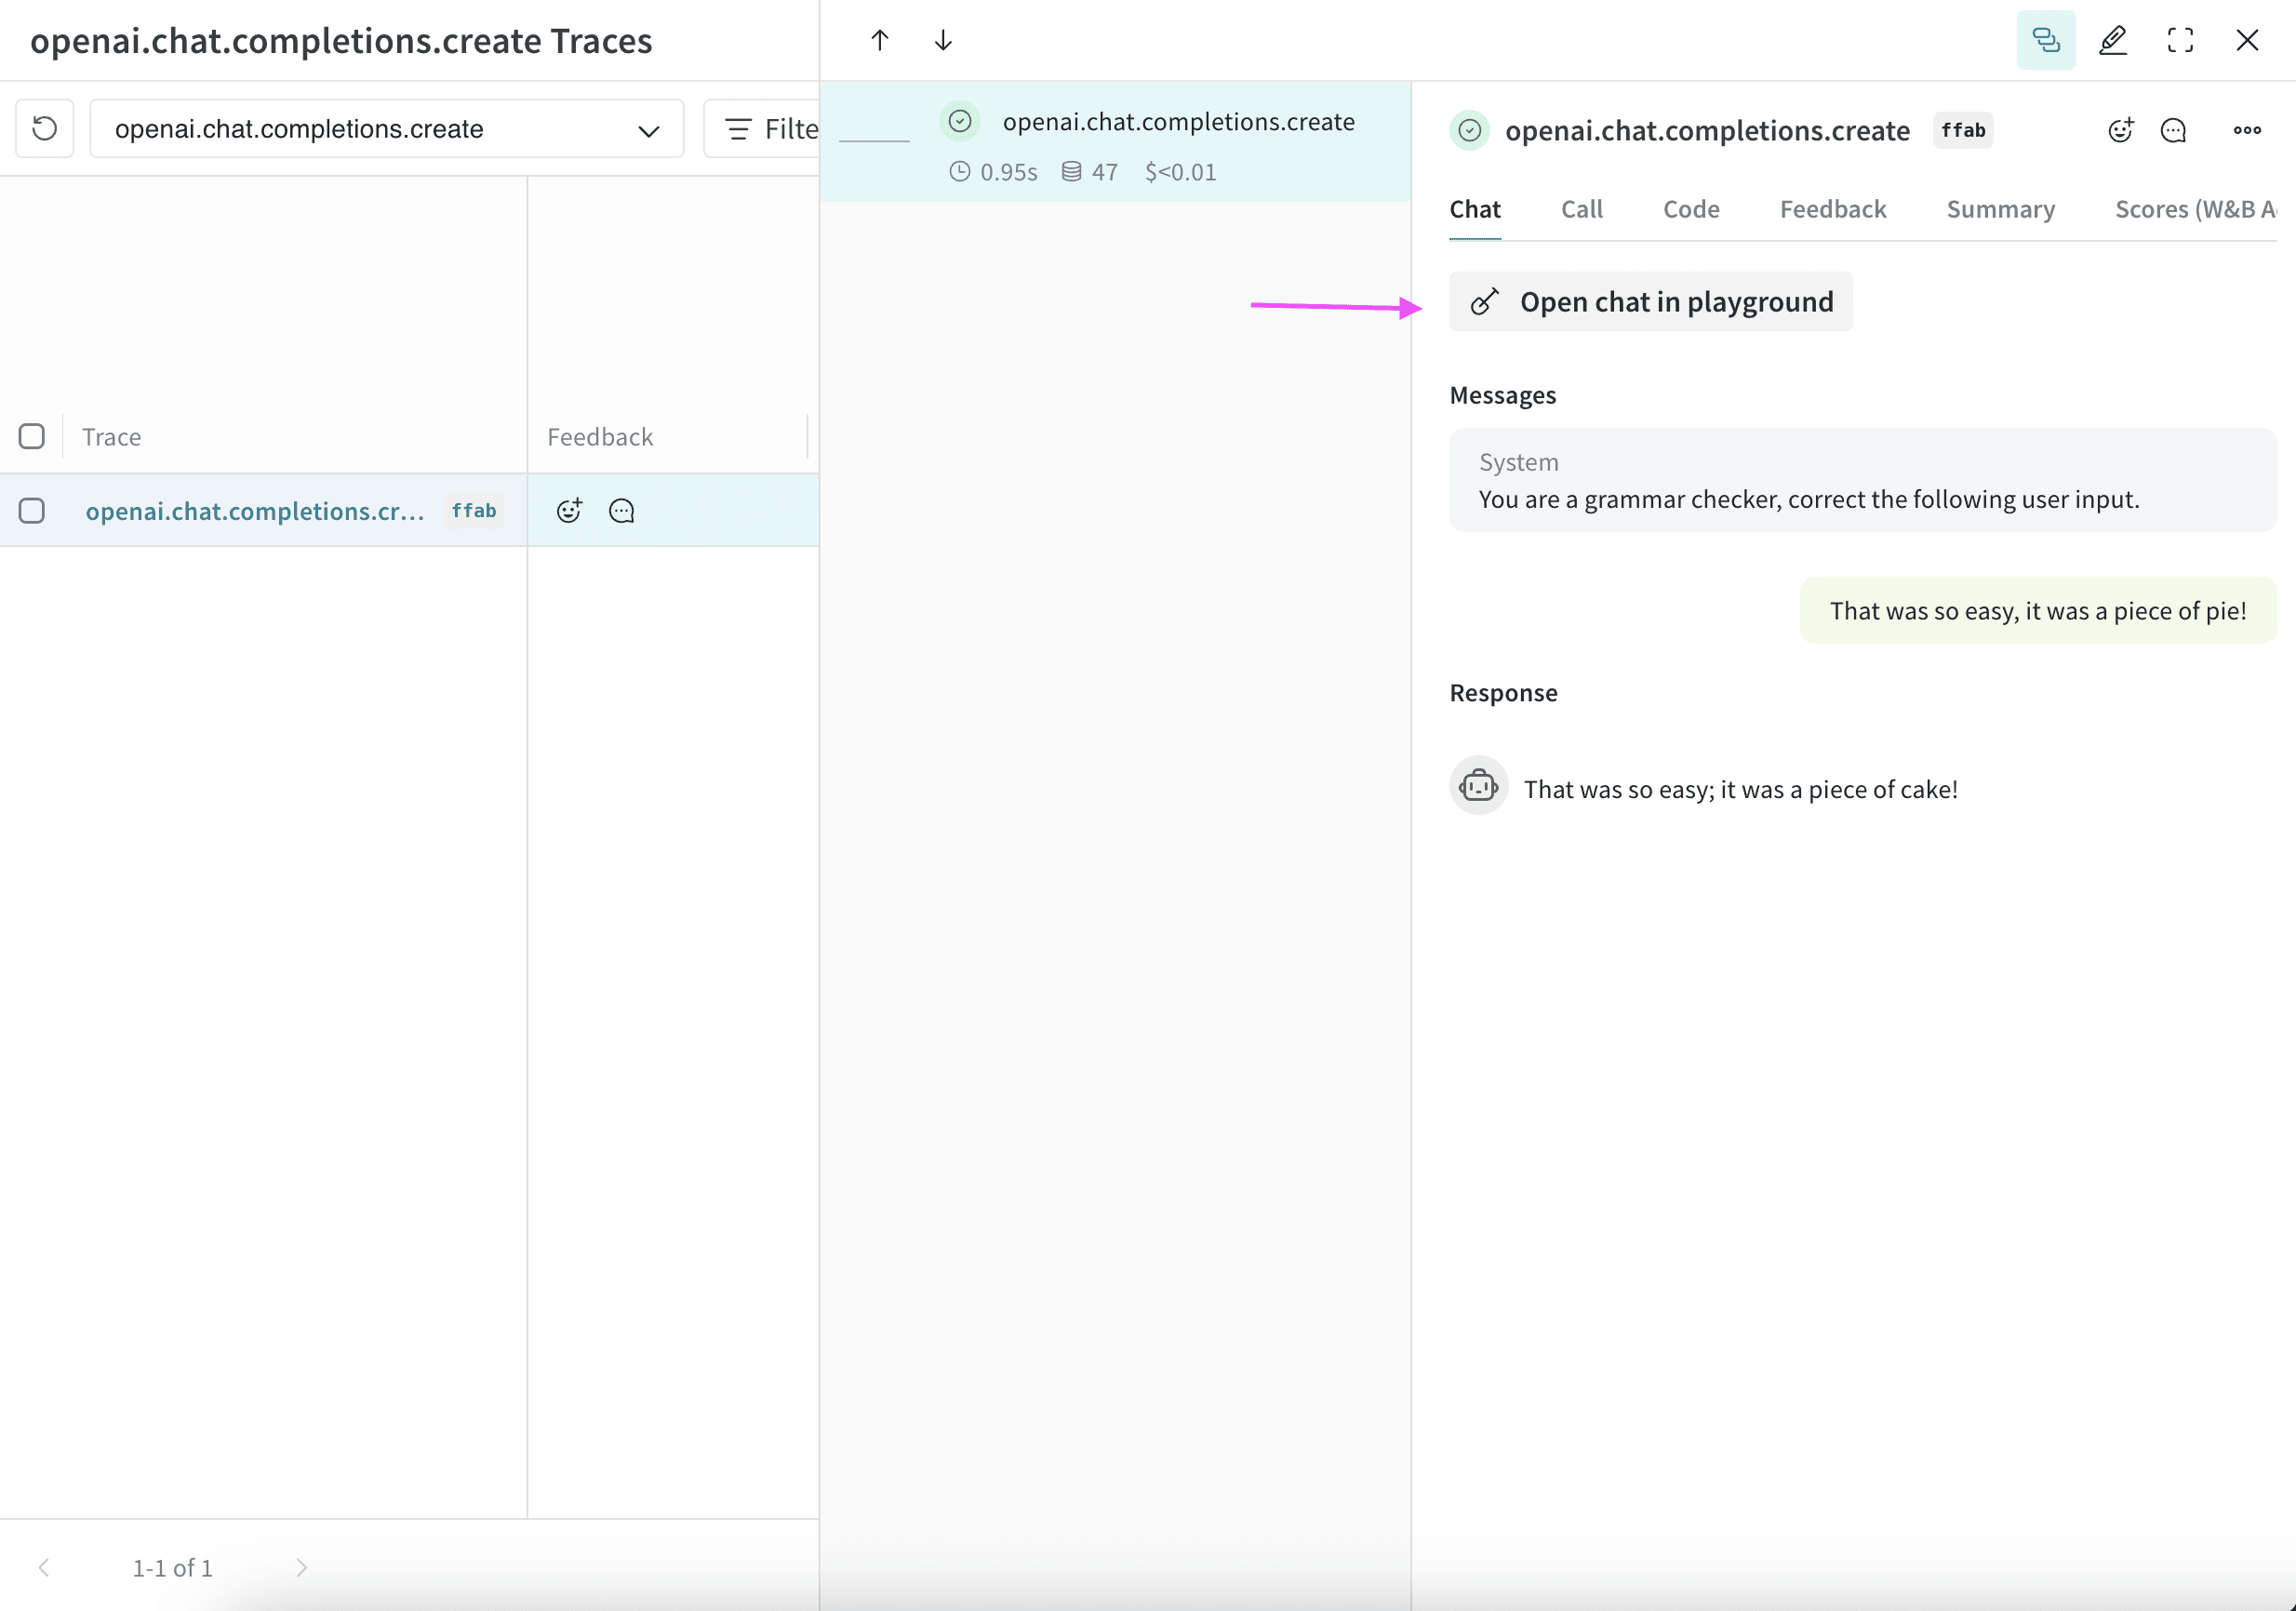
- サイドバーで トレース タブを選択します。トレースのリストが表示されます。
- トレースのリストで、表示したい Call の名前をクリックします。Call の詳細ページが開きます。
- プレイグラウンドでチャットを開く をクリックします。プレイグラウンドが新しいタブで開きます。
LLM を選択
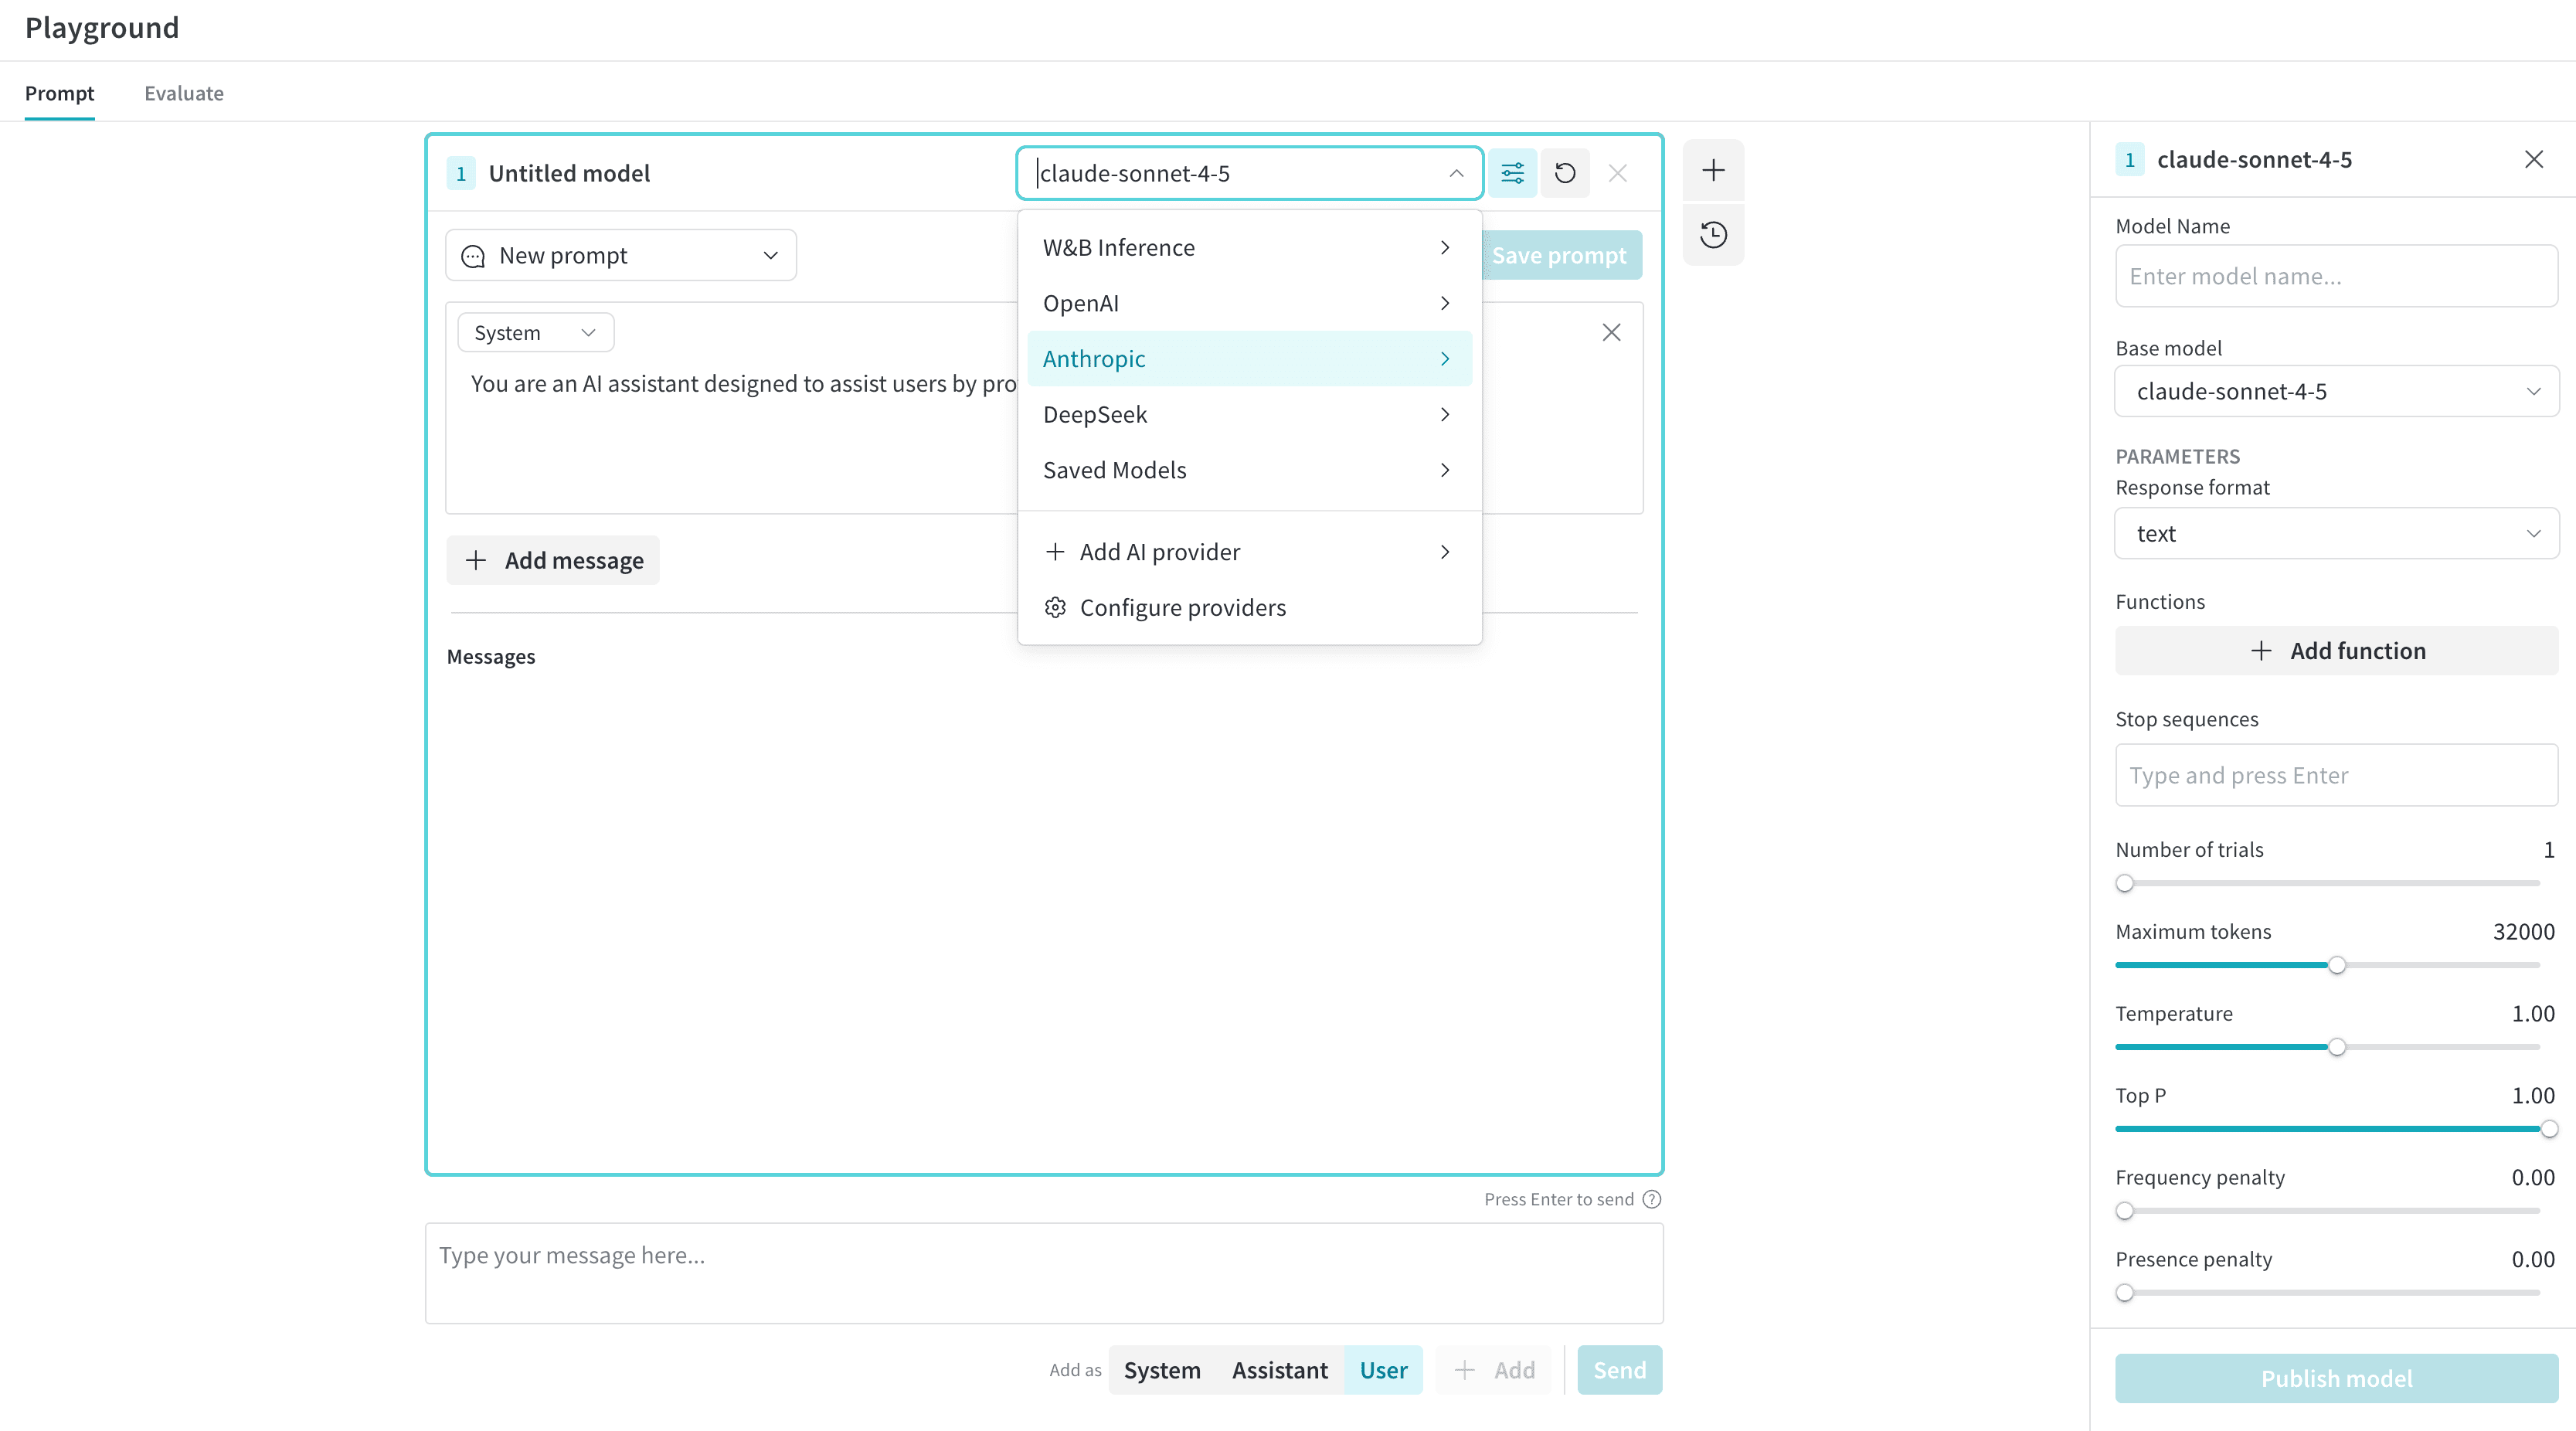
プロンプトヘッダー (メインのプレイグラウンドパネルの上部) にある Select a model ドロップダウンで LLM を切り替えられます。以下のプロバイダーが利用可能です:- Amazon Bedrock
- Anthropic
- Azure
- Deepseek
- Groq
- Mistral
- OpenAI
- X.AI
プレイグラウンド の Settings をカスタマイズする
選択したモデルのパラメーターを調整し、モデルが呼び出す関数を追加できます。以下のセクションでは、プレイグラウンド の Settings のカスタマイズ方法について説明します。LLM パラメーターを調整する
選択したモデルに対して異なるパラメーター値を試すことができます。プレイグラウンドでパラメーターを調整するには、次の手順を実行します。- プロンプトヘッダー (メインパネルの上部) で、Chat settings () ボタンをクリックして、Chat settings パネルを開きます。
- Chat settings パネルで、必要に応じてパラメーターを調整します。Weave Call トラッキングのオン/オフを切り替えたり、関数を追加したりすることもできます。
- 変更は自動的に適用されます。Chat settings をもう一度クリックするか、パネルの右上隅の x をクリックしてパネルを閉じます。Chat settings ボタンのホバーテキストには、変更した設定が表示されます。
ページを離れると、設定は失われます。設定を保存するには、モデルを保存します。変更した設定を破棄して最初からやり直す場合は、ページを更新してください。
1 です。試行回数を調整するには、Chat settings パネルを開き、Number of trials 設定を調整します。
関数を追加する
異なるモデルがユーザーから受け取る入力に基づいて、関数をどのように使用するかをテストできます。プレイグラウンドでテストする関数を追加するには、Chat settings パネルで + Add function をクリックします。画面の指示に従って関数を定義し、変更を保存します。メッセージ操作
プレイグラウンドのチャットインターフェースは、プロンプト定義エリア、メッセージパネル、メッセージコンポーザーの 3 つのエリアで構成されています。以下のセクションでは、各エリアについて説明します。プロンプト定義エリア
プロンプト定義エリア を使用すると、インタラクション全体を通じてモデルの動作を形作る指示を定義できます。 このエリアを使用して、メッセージが交換される前に一貫して適用されるコンテキストを提供します。これにはロールの定義、トーンとスタイルのガイダンス、動作の制約、出力要件が含まれます。ここで行った変更は、変更しない限り以降のすべてのインタラクションに影響します。 以下が含まれます。- Prompt selector: 既存の保存済みプロンプトを選択するか、新規に作成します。
- Message role selector: 定義するメッセージのロールを指定します (システム、アシスタント、またはユーザーロール) 。
- Prompt text: モデルが応答する方法を確立する指示テキストを入力します。
- Add message ボタン: 実行前にプロンプトコンテキストに追加のメッセージを含めることができます。
- 補足的なシステムレベルの指示を追加する。
- 応答をガイドするアシスタント メッセージの例を提供する (few-shot プロンプティングなど) 。
- 特定のシナリオをテストするためのユーザーメッセージを事前定義する。
メッセージパネル
メッセージパネル は、実行中に生成された会話を表示します。 以下が含まれます。- プロンプトのセットアップに含まれる事前定義されたメッセージ。
- メッセージコンポーザーから送信されたメッセージ。
- モデルから返された応答。
メッセージコンポーザー (入力フィールド)
メッセージコンポーザー を使用して、モデルに新しいメッセージを送信します。 メッセージのロールを選択したり、メッセージを送信して実行したりできます。ほとんどのインタラクションは ユーザー メッセージとして作成されます。指示の変更をテストする際には、システム または アシスタント メッセージを追加できます。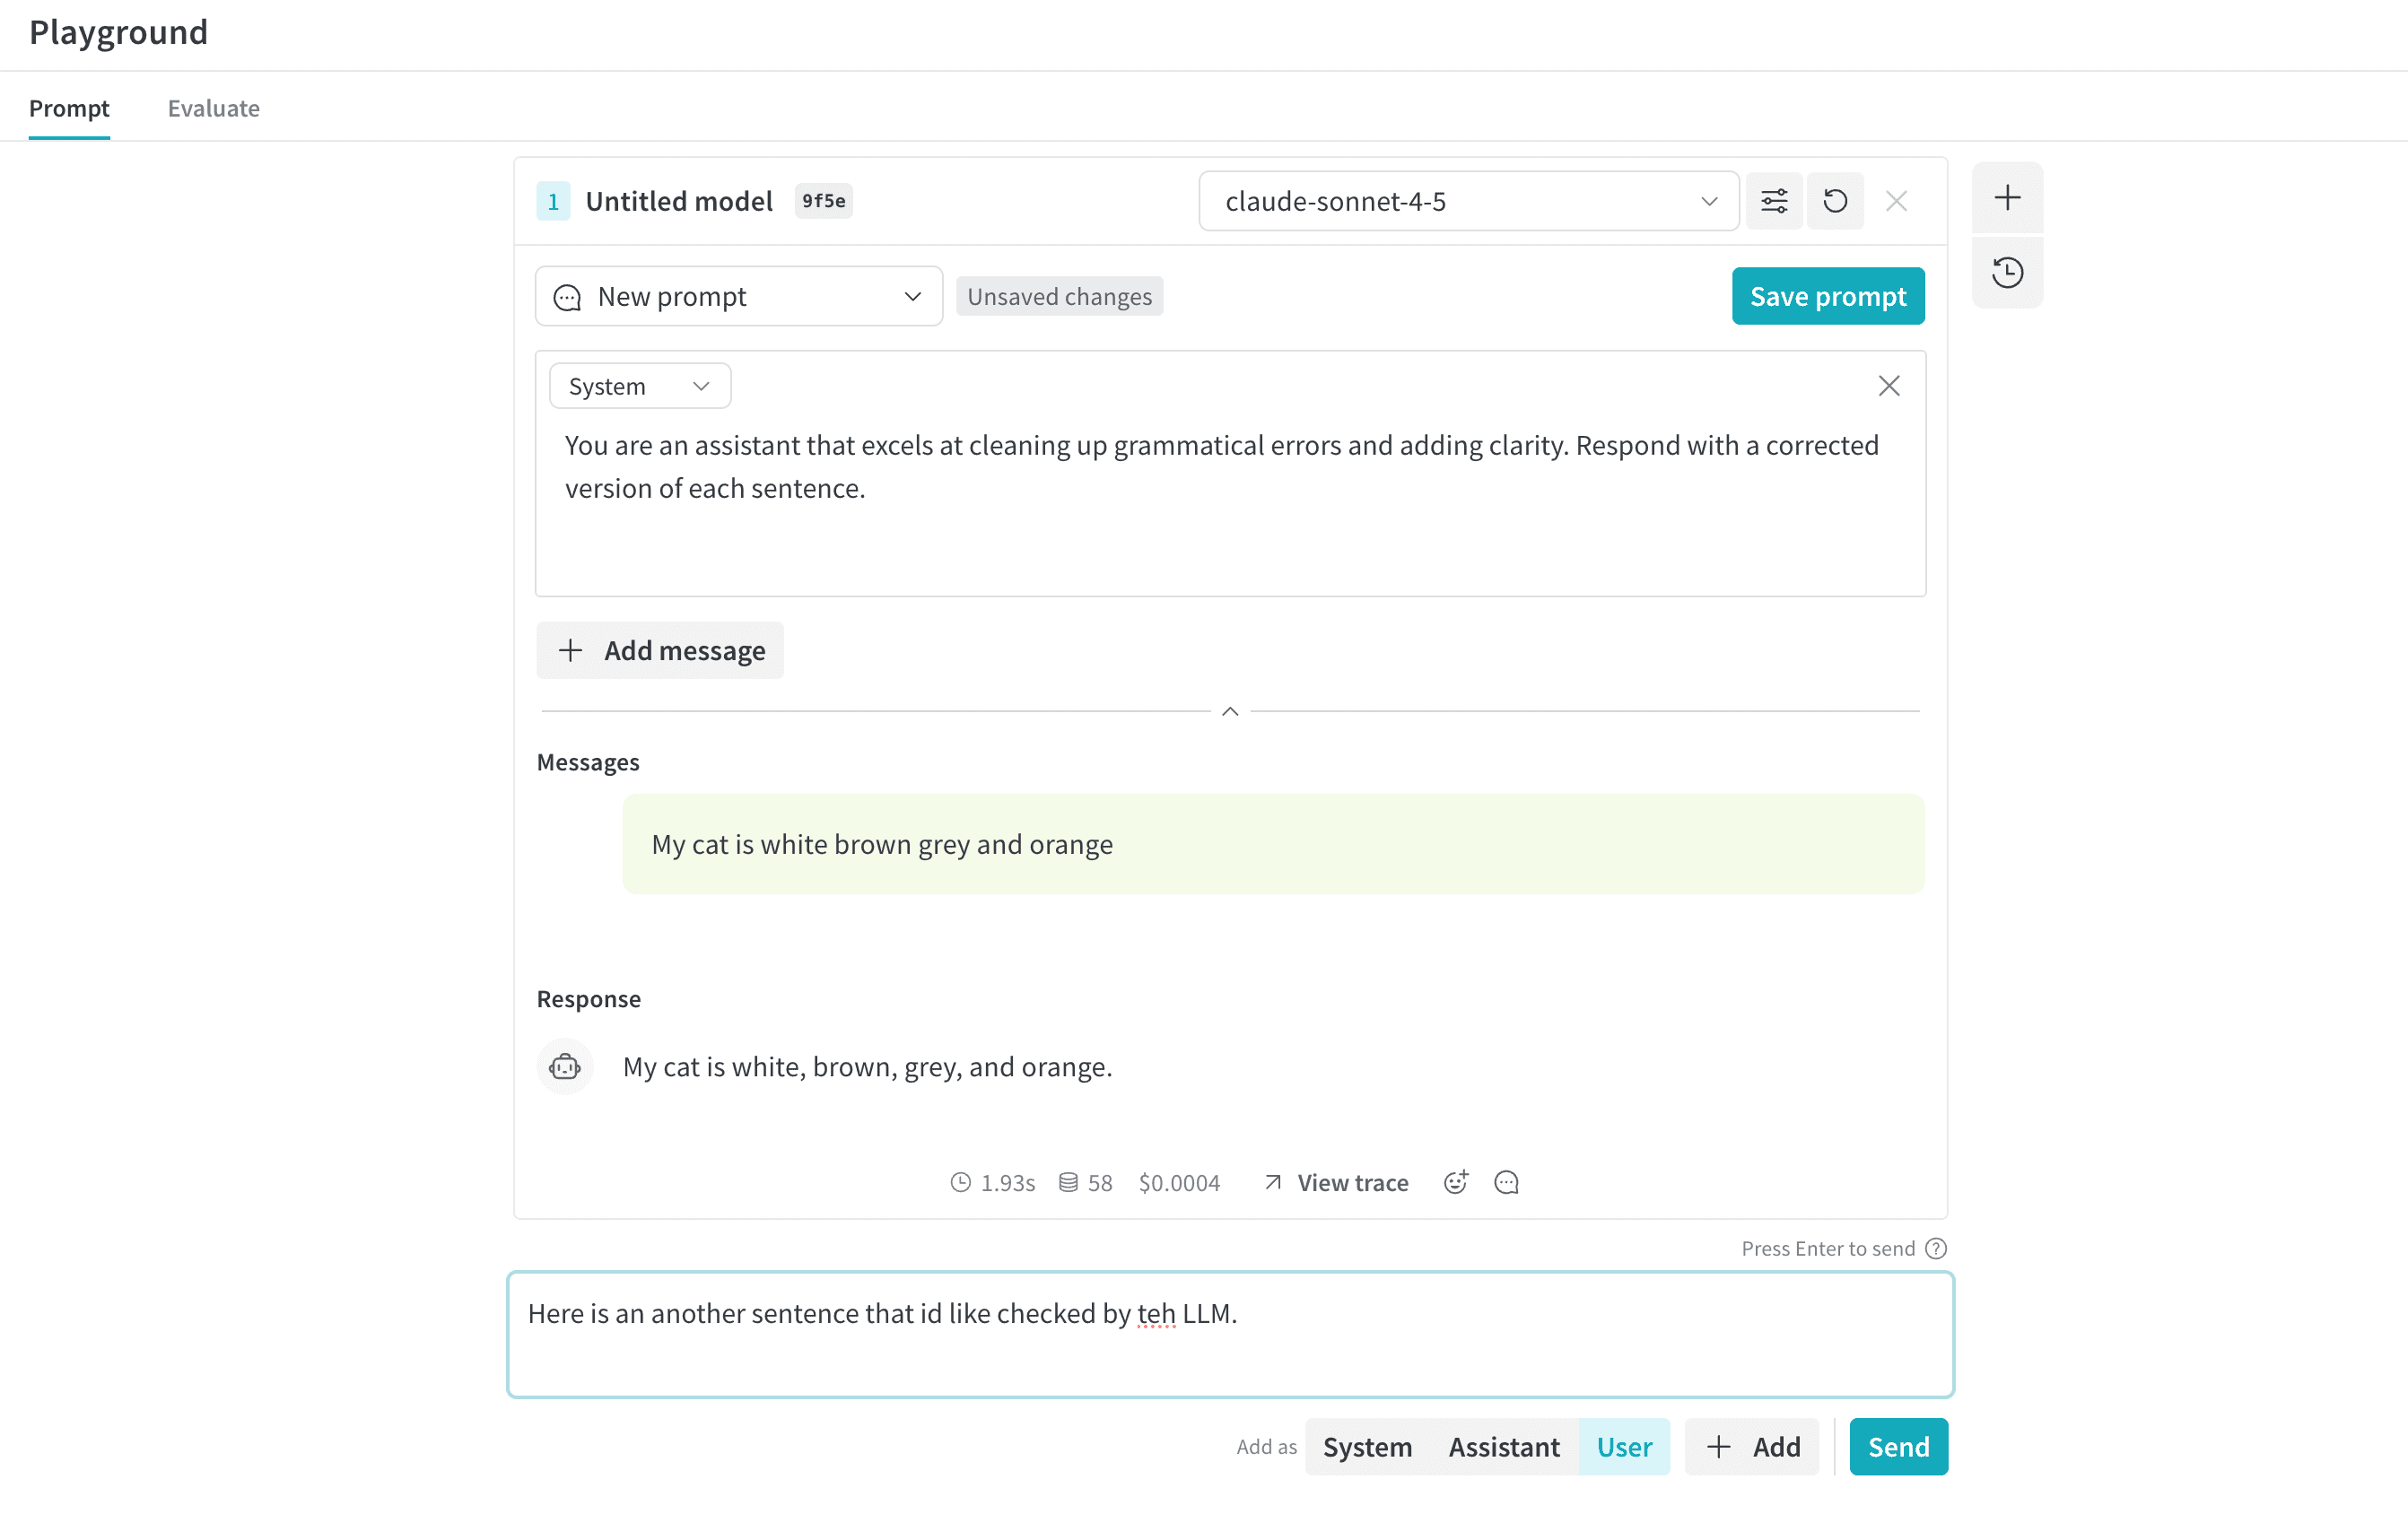
メッセージ履歴を表示
メッセージ履歴を表示するには、右側のプレイグラウンドのツールバーにある 履歴 () ボタンをクリックします。これにより、現在の project に送信されたすべてのメッセージを表示する履歴パネルが開きます。 履歴から項目を選択すると、比較用の追加のチャットパネルに読み込まれます。LLM を比較する
プレイグラウンドでは、LLM を並べて比較できるため、同じプロンプトに対して異なるモデルがどのように応答するかを評価できます。比較を行うには、右側のプレイグラウンドツールバーの チャットを追加 () ボタンをクリックします。元のチャットの横に 2 番目のチャットが開きます。2 番目のチャットには、モデルの選択、設定の調整、関数の追加など、元のチャットと同じ機能があります。カスタムランタイム
組み込みのプロバイダーに加えて、プレイグラウンドはカスタムランタイムをサポートします。これは、project に登録する OpenAI 互換 API エンドポイントです。カスタムランタイムは以前 custom providers と呼ばれていました。チームが提供するエージェントのプロトタイプ、ローカルモデル、またはサポートされるプロバイダーの古いバージョンのモデルなどのモデルをテストするためにカスタムランタイムを使用します。 UI または Python SDK でカスタムランタイムを登録する方法については、カスタムランタイム を参照してください。カスタムランタイムを登録すると、Select a model ドロップダウンからそのモデルを選択し、標準のプレイグラウンド機能を使用してテストできます。ローカルモデルをカスタムランタイムとして使用する
プレイグラウンドでローカルで実行中のモデルをテストするには、ngrok と Ollama を使用して一時的な公開 URL を作成し、CORS 制限を回避します。これにより、ブラウザーのセキュリティポリシーに違反することなく、独自のマシンで実行中のモデルにプレイグラウンドからアクセスできます。 セットアップするには、次の手順を実行します。- お使いのオペレーティングシステム向けに ngrok をインストールします。
-
Ollama モデルを起動します。実行する Ollama モデルの名前に置き換えて
[MODEL]を指定してください。 -
別のターミナルで、必要な CORS ヘッダーを指定して ngrok トンネルを作成します。
-
ngrok が起動すると、
https://xxxx-xxxx.ngrok-free.appのような公開 URL が表示されます。この URL を、カスタムランタイムを登録する 際の ベース URL として使用してください。
保存済みモデル
保存済みモデルを使用すると、プロバイダー、モデル、パラメーター、関数のフックを再利用可能なプリセットとして保存できます。以下のセクションでは、モデルの保存、使用、更新方法について説明します。モデルを保存する
再利用可能なモデルプリセットを作成して、ワークフローに合わせて設定できます。モデルを保存すると、好みの設定、パラメーター、関数フックをすばやく読み込めます。- プロンプトヘッダー (メインパネルの上部) で、Select a model ドロップダウンからプロバイダーとモデルを選択します。
- プロンプトヘッダーで、Chat settings () ボタンをクリックして Chat settings パネルを開きます。
- Chat settings パネルで:
- Model Name (必須): 保存済みモデルの名前を入力します。
- パラメーターを希望通りに調整します。Weave Call トラッキングのオン/オフを切り替えたり、関数を追加したりすることもできます。
- Publish model をクリックします。モデルは保存され、Select a model ドロップダウンの Saved Models からアクセスできるようになります。その後、保存済みモデルを使用したり、更新したりできます。
保存済みモデルを使用する
以前に保存済みモデルに切り替えて、実験やセッション全体で一貫性を維持します。これにより、以前の状態から再開できます。- プロンプトヘッダーで、Select a model ドロップダウンから Saved Models を選択します。
- 保存済みモデルのリストから、読み込みたい保存済みモデルを選択します。モデルが読み込まれ、プレイグラウンドで使用する準備が完了します。
保存済みモデルの更新
既存の 保存済みモデル を編集してパラメーターをファインチューンしたり、設定を更新したりできます。これにより、保存済みモデルはユースケースに合わせて進化します。- プロンプトヘッダーの Select a model ドロップダウンで Saved Models を選択します。
- 保存済みモデルの一覧から、更新したい保存済みモデルを選択します。
- プロンプトヘッダーで Chat settings () ボタンをクリックし、Chat settings パネルを開きます。
- Chat settings パネルで、必要に応じてパラメーターを調整します。Weave Call トラッキングをオンまたはオフに切り替えたり、関数を追加したりすることもできます。
- Update model をクリックします。これによりモデルが更新され、Select a model ドロップダウンの Saved Models からアクセスできるようになります。保存済みモデルのバージョンは自動的に増分されます。