

これはインタラクティブなノートブックです。ローカルで実行するか、以下のリンクを使用してください。
Chain of Density 要約とは
 Chain of Density (CoD) は、要約を反復的に洗練し、より簡潔で情報密度の高い要約を生成する手法です。仕組みは次のとおりです。
- 最初の要約を作成します
- 重要な情報を保持しつつ、要約がより簡潔になるよう反復的に改良します
- 反復のたびに、エンティティや技術的な詳細の密度を高めます
Weave を使用する理由
このチュートリアルでは、Weave を使用して ArXiv 論文向けの Chain of Density 要約パイプラインを実装し、評価します。このチュートリアルで学ぶ内容は次のとおりです。- LLM パイプラインをトラッキングする: Weave を使用して、要約プロセスの入力、出力、中間ステップを自動的にログします。
- LLM の出力を評価する: Weave の組み込みツールを使用して、要約を一貫した基準で評価します。
- 組み合わせ可能なオペレーションを構築する: Weave のオペレーションを組み合わせて、要約パイプラインのさまざまな部分で再利用します。
- 既存のコードと統合する: 最小限のオーバーヘッドで、既存の Python コードに Weave を追加します。
環境を設定する
まず、環境を設定し、必要なライブラリをインポートします。このステップでは、パイプラインに必要な依存関係をインストールします。具体的には、トラッキング用の Weave、LLM 用の Anthropic、ArXiv の PDF を読み込むための PyPDF2 です。Anthropic の APIキーを取得するには、次の手順に従います。
- https://www.anthropic.com でアカウントを作成します。
- アカウント設定の API セクションにアクセスします。
- 新しい APIキーを生成します。
- 生成した APIキーを
.envファイルに安全に保存します。
weave.init([PROJECT_NAME]) を呼び出すと、要約タスク用の新しい Weave プロジェクトがセットアップされます。
ArxivPaper モデルを定義する
環境の準備が整ったら、次はパイプラインで扱うデータ構造を定義します。データを表すArxivPaper クラスを作成します。
PDF コンテンツを読み込む
ArxivPaper モデルはメタデータと PDF の URL を保持していますが、要約パイプラインでは論文の全文が必要です。論文全体を扱えるように、PDF を読み込んでテキストを抽出する関数を追加します。
Chain of Density 要約を実装する
次に、Weave のオペレーションを使用して、CoD 要約の中核となるロジックを実装します。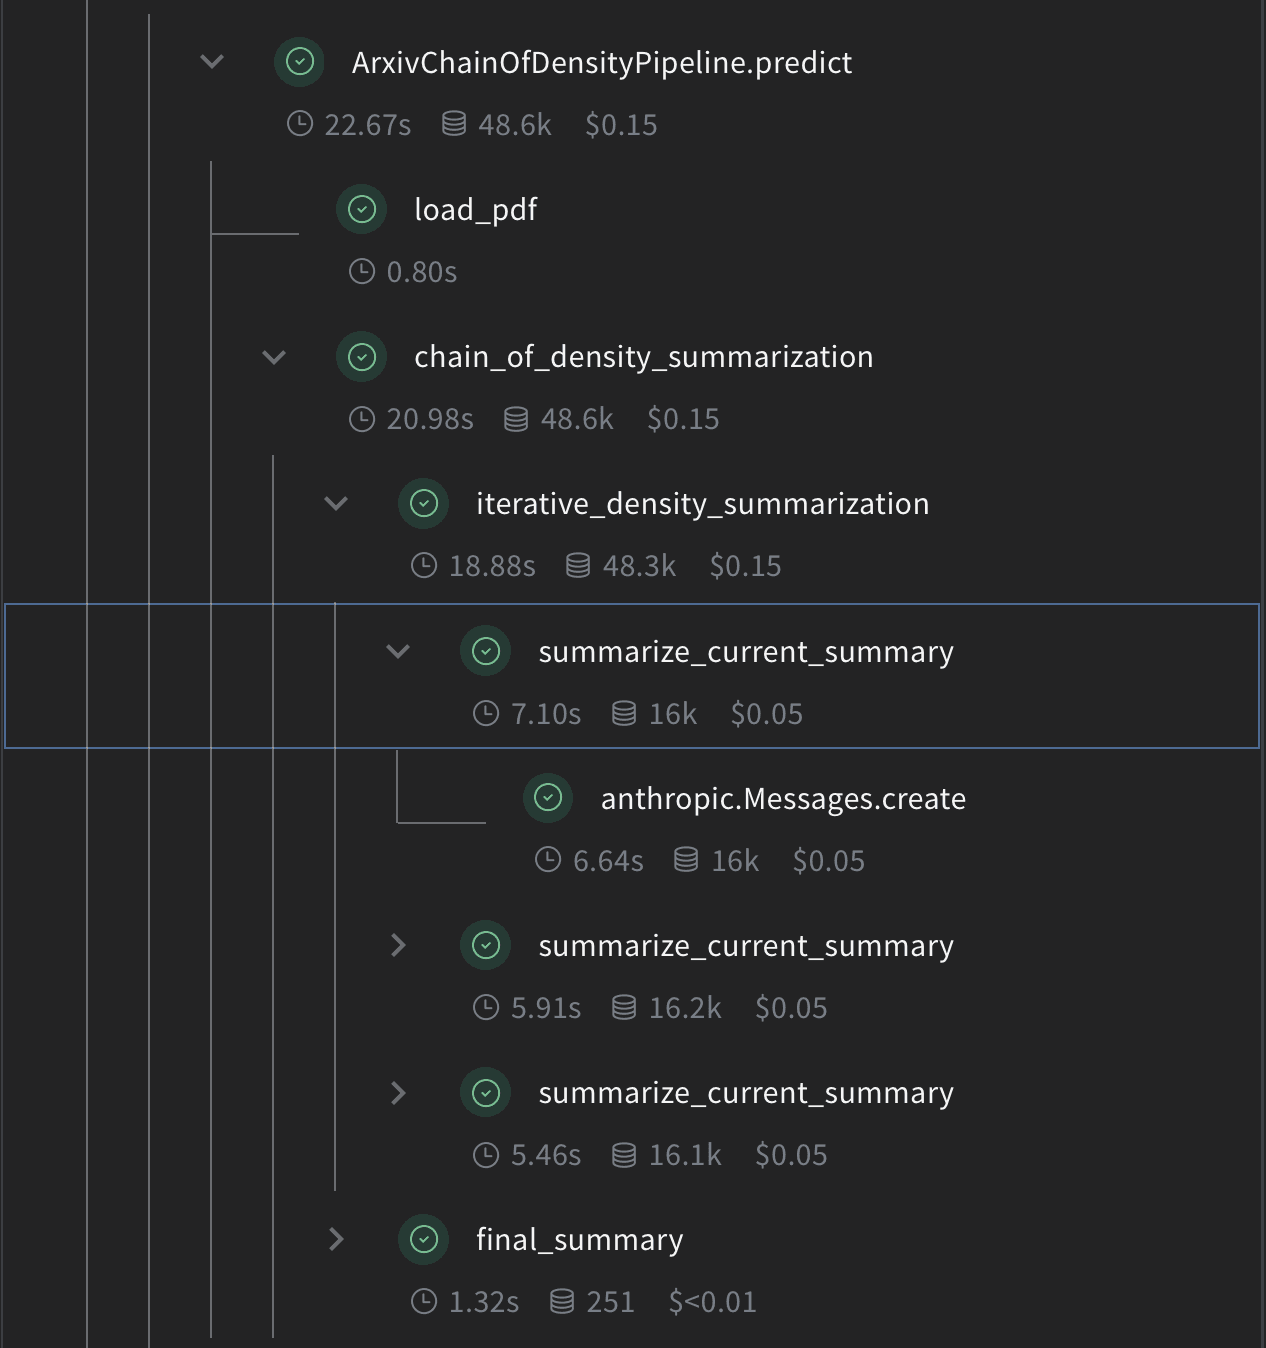
summarize_current_summary: 現在の状態をもとに、要約の反復を 1 回分生成します。iterative_density_summarization:summarize_current_summaryを複数回呼び出して、CoD 手法を適用します。chain_of_density_summarization: 要約プロセス全体を統括し、結果を返します。
@weave.op() デコレーターを付けることで、Weave がこれらの関数の入力、出力、実行をトラッキングします。
Weave モデルを作成する
要約関数の準備ができたら、次はそれらを Weave モデルとしてパッケージ化し、run、パラメーター、バージョンをまとめて追跡できるようにします。では、要約パイプラインを Weave モデルでラップしましょう。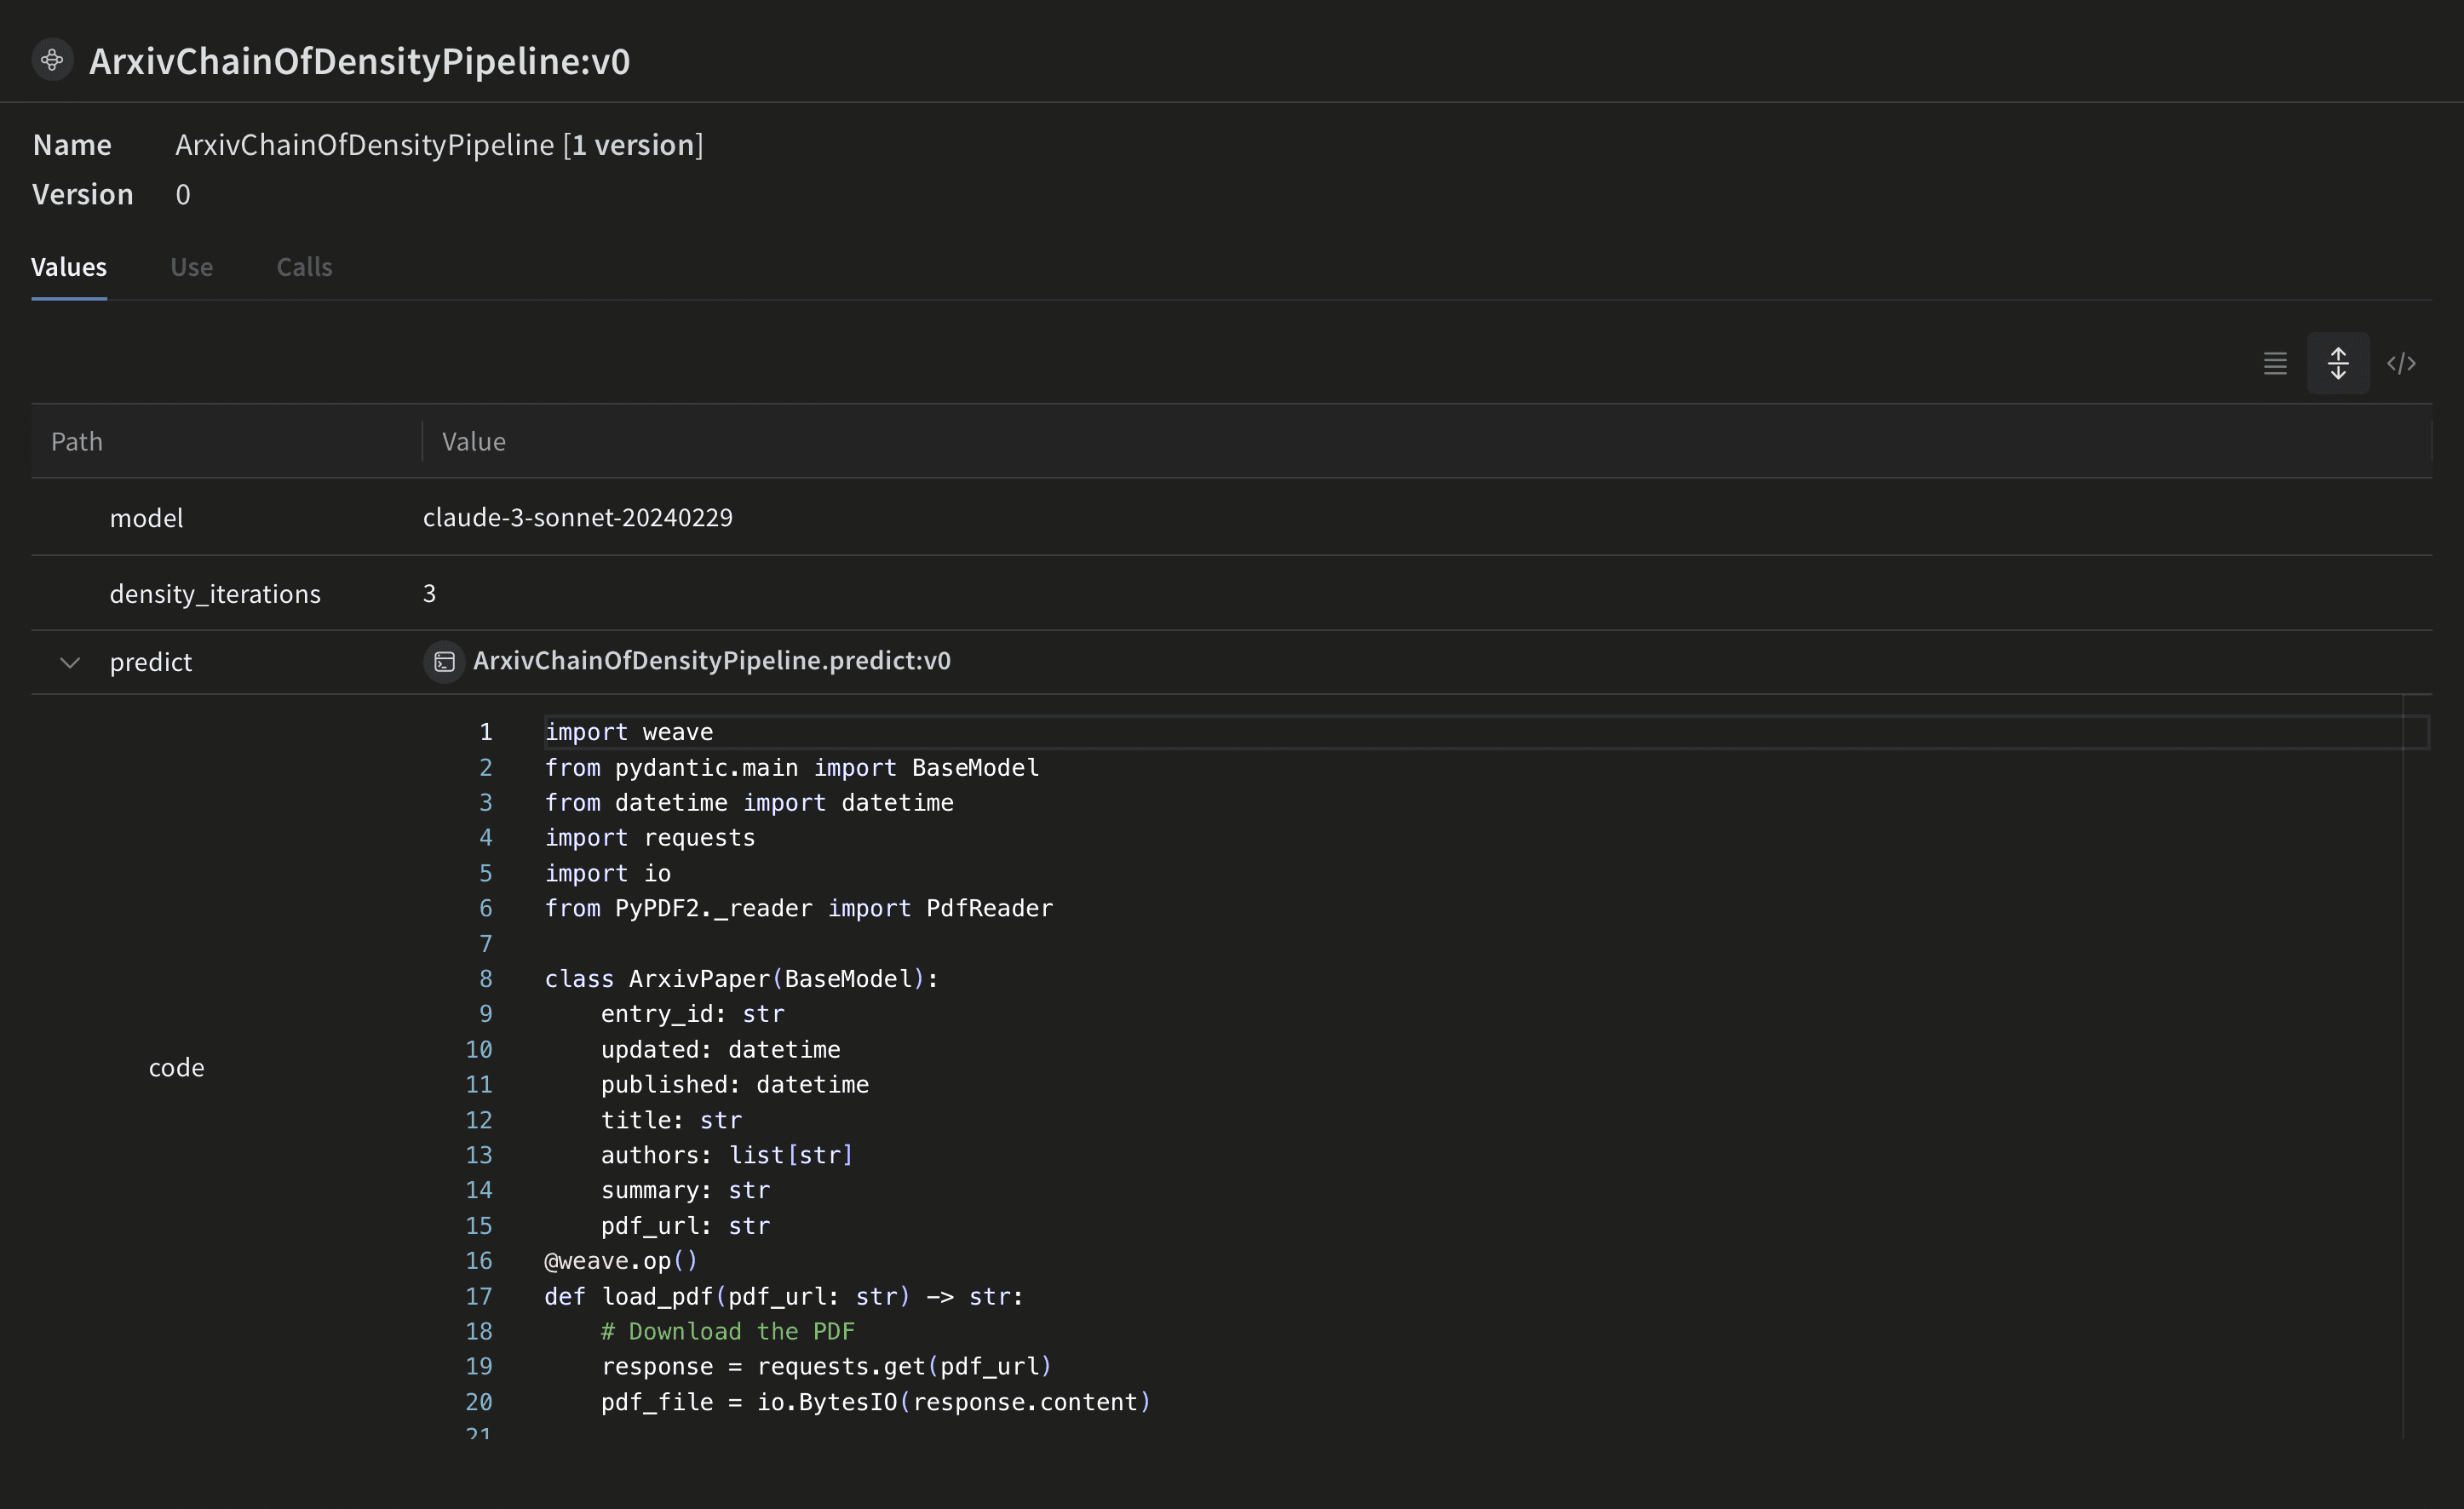
ArxivChainOfDensityPipeline クラスは、要約ロジックを Weave モデルとしてカプセル化しており、次のような利点があります。
- 自動的な実験管理: Weave は、モデルの run ごとに入力、出力、パラメーターを取得します。
- バージョン管理: モデルの属性やコードを変更すると自動的にバージョン管理されるため、要約パイプラインの変遷を明確な履歴として確認できます。
- 再現性: バージョン管理とトラッキングにより、要約パイプラインの過去の結果や設定をいつでも再現できます。
- ハイパーパラメーター管理: モデルの属性 (
modelやdensity_iterationsなど) が明確に定義され、run をまたいで追跡されるため、実験を進めやすくなります。 - Weave エコシステムとのインテグレーション:
weave.Modelを使用すると、評価やサービング機能など、他の Weave ツールと連携できます。
評価メトリクスを実装する
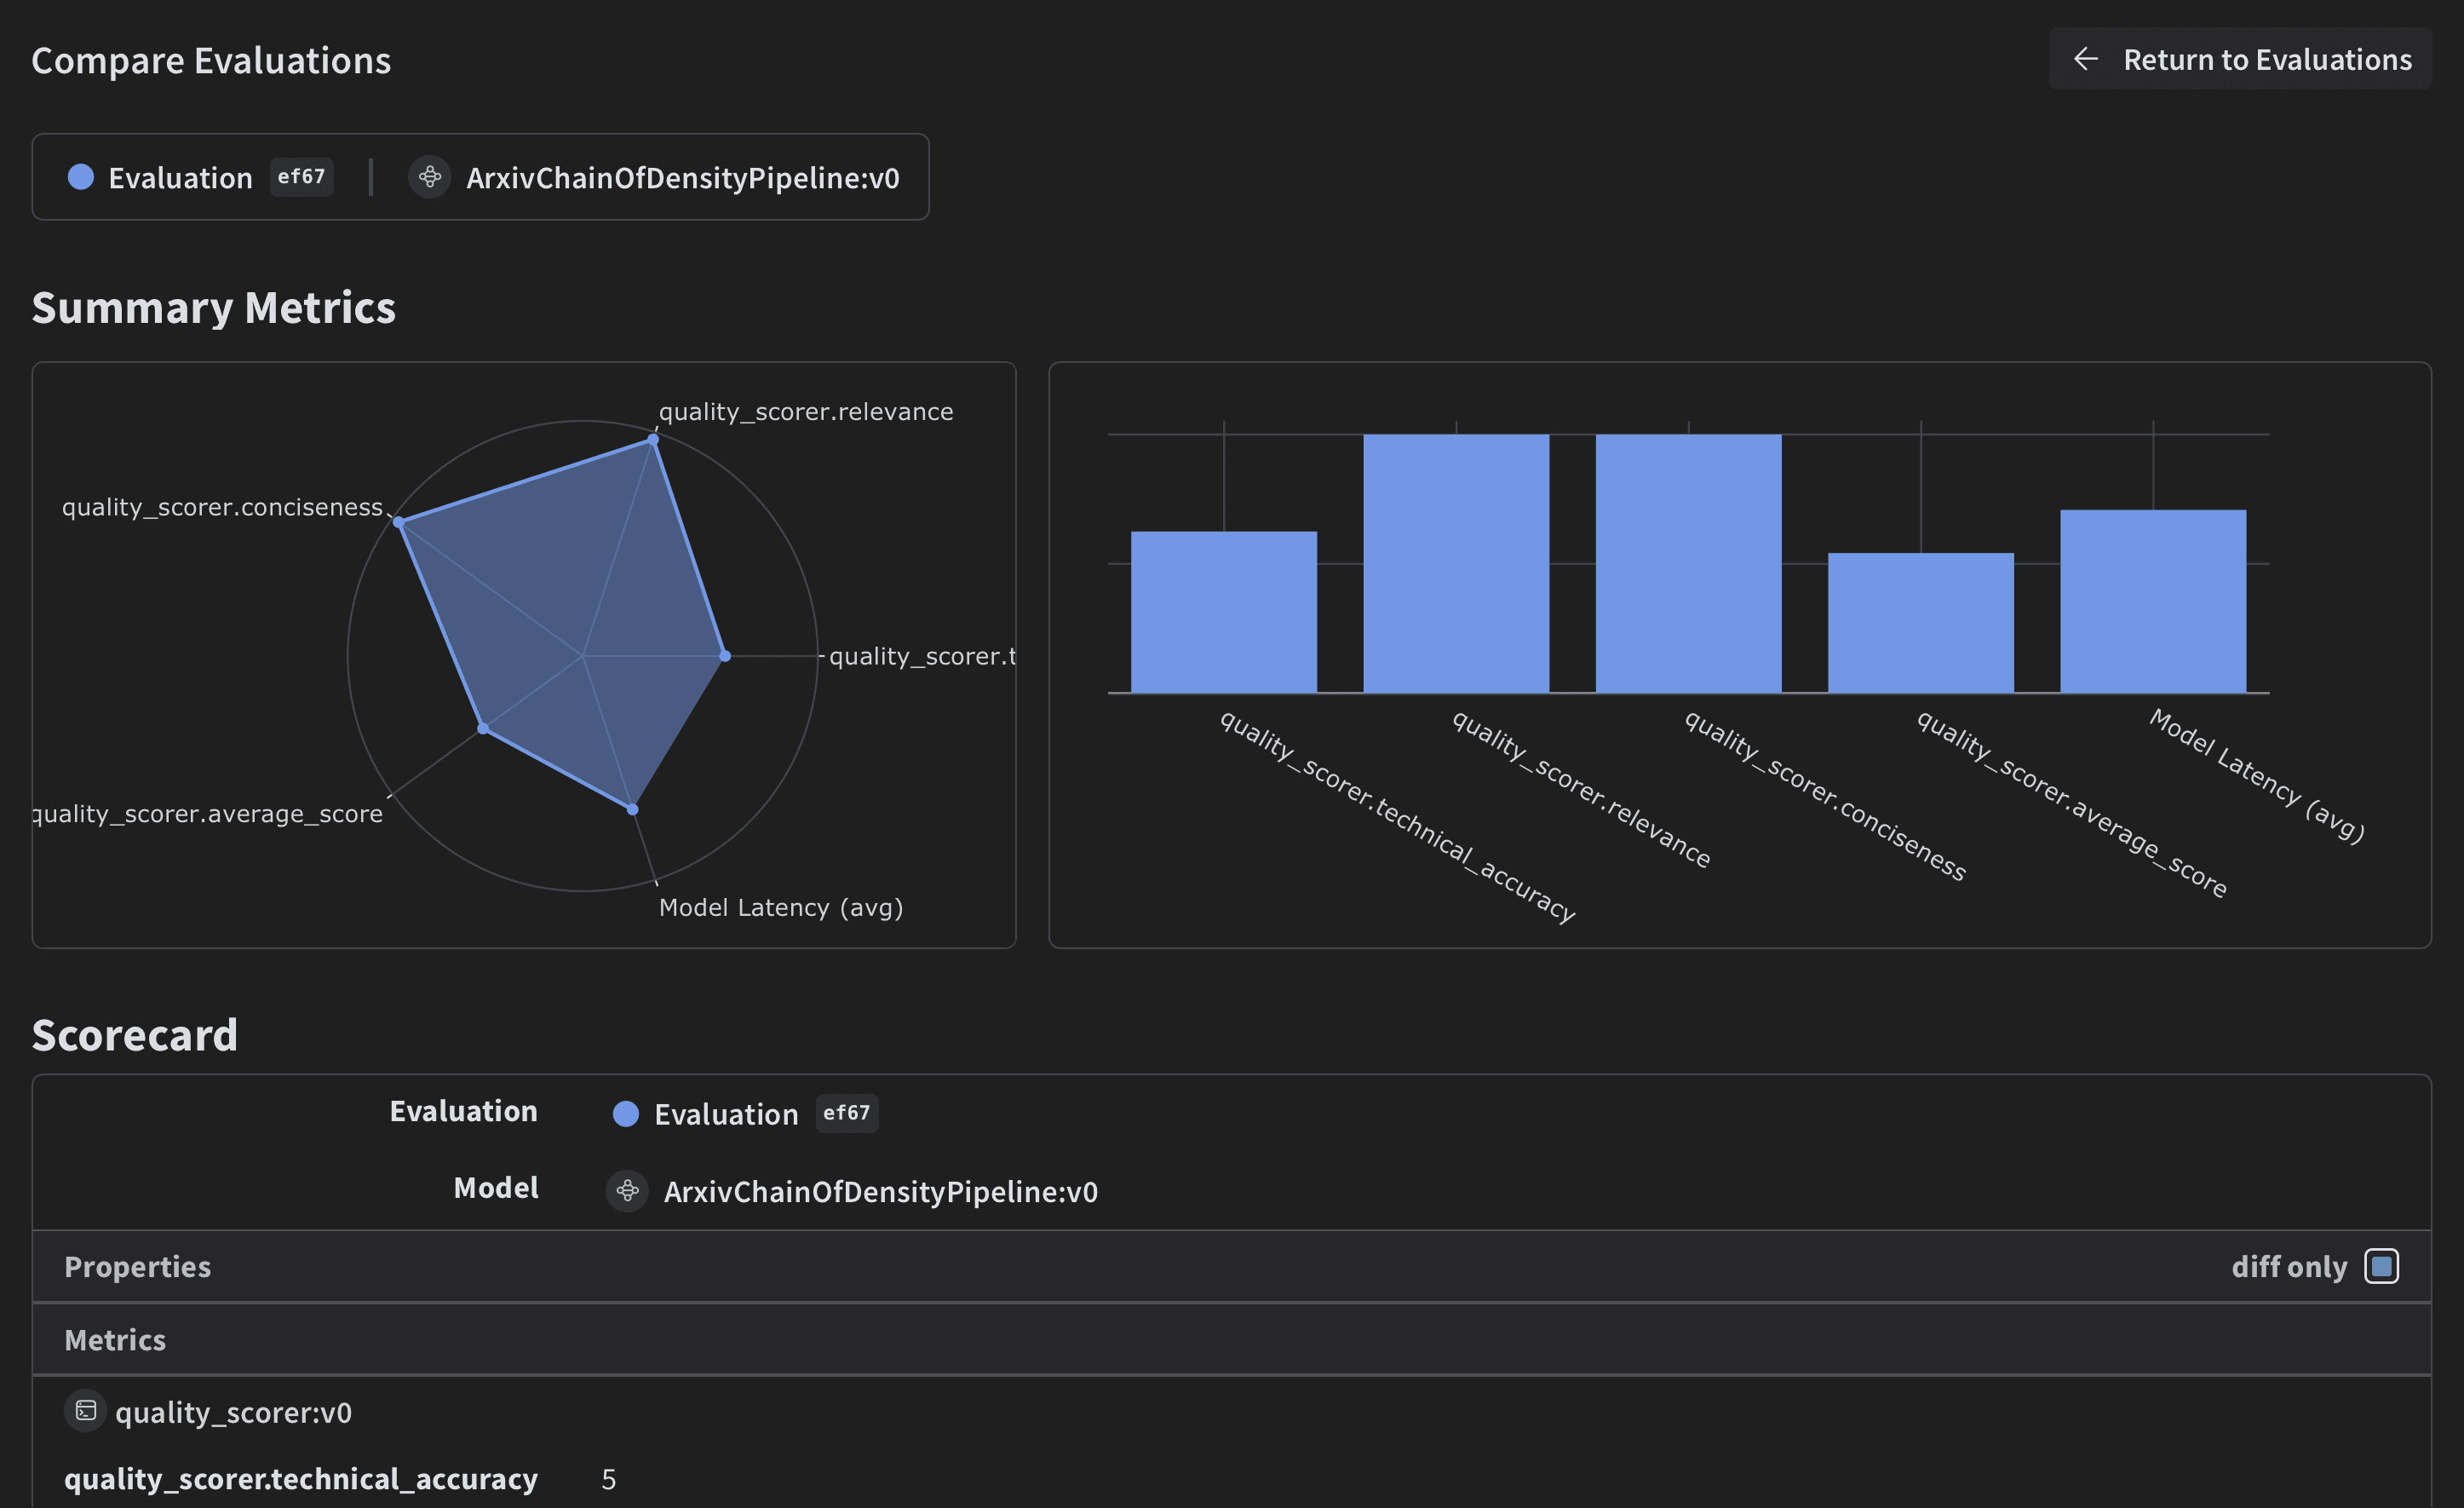
パイプラインで要約を生成できるようになったので、次は要約の品質を体系的に測定する方法が必要です。要約の品質を評価するために、シンプルな評価メトリクスを実装します。Weave Dataset を作成して評価を実行する
スコアリング関数を定義できたので、最後に、この関数をサンプル入力に適用して評価を実行します。パイプラインを評価するには、次のように Weave Dataset を作成して評価を実行します。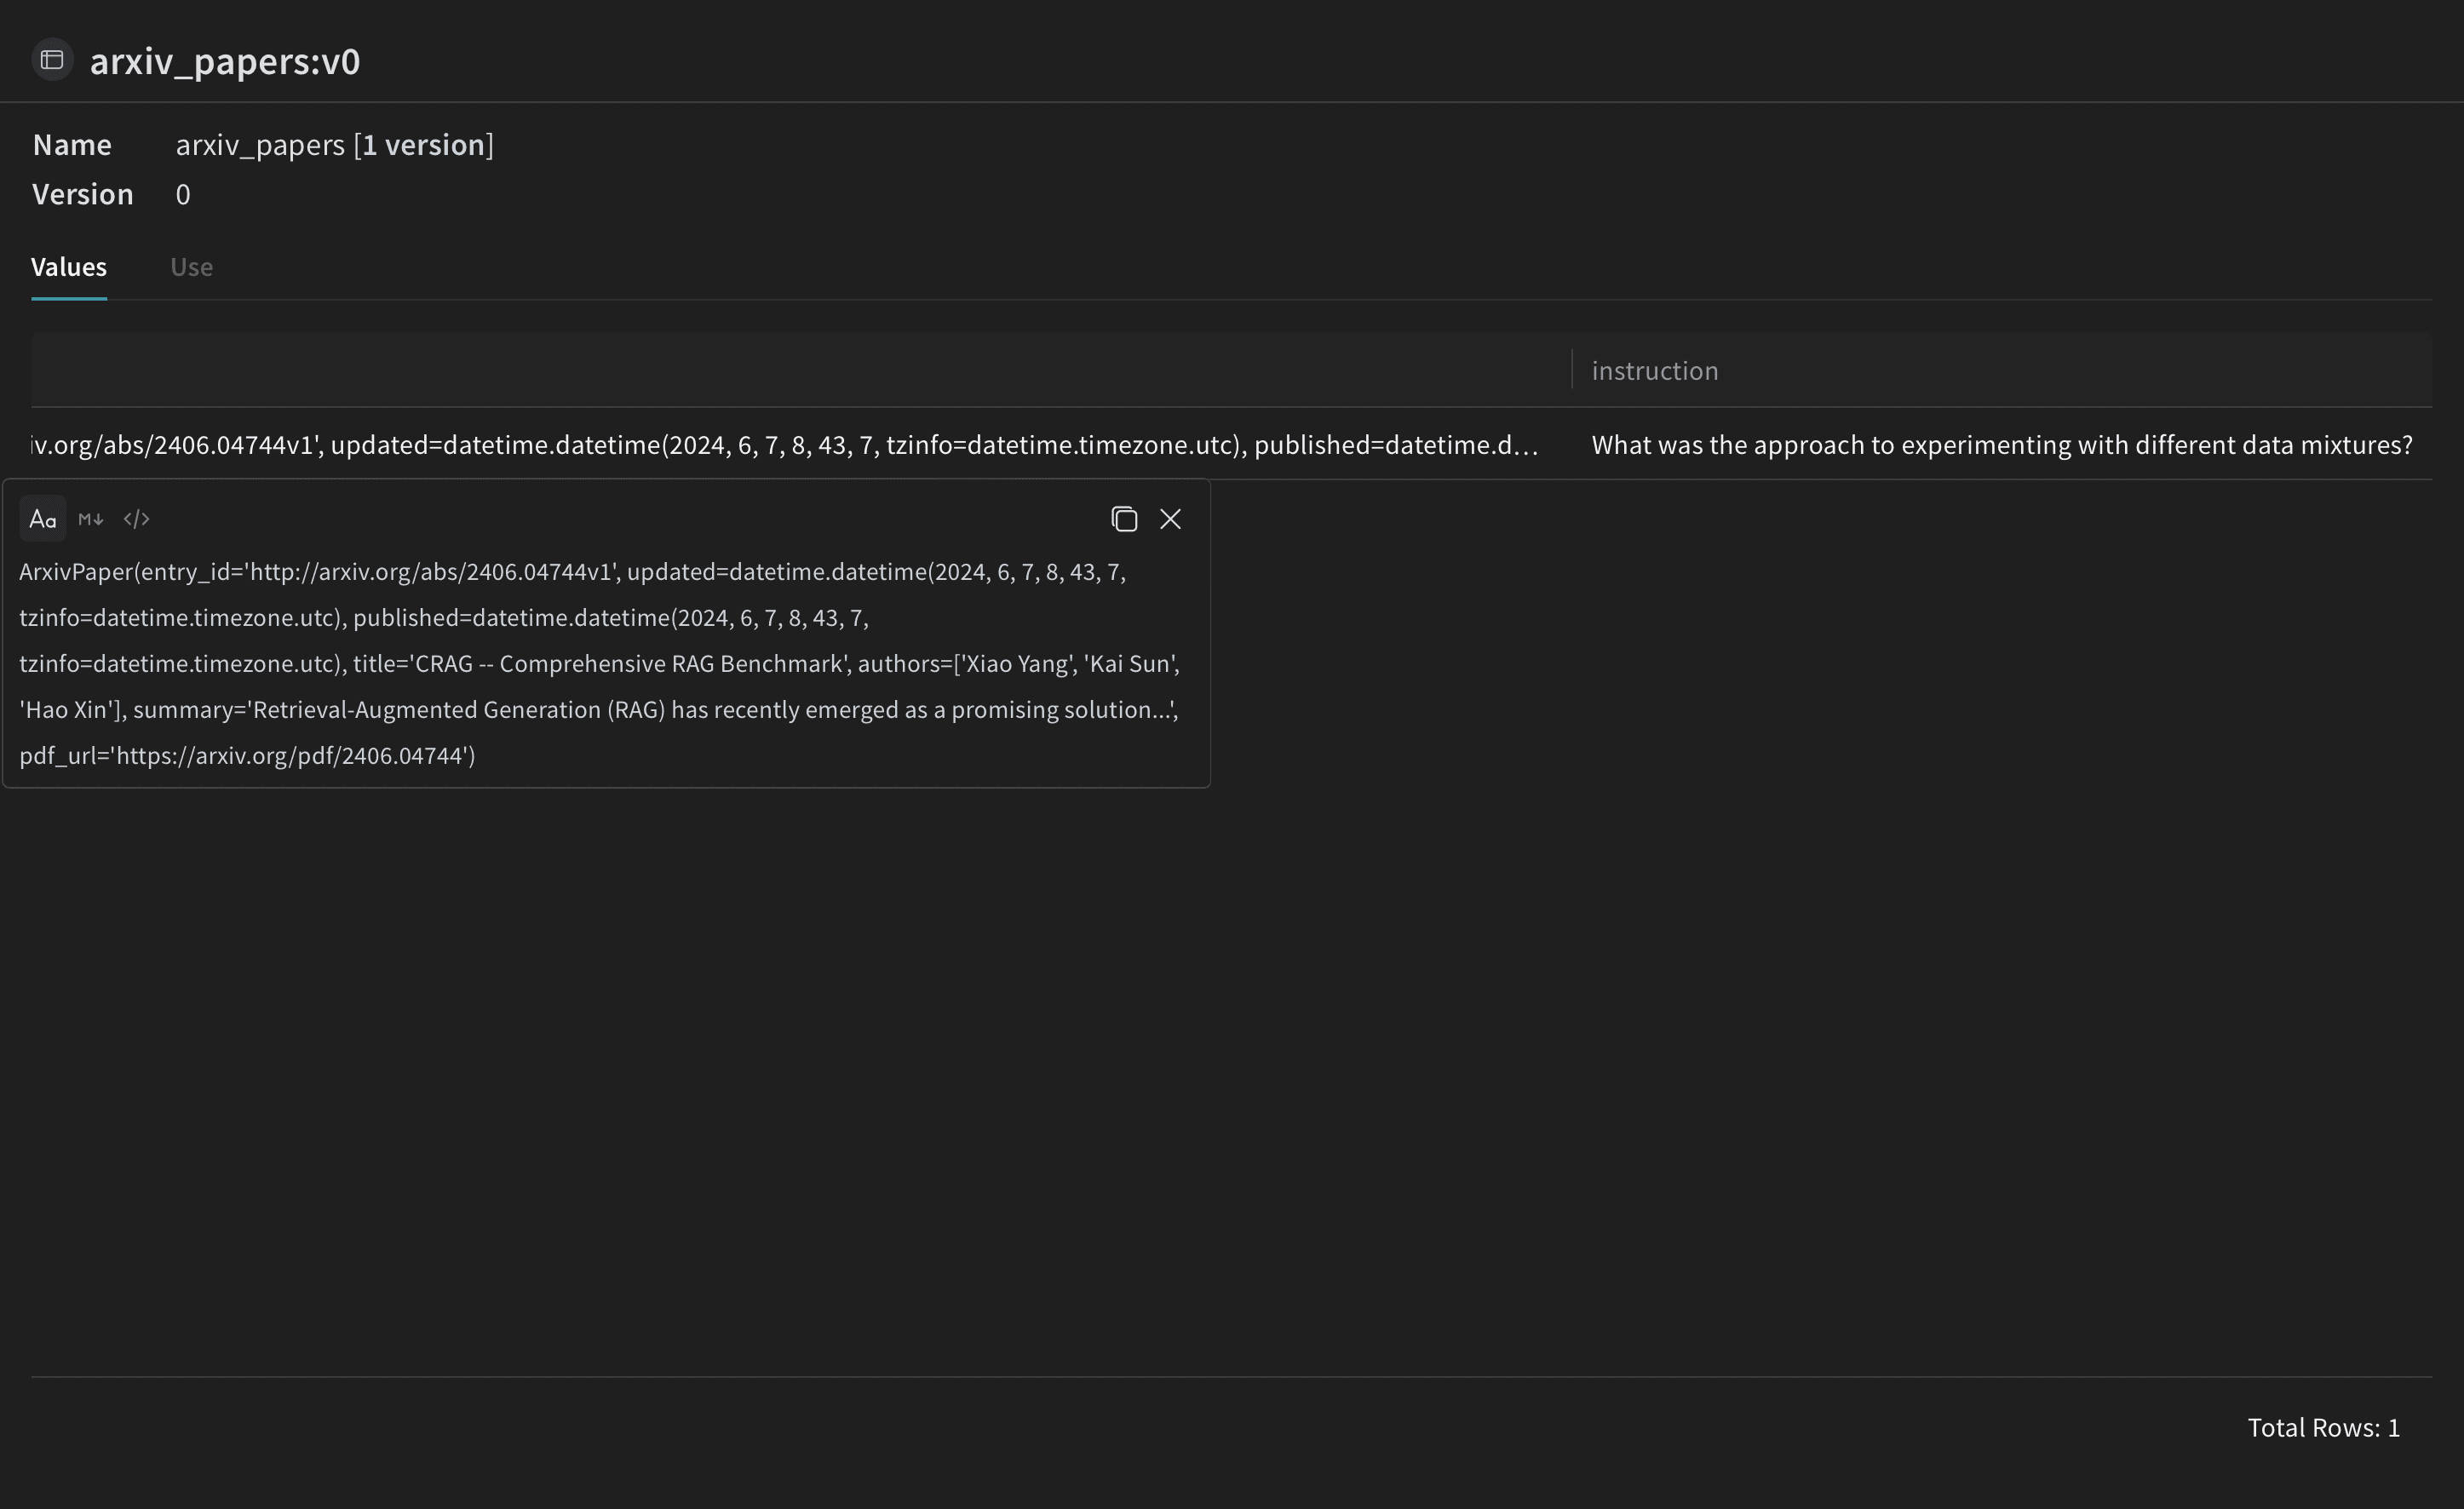

まとめ
この例では、Weave を使用して ArXiv 論文向けの Chain of Density 要約パイプラインを実装する方法を紹介しました。ここで学んだ内容は次のとおりです。- 要約プロセスの各ステップに対応する Weave オペレーションを作成する
- トラッキングと評価のために、パイプラインを Weave モデルでラップする
- Weave オペレーションを使用してカスタム評価メトリクスを実装する
- データセットを作成し、パイプラインの評価を実行する