これはインタラクティブなノートブックです。ローカルで実行するか、次のリンクから利用できます。
依存関係をインストールする
始める前に、このチュートリアルで使用するライブラリをインストールします。このチュートリアルでは、次のライブラリを使用します。- DSPy: LLM ワークフローの構築と最適化に使用します。
- Weave: LLM ワークフローのトラッキングと、プロンプト戦略の評価に使用します。
- datasets: HuggingFace Hub の BIG-Bench Hard データセットへのアクセスに使用します。
Weave を使用してトラッキングを有効にする
このセクションでは Weave を設定し、チュートリアルでこれ以降に実行する DSPy の Call が自動的にトレースされ、Weights & Biases UI で確認できるようにします。 Weave は DSPy と連携しています。コードの冒頭にweave.init を追加すると、DSPy の関数が自動的にトレースされ、Weights & Biases UI で詳しく確認できます。詳細については、DSPy 向け Weave インテグレーションのドキュメントを参照してください。
weave.Object を継承したメタデータクラスを使用してメタデータを管理します。
BIG-Bench Hard データセットを読み込む
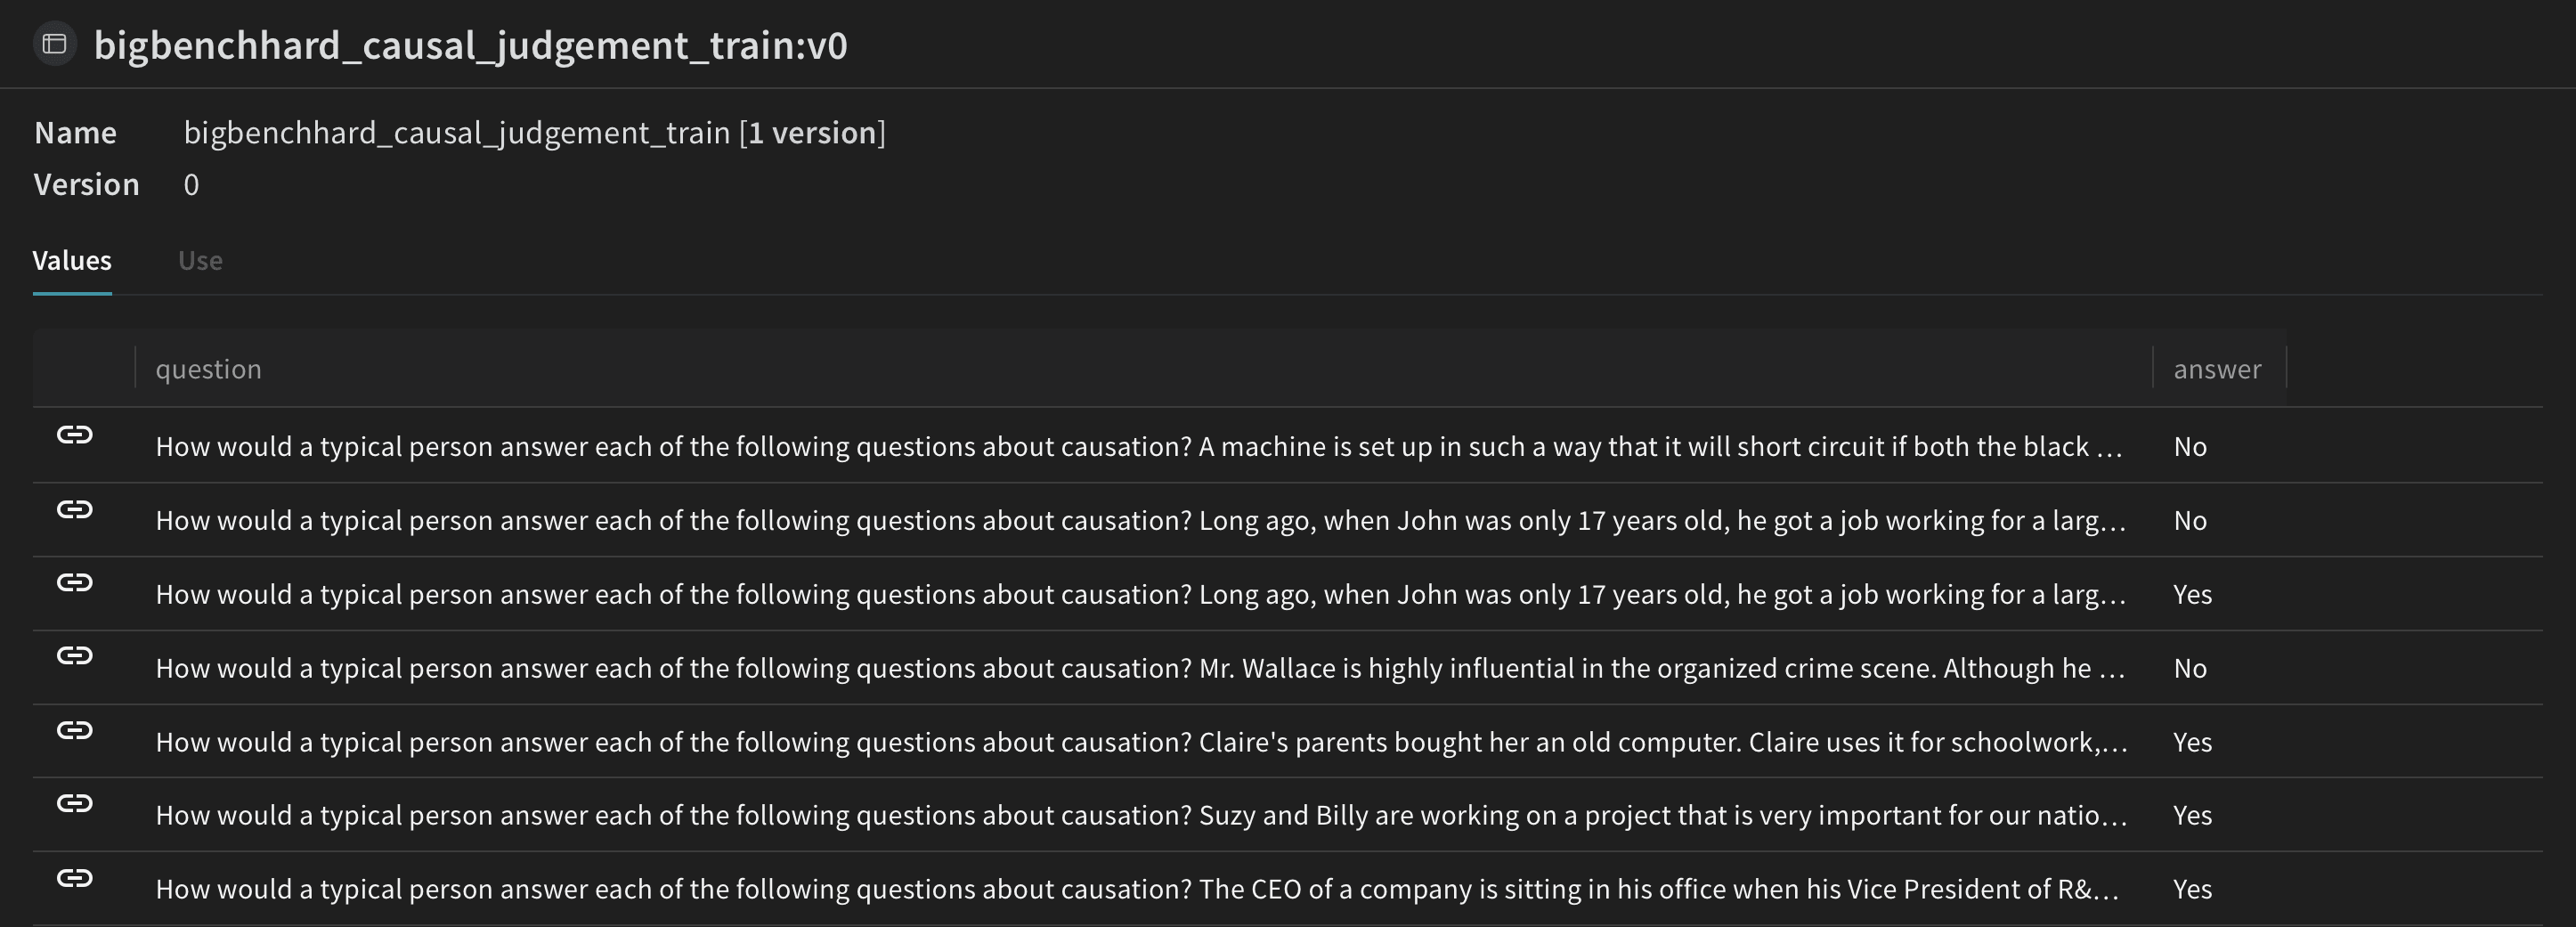
Weave のトラッキングを有効にしたら、次に DSPy プログラムのトレーニングと評価に使用するデータを準備します。 HuggingFace Hub からこのデータセットを読み込み、トレーニングセットと検証セットに分割して、Weave にパブリッシュします。パブリッシュすると、データセットをバージョン管理できるだけでなく、weave.Evaluation を使用してプロンプト戦略を評価することもできます。
DSPy プログラム
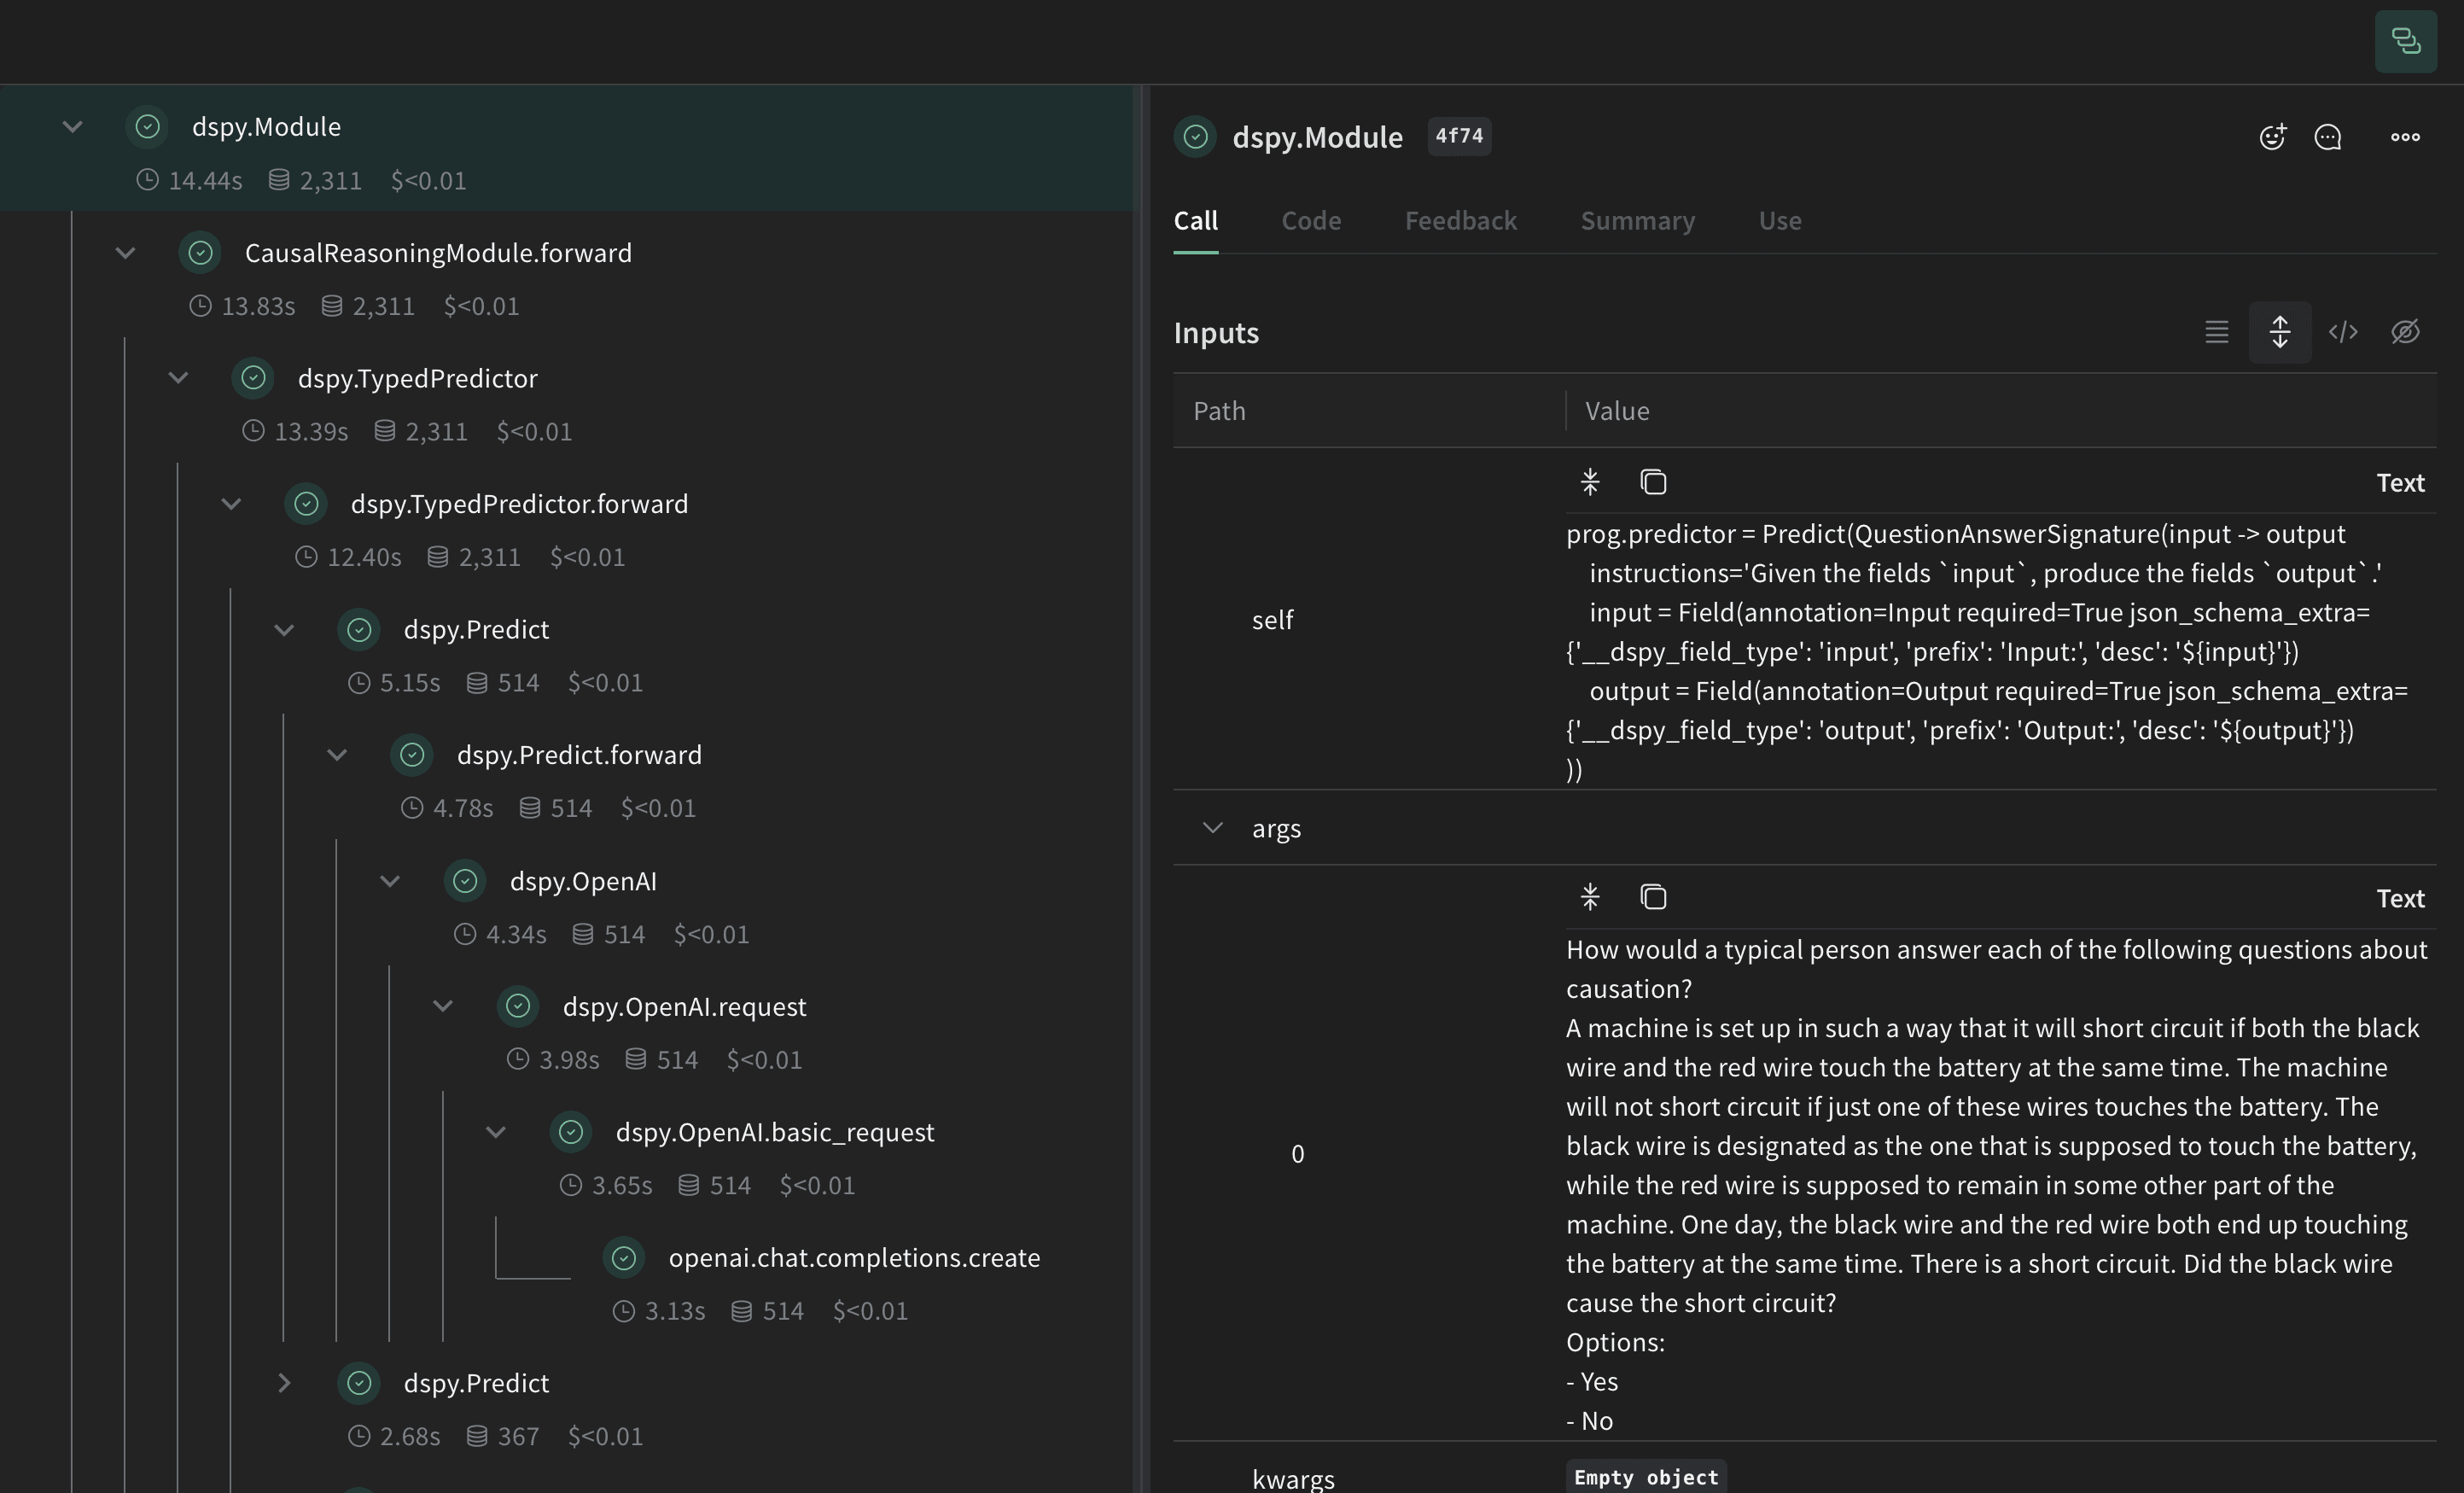
データセットを Weave にパブリッシュしたので、次に、後で評価と最適化を行うベースラインの DSPy プログラムを定義します。 DSPy は、新しい LM パイプラインの構築を、任意形式の文字列を操作する作業から、プログラミング (モジュール化されたオペレーターを組み合わせてテキスト変換グラフを構築すること) に近いものへと転換するフレームワークです。DSPy では、コンパイラーがプログラムから最適化された LM invocation 戦略とプロンプトを自動的に生成します。dspy.LM で言語モデルを設定し、dspy.configure でそのモデルをデフォルトに設定します。
因果推論の Signature を記述する
Signature は、DSPy モジュールの入出力の動作を宣言的に定義する仕様です。DSPy モジュールは、タスクに応じて適応するコンポーネント (ニューラルネットワークの層に相当) で、任意のテキスト変換を抽象化します。CausalReasoningModule) をテストします。
DSPy プログラムを評価する
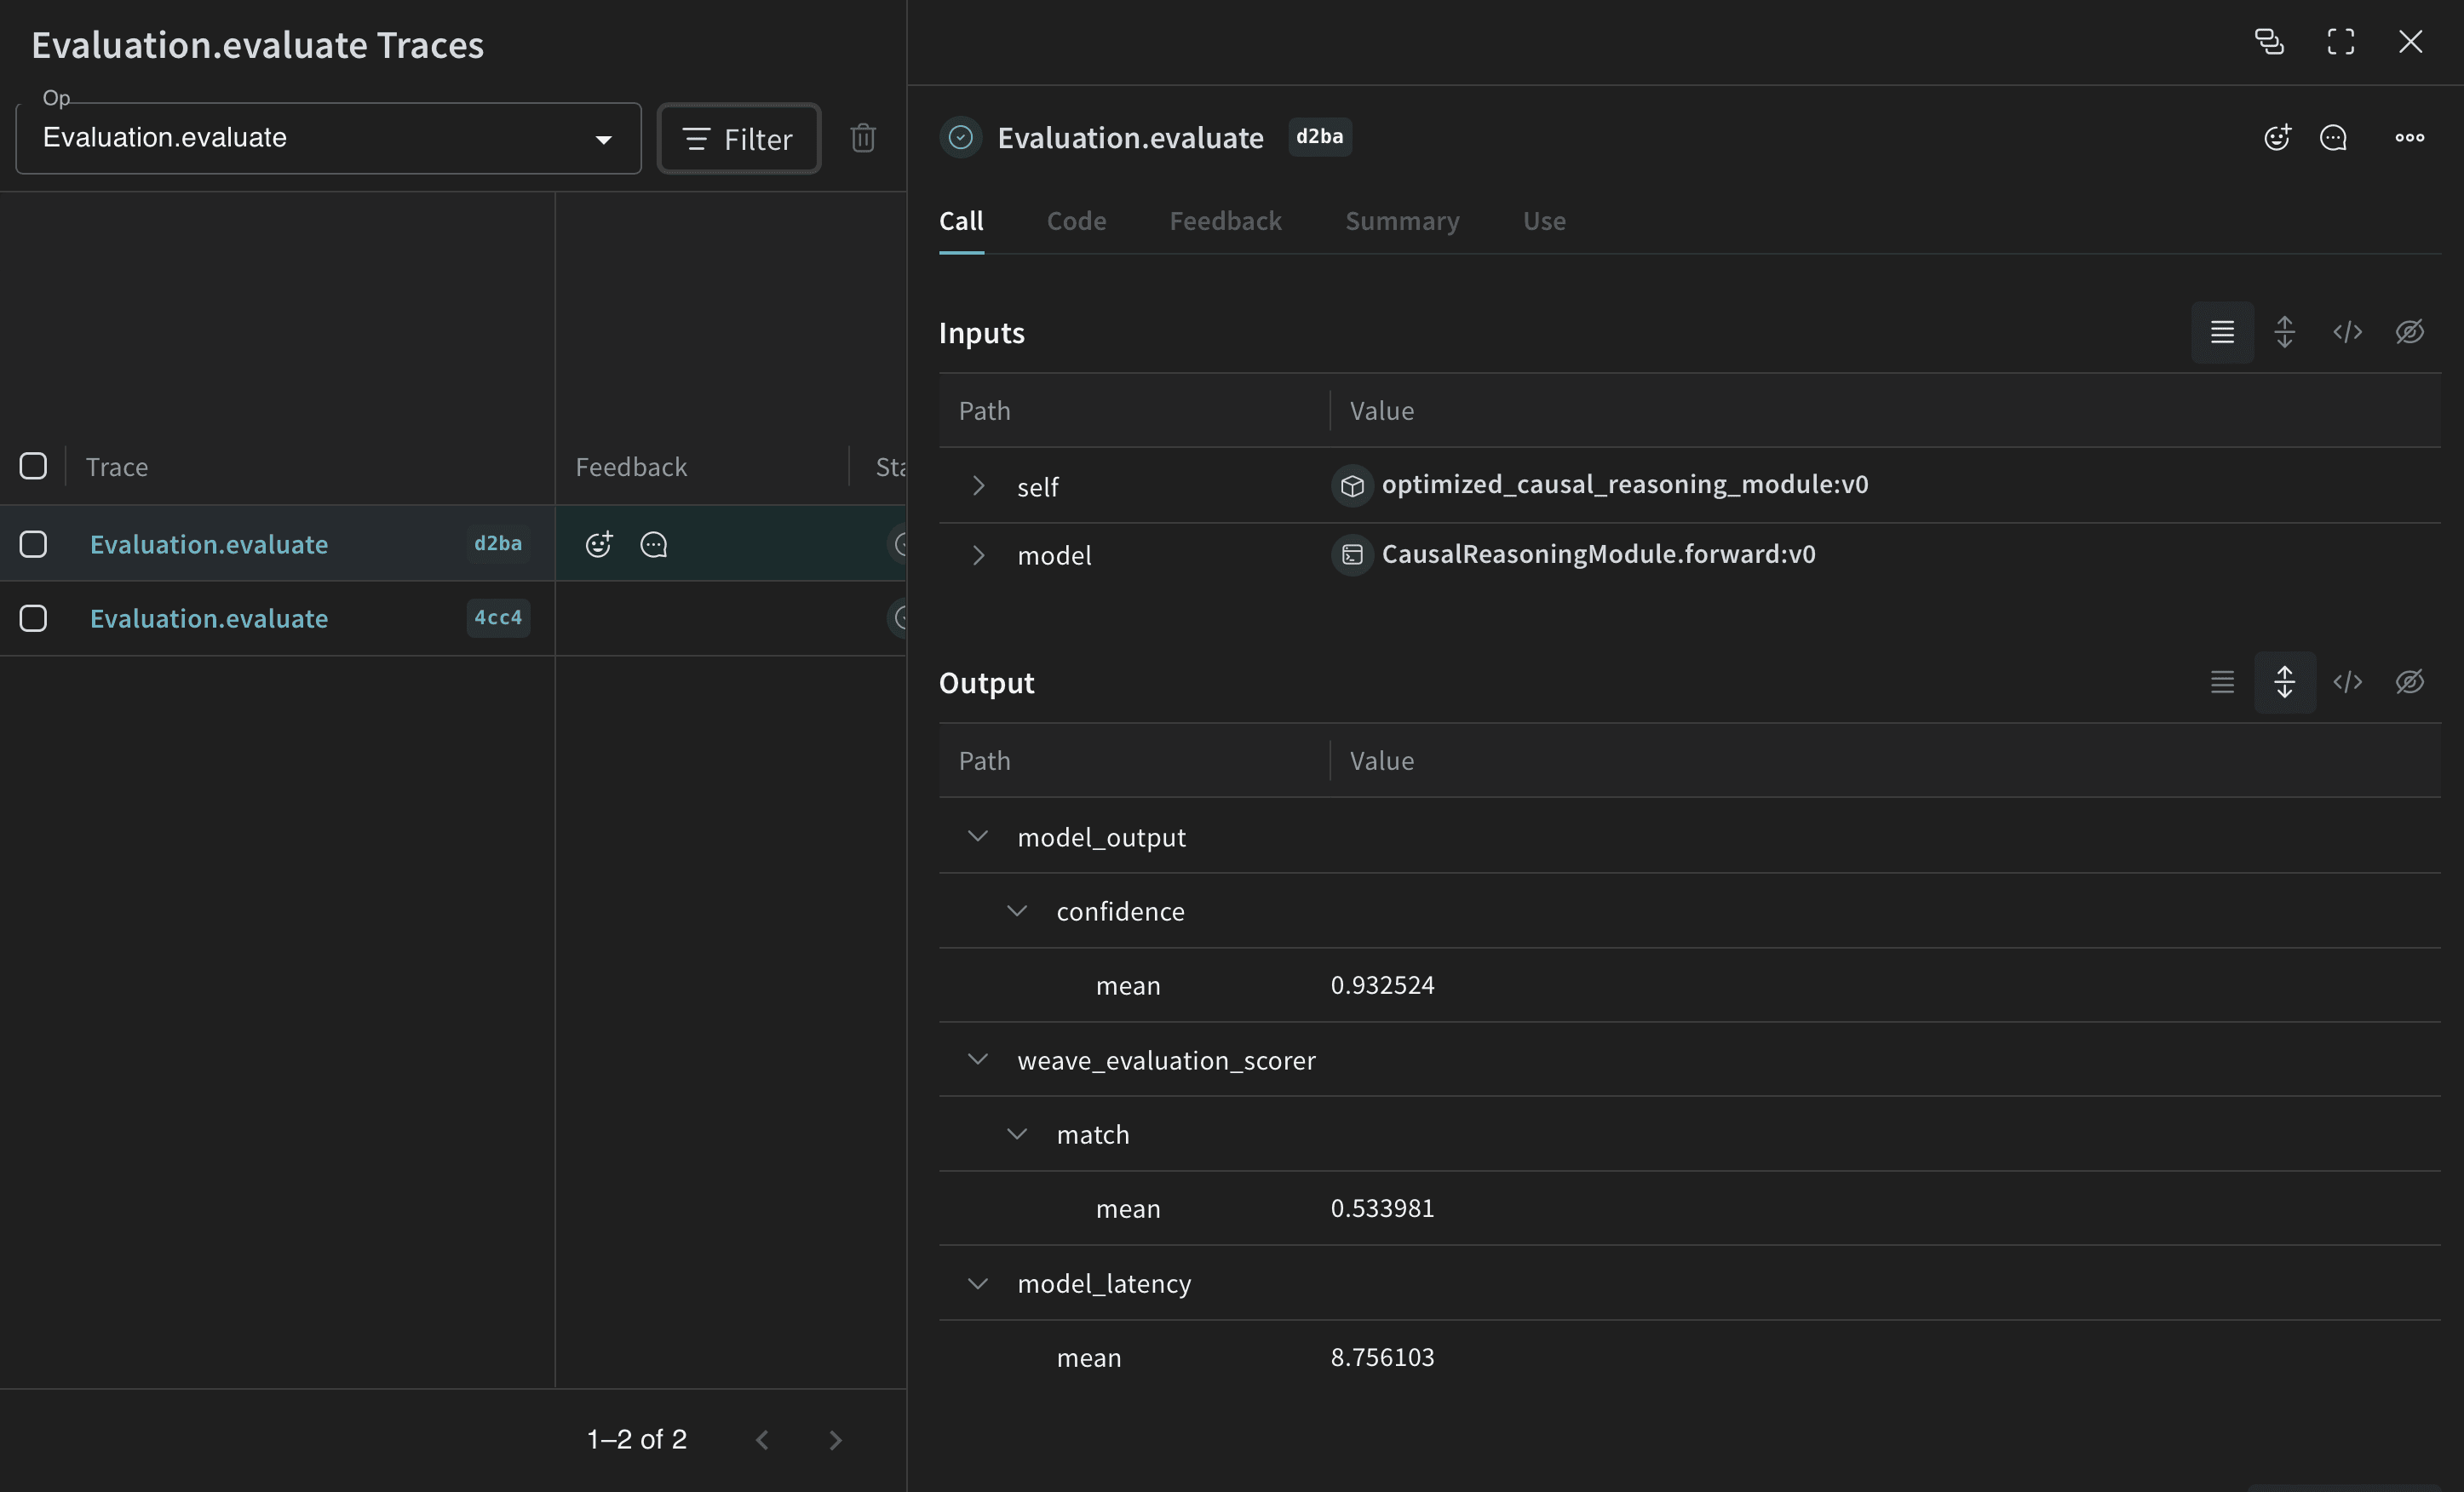
ベースラインとなるプロンプト戦略ができたので、weave.Evaluation を使用して検証セットで評価します。メトリクスには、予測された回答を正解と照合するものを使用します。Weave は各例をアプリケーションに渡し、その出力を複数のカスタムスコアリング関数でスコア付けします。これにより、アプリケーションのパフォーマンスを把握できるほか、充実した UI で個々の出力やスコアを詳しく確認できます。
まず、予測された回答が正解と一致するかどうかを判定するスコアリング関数を作成します。Weave のスコアリング関数は、モデルの戻り値を output として受け取り、データセットの例に含まれるキーのうち名前が一致するものを追加の引数として受け取ります。ここでは、answer はデータセットから渡され、output は CausalReasoningModule.forward が返す dict です。
weave.Evaluation から呼び出せるように、モジュールをトレース対象の関数でラップします。ラッパーの引数名は、モデルが使用するデータセットの列名と一致させる必要があります。
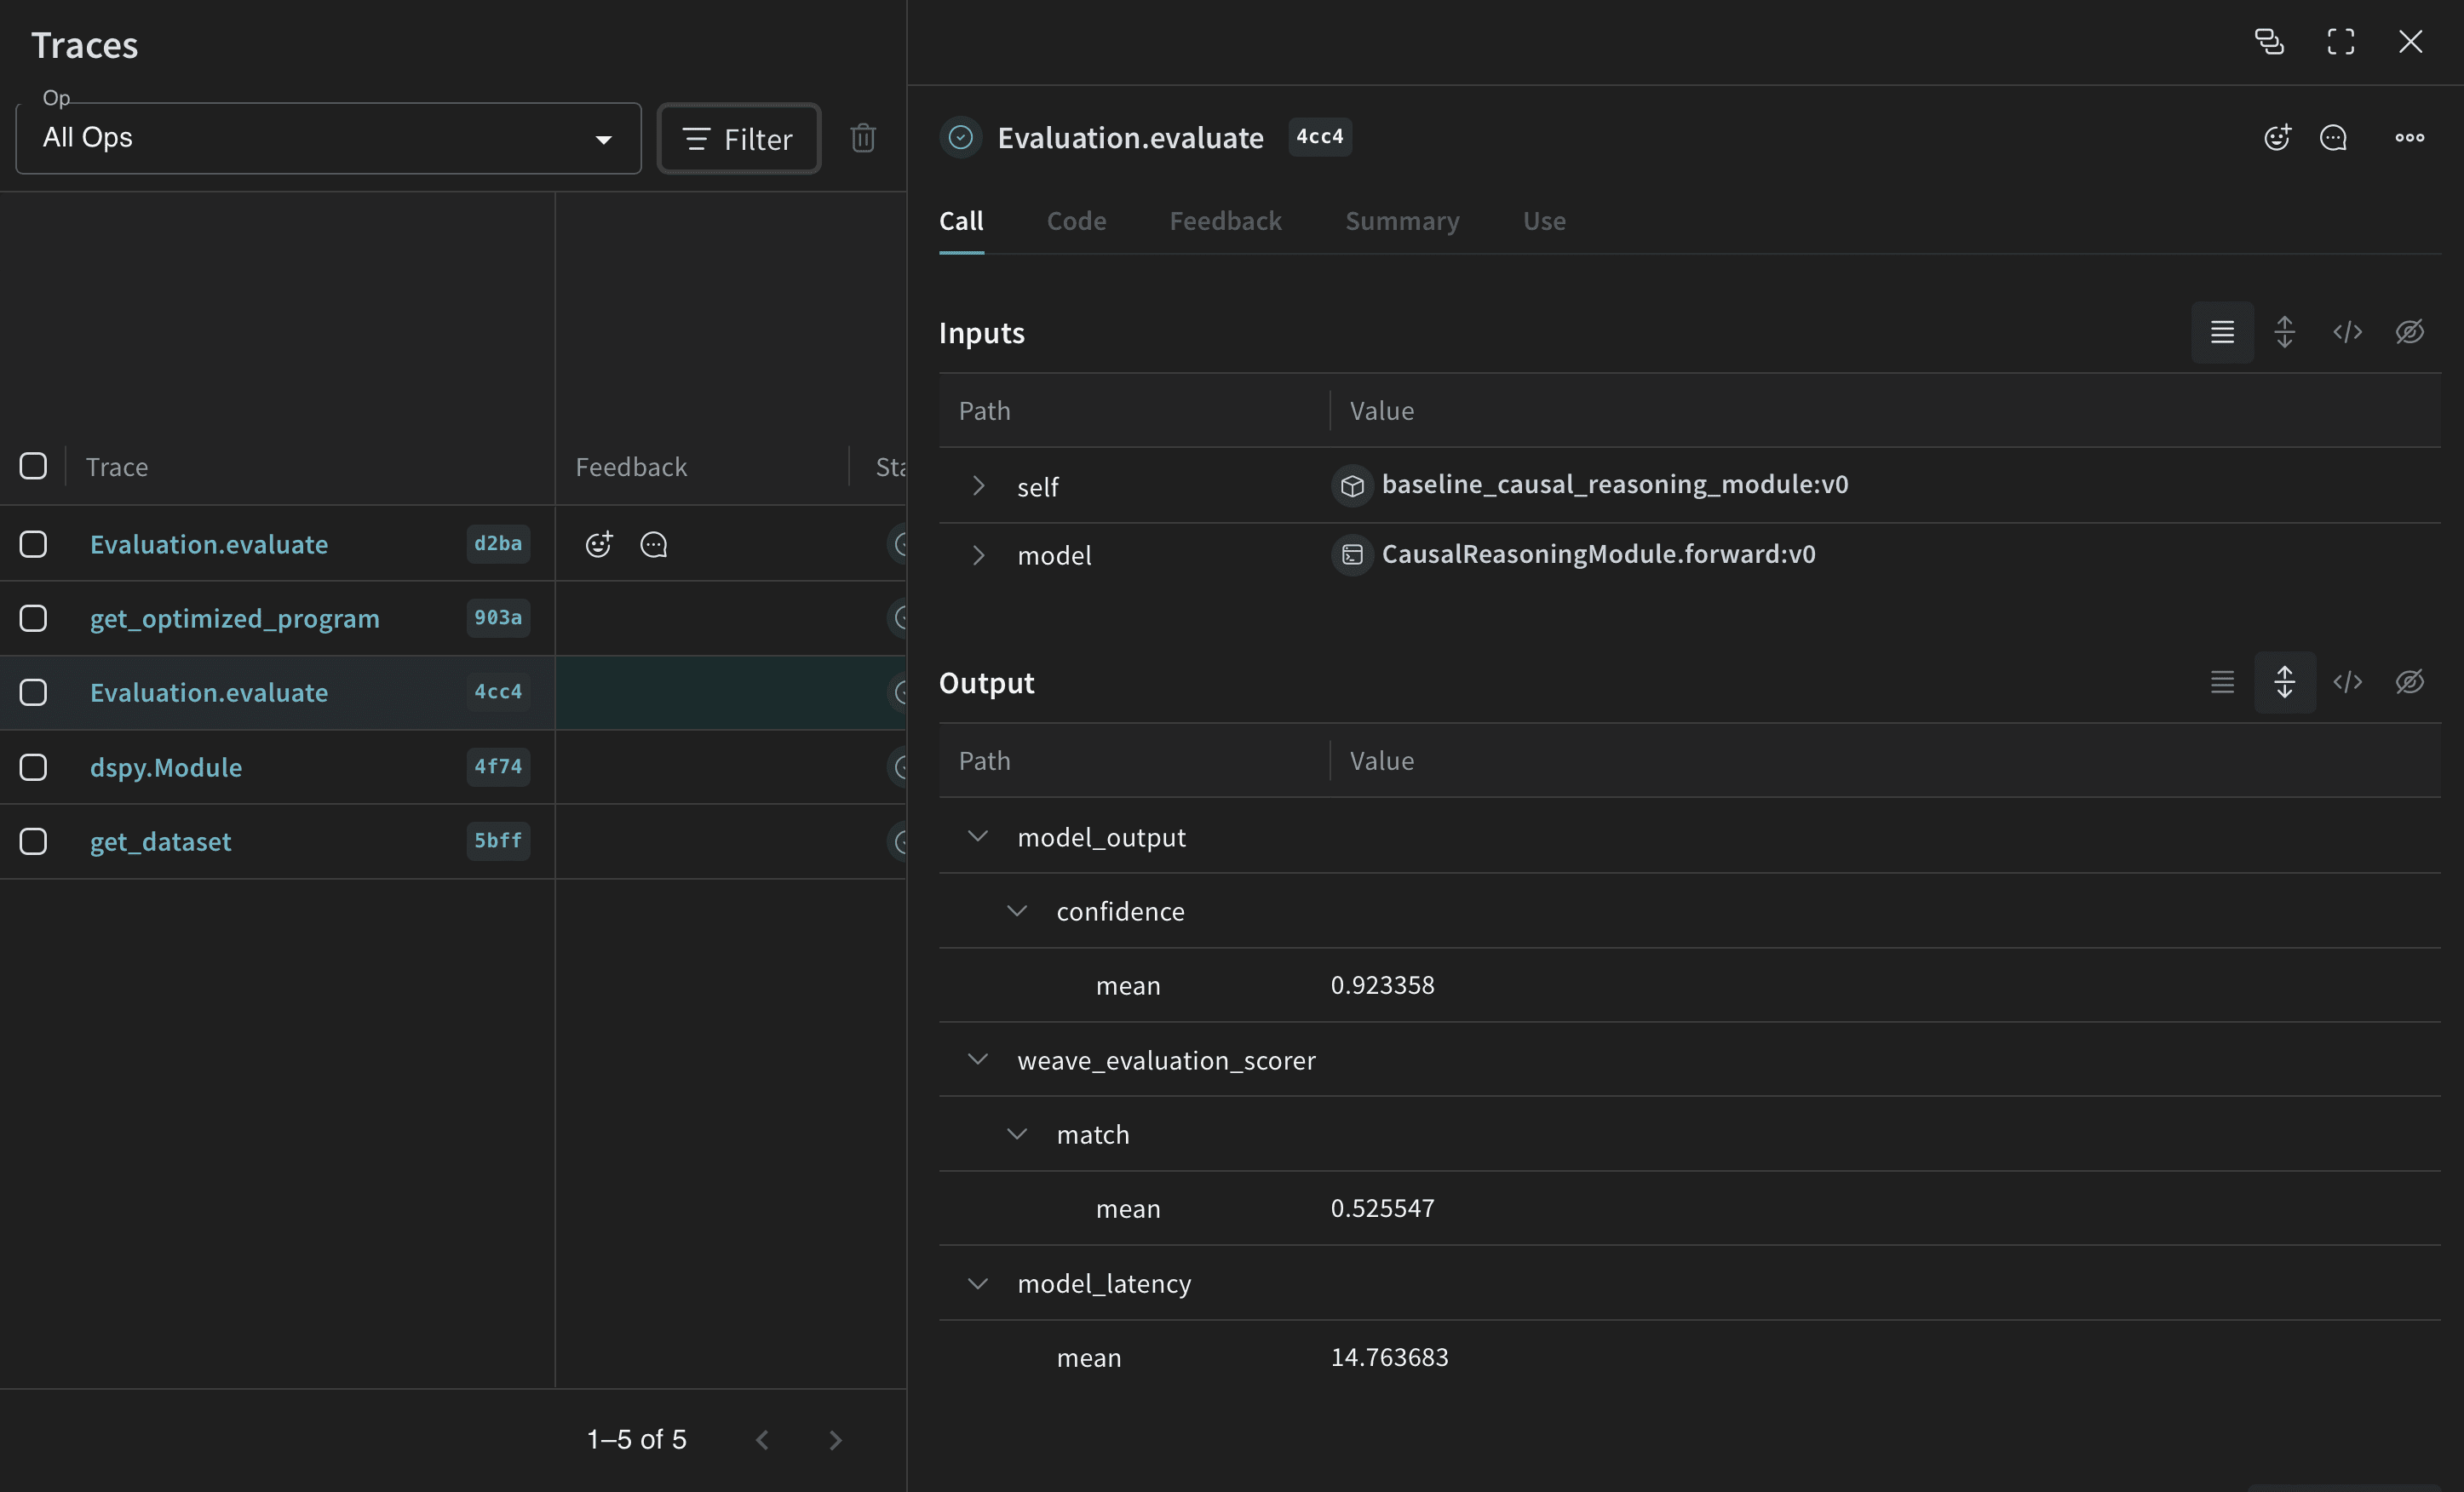
Python スクリプトから実行する場合は、次のコードで評価を実行できます。
DSPy プログラムを最適化する
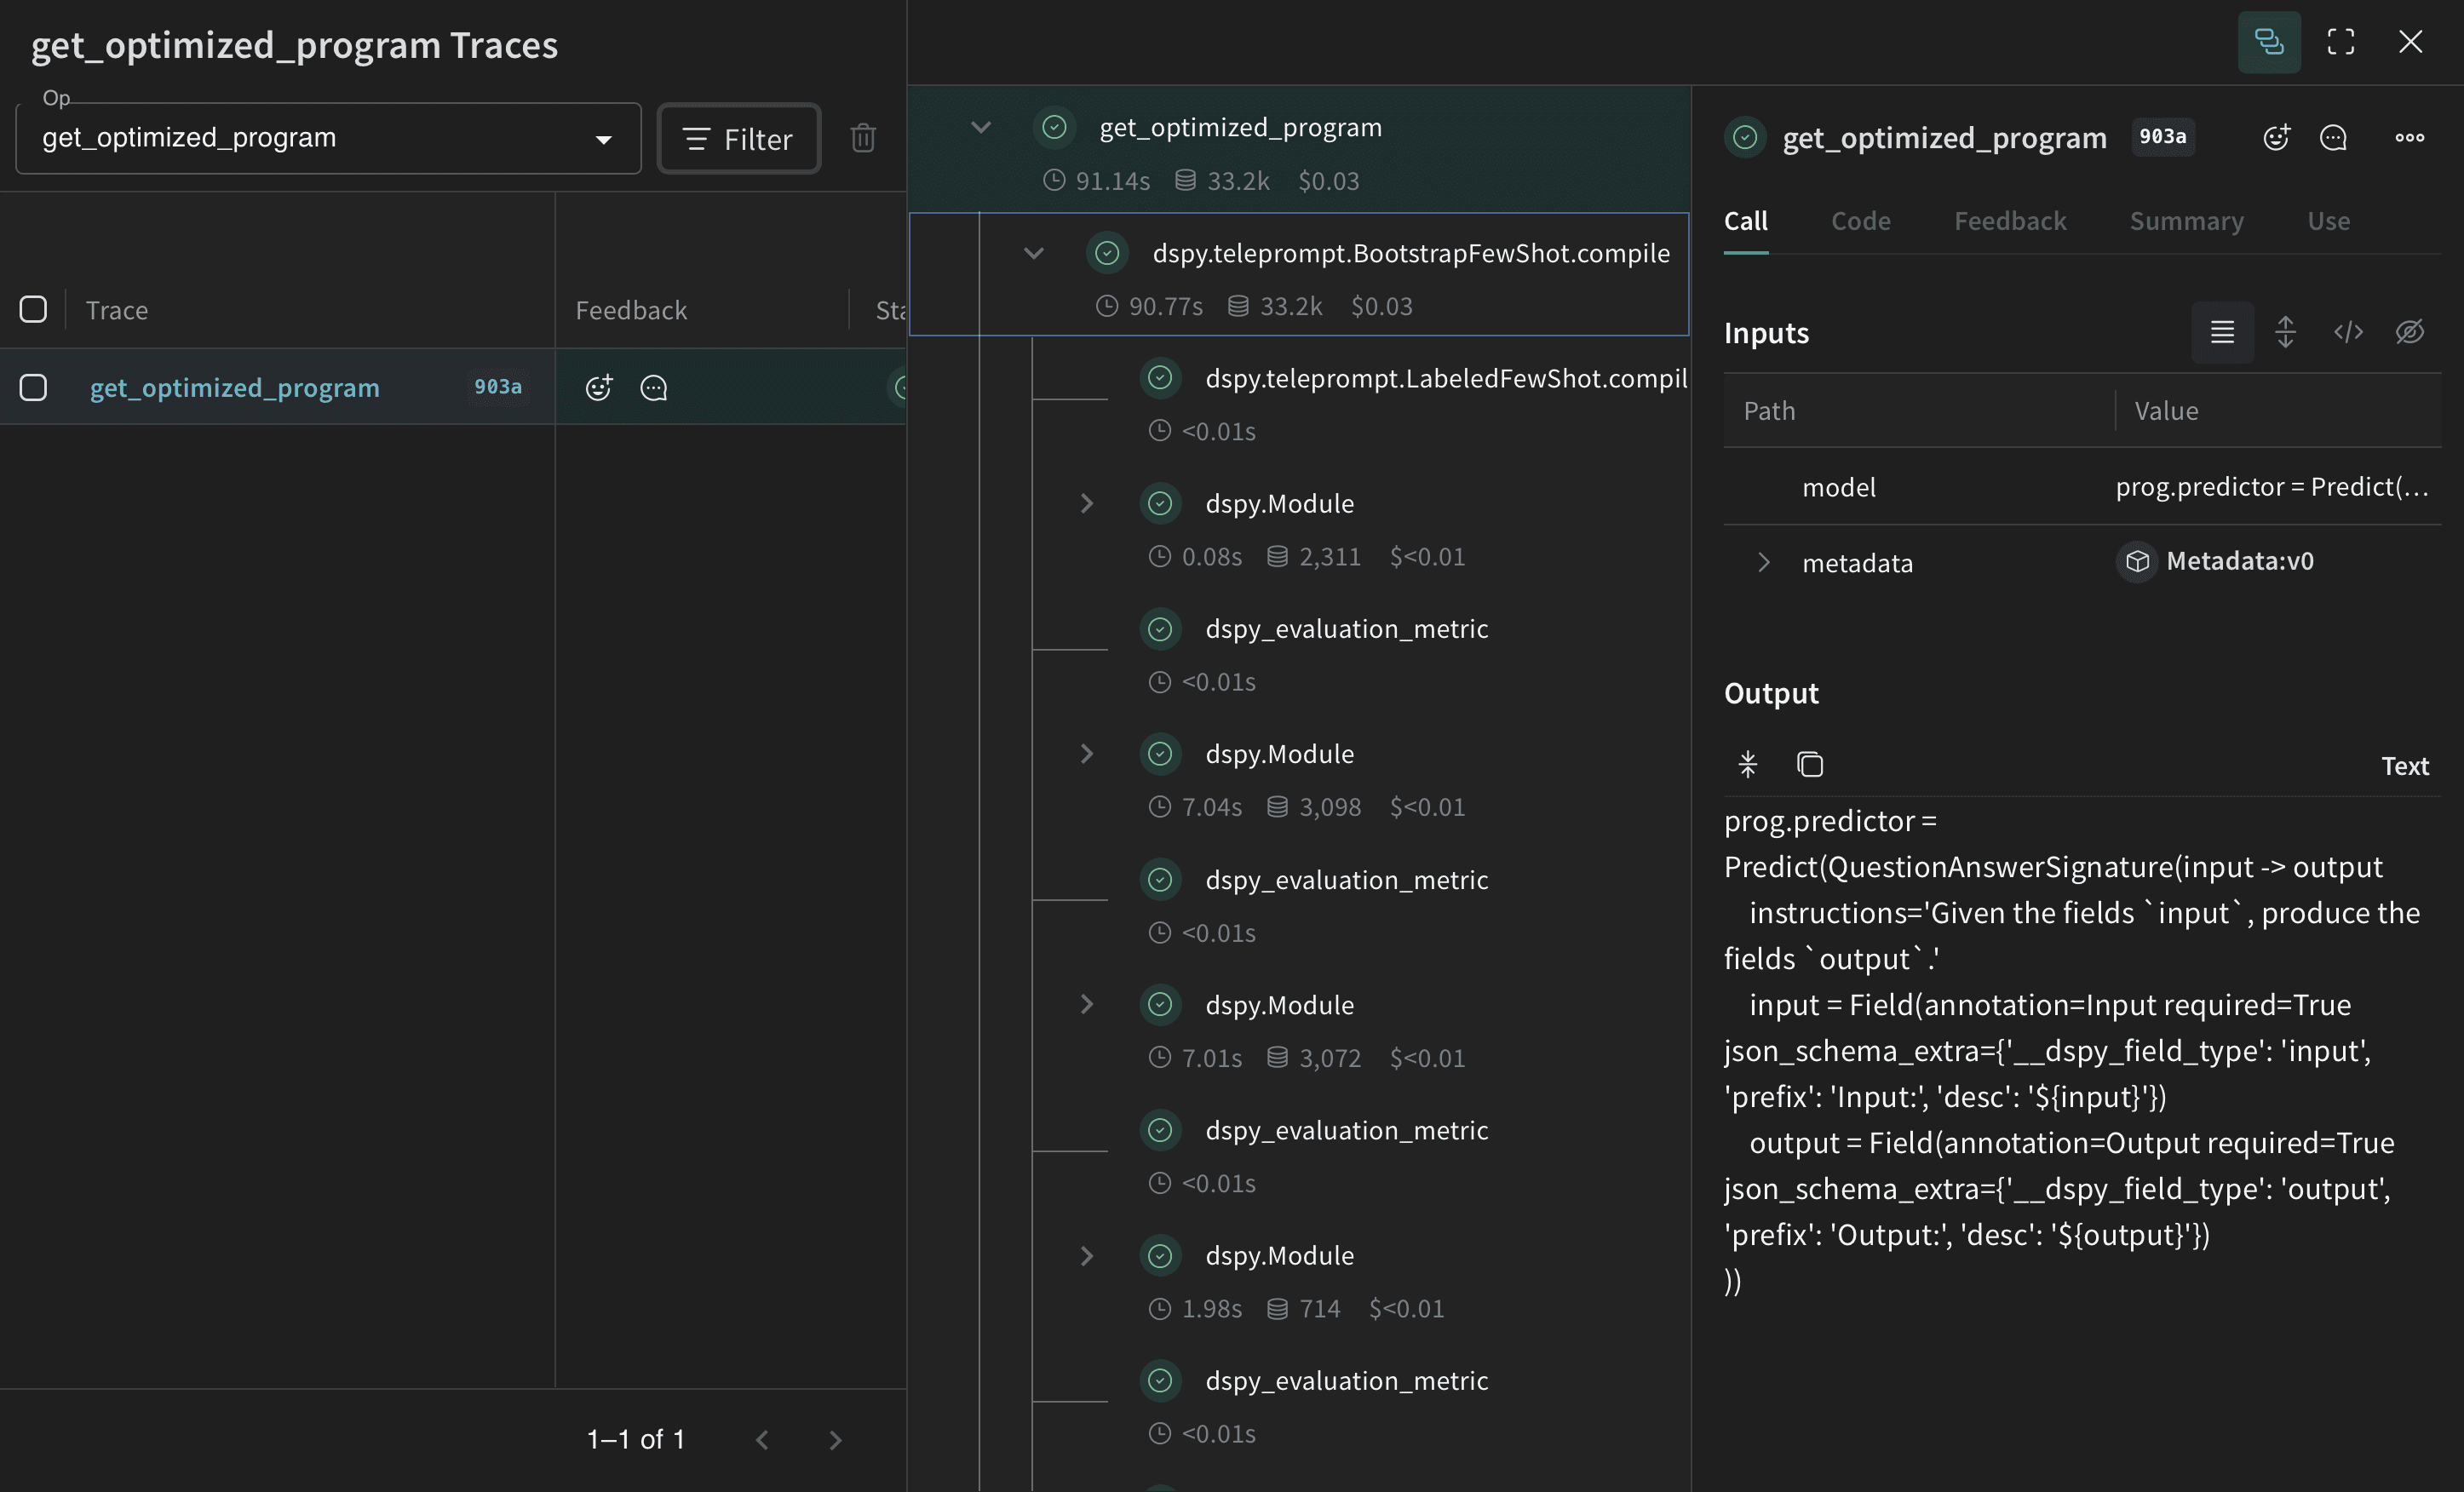
ベースラインのパフォーマンスを測定できたので、DSPy のオプティマイザーを適用し、その結果をベースラインと比較します。 ベースラインとなる DSPy プログラムが用意できたら、BootstrapFewShot オプティマイザーを使用して、因果推論におけるパフォーマンスを向上させます。このオプティマイザーは、指定したメトリクスが最大になるように DSPy プログラムのパラメーターを調整します。