이 가이드에서는 Weave를 사용하여 LlamaIndex 애플리케이션을 트레이스하고, 디버그하며, 평가하는 방법을 설명합니다. 가이드를 따라 하면 LlamaIndex Python 라이브러리를 통해 이루어지는 Call을 Weave가 자동으로 캡처하는 방식을 알 수 있으며, 별도의 맞춤형 로깅 코드를 작성하지 않고도 RAG 파이프라인, 에이전트 step, LLM Call을 모니터링할 수 있습니다. 이 가이드는 LlamaIndex로 LLM 애플리케이션을 구축하면서 디버깅, 성능 분석, 평가를 위해 워크플로를 한눈에 파악하고 싶은 개발자를 대상으로 합니다. LLM을 다루다 보면 디버깅은 피할 수 없습니다. 모델 Call이 실패하거나, 출력 형식이 잘못되거나, 중첩된 모델 Call 때문에 흐름을 파악하기 어려운 경우 문제의 원인을 정확히 찾아내기란 쉽지 않습니다. LlamaIndex 애플리케이션은 대개 여러 단계와 LLM Call로 구성되므로, 체인과 에이전트의 내부 동작을 이해하는 것이 매우 중요합니다. Weave는 LlamaIndex 애플리케이션의 트레이스를 자동으로 캡처하여 이 과정을 간소화합니다. 이를 통해 애플리케이션 성능을 모니터링하고 분석하여 LLM 워크플로를 디버그하고 최적화할 수 있습니다. 또한 Weave는 평가 워크플로도 지원합니다.

시작하기

시작하려면 스크립트 맨 앞에서 weave.init()을 호출하세요. 이렇게 하면 Weave가 초기화되고 이후의 모든 LlamaIndex Call에 대한 트레이스 캡처가 시작됩니다. weave.init()의 인수는 트레이스를 체계적으로 관리하는 데 도움이 되는 프로젝트 이름입니다.
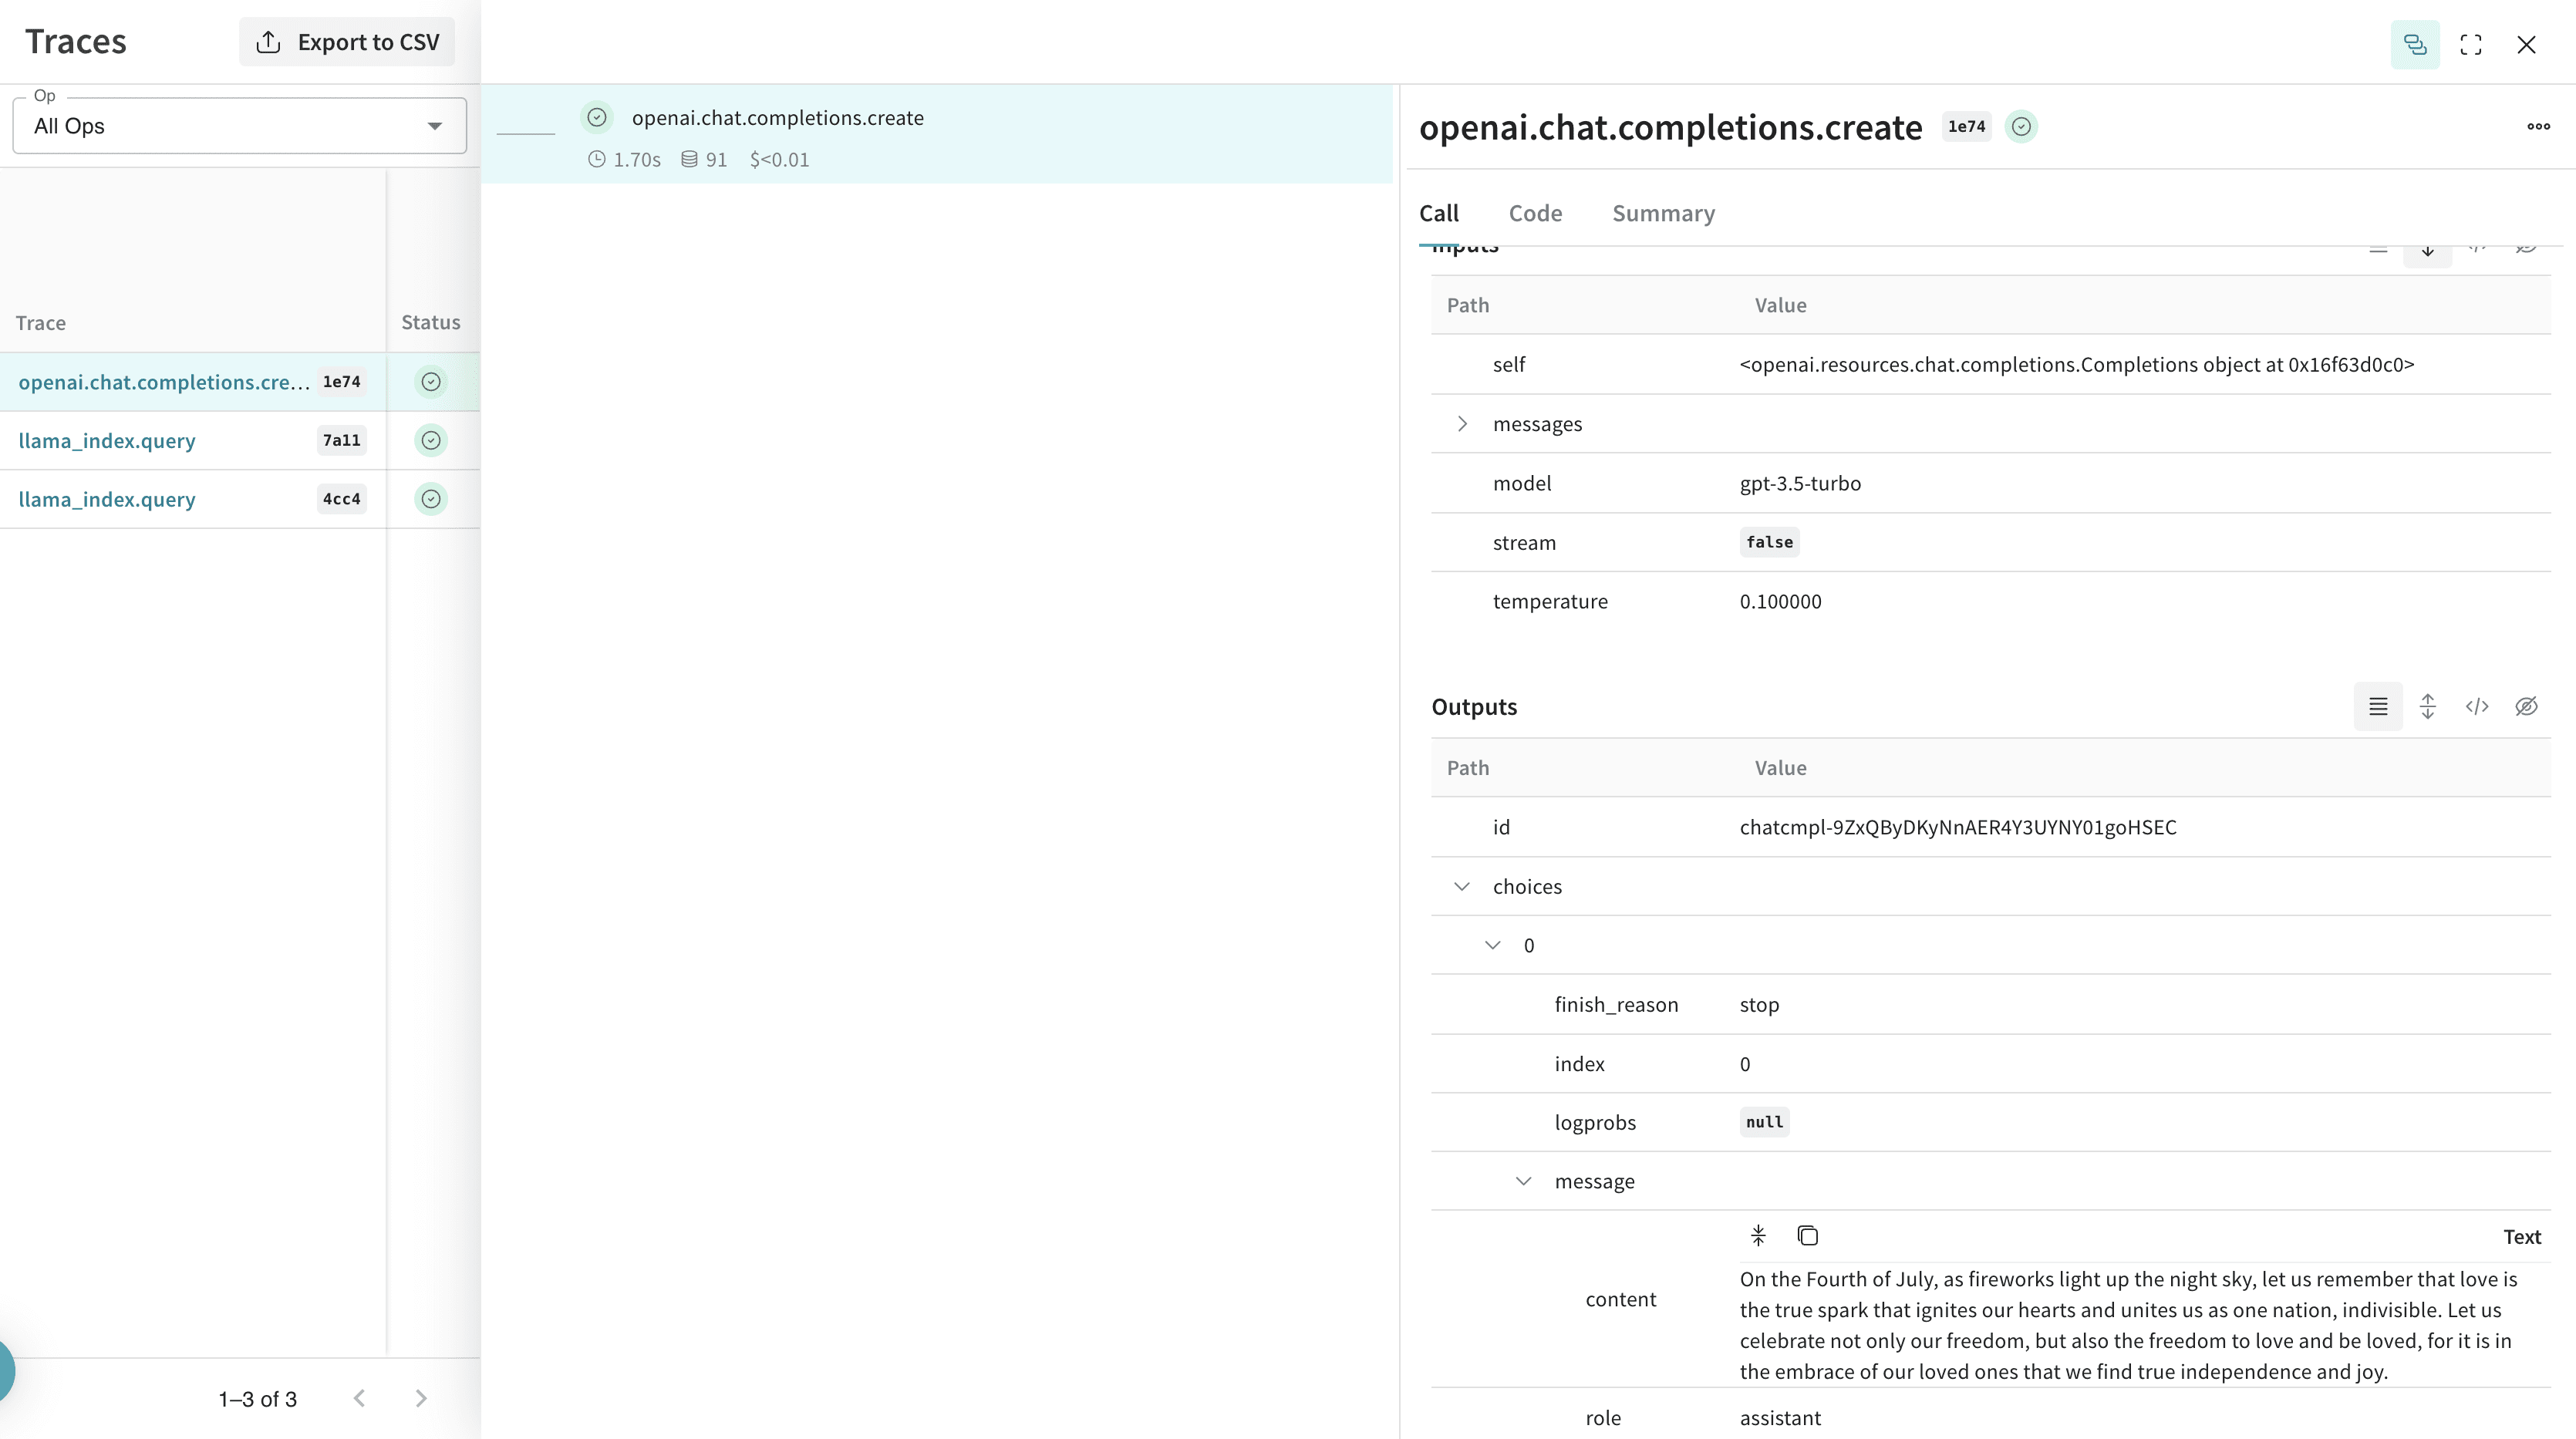
이전 예시는 내부적으로 OpenAI Call을 수행하는 기본 LlamaIndex 채팅 엔진을 생성합니다. 이 코드를 실행하면 Weave가 채팅 엔진의 실행 트레이스를 캡처하며, Weave 웹 인터페이스에서 이를 살펴볼 수 있습니다. 다음 트레이스를 확인하세요: simple_llamaindex.png

트레이스

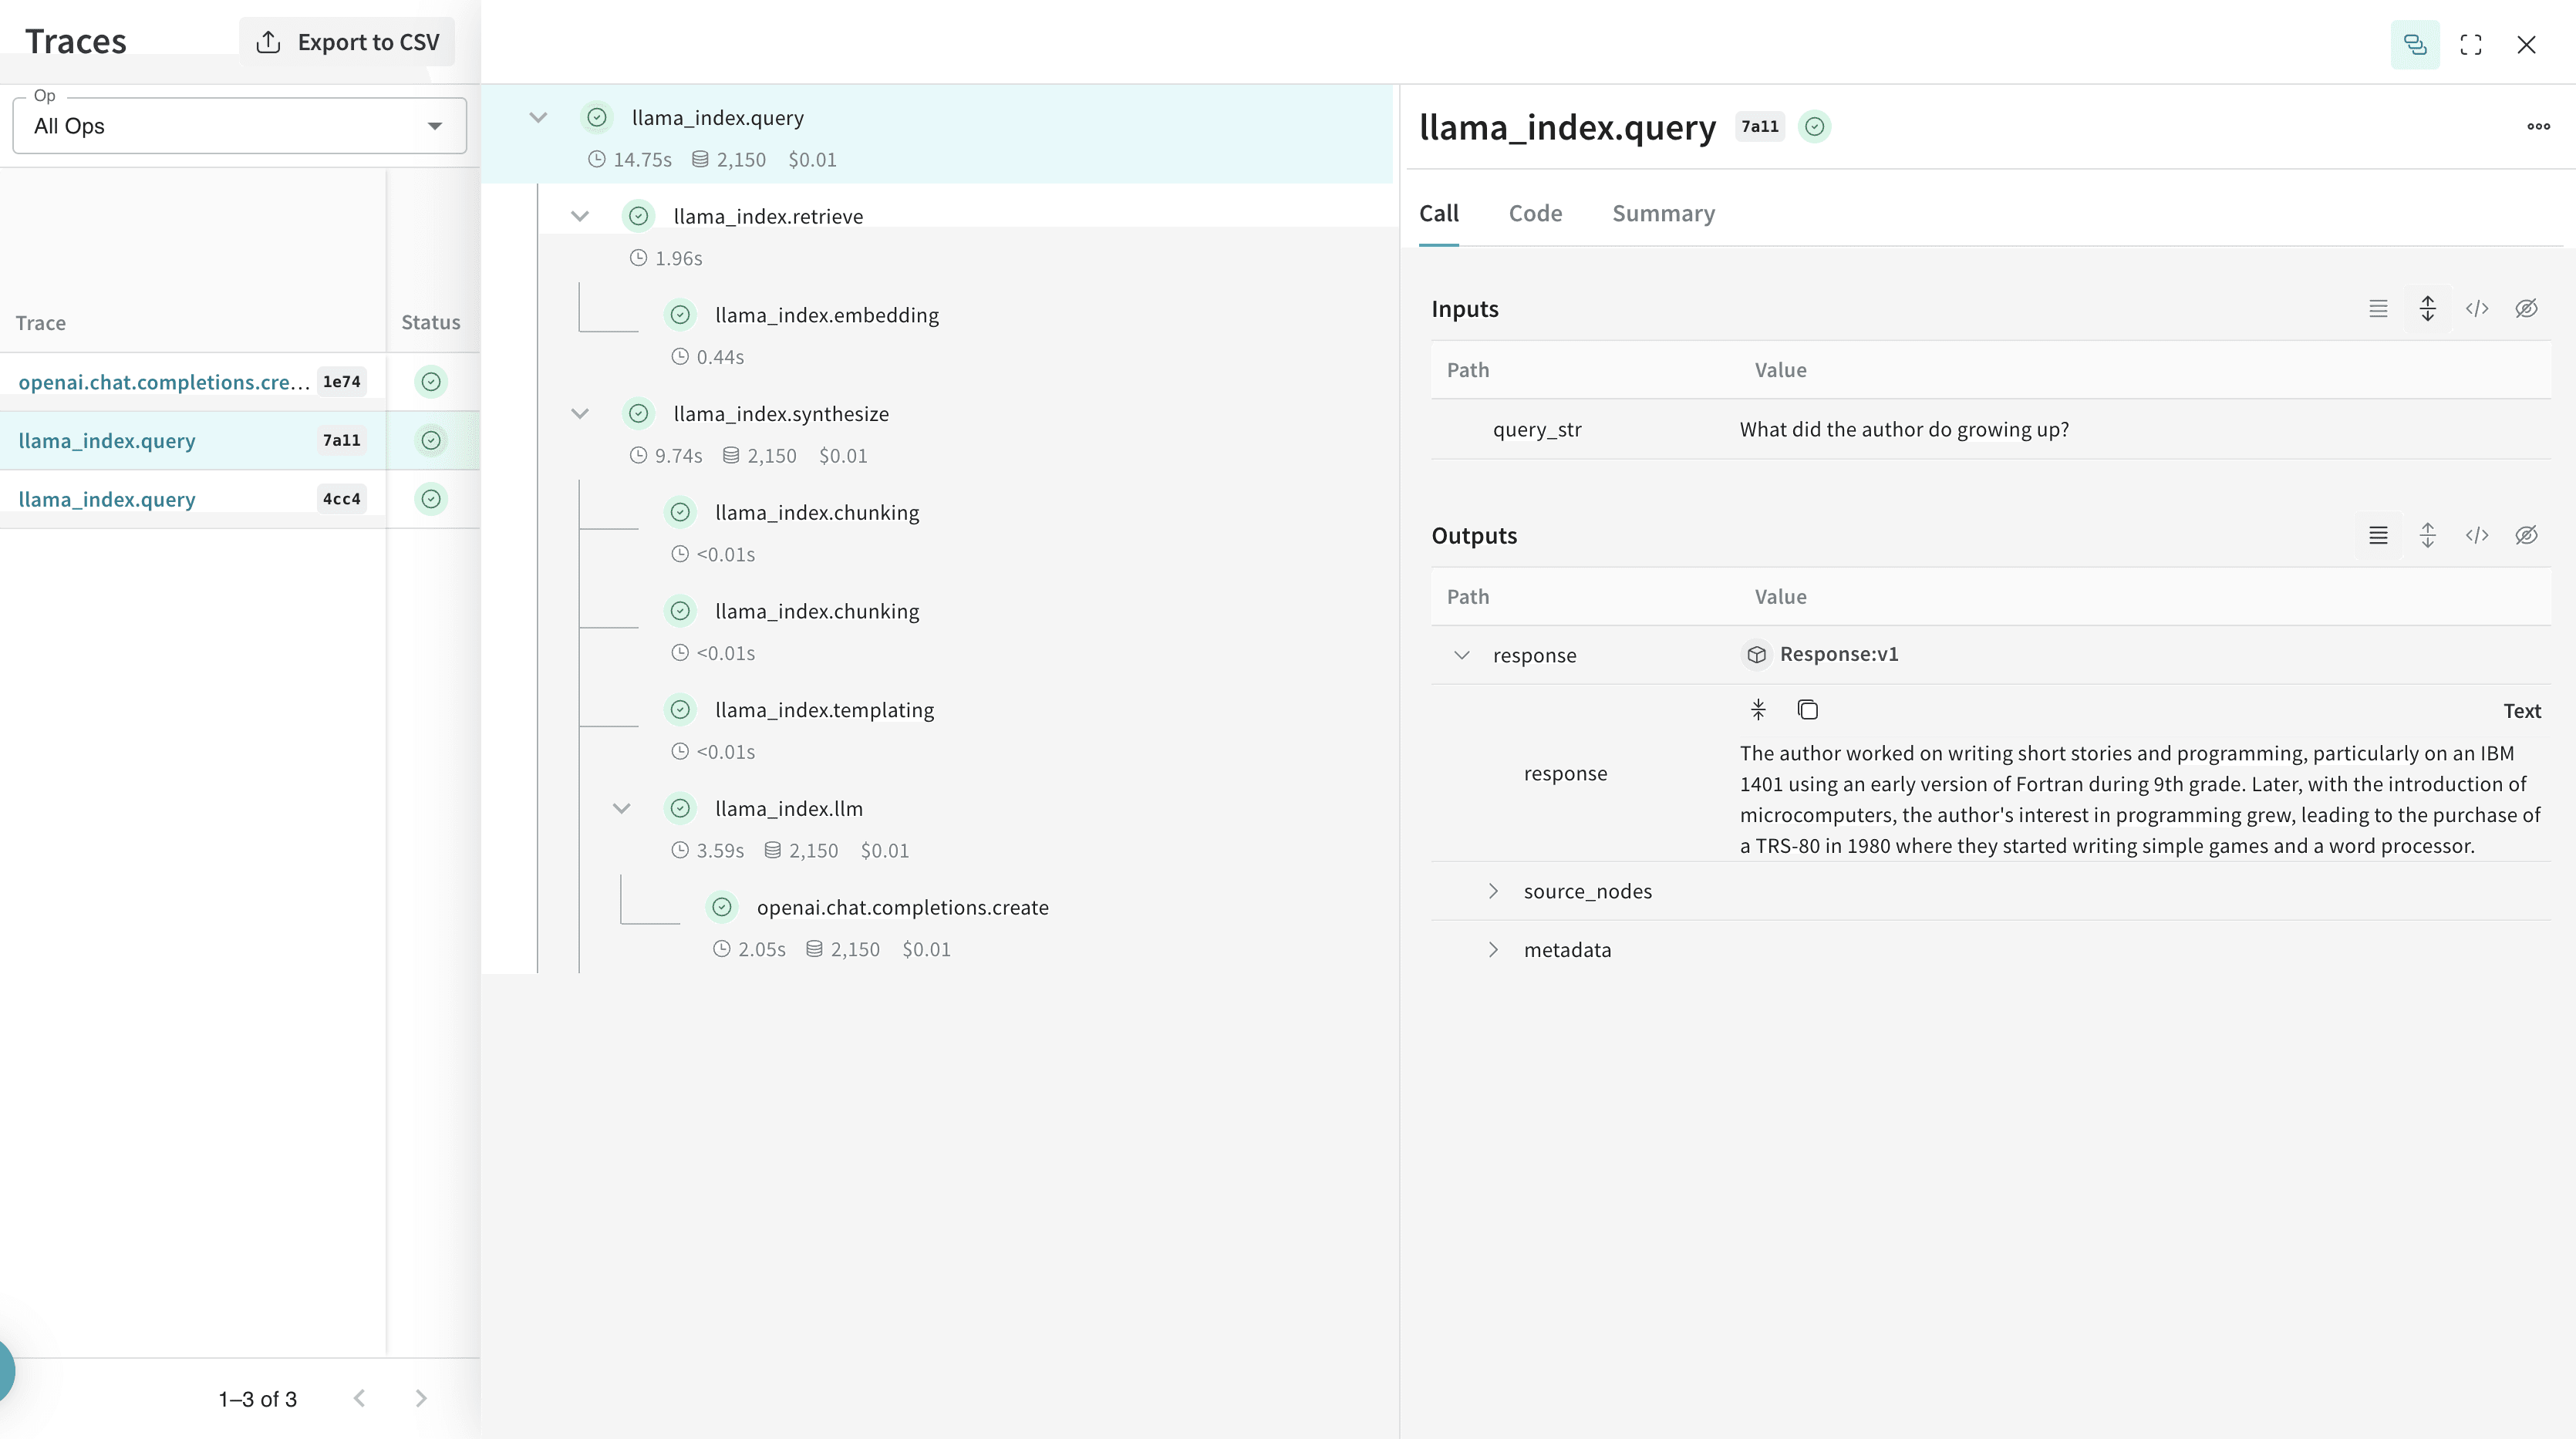
이 섹션에서는 Weave가 RAG 파이프라인과 같은 다단계 LlamaIndex 워크플로를 캡처하는 방법을 설명합니다. LlamaIndex는 데이터를 LLM과 손쉽게 연결할 수 있다는 점으로 잘 알려져 있습니다. 기본 RAG 애플리케이션에는 임베딩 단계, 검색 step, 응답 합성 단계가 필요합니다. 복잡도가 높아질수록 개발 환경과 프로덕션 환경 모두에서 개별 단계의 트레이스를 중앙 데이터베이스에 저장하는 것이 중요해집니다. 이러한 트레이스는 애플리케이션을 디버깅하고 개선하는 데 필수적입니다. Weave는 프롬프트 템플릿, LLM Call, 도구, 에이전트 step을 포함하여 LlamaIndex 라이브러리를 통해 이루어지는 모든 Call을 자동으로 추적합니다. 트레이스는 Weave 웹 인터페이스에서 확인할 수 있습니다. 다음 예시는 LlamaIndex의 Starter Tutorial (OpenAI)에 나오는 기본 RAG 파이프라인입니다.
트레이스 타임라인은 “이벤트”뿐만 아니라 실행 시간, 비용, 해당하는 경우 토큰 수도 캡처합니다. 트레이스를 드릴다운하여 각 단계의 입력과 출력을 확인하세요. llamaindex_rag.png

클릭 한 번으로 설정하는 관측성

이 섹션에서는 Weave 인테그레이션이 LlamaIndex의 내장 관측성 시스템과 연동되어 핸들러를 수동으로 설정할 필요가 없도록 하는 방식을 설명합니다. LlamaIndex는 프로덕션 환경에서 체계적인 LLM 애플리케이션을 구축할 수 있도록 클릭 한 번으로 설정하는 관측성을 제공합니다. Weave 인테그레이션은 LlamaIndex의 이 기능을 활용하여 WeaveCallbackHandler()를 llama_index.core.global_handler로 자동 설정합니다. LlamaIndex와 Weave 사용자는 weave.init([NAME_OF_PROJECT])로 Weave run을 초기화하기만 하면 됩니다.

더 쉽게 실험할 수 있도록 Model 만들기

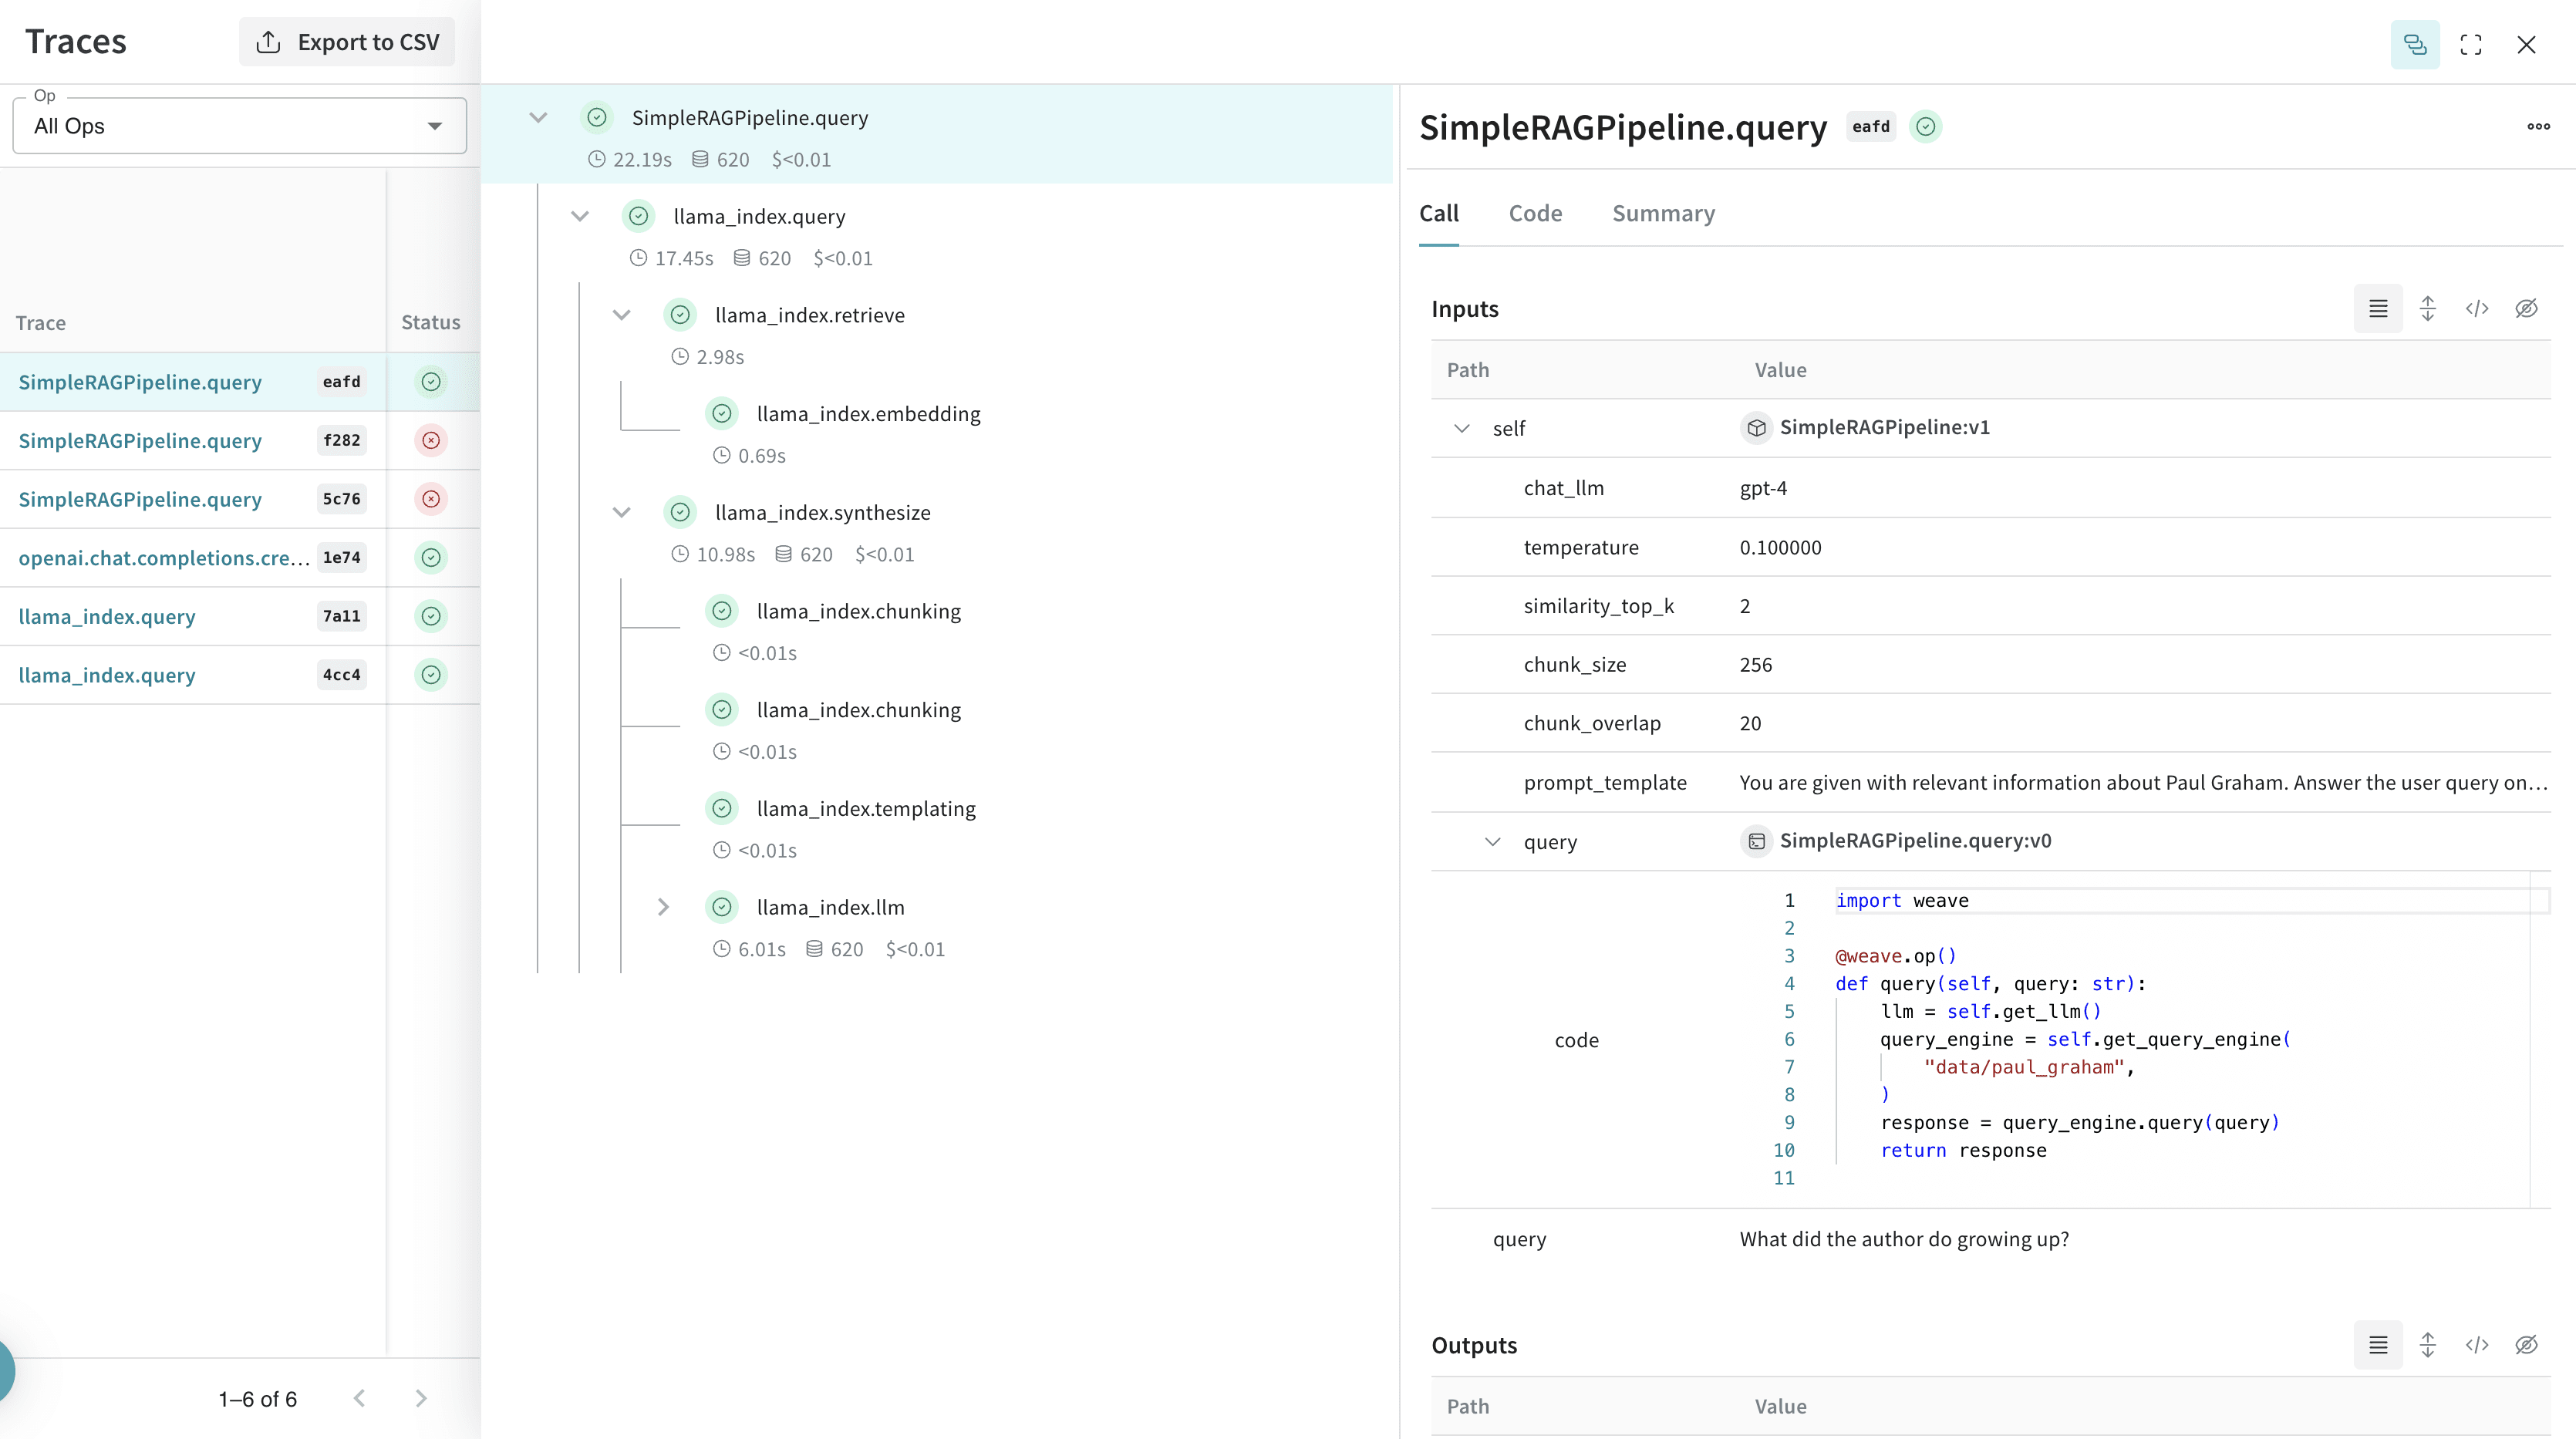
프롬프트, 모델 설정, 추론 매개변수 등 여러 컴포넌트가 있으면 다양한 사용 사례의 애플리케이션에서 LLM을 체계적으로 관리하고 평가하기가 어렵습니다. weave.Model을 사용하면 system 프롬프트나 사용하는 모델 같은 실험 세부 정보를 캡처하고 정리하여 서로 다른 개선 버전을 비교할 수 있습니다. 다음 예시는 weave/data 폴더의 데이터를 사용하여 WeaveModel에 LlamaIndex 쿼리 엔진을 구축하는 방법을 보여줍니다:
weave.Model을 상속한 SimpleRAGPipeline 클래스는 이 RAG 파이프라인의 주요 매개변수를 체계적으로 관리합니다. query 방법에 weave.op() 데코레이터를 적용하면 트레이싱이 활성화됩니다. 이 구조를 갖추면 Weave에서 RAG 파이프라인의 다양한 설정을 버전으로 관리하고 비교하고 평가할 수 있습니다. llamaindex_model.png

weave.Evaluation으로 평가

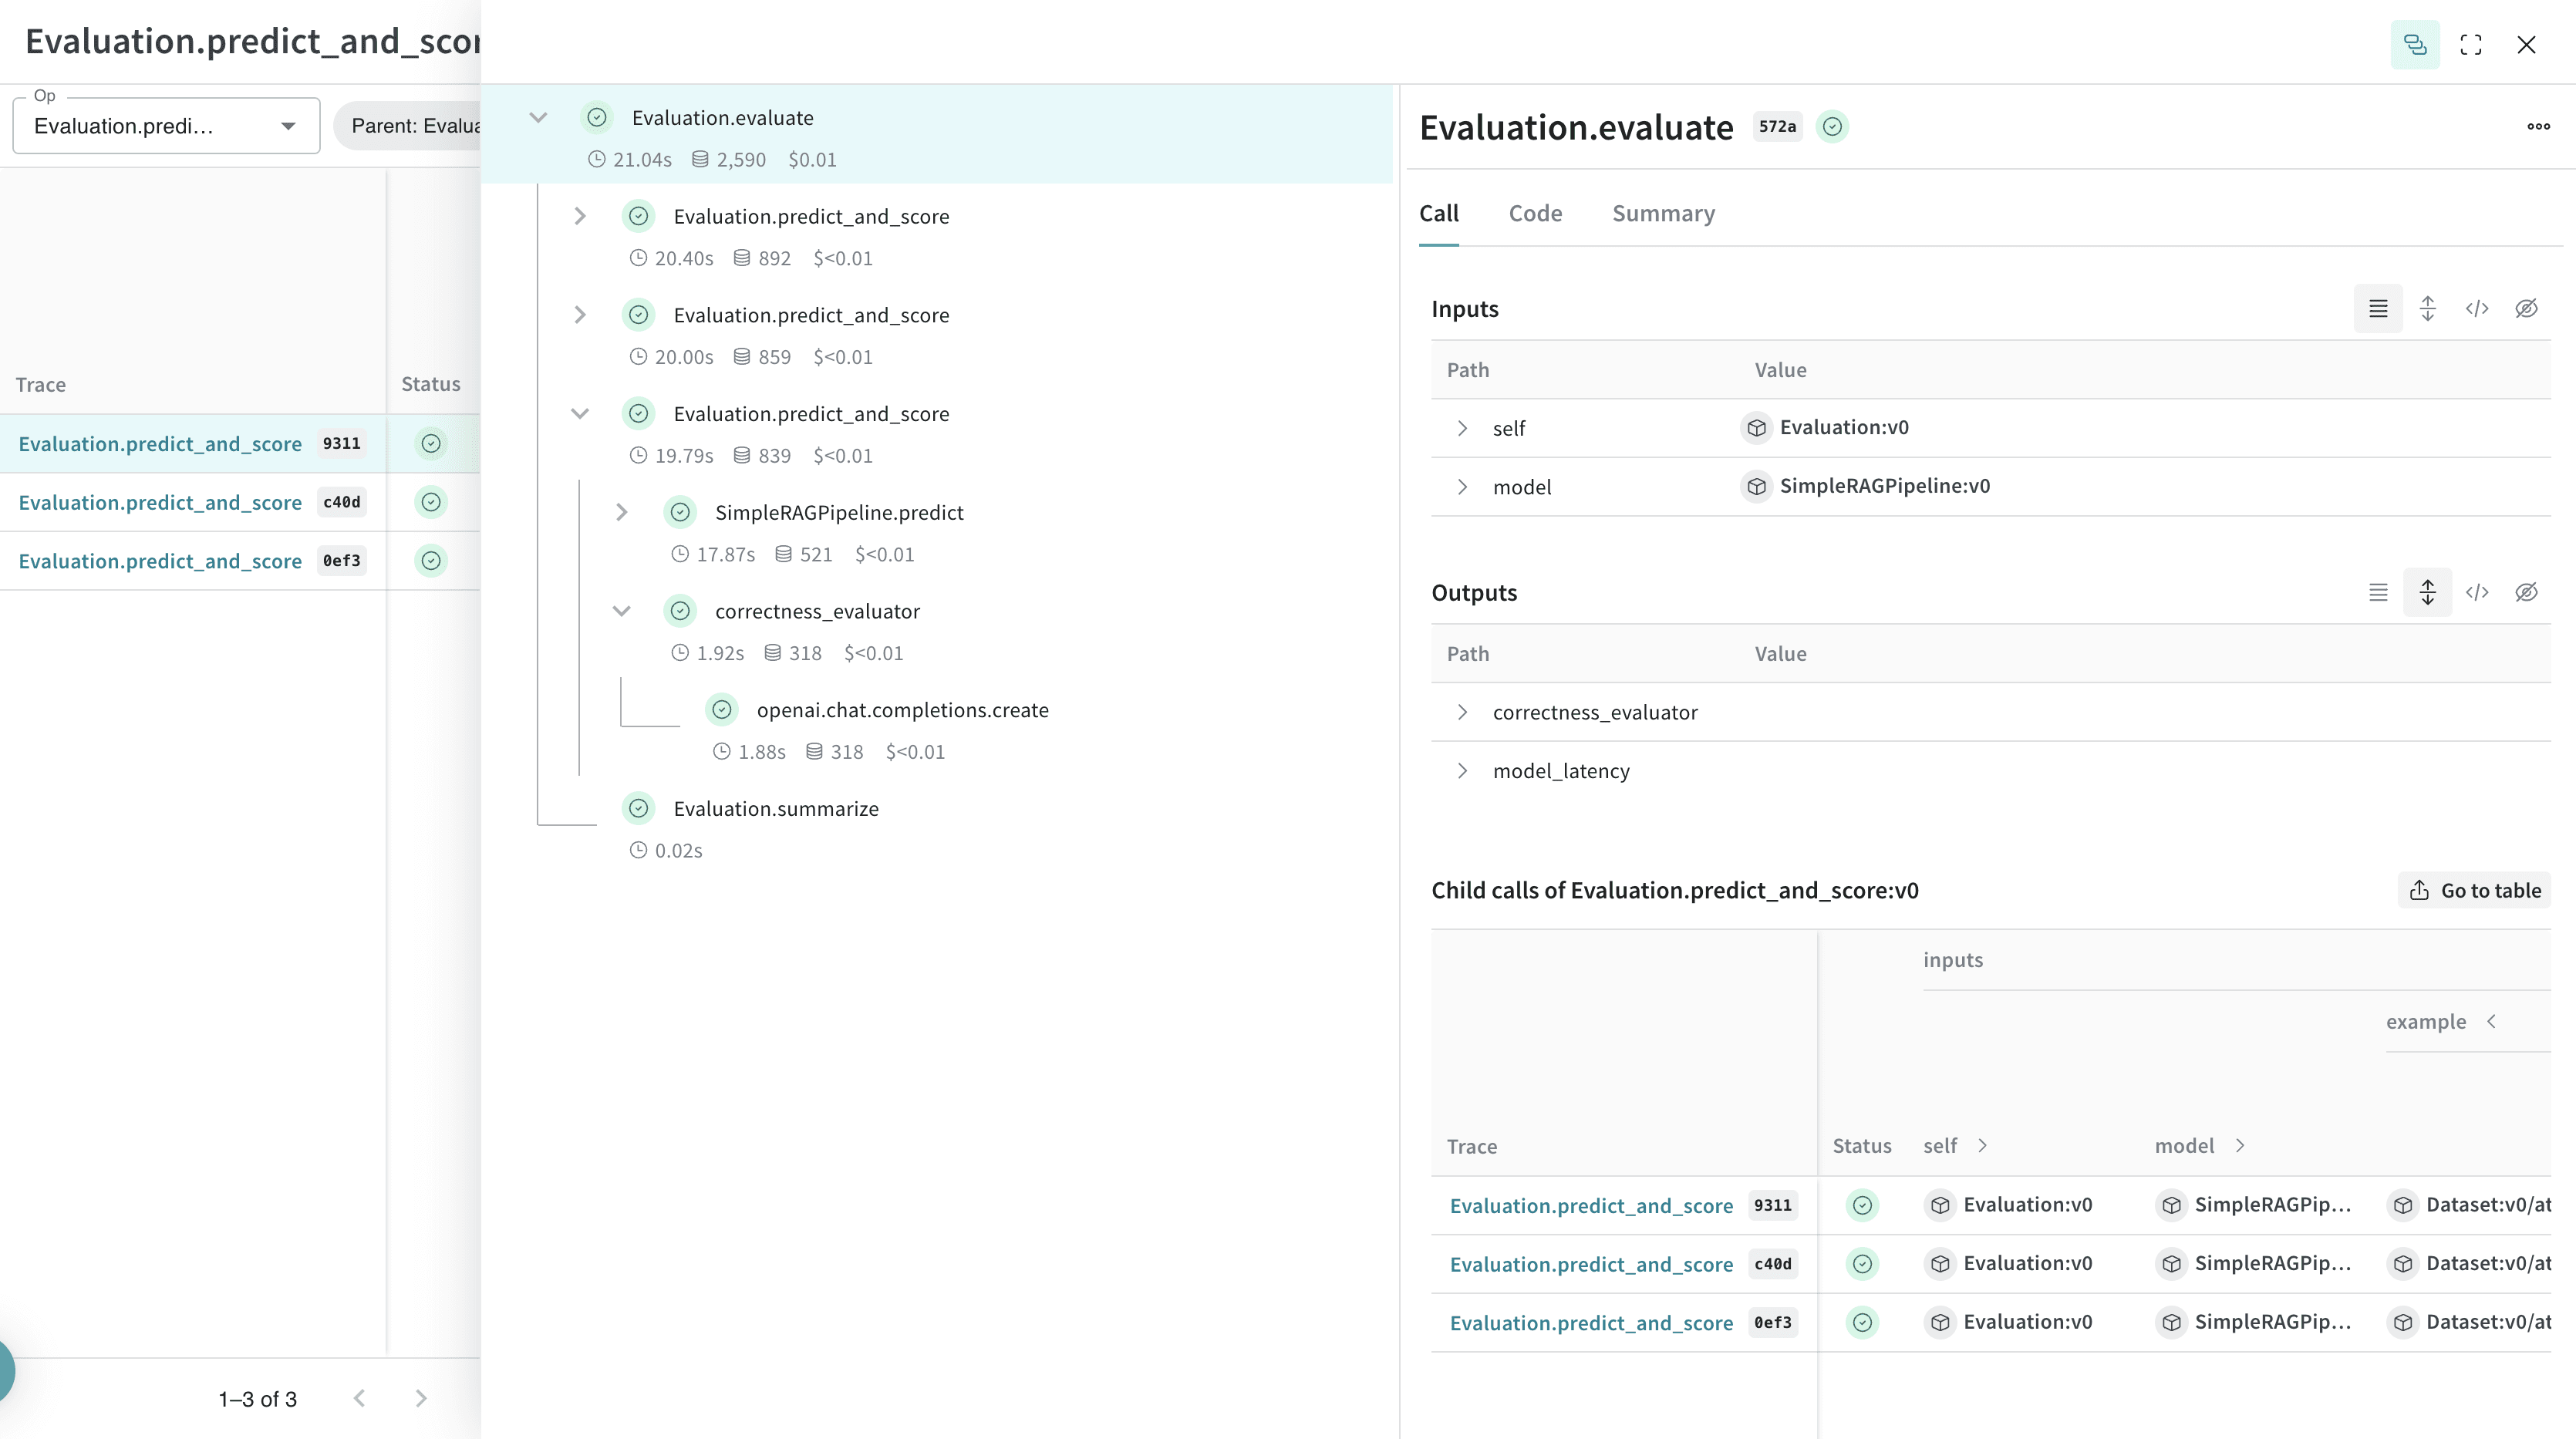
이 섹션에서는 고정된 데이터셋에서 모델의 성능을 측정하여 반복을 정량적으로 비교하는 방법을 보여줍니다. 평가는 애플리케이션의 성능을 측정하는 데 도움이 됩니다. weave.Evaluation 클래스를 사용하면 특정 작업이나 데이터셋에서 모델이 얼마나 잘 수행하는지 캡처할 수 있으며, 이를 통해 다양한 모델과 애플리케이션의 반복을 비교할 수 있습니다. 다음 예시는 이전 섹션에서 생성한 모델을 평가하는 방법을 보여줍니다:
이 평가는 이전 섹션의 예시를 기반으로 합니다. weave.Evaluation을 사용한 평가는 평가 데이터셋, Scorer 함수, weave.Model이 필요합니다. 이러한 요구 사항은 세 가지 주요 컴포넌트에 적용됩니다:
  • 평가 샘플 dict의 키는 Scorer 함수와 weave.Model의 predict 방법 인수와 일치해야 합니다.
  • weave.Model에는 predict, infer 또는 forward라는 이름의 방법이 있어야 합니다. 이 방법은 트레이싱을 위해 weave.op()로 데코레이트해야 합니다.
  • Scorer 함수는 weave.op()로 데코레이트해야 하며 output을 명명된 인수로 가져야 합니다.
llamaindex_evaluation.png Weave를 LlamaIndex와 통합하면 LLM 애플리케이션의 포괄적인 로깅과 모니터링을 보장할 수 있으며, 이를 통해 평가를 통한 디버깅과 성능 최적화를 간소화할 수 있습니다.
마지막 수정일 2026년 9월 30일