

- Python
- TypeScript
Weave 워크플로의 핵심은 _
Evaluation 객체_이며, 이 객체는 다음을 정의합니다.Evaluation을 정의한 후에는 Model 객체나 LLM 애플리케이션 로직이 담긴 맞춤형 함수를 대상으로 평가를 실행할 수 있습니다. .evaluate()를 호출할 때마다 _평가 run_이 트리거됩니다. Evaluation 객체는 설계도이고, 각 run은 그 설정에서 애플리케이션이 얼마나 잘 동작하는지 측정한 결과라고 생각하면 됩니다.Evaluation 객체 생성하기
평가 설정을 구성하려면 먼저 Evaluation 객체를 생성해야 합니다. Evaluation은 예시 데이터, 점수화 로직, 선택적 전처리로 구성되며, 이후 이 객체를 사용해 하나 이상의 평가를 실행합니다.
Weave는 각 예시를 애플리케이션에 전달한 뒤, 여러 맞춤형 점수화 함수로 출력에 점수를 매깁니다. 이를 통해 애플리케이션의 성능을 한눈에 파악할 수 있는 뷰와 함께, 개별 출력과 점수를 자세히 살펴볼 수 있는 풍부한 UI를 제공합니다.
맞춤형 이름 지정은 선택 사항이지만, 지정해 두면 Weights & Biases UI에서 여러 평가 설정과 run을 쉽게 구분할 수 있습니다. 평가가 하나뿐이라면 이 섹션은 건너뛰어도 됩니다.
선택 사항: 맞춤형 이름 지정
- Python
- TypeScript
평가 플로우에서 직접 지정할 수 있는 이름은 두 가지 유형입니다.
- Evaluation 객체 이름 (
evaluation_name): 설정한Evaluation객체에 영구적으로 붙는 레이블입니다. - 평가 run 표시 이름 (
__weave["display_name"]): 특정 평가 실행에 붙는 레이블로, UI에 표시됩니다.
Evaluation 객체 이름 지정
Evaluation 객체 자체에 이름을 지정하려면 Evaluation 클래스에 evaluation_name 매개변수를 전달하세요. 이 이름을 사용하면 코드와 UI 목록에서 Evaluation을 쉽게 파악할 수 있습니다.개별 평가 run 이름 지정
특정 평가 run(evaluate() 호출)에 이름을 지정하려면 display_name이 포함된 __weave 딕셔너리를 사용하세요. 이 값에 따라 해당 run이 UI에 표시되는 이름이 달라집니다.테스트 예시 데이터셋 정의하기
먼저 평가할 예시 컬렉션을 담은 Dataset 객체 또는 예시 목록을 정의하세요. 이러한 예시는 테스트 주도 개발(TDD)의 단위 테스트처럼, 테스트하려는 실패 사례인 경우가 많습니다.- Python
- TypeScript
다음은 딕셔너리 목록으로 데이터셋을 정의한 예시입니다.
점수화 함수 정의하기
다음으로, 하나 이상의 점수화 함수를 만드세요. Weave는 이 함수를 사용해Dataset의 각 예시에 점수를 매깁니다.
- Python
- TypeScript
각 점수화 함수에는 선택: 맞춤형
애플리케이션에 따라 맞춤형
output 매개변수가 있어야 하며, 점수가 담긴 딕셔너리를 반환해야 합니다. 필요하다면 예시의 다른 입력을 함께 받을 수도 있습니다.점수화 함수에는 output 키워드 인수가 반드시 있어야 하지만, 나머지 인수는 사용자가 정의하며 데이터셋 예시에서 값을 가져옵니다. Weave는 인수 이름과 일치하는 딕셔너리 키를 사용해 필요한 키만 가져옵니다.다음 예시의 Scorer 함수 match_score1은 examples 딕셔너리의 expected 값을 사용해 점수를 매깁니다.선택: 맞춤형 Scorer 클래스 정의하기
애플리케이션에 따라 맞춤형 Scorer 클래스가 필요할 수 있습니다. 예를 들어, 특정 매개변수(예: 채팅 모델, 프롬프트)와 행별 점수화 방식, 집계 점수 계산 방식을 정해 둔 표준화된 LLMJudge 클래스를 만들 수 있습니다.자세한 내용은 RAG 애플리케이션의 모델 기반 평가에서 Scorer 클래스 정의에 관한 튜토리얼을 참조하세요.평가할 모델 또는 함수 정의하기
- Python
- TypeScript
평가 실행하기
Evaluation 객체, 데이터셋, Scorer, 모델을 모두 정의했다면 이제 평가를 실행하고 결과를 Weave에 캡처할 수 있습니다. 평가를 실행하려면 Evaluation 객체에서 .evaluate()를 호출하세요.
- Python
- TypeScript
전체 평가 코드 예시
다음 예시는 앞의 모든 단계를 실행 가능한 하나의 스크립트로 통합한 것입니다. 평가 워크플로를 자신의 애플리케이션에 맞게 조정할 때 레퍼런스로 활용하세요.- Python
- TypeScript
다음 코드 샘플은 평가 run의 시작부터 종료까지 전체 과정을 보여 줍니다.
match_score1 및 match_score2 점수화 함수는 examples 딕셔너리를 사용하여 prompt 값을 기준으로 MyModel을 평가하고, 맞춤형 함수 function_to_evaluate도 평가합니다. Model과 함수의 평가 run은 모두 asyncio.run(evaluation.evaluate())로 호출합니다.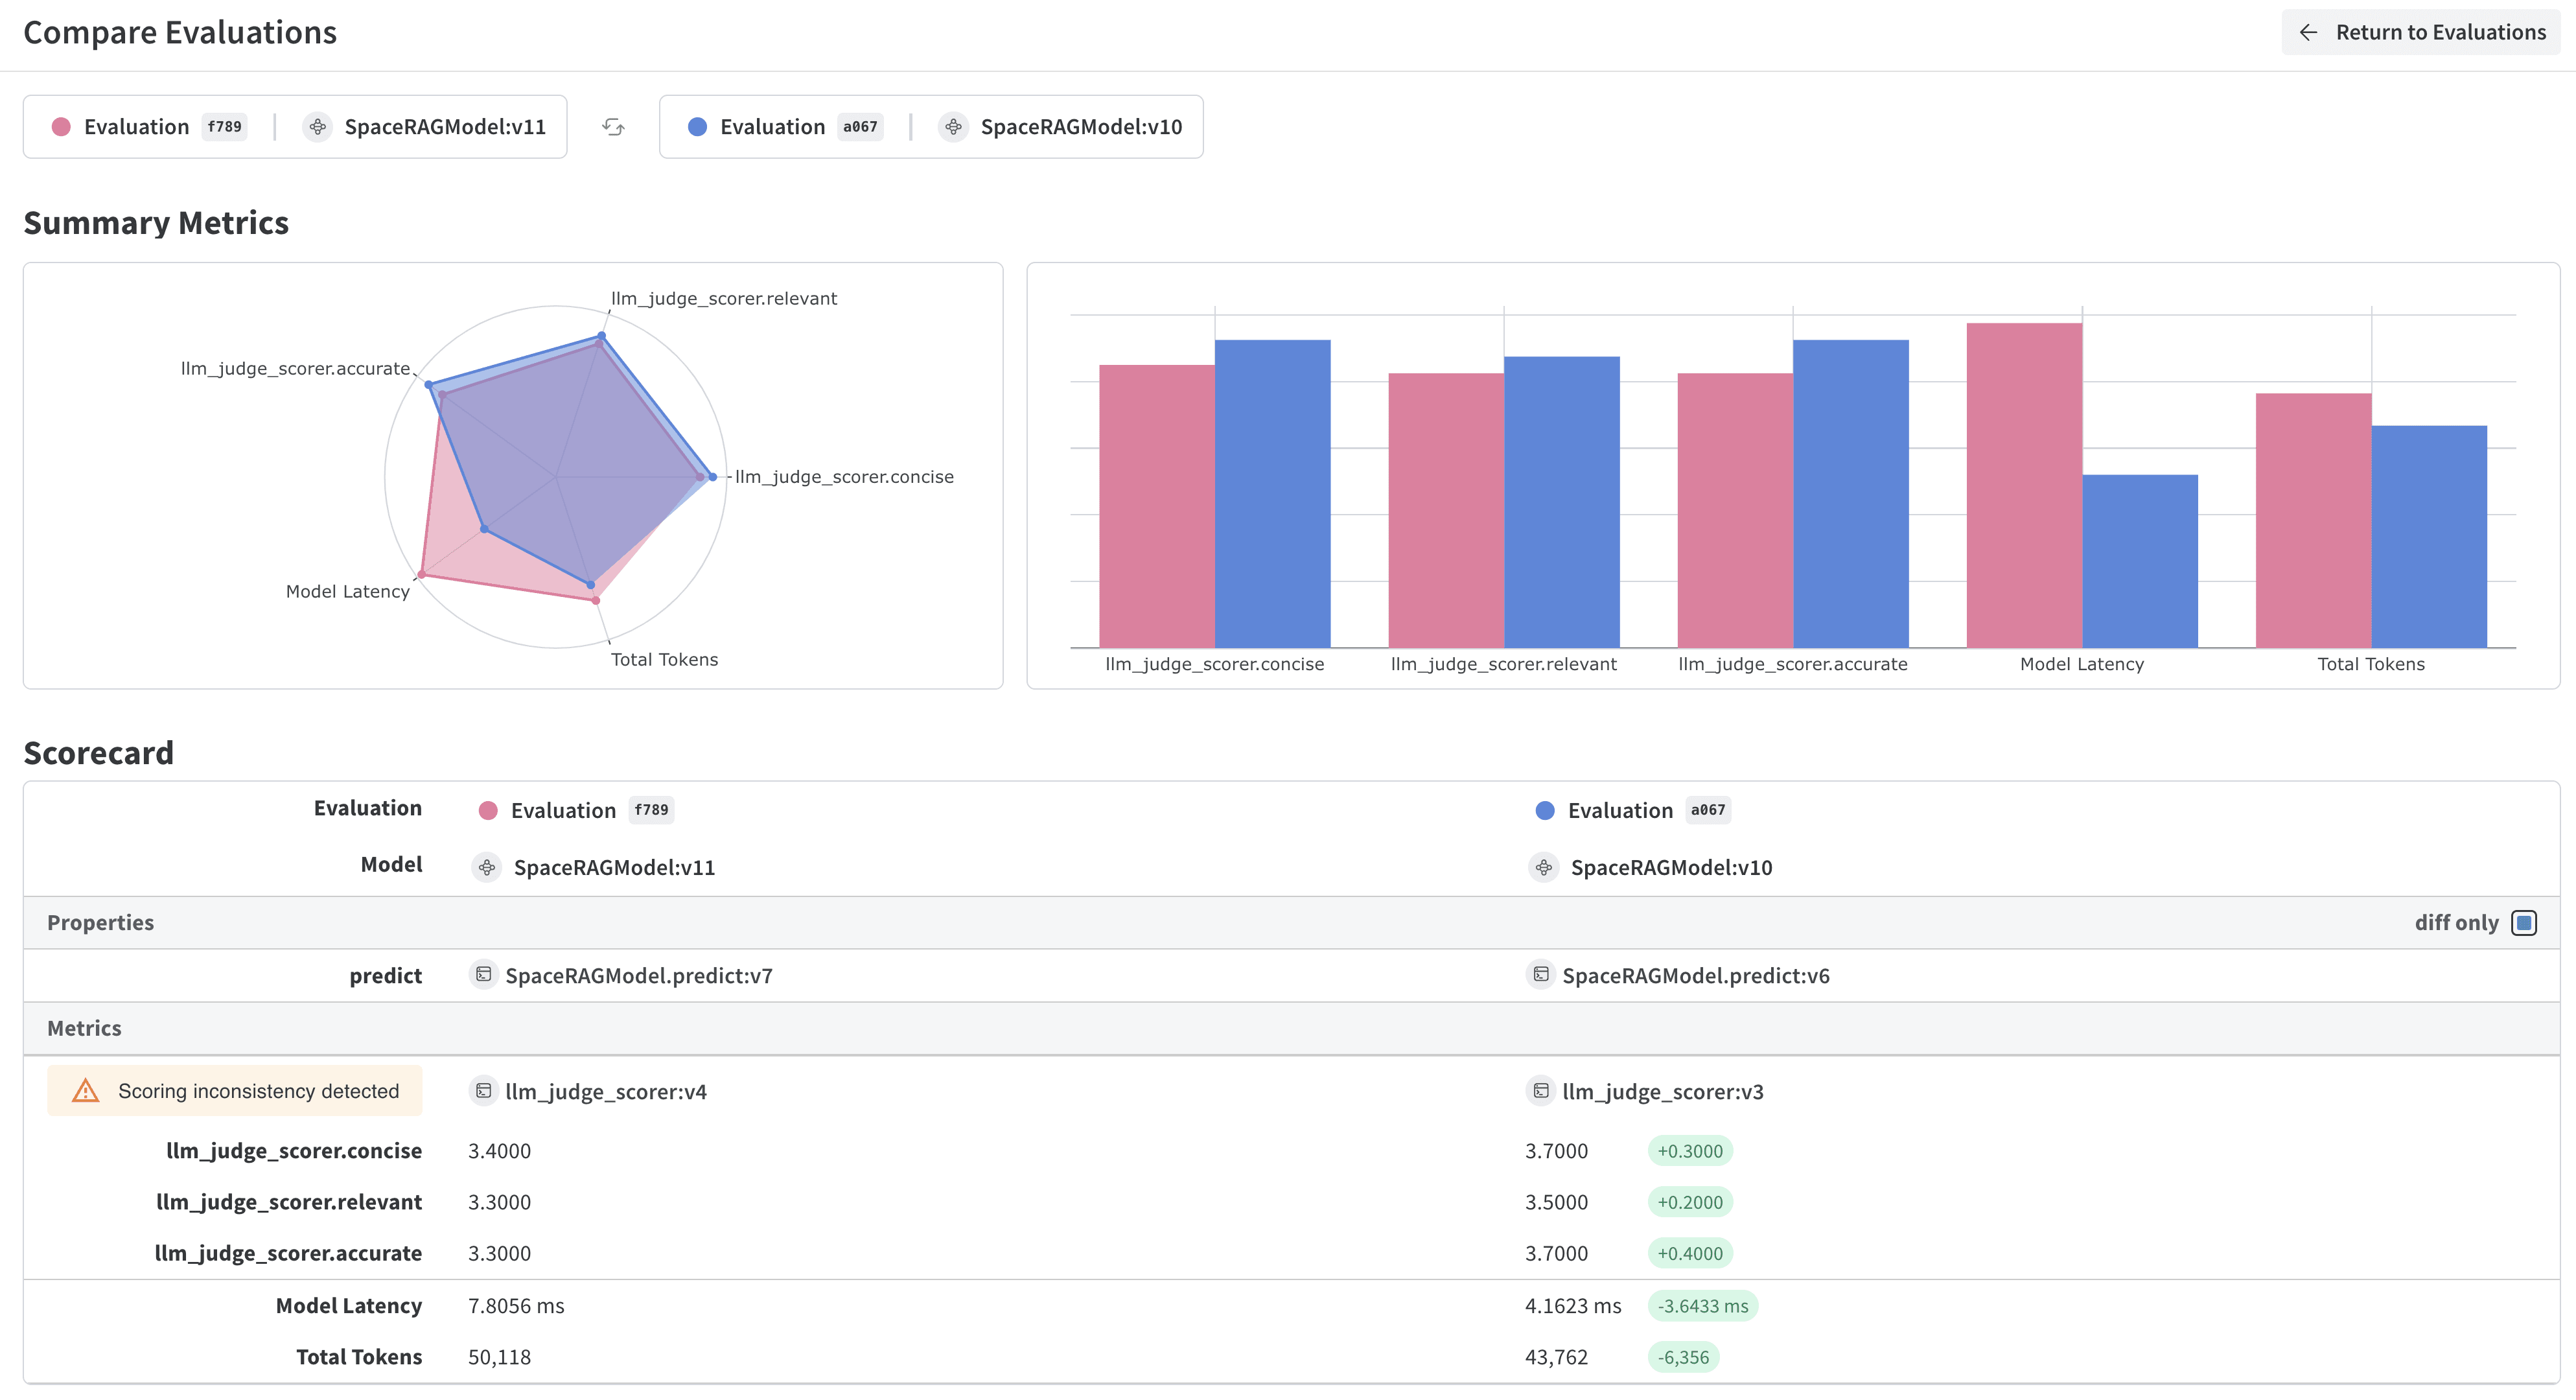
고급 평가 사용법
다음 섹션에서는 데이터셋 전처리, 서드파티 데이터셋 인테그레이션, 저장된 UI 뷰, 명령형 로깅 API 등 더 복잡한 평가 워크플로에 활용할 수 있는 선택 기능을 설명합니다.평가 전에 데이터셋 행 형식 지정하기
- Python
- TypeScript
preprocess_model_input 매개변수를 사용하면 Weave가 데이터셋 예시를 평가 함수에 전달하기 전에 예시를 변환할 수 있습니다. 이 매개변수는 다음과 같은 경우에 유용합니다.- 모델이 기대하는 입력에 맞게 필드 이름을 변경해야 하는 경우
- 데이터를 올바른 형식으로 변환해야 하는 경우
- 필드를 추가하거나 제거해야 하는 경우
- 각 예시에 추가 데이터를 로드해야 하는 경우
preprocess_model_input을 사용하여 필드 이름을 변경하는 예시입니다.input_text 필드를 가진 예시가 들어 있지만, 평가 함수는 question 매개변수를 기대합니다. preprocess_example 함수가 각 예시의 필드 이름을 변경해 주므로 평가가 올바르게 동작합니다.전처리 함수는 다음과 같이 동작합니다.- 데이터셋에서 가공되지 않은 원본 예시를 받습니다.
- 모델이 기대하는 필드를 담은 딕셔너리를 반환합니다.
- Weave가 각 예시를 평가 함수에 전달하기 전에 실행됩니다.
평가에서 HuggingFace 데이터셋 사용하기
- Python
- TypeScript
Weave 평가에서 HuggingFace Datasets를 사용하려면
preprocess_model_input을 우회 방법으로 활용할 수 있습니다.자세한 내용은 평가에서 HuggingFace 데이터셋 사용하기 쿡북을 참조하세요.저장된 뷰
Evals table 설정, 필터, 정렬을 저장된 뷰 형태로 저장해 두면 원하는 설정에 빠르게 액세스할 수 있습니다. 저장된 뷰는 UI와 Python SDK에서 설정하고 액세스할 수 있습니다. 자세한 내용은 저장된 뷰를 참조하세요.명령형 평가 (EvaluationLogger)
더 유연한 평가 프레임워크가 필요하다면 Weave의 EvaluationLogger를 참고하세요. EvaluationLogger는 Python과 TypeScript 모두에서 사용할 수 있으며, 복잡한 워크플로를 더 유연하게 구성할 수 있습니다. 반면 표준 평가 프레임워크는 더 체계적인 구조와 가이드를 제공합니다.