

Serverless Inference
_Serverless Inference_는 W&B Weave와 OpenAI 호환 API를 통해 오픈 소스 파운데이션 모델에 대한 액세스를 제공합니다. 이 가이드에서는 API와 Weights & Biases UI에서 Serverless Inference를 호출하는 방법과 Weave로 해당 Call을 추적, 평가, 모니터링하는 방법을 설명합니다. Serverless Inference로 다음 작업을 수행할 수 있습니다:- 호스팅 공급자에 가입하거나 모델을 직접 호스팅하지 않고 AI 애플리케이션과 에이전트를 개발합니다.
- Weave 플레이그라운드에서 지원되는 모델을 사용해 봅니다.
이 가이드에서는 다음 정보를 제공합니다:
사전 요구 사항
Serverless Inference 서비스에 API 또는 Weights & Biases UI를 통해 액세스하려면 다음이 필요합니다:- CoreWeave Forge 계정. 계정에 가입하세요.
- API 키. User Settings에서 API 키를 생성하세요.
- Weights & Biases 프로젝트.
- Python을 통해 Inference 서비스를 사용하는 경우, Python에서 API를 사용하기 위한 추가 사전 요구 사항을 참조하세요.
Python에서 API를 사용하기 위한 추가 사전 요구 사항
Python에서 Inference API를 사용하려면 먼저 일반 사전 요구 사항을 완료하세요. 그런 다음 로컬 환경에openai 및 weave 라이브러리를 설치하세요. openai 라이브러리는 Inference 엔드포인트를 호출하는 데 사용하는 OpenAI 호환 클라이언트를 제공하며, weave 라이브러리로는 이러한 Call을 트레이스하고 평가할 수 있습니다.
weave 라이브러리는 Weave를 사용하여 LLM application을 트레이스할 때만 필요합니다. Weave 시작에 대한 정보는 Weave 퀵스타트를 참조하세요.Weave로 Serverless Inference 서비스를 사용하는 방법을 보여주는 사용 예시는 API 사용 예시를 참조하세요.API 사양
다음 섹션에서는 API 사양 정보와 API 사용 예시를 제공하므로, Inference 서비스를 자체 애플리케이션이나 스크립트에서 프로그래밍 방식으로 호출할 수 있습니다.엔드포인트
다음 엔드포인트를 통해 Inference 서비스에 액세스하세요:사용 가능한 메서드
Inference 서비스는 다음 API 메서드를 지원합니다:Chat Completion
주요 API 방법은/chat/completions이며, 지원되는 모델에 메시지를 보내고 Chat Completion을 받기 위한 OpenAI 호환 요청 형식을 지원합니다. Weave로 Serverless Inference 서비스를 사용하는 방법을 보여 주는 사용 예시는 API 사용 예시를 참조하세요.
Chat Completion을 생성하려면 다음이 필요합니다:
- Inference 서비스의 기본 URL
https://api.inference.wandb.ai/v1 - W&B API 키
<your-api-key> - W&B entity 및 프로젝트 이름
<your-team>/<your-project> - 사용할 모델의 ID로, 다음 중 하나:
meta-llama/Llama-3.1-8B-Instructdeepseek-ai/DeepSeek-V3-0324meta-llama/Llama-3.3-70B-Instructdeepseek-ai/DeepSeek-R1-0528meta-llama/Llama-4-Scout-17B-16E-Instructmicrosoft/Phi-4-mini-instruct
- Bash
- Python
지원되는 모델 목록
API를 사용하여 사용 가능한 모든 모델과 해당 ID를 쿼리하세요. 이는 모델을 동적으로 선택하거나 환경에서 사용 가능한 항목을 검사하는 데 유용합니다.- Bash
- Python
사용 예시
다음 섹션에서는 Weave로 Serverless Inference를 사용하는 방법을 보여주는 여러 예시를 제공합니다. 기본 예시에서 단일 모델 Call을 트레이싱한 다음, 고급 예시에서 여러 모델을 평가하고 비교하세요.기본 예시: Weave로 Llama 3.1 8B 트레이스
다음 Python 코드 샘플은 Serverless Inference API를 사용하여 Llama 3.1 8B 모델에 프롬프트를 전송하고 Weave에서 Call을 트레이스하는 방법을 보여줍니다. 트레이싱을 통해 LLM Call의 전체 입력과 출력을 캡처하고, 성능을 모니터링하며, Weights & Biases UI에서 결과를 분석할 수 있습니다. 이 예제에서는:@weave.op()로 데코레이션된run_chat함수를 정의하며, 이 함수는 OpenAI 호환 클라이언트를 사용하여 Chat Completion 요청을 수행합니다.- Weave는 트레이스를 기록하고 W&B entity 및
project="<your-team>/<your-project>"프로젝트와 연결합니다. - Weave는 함수를 자동으로 트레이스하여 입력, 출력, 지연 시간, 메타데이터(예: 모델 ID)를 로깅합니다.
- 결과는 터미널에 출력되며, 트레이스는 지정된 프로젝트 아래 Forge의 Traces 탭에 표시됩니다.
https://forge.coreweave.com/wandb/<your-team>/<your-project>/r/call/01977f8f-839d-7dda-b0c2-27292ef0e04g)를 클릭하거나:
- Forge로 이동합니다.
- Weave 트레이스를 보려면 Traces 탭을 선택합니다.
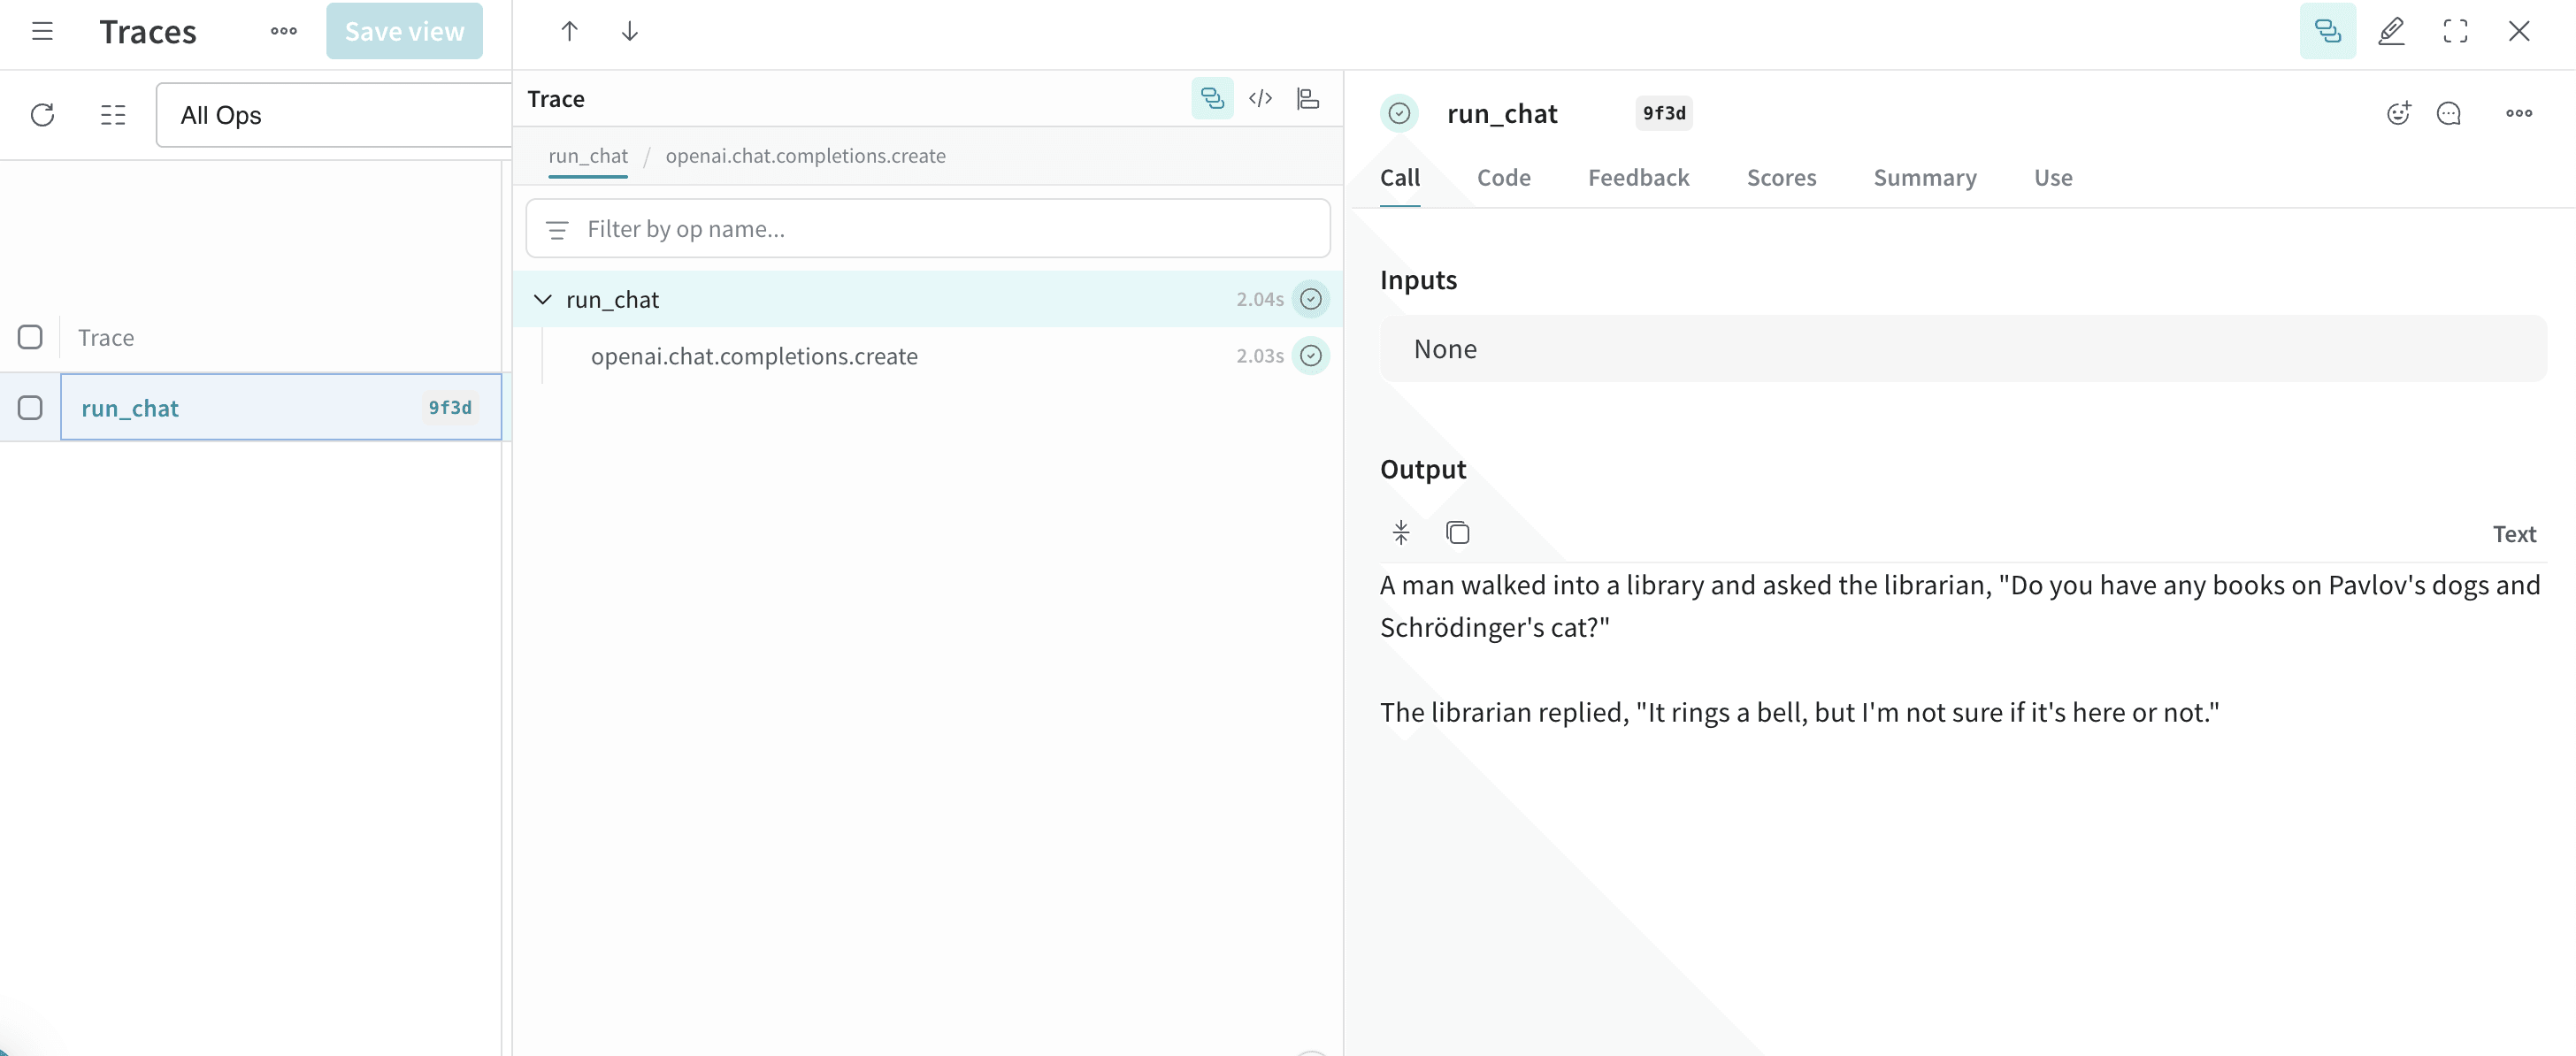
고급 예시: Inference 서비스에서 Weave Evaluations 및 Leaderboards 사용하기
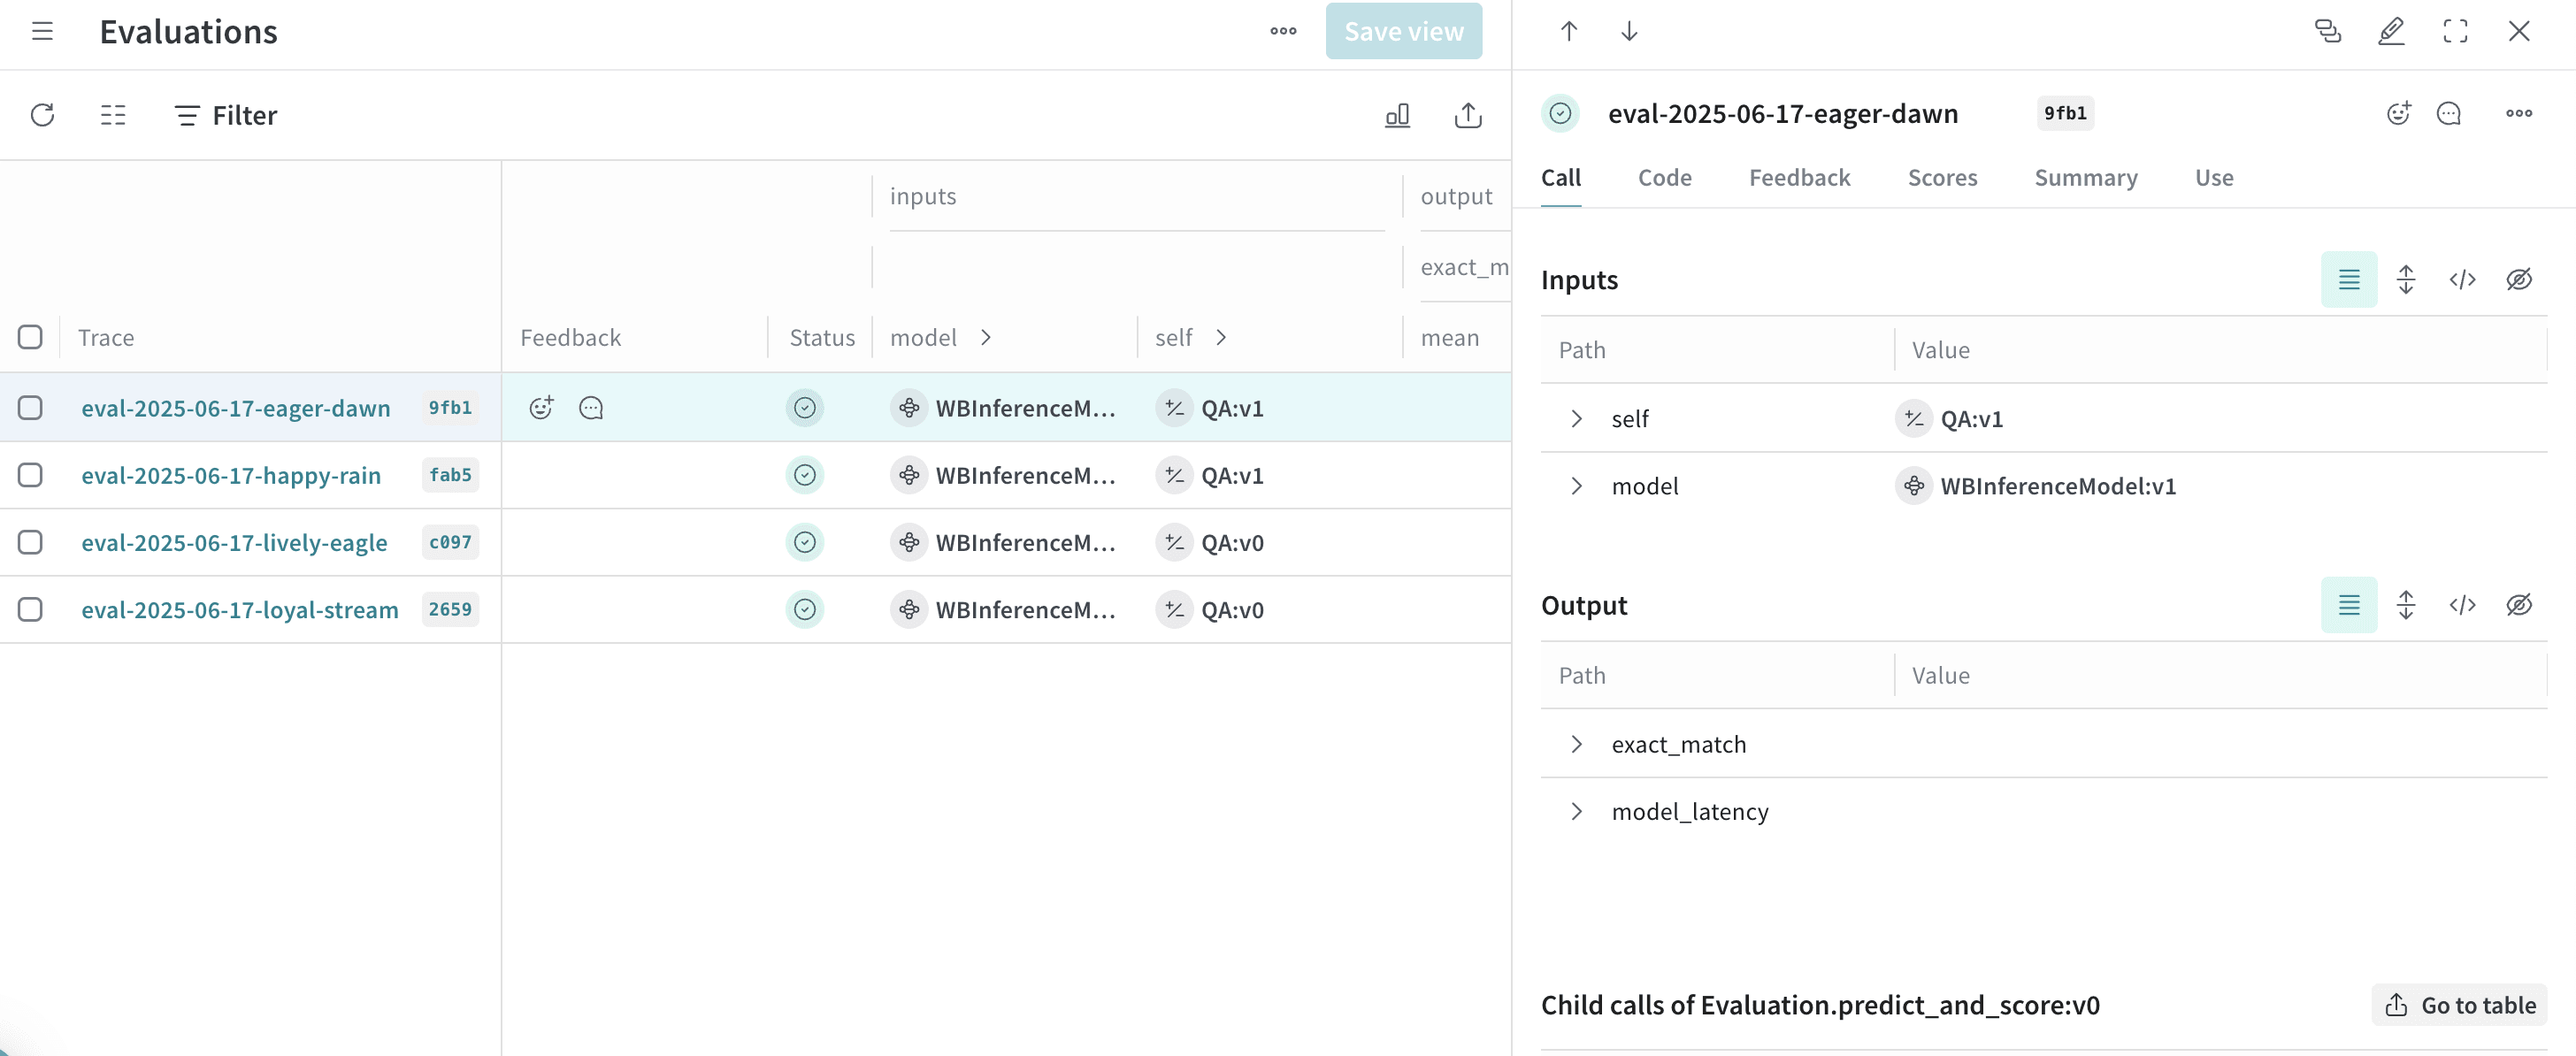
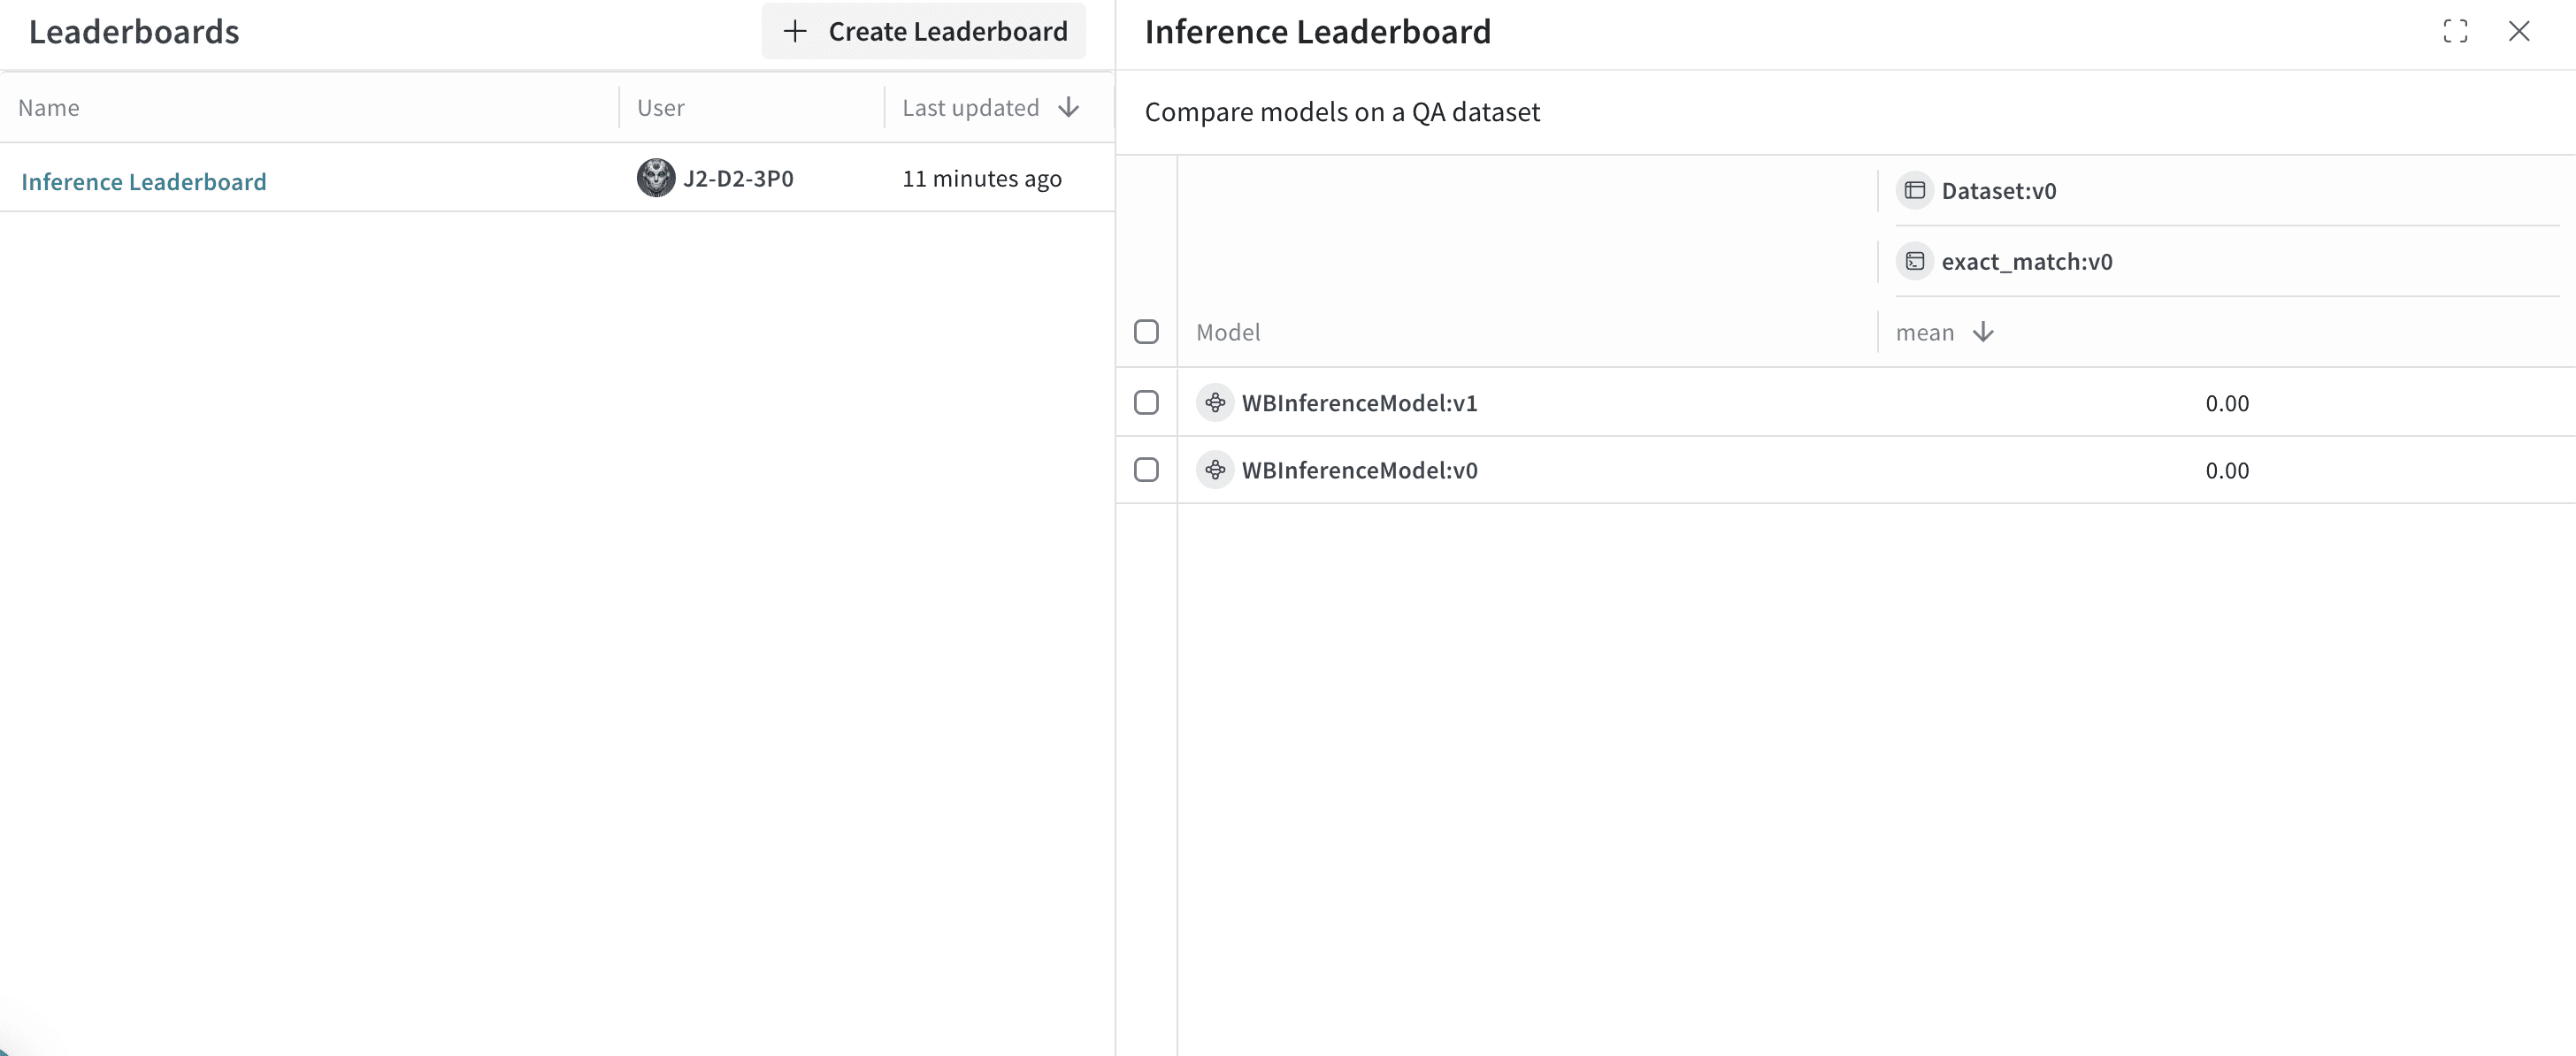
또한 Inference 서비스에서 Weave를 사용하여 모델 Call을 트레이스하고, 성능을 평가하고, leaderboard를 게시할 수 있습니다. 다음 Python 코드 샘플은 질의응답 데이터셋으로 두 모델을 비교합니다. 이 예제를 사용하려면 일반 사전 요구 사항과 Python에서 API를 사용하기 위한 추가 사전 요구 사항을 완료해야 합니다.- Traces 탭으로 이동하여 트레이스를 확인하세요.
- Evals 탭으로 이동하여 모델 평가를 확인하세요.
- Leaders 탭으로 이동하여 생성된 leaderboard를 확인하세요.
UI
다음 섹션에서는 Weights & Biases UI에서 Inference 서비스를 사용하는 방법을 설명합니다. UI에서 Inference 서비스에 액세스하려면 먼저 사전 요구 사항을 완료하세요.Inference 서비스 액세스
다음 위치에서 Weights & Biases UI를 통해 Inference 서비스에 액세스할 수 있습니다:직접 링크
https://forge.coreweave.com/inference로 이동하세요.Inference 탭에서 접근하기
- Forge에서 CoreWeave Forge 계정으로 이동하세요.
- 왼쪽 사이드바에서 Inference를 선택하세요. 사용 가능한 모델과 모델 정보를 보여 주는 페이지가 표시됩니다.
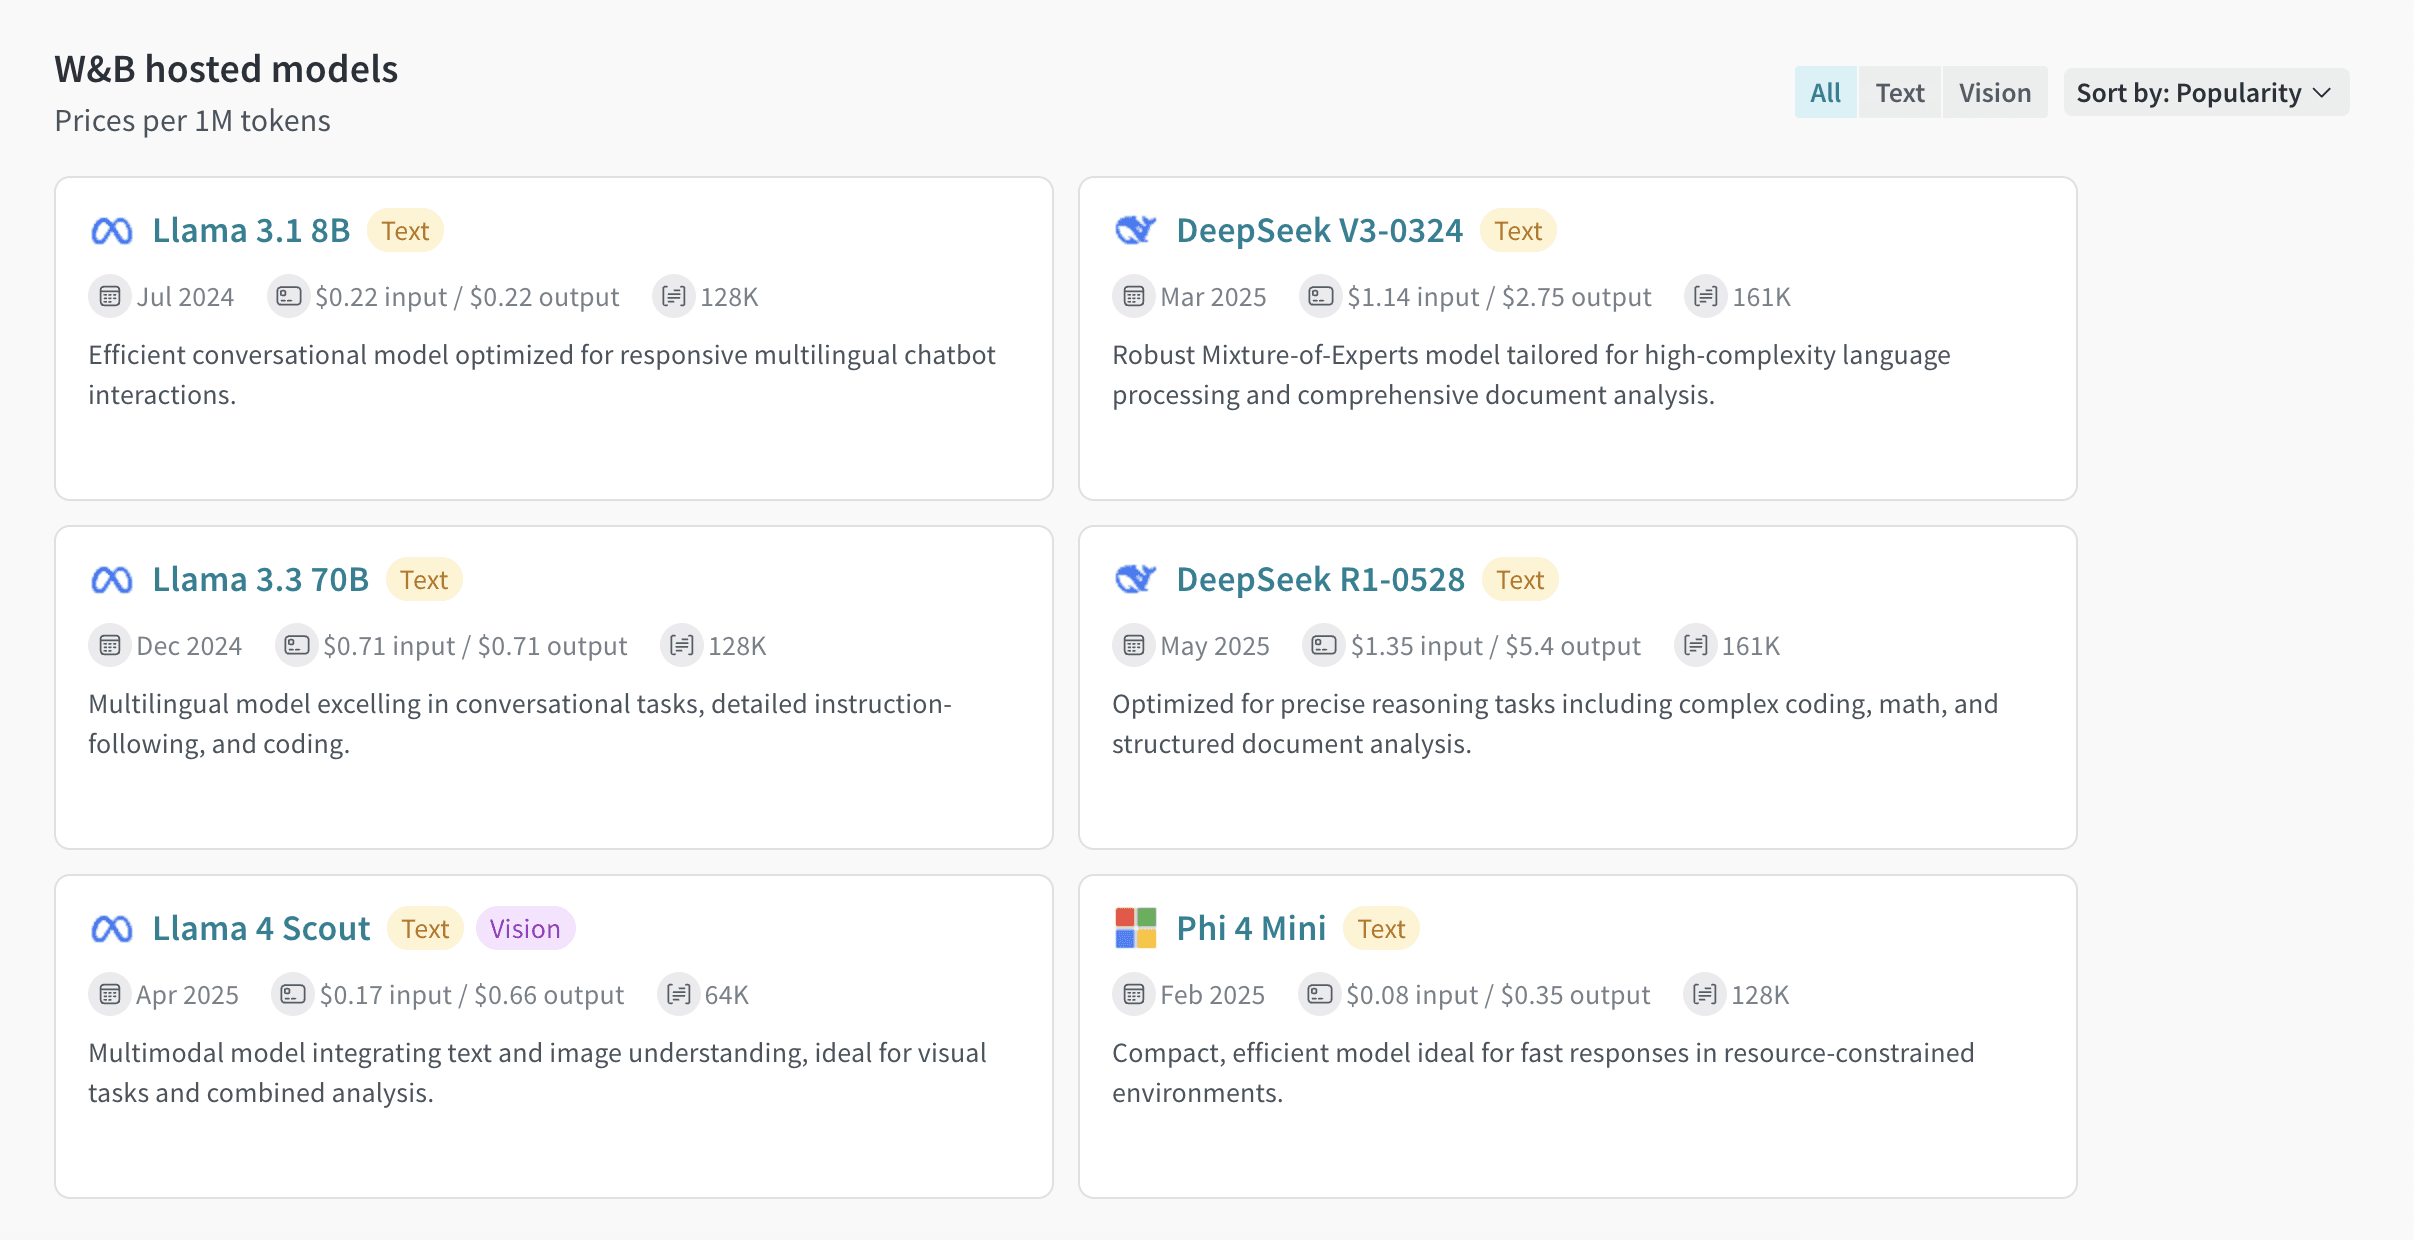
플레이그라운드 탭에서
- 왼쪽 사이드바에서 플레이그라운드를 선택하세요. 플레이그라운드 채팅 UI가 표시됩니다.
- LLM 드롭다운 목록에서 Serverless Inference에 마우스를 올리세요. 사용 가능한 Serverless Inference 모델이 있는 드롭다운이 오른쪽에 표시됩니다.
- Serverless Inference 모델 드롭다운에서 다음을 수행할 수 있습니다:
- 사용 가능한 모델의 이름을 클릭하여 플레이그라운드에서 사용해 보세요.
- 플레이그라운드에서 하나 이상의 모델을 비교하세요.
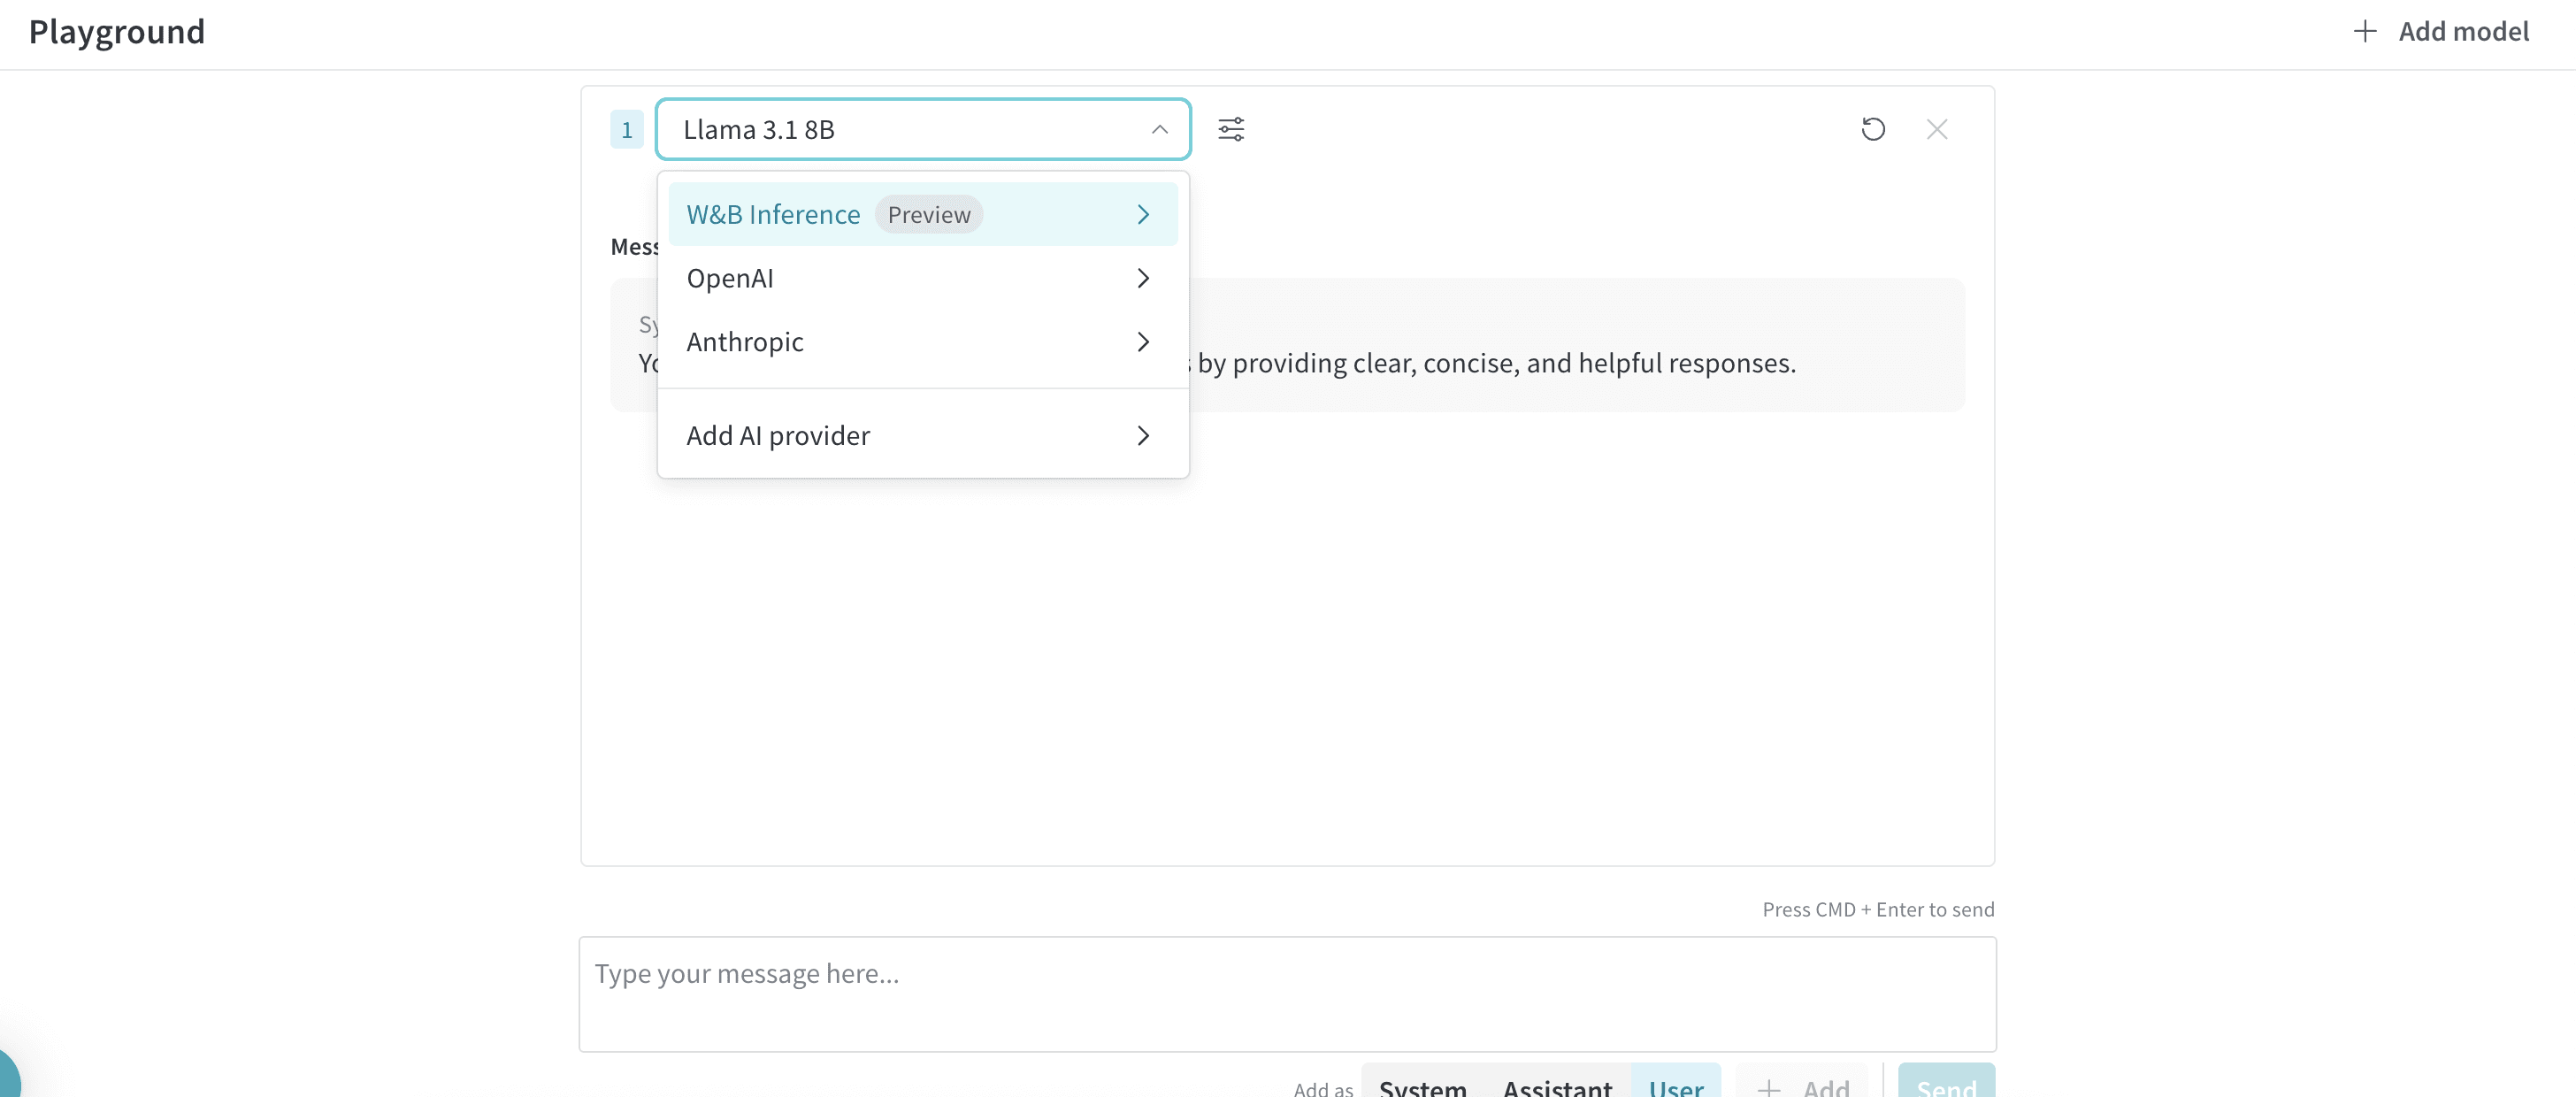
플레이그라운드에서 모델 사용해 보기
액세스 옵션 중 하나를 사용하여 모델을 선택한 후, 플레이그라운드에서 모델을 사용해 볼 수 있습니다. 다음 작업을 수행할 수 있습니다: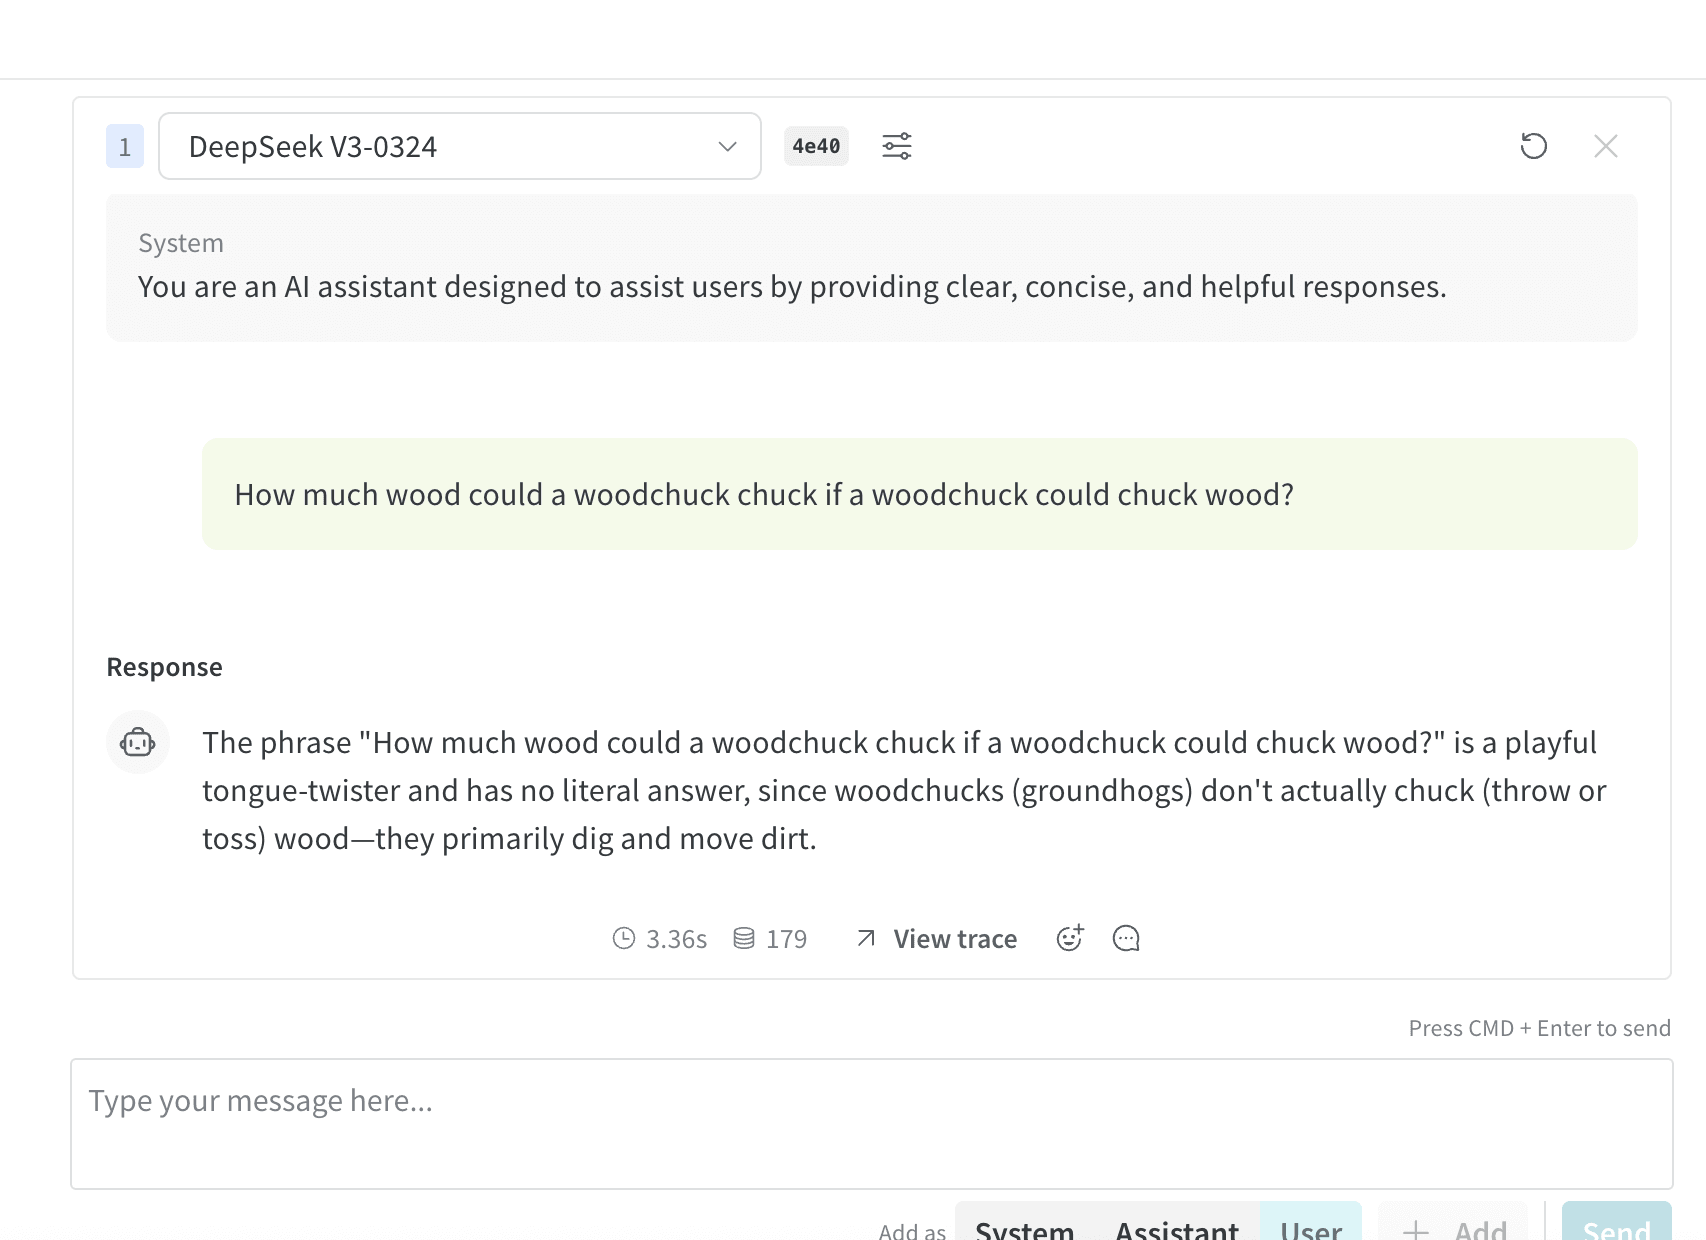
여러 모델 비교
플레이그라운드에서 여러 Inference 모델을 비교할 수 있습니다. Compare 뷰는 두 가지 다른 위치에서 액세스할 수 있습니다:Inference 탭에서 Compare 뷰에 액세스하기
- 왼쪽 사이드바에서 Inference를 선택하세요. 사용 가능한 모델과 모델 정보가 표시된 페이지가 나타납니다.
- 비교할 모델을 선택하려면 모델 Card의 아무 곳이나 클릭하세요(모델 이름은 제외). 선택을 나타내기 위해 모델 Card의 테두리가 파란색으로 강조 표시됩니다.
- 비교하려는 각 모델에 대해 단계 2를 반복하세요.
- 선택한 Card 중 하나에서 플레이그라운드에서 N개 모델 비교 버튼을 클릭하세요(
N은 비교 중인 모델 수입니다. 예를 들어 3개 모델을 선택하면 버튼이 플레이그라운드에서 3개 모델 비교로 표시됩니다). 뷰가 열립니다.
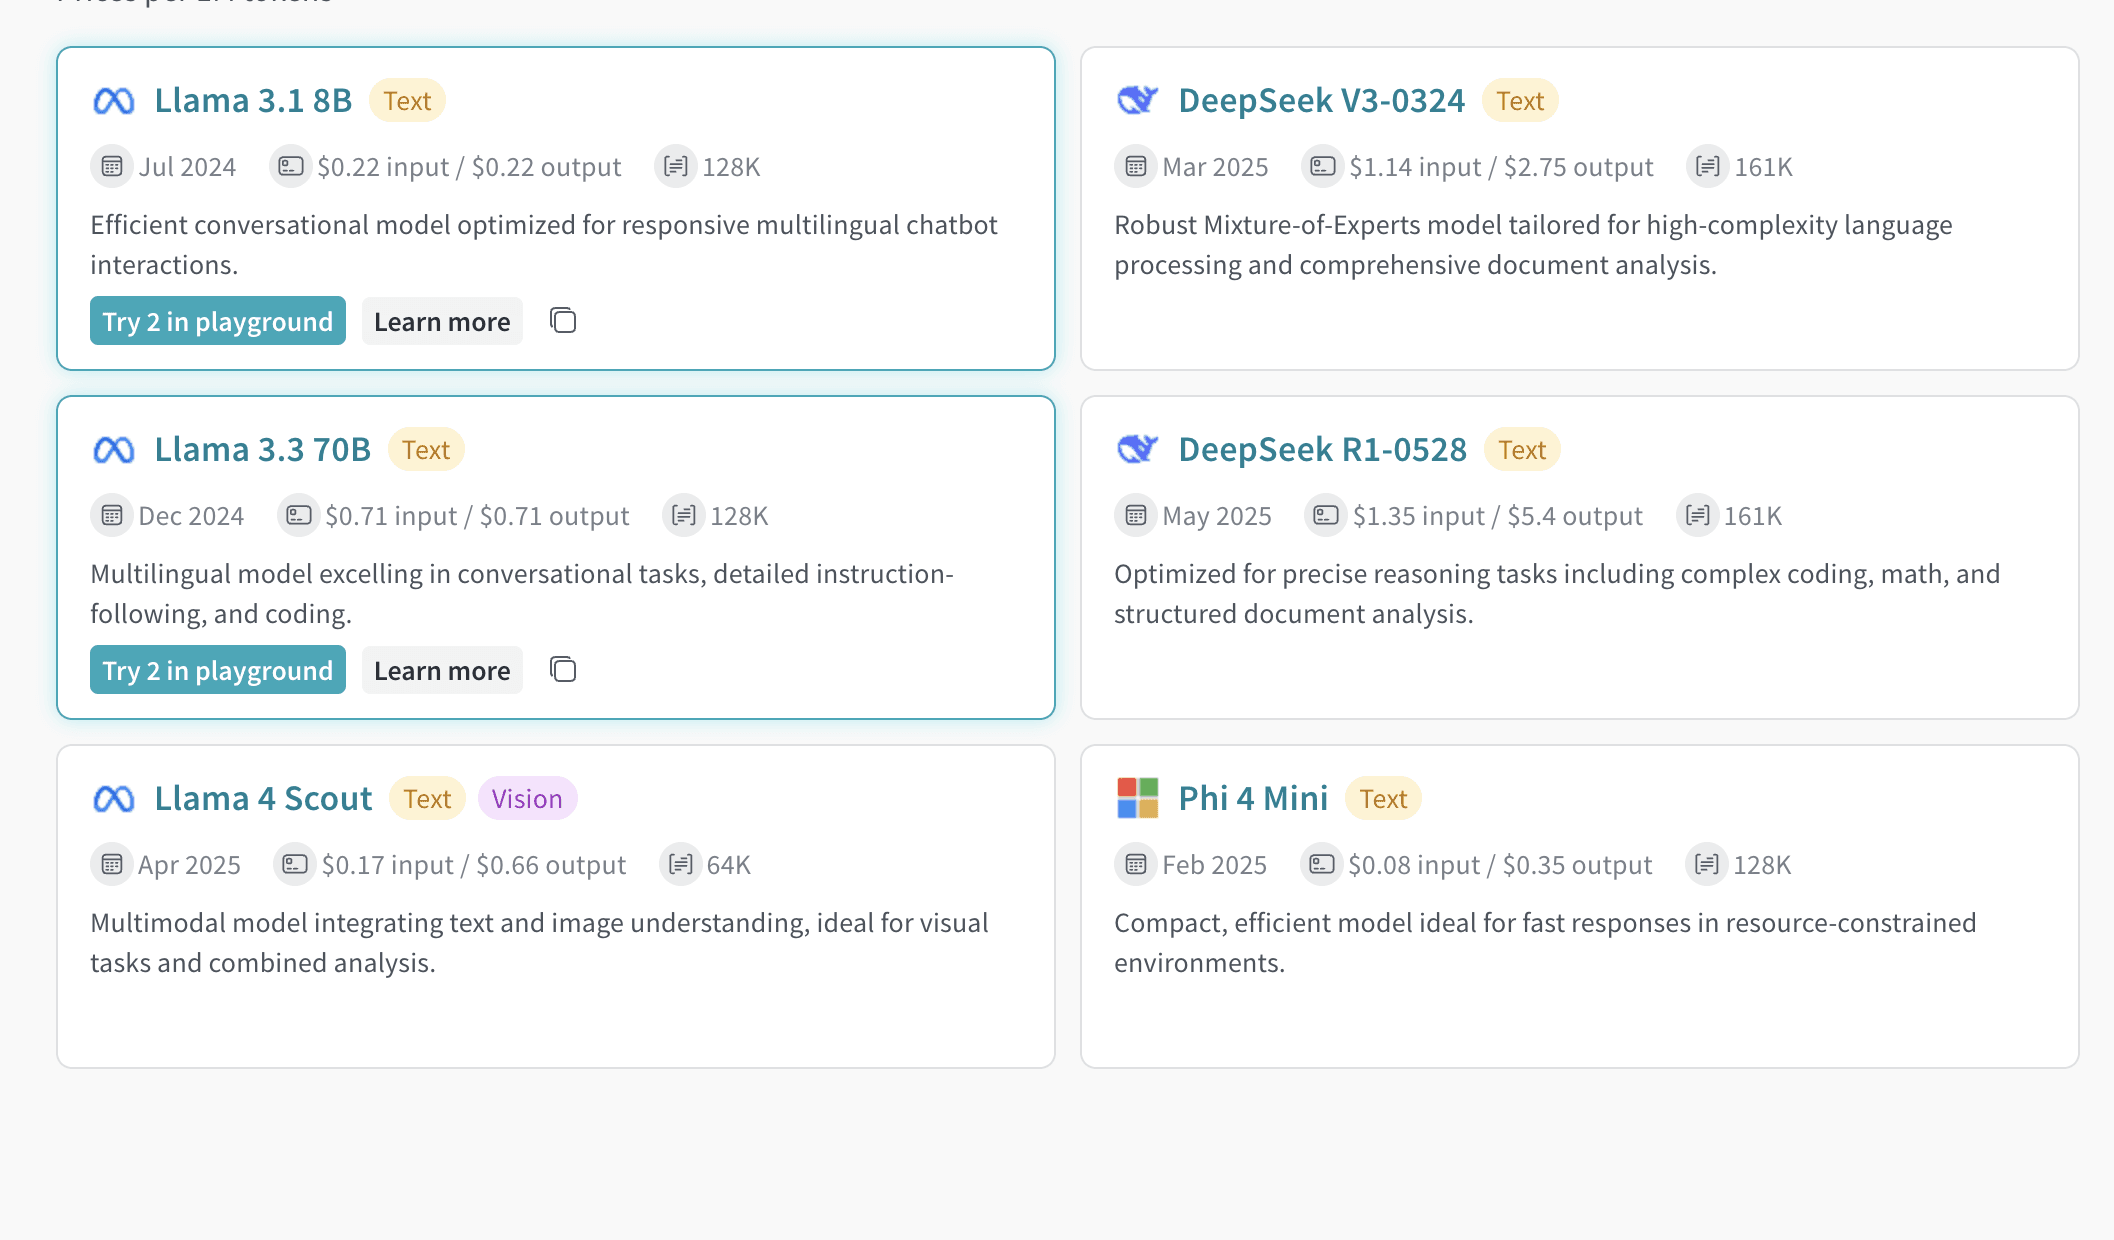
플레이그라운드 탭에서 Compare 뷰에 액세스하기
- 왼쪽 사이드바에서 플레이그라운드를 선택하세요. 플레이그라운드 chat UI가 표시됩니다.
- LLM 드롭다운 목록에서 Serverless Inference 위에 마우스를 올리세요. 사용 가능한 Serverless Inference 모델의 드롭다운이 오른쪽에 표시됩니다.
- 드롭다운에서 비교를 선택하세요. Inference 탭이 표시됩니다.
- 비교할 모델을 선택하려면 모델 Card의 아무 곳이나 클릭하세요(모델 이름 제외). 선택을 나타내기 위해 모델 Card의 테두리가 파란색으로 강조 표시됩니다.
- 비교하려는 각 모델에 대해 4단계를 반복하세요.
- 선택한 Card 중 하나에서 플레이그라운드에서 N개 모델 비교 버튼을 클릭하세요(
N은 비교 중인 모델 수입니다. 예를 들어, 3개 모델을 선택하면 버튼이 플레이그라운드에서 3개 모델 비교로 표시됩니다). 뷰가 열립니다.
결제 및 사용 정보 보기
조직 관리자는 Weights & Biases UI에서 현재 Inference 크레딧 잔액, 사용 이력, 예정된 청구 금액(해당하는 경우)을 직접 확인할 수 있습니다.- Weights & Biases UI에서 W&B Billing 페이지로 이동하세요.
- 오른쪽 하단에 Inference 결제 정보 Card가 표시됩니다. 여기에서 다음 작업을 할 수 있습니다.
- Inference 결제 정보 Card에서 View usage 버튼을 클릭하여 시간 경과별 사용량을 확인하세요.
- 유료 플랜을 사용 중이라면 예정된 Inference 요금을 확인하세요.
사용 정보 및 한도
다음 섹션에서는 지리적 제한, 동시성 한도 및 가격을 포함한 중요한 사용 정보 및 한도에 대해 설명합니다. 서비스를 사용하기 전에 이 정보를 숙지하세요.지리적 제한
Inference 서비스는 지원되는 지리적 위치에서만 액세스할 수 있습니다. 자세한 내용은 Terms of Service를 참조하세요.동시성 한도
공정한 사용과 안정적인 성능을 보장하기 위해 Serverless Inference API는 사용자 및 프로젝트 수준에서 요청 속도 제한을 강제 적용합니다. 이러한 제한은 다음과 같은 역할을 합니다.- 오용을 방지하고 API 안정성을 보호합니다.
- 모든 사용자의 액세스를 보장합니다.
- 인프라 부하를 효과적으로 관리합니다.
429 Concurrency limit reached for requests 응답을 반환합니다. 이 오류를 해결하려면 동시 요청 수를 줄이세요.