

- 모델 성능 저하 추적
- 공유 평가 워크플로 조율
리더보드는 Weights & Biases UI와 Weave Python SDK에서만 생성할 수 있습니다. TypeScript 사용자는 Weights & Biases UI에서 리더보드를 생성하고 관리할 수 있습니다.
리더보드 만들기
리더보드는 Weights & Biases UI에서 만들거나 프로그래밍 방식으로 만들 수 있습니다. 필요할 때마다 간단히 비교하려면 UI를 사용하고, 리더보드 생성을 자동화된 평가 워크플로에 통합하려면 Python SDK를 사용하세요.UI 사용하기
Weights & Biases UI에서 리더보드를 대화형으로 생성하고 사용자 지정할 수 있습니다. 다음 단계를 따르세요.- Weights & Biases UI에서 Leaders 섹션으로 이동하세요. 보이지 않으면 More → Leaders를 클릭하세요.
- + New Leaderboard를 클릭하세요.
- Leaderboard Title 필드에 리더보드를 잘 나타내는 이름을 입력하세요(예:
summarization-benchmark-v1). - 필요하면 이 리더보드에서 무엇을 비교하는지 설명을 추가하세요.
- 열을 추가하여 표시할 평가와 메트릭을 지정하세요.
- 레이아웃이 완성되면 리더보드를 저장하고 게시하여 다른 사람과 공유하세요.
열 추가
열은 리더보드에서 각 모델에 대해 표시할 내용을 정의합니다. 리더보드의 각 열은 특정 평가의 메트릭을 나타냅니다. 열을 설정하려면 다음 항목을 지정합니다.- Evaluation: 드롭다운에서 평가 run을 선택하세요(미리 생성되어 있어야 합니다).
- Scorer: 해당 평가에 사용된 점수화 함수를 선택하세요(예:
jaccard_similarity또는simple_accuracy). - Metric: 표시할 summary 메트릭을 선택하세요(예:
mean또는true_fraction).
- Move before or after. 열 순서를 변경합니다.
- Duplicate. 열 정의를 복사합니다.
- Delete. 열을 삭제합니다.
- Sort ascending. 리더보드의 기본 정렬을 설정합니다(다시 클릭하면 내림차순으로 전환됩니다).
Python SDK 사용하기
Python SDK를 사용하면 코드에서 리더보드를 정의하고, 게시하고, 조회할 수 있습니다. 이 방식을 사용하면 리더보드를 평가 코드와 함께 버전 관리하고 자동화된 워크플로의 일부로 실행할 수 있습니다. 리더보드를 생성하고 게시하려면 다음 단계를 따르세요.-
테스트 데이터셋을 정의합니다. 기본 제공
Dataset을 사용하거나, 입력과 타깃 목록을 직접 정의할 수 있습니다. -
하나 이상의 Scorer를 정의합니다.
-
Evaluation을 생성합니다. -
평가할 모델을 정의합니다.
-
평가를 실행합니다.
-
리더보드를 생성합니다.
-
리더보드를 게시합니다.
-
결과를 조회합니다.
엔드투엔드 Python 예시
다음 예시에서는 Weave Evaluations로 리더보드를 만들고, 맞춤형 메트릭을 사용해 공유 데이터셋에서 세 가지 요약 모델을 비교합니다. 소규모 벤치마크를 만들어 각 모델을 평가하고, Jaccard 유사도로 각 모델의 점수를 매긴 후, 결과를 Weave 리더보드에 게시합니다.리더보드 보기 및 해석
스크립트가 리더보드를 게시하면 Weights & Biases UI에서 결과를 확인하고 모델 성능을 나란히 비교할 수 있습니다.- Weights & Biases UI에서 Leaders 탭으로 이동하세요. 탭이 보이지 않으면 More를 클릭한 다음 Leaders를 선택하세요.
- 리더보드 이름(예:
Summarization Model Comparison)을 클릭하세요.
model_humanlike, model_vanilla, model_messy)을 나타냅니다. mean 열에는 모델 출력과 참조 요약 간의 평균 Jaccard 유사도가 표시됩니다.
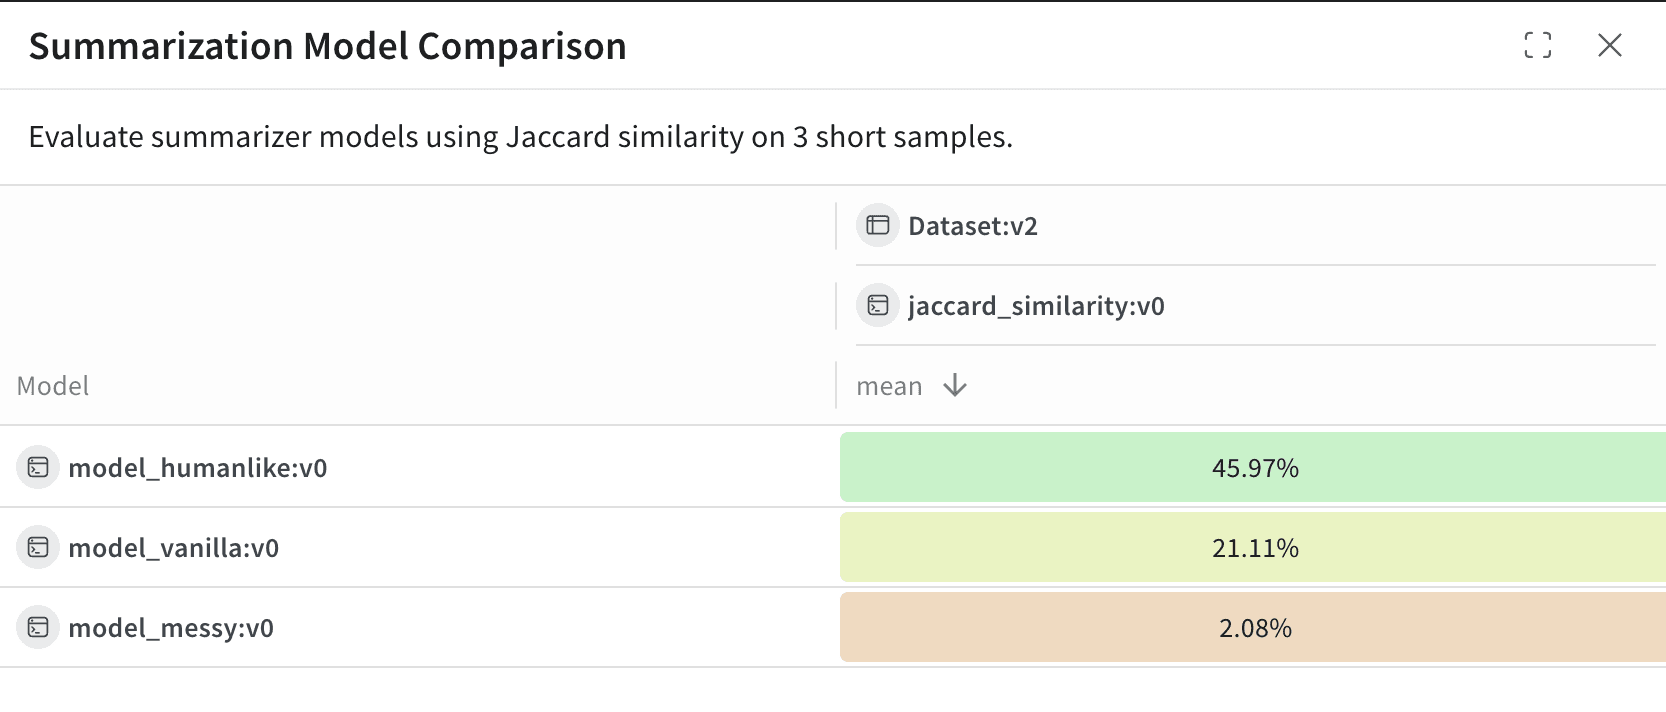
model_humanlike는 약 46%의 일치율로 가장 높은 성능을 보입니다.model_vanilla(단순히 텍스트를 잘라내는 방식)는 약 21%를 기록합니다.- 의도적으로 성능을 낮게 만든
model_messy는 약 2%에 그칩니다.