

Model 및 Evaluation 클래스를 통해 평가 추적 기능을 기본으로 지원합니다. 이 API는 최소한의 가정만 전제하므로 다양한 사용 사례에 맞게 활용할 수 있습니다.
학습 내용
이 가이드에서는 다음 방법을 알아봅니다.Model을 설정합니다.- LLM의 응답을 테스트하는 데 기준이 될 데이터셋을 생성합니다.
- 모델 출력을 기대 출력과 비교하는 점수화 함수를 정의합니다.
- 점수화 함수와 기본 제공 Scorer를 함께 사용해 데이터셋으로 모델을 테스트하는 평가를 실행합니다.
- Weights & Biases UI에서 평가 결과를 확인합니다.
사전 요구 사항
- CoreWeave Forge 계정
- Python 3.10 이상 또는 Node.js 18 이상
- 필수 패키지 설치:
- Python:
pip install weave openai - TypeScript:
npm install weave openai
- Python:
- 환경 변수로 설정된 OpenAI API 키
필요한 라이브러리 및 함수 임포트하기
다음 라이브러리를 스크립트에 임포트하세요.- Python
- TypeScript
Model 구축하기
라이브러리가 준비되었다면 이제 평가할 모델을 정의할 차례입니다.
Weave에서 Models는 객체로, 모델 또는 에이전트의 동작(로직, 프롬프트, 매개변수)과 버전이 관리되는 메타데이터(매개변수, 코드, 세부 설정)를 함께 캡처합니다. 덕분에 모델을 안정적으로 추적, 비교, 평가하고 반복 개선할 수 있습니다.
Model을 인스턴스화하면 Weave가 해당 설정과 동작을 자동으로 캡처하고, 변경 사항이 생기면 버전을 업데이트합니다. 따라서 모델을 반복 개선하면서 시간에 따른 성능 변화를 추적할 수 있습니다.
Model을 선언하려면 Model의 서브클래스를 만들고, 예시 하나를 입력받아 응답을 반환하는 predict 함수를 구현하세요.
다음 예시 모델은 OpenAI를 사용하여 입력 문장에서 외계 과일의 이름, 색상, 맛을 추출합니다.
- Python
- TypeScript
ExtractFruitsModel 클래스는 weave.Model을 상속(서브클래싱)하므로 Weave가 인스턴스화된 객체를 추적할 수 있습니다. @weave.op는 predict 함수를 데코레이트하여 입력과 출력을 추적합니다.
Model 객체는 다음과 같이 인스턴스화할 수 있습니다.
- Python
- TypeScript
데이터셋 생성
Model을 정의했다면 이제 모델을 평가할 데이터셋이 필요합니다. Dataset은 Weave 객체로 저장되는 예시 컬렉션입니다. 데이터셋을 Weave에 게시하면 버전이 관리되며, 여러 평가 run에서 재사용할 수 있습니다.
다음 예제 데이터셋은 입력 문장 예시 세 개와 각각의 정답(labels)을 정의한 뒤, 점수화 함수가 읽을 수 있는 JSON table 형식으로 구성합니다.
이 예제에서는 코드에서 예시 목록을 직접 구축하지만, 실행 중인 애플리케이션에서 예시를 하나씩 로깅할 수도 있습니다.
- Python
- TypeScript
weave.Dataset() 클래스로 데이터셋을 생성하고 게시하세요.
- Python
- TypeScript
맞춤형 점수화 함수 정의하기
모델과 데이터셋이 준비되었다면, 이제 각 예시에서 모델의 성능을 측정할 방법이 필요합니다. 점수화 함수는 모델의 출력을 기대하는 target과 비교하여 평가 결과로 보고되는 메트릭을 생성합니다. Weave 평가를 사용하려면output과 비교할 target이 있어야 합니다. 다음 점수화 함수는 두 개의 딕셔너리(target, output)를 받아 출력이 target과 일치하는지를 나타내는 불리언 값의 딕셔너리를 반환합니다. @weave.op() 데코레이터를 사용하면 Weave가 점수화 함수의 실행을 추적합니다.
- Python
- TypeScript
Scorer 클래스를 만들어야 할 수도 있습니다. 예를 들어 특정 매개변수(예: 채팅 모델, 프롬프트), 행별 점수화 방식, 집계 점수 계산 로직을 갖춘 표준화된 LLMJudge 클래스를 만들 수 있습니다. 자세한 내용은 RAG 애플리케이션의 모델 기반 평가 튜토리얼에서 Scorer 클래스 정의 부분을 참조하세요.
기본 제공 Scorer를 사용하여 평가 실행하기
모델, 데이터셋, 맞춤형 Scorer가 모두 준비되었으니 이제 이들을 하나로 연결하여 평가 run을 실행할 수 있습니다. 맞춤형 점수화 함수뿐 아니라 Weave의 기본 제공 Scorer도 사용할 수 있습니다. 다음 평가에서weave.Evaluation()은 이전 섹션에서 정의한 fruit_name_score 함수와, F1 점수를 계산하는 기본 제공 MultiTaskBinaryClassificationF1 Scorer를 사용합니다.
다음 예시는 두 점수화 함수를 사용해 fruits 데이터셋으로 ExtractFruitsModel을 평가하고, 그 결과를 Weave에 로깅합니다.
- Python
- TypeScript
Python 스크립트에서 실행하는 경우
asyncio.run을 사용해야 합니다. Jupyter 노트북에서 실행하는 경우에는 await를 바로 사용할 수 있습니다.전체 예제
스크립트 하나로 구현한 전체 평가 파이프라인:
스크립트 하나로 구현한 전체 평가 파이프라인:
- Python
- TypeScript
평가 결과 보기
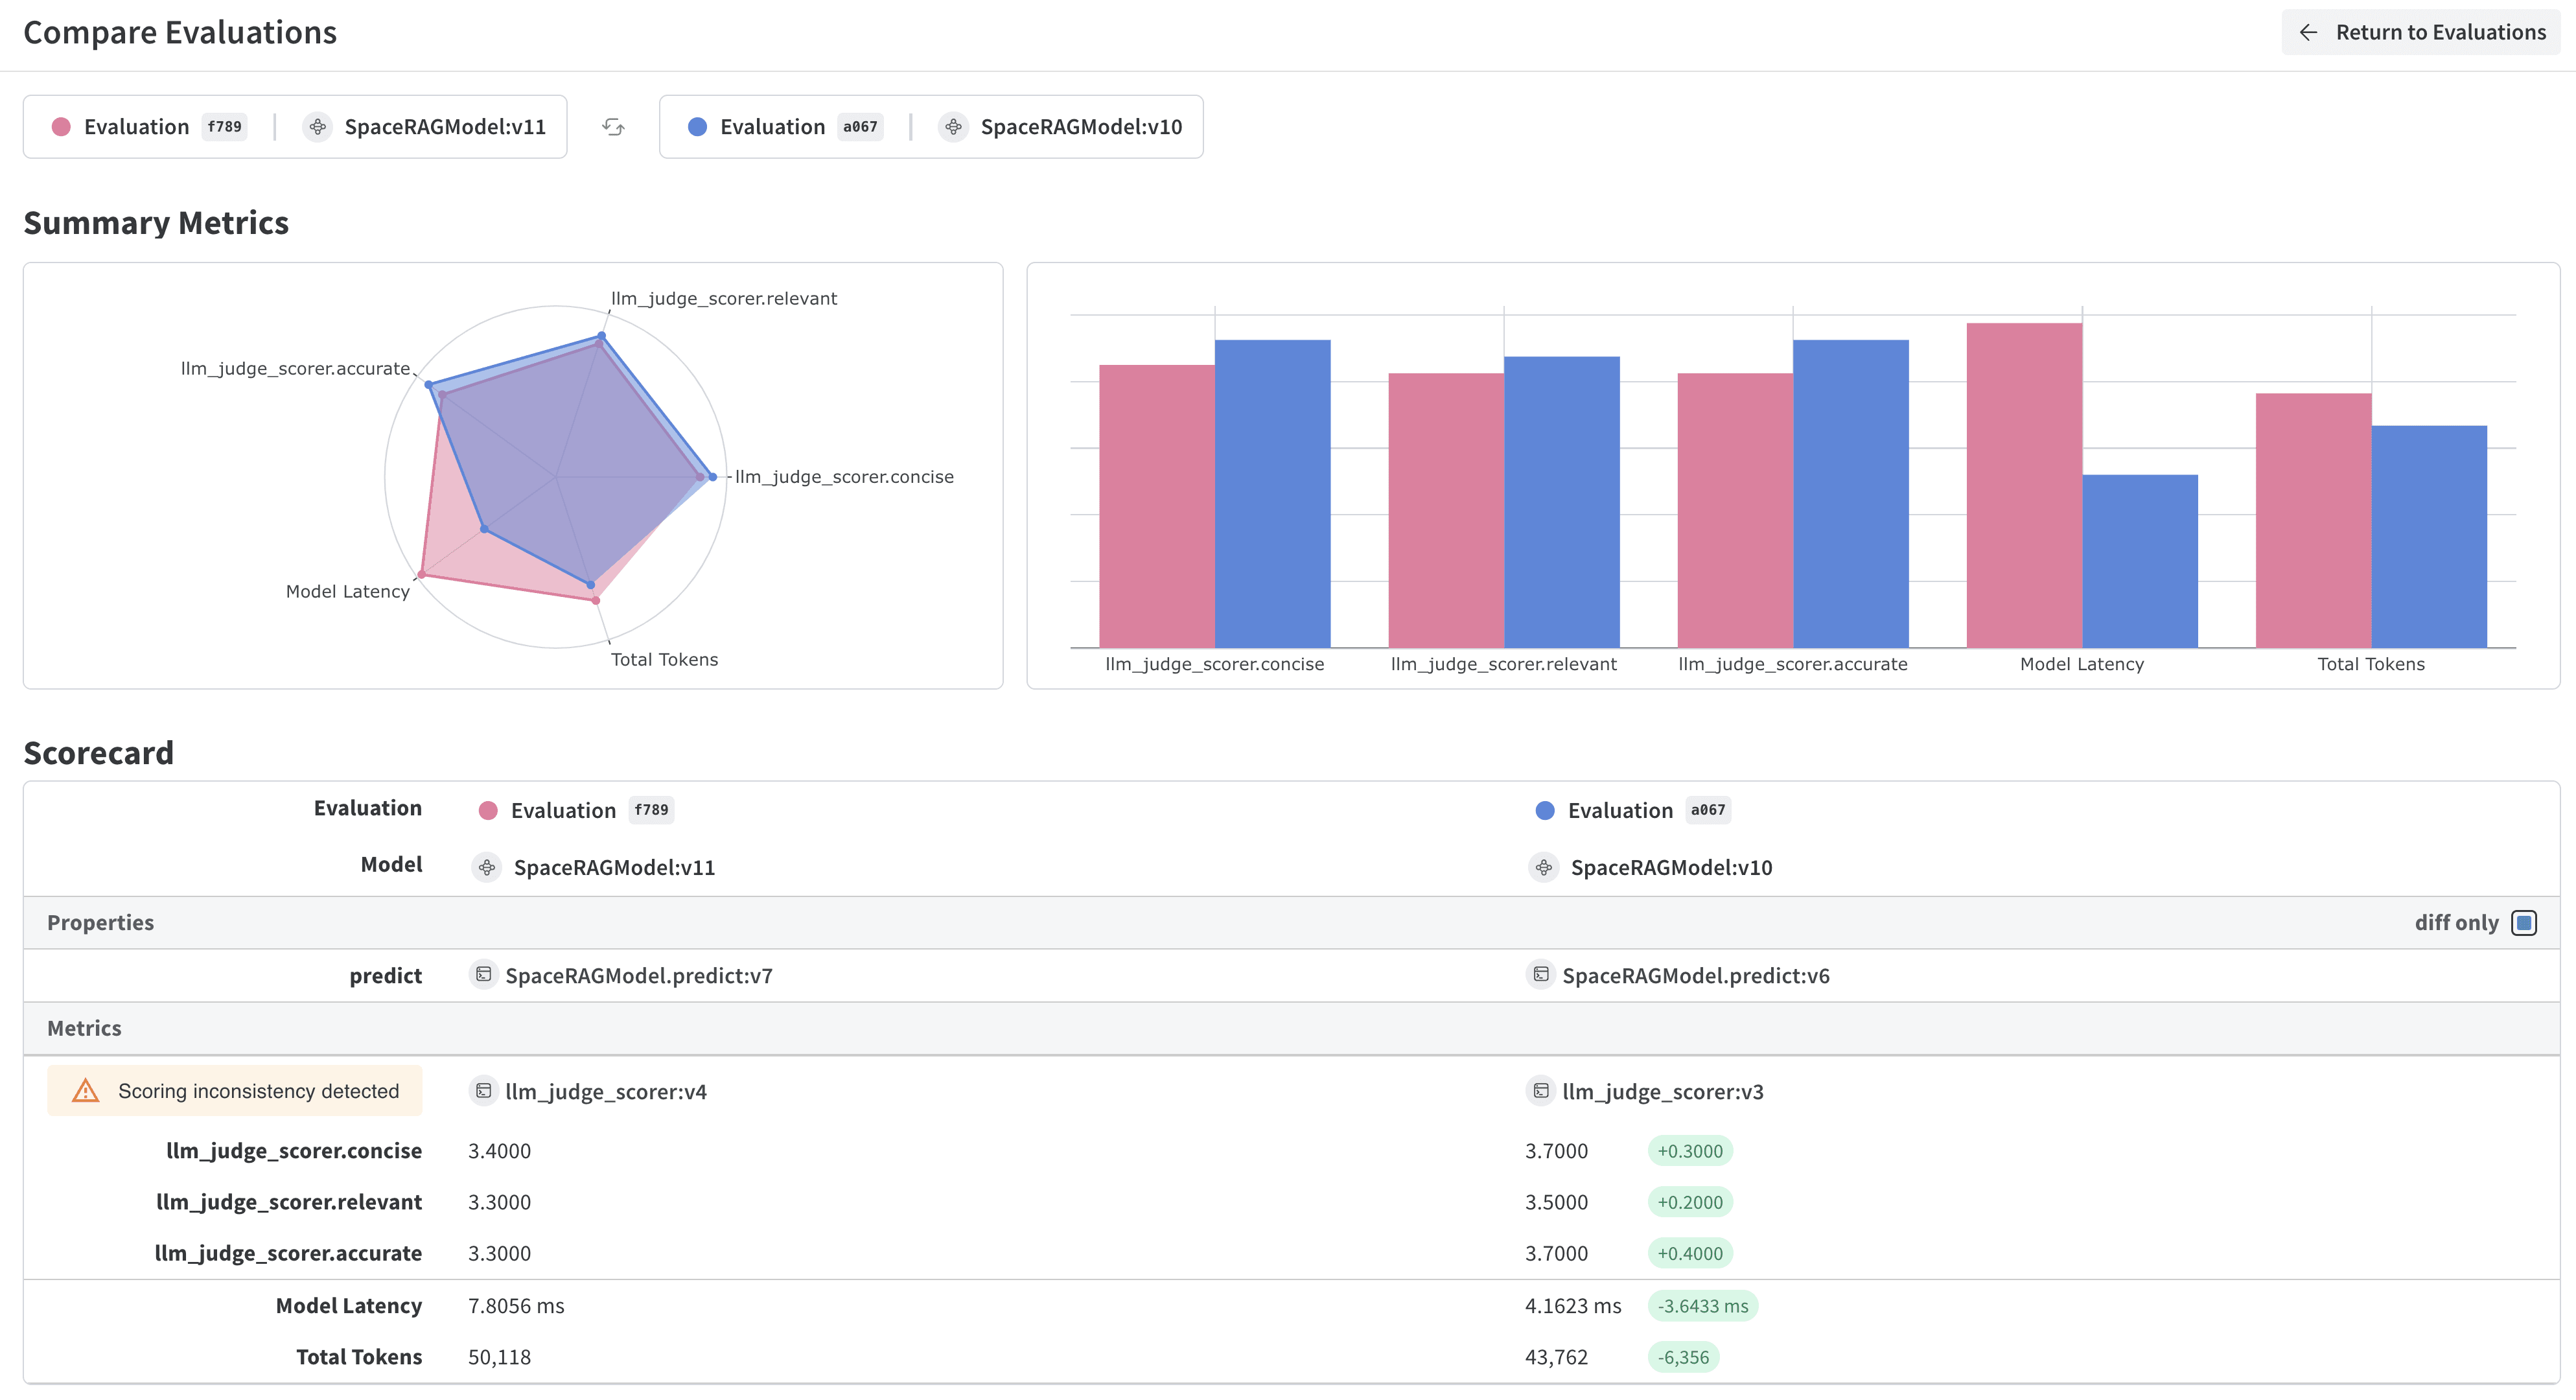
평가가 완료되면 Weights & Biases UI에서 각 예측과 Scorer 결과를 살펴볼 수 있습니다. Weave는 각 예측과 점수의 트레이스를 자동으로 캡처합니다. 결과를 확인하려면 평가 실행 시 출력되는 링크를 클릭하세요.
Weave 평가 자세히 알아보기
이제 전체 평가 파이프라인이 완성되었습니다. Weave의 평가 기능을 더 깊이 알아보려면 다음 자료를 참조하세요.- Scorer를 구축하고 사용하는 방법을 자세히 알아보세요.
- Weave의 기본 제공 점수화 함수를 확인하세요.
- LLM을 평가자로 활용하는 모델 기반 평가에 대해 알아보세요.