

- 단일 프로세스 추적: W&B로 rank 0 프로세스(“리더” 또는 “코디네이터”라고도 함)를 추적합니다. PyTorch Distributed Data Parallel(DDP) 클래스로 분산 트레이닝 실험을 로깅할 때 흔히 사용하는 방법입니다.
- 여러 프로세스 추적: 여러 프로세스를 추적할 때는 다음 중 한 가지 방법을 선택할 수 있습니다.
- 프로세스당 하나의 run을 사용하여 각 프로세스를 개별적으로 추적합니다. 필요하면 W&B App UI에서 이 run을 그룹으로 묶을 수 있습니다.
- 모든 프로세스를 하나의 run으로 추적합니다.
단일 프로세스 추적
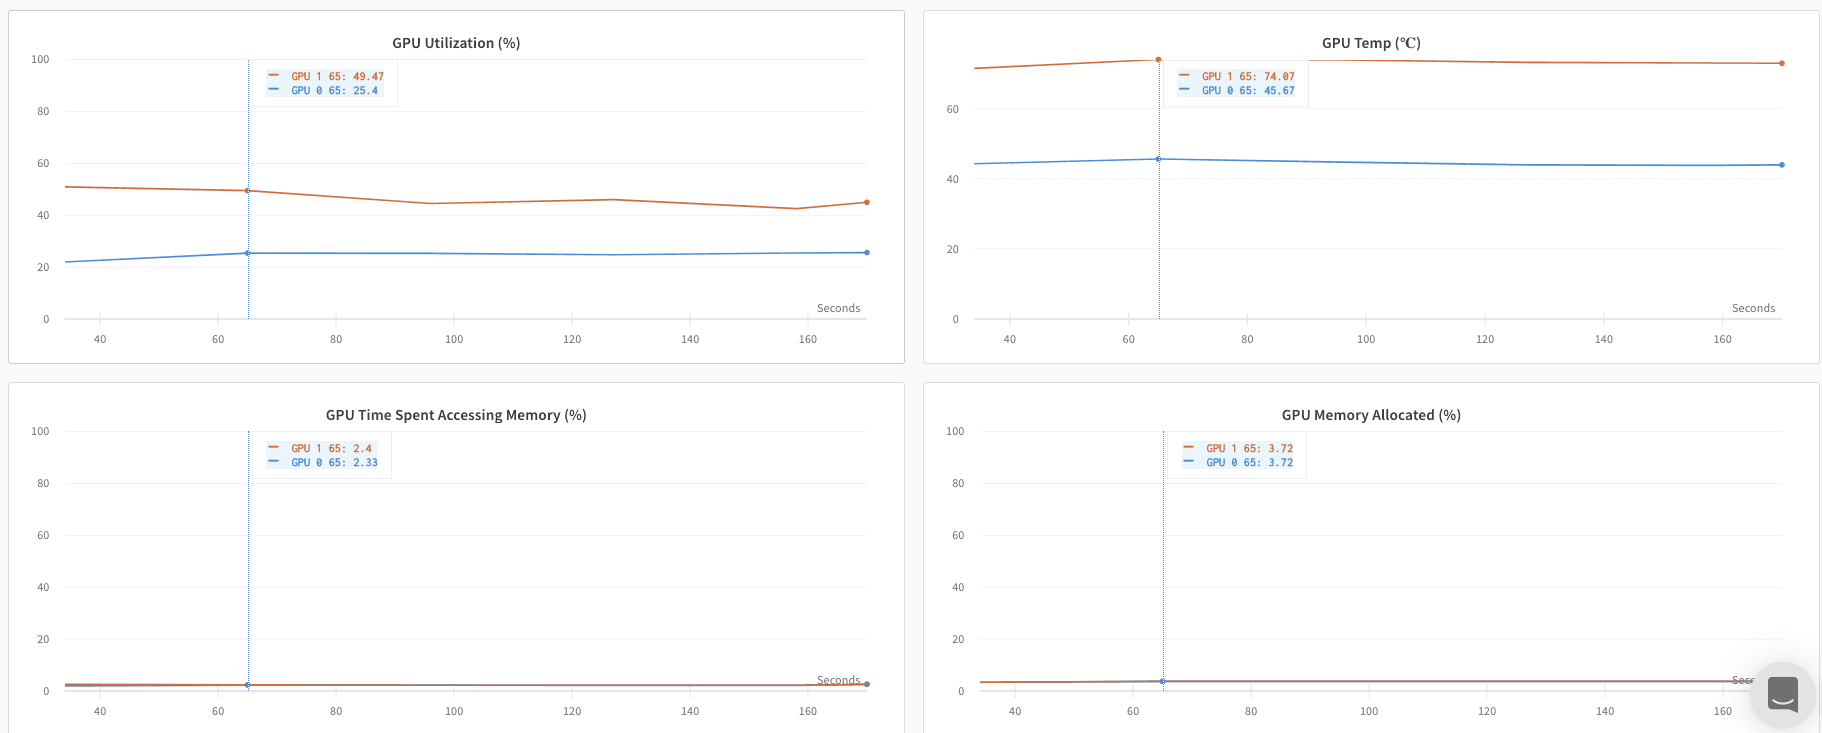
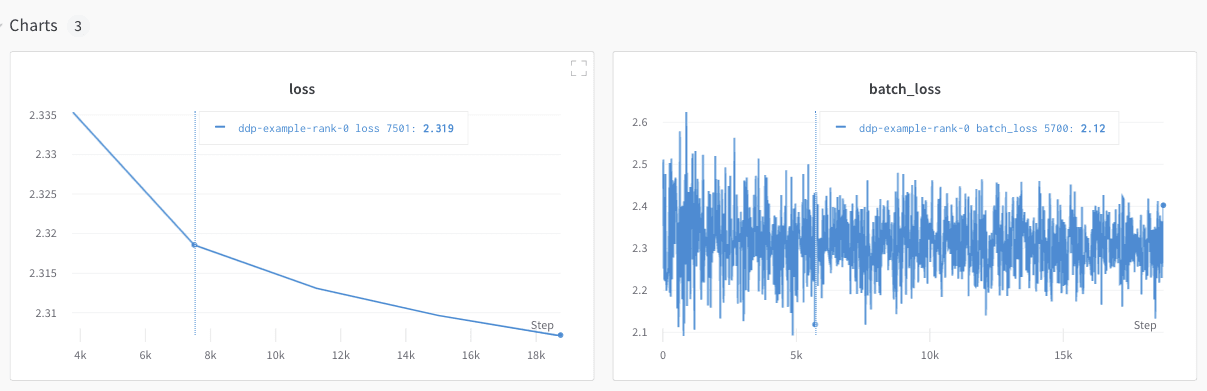
이 섹션에서는 rank 0 프로세스에서 사용할 수 있는 값과 메트릭을 추적하는 방법을 설명합니다. 이 방식은 단일 프로세스에서 얻을 수 있는 메트릭만 추적할 때 사용하세요. 대표적인 메트릭으로는 GPU/CPU 사용량, 공유 검증 세트에서의 동작, 그라디언트와 매개변수, 대표 데이터 예시에 대한 손실 값 등이 있습니다. rank 0 프로세스 내에서wandb.init()으로 W&B run을 초기화하고, 해당 run에 실험을 로깅하세요(wandb.Run.log()).
다음 샘플 Python 스크립트(log-ddp.py)는 PyTorch DDP를 사용하여 단일 머신의 GPU 두 개에서 메트릭을 추적하는 한 가지 방법을 보여줍니다. PyTorch DDP(torch.nn의 DistributedDataParallel)는 분산 트레이닝에 널리 사용되는 라이브러리입니다. 기본 원칙은 어떤 분산 트레이닝 환경에도 적용되지만, 구현 방식은 다를 수 있습니다.
이 Python 스크립트는 다음을 수행합니다.
torch.distributed.launch로 여러 프로세스를 시작합니다.--local_rank명령줄 인수로 rank를 확인합니다.- rank가 0이면
train()함수에서 조건부로wandb로깅을 설정합니다.
여러 프로세스 추적하기
W&B에서 여러 프로세스를 추적하려면 다음 방법 중 하나를 사용하세요.- 프로세스마다 run을 생성하여 각 프로세스를 개별적으로 추적합니다.
- 모든 프로세스를 단일 run으로 추적합니다.
각 프로세스를 개별적으로 추적하기
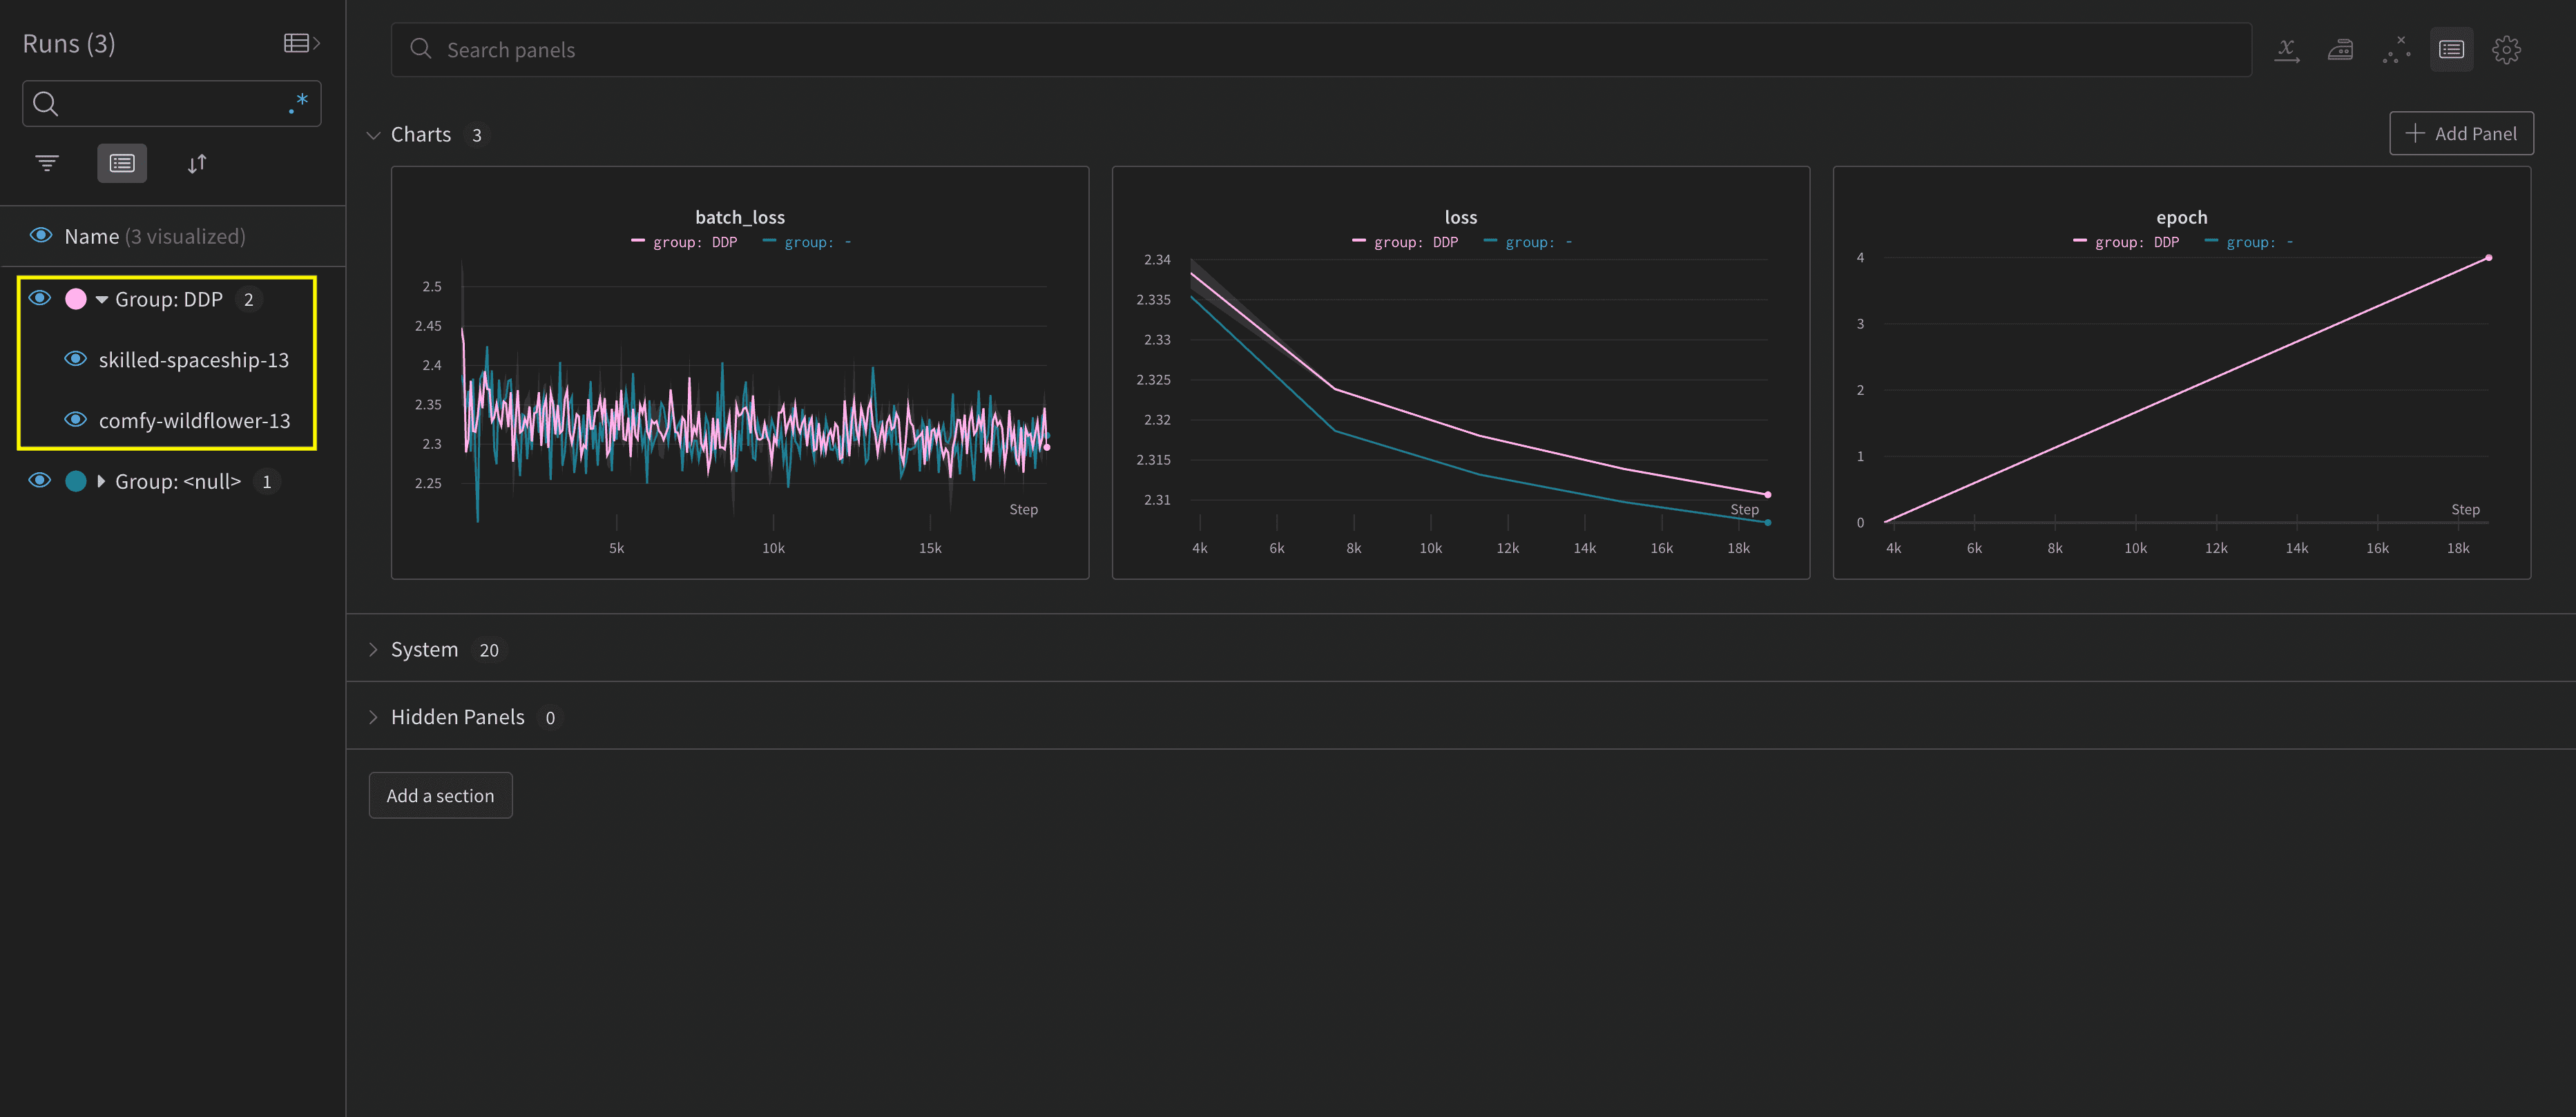
이 섹션에서는 프로세스마다 run을 생성하여 각 프로세스를 개별적으로 추적하는 방법을 설명합니다. 각 run에서는 메트릭, 아티팩트 등을 해당 run에 로깅합니다. 트레이닝이 끝나면wandb.Run.finish()를 호출하여 run이 완료되었음을 표시하고 모든 프로세스가 정상적으로 종료되도록 하세요.
여러 실험에 걸쳐 run을 추적하기가 어려울 수 있습니다. 이 문제를 줄이려면 W&B를 초기화할 때 group 매개변수에 값을 지정하여(wandb.init(group='group-name')) 각 run이 어떤 실험에 속하는지 추적하세요. 실험에서 트레이닝 및 평가 W&B run을 추적하는 방법에 대한 자세한 내용은 Group Runs를 참조하세요.
개별 프로세스의 메트릭을 추적하려면 이 방법을 사용하세요. 대표적인 예로는 각 노드의 데이터와 예측(데이터 분포 디버깅용), 메인 노드 이외의 개별 배치에 대한 메트릭이 있습니다. 모든 노드의 시스템 메트릭을 조회하거나 메인 노드에서 사용 가능한 요약 통계를 조회할 때는 이 방법을 사용하지 않아도 됩니다.
분산 run 구성하기
W&B를 초기화할 때(wandb.init(job_type='type-name')) job_type 매개변수를 설정하면 노드를 역할별로 분류할 수 있습니다. 예를 들어 전체 작업을 조율하는 메인 노드 하나와 결과를 보고하는 워커 노드 여러 개로 구성할 수 있습니다. 이 경우 메인 조율 노드의 job_type은 main으로, 보고용 워커 노드의 job_type은 worker로 설정하면 됩니다.
job_type을 설정한 후에는 워크스페이스에서 저장된 뷰를 만들어 run을 정리할 수 있습니다. 오른쪽 상단의 액션 () 메뉴를 클릭한 다음 Save as new view를 클릭하세요.
예를 들어 다음과 같은 저장된 뷰를 만들 수 있습니다.
- Default view: 워커 노드를 필터링으로 제외하여 불필요한 정보를 줄입니다
-
Filter를 클릭한 다음 Job Type을
worker로 설정하세요. - 리포팅 노드만 표시됩니다
-
Debug view: 문제 해결을 위해 워커 노드만 집중적으로 살펴봅니다
- Filter를 클릭한 다음 Job Type을
==worker로 설정하고 State를INcrashed로 설정하세요. - 크래시가 발생했거나 오류 상태인 워커 노드만 표시됩니다
- Filter를 클릭한 다음 Job Type을
-
All nodes view: 모든 노드를 한눈에 확인합니다
- 필터 없음
- 전체 모니터링에 유용합니다
-
Filter를 클릭한 다음 Job Type을
모든 프로세스를 단일 run으로 추적하기
요구 사항여러 프로세스를 단일 run으로 추적하려면 다음이 필요합니다.
-
W&B Python SDK 버전
v0.19.9이상 - W&B Server v0.68 이상
wandb.init()으로 W&B run을 초기화하세요. 이때 settings 매개변수에 다음 항목을 포함한 wandb.Settings 객체를 전달합니다(wandb.init(settings=wandb.Settings()).
- 공유 모드를 활성화하려면
mode매개변수를"shared"로 설정합니다. x_label에 고유한 레이블을 지정합니다.x_label에 지정한 값을 사용하면 W&B App UI의 로그와 시스템 메트릭에서 데이터가 어느 노드에서 왔는지 파악할 수 있습니다. 지정하지 않으면 W&B가 호스트 이름과 임의의 해시를 사용하여 레이블을 생성합니다.- 이 노드가 기본 노드임을 나타내려면
x_primary매개변수를True로 설정합니다. - 필요한 경우
x_stats_gpu_device_ids에 GPU 인덱스 목록([0,1,2])을 전달하여 W&B가 메트릭을 추적할 GPU를 지정할 수 있습니다. 목록을 전달하지 않으면 W&B는 머신의 모든 GPU에 대한 메트릭을 추적합니다.
WANDB_RUN_ID 환경 변수를 생성한 run ID로 설정하세요. 프로세스가 wandb.init()을 호출하면 W&B가 WANDB_RUN_ID를 자동으로 읽습니다.
x_primary=True는 기본 노드와 워커 노드를 구분합니다. 설정 파일, telemetry 등 노드 간에 공유되는 파일은 기본 노드만 업로드하며, 워커 노드는 이러한 파일을 업로드하지 않습니다.wandb.init()으로 W&B run을 초기화하고 다음을 지정하세요.
settings매개변수에 다음 항목을 포함한wandb.Settings객체(wandb.init(settings=wandb.Settings())를 전달합니다.- 공유 모드를 활성화하려면
mode매개변수를"shared"로 설정합니다. x_label에 고유한 레이블을 지정합니다.x_label에 지정한 값을 사용하면 W&B App UI의 로그와 시스템 메트릭에서 데이터가 어느 노드에서 왔는지 파악할 수 있습니다. 지정하지 않으면 W&B가 호스트 이름과 임의의 해시를 사용하여 레이블을 생성합니다.- 이 노드가 워커 노드임을 나타내려면
x_primary매개변수를False로 설정합니다.
- 공유 모드를 활성화하려면
- 워커 프로세스가 시작되기 전에
WANDB_RUN_ID를 기본 노드와 동일한 run ID로 설정합니다. - 필요한 경우
x_update_finish_state를False로 설정합니다. 이렇게 하면 기본 노드가 아닌 노드가 run 상태를 너무 일찍finished로 업데이트하는 것을 막을 수 있어, run 상태가 일관되게 유지되고 기본 노드에서 관리됩니다.
WANDB_RUN_ID를 설정한 후 각 프로세스 내에서 W&B를 설정하는 방법을 보여 줍니다.
다음 예시는 기본 노드에서 run을 초기화합니다.
GKE의 멀티 노드 및 멀티 GPU Kubernetes 클러스터에서 모델을 트레이닝하는 전체 예시는 Distributed Training with Shared Mode 리포트를 참조하세요.
- run이 포함된 프로젝트로 이동하세요.
- 프로젝트 사이드바에서 Runs 탭을 클릭하세요.
- 확인하려는 run을 클릭하세요.
- 프로젝트 사이드바에서 Logs 탭을 클릭하세요.
x_label에 지정한 레이블을 기준으로 콘솔 로그를 필터링할 수 있습니다. 예를 들어, 다음 이미지는 x_label에 rank0, rank1, rank2, rank3, rank4, rank5, rank6 값을 지정했을 때 콘솔 로그 필터링에 사용할 수 있는 옵션을 보여줍니다.`
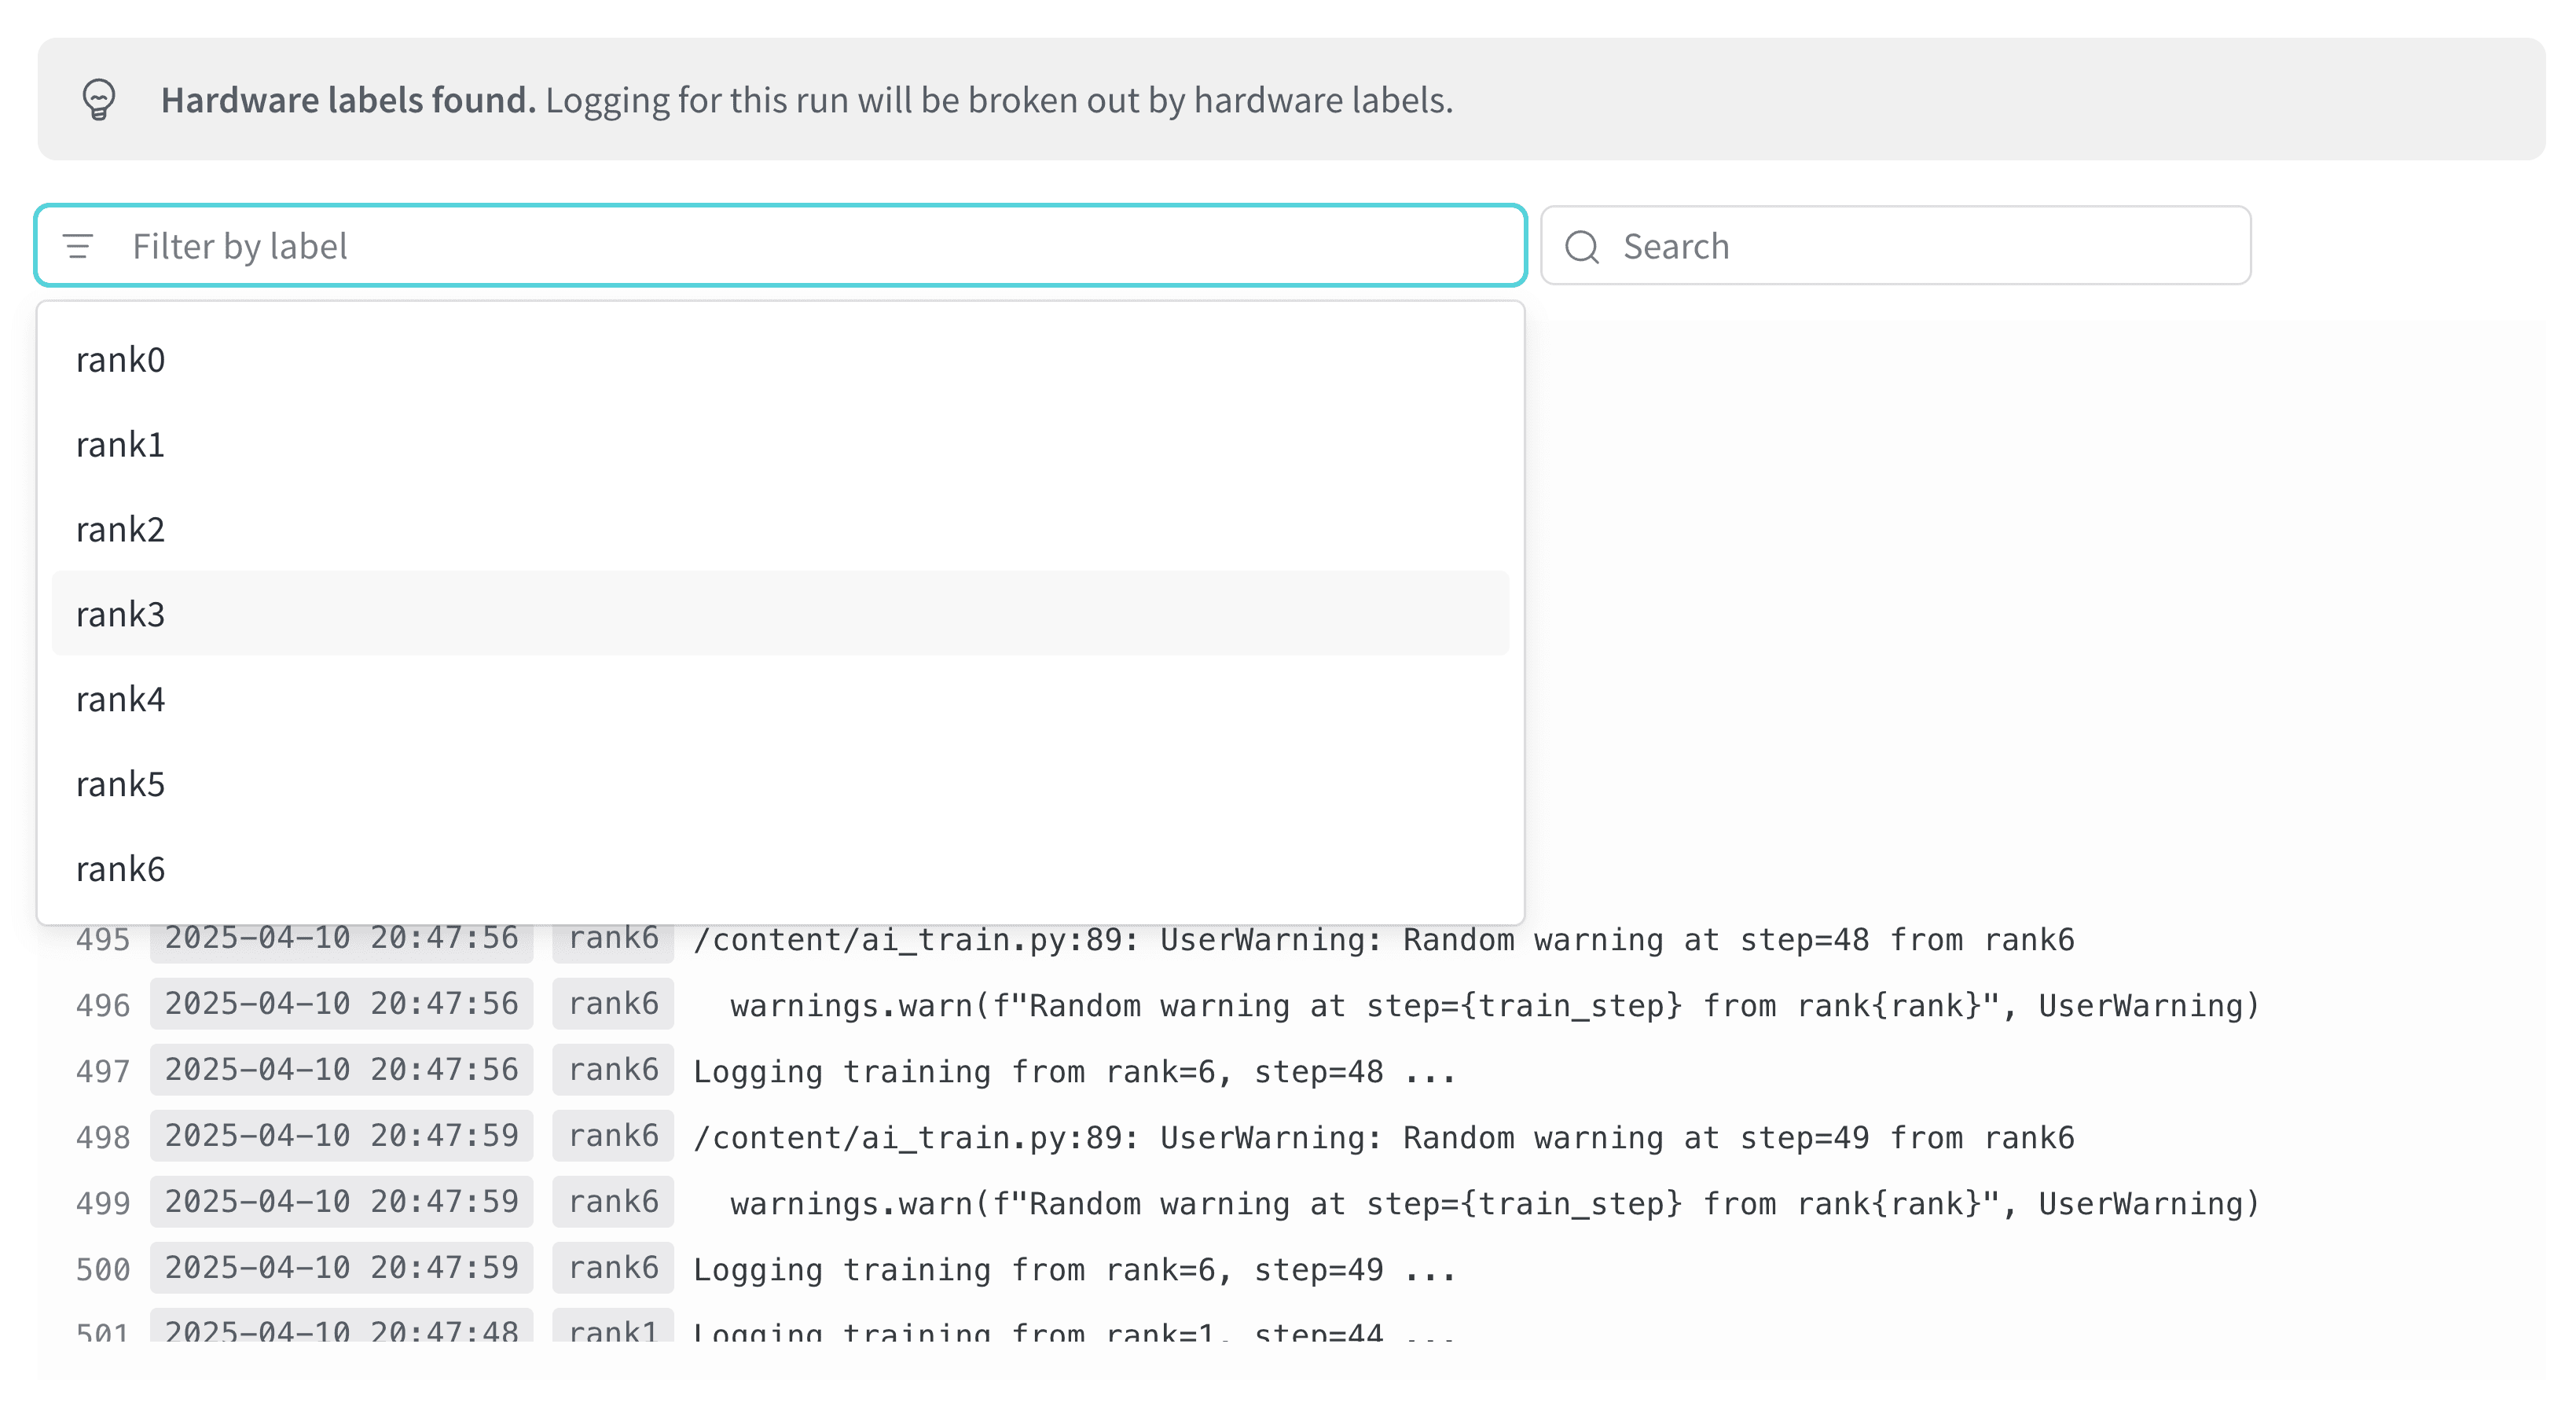
x_label 매개변수에 지정한 고유 레이블(rank_0, rank_1, rank_2)이 붙습니다.
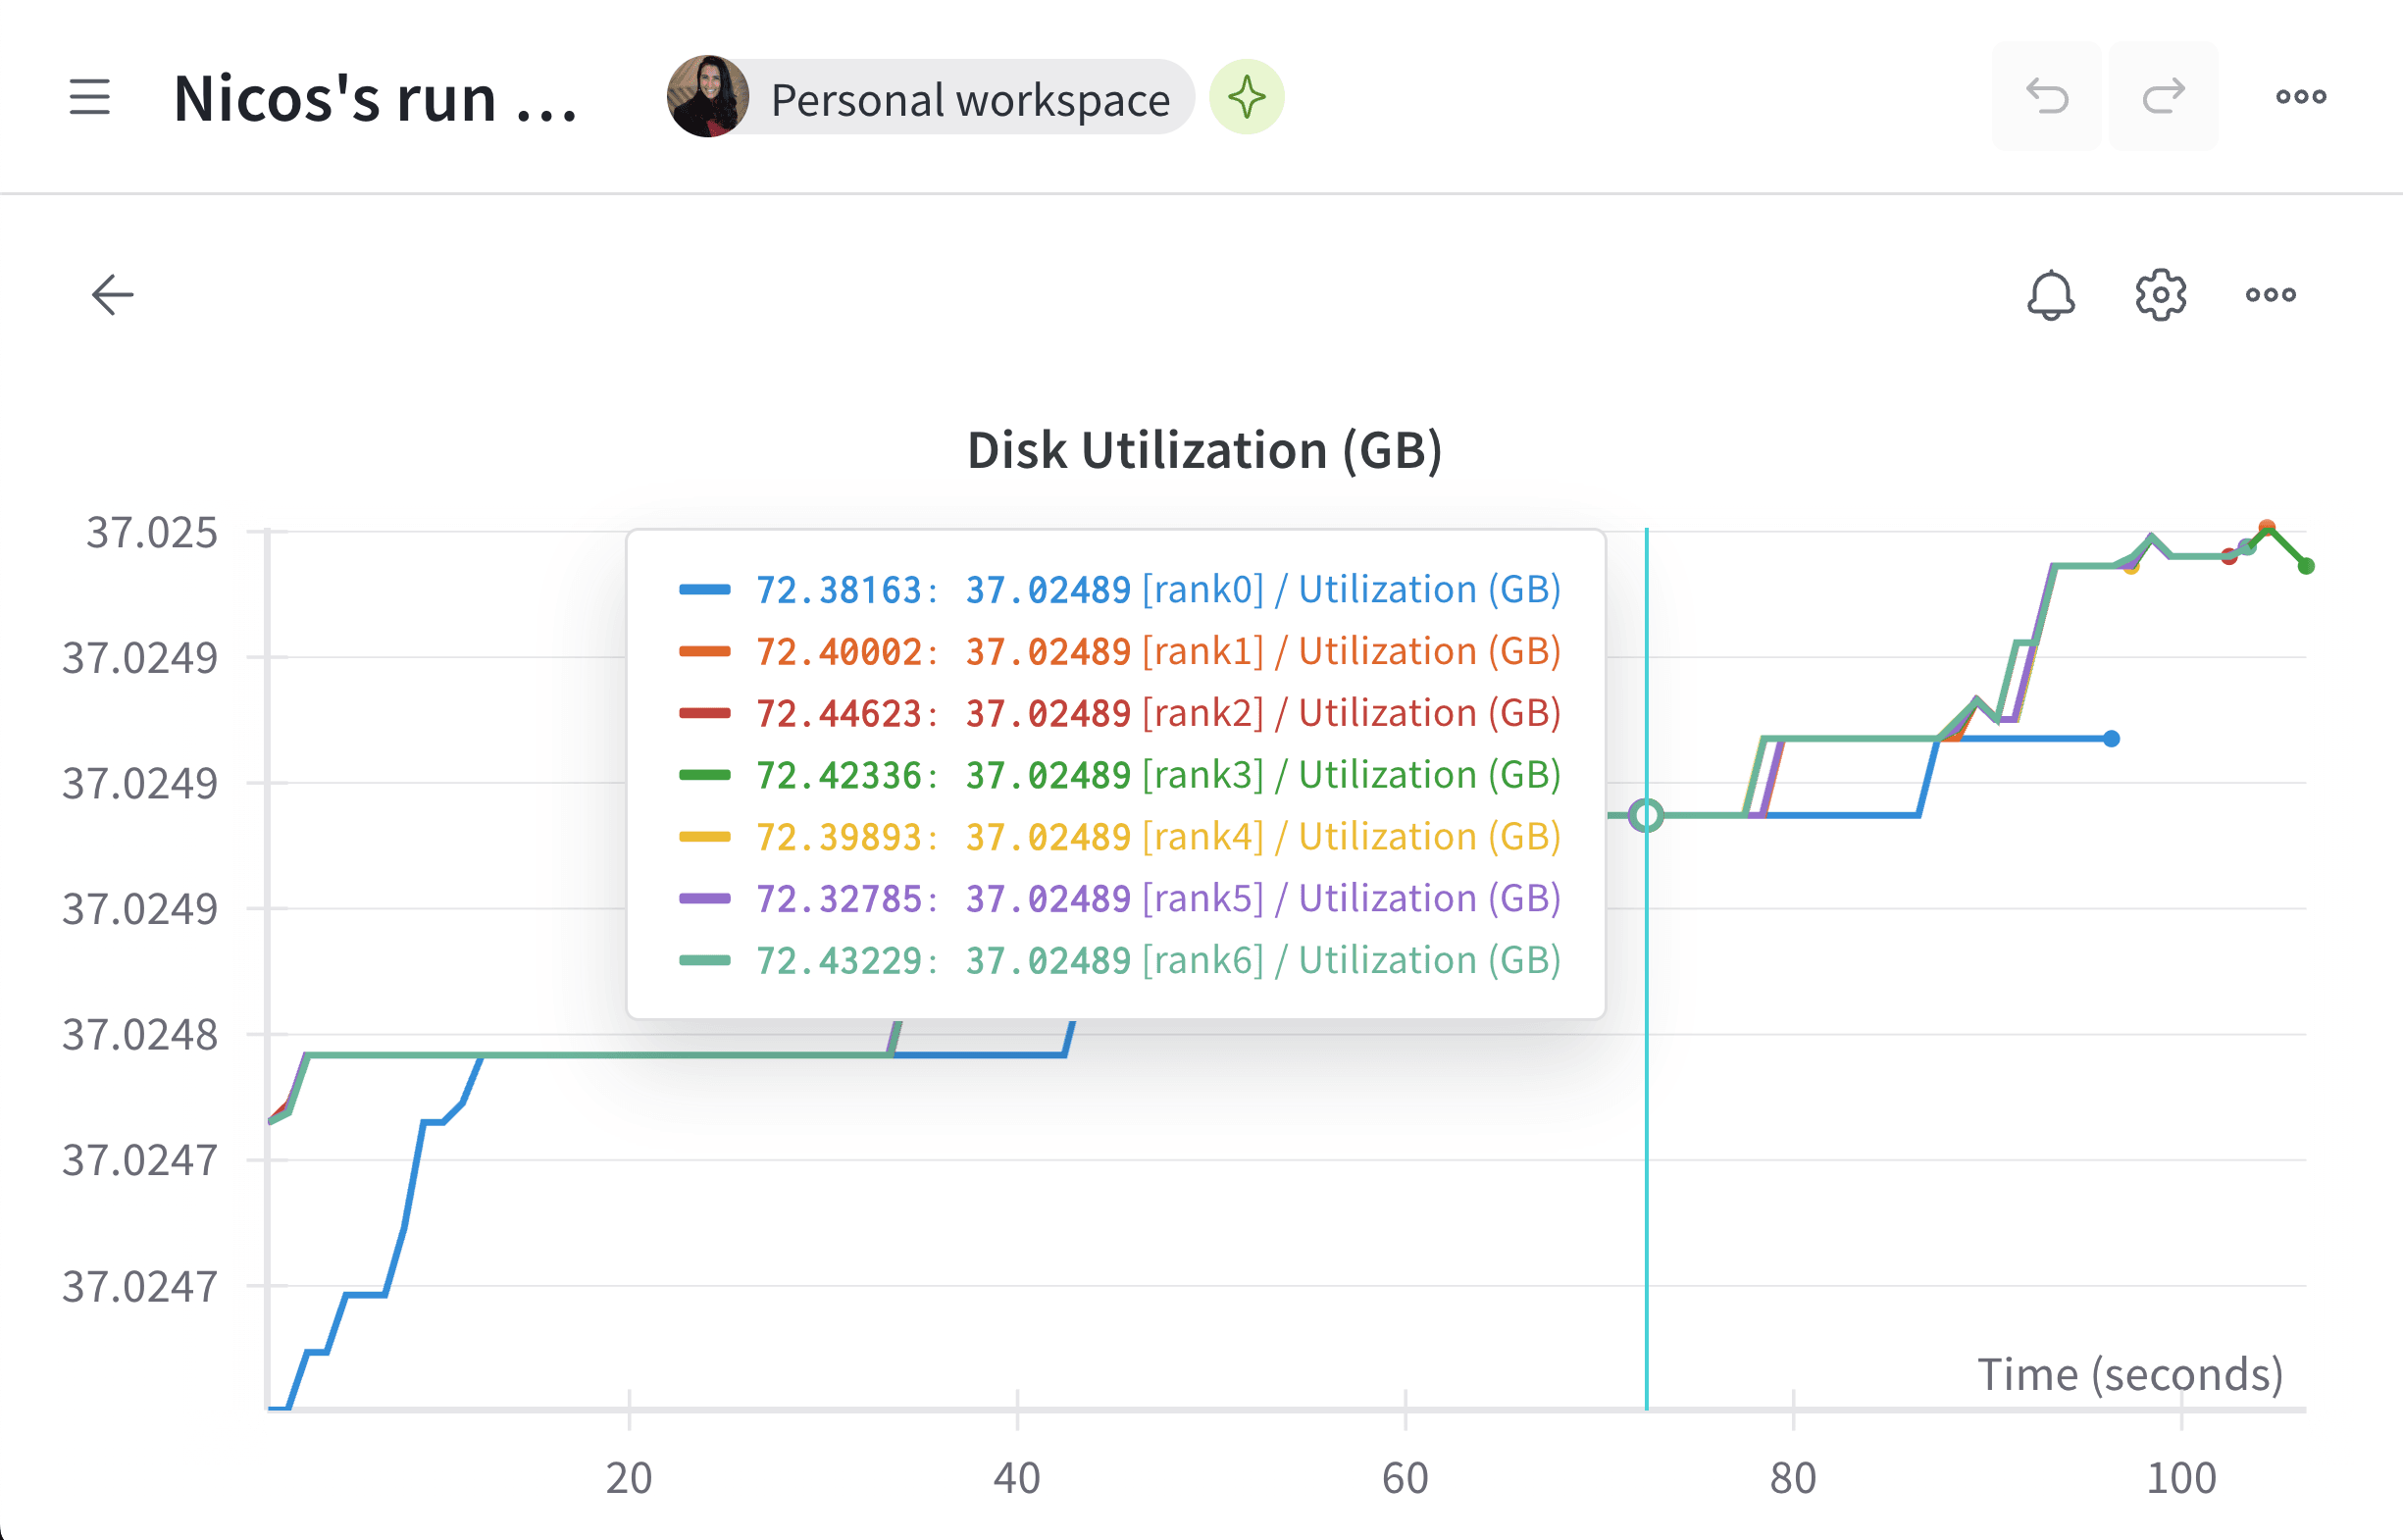
사용 사례 예시
다음 코드 스니펫은 고급 분산 환경에서 자주 사용되는 시나리오를 보여줍니다.Spawn 프로세스
spawn된 프로세스에서 run을 시작하는 경우 main 함수에서wandb.setup() 메서드를 사용하세요:
run 공유하기
프로세스 간에 run을 공유하려면 run 객체를 인수로 전달하세요.문제 해결
W&B와 분산 트레이닝을 함께 사용할 때 흔히 발생하는 문제는 두 가지입니다.- 트레이닝 시작 시 멈춤 -
wandb의 멀티프로세싱이 분산 트레이닝의 멀티프로세싱과 충돌하면wandb프로세스가 멈출 수 있습니다. - 트레이닝 종료 시 멈춤 -
wandb프로세스가 언제 종료해야 하는지 알지 못하면 트레이닝 작업이 멈출 수 있습니다. Python 스크립트 끝에서wandb.Run.finish()API를 호출해 run이 완료되었음을 W&B에 알리세요.wandb.Run.finish()API를 호출하면 데이터 업로드가 마무리되고 W&B가 종료됩니다. 분산 작업의 안정성을 높이려면wandb service명령을 사용하는 것이 좋습니다. 앞서 설명한 두 가지 트레이닝 문제는 모두 wandb service를 사용할 수 없는 W&B SDK 버전에서 주로 발생합니다.
W&B Service 활성화
사용 중인 W&B SDK 버전에 따라 W&B Service가 이미 기본적으로 활성화되어 있을 수 있습니다.W&B SDK 0.13.0 이상
W&B SDK0.13.0 이상 버전에서는 W&B Service가 기본적으로 활성화되어 있습니다.
W&B SDK 0.12.5 이상
W&B SDK 버전 0.12.5 이상에서 W&B Service를 활성화하려면 Python 스크립트를 수정하세요. main 함수 안에서wandb.require() 메서드를 호출하고 문자열 "service"를 전달하세요.
WANDB_START_METHOD 환경 변수를 "thread"로 설정하여 멀티스레딩을 대신 사용하세요.