Weave로 모델 평가하기
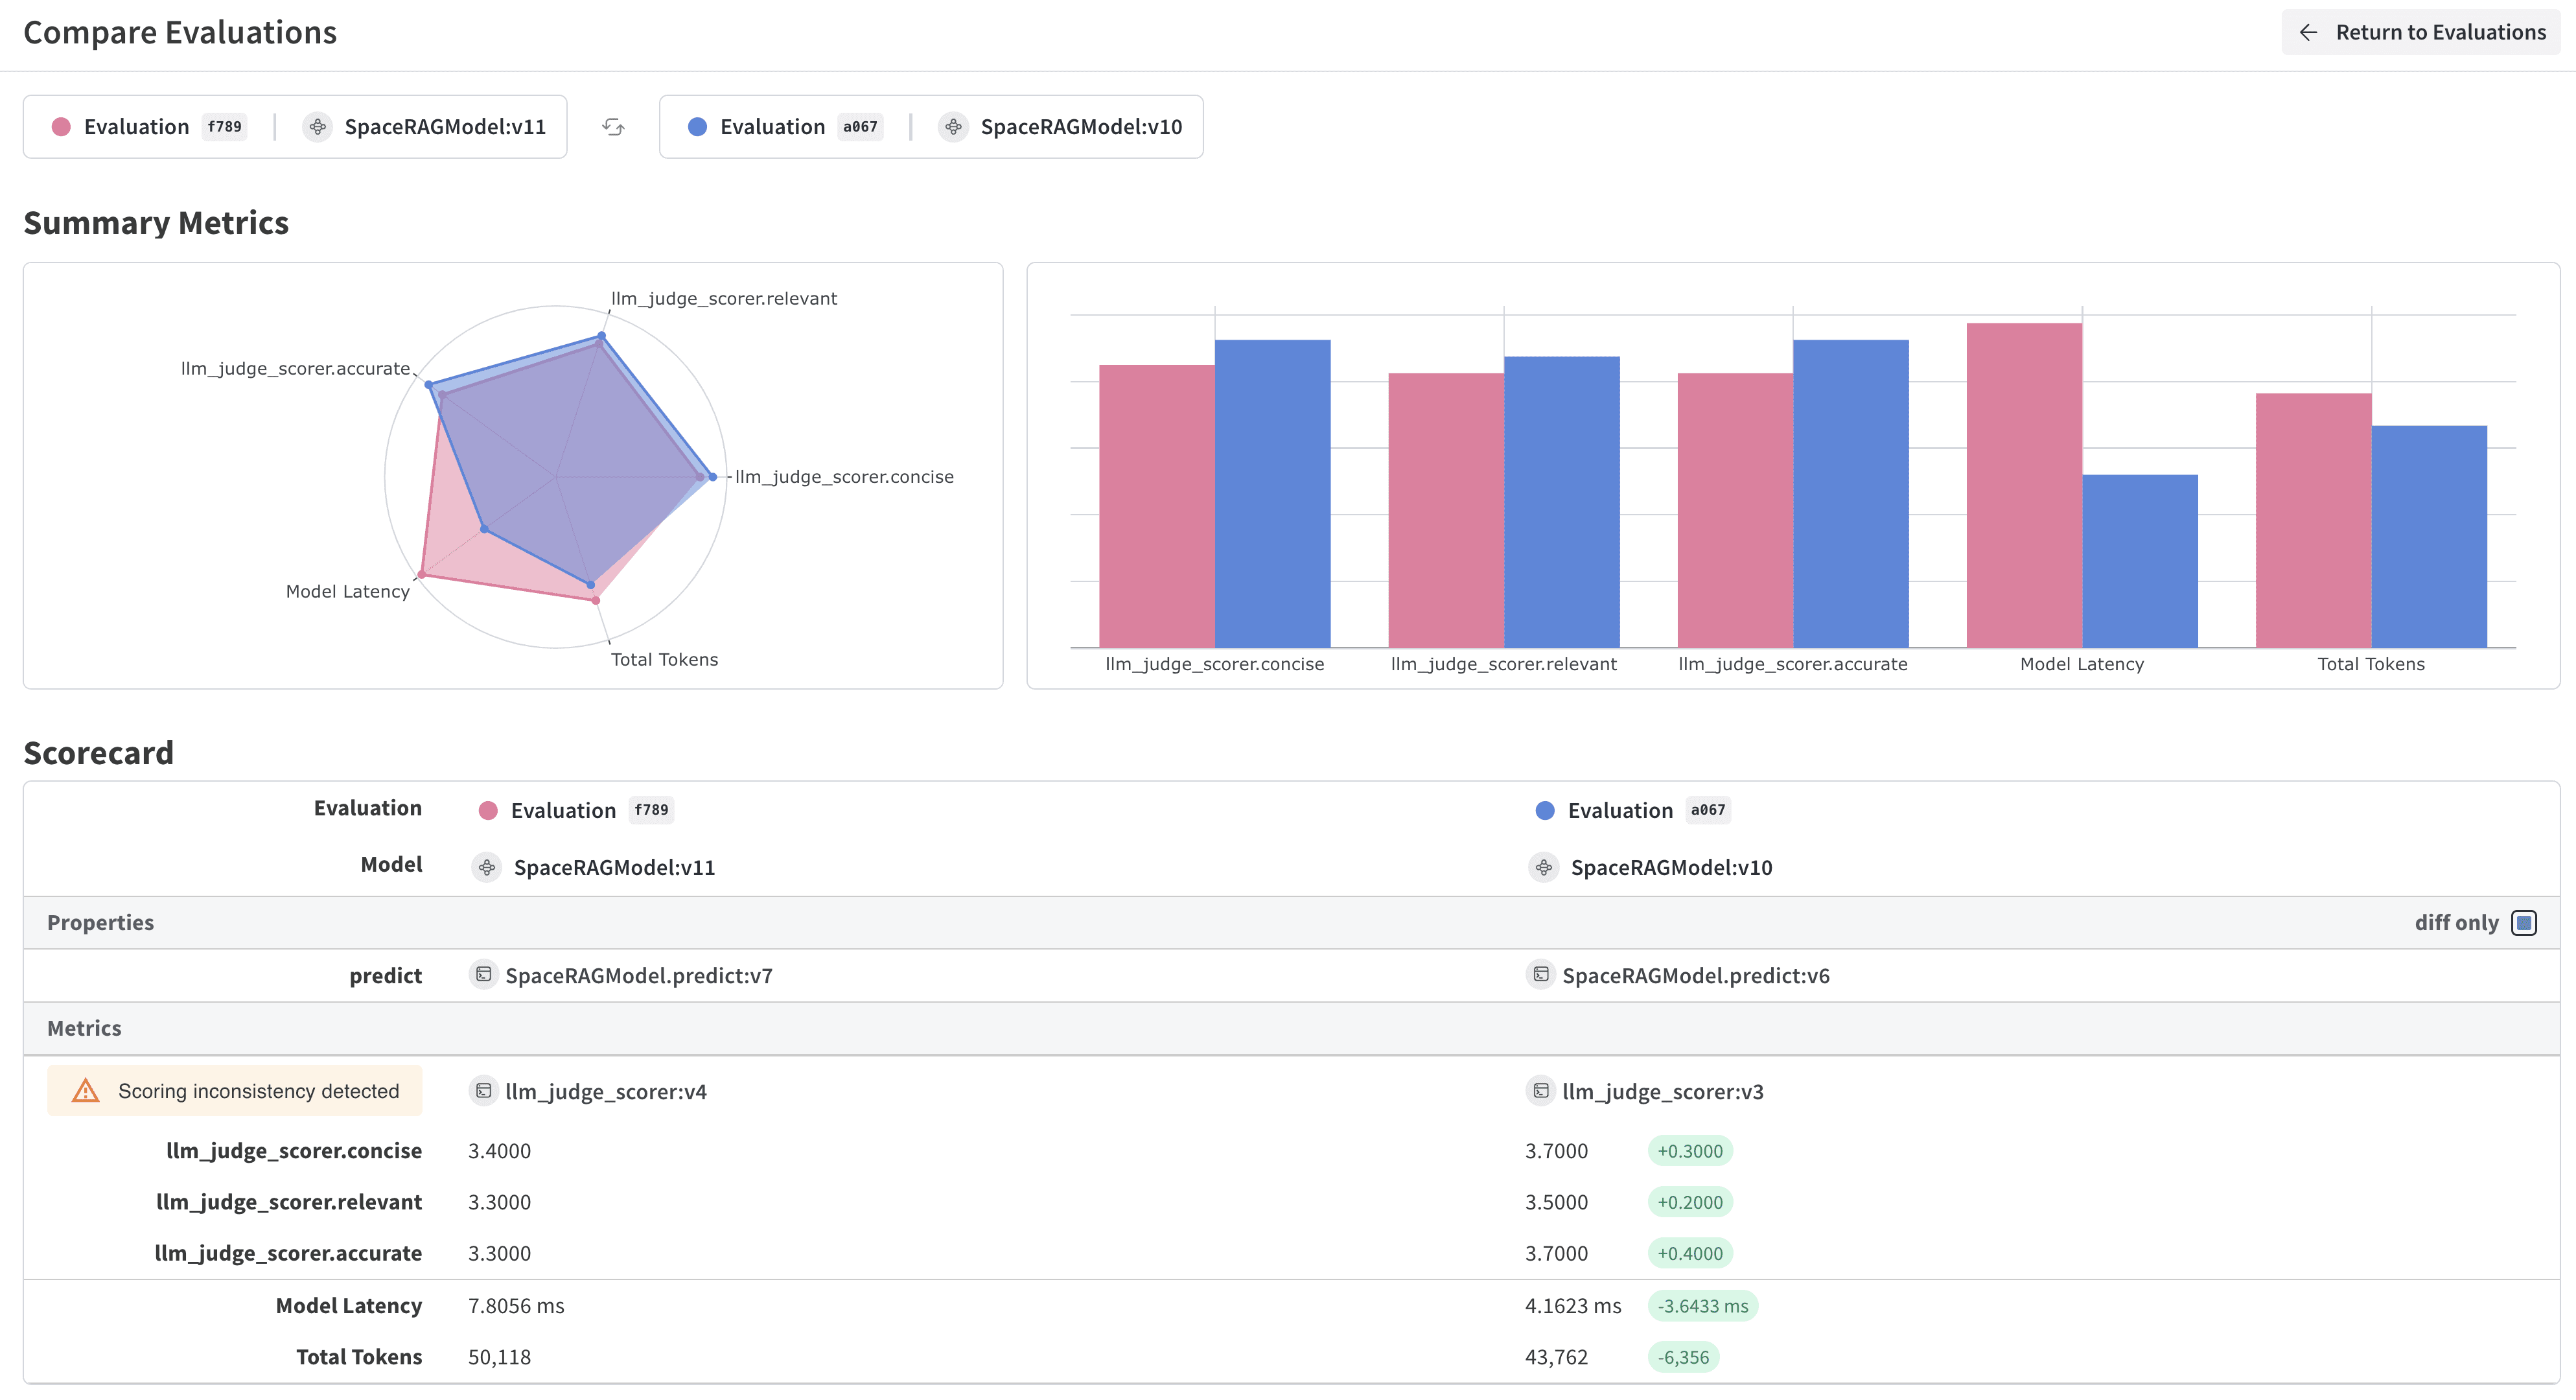
W&B Weave는 LLM과 GenAI 애플리케이션 평가를 위해 특별히 설계된 툴킷입니다. Scorer, 평가자, 상세 트레이싱 등 포괄적인 평가 기능을 제공하므로 모델 성능을 파악하고 개선할 수 있습니다. Weave는 W&B Models와 통합되므로 모델 레지스트리에 저장된 모델을 평가할 수 있습니다.
모델 평가를 위한 주요 기능
- Scorer 및 평가자: 정확도, 관련성, 일관성 등을 위한 사전 구축 및 맞춤형 평가 메트릭
- 평가 데이터셋: 체계적인 평가를 위한 그라운드 트루스가 포함된 구조화된 테스트 세트
- 모델 버전 관리: 모델의 다양한 버전을 추적하고 비교
- 상세 트레이싱: 완전한 입력/출력 트레이스로 모델 동작 디버그
- 비용 추적: 평가 전반에 걸쳐 API 비용 및 토큰 사용량 모니터링
Getting Started: 레지스트리에서 모델 평가하기
W&B Models 레지스트리에서 모델을 다운로드한 후 Weave로 평가하세요.
Weave 평가를 W&B Models와 통합하기
Models and Weave Integration Demo에서는 다음을 위한 완전한 워크플로를 보여줍니다:
- 레지스트리에서 모델 로드: W&B Models 레지스트리에 저장된 fine-tuned 모델 다운로드
- 평가 파이프라인 생성: 맞춤형 Scorer로 종합적인 평가 구축
- W&B에 결과 로깅: 평가 메트릭을 모델 run에 연결
- 평가된 모델 버전 관리: 개선된 모델을 레지스트리에 다시 저장
Weave와 W&B Models 모두에 평가 결과 로깅:
Weave 고급 기능
맞춤형 Scorer 및 평가자
사용 사례에 맞춘 정교한 평가 메트릭을 만드세요:
배치 평가
여러 모델 버전 또는 설정을 평가하세요:
다음 단계
table로 모델 평가
W&B Tables를 사용하여:
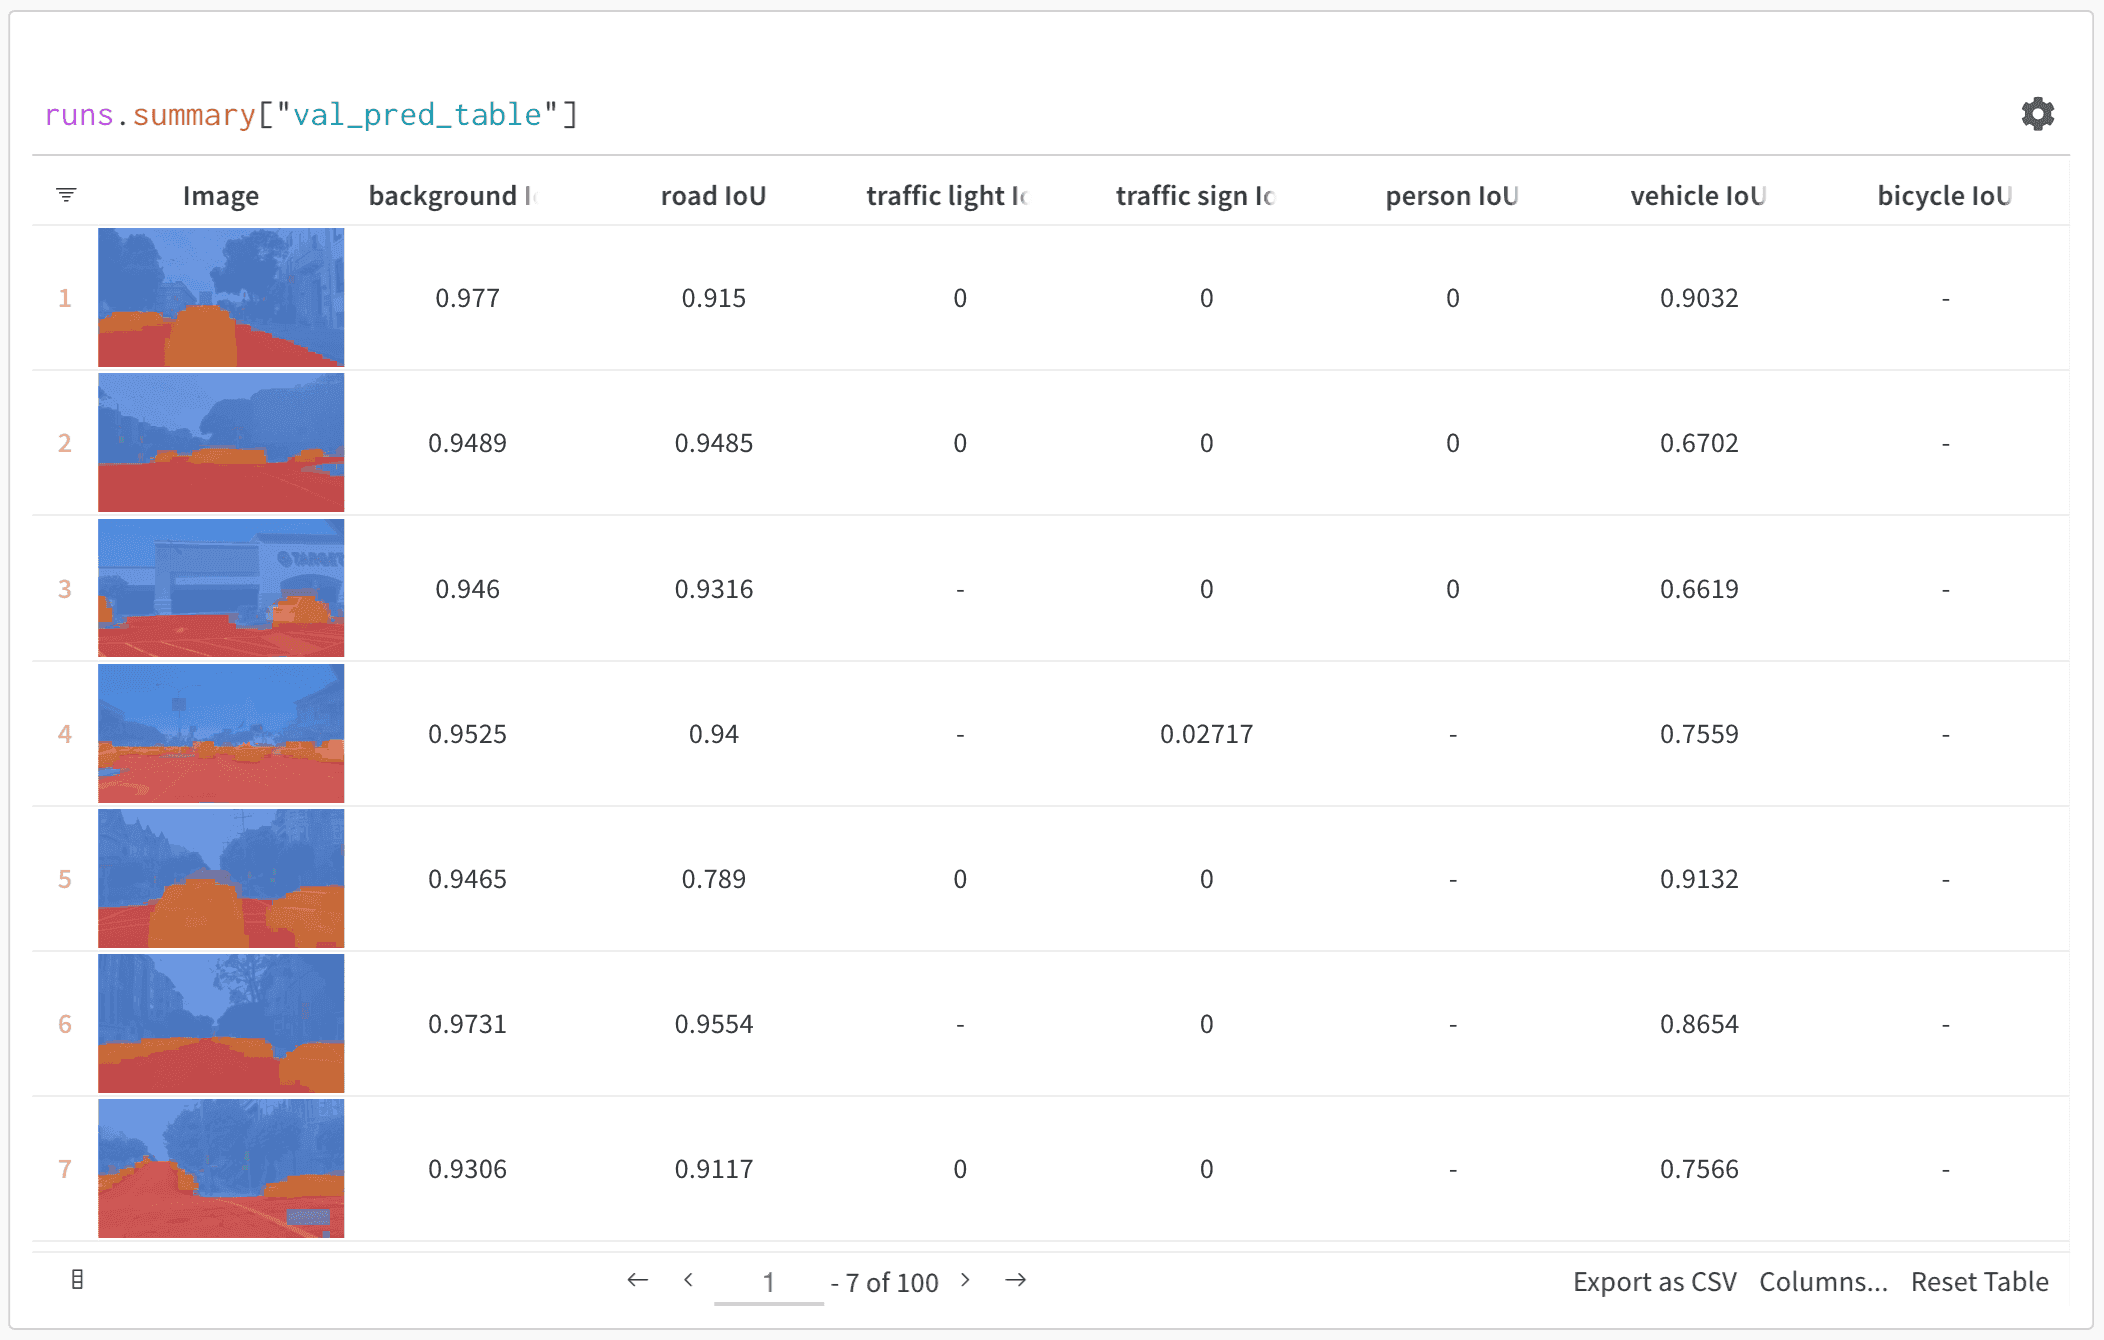
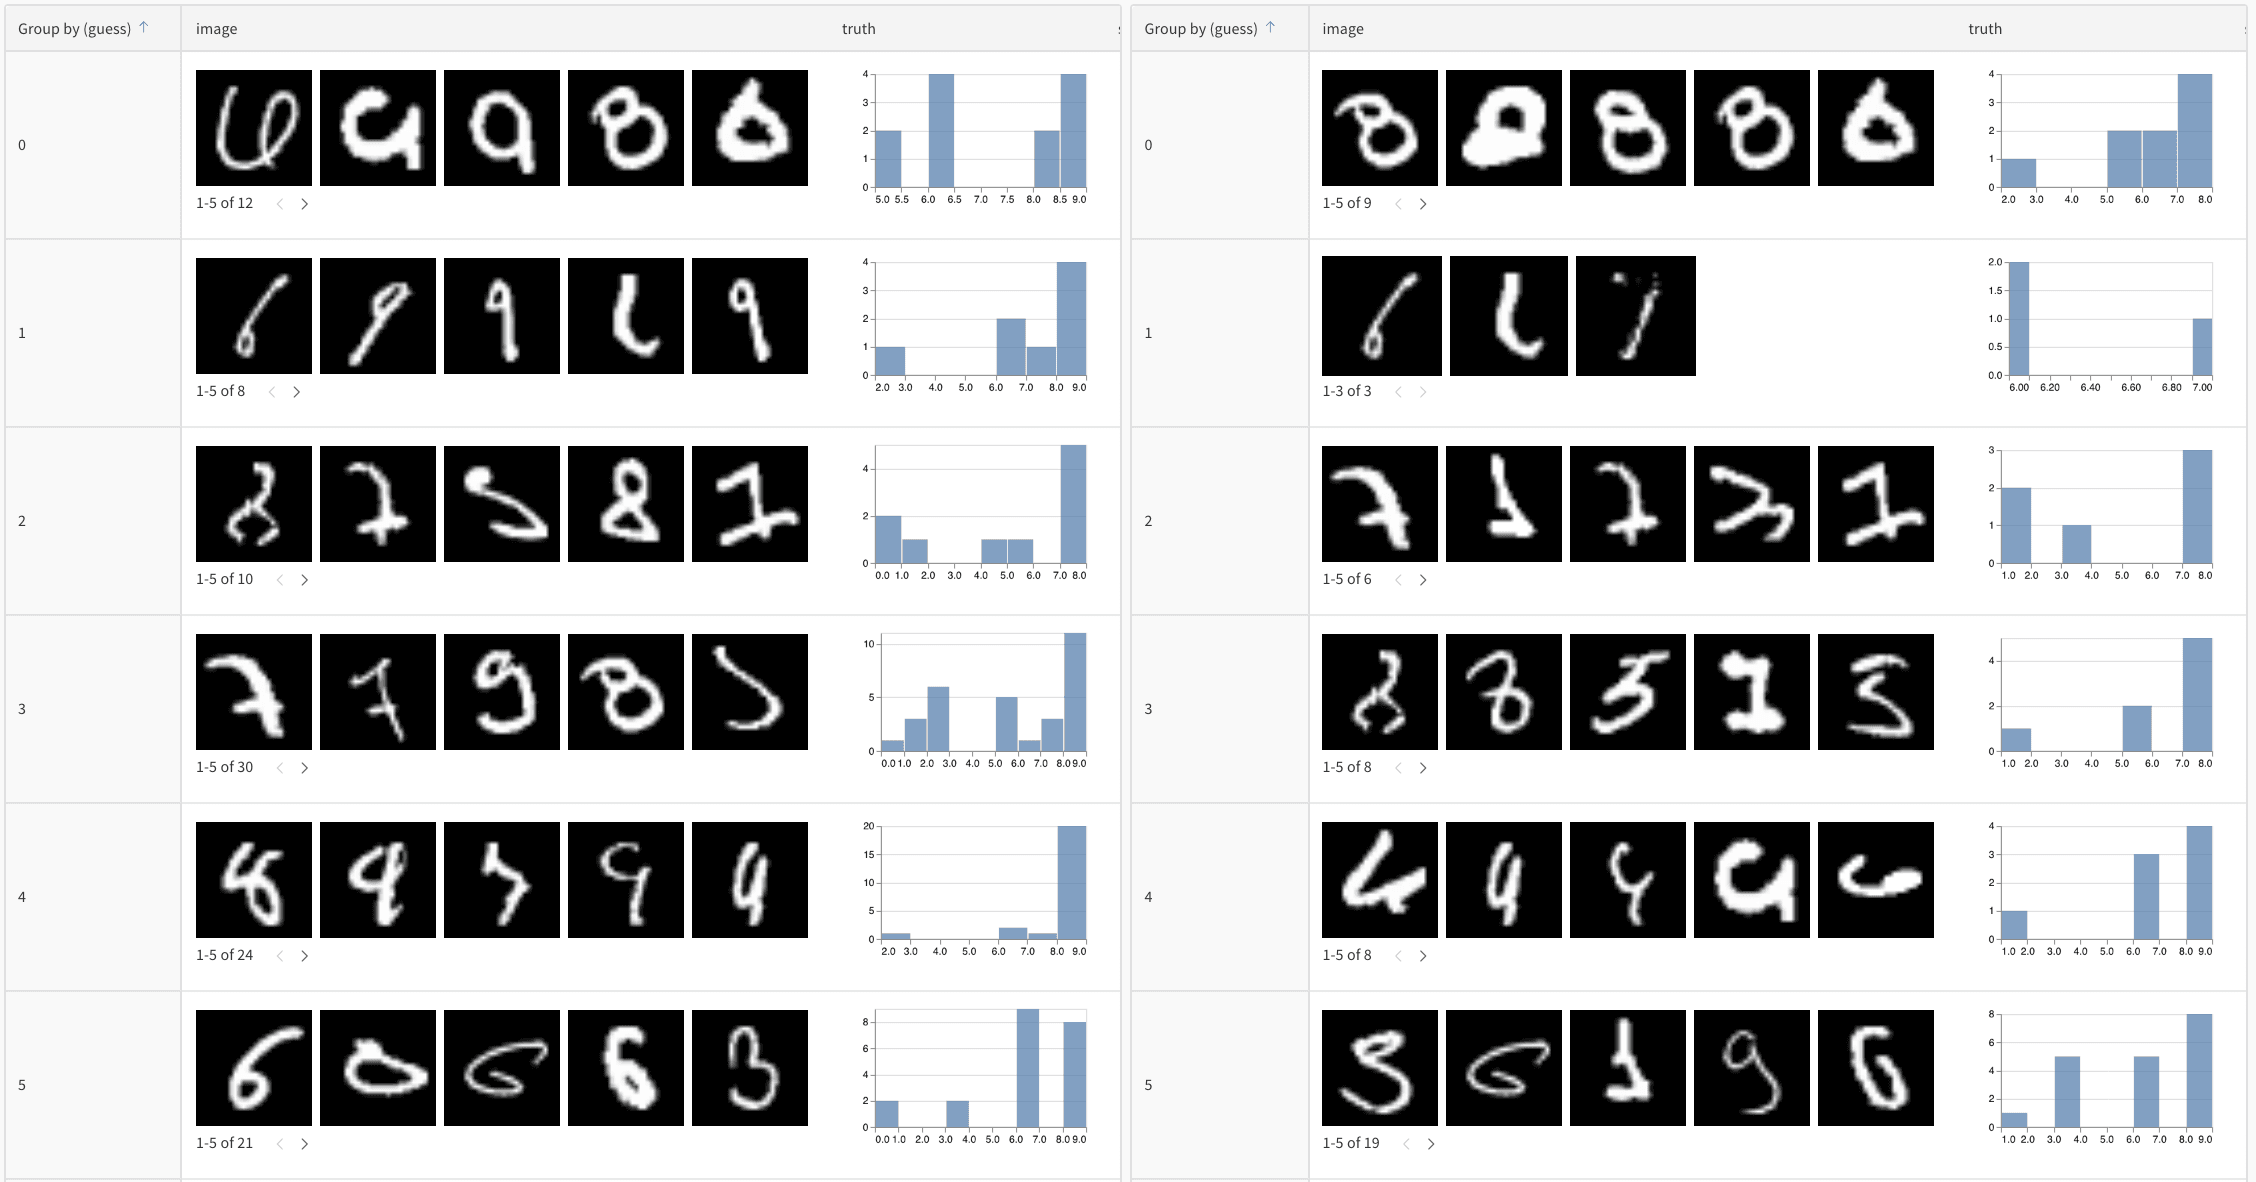
- 모델 예측 비교: 동일한 테스트 세트에서 서로 다른 모델의 성능을 나란히 비교하여 확인
- 예측 변경 추적: 트레이닝 에포크 또는 모델 버전에 걸쳐 예측이 어떻게 변화하는지 모니터링
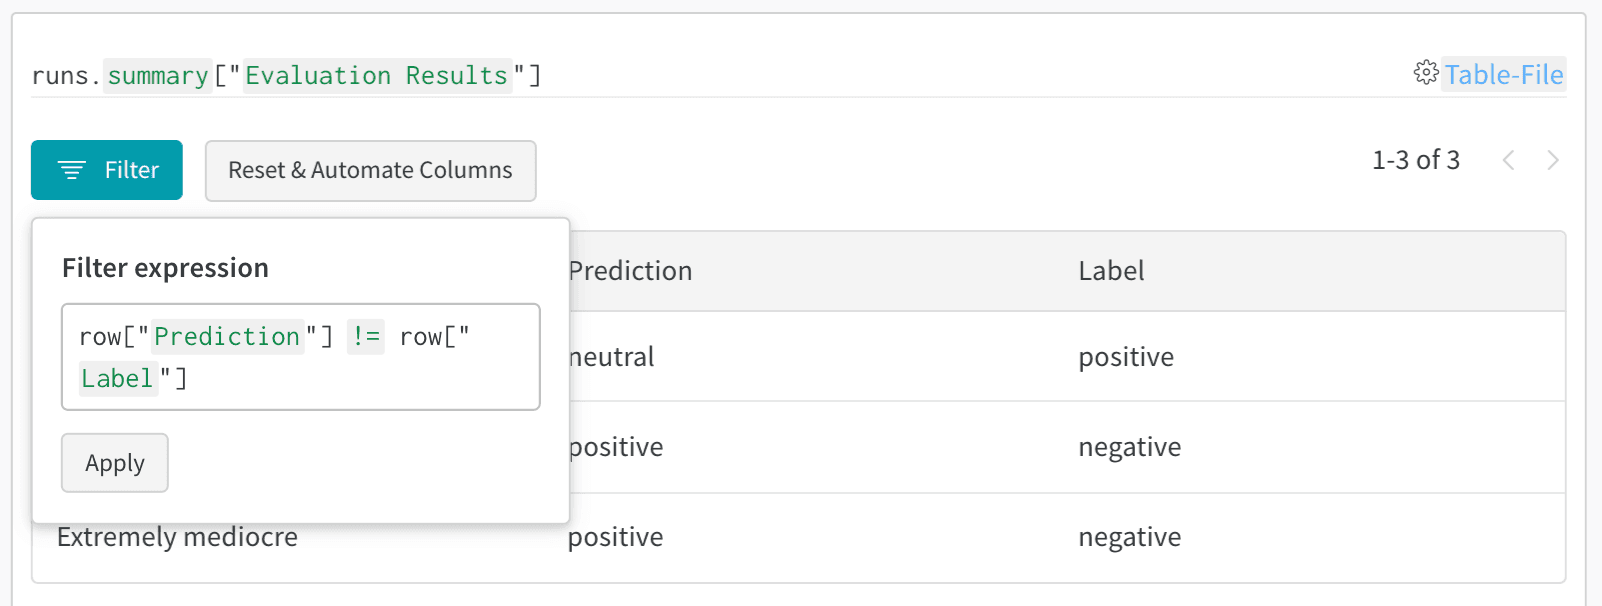
- 오류 분석: Filter와 쿼리를 사용하여 일반적으로 잘못 분류된 예시와 오류 패턴 찾기
- 리치 미디어 시각화: 예측 및 메트릭과 함께 이미지, 오디오, 텍스트 및 기타 미디어 유형 표시
기본 예시: 평가 결과 로깅하기
고급 table 워크플로
여러 모델 비교
여러 모델의 eval table을 동일한 키에 로깅하여 직접 비교하세요:
시간에 따른 예측 추적
트레이닝 에포크별로 table을 로깅하여 개선 추이를 시각화하세요:
W&B UI에서의 대화형 분석
데이터를 로깅한 후 다음을 수행할 수 있습니다:
- 결과 필터링: 열 헤더를 클릭하여 예측 정확도, 신뢰도 임계값 또는 특정 클래스로 필터링하세요
- table 비교: 여러 table 버전을 선택하여 나란히 비교를 확인하세요
- 데이터 쿼리: 쿼리 바를 사용하여 특정 패턴을 찾으세요 (예:
"correct" = false AND "confidence" > 0.8)
- 그룹화 및 집계: 예측된 클래스로 그룹화하여 클래스별 정확도 메트릭을 확인하세요
예시: 정보를 보강한 table을 활용한 오류 분석
Last modified on September 30, 2026