이 노트북에서 다루는 내용
이 튜토리얼에서는 W&B를 PyTorch 트레이닝 코드와 통합하여 실험을 추적하고, 메트릭과 그라디언트를 로깅하고, 모델 버전을 관리하는 방법을 설명합니다. 이를 활용하여 기존 PyTorch 파이프라인에 실험 추적을 추가하세요.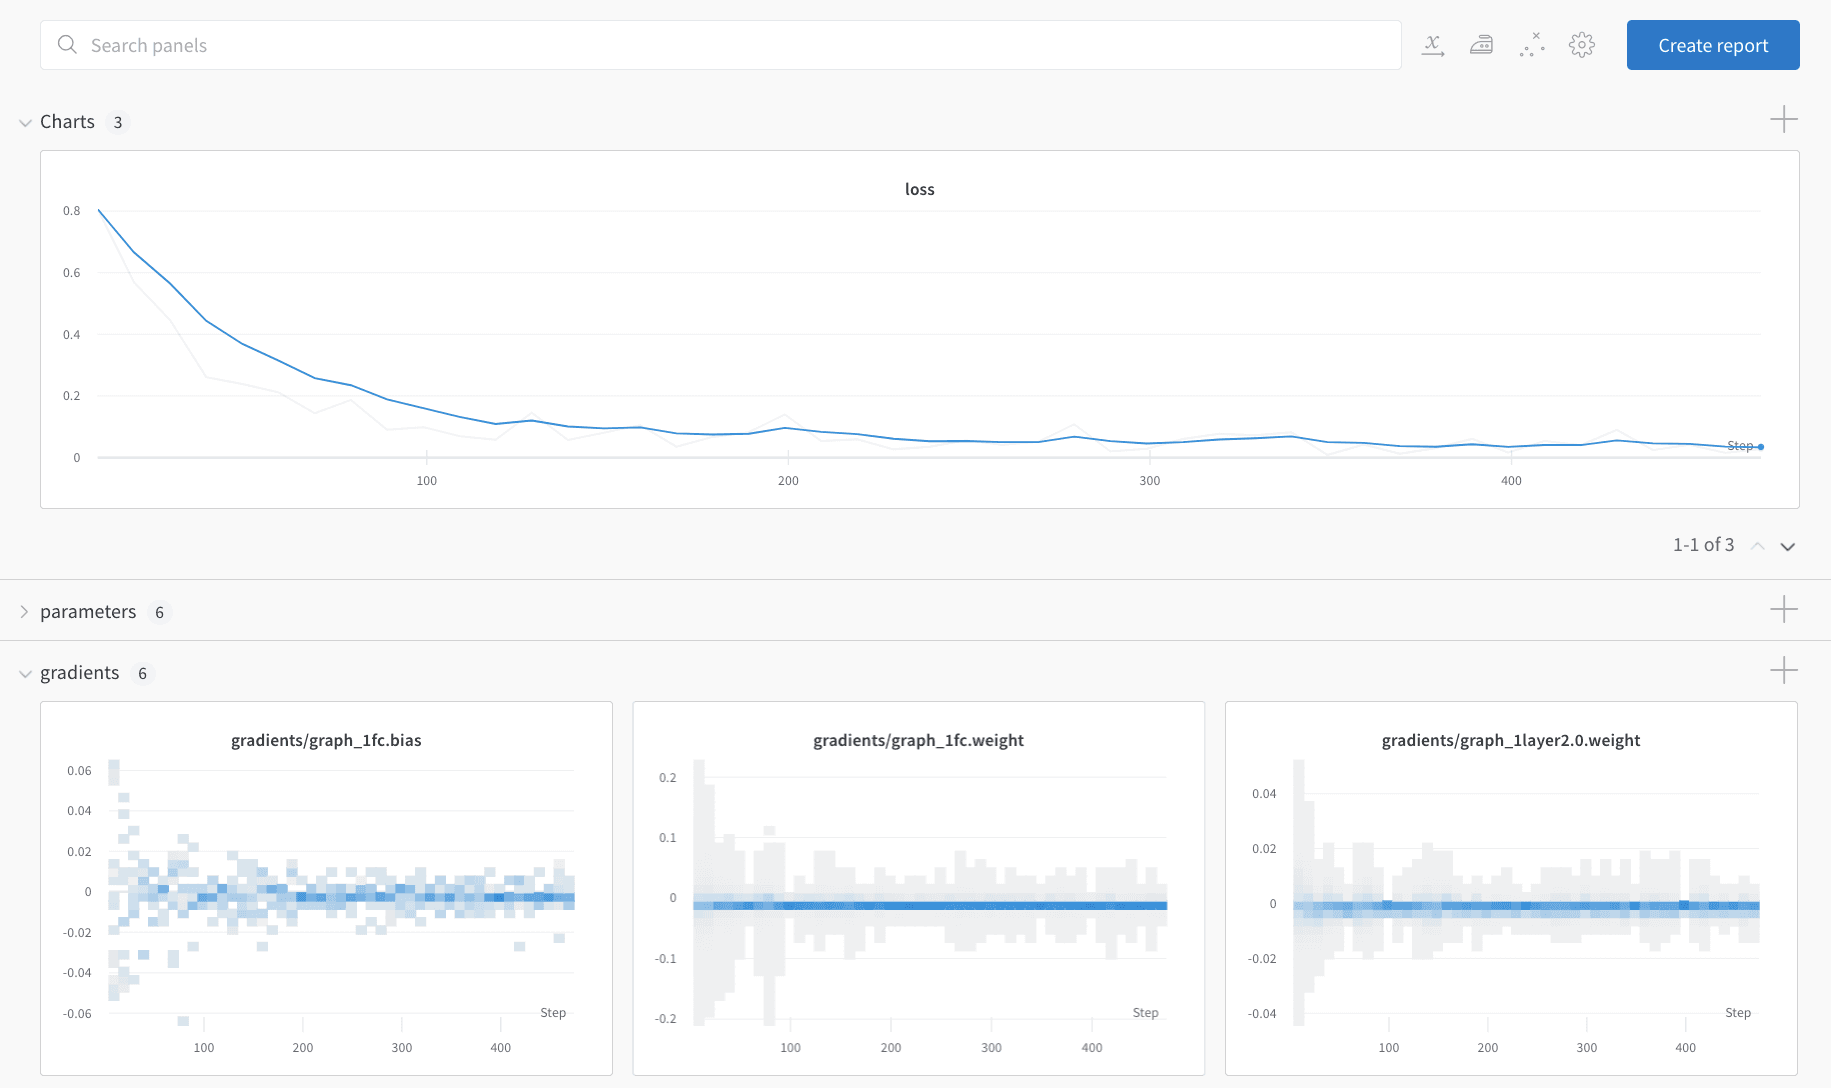
설치, 임포트 및 로그인
실험을 정의하기 전에 환경을 설정하고 W&B 인증을 완료하세요.단계 0: W&B 설치
시작하려면wandb 라이브러리를 pip로 설치해야 합니다.
1단계: W&B 임포트 및 로그인
W&B 서비스에 데이터를 로깅하려면 로그인해야 합니다. W&B를 처음 사용하는 경우, 표시되는 링크에서 무료 계정을 만드세요.실험 및 파이프라인 정의
W&B를 설치하고 세션 인증을 완료했다면, 실험 설정과 이를 사용할 트레이닝 파이프라인을 정의하세요.wandb.init()으로 메타데이터와 하이퍼파라미터 추적하기
먼저 코드로 실험을 정의하세요. 하이퍼파라미터는 무엇인가요? 이 run에 연결된 메타데이터는 무엇인가요?
일반적인 워크플로는 이 정보를 config 딕셔너리(또는 유사한 객체)에 저장한 다음 필요에 따라 액세스하는 것입니다.
이 예제에서는 몇 가지 하이퍼파라미터만 변경하고 나머지는 직접 코드로 지정합니다. 모델의 어떤 부분이든 config에 포함할 수 있습니다.
이 예시에는 MNIST 데이터셋과 합성곱 아키텍처의 메타데이터도 포함되어 있습니다. 나중에 같은 프로젝트에서 CIFAR의 완전 연결 아키텍처 등을 사용하는 경우, 이 메타데이터를 통해 run을 구분할 수 있습니다.
- 모델과 관련 데이터, 옵티마이저를
make합니다. - 이를 바탕으로 모델을
train합니다. test를 실행해 트레이닝 결과를 확인합니다.
wandb.init()의 컨텍스트 내에서 이루어진다는 것입니다. 이 함수를 호출하면 코드와 W&B 서버 간의 통신이 설정됩니다.
config 딕셔너리를 wandb.init()에 전달하면 모든 정보가 즉시 W&B에 로깅되므로, 실험에 사용하도록 설정한 하이퍼파라미터 값을 항상 확인할 수 있습니다.
선택하고 로깅한 값이 항상 모델에서 사용되도록 하려면, W&B는 객체의 run.config 사본을 사용하는 것을 권장합니다. 몇 가지 예시는 다음 make 정의를 확인하세요.
파이프라인을 정의했으므로, 다음 섹션에서는 데이터 및 모델 설정, 트레이닝, 테스트의 각 단계를 차례로 구현합니다.
참고: W&B는 별도의 프로세스에서 코드를 실행하므로 W&B 측에 문제가 발생해도 코드가 비정상 종료되지 않습니다. 문제가 해결되면 wandb sync로 데이터를 로깅할 수 있습니다.
데이터 로딩 및 모델 정의
다음으로, 데이터를 로드하는 방식과 모델의 구조를 지정하세요. 이 부분은 중요하지만,wandb를 사용하지 않을 때와 다르지 않습니다.
wandb를 사용하더라도 모델 정의 방식은 달라지지 않으므로, 이 예제에서는 표준 ConvNet 아키텍처를 사용합니다. 이 코드로 자유롭게 실험해 보세요. W&B는 모든 결과를 Forge에 로깅합니다.
트레이닝 로직 정의
이제model_pipeline의 다음 단계로, train 방법을 지정할 차례입니다. 이 단계에서 W&B 인테그레이션은 트레이닝이 진행되는 동안 그라디언트, 매개변수, 메트릭을 추적합니다.
여기서는 wandb 함수 watch와 log를 사용합니다.
run.watch()로 그라디언트를 추적하고 run.log()로 나머지 모든 항목을 추적하세요
run.watch()는 트레이닝 중 log_freq step마다 모델의 그라디언트와 매개변수를 로깅합니다.
트레이닝을 시작하기 전에 run.watch()를 호출하세요. 로깅 모드, 여러 모델, 성능 관련 팁은 wandb.watch로 그라디언트와 모델 가중치를 로깅하려면 어떻게 해야 하나요?를 참조하세요.
나머지 트레이닝 코드는 동일합니다. 에포크와 배치를 반복하면서 순전파와 역전파를 수행하고 optimizer를 적용하세요.
run.log()에 전달합니다.
run.log()는 문자열을 키로 사용하는 딕셔너리를 받습니다. 이 문자열은 값에 해당하는 로깅 대상 객체를 파악하는 데 사용됩니다. 선택적으로 현재 트레이닝의 step도 로깅할 수 있습니다.
참고: 모델이 처리한 예시 수를 사용하면 배치 크기가 다른 경우에도 더 쉽게 비교할 수 있지만, 실제 step 수나 배치 수를 사용해도 됩니다. 트레이닝 run이 길다면 epoch 단위로 로깅하는 것도 적절할 수 있습니다.
테스트 로직 정의하기
모델 트레이닝이 끝나면 모델을 테스트하세요. 예를 들어 프로덕션에서 가져온 새로운 데이터로 모델을 실행하거나, 직접 선별한 예시에 모델을 적용해 볼 수 있습니다. 테스트 단계는 트레이닝된 모델을 저장하기에도 자연스러운 시점입니다.선택: run.save() 호출
이 시점에 모델의 아키텍처와 최종 매개변수를 디스크에 저장하는 것도 좋습니다. 폭넓은 호환성을 위해 모델을 Open Neural Network eXchange (ONNX) 형식으로 export하세요.
해당 파일 이름을 run.save()에 전달하면 모델 매개변수가 W&B 서버에 저장됩니다. 이제 어떤 .h5 또는 .pb가 어떤 트레이닝 run에 해당하는지 놓칠 일이 없습니다.
모델 저장, 버전 관리, 배포를 위한 더 고급 wandb 기능은 Artifacts 도구를 확인하세요.
트레이닝을 실행하고 wandb.ai에서 메트릭을 실시간으로 확인하세요
이제 전체 파이프라인을 정의하고 몇 줄의 W&B 코드를 추가했으므로, 완전히 추적되는 실험을 실행할 준비가 되었습니다. W&B는 문서, 프로젝트 페이지(프로젝트의 모든 run을 정리하는 페이지), run 페이지(이 run의 결과가 저장되는 페이지)로 이동하는 링크를 제공합니다. run 페이지로 이동하여 다음 탭을 확인하세요:- 차트: 트레이닝 과정 전반에 걸쳐 모델 그라디언트, 매개변수 값, 손실이 로깅됩니다.
- 시스템: 디스크 I/O 사용량, CPU 및 GPU 메트릭을 비롯한 시스템 메트릭이 포함됩니다.
- 로그: 트레이닝 중 표준 출력으로 전송된 모든 내용의 사본이 있습니다.
- 파일: 트레이닝이 완료되면
model.onnx를 클릭하여 Netron 모델 뷰어로 신경망을 볼 수 있습니다.
with wandb.init() 블록을 벗어나면 W&B는 셀 출력에 결과 요약도 표시합니다.
스윕으로 하이퍼파라미터 테스트하기
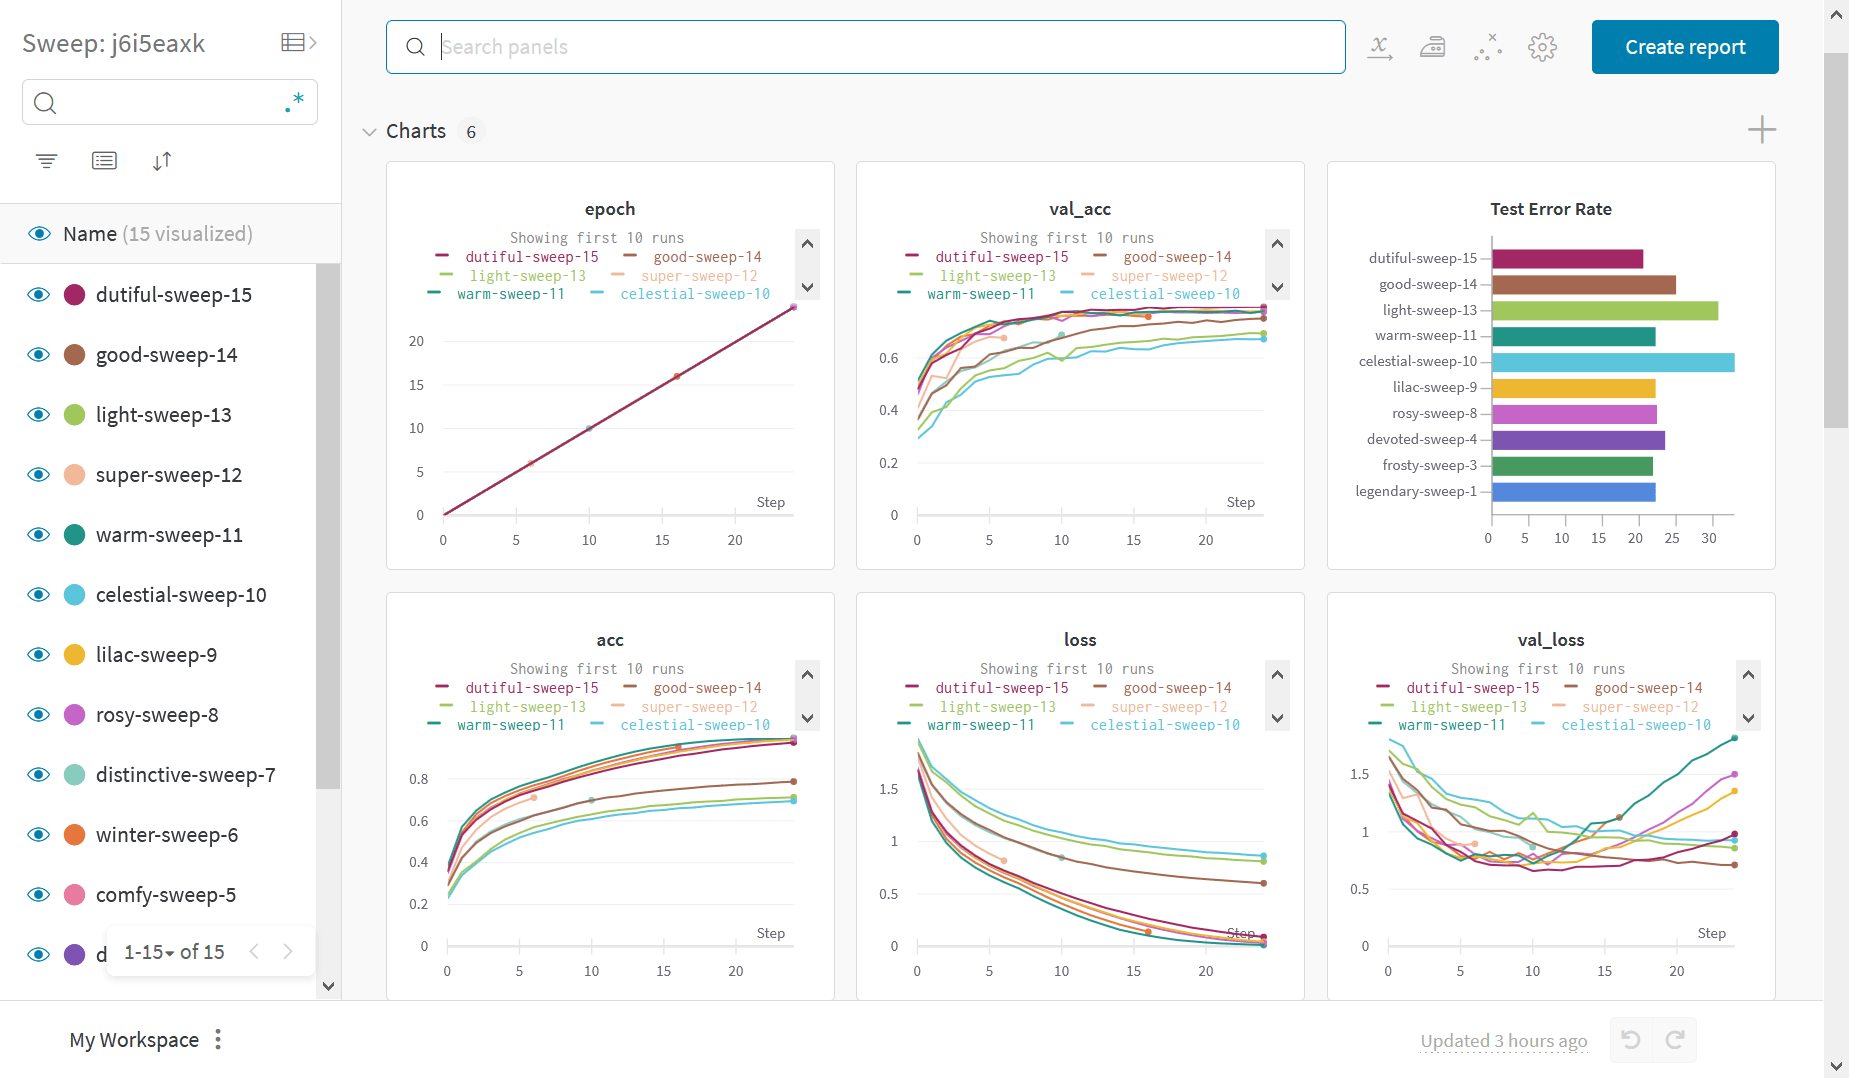
이 예제에서는 하이퍼파라미터 조합 하나만 살펴보았습니다. 하지만 대부분의 ML 워크플로에서는 여러 하이퍼파라미터를 바꿔 가며 반복적으로 실험하는 과정이 중요합니다. W&B Sweeps를 사용하면 하이퍼파라미터 테스트를 자동화하고, 가능한 모델과 최적화 전략의 탐색 공간을 살펴볼 수 있습니다. 이를 통해 앞에서 실행한 단일 설정 run보다 더 큰 규모로 실험을 확장할 수 있습니다. W&B Sweeps를 사용한 하이퍼파라미터 최적화 예시 Colab 노트북을 확인해 보세요. W&B로 하이퍼파라미터 스윕을 실행하려면 다음 세 단계를 거칩니다.- 스윕 정의: 검색할 매개변수, 검색 전략, 최적화 메트릭 등을 지정하는 딕셔너리 또는 YAML 파일을 만듭니다.
- 스윕 초기화:
sweep_id = wandb.sweep(sweep_config). - 스윕 에이전트 실행:
wandb.agent(sweep_id, function=train).