

W&B를 사용하는 이유
- 통합 대시보드: 모든 모델 메트릭과 예측을 한곳에서 관리하는 중앙 저장소입니다.
- 경량: 코드를 변경하지 않고도 Hugging Face와 통합할 수 있습니다.
- 접근성: 개인과 학술 팀은 무료로 사용할 수 있습니다.
- 보안: 모든 프로젝트는 기본적으로 비공개입니다.
- 신뢰성: OpenAI, Toyota, Lyft 등의 머신러닝 팀이 사용하고 있습니다.
설치, 임포트 및 로그인
이 섹션에서는 튜토리얼 실행에 필요한 환경을 설정합니다. Hugging Face 및 W&B 라이브러리를 설치하고, 이 튜토리얼에서 사용할 GLUE 데이터셋과 트레이닝 스크립트를 다운로드하세요.- Hugging Face Transformers: 자연어 모델 및 데이터셋.
- W&B: 실험 추적 및 시각화.
- GLUE dataset: 언어 이해 벤치마크 데이터셋.
- GLUE script: 시퀀스 분류용 모델 트레이닝 스크립트.
API 키 추가
API 키로 인증하면 이 노트북이 W&B 계정에 연결되어 run이 프로젝트에 로깅됩니다. 가입 후 다음 셀을 실행하고 링크를 클릭하여 API 키를 조회하고 이 노트북을 인증하세요.WANDB_WATCH=all을 설정하여 그라디언트와 매개변수를 모두 로깅할 수 있습니다. Hugging Face 인테그레이션 가이드에서 옵션의 전체 목록을 확인하세요.
모델 트레이닝
환경 설정과 인증을 마쳤다면 이제 트레이닝 run을 시작할 수 있습니다. 다운로드한 트레이닝 스크립트run_glue.py를 호출하면 트레이닝 과정이 W&B 대시보드에 자동으로 기록되는 것을 확인할 수 있습니다. 이 스크립트는 Microsoft Research Paraphrase Corpus(두 문장의 의미가 같은지 여부를 나타내는 휴먼 어노테이션이 달린 문장 쌍)로 BERT를 파인튜닝합니다.
대시보드에서 결과 시각화하기
트레이닝이 시작되면 메트릭을 실시간으로 모니터링할 수 있습니다. 이전 셀에서 출력된 링크를 클릭하거나 wandb.ai로 이동하여 실시간으로 들어오는 결과를 확인하세요. 브라우저에서 run을 확인할 수 있는 링크는 모든 의존성이 로드된 후에 나타납니다. 다음 출력을 찾아보세요: “wandb: View run at [해당 run의 고유 URL]”모델 성능 시각화
실험 전반을 살펴보고, 발견 사항을 확대하여 확인하며, 고차원 데이터를 시각화하세요.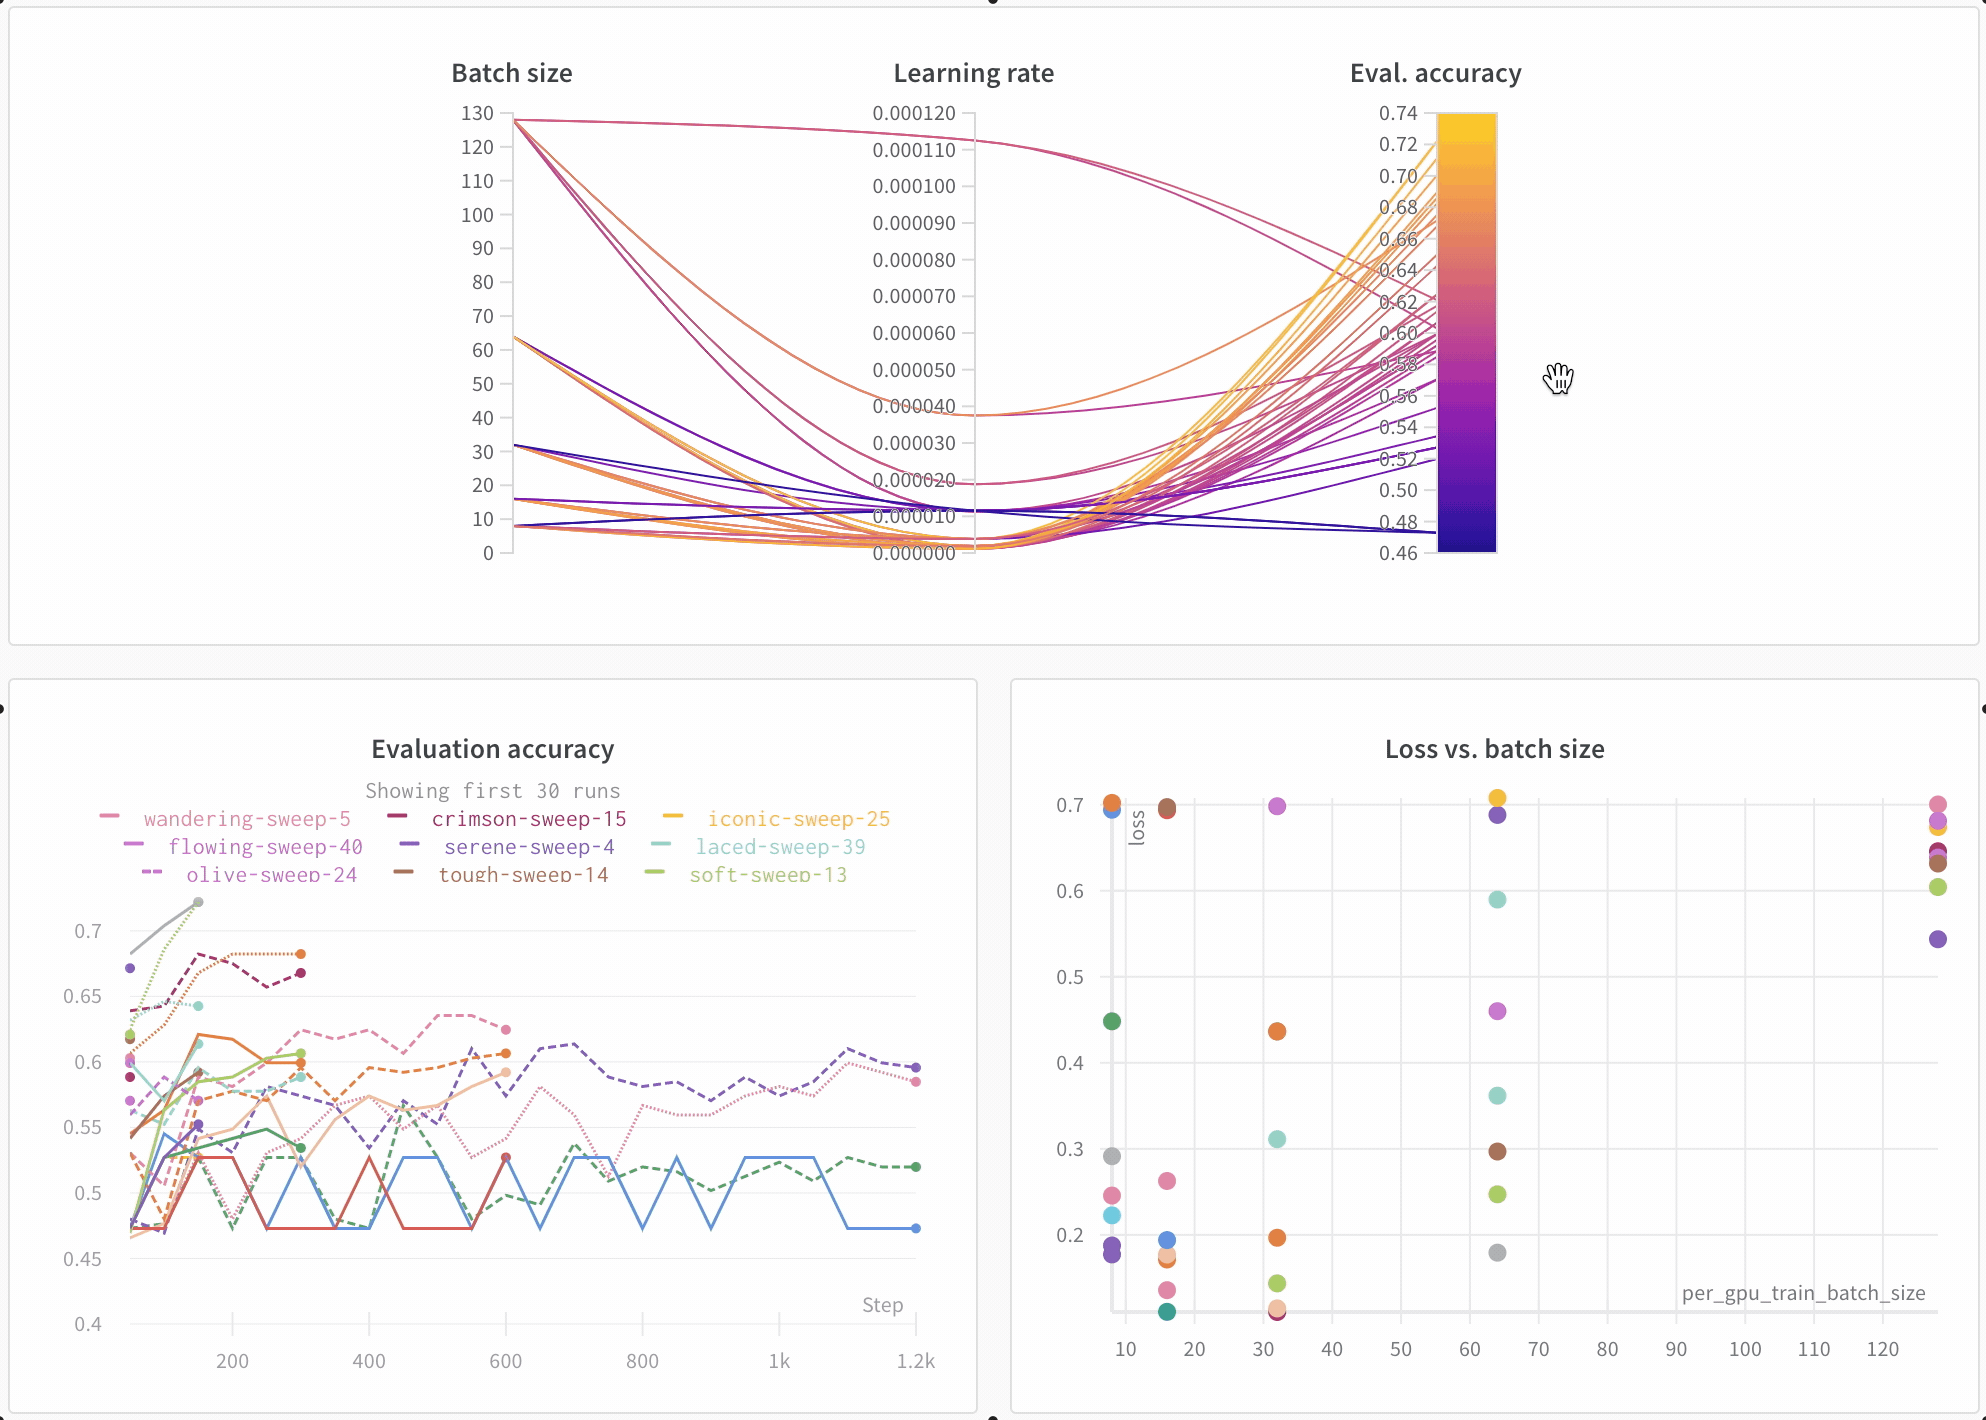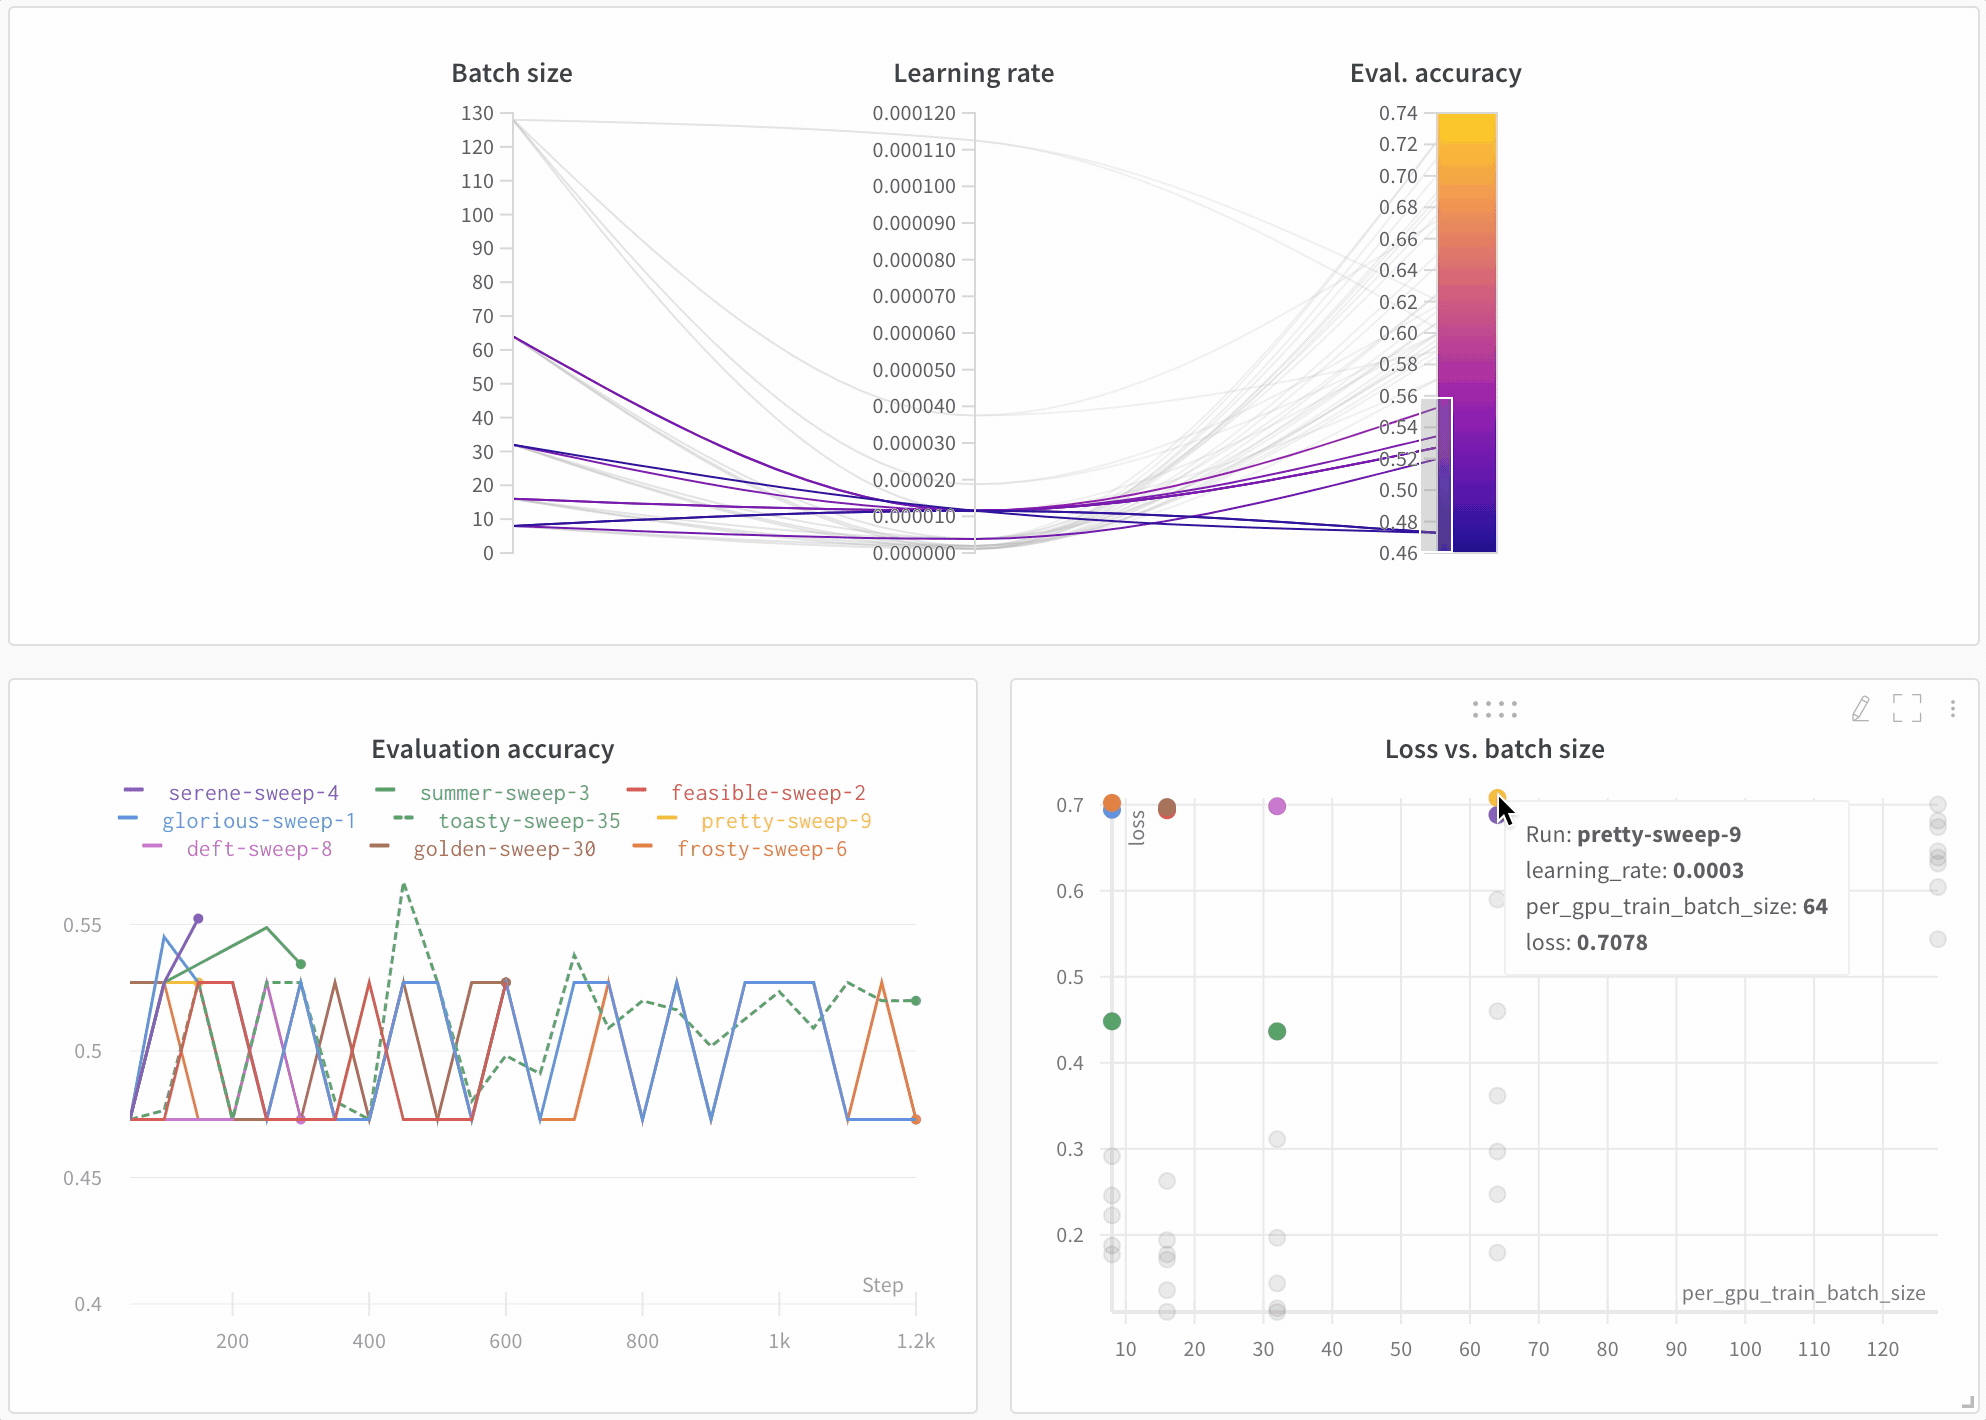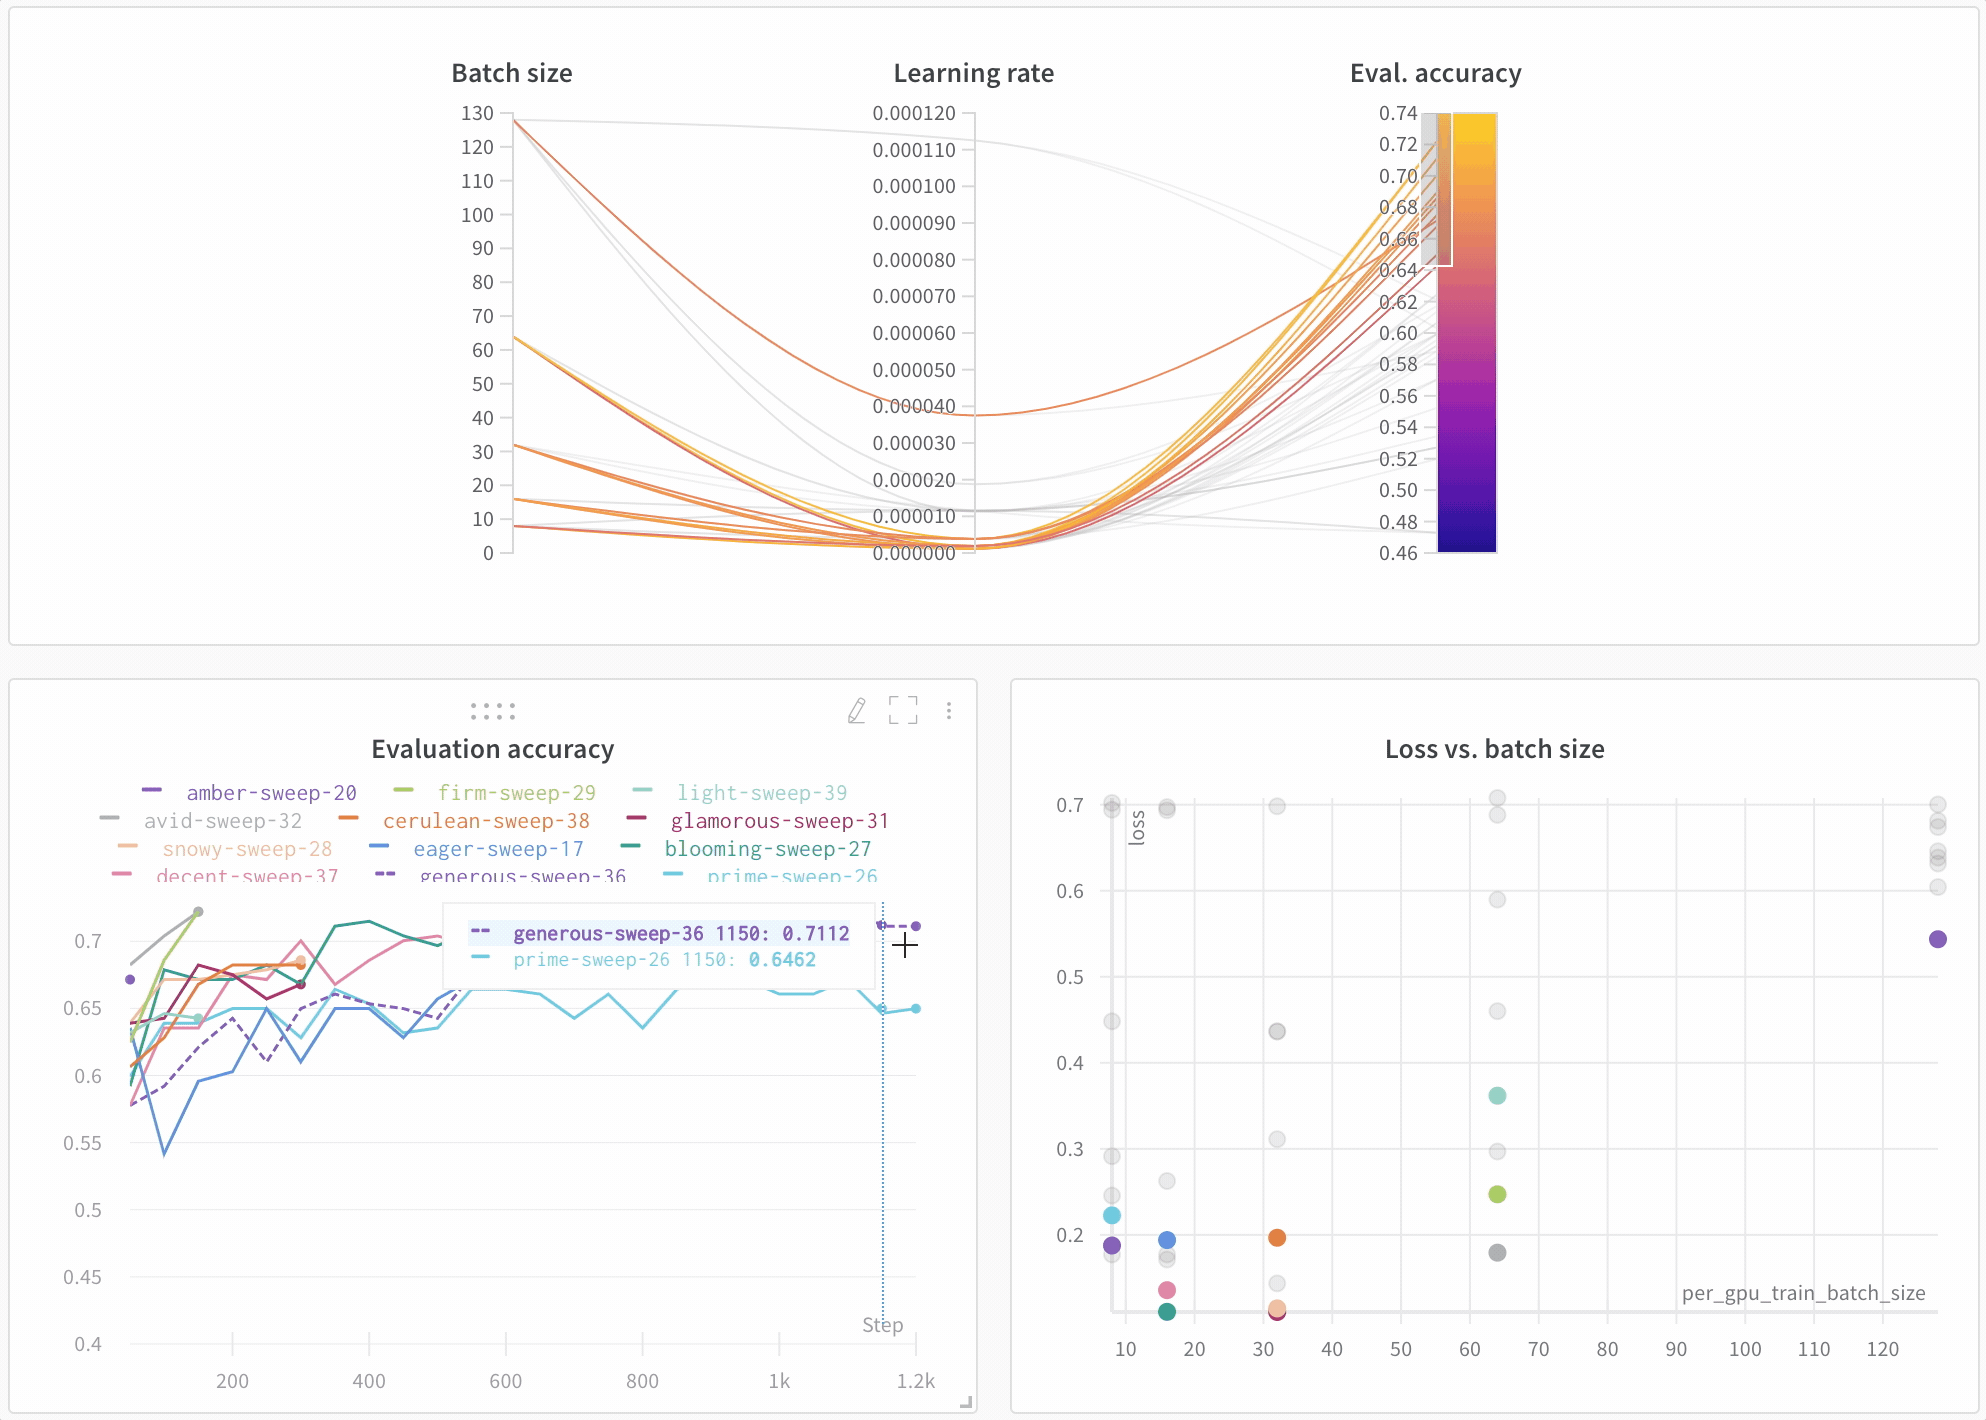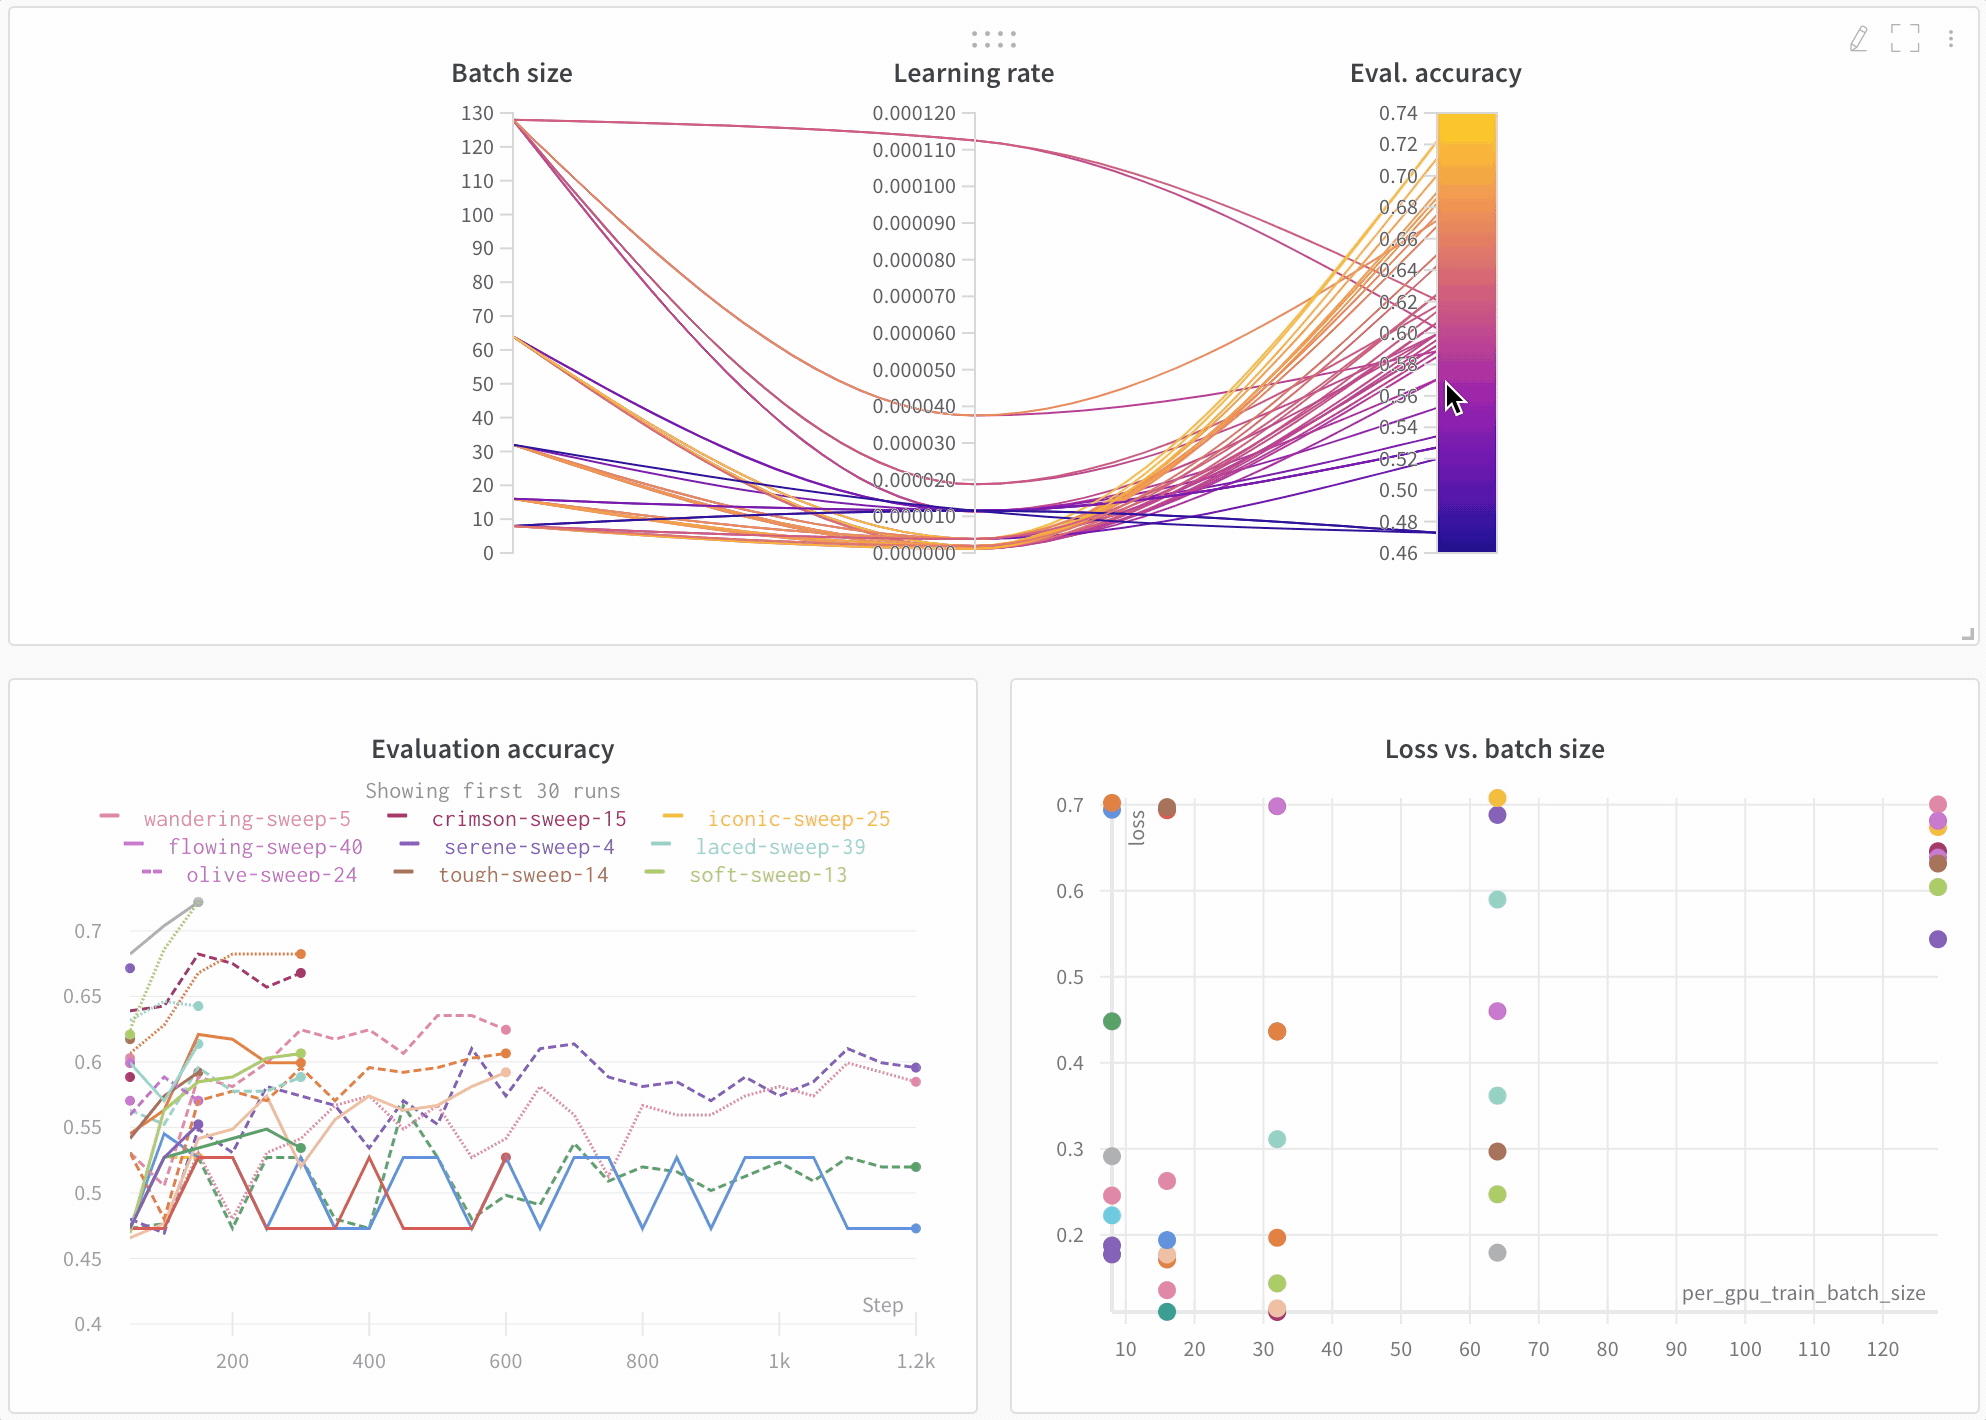
아키텍처 비교
다음은 BERT와 DistilBERT를 비교한 예시입니다. 자동으로 생성되는 선형 플롯 시각화를 통해 아키텍처에 따라 트레이닝 전반에 걸쳐 평가 정확도가 어떻게 달라지는지 확인할 수 있습니다.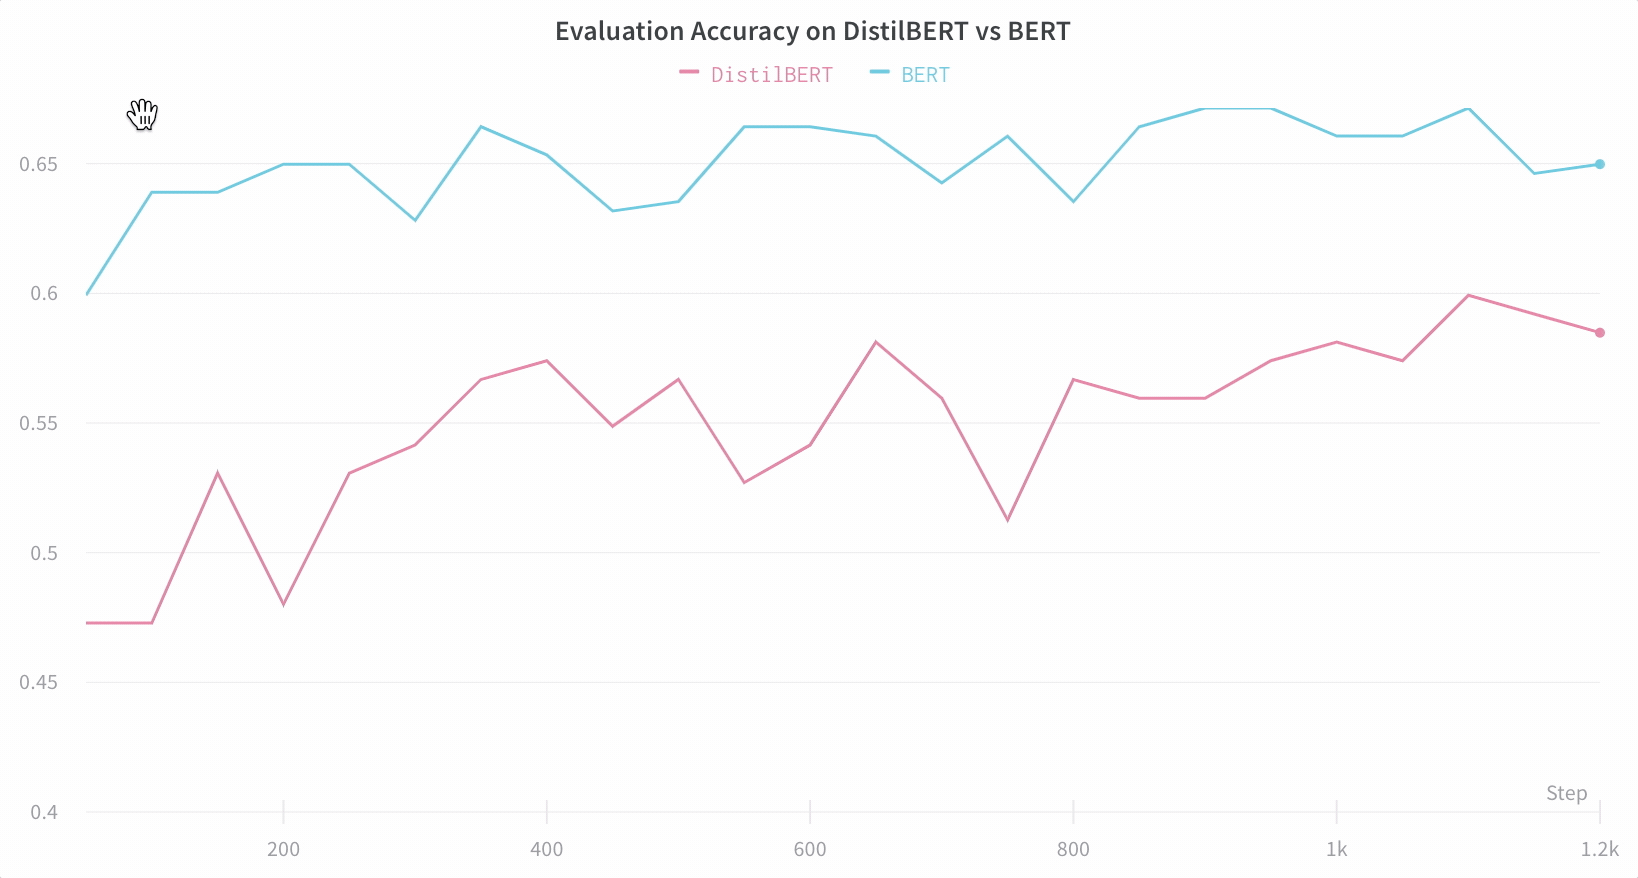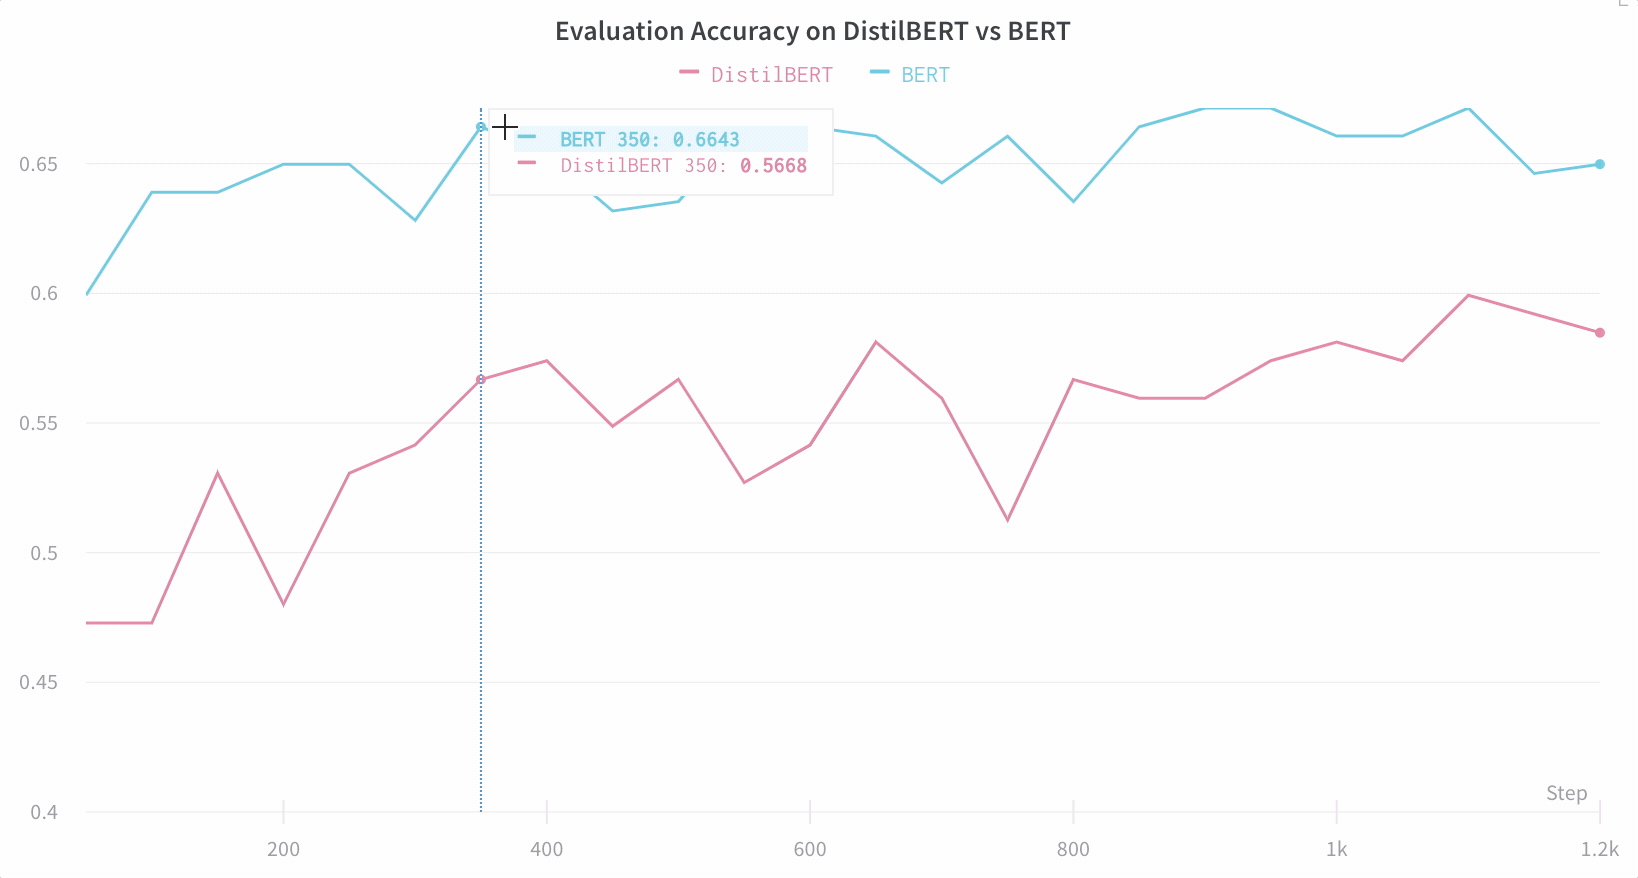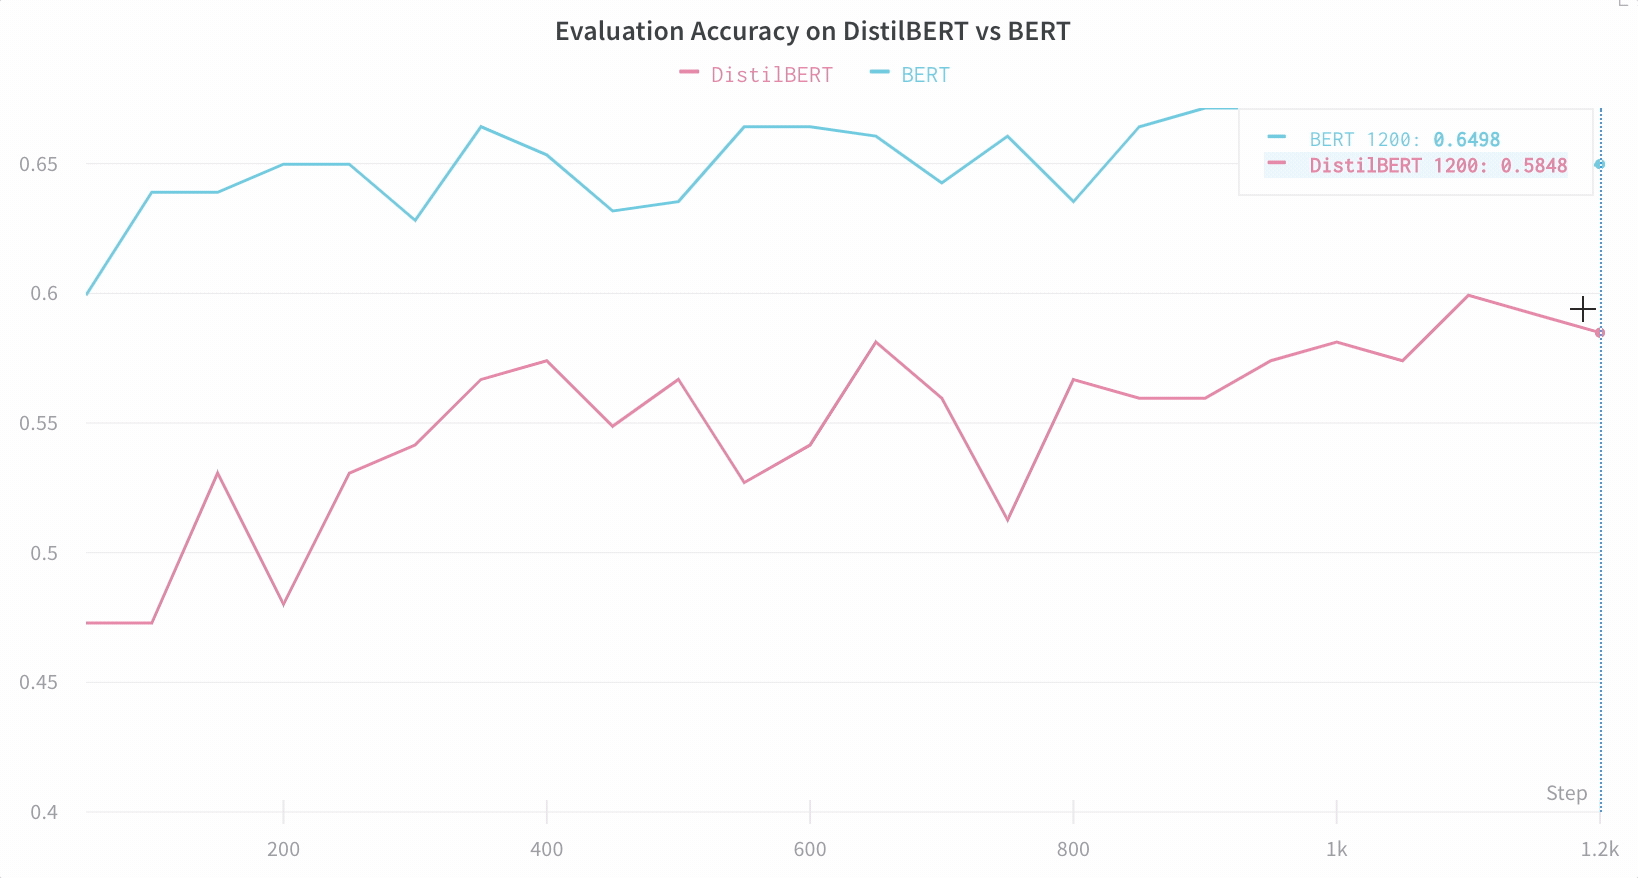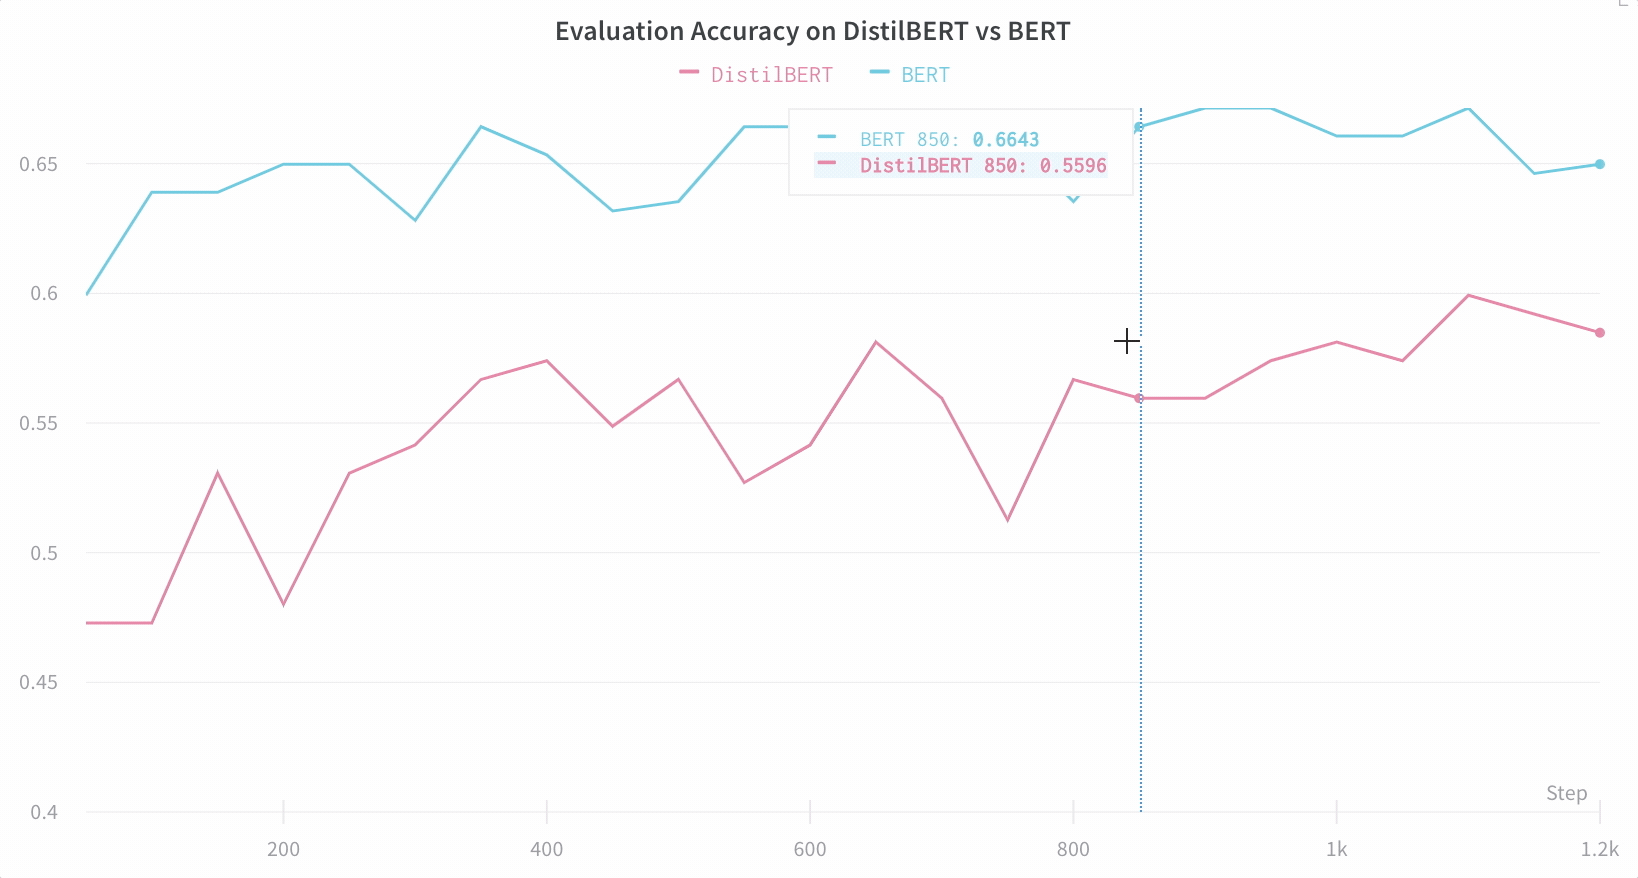
기본적으로 주요 정보 추적
이 섹션에서는 W&B가 자동으로 캡처하는 내용을 설명하므로 추가 설정 없이 대시보드에서 사용 가능한 데이터를 알 수 있습니다. W&B는 각 실험에 대해 새 run을 저장합니다. 기본적으로 저장되는 정보는 다음과 같습니다:- 하이퍼파라미터: W&B는 모델의 설정을 Config에 저장합니다.
- 모델 메트릭: W&B는 Log로 스트리밍되는 메트릭의 시계열 데이터를 저장합니다.
- 터미널 로그: W&B는 명령줄 출력을 저장하고 탭에서 사용할 수 있도록 합니다.
- 시스템 메트릭: GPU 및 CPU 사용량, 메모리, 온도.