

Model クラスと Evaluation クラスによる評価のトラッキングを標準でサポートしています。これらの API は前提条件を最小限に抑えているため、幅広いユースケースに対応できます。
このガイドで学ぶこと
このガイドでは、以下の方法を説明します。Modelを設定します。- LLM の応答をテストするためのデータセットを作成します。
- モデル出力を期待される出力と比較するスコアリング関数を定義します。
- スコアリング関数と追加の組み込みScorerを使用して、データセットに対してモデルをテストする評価を実行します。
- Weights & Biases UI で評価結果を確認します。
前提条件
- CoreWeave Forge アカウント
- Python 3.10 以降または Node.js 18 以降
- 必須パッケージがインストールされていること:
- Python:
pip install weave openai - TypeScript:
npm install weave openai
- Python:
- OpenAI APIキーが環境変数として設定されていること。
必要なライブラリと関数をインポートする
次のライブラリをスクリプトにインポートします。- Python
- TypeScript
Model を構築する
ライブラリの準備ができたら、次のステップは評価するモデルを定義することです。
Weave では、Models はオブジェクトです。モデルやエージェントの動作 (ロジック、プロンプト、パラメーター) と、バージョン管理されたメタデータ (パラメーター、コード、詳細設定) の両方を取得するため、トラッキング、比較、評価、反復的な改善を確実に行えます。
Model をインスタンス化すると、Weave はその設定と動作を自動的に取得し、変更が発生するとバージョンを更新します。これにより、反復的に改善しながら、パフォーマンスの推移をトラッキングできます。
Model を宣言するには、Model をサブクラス化し、1 つの例を受け取って応答を返す predict 関数を実装します。
次のモデルの例では、OpenAI を使用して、入力文から異星の果物の名、色、味を抽出します。
- Python
- TypeScript
ExtractFruitsModel クラスは weave.Model を継承 (サブクラス化) するため、Weave はインスタンス化されたオブジェクトをトラッキングできます。@weave.op は predict 関数をデコレートし、その入力と出力をトラッキングします。
Model オブジェクトは次のようにインスタンス化できます。
- Python
- TypeScript
データセットを作成する
Model を定義したら、次はモデルを評価するためのデータセットが必要です。Dataset は、Weave オブジェクトとして保存されるサンプルのコレクションです。データセットを Weave にパブリッシュすると、バージョンが付与され、複数の評価 run で再利用できるようになります。
次のサンプルデータセットでは、3 つの入力文とそれぞれの正解 (labels) を定義し、スコアリング関数が読み取れる JSON 形式の表に整えます。
この例ではコード内でサンプルのリストを作成しますが、実行中のアプリケーションから 1 件ずつログすることもできます。
- Python
- TypeScript
weave.Dataset() クラスを使用してデータセットを作成し、パブリッシュします。
- Python
- TypeScript
カスタムスコアリング関数を定義する
モデルとデータセットが用意できたら、各例に対するモデルの性能を測定する方法が必要です。スコアリング関数は、モデルの出力と期待されるターゲットを比較し、評価で報告されるメトリクスを生成します。 Weave の評価を使用する場合、Weave はoutput の比較対象として target を必要とします。次のスコアリング関数は、2 つの辞書 (target と output) を受け取り、出力がターゲットと一致するかどうかを示す真偽値の辞書を返します。@weave.op() デコレーターにより、Weave はスコアリング関数の実行をトラッキングできます。
- Python
- TypeScript
Scorer クラスを作成したい場合があります。たとえば、特定のパラメーター (チャットモデルやプロンプトなど) 、特定の行のスコアリング、集計スコアの計算を備えた標準化された LLMJudge クラスを作成できます。詳しくは、RAG アプリケーションのモデルベース評価 にある Scorer クラスの定義に関するチュートリアルを参照してください。
組み込みScorerを使用して評価を実行する
モデル、データセット、カスタムScorerが揃ったので、すべてを組み合わせて評価 run を実行する準備ができました。 カスタムのスコアリング関数に加えて、Weave の組み込みScorerも使用できます。以下の評価では、weave.Evaluation() が前のセクションで定義した fruit_name_score 関数と、F1 スコアを計算する組み込みの MultiTaskBinaryClassificationF1 Scorerを使用します。
以下の例では、2 つのスコアリング関数を使用して fruits データセットで ExtractFruitsModel を評価し、結果を Weave にログします。
- Python
- TypeScript
Python スクリプトから実行する場合は、
asyncio.run を使用する必要があります。ただし、Jupyter ノートブックから実行する場合は、await を直接使用できます。完全な設定例
1 つのスクリプトで完結する評価パイプライン:
1 つのスクリプトで完結する評価パイプライン:
- Python
- TypeScript
評価結果を表示する
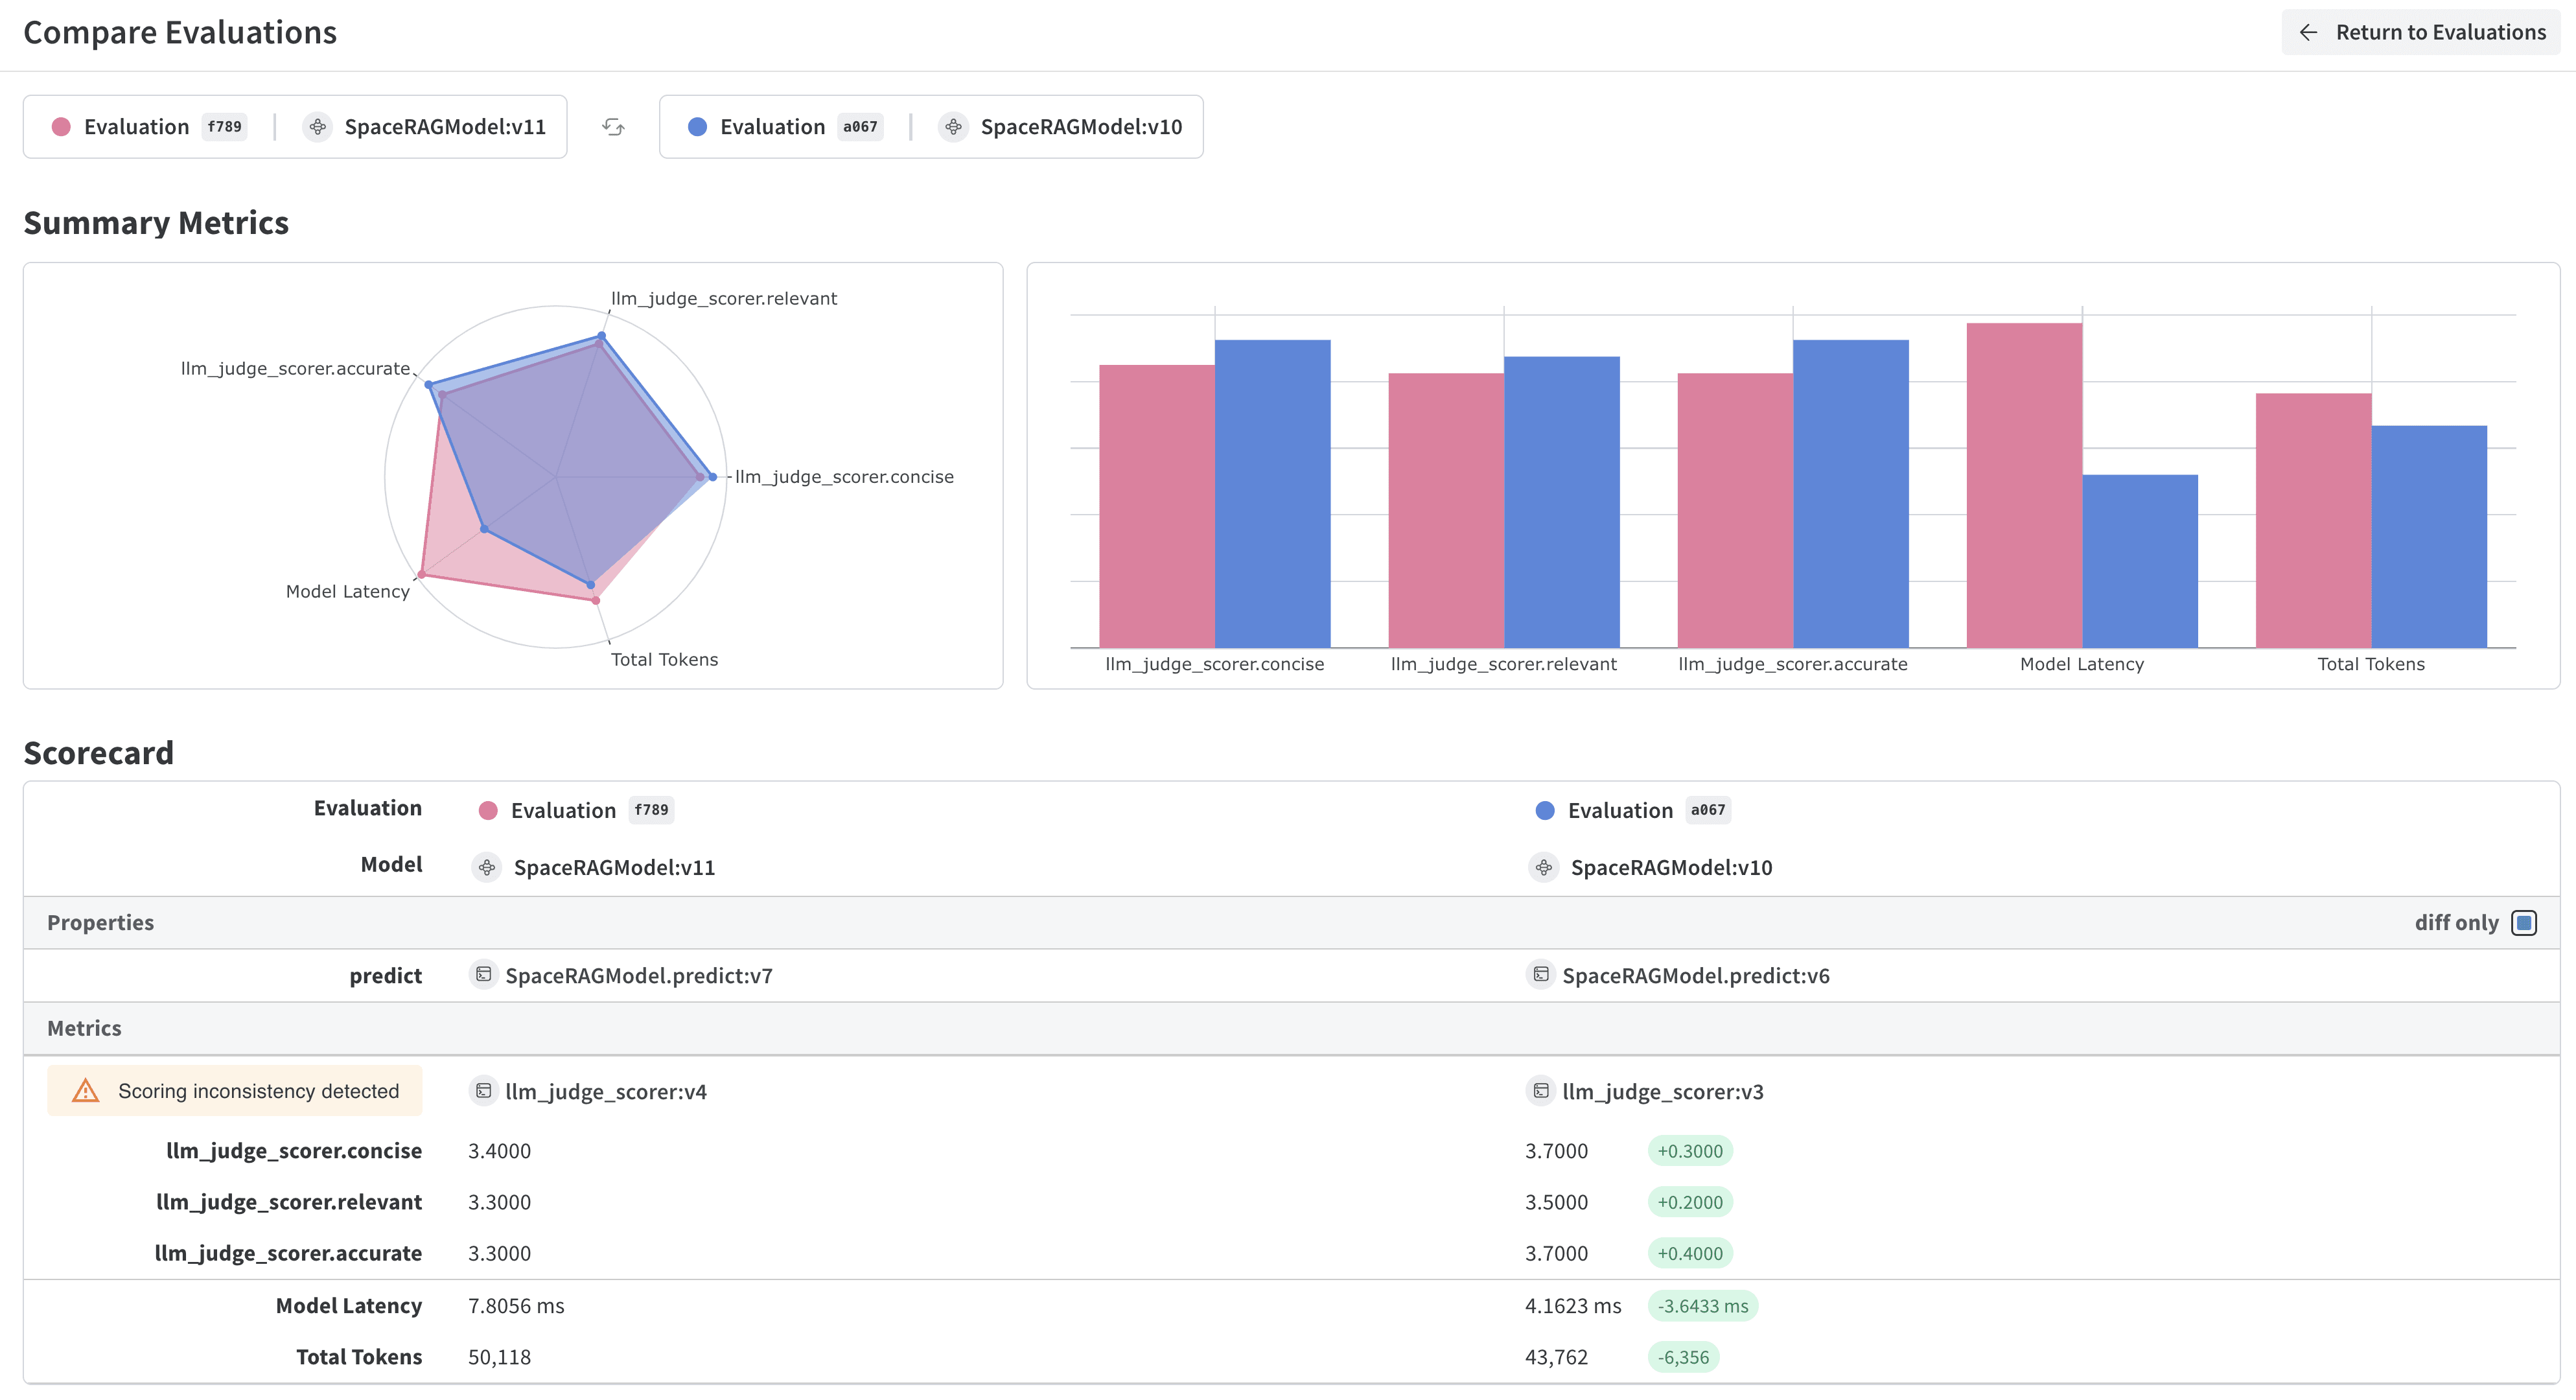
評価が完了すると、Weights & Biases UI で各予測と Scorer の結果を検査できます。Weave は各予測とスコアのトレースを自動的に取得します。結果を表示するには、評価が出力するリンクをクリックしてください。
Weave の評価についてさらに学ぶ
これで評価パイプラインが完成しました。Weave の評価機能をさらに詳しく知るには、次のリソースを参照してください。- Scorerの構築と使用について詳しく学びます。
- Weave の組み込みスコアリング関数を確認します。
- LLM を評価者として使用するためのモデルベースの評価について学びます。