

これはインタラクティブなノートブックです。ローカルで実行するか、以下のリンクを使用してください。
- 正規表現: PII データを特定してマスクします。
- Microsoft の Presidio: Python ベースのデータ保護 SDK で、マスキングと置換の機能を備えています。
- Faker: 疑似データを生成する Python ライブラリです。Presidio と組み合わせて PII データを匿名化します。
weave.op の入力/出力ログのカスタマイズ_と autopatch_settings を使用して、PII のマスキングと匿名化をワークフローに組み込む方法も説明します。詳細については、ログする入力と出力のカスタマイズを参照してください。
まずは、次の手順を実行してください。
- 概要セクションを確認します。
- 前提条件を満たします。
- PII データを特定、マスク、匿名化するための利用可能なメソッドを確認します。
- Weave の Call にメソッドを適用します。
概要
このセクションでは、weave.op を使用した入出力のロギングの概要と、Weave で PII データを扱う際のベストプラクティスについて説明します。
weave.op を使用して入出力のロギングをカスタマイズする
Weave Op では、入力と出力の後処理関数を定義できます。これらの関数を使うと、LLM Call に渡すデータや Weave にログするデータを変更できます。
次の例では、2 つの後処理関数を定義し、それらを引数として weave.op() に渡しています。
PII データを扱う際の Weave のベストプラクティス
PII データを扱う環境で Weave を使用する前に、以下のベストプラクティスを確認してください。ベストプラクティスは開発ライフサイクルの段階ごとにまとめてあり、暗号化に関する補足ガイダンスも記載しています。テスト時
- 匿名化したデータをログして、PII が検出されるかを確認します。
- Weave トレースを使用して、PII の処理プロセスをトラッキングします。
- 実際の PII を露出させずに、匿名化のパフォーマンスを測定します。
本番環境では
- 生の PII は絶対にログしないでください。
- 機密性の高いフィールドは、ログする前に暗号化してください。
暗号化のヒント
- 後で復号する必要があるデータには、可逆暗号化を使用します。
- 元に戻す必要のない一意の ID には、一方向ハッシュを適用します。
- 暗号化したまま分析する必要があるデータには、専用の暗号化方式の使用を検討してください。
前提条件
いずれかのマスキング方法を適用する前に、以下のセットアップ手順を実行して、依存関係のインストール、APIキーの設定、Weave プロジェクトの初期化、サンプルデータの読み込みを済ませておいてください。- まず、必要なパッケージをインストールします。
- 次のページでAPIキーを作成します。
- Weave プロジェクトを初期化します。
- 10 件のテキストブロックを含む、デモ用の PII データセットを読み込みます。
マスキング方法の概要
前提条件を満たしたら、次のいずれかの方法で PII データを検出して保護できます。どの方法でも PII を特定してマスクでき、必要に応じて匿名化も行えます。- 正規表現: PII データを特定してマスクします。
- Microsoft Presidio: マスキングと置換の機能を備えた、Python ベースのデータ保護 SDK です。
- Faker: 疑似データを生成する Python ライブラリです。
方法 1: 正規表現を使用してフィルターする
正規表現 (regex) は、PII データを特定してマスクするためのシンプルな方法です。正規表現を使用すると、電話番号、メールアドレス、社会保障番号など、さまざまな形式の機密情報に一致するパターンを定義できます。より複雑な NLP 手法を使わなくても、大量のテキストをスキャンして情報を置換またはマスクできます。方法 2: Microsoft Presidio を使用してマスクする
次の方法では、Microsoft Presidio を使用して PII データを完全に削除します。Presidio は PII をマスクし、その PII のタイプを表すプレースホルダーに置き換えます。たとえば、"My name is Alex" の Alex は <PERSON> に置き換えられます。
Presidio は、一般的なエンティティを標準でサポートしています。次の例では、PHONE_NUMBER、PERSON、LOCATION、EMAIL_ADDRESS、US_SSN のいずれかに該当するエンティティをすべてマスクします。Presidio による処理は関数にまとめてあります。
方法 3: Faker と Presidio を使用して置換による匿名化を行う
テキストをマスクする代わりに、MS Presidio を使用して名前や電話番号などの PII を Faker Python ライブラリで生成した疑似データに置き換えることで、データを匿名化できます。たとえば、次のようなデータがあるとします。"My name is Raphael and I like to fish. My phone number is 212-555-5555"
Presidio と Faker でデータを処理すると、たとえば次のようになります。
"My name is Katherine Dixon and I like to fish. My phone number is 667.431.7379"
Presidio と Faker を組み合わせて使用するには、カスタムオペレーターへの参照を指定する必要があります。これらのオペレーターによって、PII を疑似データに置き換える Faker の関数が Presidio に指定されます。
方法 4: autopatch_settings を使用する
autopatch_settings を使用すると、サポートされる 1 つ以上の LLM インテグレーションについて、初期化時に PII の処理を直接設定できます。特定のインテグレーションに対するすべての Call で PII の処理を一元管理したい場合は、この方法をお勧めします。この方法には次の利点があります。
- PII の処理ロジックが初期化時に一元化され、その適用範囲も初期化時に決まるため、カスタムロジックを各所に分散させる必要が少なくなります。
- 特定のインテグレーションについて、PII の処理ワークフローをカスタマイズしたり、完全に無効にしたりできます。
autopatch_settings を使用して PII の処理を設定するには、サポートされるいずれかの LLM インテグレーションの op_settings で postprocess_inputs または postprocess_output を定義します。
メソッドを Weave の Call に適用する
ここまでで各マスキング方法を個別に確認しました。次のサンプルでは、これらを Weave モデルに統合し、Weave トレースで結果をプレビューする方法を紹介します。 まず、Weave モデルを作成します。Weave モデルは、設定、モデルの重み、モデルの動作を定義するコードなどの情報をまとめたものです。 このモデルには、Anthropic API を呼び出す predict 関数が含まれています。Anthropic の Claude Sonnet が感情分析を行い、その際の LLM Call は トレース を使用してトレースされます。Claude Sonnet はテキストを受け取り、positive、negative、neutral のいずれかの感情分類を出力します。また、このモデルには、PII データが LLM に送信される前に確実にマスクまたは匿名化されるよう、後処理関数も含まれています。 このコードを実行すると、Weave プロジェクトのページと、実行した特定のトレース (LLM Call) へのリンクが表示されます。これらのリンクから、入力が LLM に到達する前に後処理関数によって期待どおりマスクまたは匿名化されていることを確認してください。正規表現による方法
手始めに、正規表現を使用して元のテキストから PII データを特定し、マスクできます。Presidio のマスキング方法
次に、Presidio を使用して、元のテキストから PII データを特定してマスクします。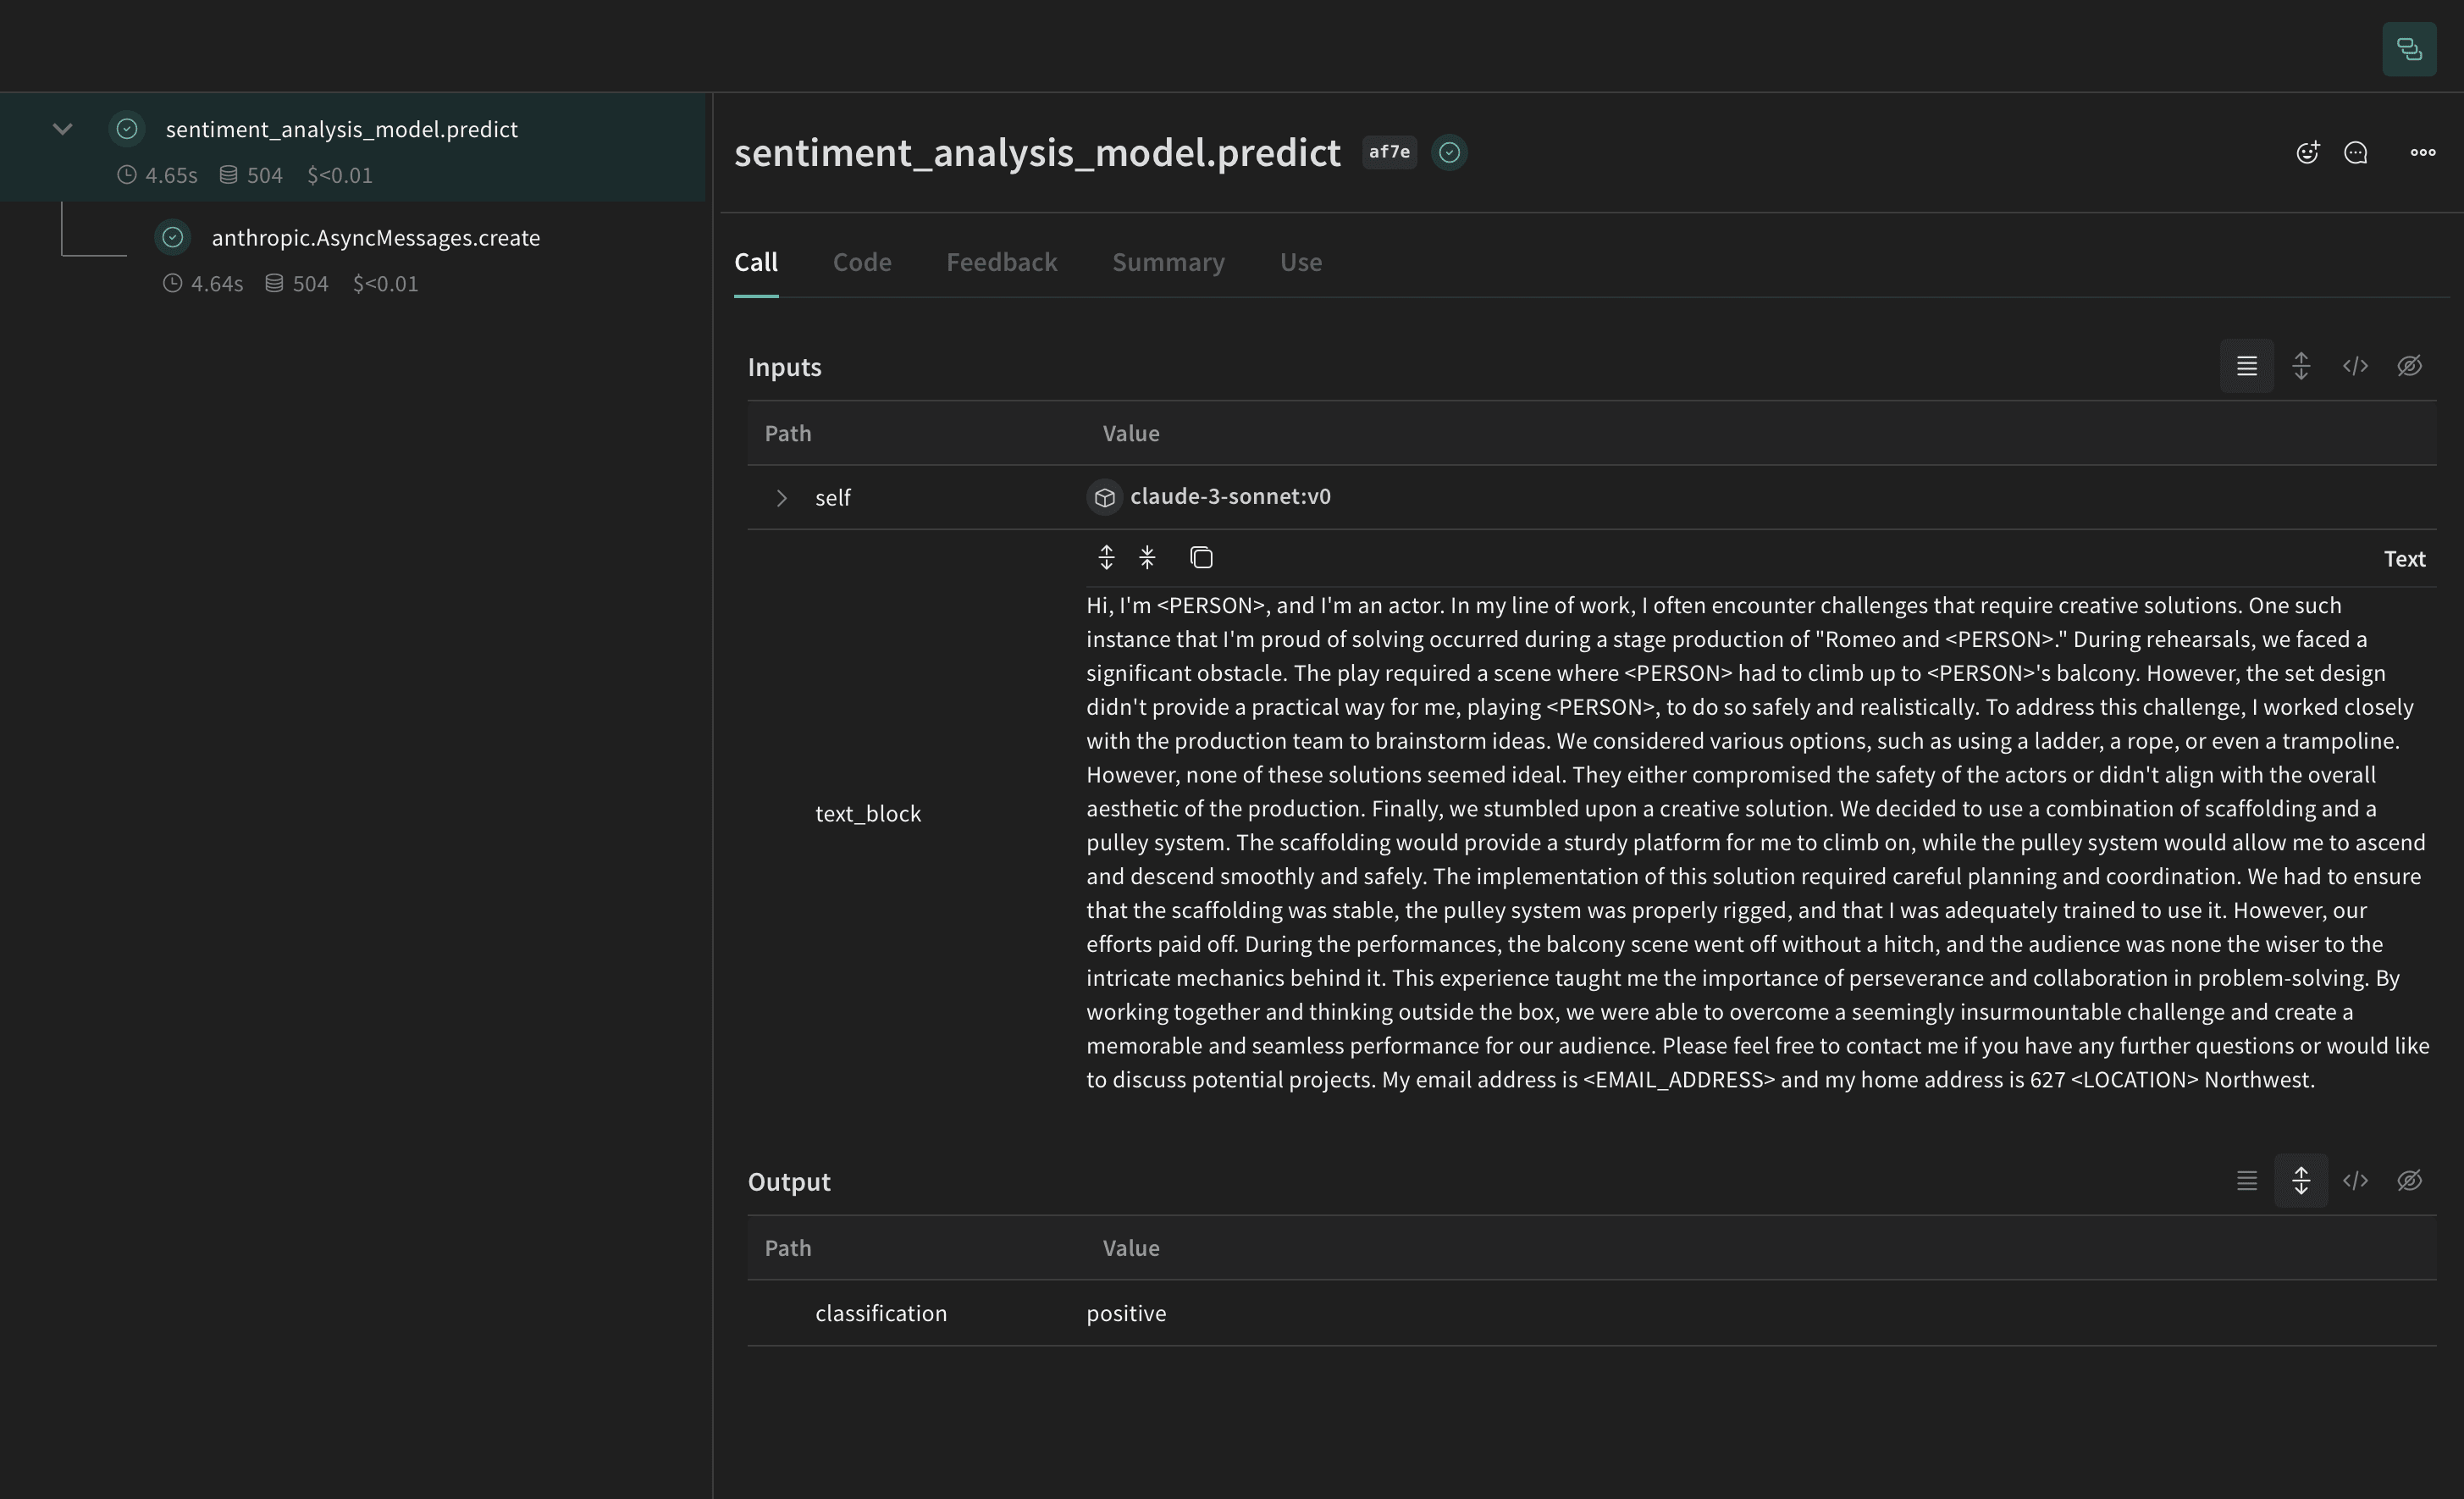
Faker と Presidio による置換手法
この例では、Faker を使用して匿名化された置換用の PII データを生成し、Presidio を使用して元のテキスト内の PII データを特定して置換します。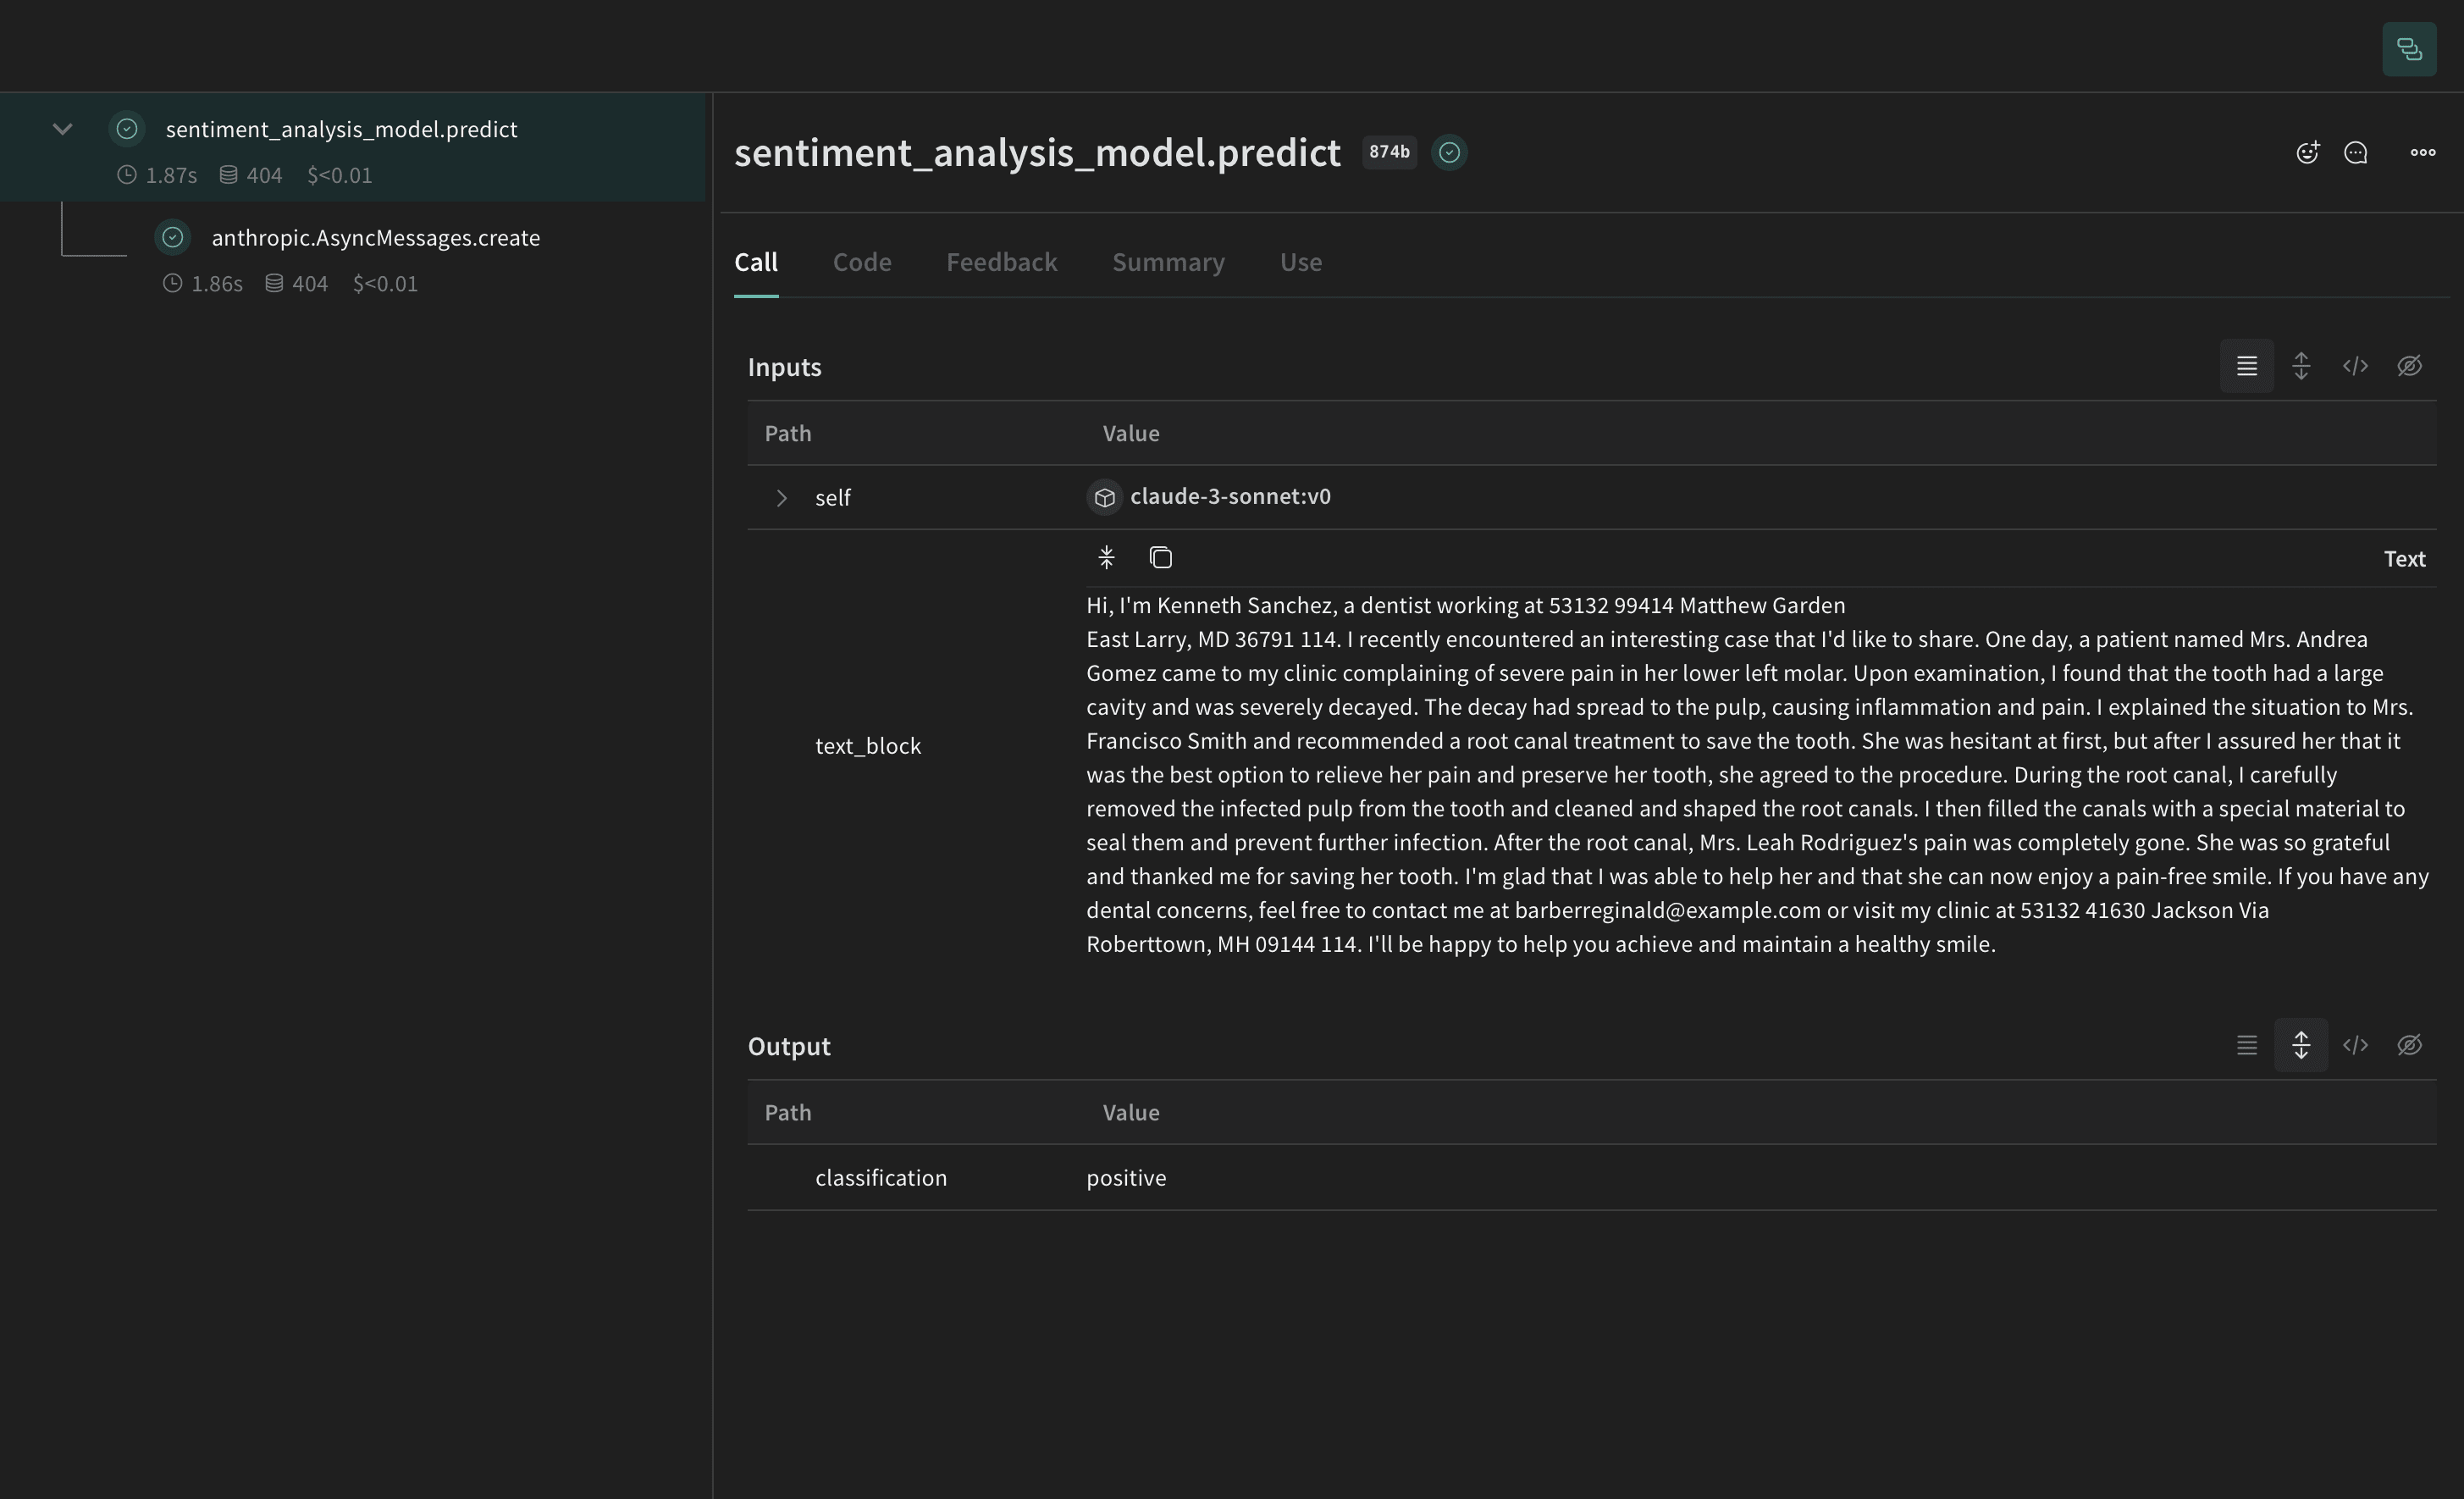
autopatch_settings メソッド
次の例では、初期化時に anthropic の postprocess_inputs として postprocess_inputs_regex() 関数を設定しています。postprocess_inputs_regex 関数は、方法 1: 正規表現を使用してフィルターする で定義した redact_with_regex メソッドを適用します。これにより、anthropic のすべてのモデルへの入力すべてに redact_with_regex が適用されます。
オプション: データを暗号化する
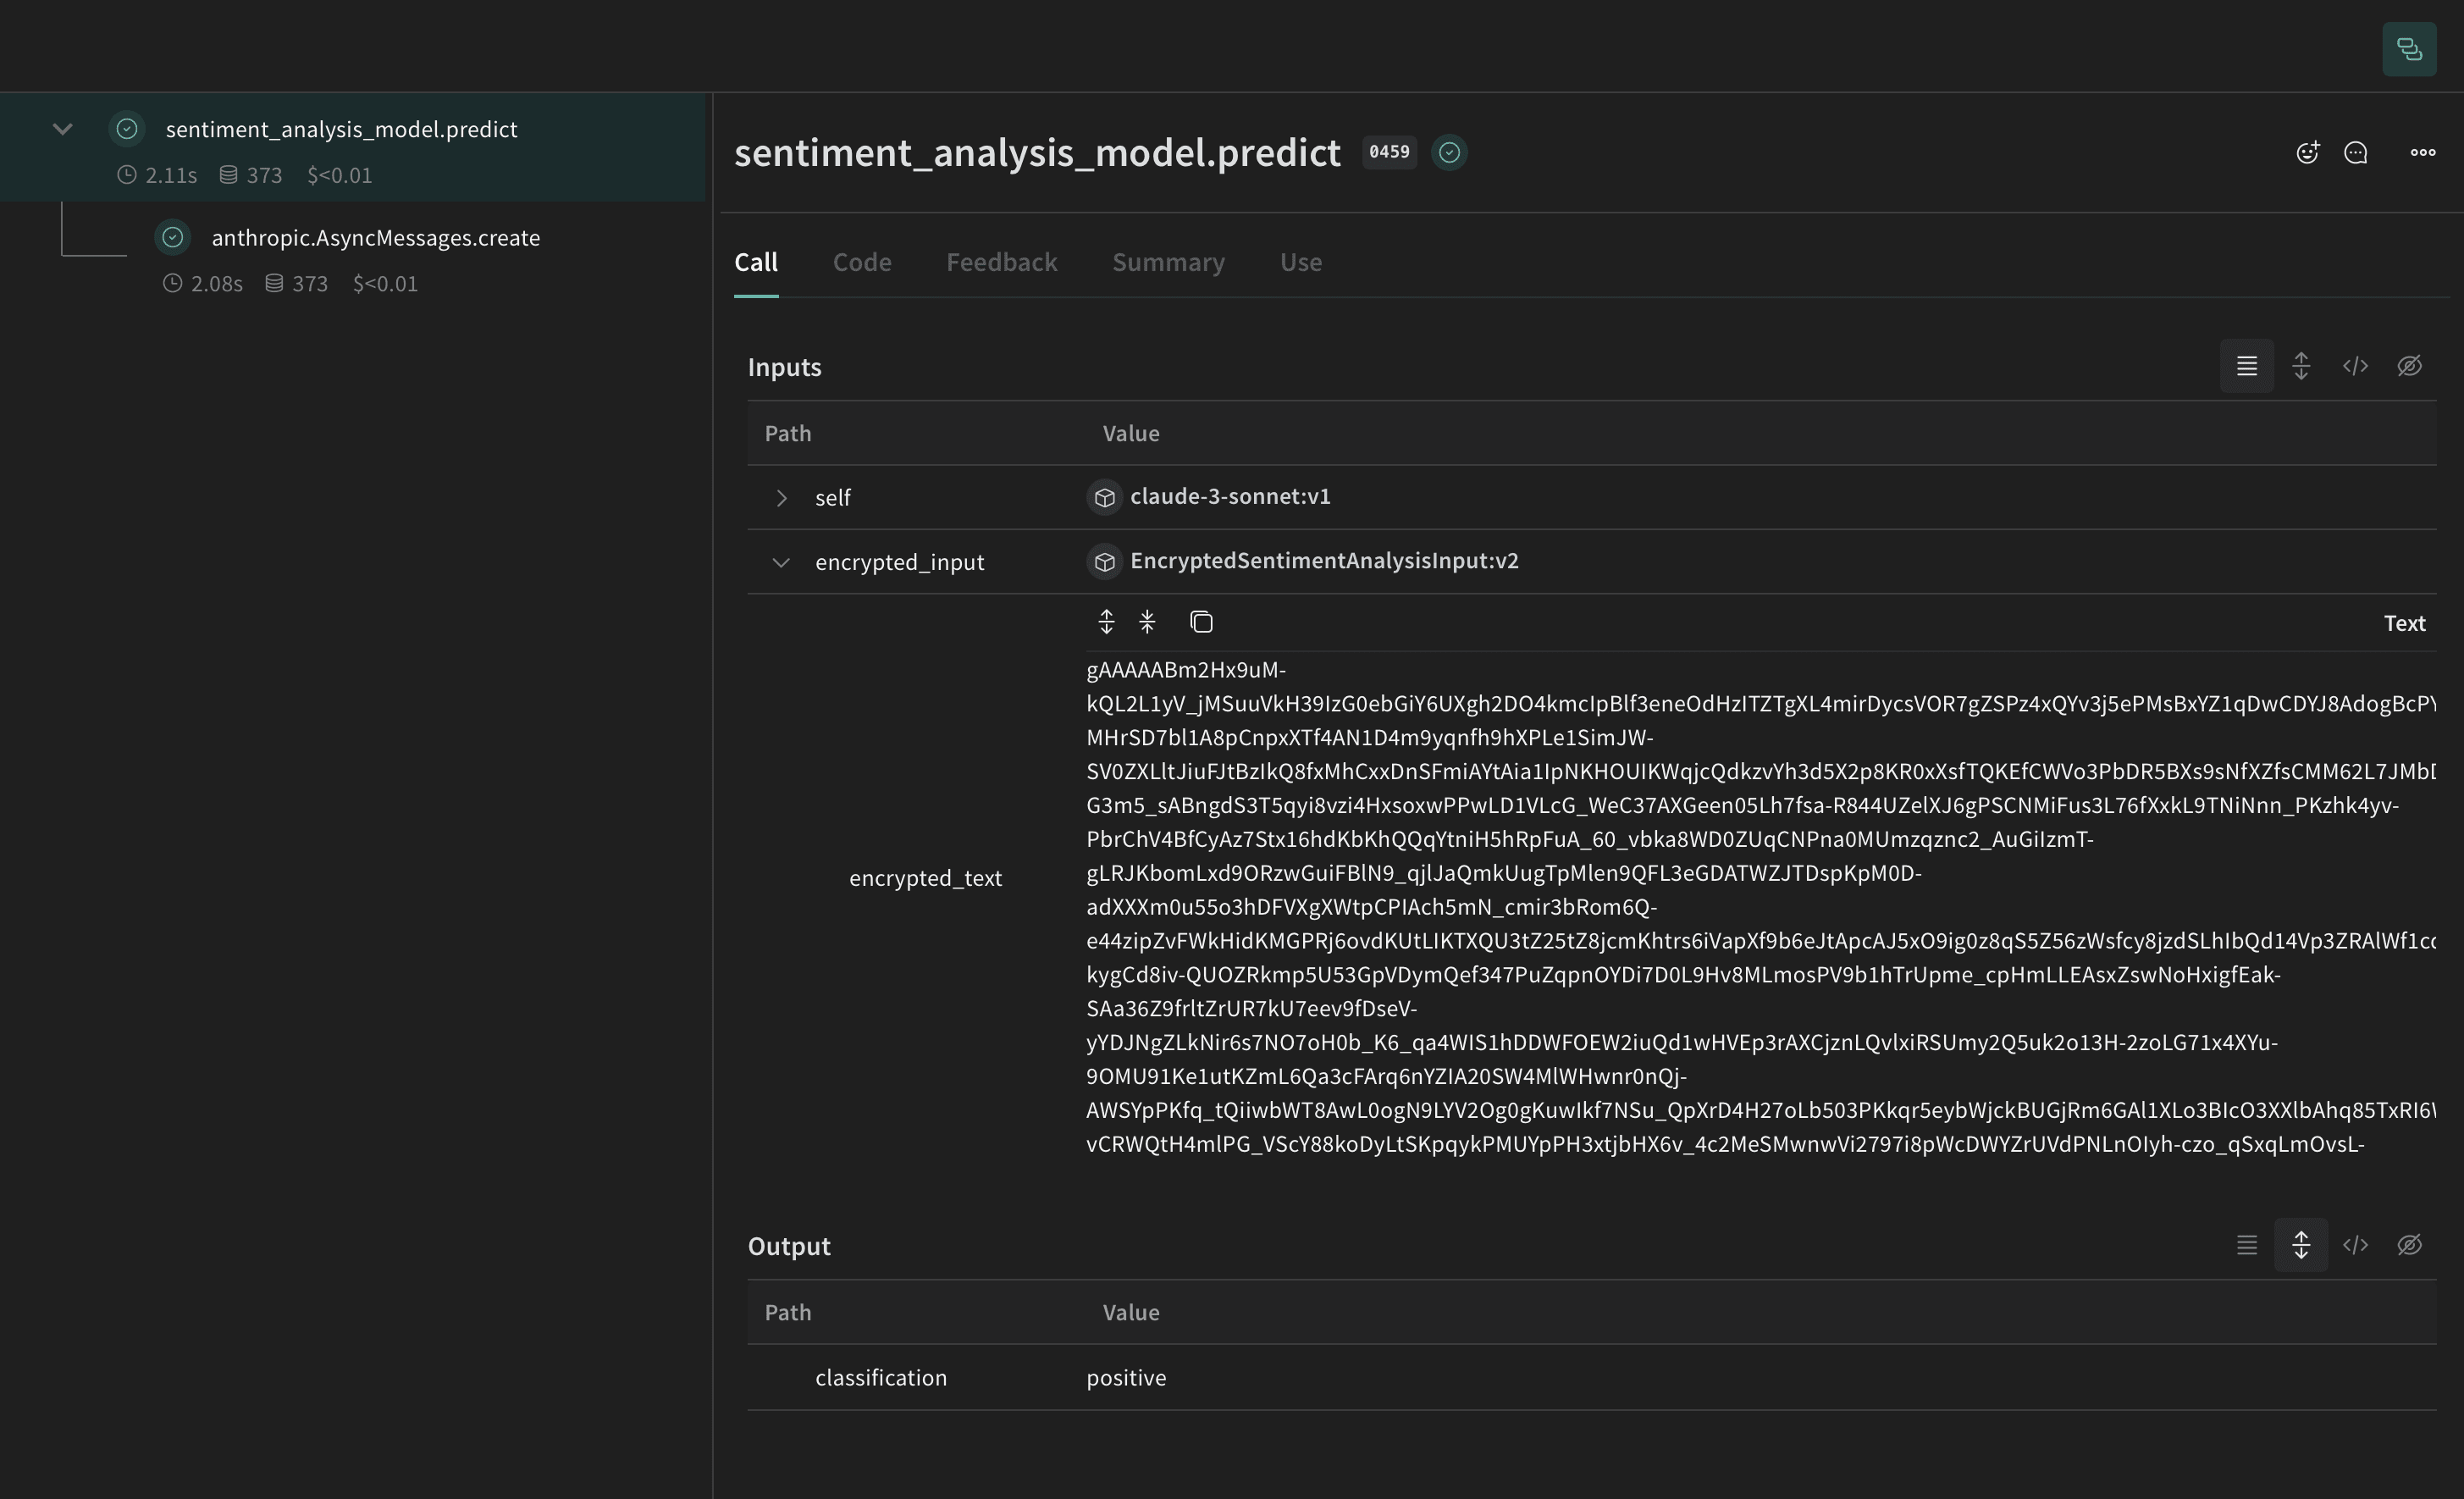
predict メソッド内で復号する方法を示します。