Weave でモデルを評価する
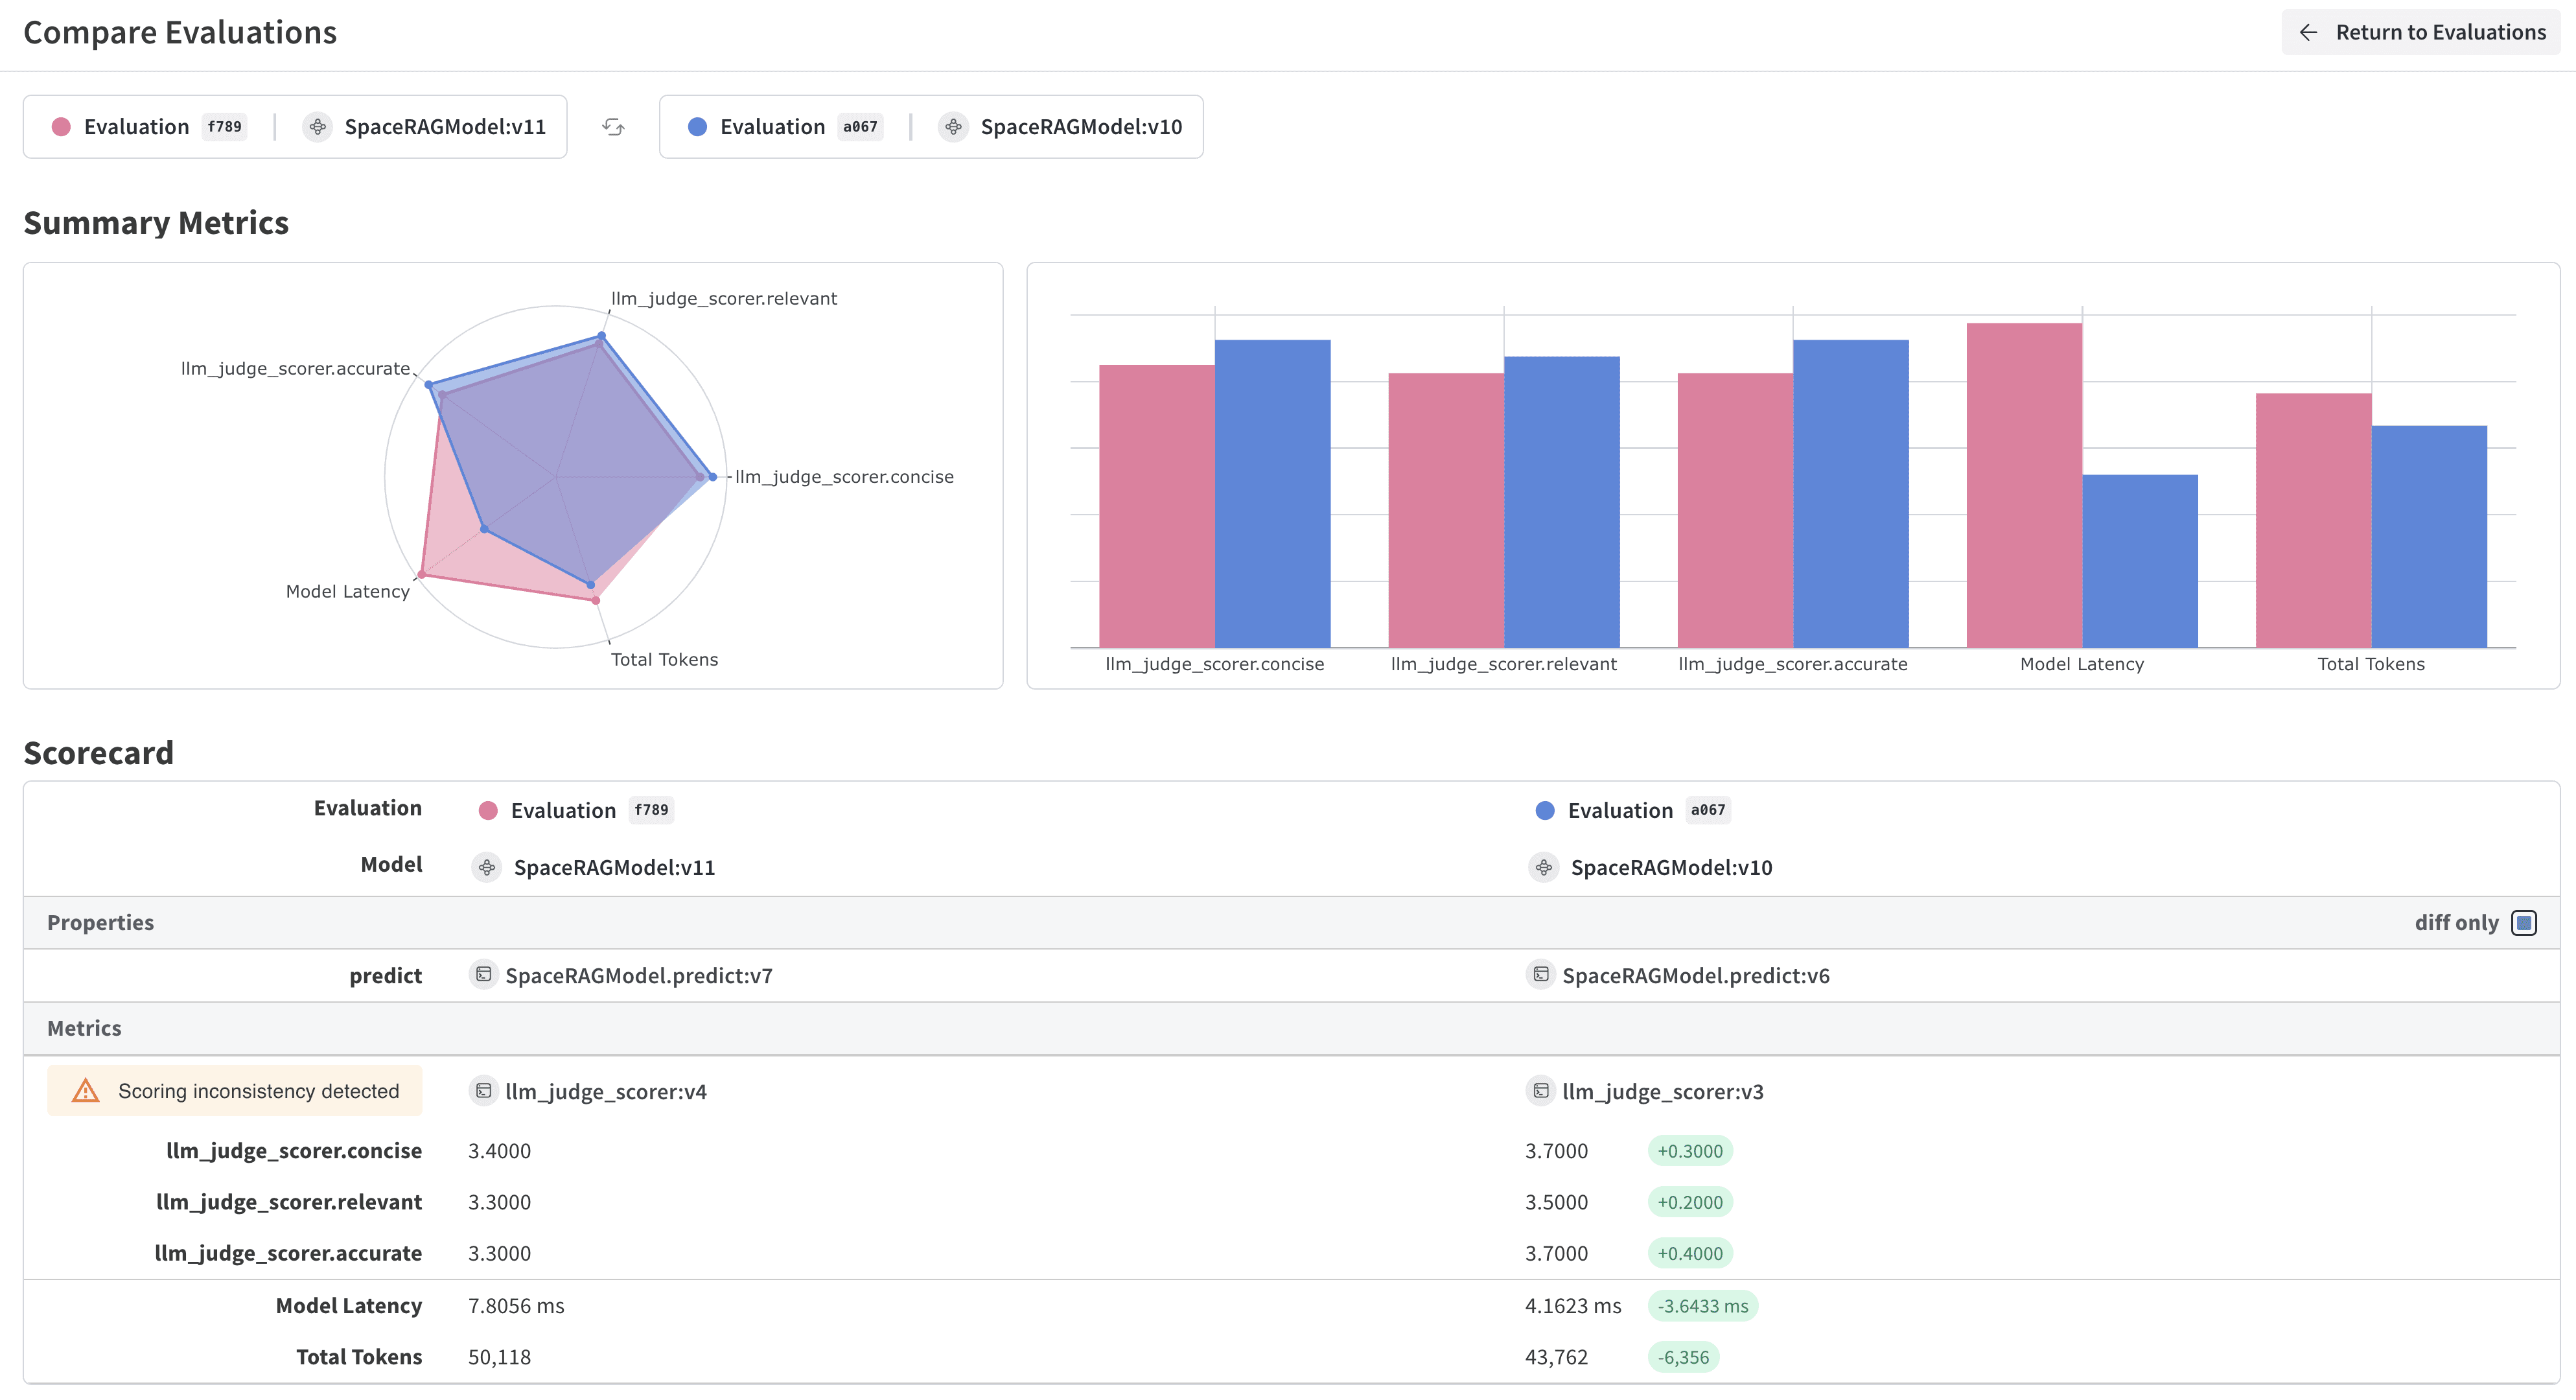
W&B Weave は、LLM および GenAI アプリケーションの評価向けに設計されたツールキットです。Scorer、judge、詳細なトレースを含む包括的な評価機能を提供し、モデル性能の理解と改善を支援します。Weave は W&B Models と連携し、モデルレジストリに保存されたモデルを評価できます。
モデル評価の主要な機能
- Scorers and judges: 精度、関連性、一貫性などに対応した、事前構築済みおよびカスタムの評価メトリクス
- 評価データセット: 体系的な評価のためのグラウンドトゥルースを備えた構造化されたテストセット
- モデルのバージョン管理: モデルの異なるバージョンをトラッキングし、比較します
- 詳細なトレース: 完全な入出力トレースでモデルの動作をデバッグします
- コストトラッキング: 評価全体の API コストとトークン使用量を監視します
はじめに: Registry からモデルを評価する
W&B Models Registry からモデルをダウンロードし、Weave を使用して評価します:
Weave の評価を W&B Models と統合する
Models と Weave のインテグレーション例 は、以下の完全なワークフローを示しています:
- Registry からモデルをロードする: W&B Models Registry に保存されたファインチューニングしたモデルをダウンロードします
- 評価パイプラインを作成する: カスタム Scorer を使用して包括的な評価を構築します
- 結果を W&B にログする: 評価メトリクスをモデルの run に接続します
- 評価済みモデルをバージョン管理する: 改善されたモデルを Registry に保存します
評価結果を Weave と W&B Models の両方にログします:
Weave の高度な機能
Custom scorers and judges
あなたのユースケースに合わせた高度な評価メトリクスを作成します:
バッチ評価
複数のモデルバージョンまたは設定を評価します:
次のステップ
表でモデルを評価する
W&B 表を使用すると、次のことができます:
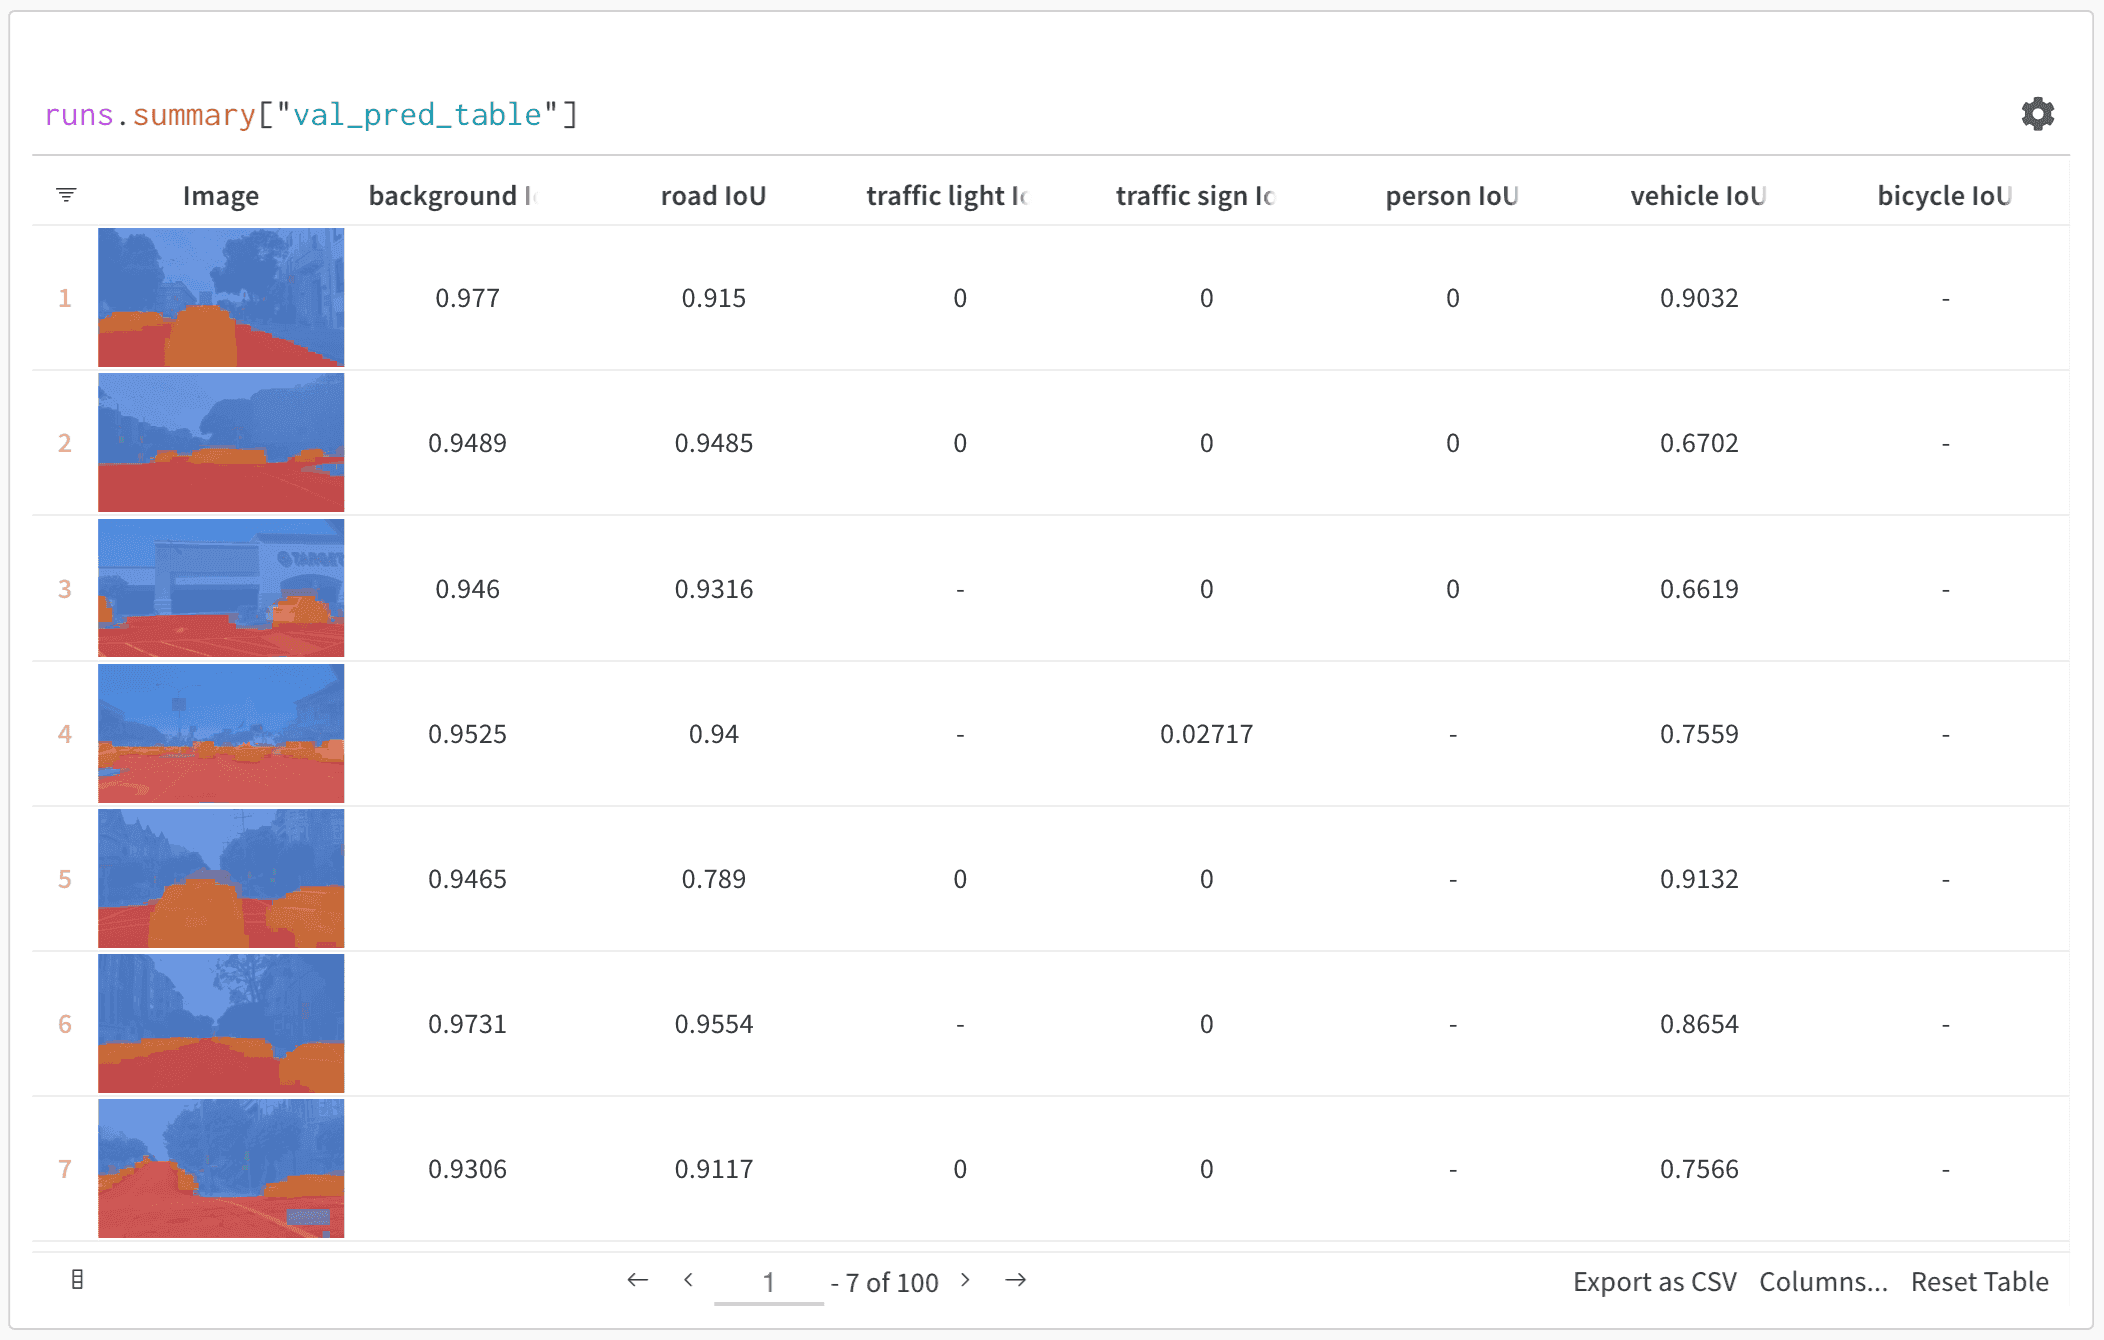
- モデル予測の比較: 同じテストセットで異なるモデルがどのように動作するかを並べて比較できます
- 予測の変化をトラッキングする: トレーニングのエポックやモデルバージョン全体で予測がどのように変化するかを監視します
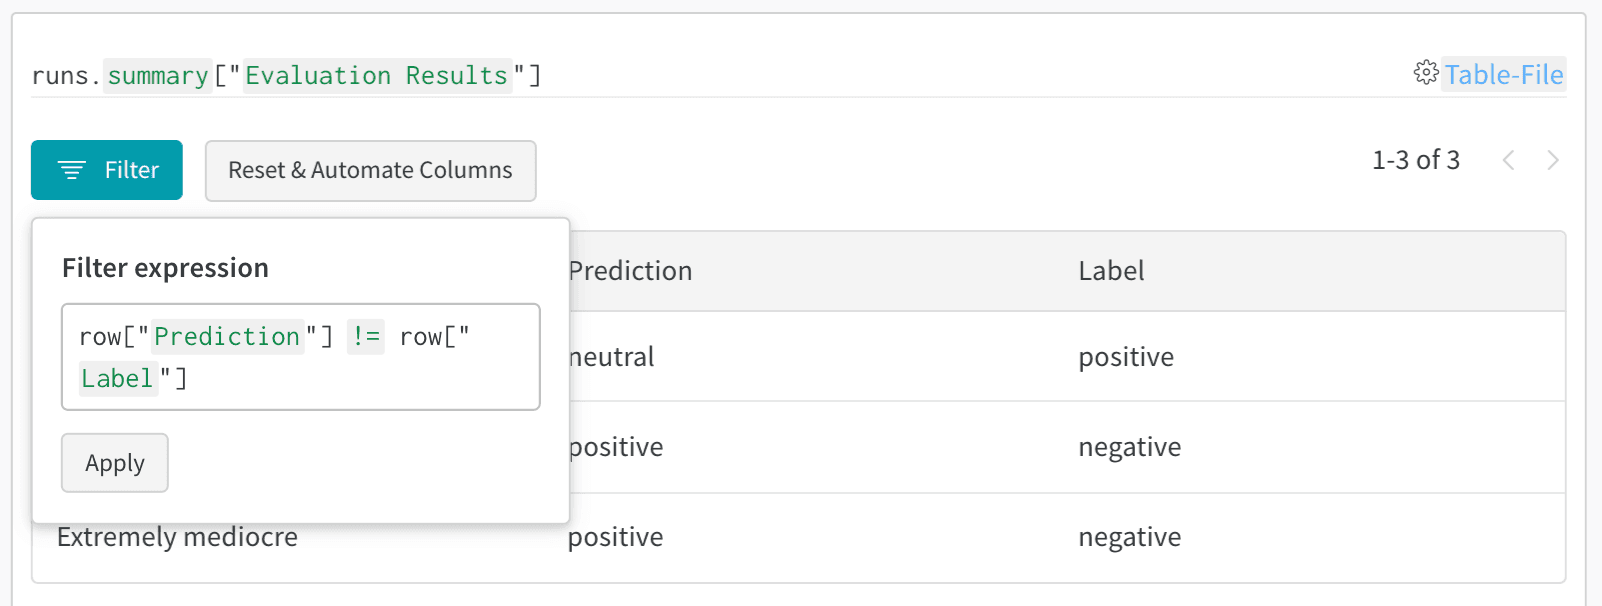
- エラーの分析: フィルターとクエリを使用して、よく誤分類される例やエラーパターンを検索します
- リッチメディアの視覚化: 予測やメトリクスとともに画像、オーディオ、テキスト、その他のメディアタイプを表示します
基本例: 評価結果をログする
高度な表ワークフロー
複数のモデルを比較
異なるモデルの eval 表を同じ key にログして、直接比較します:
予測を時間の経過とともにトラッキングする
改善を視覚化するために、異なるトレーニングのエポックで表をログします:
W&B UI でのインタラクティブな分析
ログしたら、次のことができます:
- 結果をフィルターする: 列ヘッダーをクリックして、予測精度、信頼度のしきい値、または特定のクラスでフィルターします
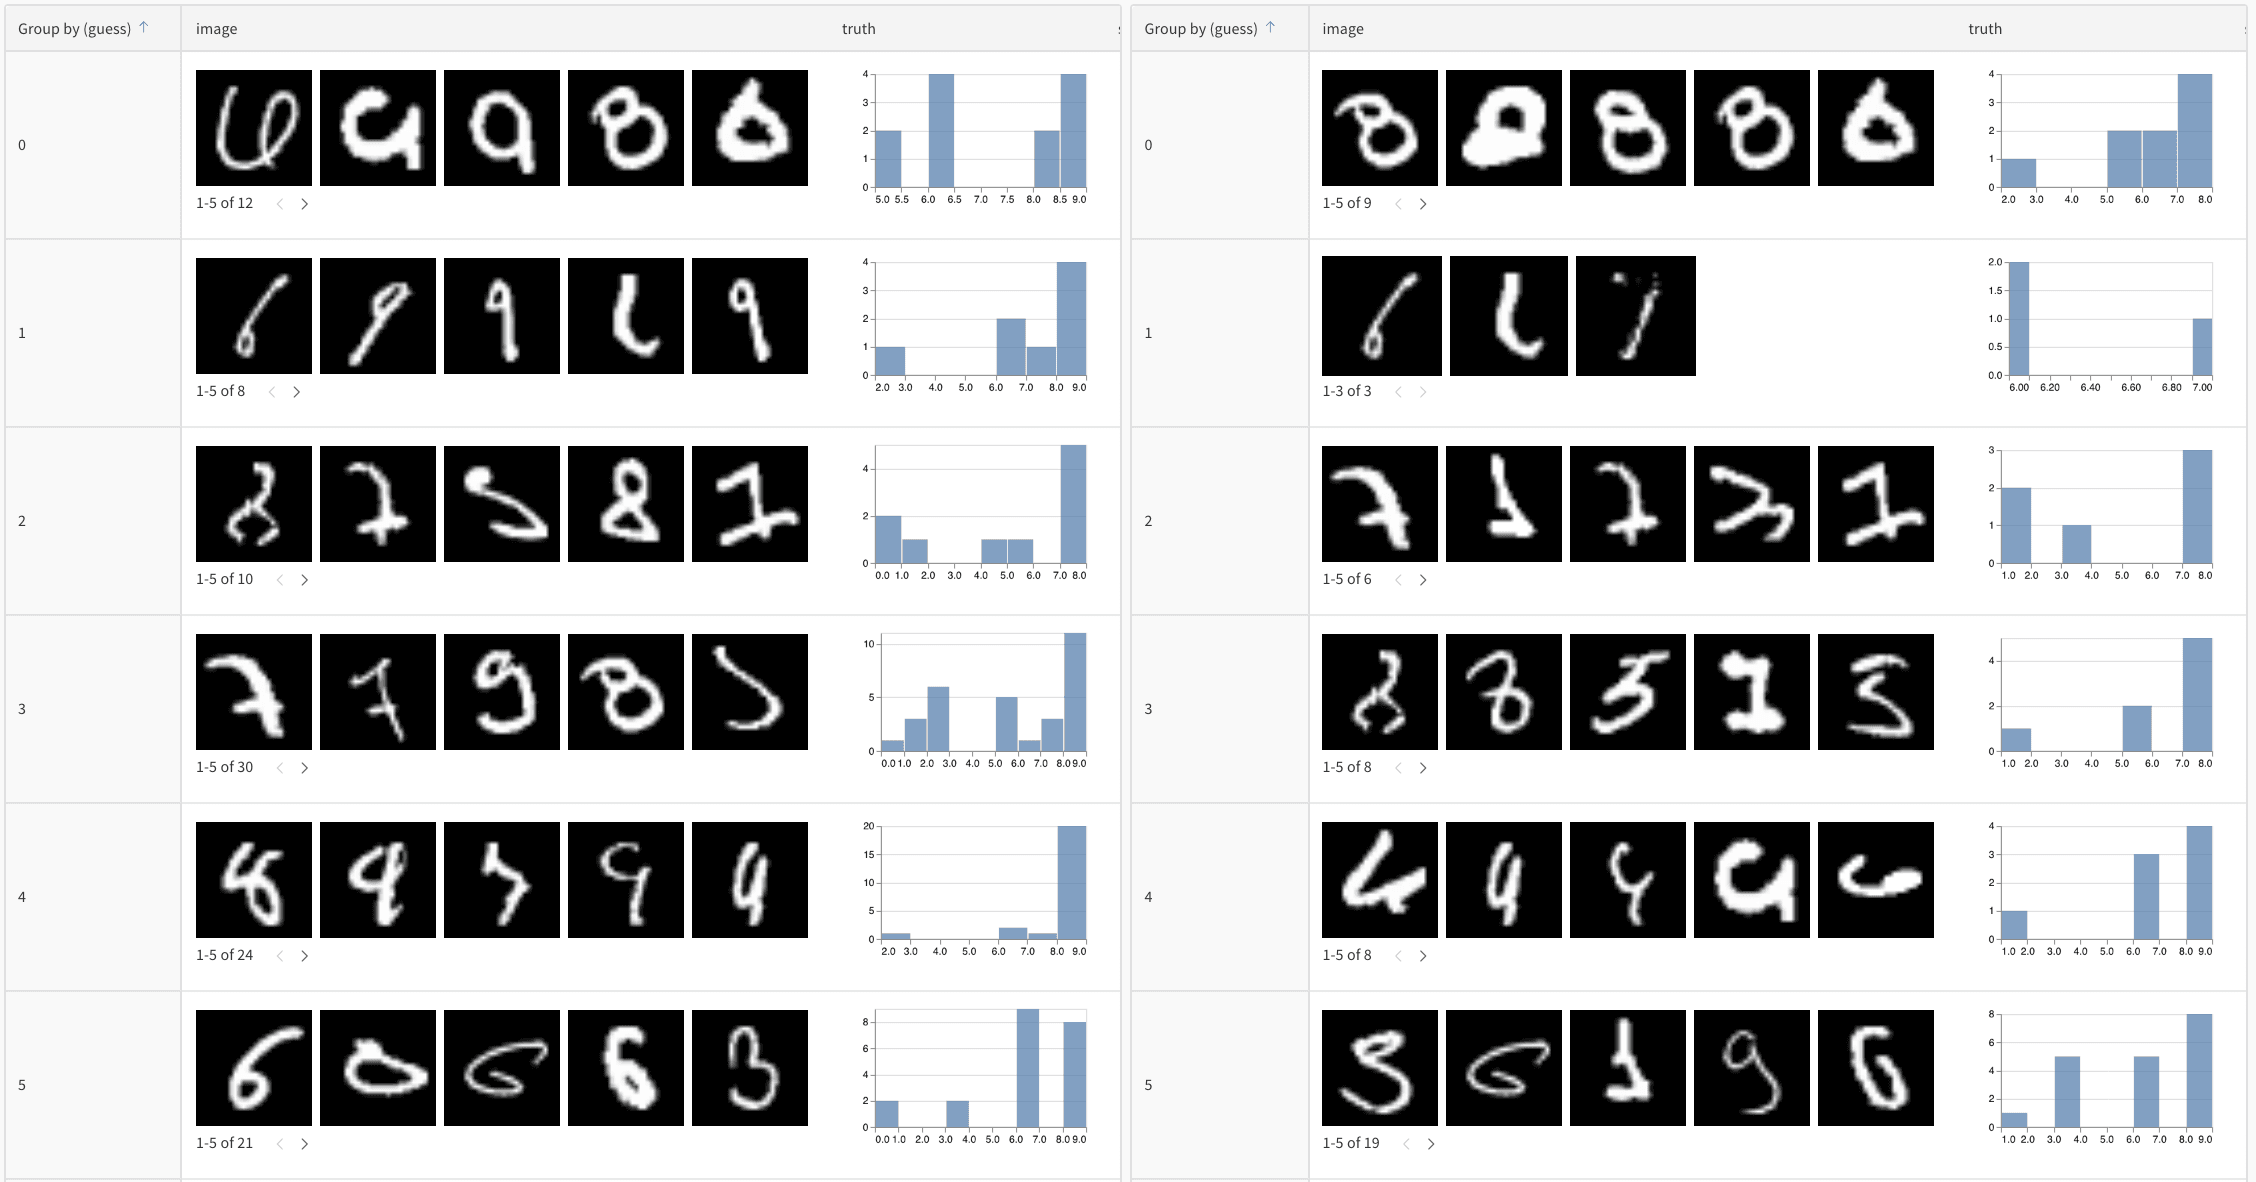
- 表を比較する: 複数の表バージョンを選択して、並べて比較します
- データをクエリする: クエリバーを使用して特定のパターンを検索します (例:
"correct" = false AND "confidence" > 0.8)
- グループ化と集計: 予測されたクラスでグループ化して、クラスごとの精度メトリクスを表示します
Example: エンリッチされた表によるエラー分析
Last modified on September 30, 2026