

Model et Evaluation. Ces API reposent sur un minimum d’hypothèses, ce qui leur permet de s’adapter à de nombreux cas d’usage.
Ce que vous allez apprendre
Ce guide vous montre comment :- Configurer un
Model. - Créer un dataset sur lequel tester les réponses d’un LLM.
- Définir une fonction de score pour comparer la sortie du modèle aux sorties attendues.
- Exécuter une évaluation qui teste le modèle sur le dataset à l’aide de la fonction de score et d’un évaluateur intégré supplémentaire.
- Afficher les résultats de l’évaluation dans l’interface de Weights & Biases.
Prérequis
- Un compte CoreWeave Forge
- Python 3.10+ ou Node.js 18+
- Les paquets requis installés :
- Python :
pip install weave openai - TypeScript :
npm install weave openai
- Python :
- Une clé API OpenAI définie dans une variable d’environnement.
Importer les bibliothèques et fonctions nécessaires
Importez les bibliothèques suivantes dans votre script :- Python
- TypeScript
Créer un Model
Une fois les bibliothèques en place, l’étape suivante consiste à définir le modèle que vous souhaitez évaluer.
Dans Weave, les Models sont des objets qui capturent à la fois le comportement de votre modèle ou agent (logique, prompt, paramètres) et ses métadonnées versionnées (paramètres, code, micro-configuration), afin que vous puissiez suivre, comparer, évaluer et itérer de manière fiable.
Lorsque vous instanciez un Model, Weave capture automatiquement sa configuration et ses comportements, et met à jour la version à chaque modification. Vous pouvez ainsi suivre l’évolution de ses performances au fil de vos itérations.
Pour déclarer un Model, créez une sous-classe de Model et implémentez une fonction predict qui prend un exemple en paramètre et renvoie la réponse.
L’exemple de modèle suivant utilise OpenAI pour extraire le nom, la couleur et la saveur de fruits extraterrestres à partir des phrases fournies en entrée.
- Python
- TypeScript
ExtractFruitsModel hérite de weave.Model (elle en est une sous-classe) afin que Weave puisse suivre l’objet instancié. Le décorateur @weave.op appliqué à la fonction predict permet de suivre ses entrées et ses sorties.
Vous pouvez instancier des objets Model comme suit :
- Python
- TypeScript
Créer un dataset
Maintenant que votreModel est défini, il vous faut un dataset sur lequel l’évaluer. Un Dataset est une collection d’exemples stockée sous forme d’objet Weave. Publier le dataset vers Weave permet de le versionner et de le réutiliser d’un run d’évaluation à l’autre.
L’exemple de dataset suivant définit trois phrases d’entrée et leurs réponses attendues (labels), puis les met en forme dans un tableau JSON exploitable par les fonctions de score.
Cet exemple construit une liste d’exemples directement dans le code, mais vous pouvez également les journaliser un par un depuis votre application en cours d’exécution.
- Python
- TypeScript
weave.Dataset(), puis publiez-le :
- Python
- TypeScript
Définir des fonctions de score personnalisées
Maintenant que vous disposez d’un modèle et d’un dataset, il vous faut un moyen de mesurer les performances du modèle sur chaque exemple. Les fonctions de score comparent la sortie du modèle à la cible attendue et produisent les métriques présentées dans les résultats d’une évaluation. Lorsque vous utilisez les évaluations Weave, Weave attend unetarget à laquelle comparer output. La fonction de score suivante prend deux dictionnaires (target et output) et renvoie un dictionnaire de valeurs booléennes qui indiquent si la sortie correspond à la cible. Le décorateur @weave.op() permet à Weave de suivre l’exécution de la fonction de score.
- Python
- TypeScript
Scorer personnalisées. Vous pouvez par exemple créer une classe LLMJudge standardisée avec des paramètres spécifiques (comme le modèle de chat ou le prompt), une logique de score propre à chaque ligne et un calcul de score agrégé. Pour plus d’informations, consultez le tutoriel sur la définition d’une classe Scorer dans Évaluation d’applications RAG basée sur un modèle.
Utiliser un évaluateur intégré et exécuter l’évaluation
Maintenant que le modèle, le dataset et un évaluateur personnalisé sont en place, vous pouvez tout assembler dans un run d’évaluation. Outre les fonctions de score personnalisées, vous pouvez également utiliser les évaluateurs intégrés de Weave. Dans l’évaluation suivante,weave.Evaluation() utilise la fonction fruit_name_score définie dans la section précédente ainsi que l’évaluateur intégré MultiTaskBinaryClassificationF1, qui calcule des scores F1.
L’exemple suivant évalue ExtractFruitsModel sur le dataset fruits à l’aide des deux fonctions de score, puis journalise les résultats dans Weave.
- Python
- TypeScript
Si vous exécutez le code depuis un script Python, vous devez utiliser
asyncio.run. En revanche, depuis un notebook Jupyter, vous pouvez utiliser await directement.Exemple complet
Pipeline d’évaluation complet dans un seul script :
Pipeline d’évaluation complet dans un seul script :
- Python
- TypeScript
Afficher les résultats de votre évaluation
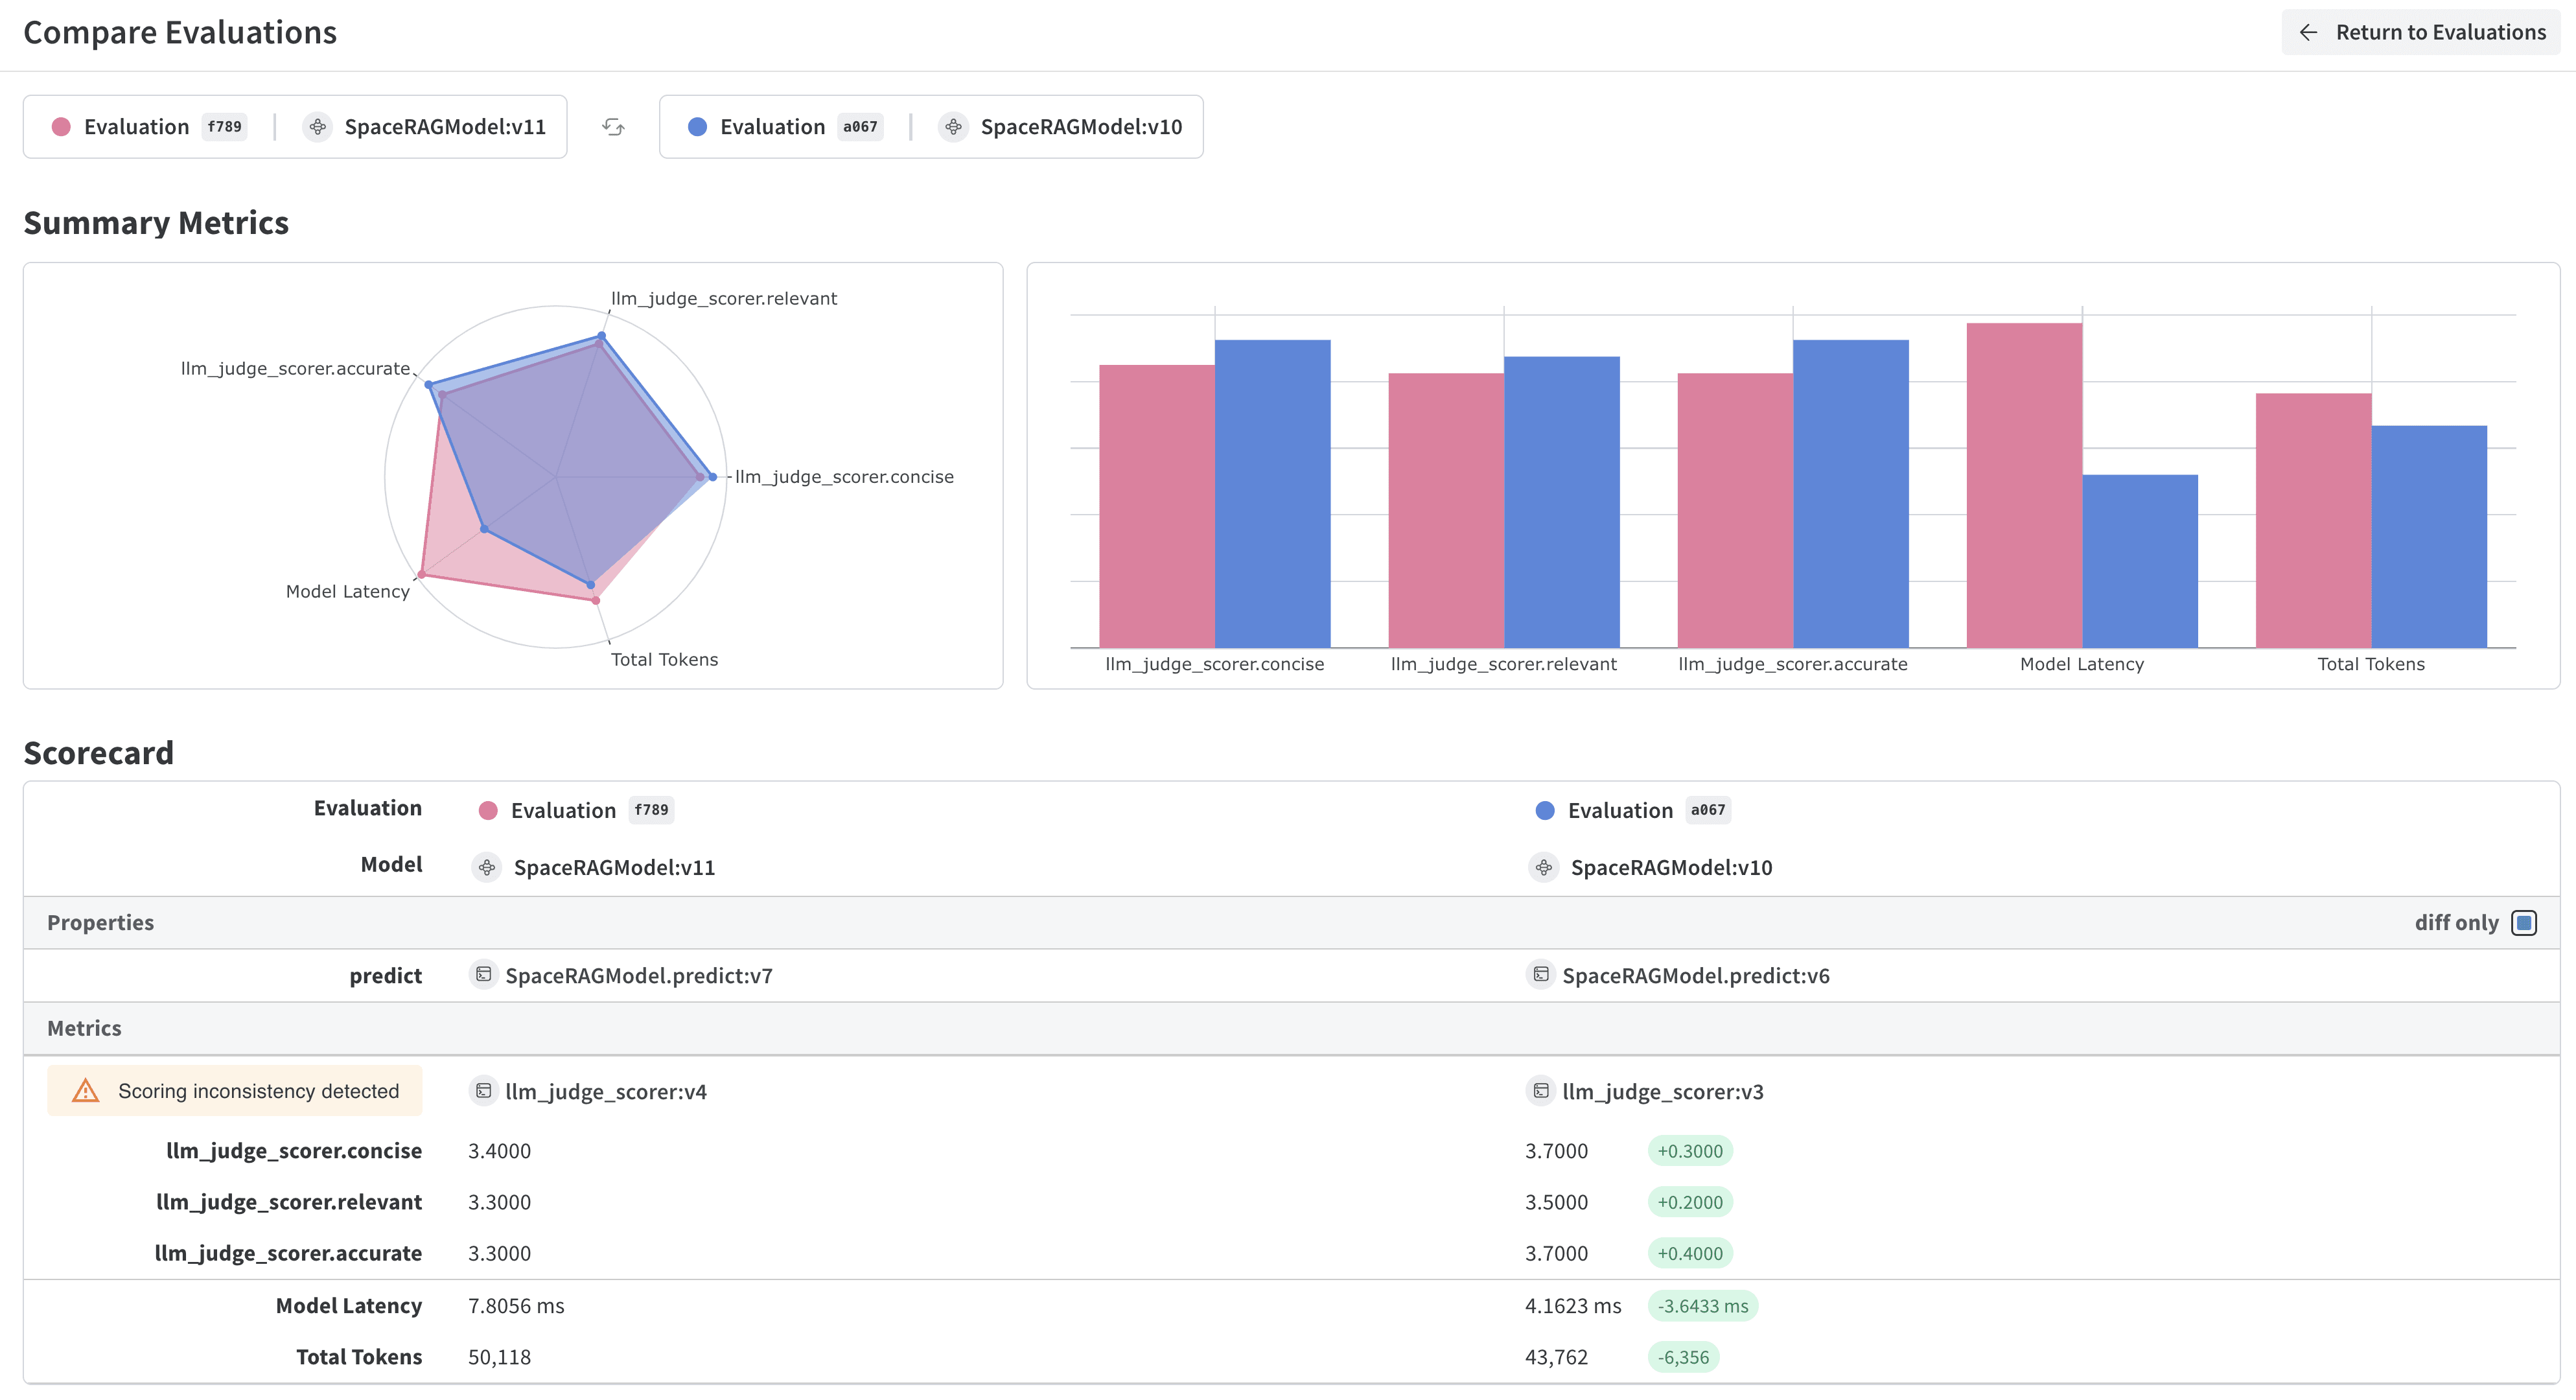
Une fois l’évaluation terminée, vous pouvez examiner chaque prédiction et chaque résultat d’évaluateur dans l’interface de Weights & Biases. Weave capture automatiquement les traces de chaque prédiction et de chaque score. Pour consulter les résultats, cliquez sur le lien affiché par l’évaluation.
En savoir plus sur les évaluations Weave
Vous disposez désormais d’un pipeline d’évaluation complet. Pour aller plus loin avec les fonctionnalités d’évaluation de Weave, consultez les ressources suivantes :- Découvrez comment créer et utiliser des évaluateurs.
- Consultez les fonctions de score intégrées de Weave.
- Découvrez l’évaluation basée sur des modèles, qui utilise des LLM comme juges.