Ceci est un notebook interactif. Vous pouvez l’exécuter localement ou utiliser les liens suivants :
Installer les dépendances
Avant de commencer, installez les bibliothèques utilisées tout au long du tutoriel. Ce tutoriel utilise les bibliothèques suivantes :- DSPy pour créer et optimiser le flux de travail LLM.
- Weave pour suivre le flux de travail LLM et évaluer différentes stratégies de prompting.
- datasets pour accéder au dataset BIG-Bench Hard depuis le Hugging Face Hub.
Activer le suivi avec Weave
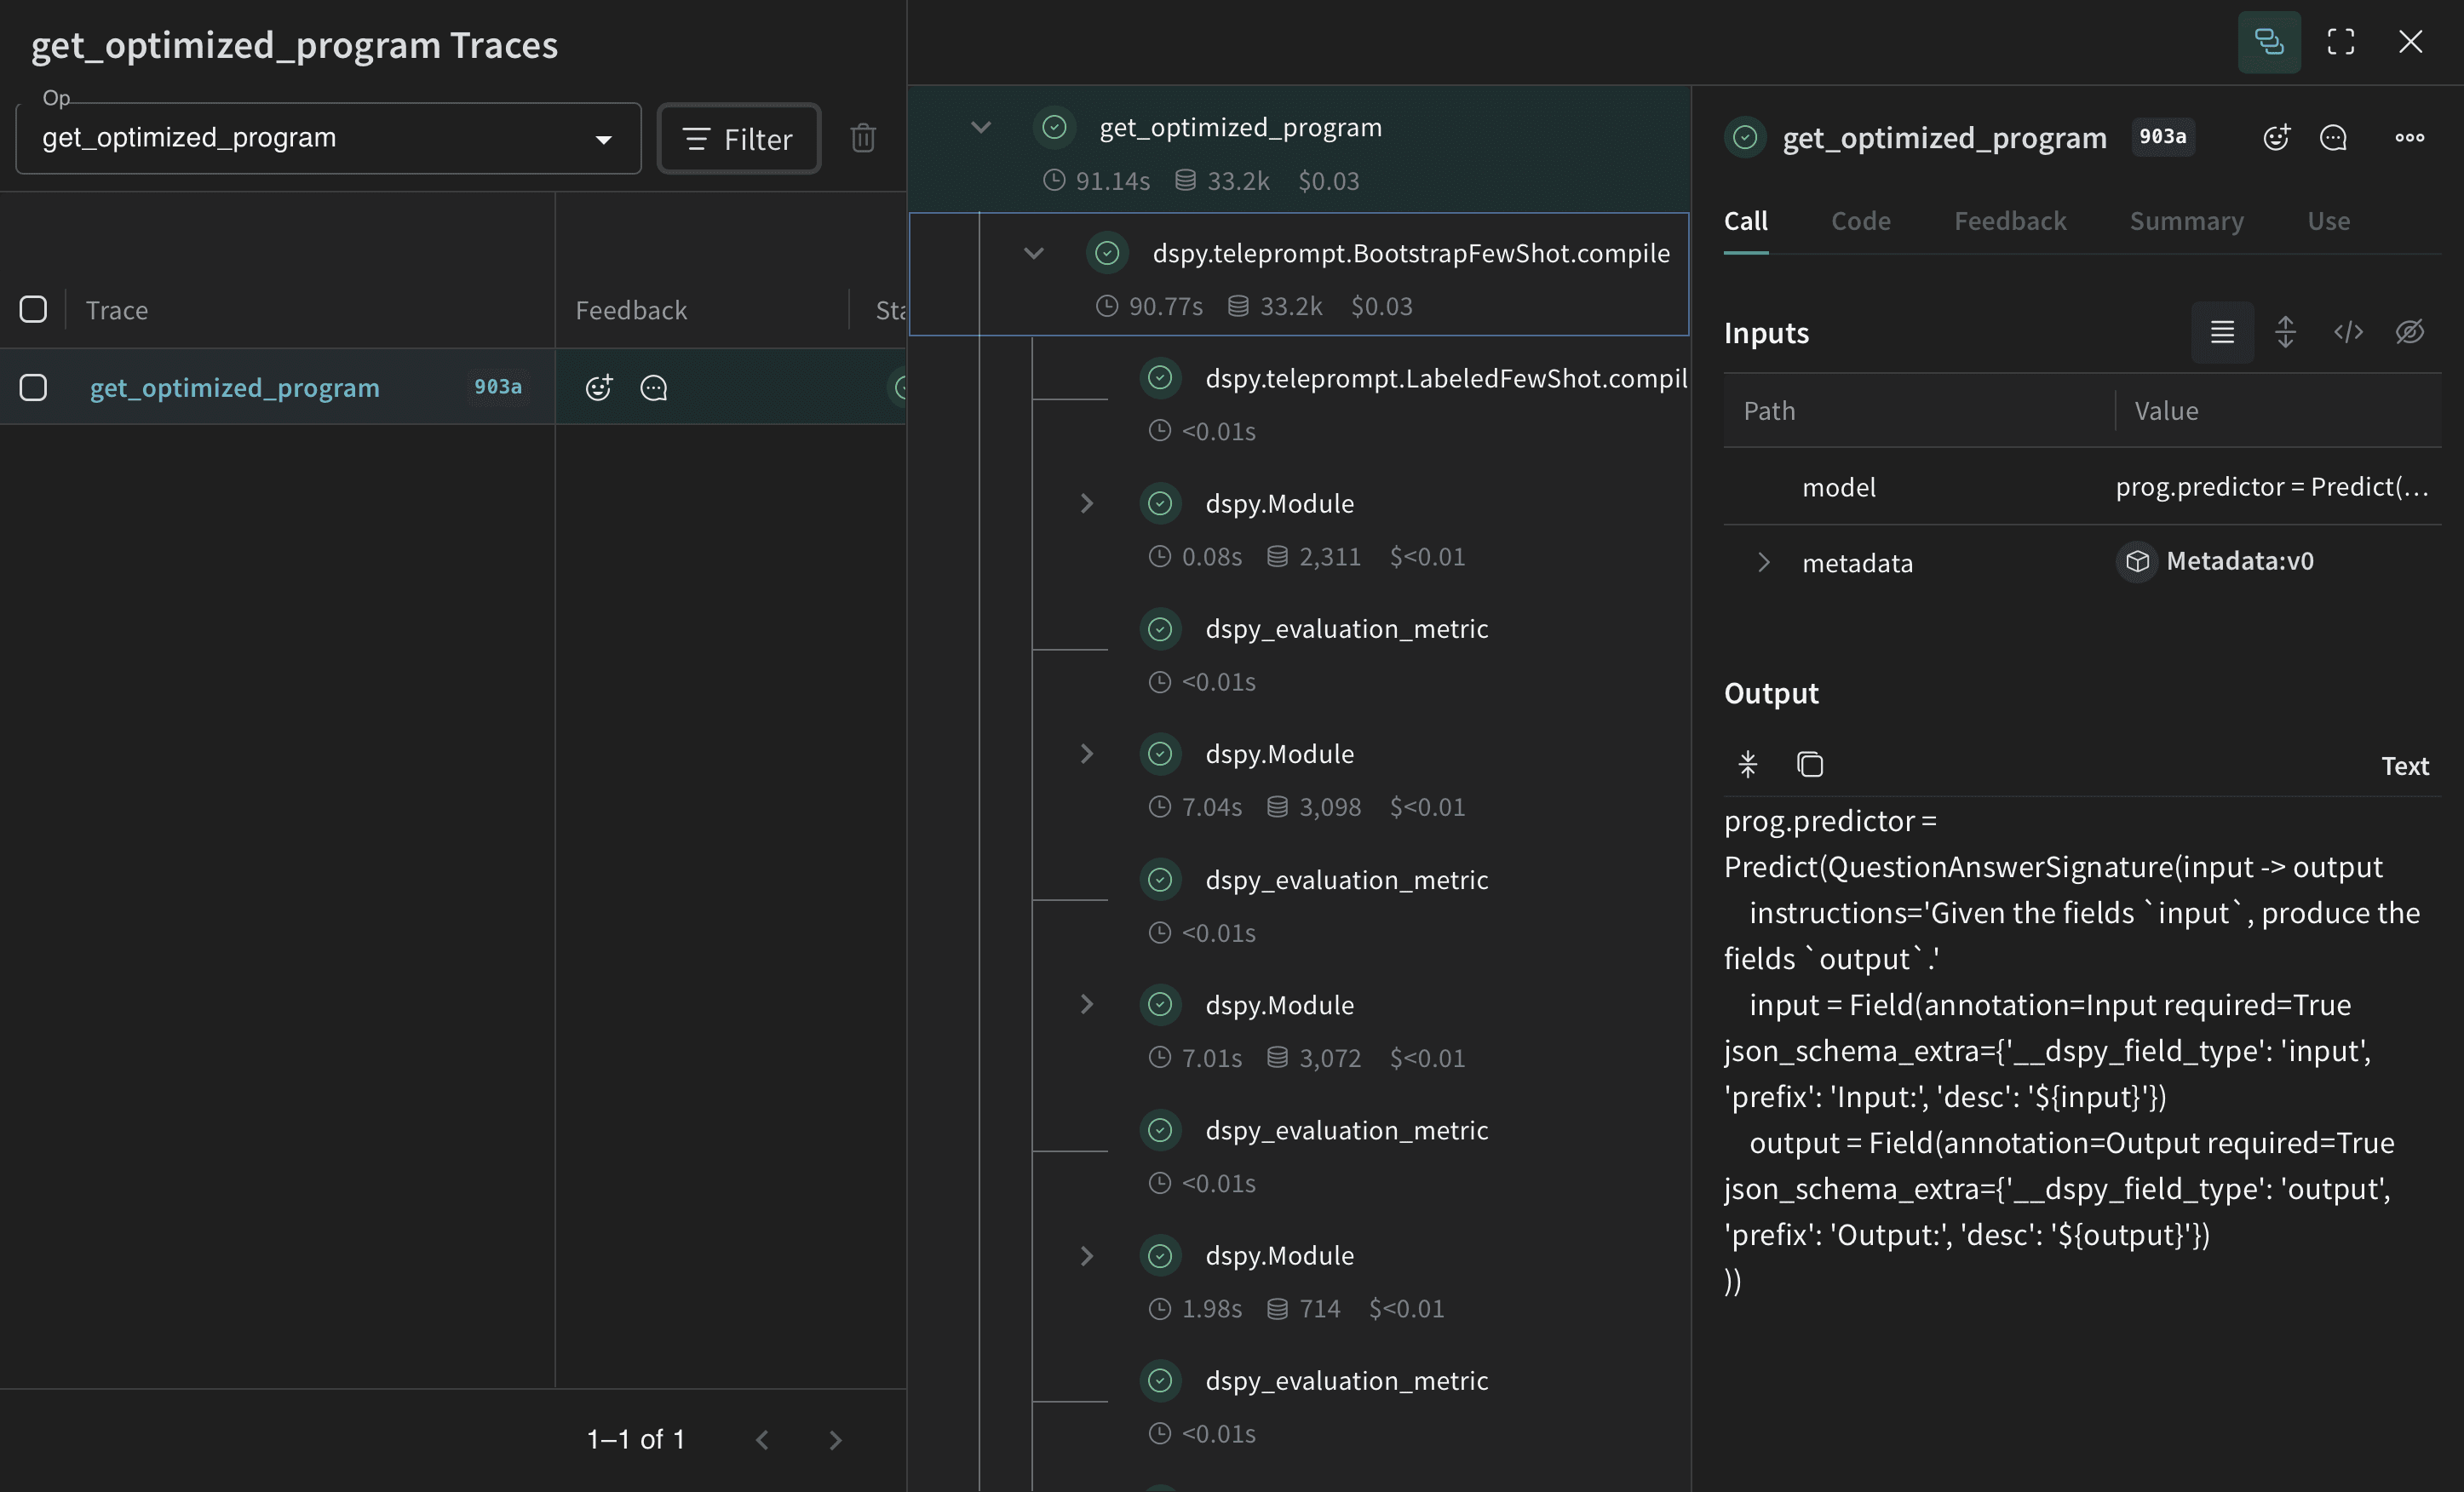
Cette section configure Weave afin que les appels DSPy effectués dans la suite du tutoriel soient automatiquement tracés et consultables dans l’interface utilisateur de Weights & Biases. Weave s’intègre à DSPy. Il suffit d’ajouterweave.init au début de votre code pour tracer automatiquement vos fonctions DSPy, que vous pourrez ensuite explorer dans l’interface utilisateur de Weights & Biases. Pour plus d’informations, voir la documentation de l’intégration Weave pour DSPy.
weave.Object pour gérer les métadonnées.
Charger le dataset BIG-Bench Hard
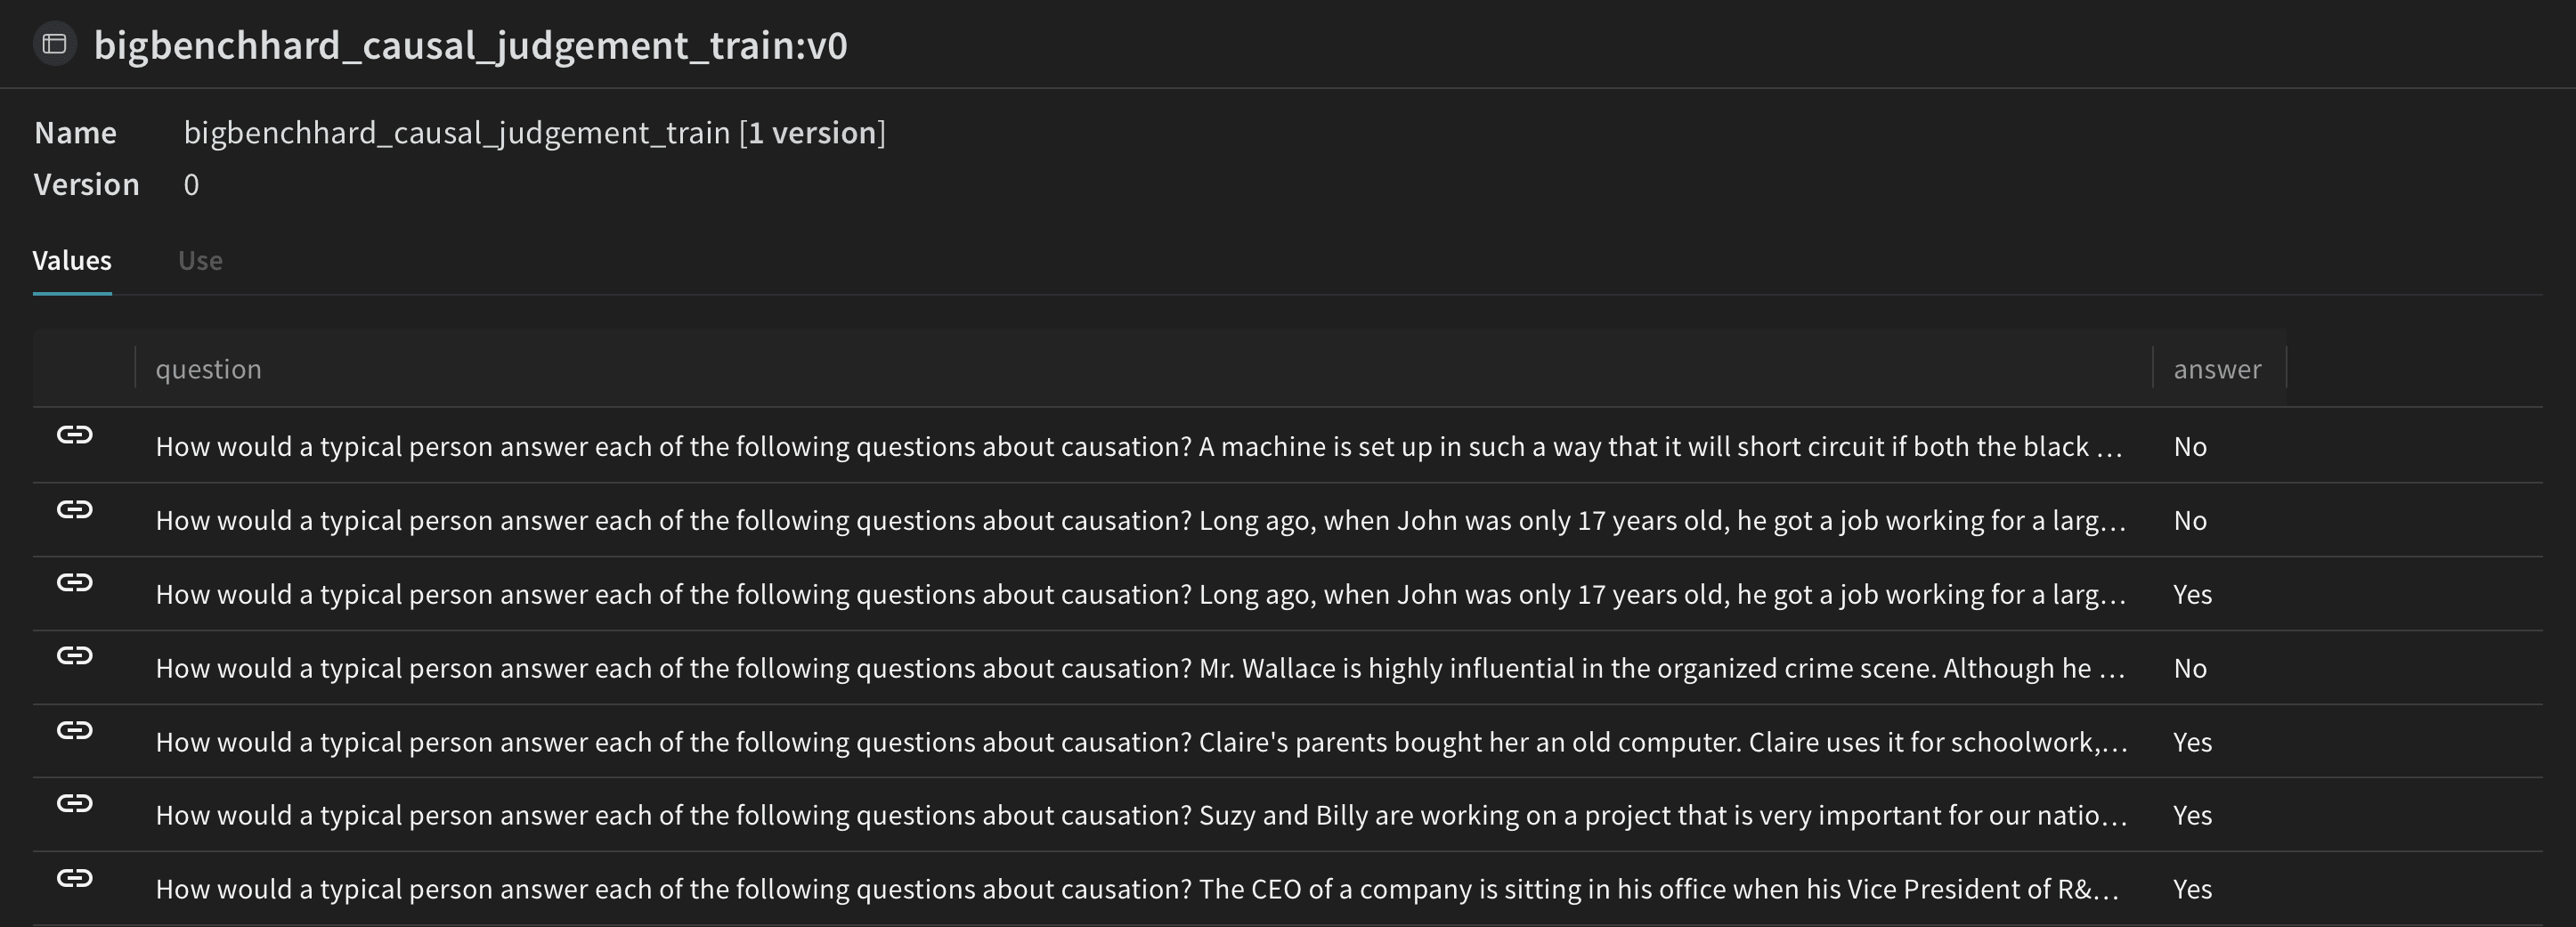
Une fois le suivi Weave activé, l’étape suivante consiste à préparer les données qui serviront à entraîner et à évaluer le programme DSPy. Chargez ce dataset depuis le HuggingFace Hub, divisez-le en ensembles d’entraînement et de validation, puis publiez-les sur Weave. La publication vous permet de versionner les datasets, mais aussi d’utiliserweave.Evaluation pour évaluer votre stratégie de prompting.
Le programme DSPy
Une fois le dataset publié dans Weave, vous pouvez définir le programme DSPy de référence que vous évaluerez et optimiserez par la suite. DSPy est un framework qui éloigne la création de nouveaux pipelines de LM de la manipulation de chaînes de caractères libres pour la rapprocher de la programmation (composition d’opérateurs modulaires pour construire des graphes de transformation de texte), un compilateur générant automatiquement, à partir d’un programme, des stratégies d’invocation de LM et des prompts optimisés. Utilisezdspy.LM pour configurer le modèle de langage et dspy.configure pour le définir comme modèle par défaut.
Écrire la signature de raisonnement causal
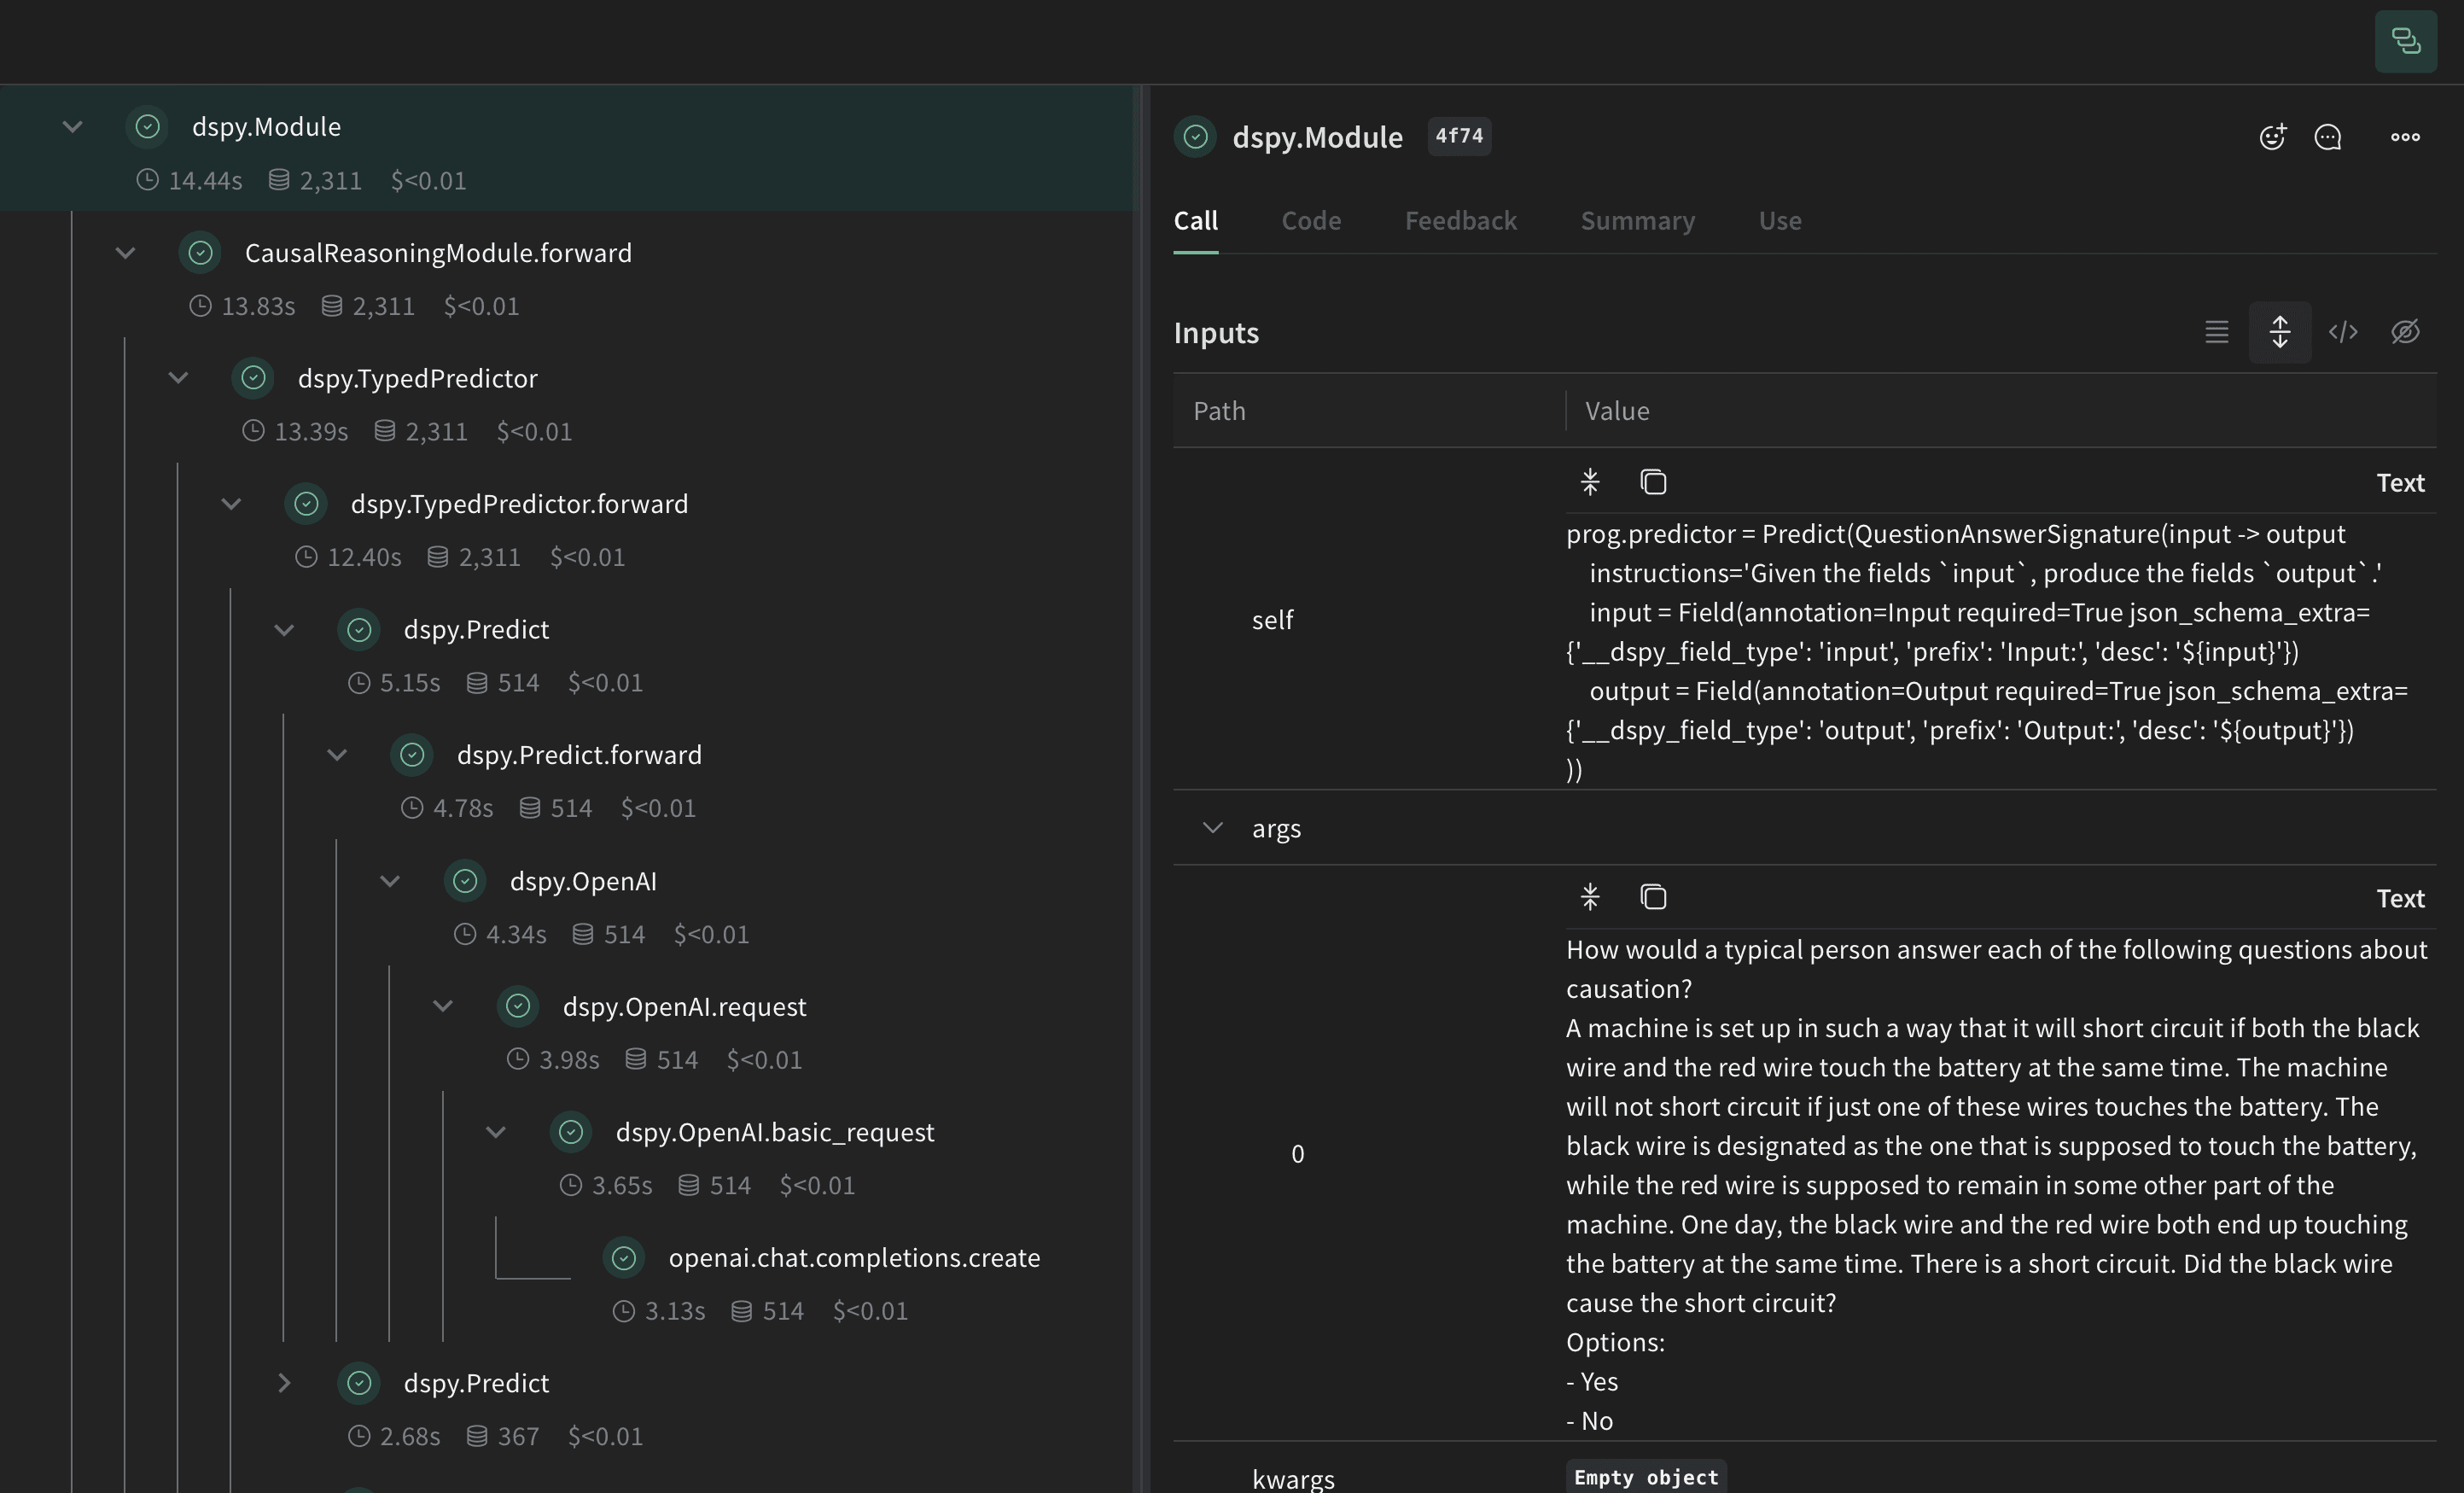
Une signature est une spécification déclarative du comportement d’entrée/sortie d’un module DSPy. Les modules DSPy sont des composants qui s’adaptent à la tâche (à la manière des couches d’un réseau de neurones) et qui abstraient une transformation de texte donnée.CausalReasoningModule) sur un exemple tiré du sous-ensemble de raisonnement causal de BIG-Bench Hard.
Évaluer le programme DSPy
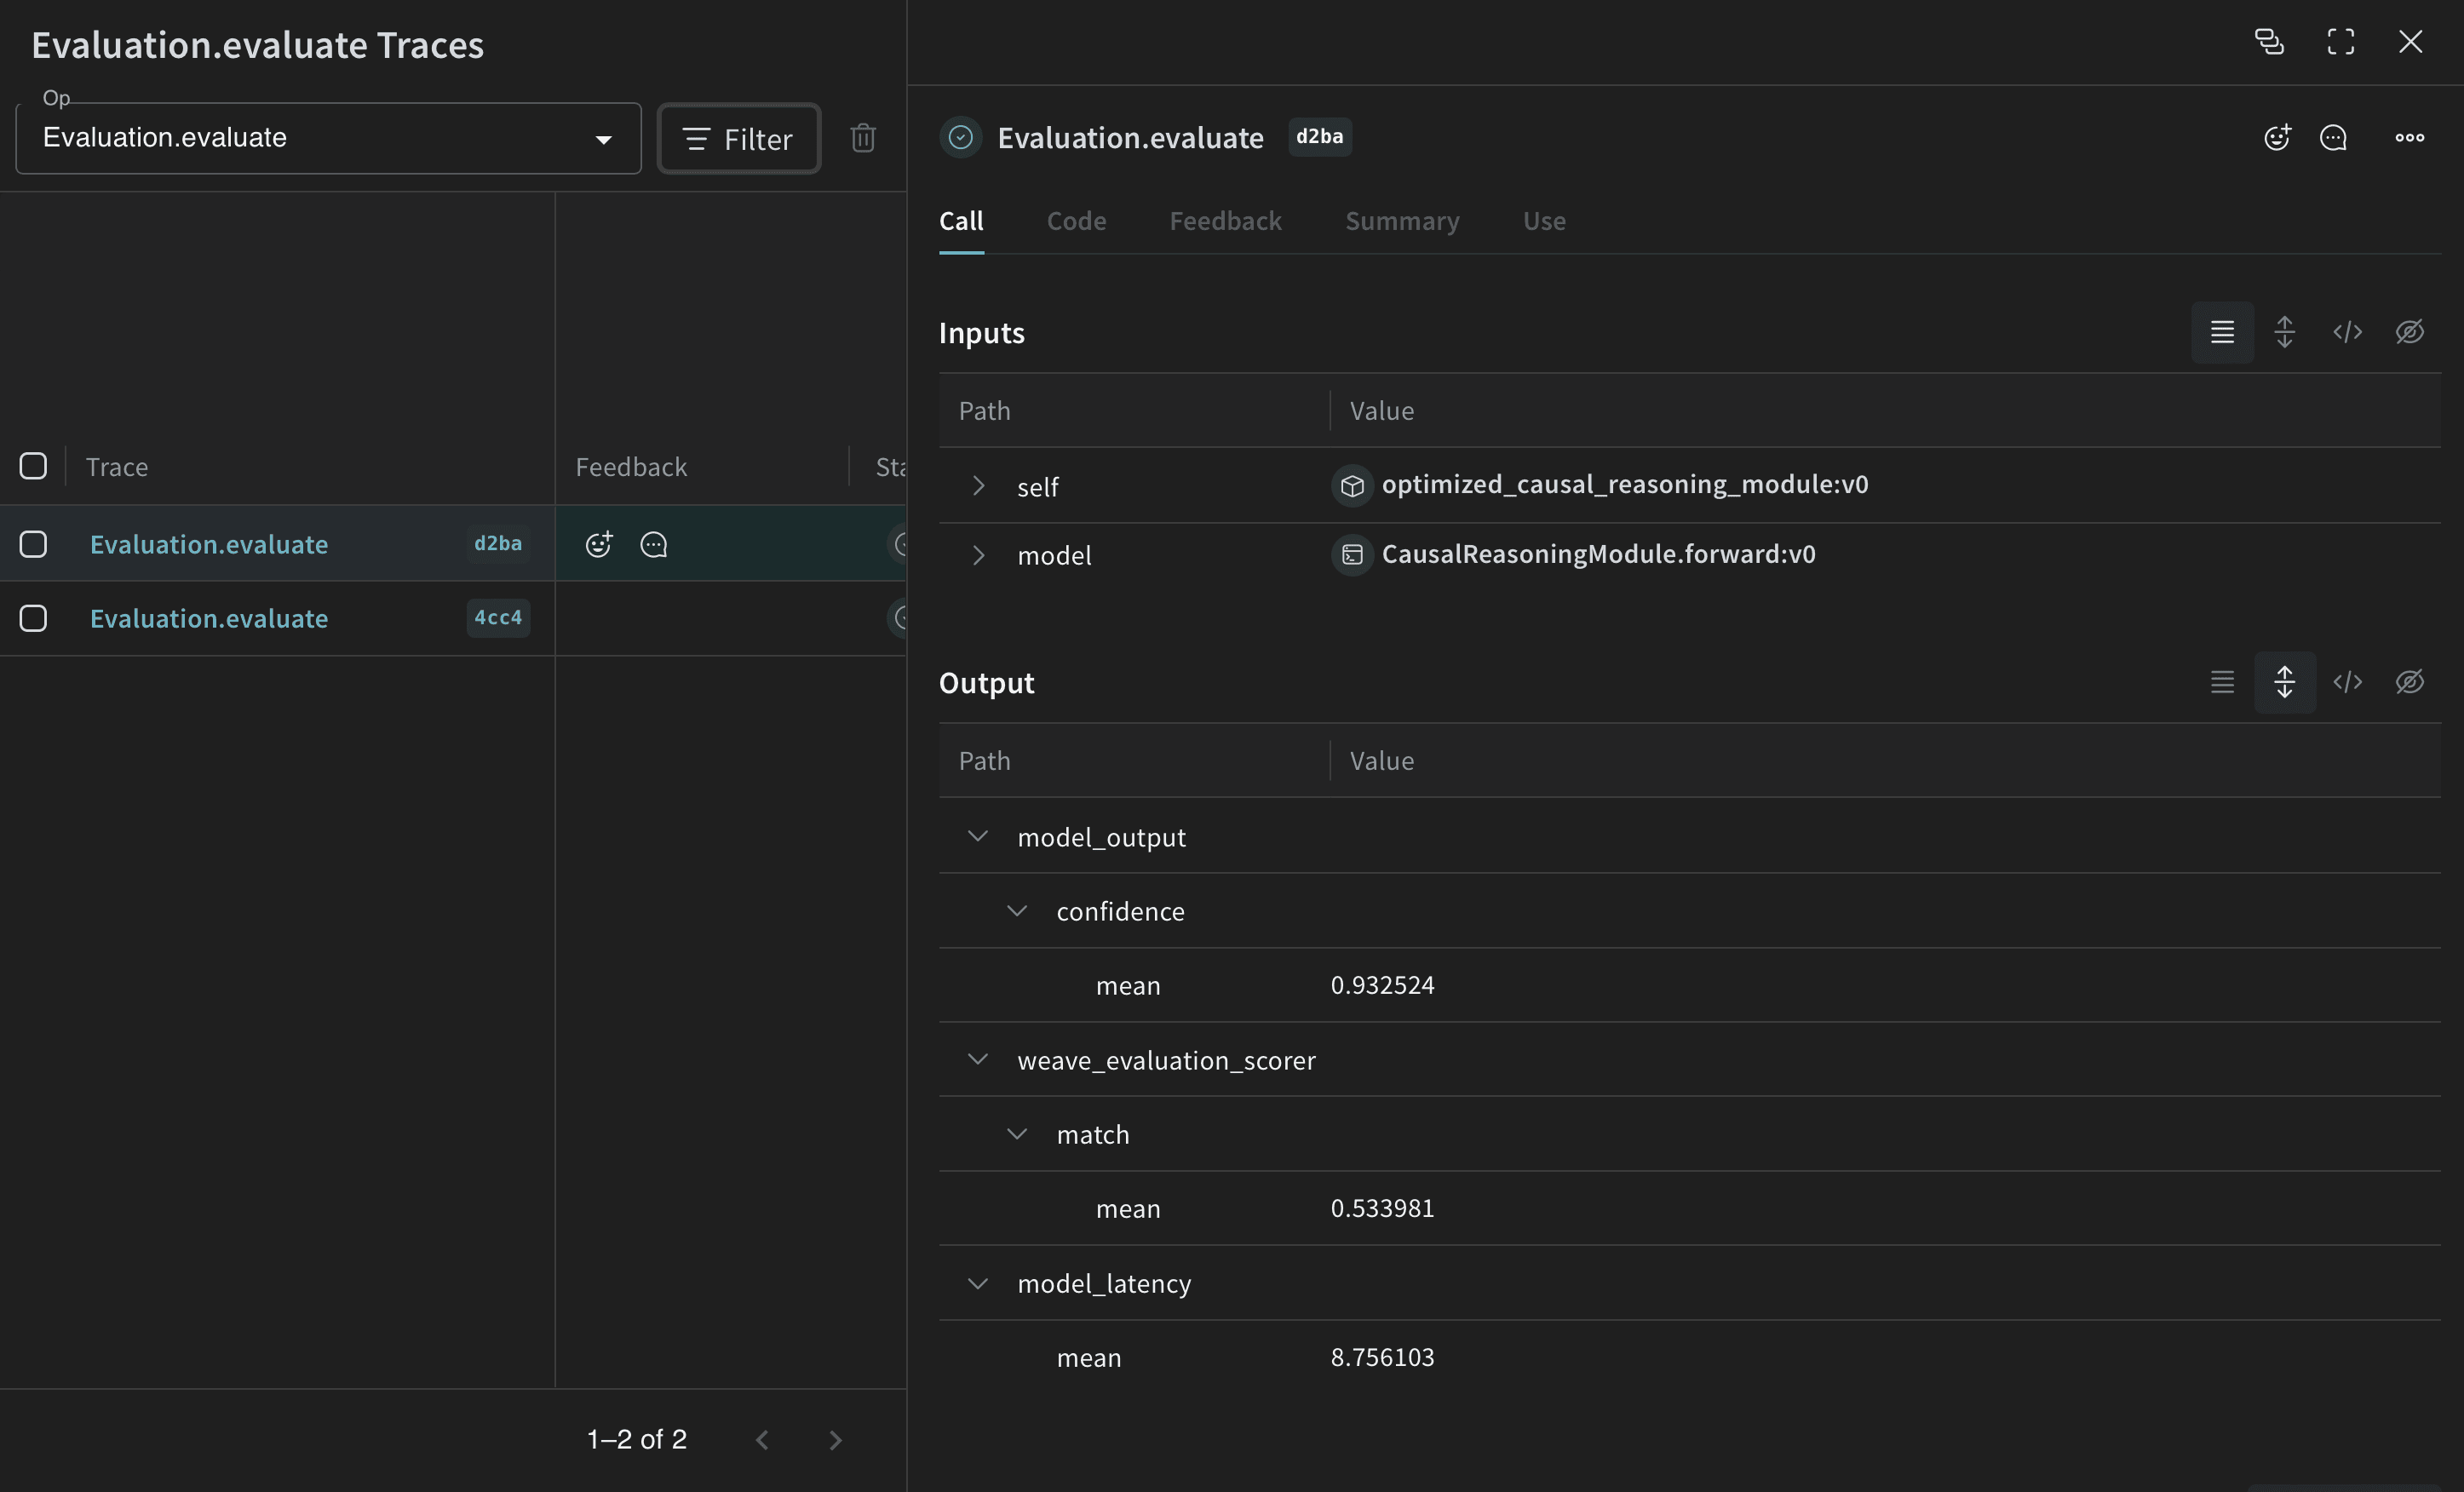
Maintenant que vous disposez d’une stratégie de prompting de référence, évaluez-la sur l’ensemble de validation à l’aide deweave.Evaluation, avec une métrique qui compare la réponse prédite à la vérité terrain. Weave prend chaque exemple, le transmet à votre application et évalue la sortie à l’aide de plusieurs fonctions de score personnalisées. Vous obtenez ainsi une vue d’ensemble des performances de votre application, ainsi qu’une interface riche pour examiner en détail chaque sortie et chaque score.
Commencez par créer une fonction de score qui détermine si la réponse prédite correspond à la vérité terrain. Les fonctions de score Weave reçoivent la valeur de retour du modèle dans output, ainsi que, sous forme d’arguments supplémentaires, toutes les clés correspondantes de l’exemple du dataset. Ici, answer provient du dataset et output est le dict renvoyé par CausalReasoningModule.forward.
weave.Evaluation peut appeler. Les noms des arguments du wrapper doivent correspondre aux noms des colonnes du dataset exploitées par le modèle.
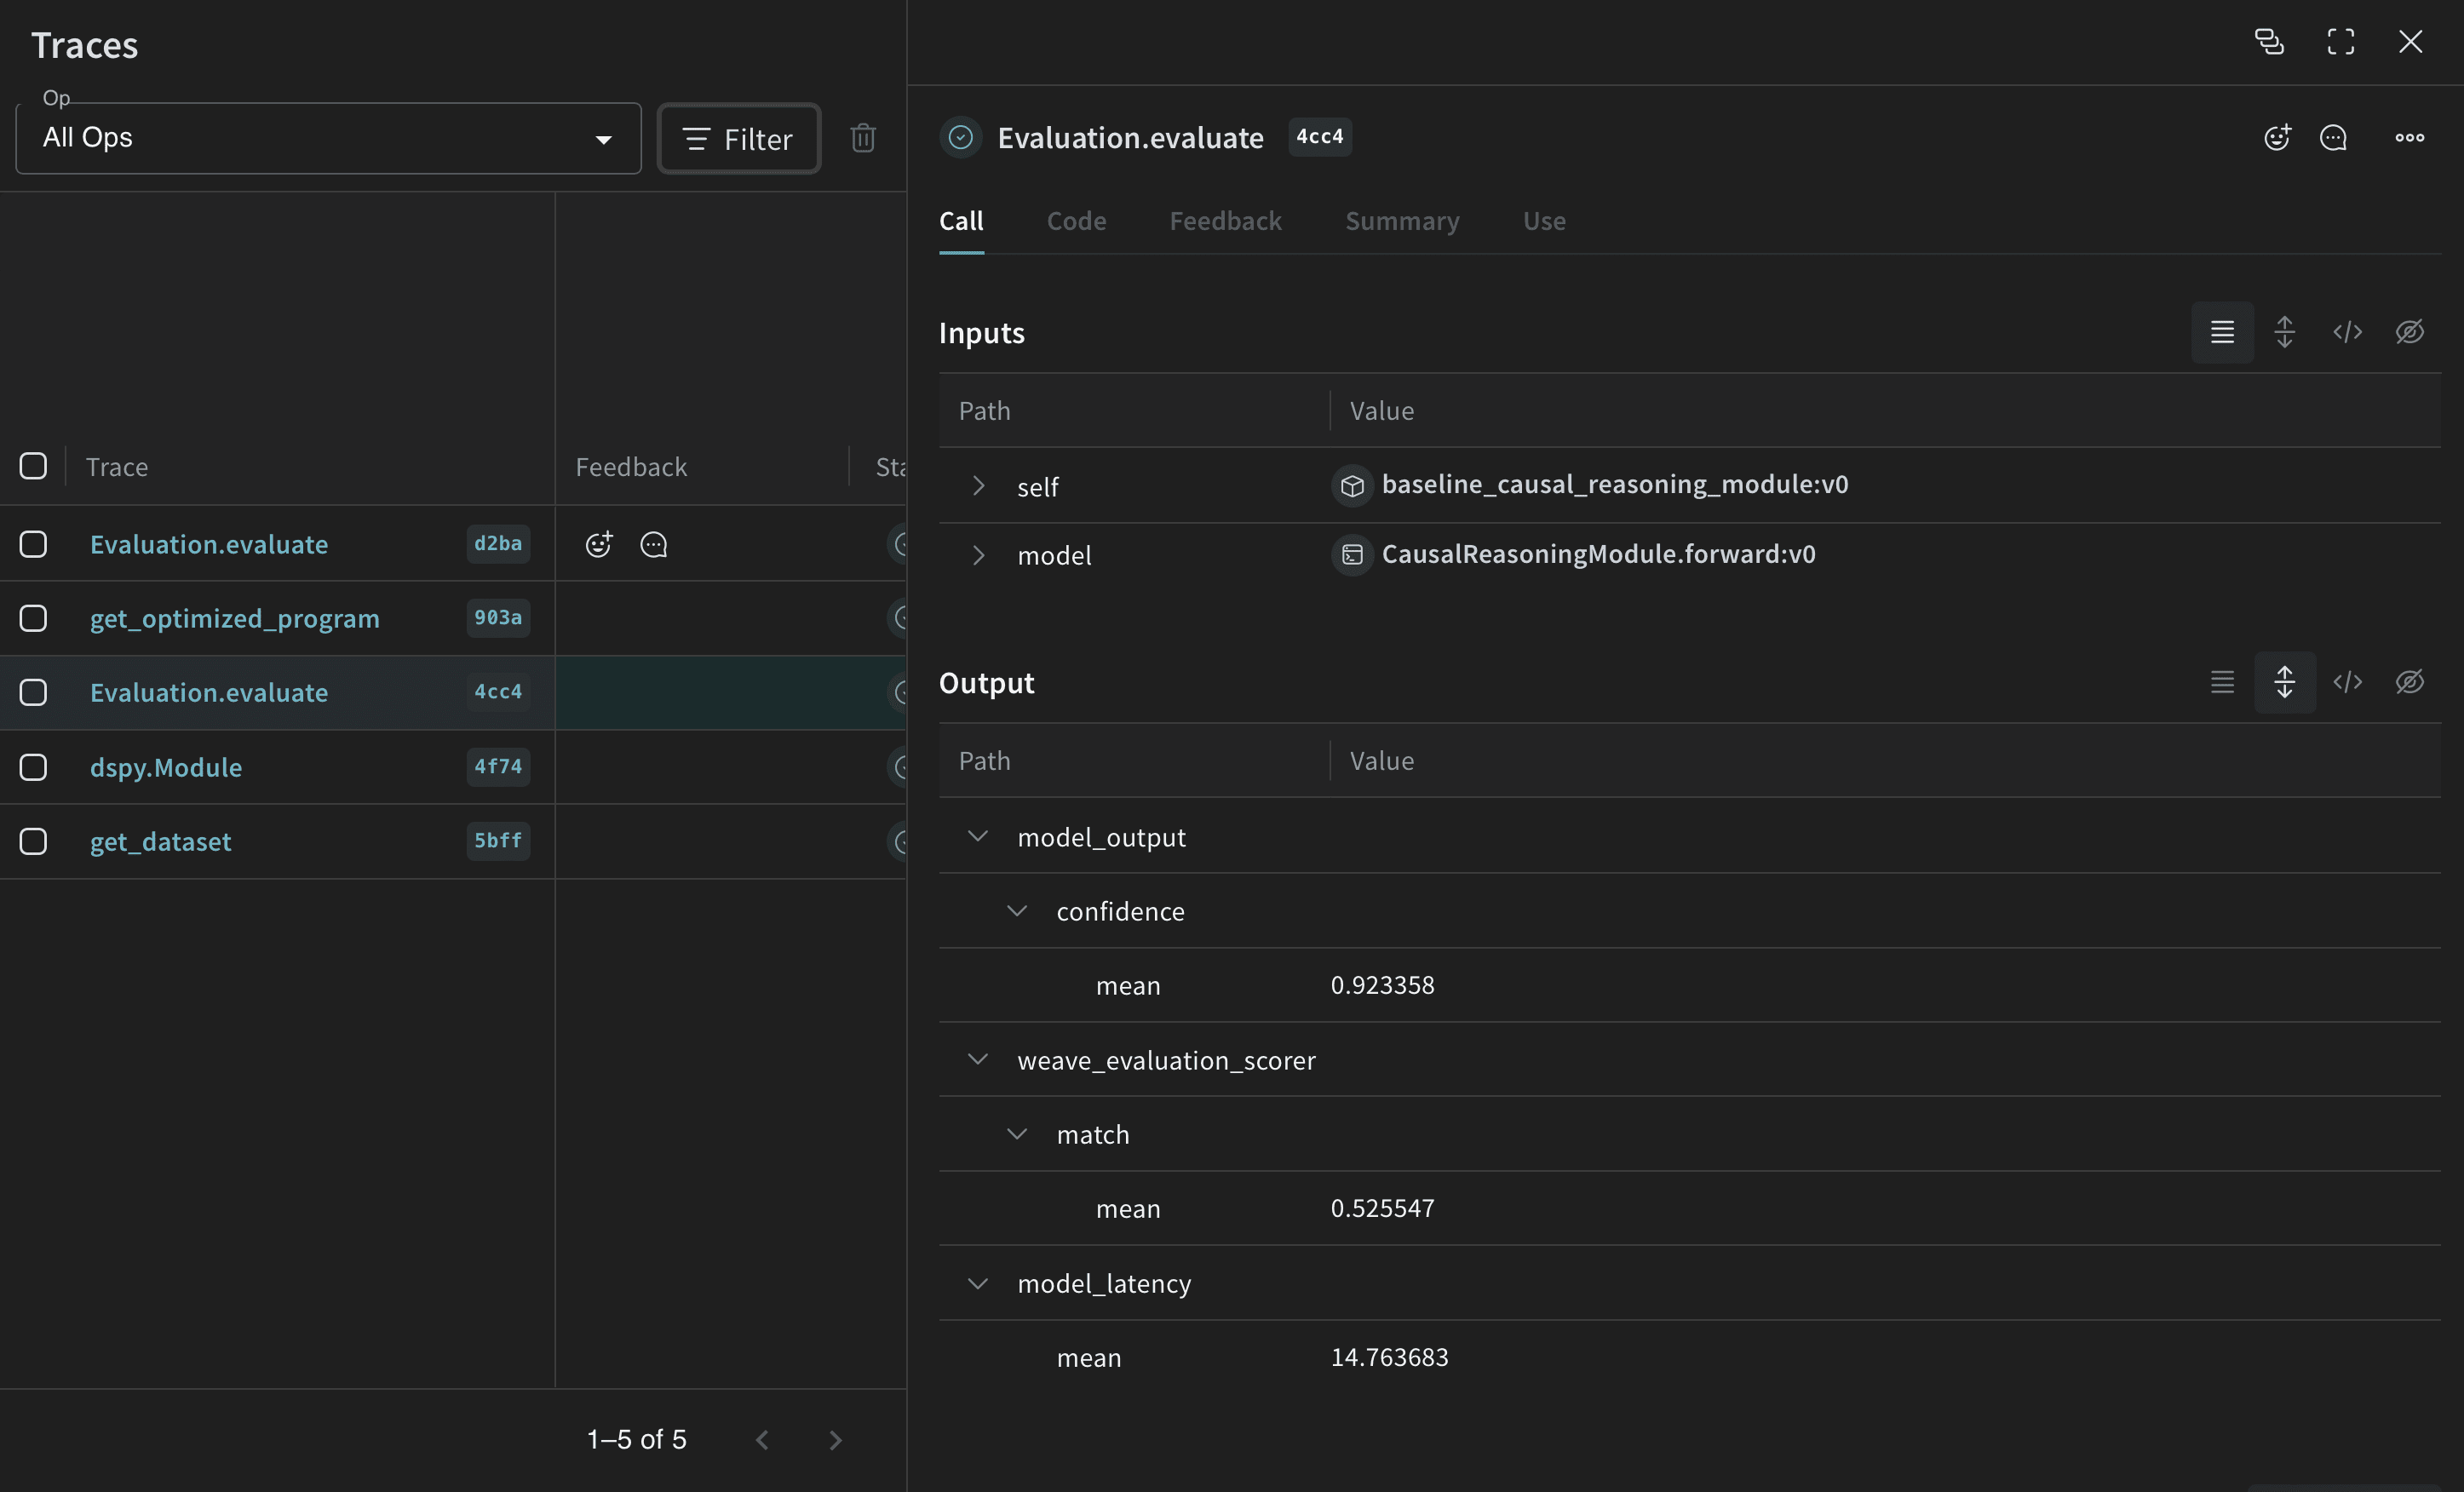
Si vous exécutez le code à partir d’un script Python, vous pouvez utiliser le code suivant pour lancer l’évaluation :
Optimiser le programme DSPy
Une fois les performances de référence mesurées, vous pouvez appliquer un optimiseur DSPy et comparer le résultat à la référence. Maintenant que vous disposez d’un programme DSPy de référence, améliorez ses performances en raisonnement causal à l’aide de l’optimiseur BootstrapFewShot, qui peut ajuster les paramètres d’un programme DSPy afin de maximiser les métriques spécifiées.