이 페이지의 모든 코드 샘플은 Python으로 작성되었습니다.
Google Colab에서 Weave로 Hugging Face Hub 사용해 보기
별도의 설정 없이 Hugging Face Hub와 Weave를 바로 실험해 보고 싶으신가요? 이 페이지의 코드 샘플을 Google Colab에서 Jupyter Notebook으로 사용해 볼 수 있습니다.
개요
Hugging Face Hub는 크리에이터와 협업자를 위한 머신러닝 플랫폼으로, 다양한 유형의 프로젝트에 활용할 수 있는 사전 트레이닝된 모델과 데이터셋을 폭넓게 제공합니다.huggingface_hub Python 라이브러리는 Hub에 호스팅된 모델을 여러 서비스에서 추론할 수 있도록 통합 인터페이스를 제공합니다. InferenceClient를 사용하면 이러한 모델을 호출할 수 있습니다.
Weave는 InferenceClient의 트레이스를 자동으로 캡처합니다. 추적을 시작하려면 weave.init()을 호출한 뒤 평소처럼 라이브러리를 사용하세요.
사전 요구 사항
시작하기 전에 다음 설정 단계에 따라 필요한 라이브러리를 설치하고 Hugging Face Hub에 대한 액세스를 설정하세요.-
Weave로
huggingface_hub를 사용하려면 먼저 필요한 라이브러리를 설치하거나 최신 버전으로 업그레이드해야 합니다. 다음 명령은huggingface_hub와weave를 설치하고, 이미 설치되어 있으면 최신 버전으로 업그레이드합니다. 또한 설치 출력을 최소화합니다. -
Hugging Face Hub의 모델로 추론을 실행하려면 User Access Token을 설정하세요. 토큰은 Hugging Face Hub 설정 페이지에서 설정하거나 프로그래밍 방식으로 설정할 수 있습니다. 다음 코드 샘플은
HUGGINGFACE_TOKEN을 입력하라는 메시지를 표시한 뒤, 입력한 토큰을 환경 변수로 설정합니다.
기본 트레이싱
개발 및 프로덕션 단계에서는 언어 모델 애플리케이션의 트레이스를 한곳에 모아 저장하는 것이 필수적입니다. 이러한 트레이스는 디버깅에 유용하며, 애플리케이션 개선을 위한 데이터셋으로도 활용할 수 있습니다. Weave는InferenceClient의 트레이스를 자동으로 캡처합니다. 추적을 시작하려면 weave.init()을 호출하여 Weave를 초기화한 후 평소처럼 라이브러리를 사용하세요.
다음 예시는 Weave를 사용하여 Hugging Face Hub에 대한 추론 Call을 로깅하는 방법을 보여줍니다.
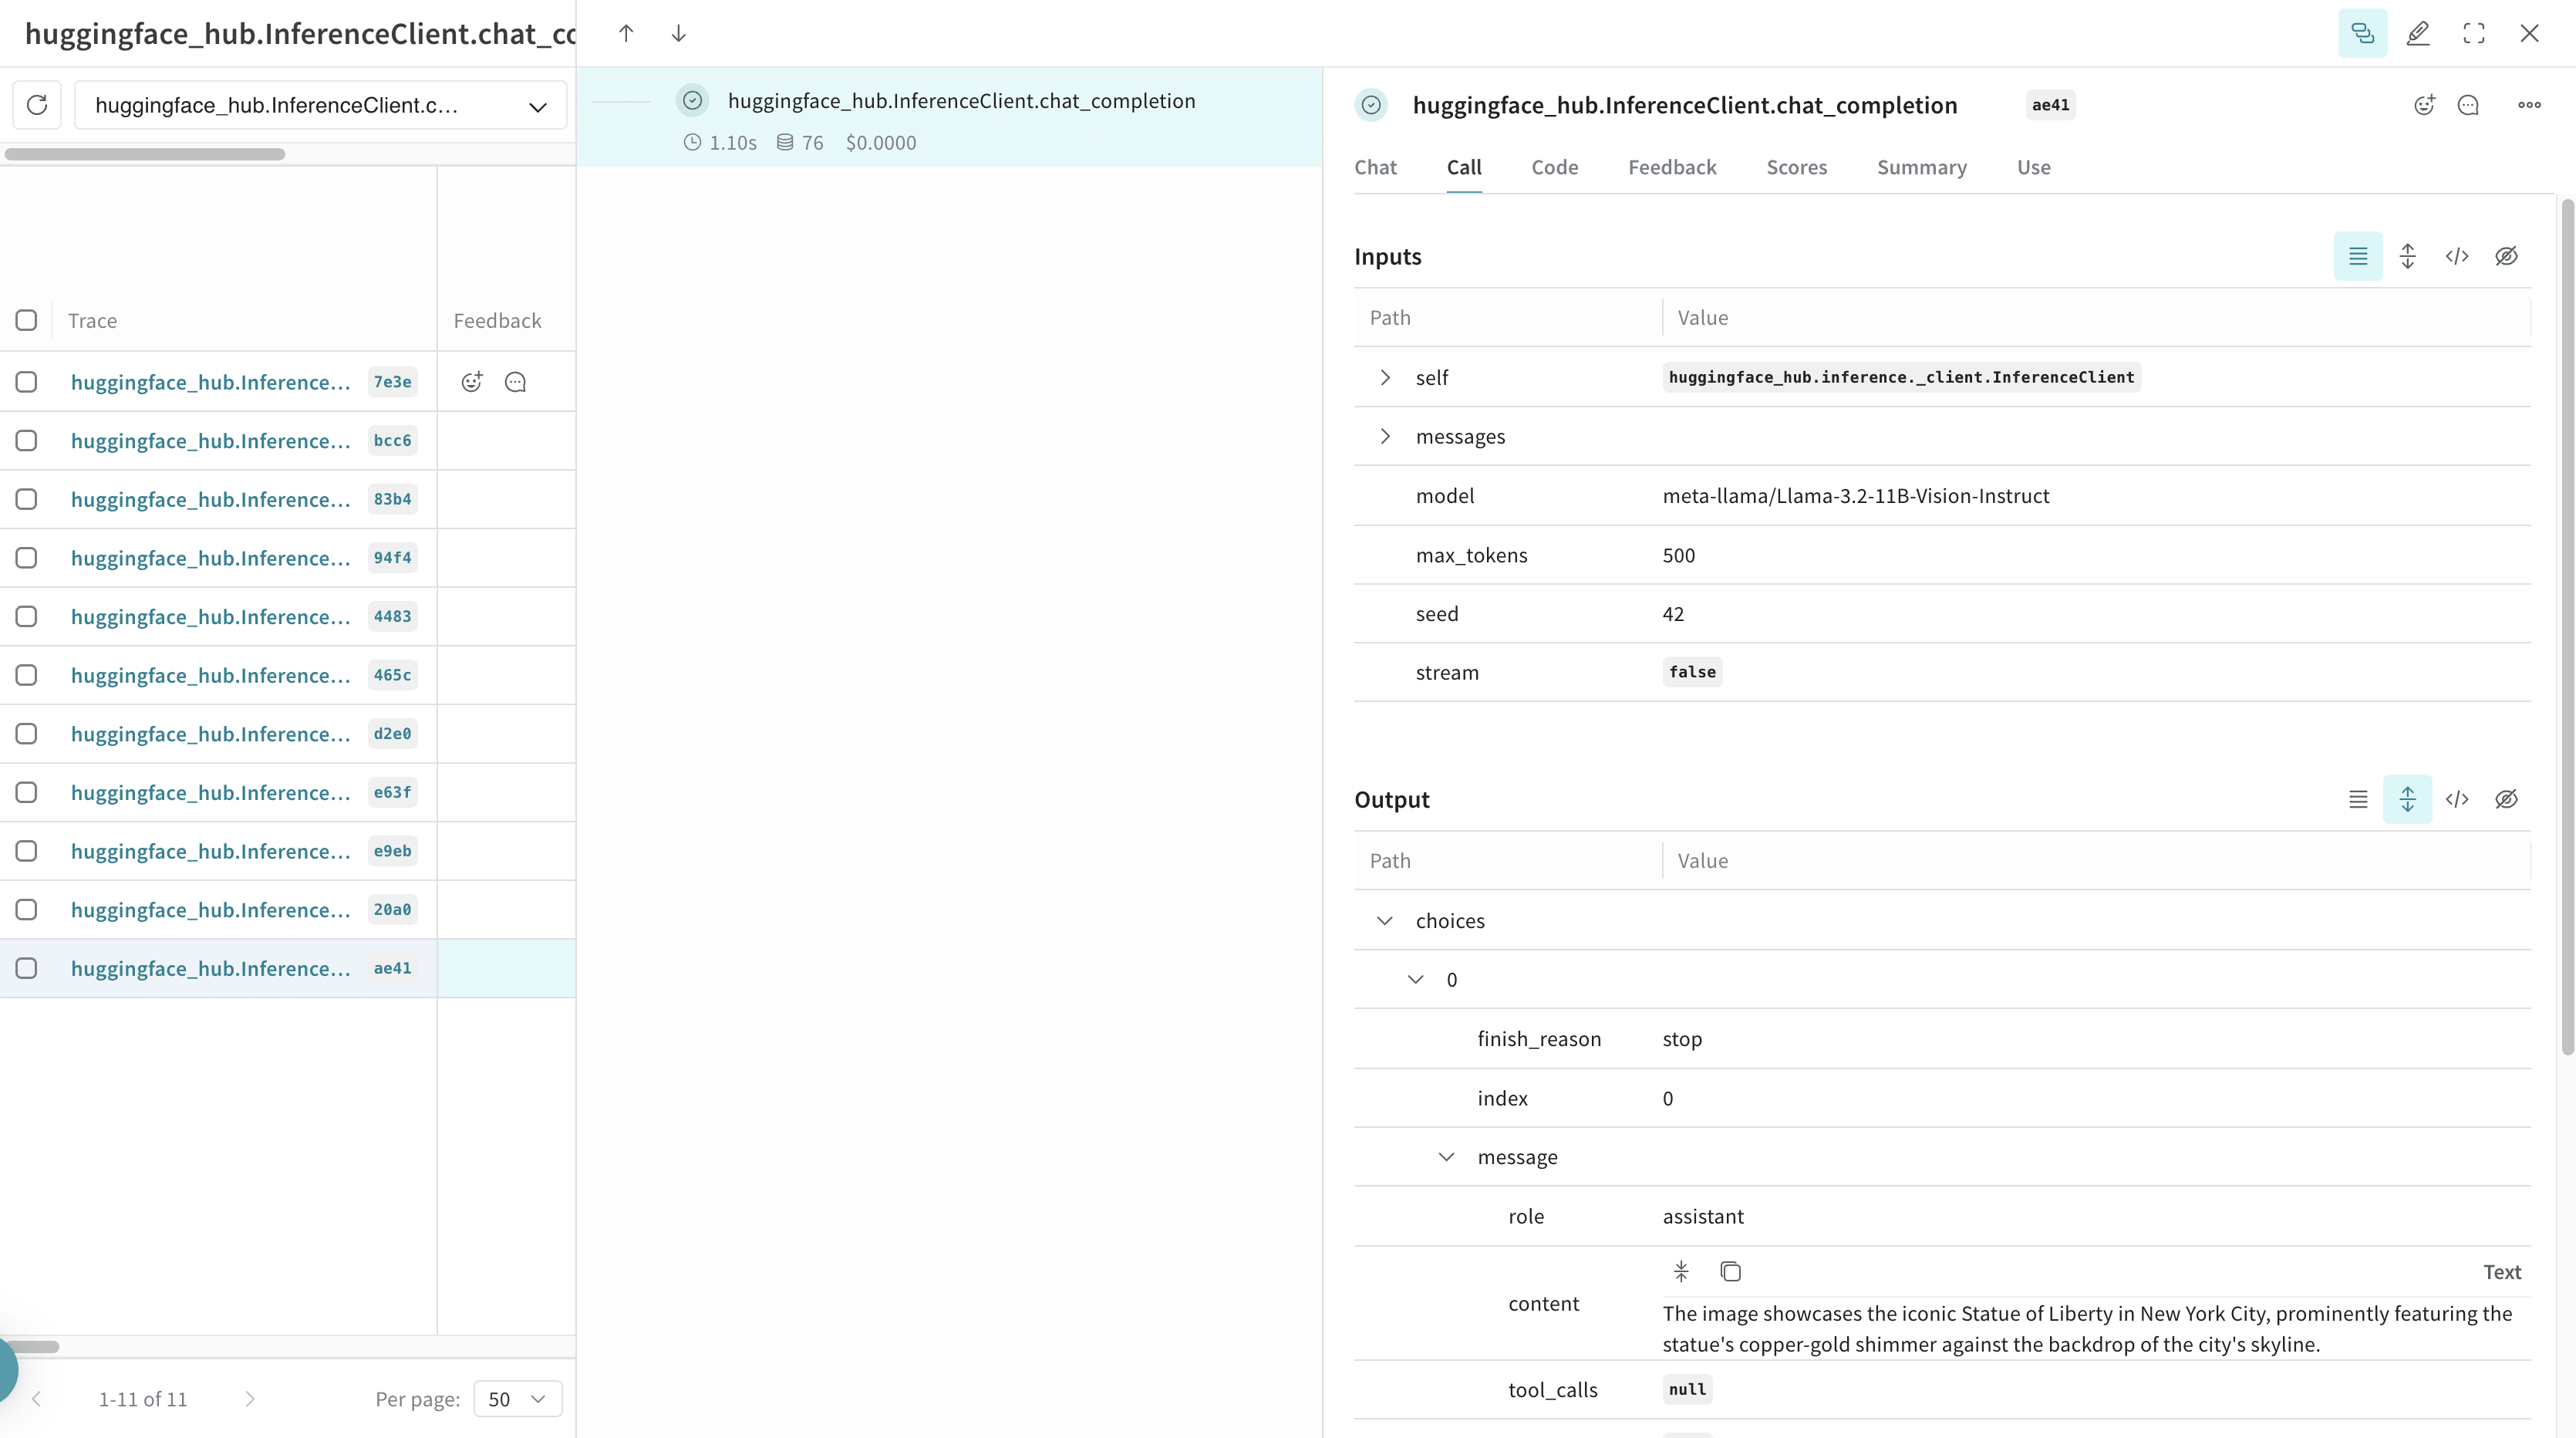
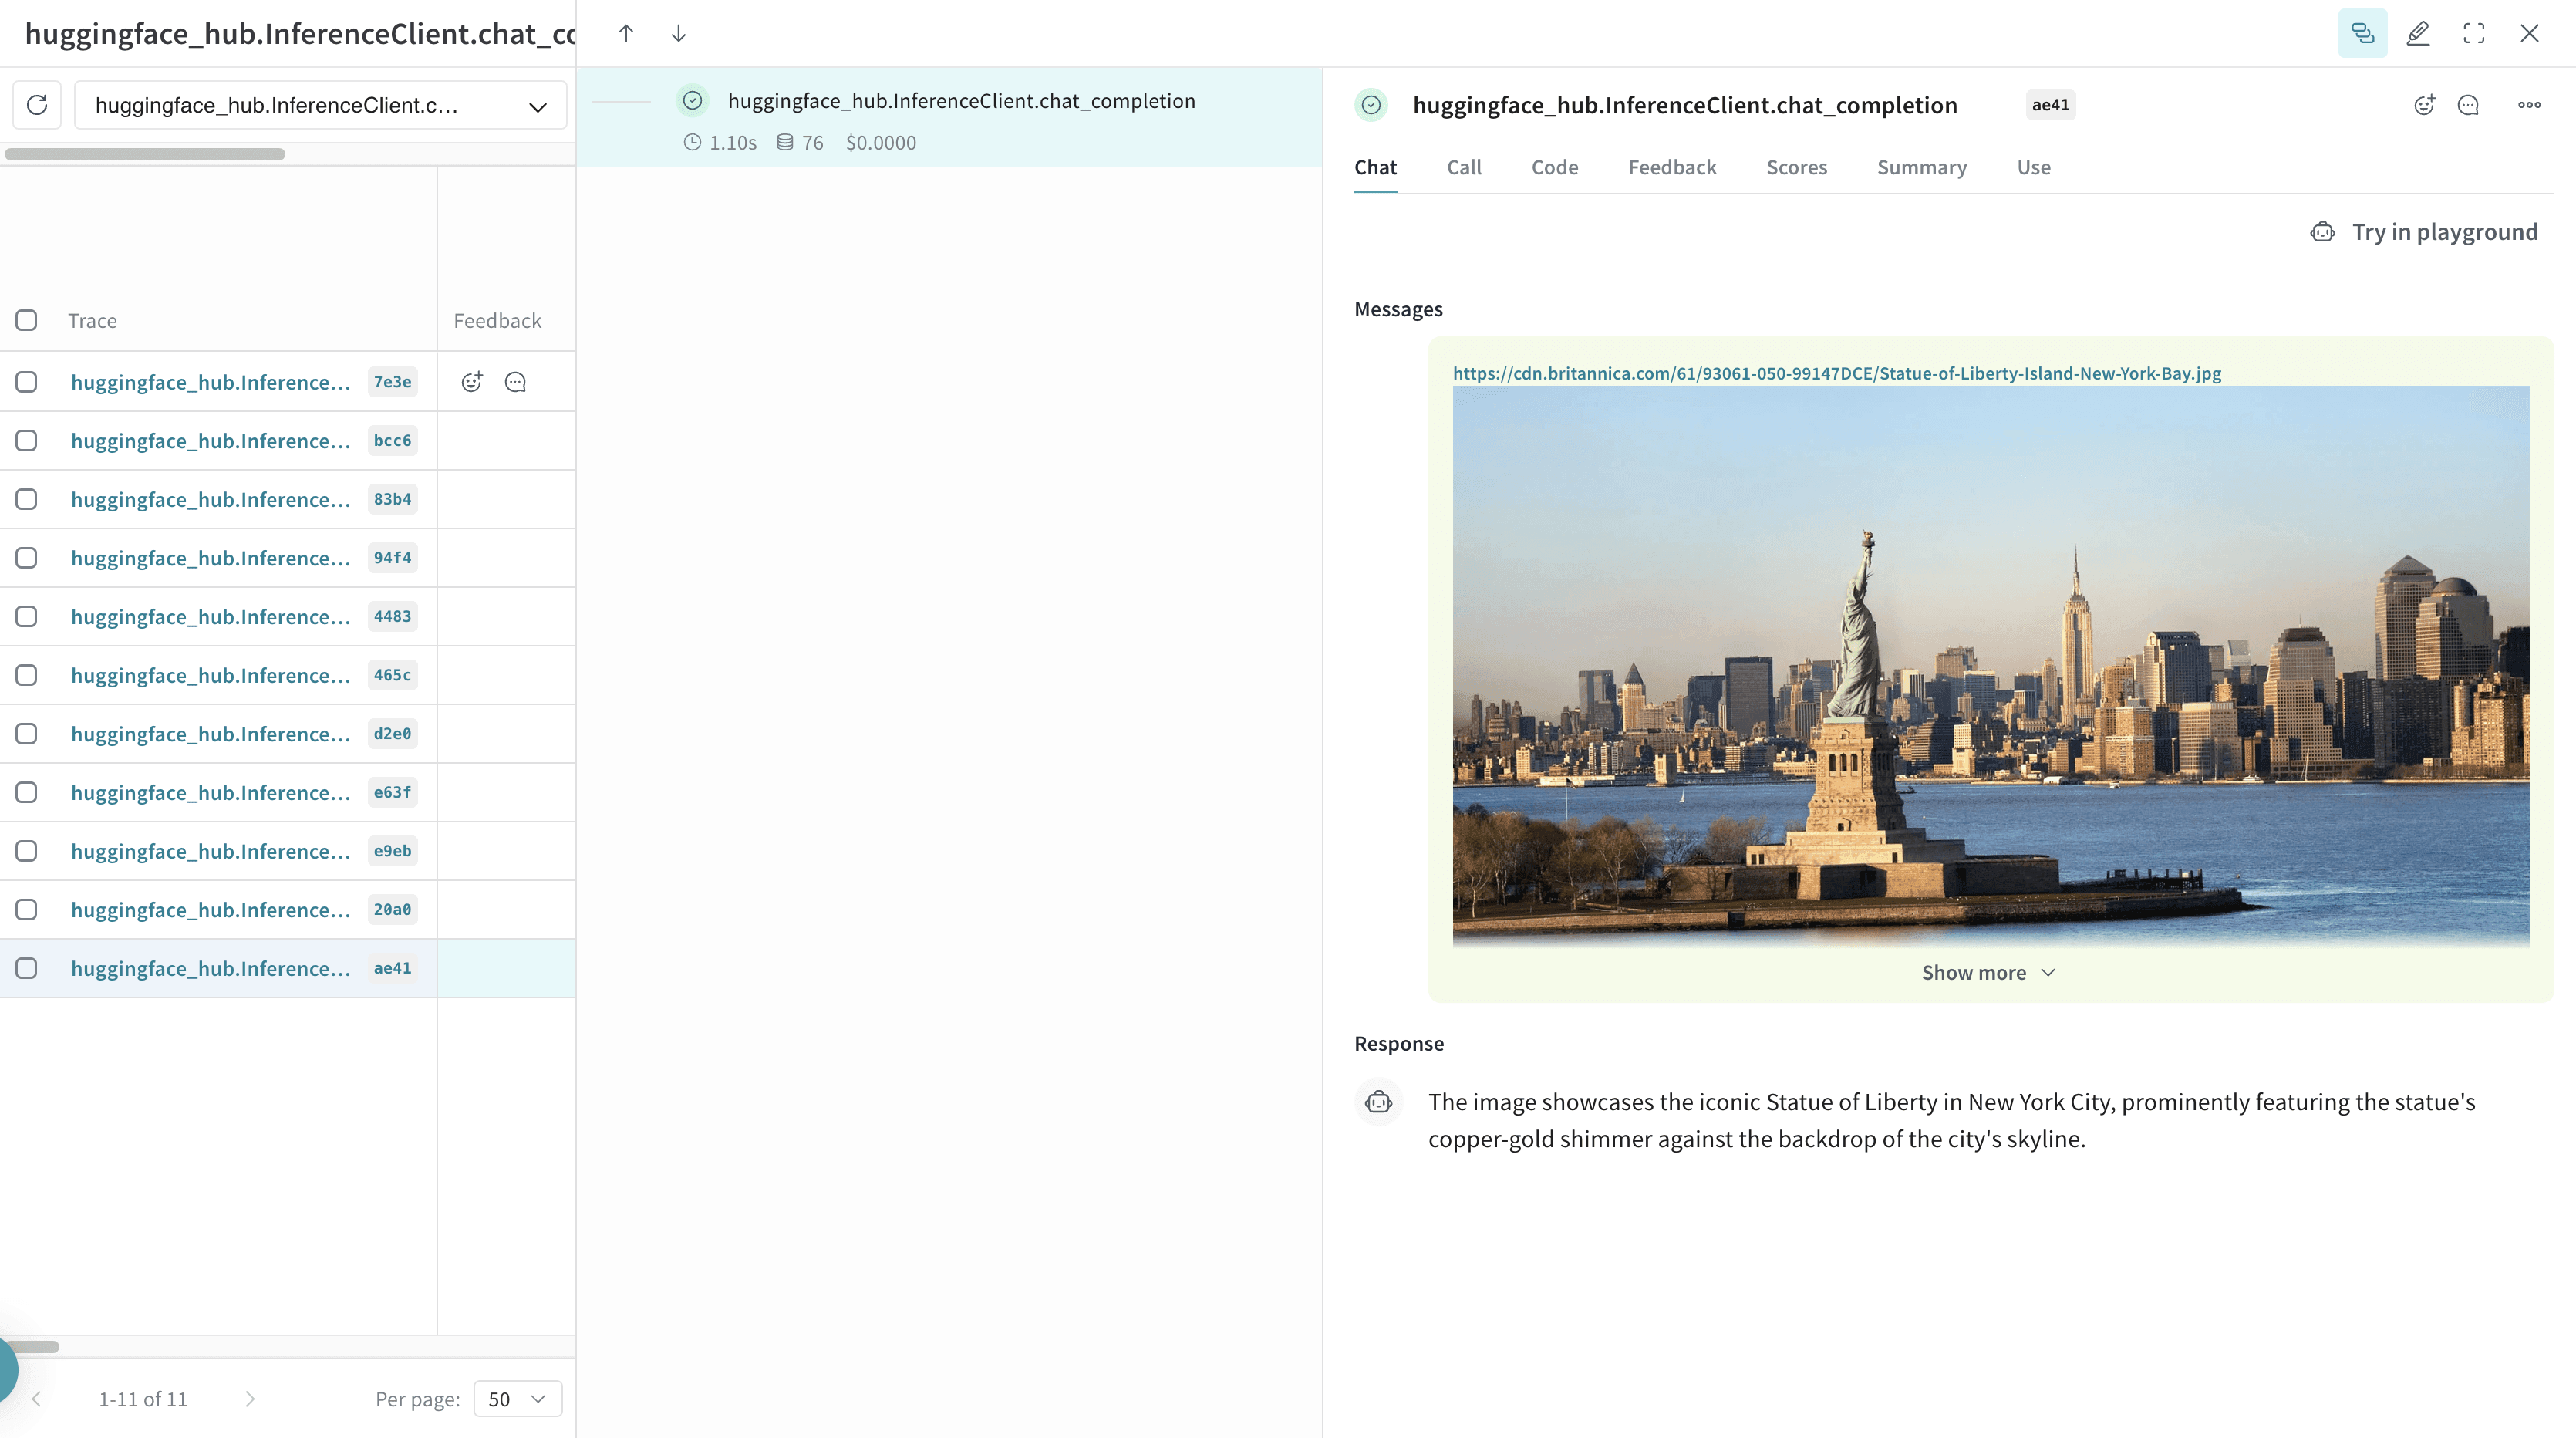 또한 Weave는 UI에서 Call을 채팅 뷰로 렌더링하여 모델과 주고받은 전체 채팅 이력을 보여 줍니다.
함수 트레이스하기
애플리케이션에서 데이터가 어떻게 흐르는지 더 깊이 파악하려면@weave.op를 사용해 함수 Call을 추적하세요. 입력, 출력, 실행 로직이 캡처되므로 디버깅과 성능 분석에 도움이 됩니다.
여러 Op를 중첩하면 추적 대상 함수들로 이루어진 구조화된 트리를 구축할 수 있습니다. 또한 Weave는 코드 버전을 자동으로 관리하므로, Git에 변경 사항을 커밋하기 전이라도 실험 중의 중간 상태가 보존됩니다.
추적을 시작하려면 추적할 함수에 @weave.op 데코레이터를 추가하세요.
다음 예시에서 Weave는 generate_image, check_image_correctness, generate_image_and_check_correctness의 세 함수를 추적합니다. 이 함수들은 이미지를 생성한 뒤, 해당 이미지가 주어진 프롬프트와 일치하는지 검증합니다.
@weave.op으로 래핑된 모든 함수 Call을 로깅하므로, Weights & Biases UI에서 실행 세부 정보를 분석할 수 있습니다.
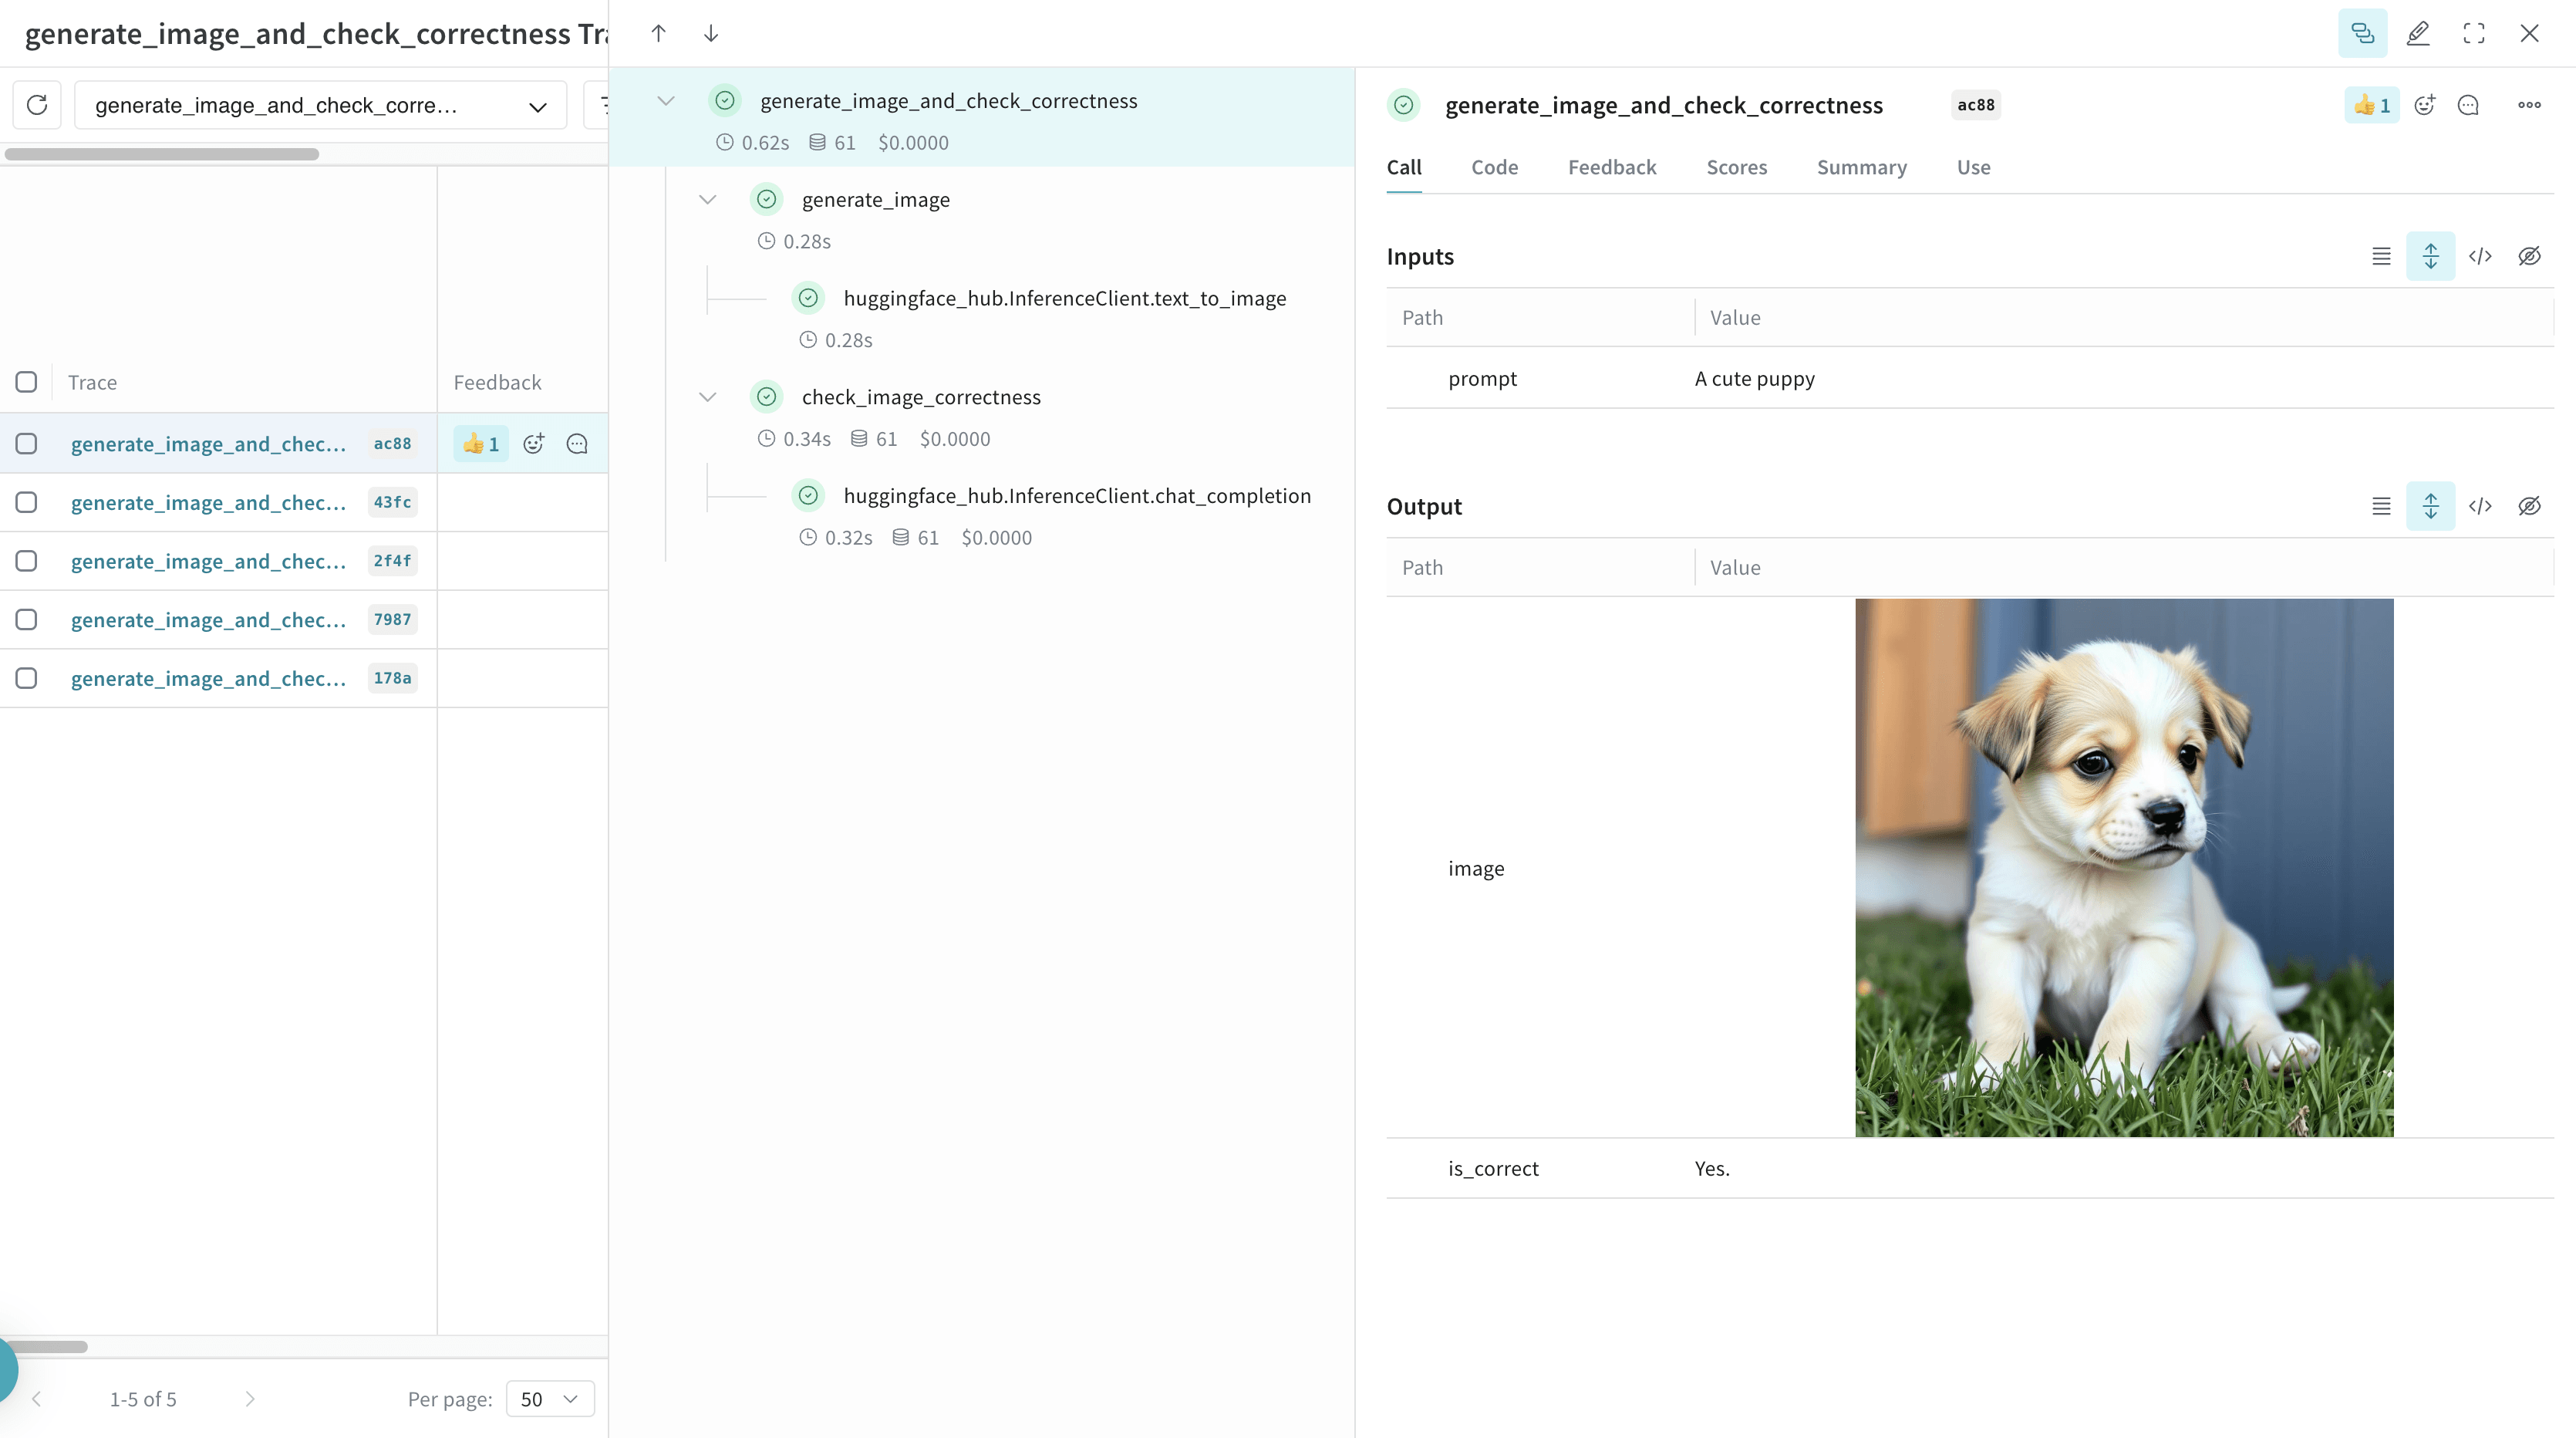 또한 Weave는 함수 실행을 캡처하고 시각화하므로 애플리케이션 내의 데이터 흐름과 로직을 쉽게 파악할 수 있습니다.
실험에 Model 사용하기
여러 컴포넌트가 얽힌 LLM 실험은 관리하기가 까다로울 수 있습니다. Weave Model 클래스를 사용하면 system 프롬프트나 모델 설정 같은 실험 세부 정보를 캡처하고 정리할 수 있어, 여러 반복 버전을 비교할 수 있습니다.
Model은 코드 버전 관리와 입력 및 출력 캡처 외에도 애플리케이션 동작을 제어하는 구조화된 매개변수를 저장합니다. 덕분에 어떤 설정이 가장 좋은 결과를 냈는지 추적할 수 있습니다. 또한 Weave Model을 Weave Serve 및 Evaluations와 통합하면 더 깊은 인사이트를 얻을 수 있습니다.
다음 예시는 여행지를 추천하는 CityVisitRecommender 모델을 정의합니다. 매개변수를 수정할 때마다 새 버전이 생성되므로 반복적으로 실험할 수 있습니다.