

이 문서는 대화형 노트북입니다. 로컬에서 실행하거나 아래 링크를 사용하세요.
- 정규 표현식: PII 데이터를 파악하고 마스킹합니다.
- Microsoft의 Presidio: Python 기반 데이터 보호 SDK로, 마스킹 및 대체 기능을 제공합니다.
- Faker: 가짜 데이터를 생성하는 Python 라이브러리로, Presidio와 함께 사용하여 PII 데이터를 익명화합니다.
weave.op 입력/출력 로깅 사용자 지정 과 autopatch_settings 를 사용하여 PII 마스킹 및 익명화를 워크플로에 통합하는 방법도 알아봅니다. 자세한 내용은 로깅되는 입력 및 출력 사용자 지정하기를 참조하세요.
시작하려면 다음 단계를 따르세요.
- 개요 섹션을 살펴보세요.
- 사전 요구 사항을 완료하세요.
- PII 데이터를 파악, 마스킹, 익명화하는 데 사용 가능한 방법을 살펴보세요.
- Weave Call에 방법을 적용하세요.
개요
이 섹션에서는weave.op를 사용한 입력 및 출력 로깅을 개괄적으로 소개하고, Weave에서 PII 데이터를 다룰 때의 모범 사례를 설명합니다.
weave.op를 사용하여 입력 및 출력 로깅 사용자 지정하기
Weave Op에서는 입력 및 출력 후처리 함수를 정의할 수 있습니다. 이 함수를 사용하면 LLM Call에 전달되거나 Weave에 로깅되는 데이터를 수정할 수 있습니다.
다음 예시에서는 후처리 함수 두 개를 정의하고 weave.op()에 인수로 전달합니다.
PII 데이터에 Weave를 사용할 때의 모범 사례
PII 데이터에 Weave를 사용하기 전에 다음 모범 사례를 확인하세요. 모범 사례는 개발 라이프사이클 단계별로 정리되어 있으며, 암호화에 관한 추가 지침도 함께 제공합니다.테스트 단계
- 익명화된 데이터를 로깅하여 PII 탐지가 제대로 되는지 확인하세요.
- Weave Traces로 PII 처리 과정을 추적하세요.
- 실제 PII를 노출하지 않고 익명화 성능을 측정하세요.
프로덕션 환경에서
- 원시 PII는 절대 로깅하지 마세요.
- 민감한 필드는 로깅하기 전에 암호화하세요.
암호화 팁
- 나중에 복호화해야 하는 데이터에는 가역 암호화를 사용하세요.
- 원래 값으로 되돌릴 필요가 없는 고유 ID에는 단방향 해싱을 적용하세요.
- 암호화된 상태에서 분석해야 하는 데이터에는 특수 암호화 방식을 사용하는 것을 고려하세요.
사전 요구 사항
마스킹 방법을 적용하기 전에 다음 설정 단계를 완료하세요. 이 단계에서는 의존성을 설치하고, API 키를 설정하고, Weave 프로젝트를 초기화한 다음, 샘플 데이터를 로드합니다.- 먼저 필요한 패키지를 설치하세요.
- 다음 위치에서 API 키를 생성하세요.
- Weave 프로젝트를 초기화하세요.
- 텍스트 블록 10개로 구성된 데모 PII 데이터셋을 로드하세요.
마스킹 방법 개요
사전 요구 사항을 완료한 후 다음 방법 중 하나를 선택해 PII 데이터를 탐지하고 보호할 수 있습니다. 각 방법은 PII를 파악해 마스킹하며, 필요에 따라 익명화할 수도 있습니다.- 정규 표현식: PII 데이터를 파악하고 마스킹합니다.
- Microsoft Presidio: 마스킹 및 대체 기능을 제공하는 Python 기반 데이터 보호 SDK입니다.
- Faker: 가짜 데이터를 생성하는 Python 라이브러리입니다.
방법 1: 정규 표현식을 사용한 필터링
정규 표현식(정규식)은 PII 데이터를 파악하고 마스킹하는(마스킹하다) 간단한 방법입니다. 정규식을 사용하면 전화번호, 이메일 주소, 사회 보장 번호 등 다양한 형식의 민감한 정보와 일치하는 패턴을 정의할 수 있습니다. 더 복잡한 NLP 기법을 쓰지 않아도 정규식만으로 대량의 텍스트를 검사하고 해당 정보를 대체하거나 마스킹할 수 있습니다.방법 2: Microsoft Presidio를 사용한 마스킹
다음 방법은 Microsoft Presidio를 사용하여 PII 데이터를 완전히 제거하는 것입니다. Presidio는 PII를 마스킹하여 해당 PII 유형을 나타내는 자리 표시자로 대체합니다. 예를 들어 Presidio는"My name is Alex"의 Alex를 <PERSON>으로 대체합니다.
Presidio는 일반적인 엔티티를 기본적으로 지원합니다. 다음 예시는 PHONE_NUMBER, PERSON, LOCATION, EMAIL_ADDRESS, US_SSN에 해당하는 모든 엔티티를 마스킹합니다. Presidio 처리 과정은 하나의 함수로 캡슐화되어 있습니다.
방법 3: Faker와 Presidio로 대체하여 익명화
텍스트를 마스킹하는 대신, MS Presidio로 이름이나 전화번호 같은 PII를 Faker Python 라이브러리가 생성한 가짜 데이터로 바꿔 익명화할 수 있습니다. 예를 들어 다음과 같은 데이터가 있다고 가정해 보겠습니다."My name is Raphael and I like to fish. My phone number is 212-555-5555"
Presidio와 Faker로 데이터를 처리하면 다음과 같이 바뀔 수 있습니다.
"My name is Katherine Dixon and I like to fish. My phone number is 667.431.7379"
Presidio와 Faker를 함께 사용하려면 맞춤형 Operator에 대한 참조를 제공해야 합니다. 이 Operator는 Presidio가 PII를 가짜 데이터로 바꾸는 Faker 함수를 호출하도록 연결해 줍니다.
방법 4: autopatch_settings 사용하기
autopatch_settings를 사용하면 지원되는 LLM 인테그레이션 중 하나 이상에 대해 초기화 시점에 PII 처리를 직접 설정할 수 있습니다. 특정 인테그레이션의 모든 Call에 대해 PII 처리를 한곳에서 관리하려면 이 방법을 사용하는 것이 좋습니다. 이 방법의 장점은 다음과 같습니다.
- PII 처리 로직이 초기화 시점에 한곳에 모이고 적용 범위가 정해지므로, 여러 곳에 맞춤형 로직을 흩어 둘 필요가 줄어듭니다.
- 특정 인테그레이션에 대해 PII 처리 워크플로를 사용자 지정하거나 완전히 비활성화할 수 있습니다.
autopatch_settings로 PII 처리를 설정하려면 지원되는 LLM 인테그레이션 중 하나의 op_settings에 postprocess_inputs 또는 postprocess_output을 정의하세요.
Weave Call에 방법 적용하기
지금까지 각 마스킹 방법을 개별적으로 살펴보았습니다. 다음 예시에서는 이러한 방법을 Weave 모델에 통합하고 Weave Traces에서 결과를 미리 확인하는 방법을 보여 줍니다. 먼저 Weave 모델을 생성하세요. Weave 모델은 설정 값, 모델 가중치, 모델의 동작 방식을 정의하는 코드 등의 정보를 하나로 묶은 것입니다. 이 모델에는 Anthropic API를 호출하는 predict 함수가 포함되어 있습니다. Anthropic의 Claude Sonnet이 감성 분석을 수행하고, Traces로 LLM Call을 트레이싱합니다. Claude Sonnet은 텍스트 블록을 입력받아 positive, negative, neutral 중 하나의 감성 분류를 출력합니다. 또한 이 모델에는 PII 데이터를 LLM으로 전송하기 전에 마스킹하거나 익명화하는 후처리 함수도 포함되어 있습니다. 이 코드를 실행하면 Weave 프로젝트 페이지와 방금 실행한 트레이스(LLM Call)로 연결되는 링크가 제공됩니다. 이 링크에서 입력이 LLM에 전달되기 전에 후처리 함수가 예상대로 마스킹 또는 익명화했는지 확인하세요.정규식 방법
먼저 정규식(정규식)을 사용하여 원본 텍스트에서 PII 데이터를 파악하고 마스킹할 수 있습니다.Presidio 마스킹 방법
다음으로 Presidio를 사용해 원본 텍스트에서 PII 데이터를 파악하고 마스킹하세요.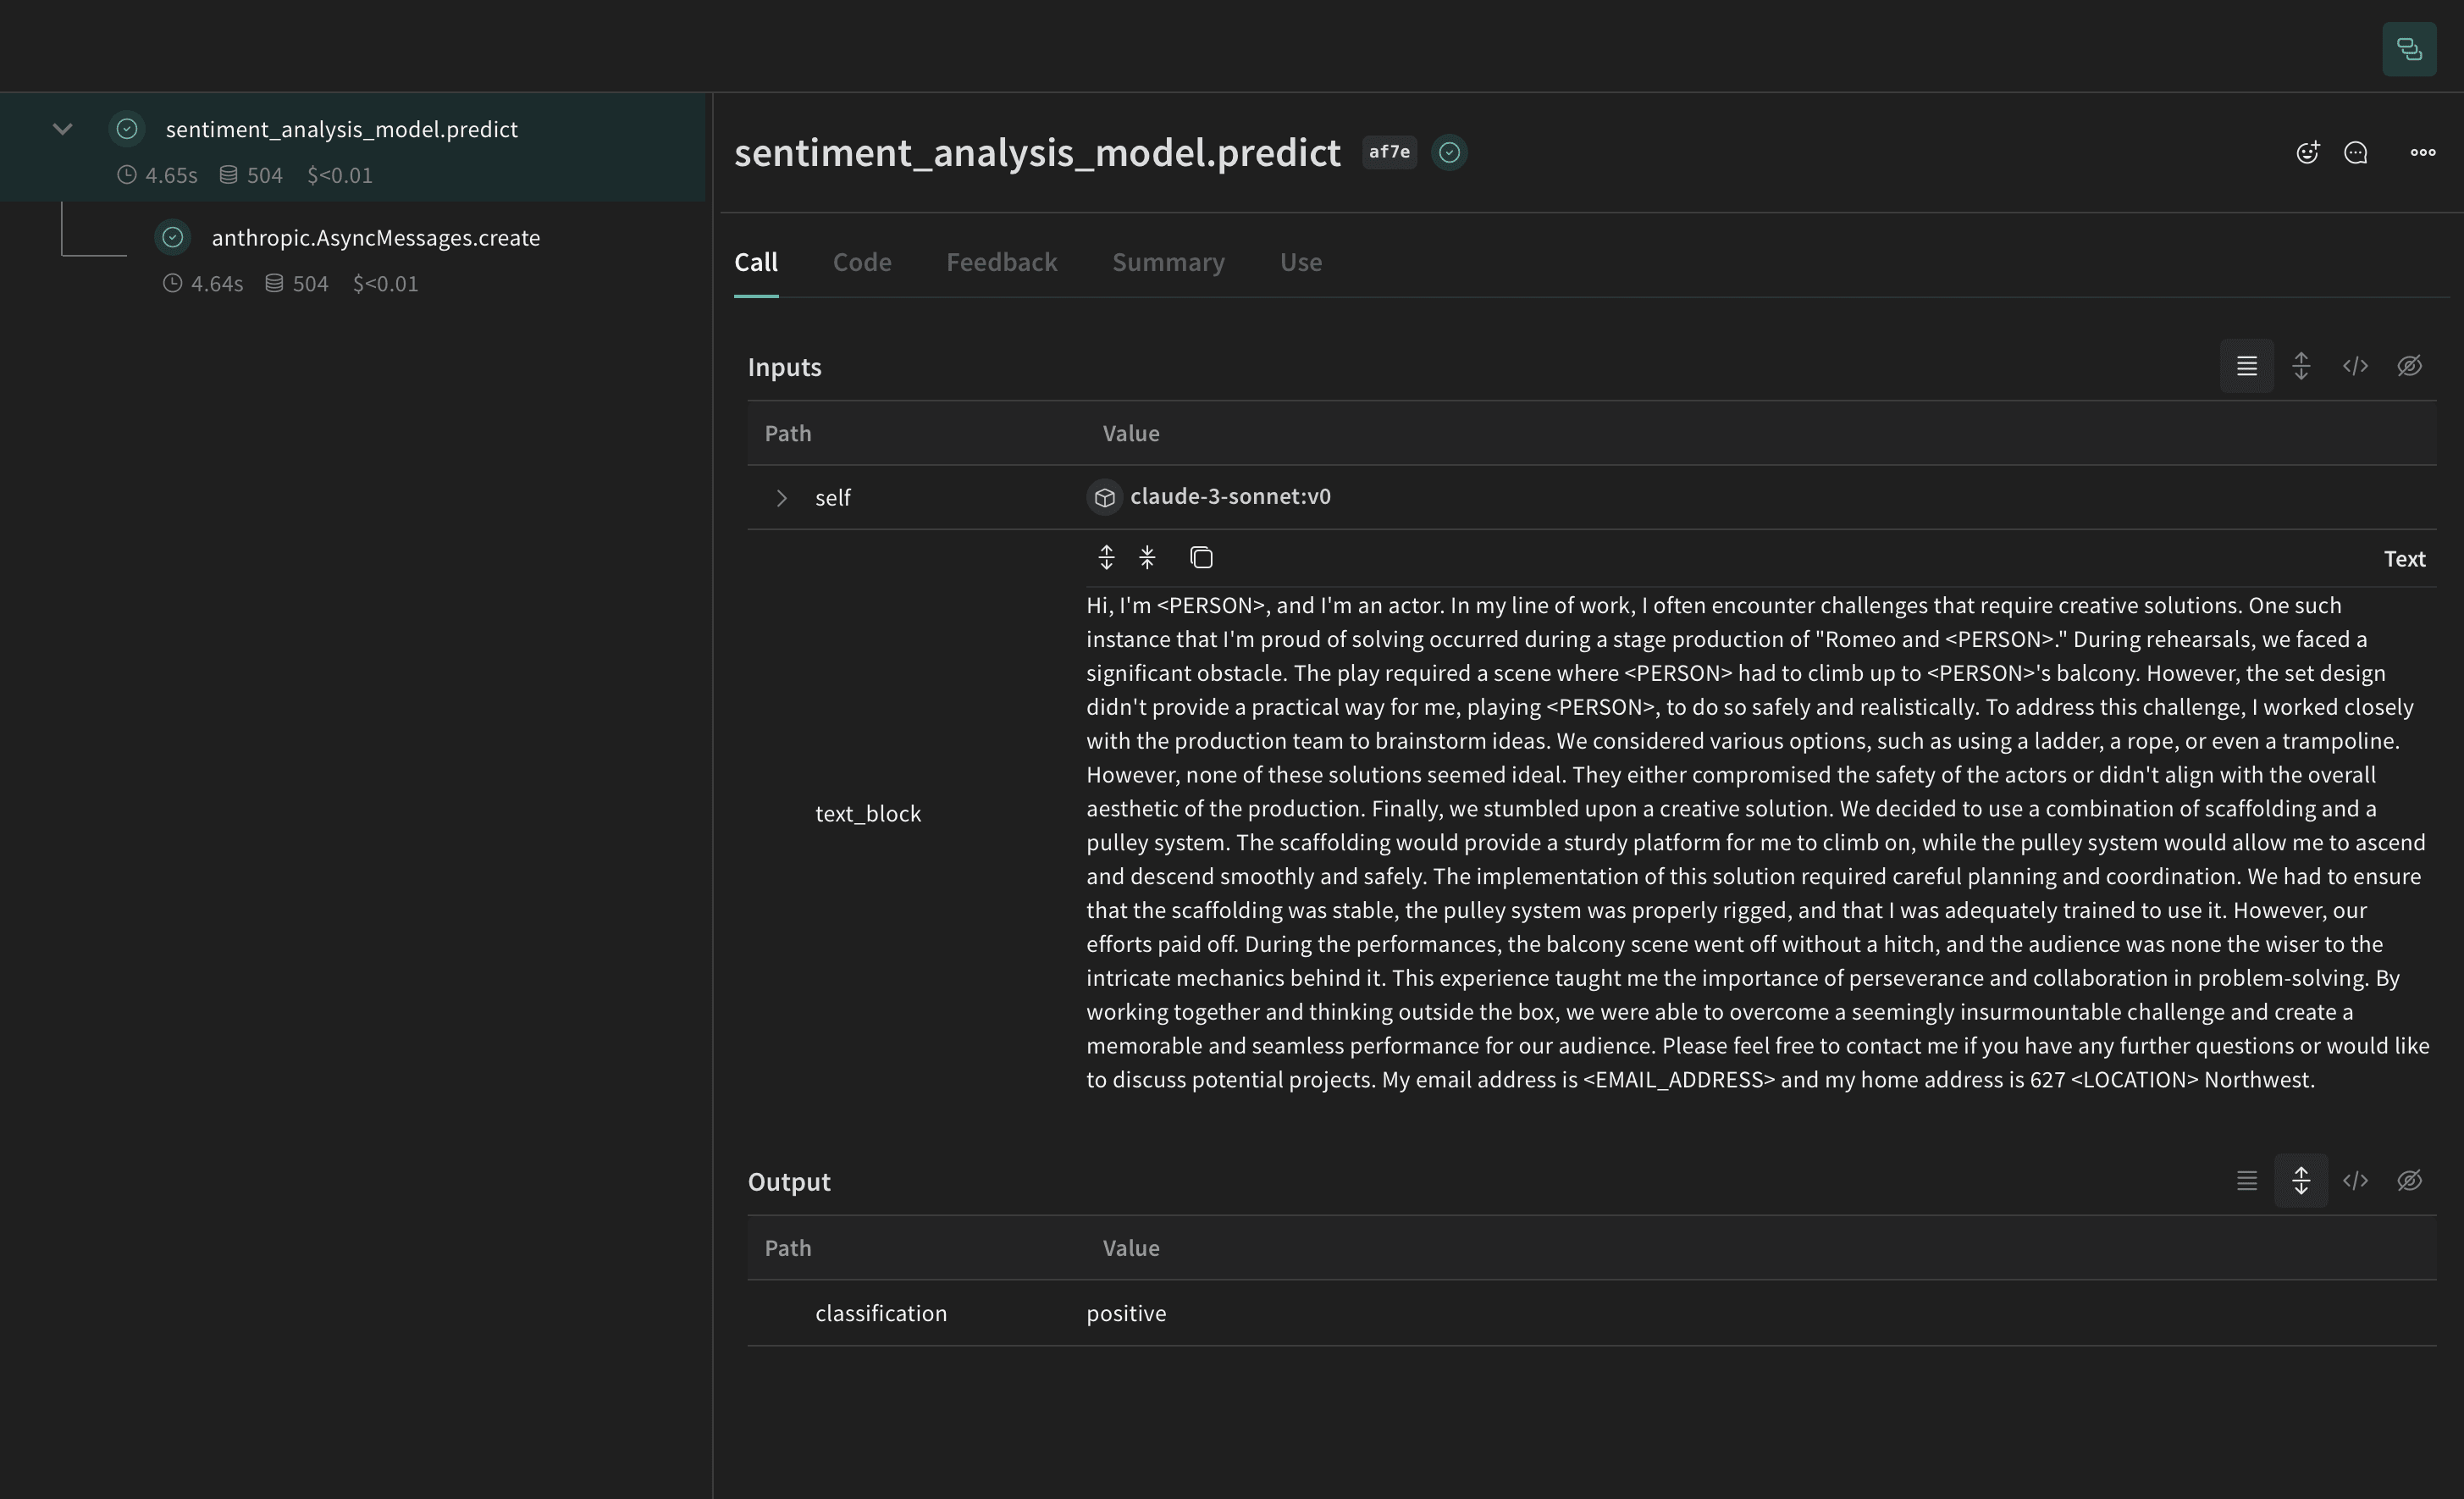
Faker 및 Presidio 대체 방법
이 예제에서는 Faker로 익명화된 대체 PII 데이터를 생성하고, Presidio로 원본 텍스트의 PII 데이터를 파악해 대체합니다.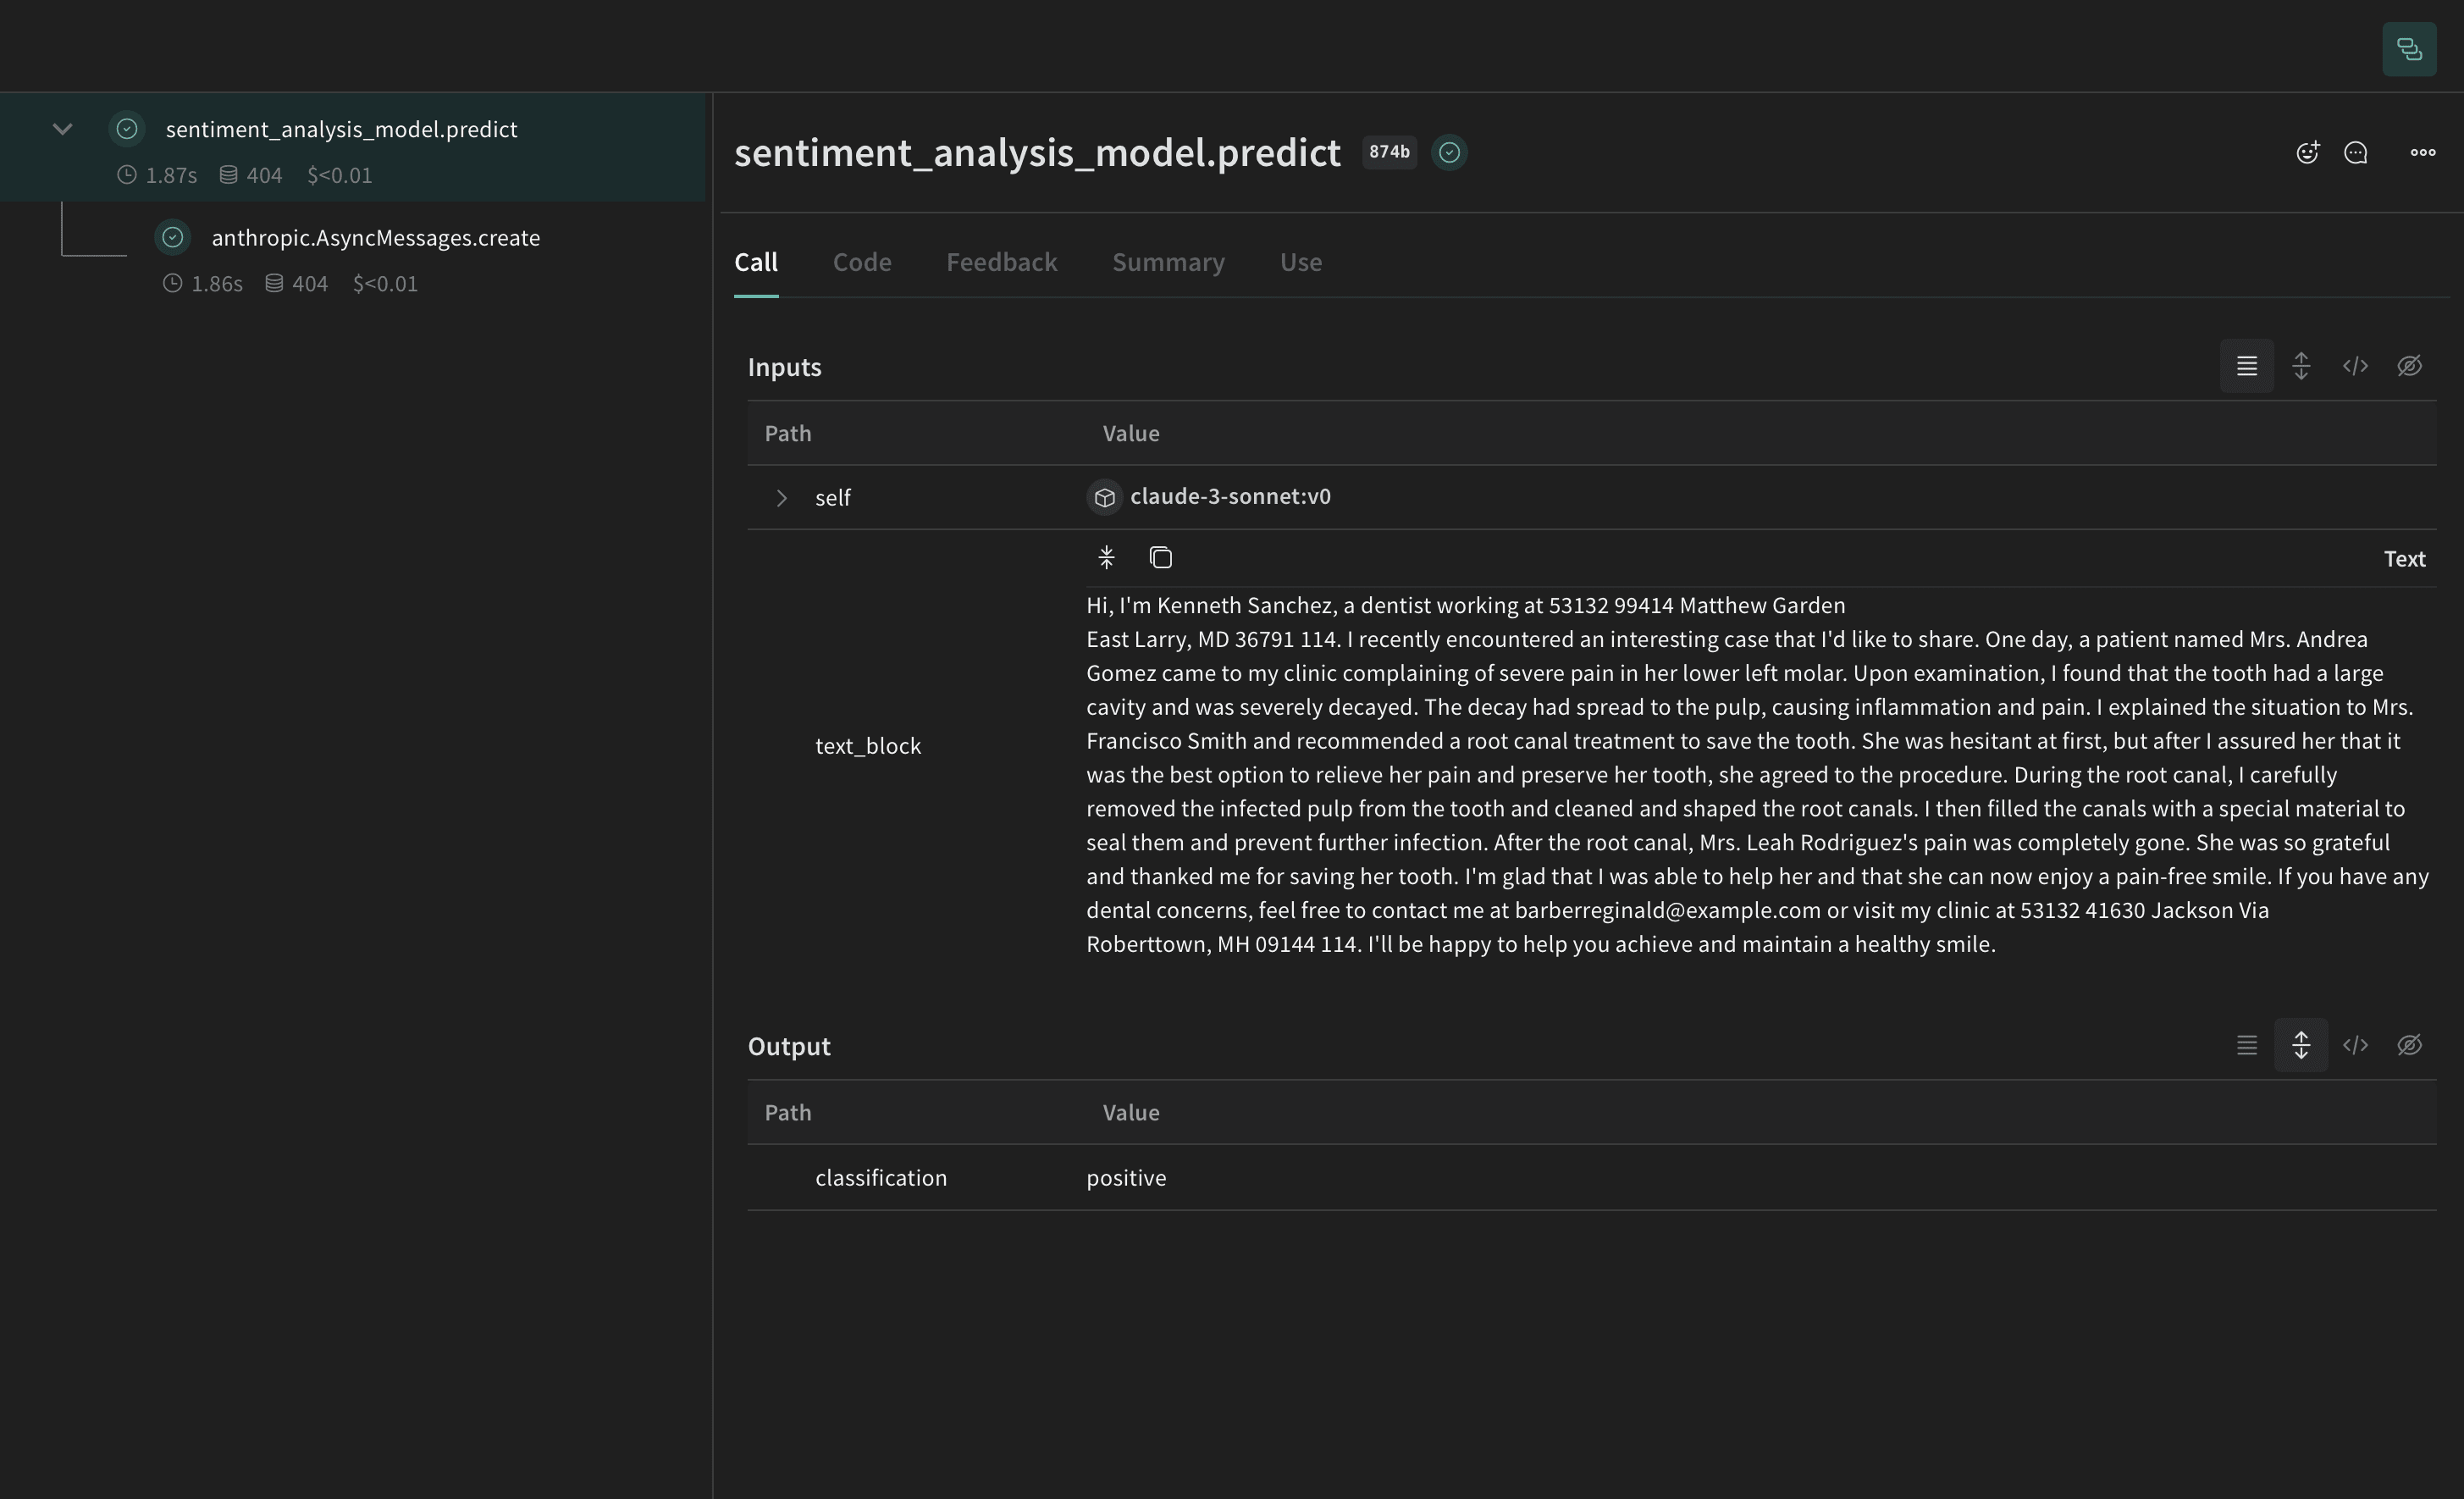
autopatch_settings 방법
다음 예시에서는 초기화 시 anthropic의 postprocess_inputs를 postprocess_inputs_regex() 함수로 설정합니다. postprocess_inputs_regex 함수는 방법 1: 정규 표현식을 사용한 필터링에서 정의한 redact_with_regex 방법을 적용합니다. 따라서 모든 anthropic 모델의 입력에 redact_with_regex가 적용됩니다.
선택 사항: 데이터 암호화
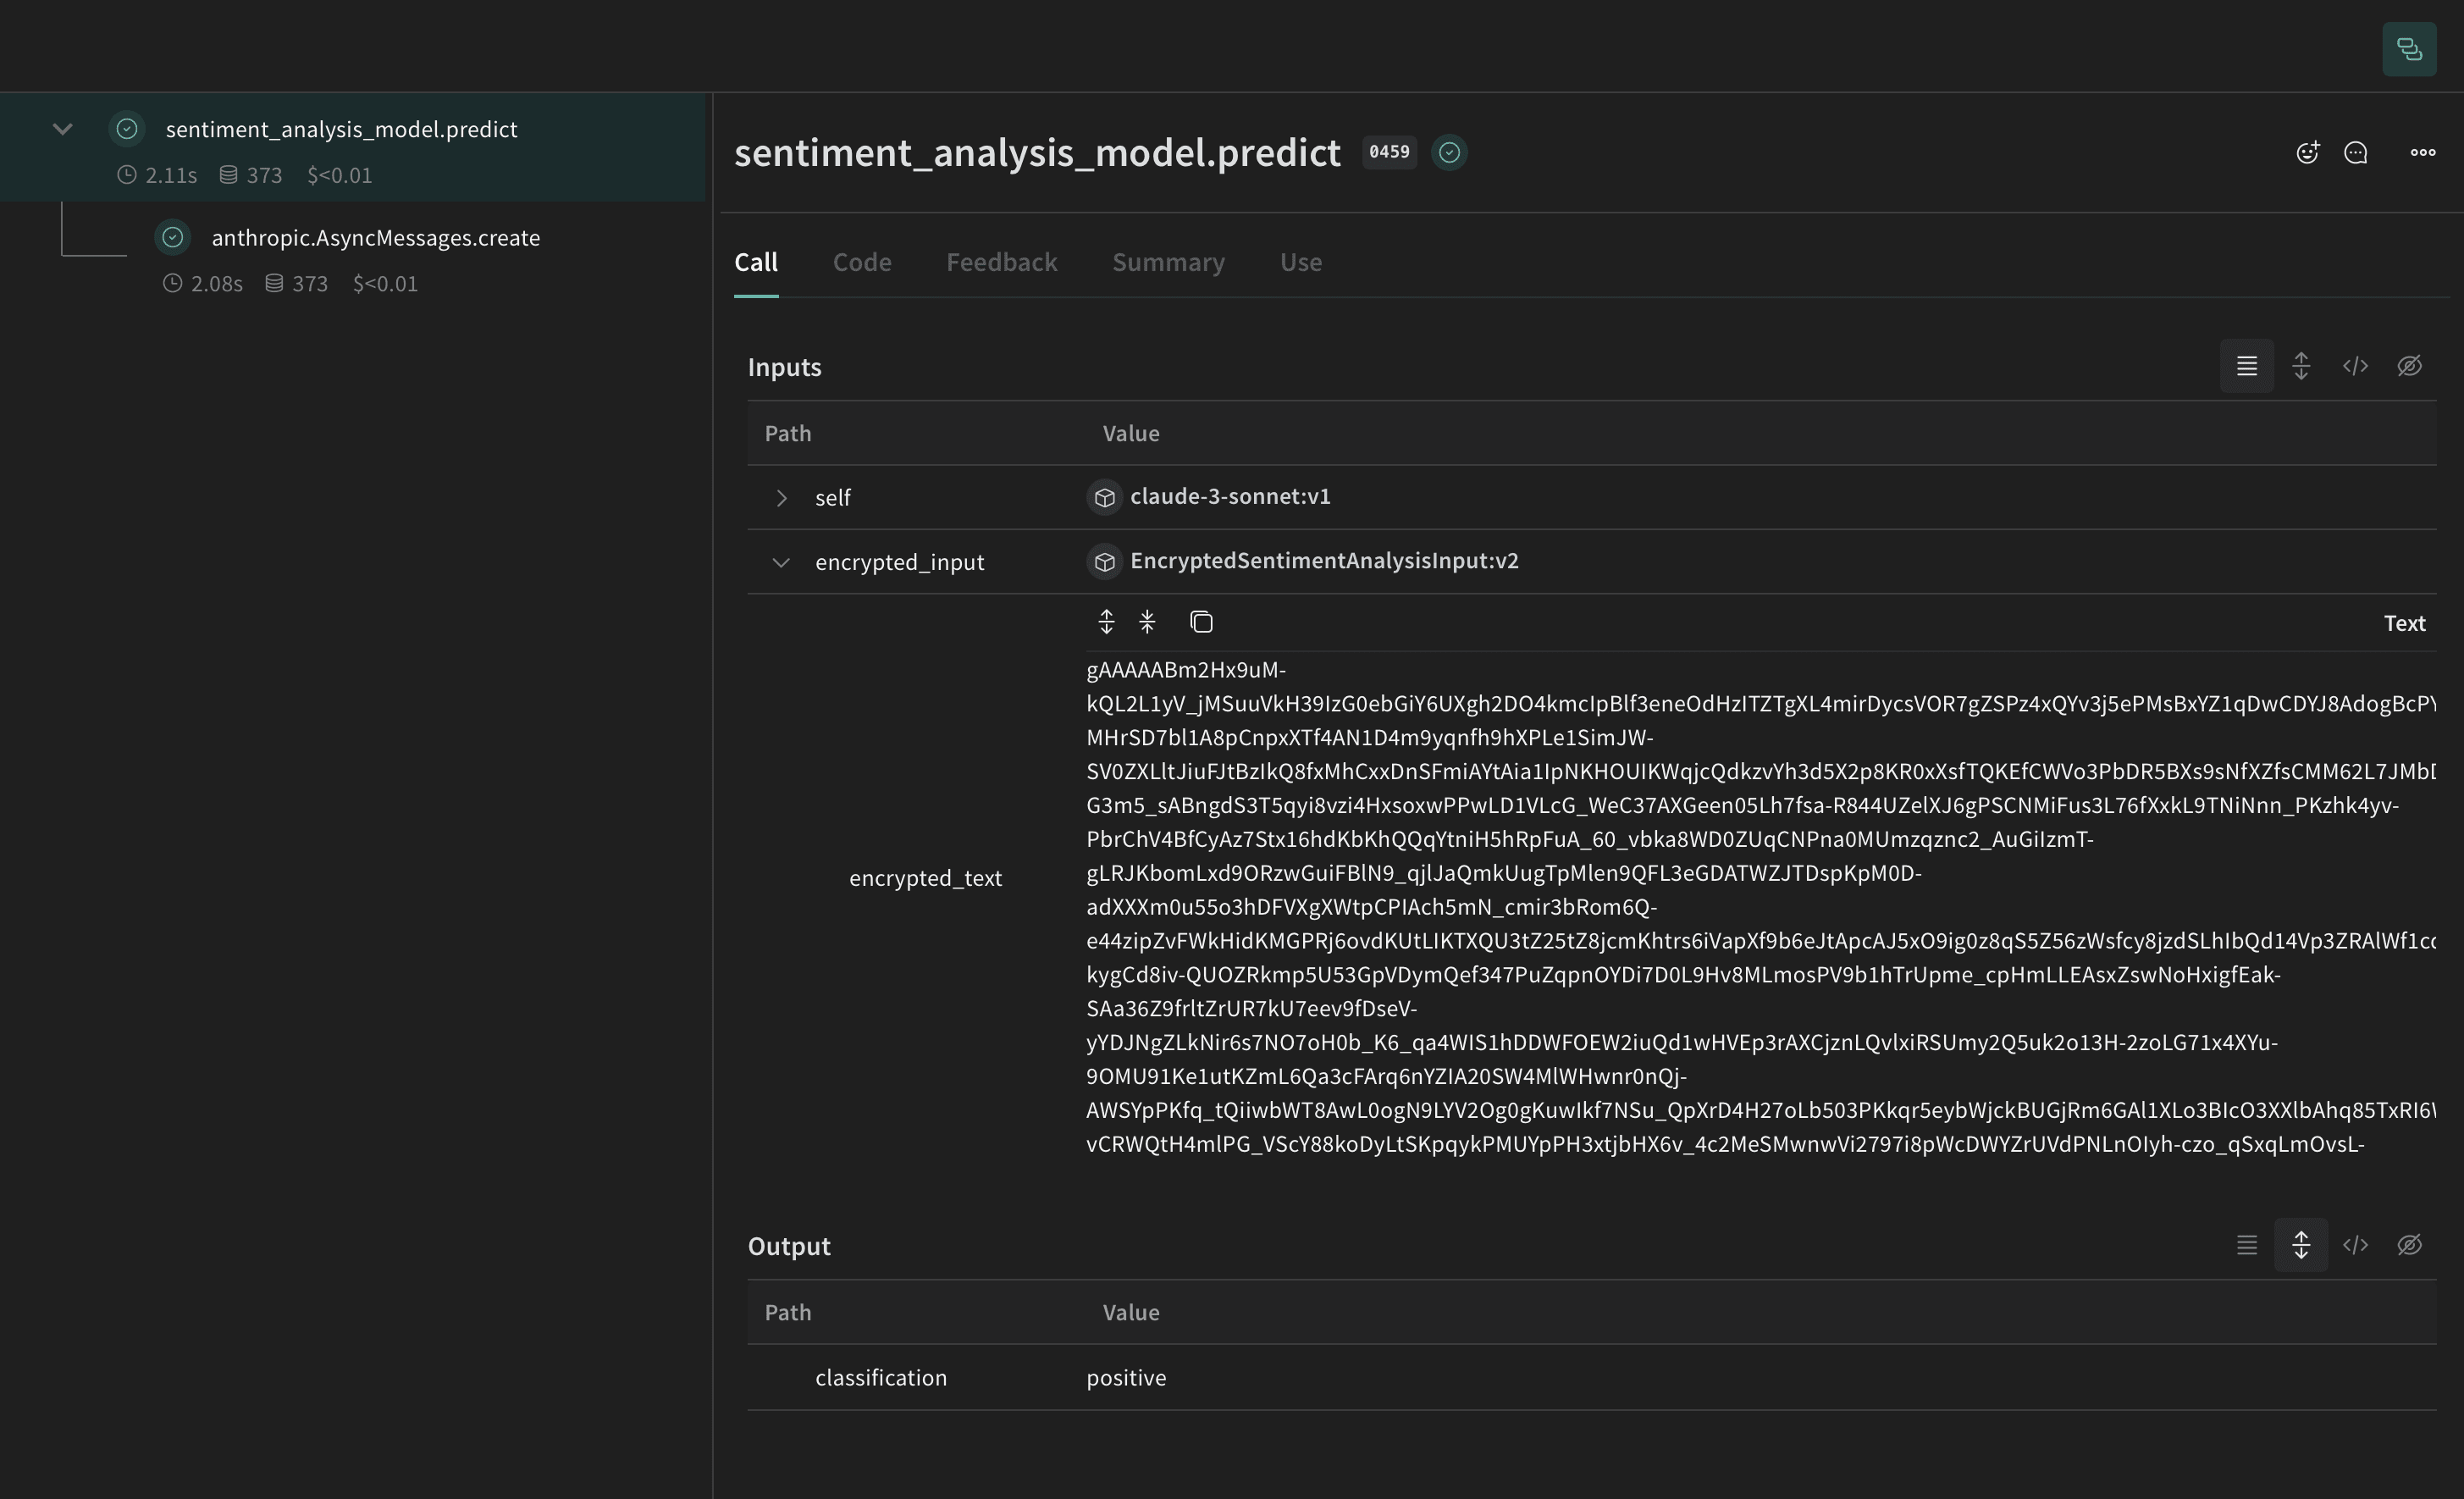
predict 메서드 안에서 복호화하는 방법을 보여줍니다.