

이 문서는 대화형 노트북입니다. 로컬에서 실행하거나 다음 링크를 이용하세요.
Weave를 사용하는 이유
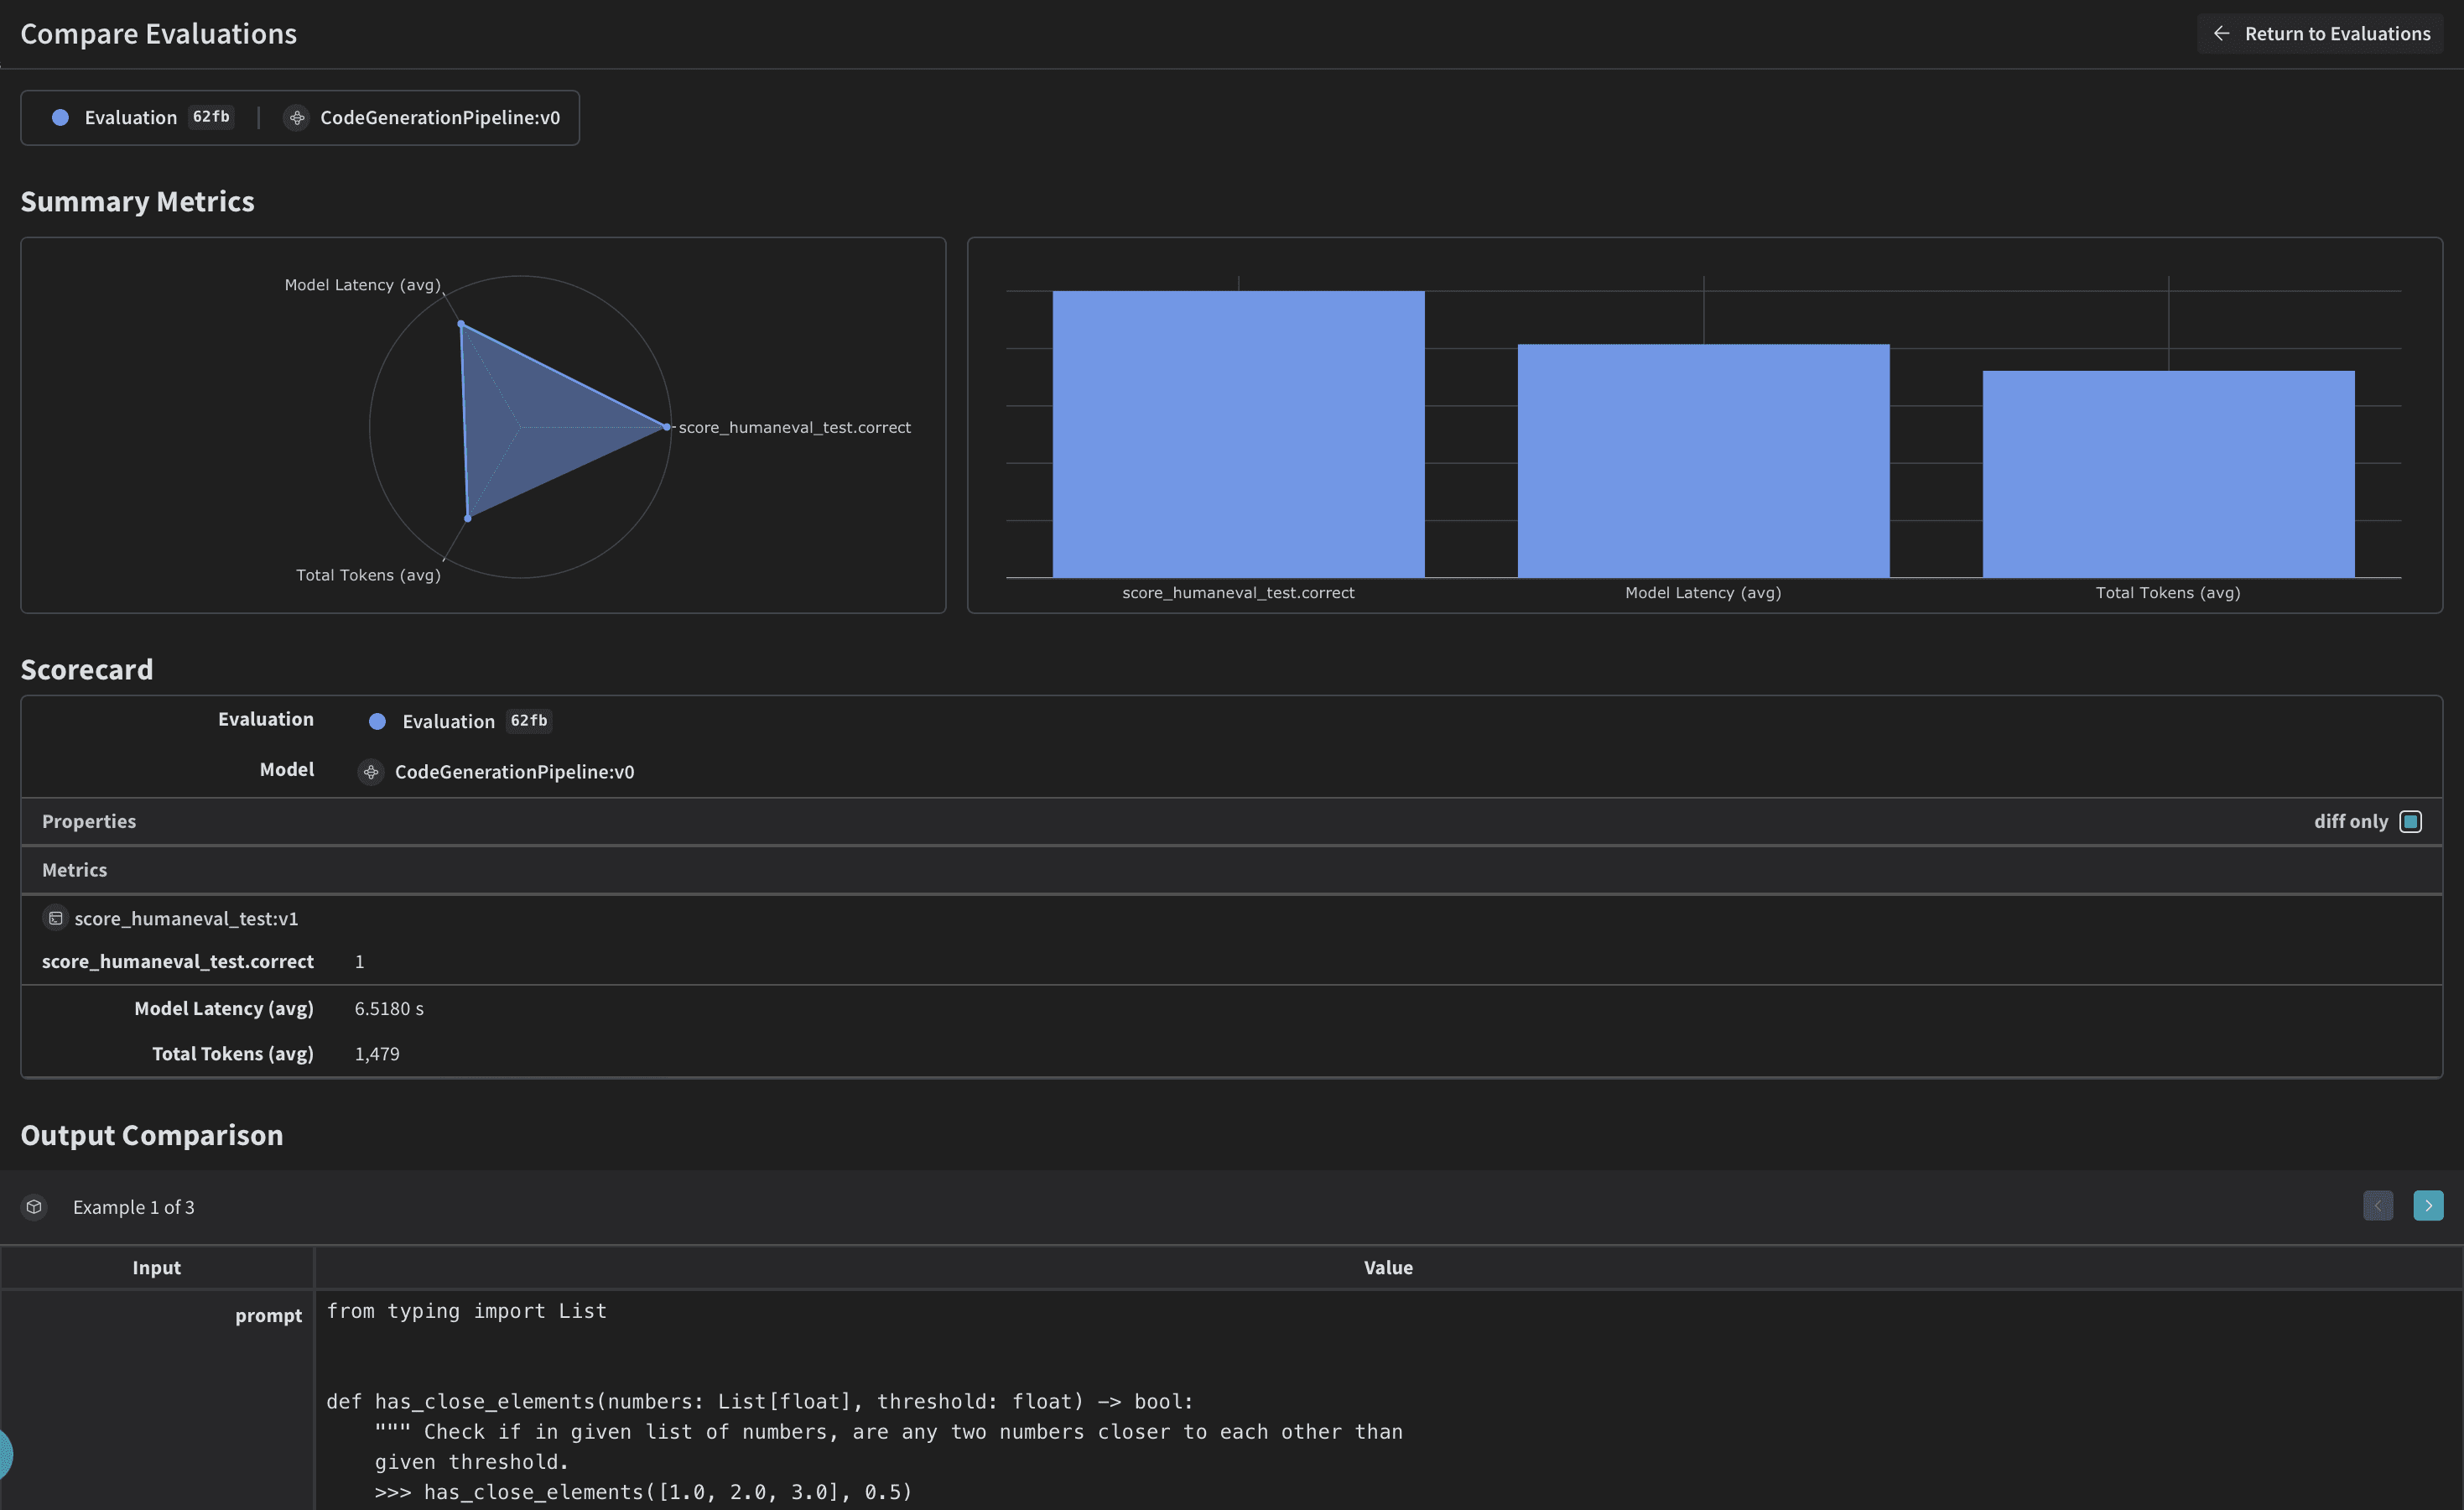
이 튜토리얼에서는 Weave를 사용하여 코드 생성 파이프라인을 구현하고 평가합니다. 이 튜토리얼에서 배울 내용은 다음과 같습니다.- LLM 파이프라인 추적: 코드 생성 프로세스의 입력, 출력, 중간 단계를 로깅합니다.
- LLM 출력 평가: 디버깅 도구와 시각화를 활용해 생성된 코드에 대한 평가를 만들고 비교합니다.
환경 설정
환경을 설정하고 필요한 라이브러리를 임포트하세요. 이러한 의존성은 파이프라인 전반에서 사용되는 서식 지정 도구, 데이터셋 로더, OpenAI 및 Weave 클라이언트를 제공합니다.Weave는 입력, 출력, 메타데이터를 포함한 OpenAI API 호출을 자동으로 추적합니다. OpenAI와의 상호작용을 로깅하기 위해 별도의 코드를 추가할 필요가 없습니다. Weave가 백그라운드에서 모두 처리합니다.
구조화된 출력과 Pydantic 모델
이 코드 생성 파이프라인은 OpenAI의 구조화된 출력 모드와 Pydantic 모델을 사용하여 언어 모델에서 일관되고 형식이 잘 갖춰진 응답을 생성합니다. 이 방식에는 다음과 같은 이점이 있습니다.- 유형 안전성: 예상 출력에 맞는 Pydantic 모델을 정의하면 생성된 코드, 프로그램 러너, 단위 테스트에 엄격한 구조가 강제 적용됩니다.
- 간편한 파싱: 구조화된 출력 모드는 모델의 응답을 사전 정의된 Pydantic 모델로 바로 파싱하므로 복잡한 후처리 작업이 줄어듭니다.
- 안정성 향상: 원하는 형식을 정확히 지정하면 언어 모델이 예기치 않은 출력이나 잘못된 형식의 출력을 생성할 가능성이 줄어듭니다.
코드 포매터 구현하기
일관되고 깔끔한 코드를 출력하려면 Weave 오퍼레이션을 사용해CodeFormatter 클래스를 구현하세요. 이 포매터는 생성된 코드, 프로그램 러너, 단위 테스트에 린팅 및 스타일 규칙을 적용합니다.
CodeFormatter 클래스는 생성된 코드를 정리하고 포맷팅하는 여러 Weave 오퍼레이션을 제공합니다.
- 이스케이프된 줄바꿈 문자를 실제 줄바꿈으로 바꿉니다.
- 사용하지 않는 임포트와 변수를 제거합니다.
- 임포트를 정렬합니다.
- PEP 8 포맷팅을 적용합니다.
- 누락된 임포트를 추가합니다.
CodeGenerationPipeline 정의하기
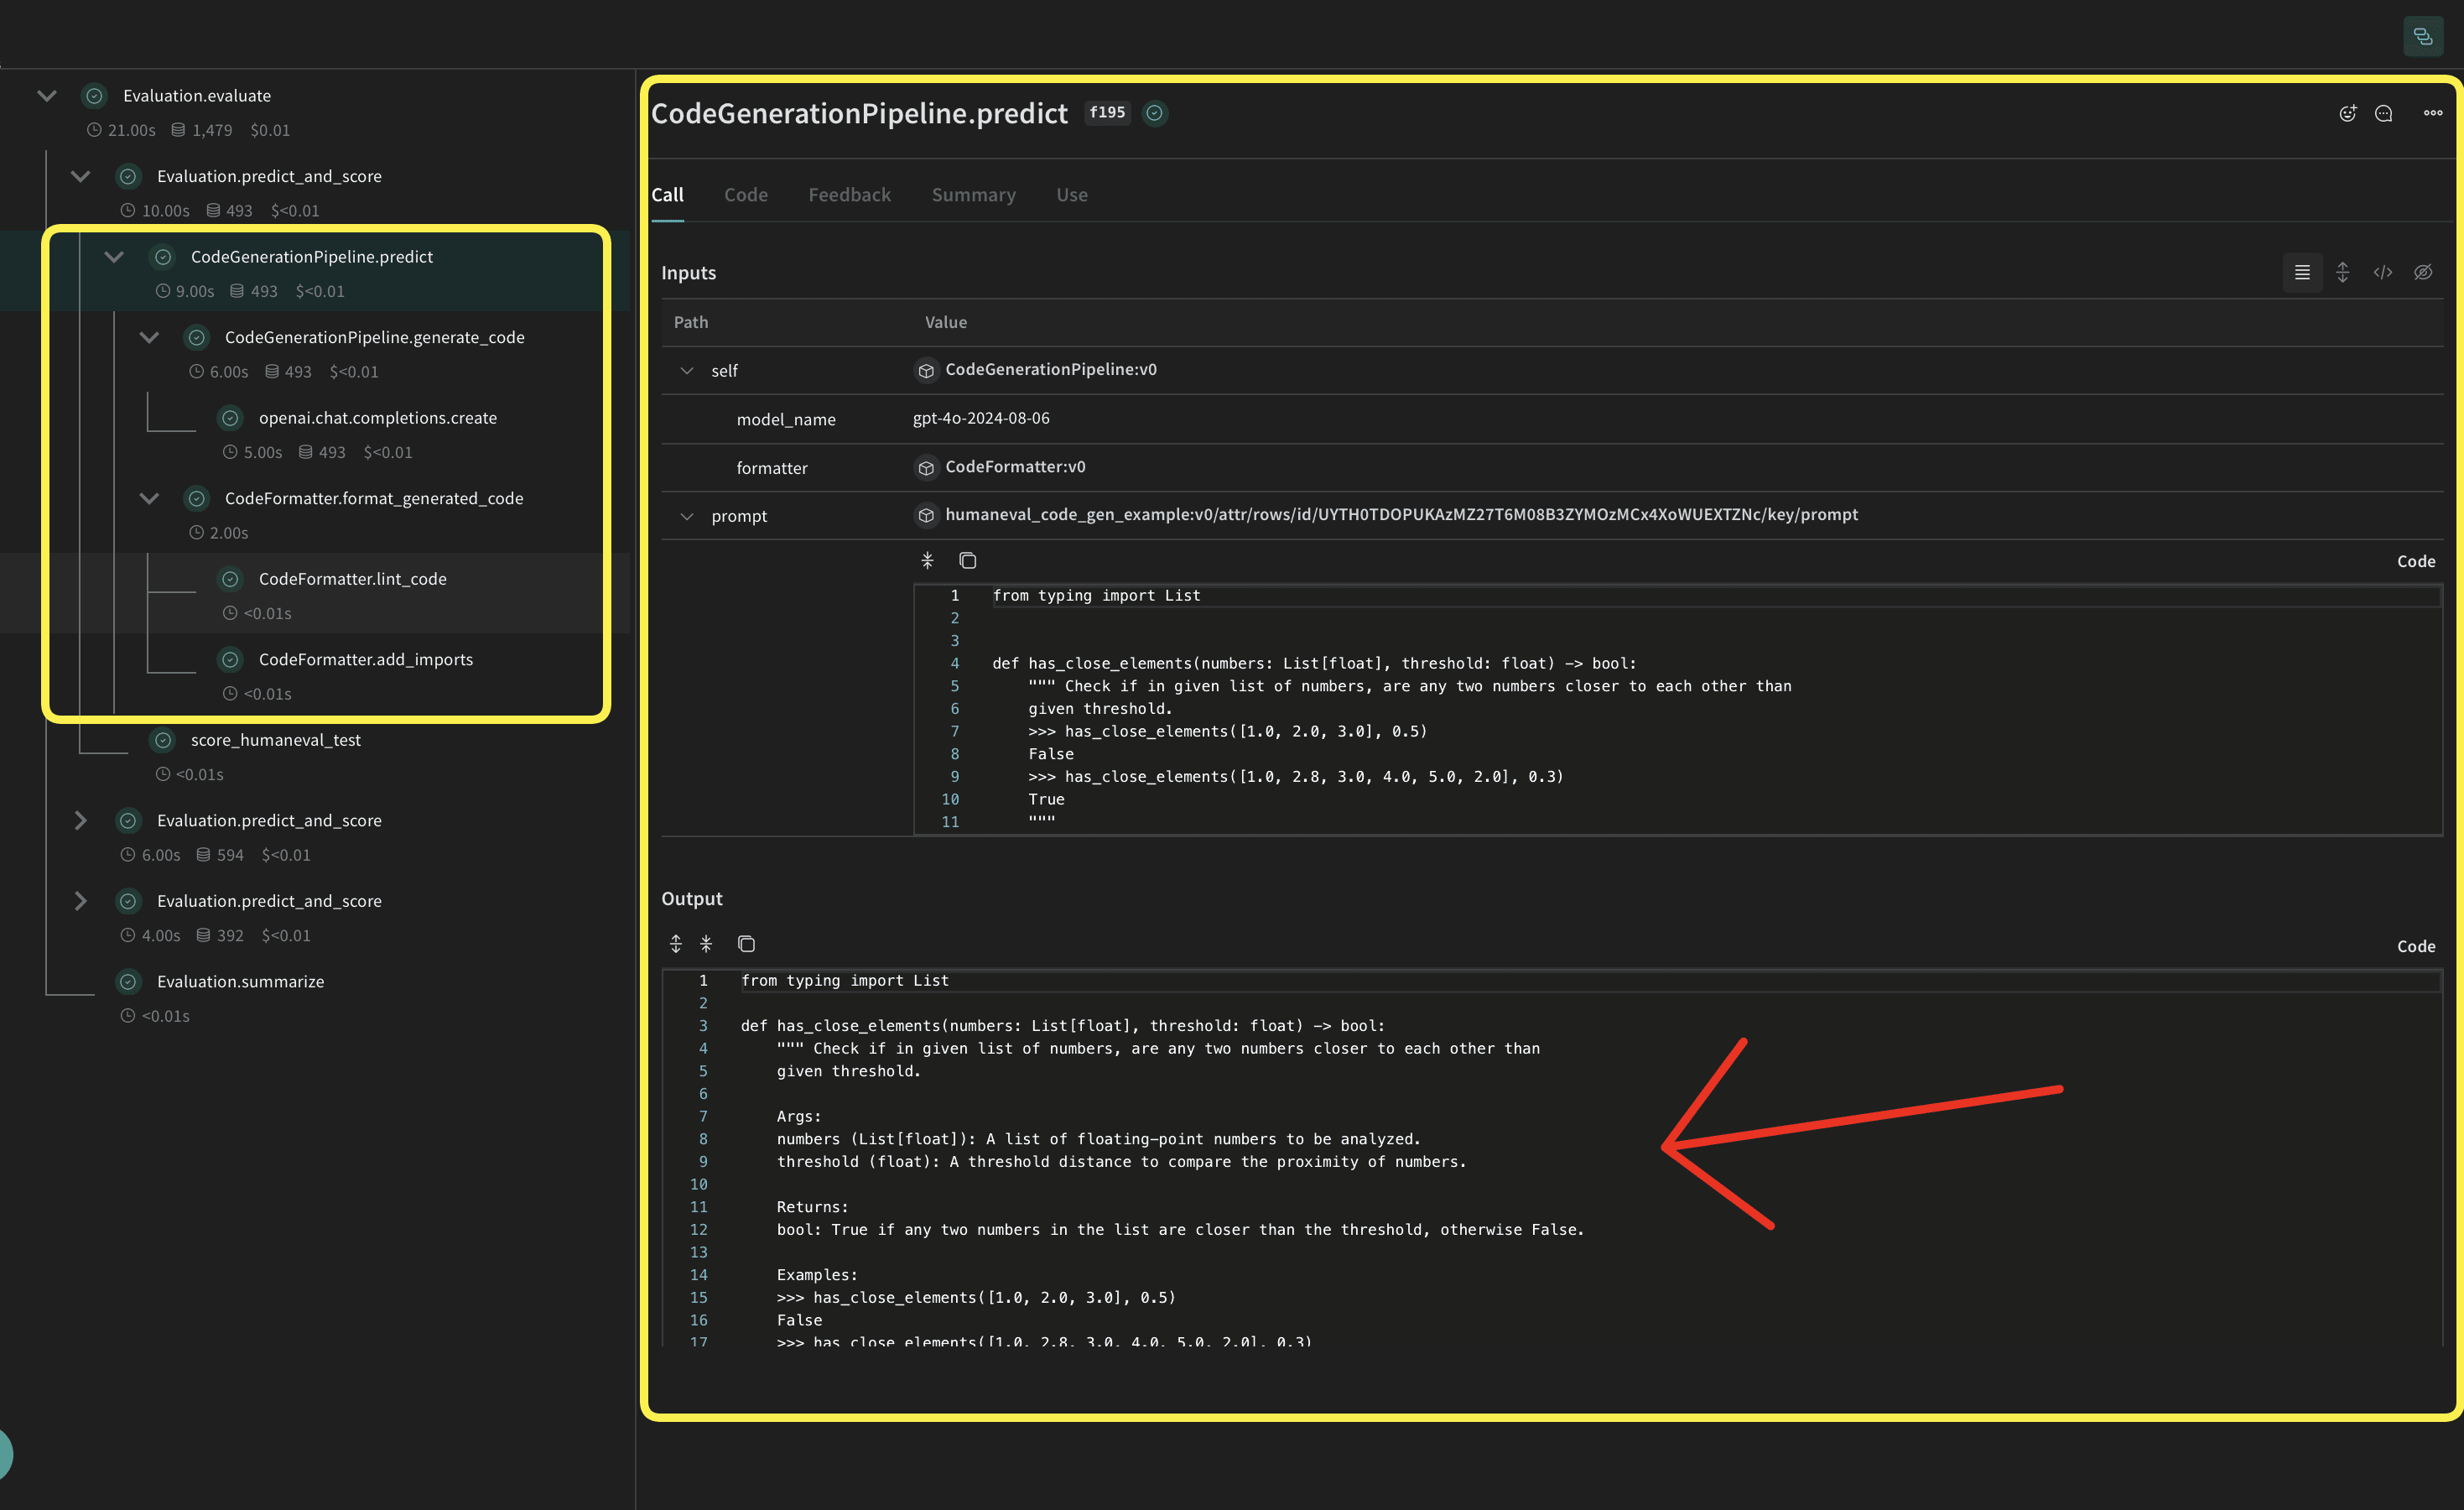
weave.Model을 사용하므로 모델이 변경될 때마다 버전이 자동으로 관리됩니다. model_name을 속성으로 두면 값을 바꿔 가며 실험하고 Weave에서 차이를 확인하고 비교할 수 있습니다. 함수 호출은 @weave.op으로 추적되며, 입력과 출력이 로깅되므로 오류 추적과 디버깅에 유용합니다.
CodeGenerationPipeline 클래스는 코드 생성 로직을 Weave Model로 캡슐화하며, 다음과 같은 이점을 제공합니다.
- 자동 실험 추적: Weave는 모델의 각 run마다 입력, 출력, 매개변수를 캡처합니다.
- 버전 관리: 모델의 속성이나 코드가 변경되면 자동으로 버전이 관리되므로, 코드 생성 파이프라인이 시간이 지남에 따라 어떻게 발전해 왔는지 이력으로 남습니다.
- 재현성: 버전 관리와 추적 기능 덕분에 코드 생성 파이프라인의 이전 결과나 설정을 언제든지 재현할 수 있습니다.
- 하이퍼파라미터 관리: 모델 속성(예:
model_name)이 정의되고 여러 run에 걸쳐 추적되므로 실험을 더 쉽게 진행할 수 있습니다. - Weave 생태계와의 인테그레이션:
weave.Model을 사용하면 파이프라인을 평가, 서빙 기능 등 다른 Weave 도구와 연결할 수 있습니다.
평가 메트릭 구현하기
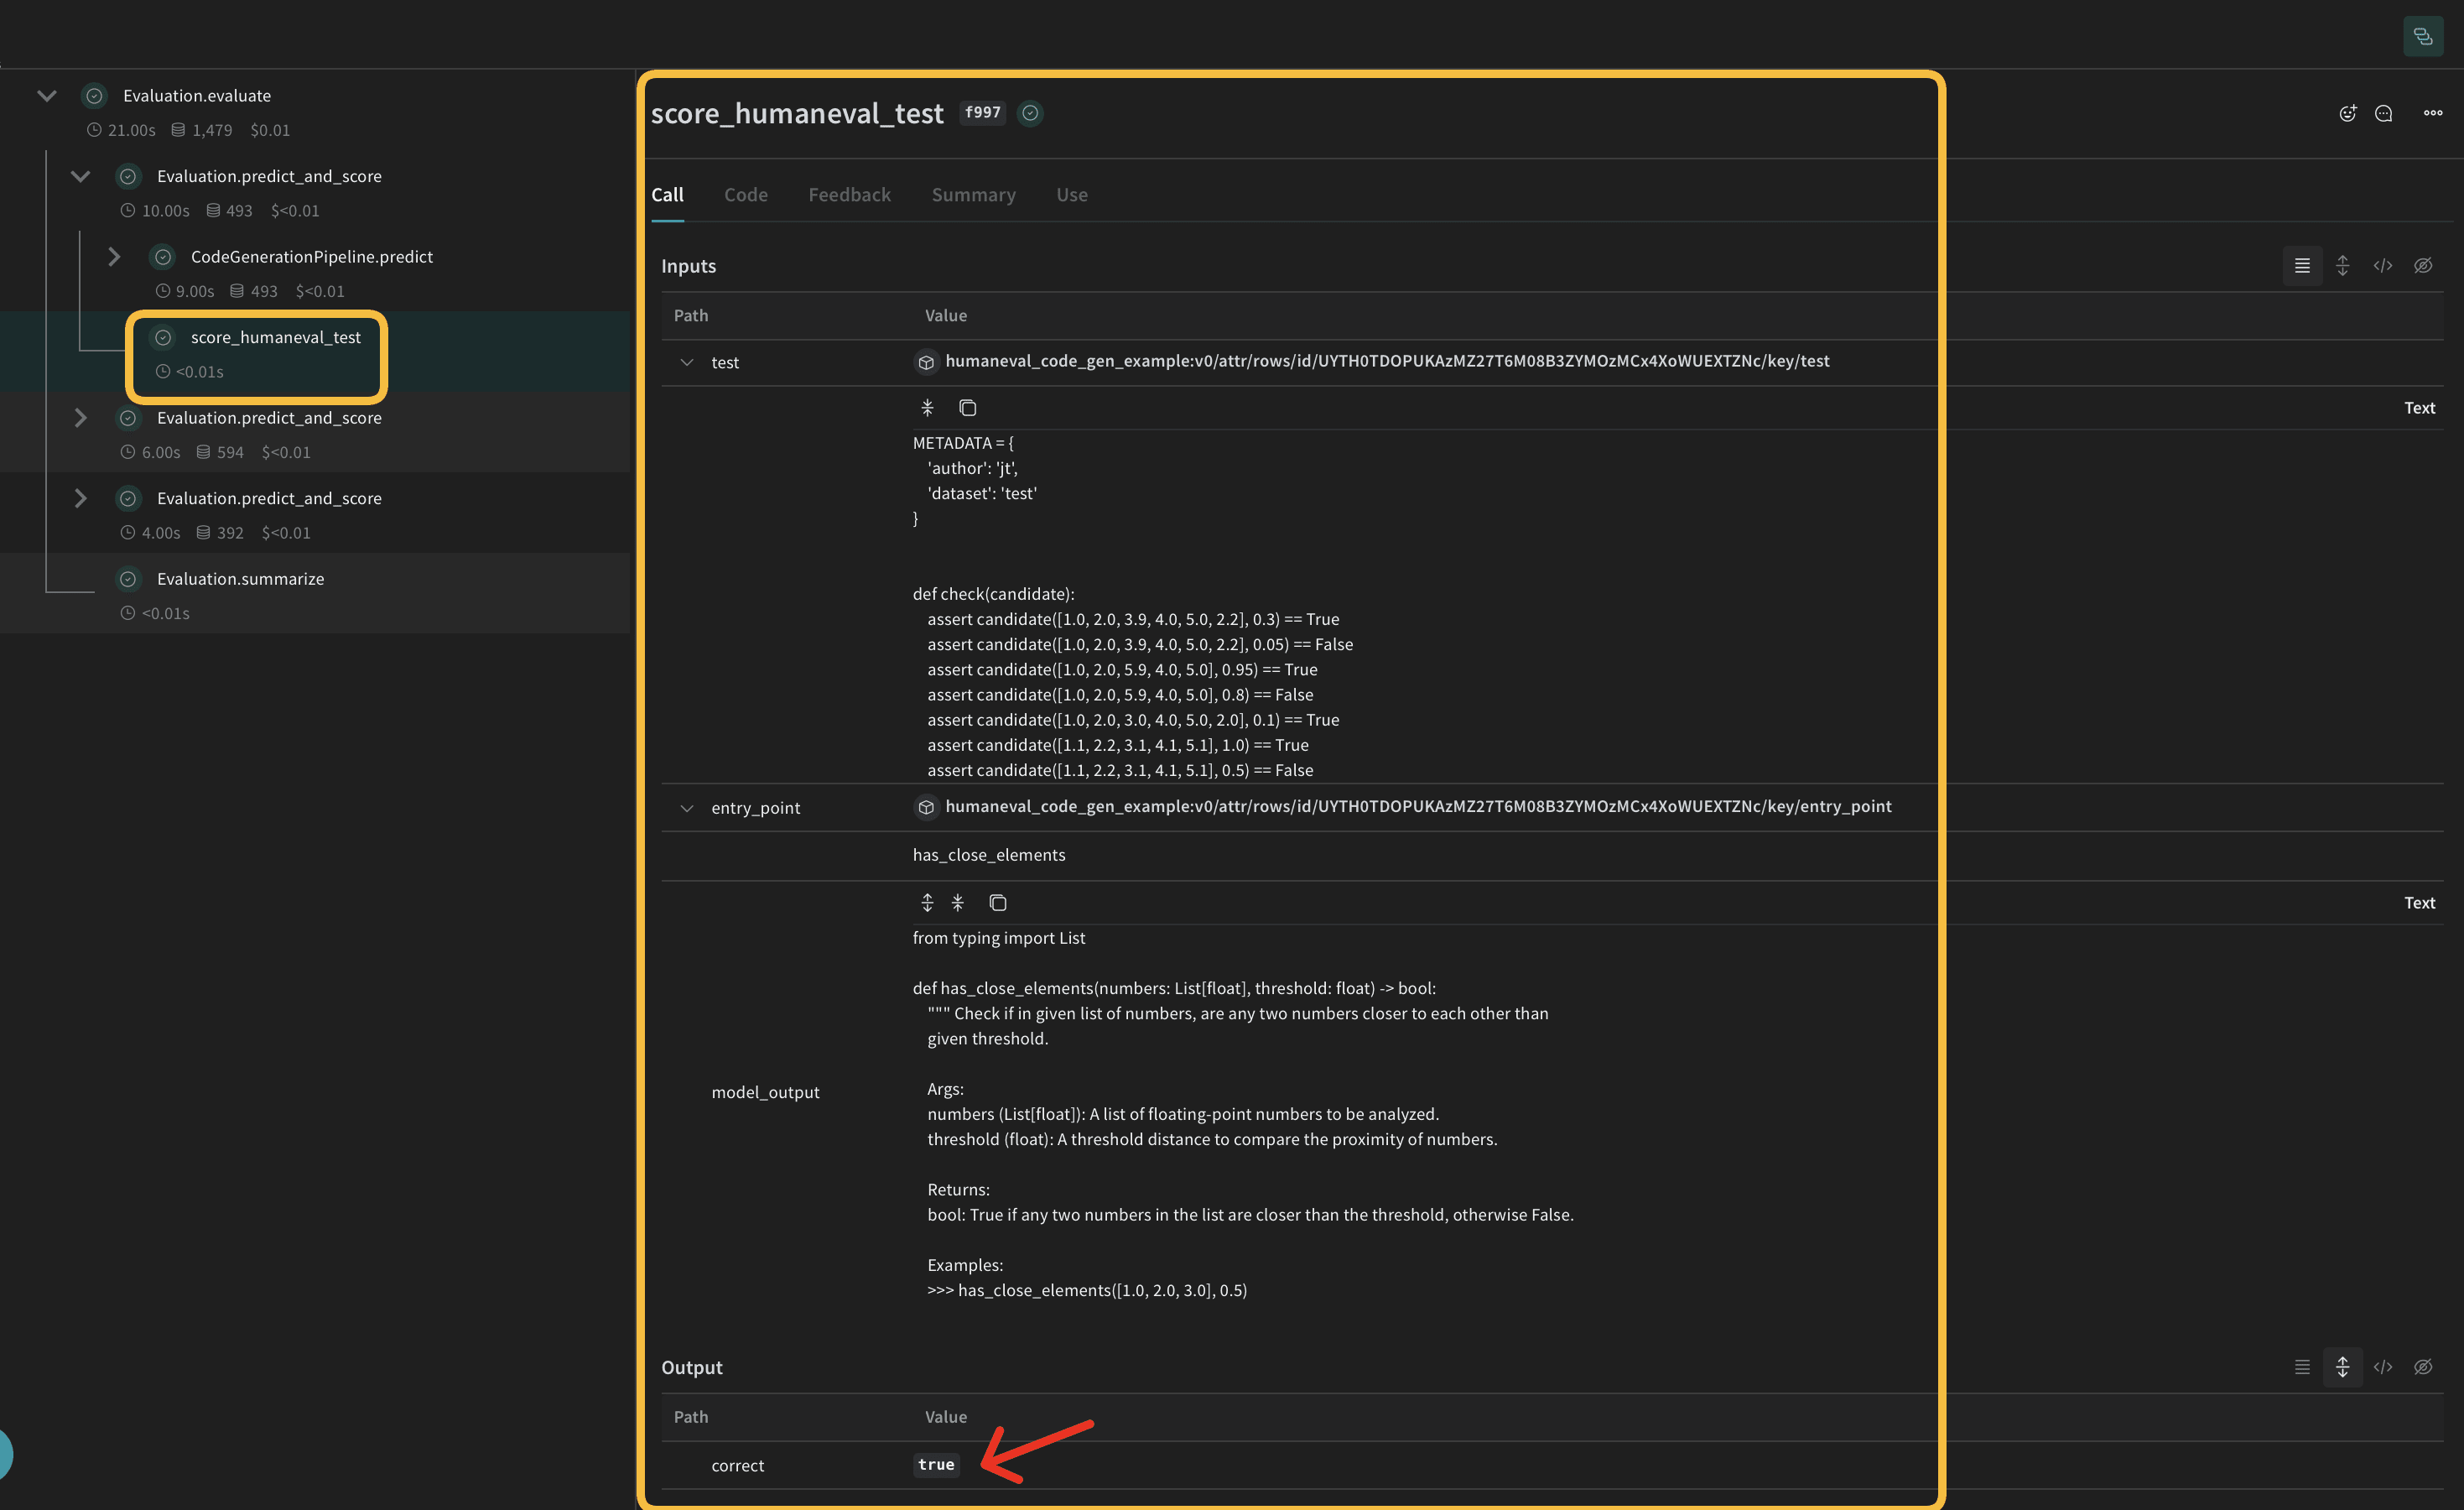
생성된 코드의 품질을 평가하려면weave.Scorer 서브클래스로 평가 메트릭을 구현하세요. 이 서브클래스는 데이터셋의 모든 model_output에 대해 score를 실행합니다. model_output은 weave.Model의 predict 함수가 반환한 출력이고, prompt는 human-eval 데이터셋에서 가져옵니다.
Weave 데이터셋 생성 및 평가 실행
파이프라인과 Scorer를 정의했으니, 마지막 단계로 평가 데이터셋을 구성하고 전체 과정을 엔드 투 엔드로 실행합니다. 파이프라인을 평가하려면 다음과 같이 Weave 데이터셋을 생성하고 평가를 실행하세요.결론
이 예제에서는 Weave와 OpenAI의 언어 모델을 사용하여 코드 생성 파이프라인을 구현하는 방법을 살펴보았습니다. 이 예제를 통해 다음 방법을 배웠습니다.- 코드 생성 프로세스의 각 단계에 대한 Weave 오퍼레이션을 생성합니다.
- 파이프라인을 Weave Model로 래핑하여 추적과 평가를 간소화합니다.
- Weave 오퍼레이션을 사용하여 맞춤형 평가 메트릭을 구현합니다.
- 데이터셋을 생성하고 파이프라인 평가를 실행합니다.