

이 문서는 대화형 노트북입니다. 로컬에서 실행하거나 다음 링크를 사용하세요.

설정
이 섹션에서는 Python 패키지를 설치하고 API 자격 증명을 불러온 뒤, Chat Completion 예시에 필요한 라이브러리를 임포트합니다. 먼저 OpenAI(openai)와 Weave(weave) 의존성, 그리고 API 키 관리 의존성인 set-env를 설치하세요.
%%capture
!pip install openai
!pip install weave
!pip install set-env-colab-kaggle-dotenv -q # 환경 변수용
python
%%capture
# openai 버그를 해결하기 위한 임시 해결 방법:
# TypeError: Client.__init__() got an unexpected keyword argument 'proxies'
# 참고: https://community.openai.com/t/error-with-openai-1-56-0-client-init-got-an-unexpected-keyword-argument-proxies/1040332/15
!pip install "httpx<0.28"
set_env를 사용합니다. set_env는 Google Colab의 시크릿 키 관리자와 호환되며, Colab 전용인 google.colab.userdata 대신 사용할 수 있습니다. set-env-colab-kaggle-dotenv 사용 안내를 참조하세요.
# 환경 변수를 설정합니다.
from set_env import set_env

_ = set_env("OPENAI_API_KEY")
_ = set_env("WANDB_API_KEY")
import base64
import os
import time
import wave

import numpy as np
from IPython.display import display
from openai import OpenAI

import weave
오디오 스트리밍 및 저장소 예시
의존성을 설치하고 자격 증명을 불러왔다면, 이제 오디오 모달리티를 활성화한 상태로 OpenAI의 completions 엔드포인트에 대한 Call을 설정할 수 있습니다. 먼저 OpenAI 클라이언트를 생성하고 Weave 프로젝트를 초기화하세요. 그러면 이후의 Call이 Weave를 통해 워크스페이스에 로깅됩니다.client = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))
weave.init("openai-audio-chat")
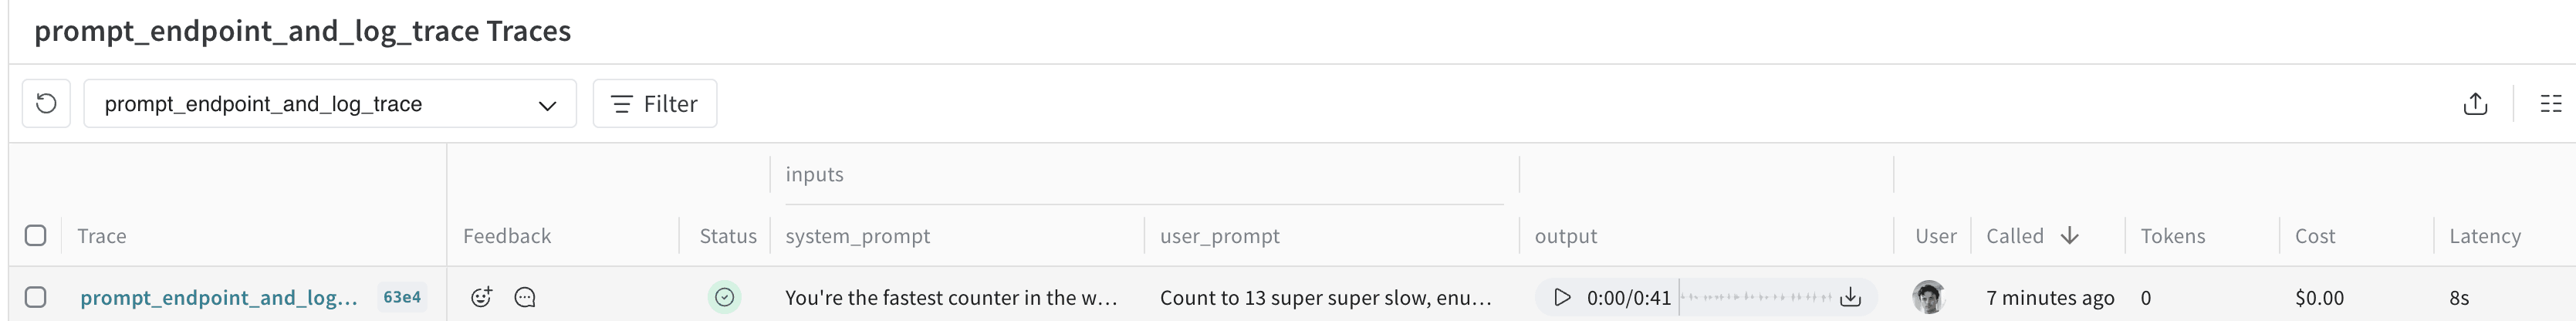
@weave.op() 데코레이터를 사용하면 Weave가 함수의 입력, 출력, 오디오 파일을 트레이스에 캡처합니다.
다음 코드는 prompt_endpoint_and_log_trace 함수를 정의합니다. 이 함수는 세 가지 주요 단계로 구성됩니다.
-
텍스트 및 오디오 입출력을 지원하는
gpt-4o-audio-preview모델을 사용해 completion 객체를 만듭니다.- 다양한 억양으로 13까지 천천히 세도록 모델에 프롬프트를 입력합니다.
- completion을
stream으로 설정합니다.
- 스트리밍 데이터를 청크 단위로 받을 새 출력 파일을 엽니다.
- Weave가 오디오 데이터를 트레이스에 로깅할 수 있도록 오디오 파일의 열린 파일 핸들러를 반환합니다.
SAMPLE_RATE = 22050

@weave.op()
def prompt_endpoint_and_log_trace(system_prompt=None, user_prompt=None):
    if not system_prompt:
        system_prompt = "You're the fastest counter in the world"
    if not user_prompt:
        user_prompt = "Count to 13 super super slow, enunciate each number with a dramatic flair, changing up accents as you go along. British, French, German, Spanish, etc."
    # 오디오 모달리티로 OpenAI API에 요청
    completion = client.chat.completions.create(
        model="gpt-4o-audio-preview",
        modalities=["text", "audio"],
        audio={"voice": "fable", "format": "pcm16"},
        stream=True,
        messages=[
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": user_prompt},
        ],
    )

    # 쓰기 모드로 wave 파일 열기
    with wave.open("./output.wav", "wb") as wav_file:
        wav_file.setnchannels(1)  # 모노
        wav_file.setsampwidth(2)  # 16-bit
        wav_file.setframerate(SAMPLE_RATE)  # 샘플 레이트(필요하면 조정)

        # API에서 청크가 스트리밍되는 대로 파일에 쓰기
        for chunk in completion:
            if (
                hasattr(chunk, "choices")
                and chunk.choices is not None
                and len(chunk.choices) > 0
                and hasattr(chunk.choices[0].delta, "audio")
                and chunk.choices[0].delta.audio.get("data") is not None
            ):
                # base64 오디오 데이터 디코딩
                audio_data = base64.b64decode(chunk.choices[0].delta.audio.get("data"))

                # 현재 청크를 wave 파일에 쓰기
                wav_file.writeframes(audio_data)

    # Weave Op에 파일 반환
    return wave.open("output.wav", "rb")
테스트
함수를 정의했으면 다음 셀을 실행해 함수를 엔드투엔드로 호출하고, 오디오가 생성되어 로깅되는지 확인하세요. Weave는 시스템 프롬프트와 사용자 프롬프트를 출력 오디오와 함께 트레이스에 저장합니다. 셀을 실행한 후 셀 출력에 표시된 트레이스 링크를 클릭하면 트레이스를 확인할 수 있습니다. 이제 Weave에서 트레이스가 기록된 Chat Completion 오디오 호출이 모두 준비되었습니다.from IPython.display import Audio
# 함수를 호출하여 오디오 스트림을 파일에 쓰기
prompt_endpoint_and_log_trace(
system_prompt="You're the fastest counter in the world",
user_prompt="Count to 13 super super slow, enunciate each number with a dramatic flair, changing up accents as you go along. British, French, German, Spanish, etc.",
)
# 업데이트된 오디오 스트림 표시
display(Audio("output.wav", rate=SAMPLE_RATE, autoplay=True))
고급 사용법: Weave로 Realtime API 사용하기
이 쿡북의 나머지 부분에서는 OpenAI의 Realtime API와 Weave를 함께 사용하여 실시간 양방향 오디오 대화를 트레이스하는 고급 예시를 살펴봅니다.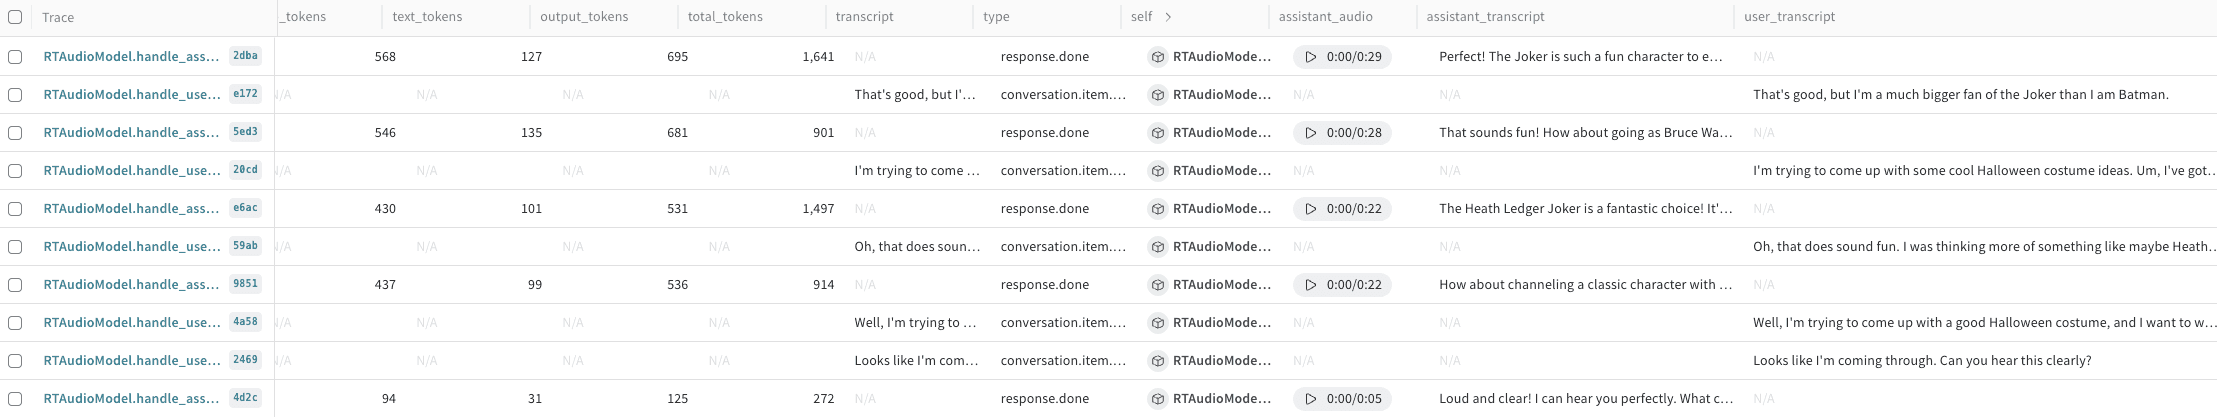
- 마이크 설정의 셀을 검토하세요.
- Google Colab 실행 환경의 제약으로 인해 이 예시는 호스트 머신에서 Jupyter Notebook으로 실행해야 합니다. 브라우저에서는 실행할 수 없습니다.
- macOS에서 PyAudio를 사용하려면 Brew로
portaudio를 설치해야 합니다.
- macOS에서 PyAudio를 사용하려면 Brew로
enable_audio_playback토글을 켜면 assistant가 출력하는 오디오가 재생됩니다. 에코 감지를 구현하기가 복잡하므로 이 옵션을 활성화하려면 헤드폰을 사용해야 합니다.
요구 사항 설정
Realtime 예시를 실행하려면 오디오 입출력 및 웹소켓 통신용 패키지를 추가로 설치해야 합니다. 패키지를 설치한 후 환경 변수를 다시 로드하세요.%%capture
!pip install numpy==2.0
!pip install weave
!pip install pyaudio # Mac에서는 `brew install portaudio`로 portaudio를 먼저 설치해야 할 수도 있습니다
!pip install websocket-client
!pip install set-env-colab-kaggle-dotenv -q # 환경 변수 설정용
!pip install resampy
python
import io
import json
import os
import threading
from typing import Optional
import pyaudio
import resampy
import websocket
from set_env import set_env
import weave
python
# 환경 변수를 설정합니다.
# 사용 방법은 https://pypi.org/project/set-env-colab-kaggle-dotenv/ 를 참조하세요.
_ = set_env("OPENAI_API_KEY")
_ = set_env("WANDB_API_KEY")
마이크 설정
Realtime 예시는 마이크로 녹음하고 스피커로 오디오를 재생하므로, PyAudio에 사용할 장치를 지정해야 합니다. 다음 셀을 실행하여 사용 가능한 오디오 장치를 모두 확인하세요. 그런 다음 표시된 장치 목록을 참고하여INPUT_DEVICE_INDEX와 OUTPUT_DEVICE_INDEX 값을 입력하세요. 입력 장치는 입력 채널이 하나 이상 있는 장치이고, 출력 장치는 출력 채널이 하나 이상 있는 장치입니다.
# 다음 셀을 설정할 수 있도록 pyaudio에서 디바이스 목록을 조회합니다
p = pyaudio.PyAudio()
devices_data = {i: p.get_device_info_by_index(i) for i in range(p.get_device_count())}
for i, device in devices_data.items():
    print(
        f"Found device @{i}: {device['name']} with sample rate: {device['defaultSampleRate']} and input channels: {device['maxInputChannels']} and output channels: {device['maxOutputChannels']}"
    )
python
INPUT_DEVICE_INDEX = 3  # @param                                                 # 위의 디바이스 목록을 참고하여 선택하세요. 입력 채널이 1개 이상인 디바이스인지 확인하세요.
OUTPUT_DEVICE_INDEX = 12  # @param                                                # 위의 디바이스 목록을 참고하여 선택하세요. 출력 채널이 1개 이상인 디바이스인지 확인하세요.
enable_audio_playback = True  # @param {type:"boolean"}                           # assistant 오디오 재생을 켭니다. 헤드폰이 필요합니다.

# 오디오 녹음 및 스트리밍 매개변수
INPUT_DEVICE_CHANNELS = devices_data[INPUT_DEVICE_INDEX][
    "maxInputChannels"
]  # 위의 디바이스 목록에서 가져온 값
SAMPLE_RATE = int(
    devices_data[INPUT_DEVICE_INDEX]["defaultSampleRate"]
)  # 위의 디바이스 목록에서 가져온 값
CHUNK = int(SAMPLE_RATE / 10)  # 프레임당 샘플 수
SAMPLE_WIDTH = p.get_sample_size(pyaudio.paInt16)  # 해당 포맷의 프레임당 샘플 수
CHUNK_DURATION = 0.3  # OAI API로 전송하는 청크당 오디오 길이(초)
OAI_SAMPLE_RATE = (
    24000  # OAI 샘플 레이트는 24kHz이며, assistant 오디오를 재생하거나 저장할 때 필요합니다
)
OUTPUT_DEVICE_CHANNELS = 1  # 모노로 출력하려면 1로 설정합니다
OpenAI Realtime API 스키마 구현
다음 섹션에서는 메시지 스키마, 오디오 작성기, Weave로 계측한 모델, 레코더 순으로 Realtime 클라이언트를 하나씩 구축합니다. OpenAI Python SDK는 아직 Realtime API를 지원하지 않습니다. 이 예제에서는 가독성을 높이기 위해 OpenAI Realtime API 스키마 전체를 Pydantic으로 구현하며, 공식 지원이 제공되면 이 구현은 지원 중단될 수 있습니다.OpenAI Realtime API용 Pydantic 스키마
from enum import Enum
from typing import Any, Literal, Union

from pydantic import BaseModel, Field, ValidationError

class BaseEvent(BaseModel):
    type: Union["ClientEventTypes", "ServerEventTypes"]
    event_id: Optional[str] = None  # 모든 이벤트에 event_id를 선택 필드로 추가

    # def model_dump_json(self, *args, **kwargs):
    #     # None이 아닌 필드만 포함
    #     return super().model_dump_json(*args, exclude_none=True, **kwargs)

class ChatMessage(BaseModel):
    role: Literal["user", "assistant"]
    content: str
    timestamp: float

""" CLIENT EVENTS """

class ClientEventTypes(str, Enum):
    SESSION_UPDATE = "session.update"
    CONVERSATION_ITEM_CREATE = "conversation.item.create"
    CONVERSATION_ITEM_TRUNCATE = "conversation.item.truncate"
    CONVERSATION_ITEM_DELETE = "conversation.item.delete"
    RESPONSE_CREATE = "response.create"
    RESPONSE_CANCEL = "response.cancel"
    INPUT_AUDIO_BUFFER_APPEND = "input_audio_buffer.append"
    INPUT_AUDIO_BUFFER_COMMIT = "input_audio_buffer.commit"
    INPUT_AUDIO_BUFFER_CLEAR = "input_audio_buffer.clear"
    ERROR = "error"

#### 세션 업데이트
class TurnDetection(BaseModel):
    type: Literal["server_vad"]
    threshold: float = Field(..., ge=0.0, le=1.0)
    prefix_padding_ms: int
    silence_duration_ms: int

class InputAudioTranscription(BaseModel):
    model: Optional[str] = None

class ToolParameterProperty(BaseModel):
    type: str

class ToolParameter(BaseModel):
    type: str
    properties: dict[str, ToolParameterProperty]
    required: list[str]

class Tool(BaseModel):
    type: Literal["function", "code_interpreter", "file_search"]
    name: Optional[str] = None
    description: Optional[str] = None
    parameters: Optional[ToolParameter] = None

class Session(BaseModel):
    modalities: Optional[list[str]] = None
    instructions: Optional[str] = None
    voice: Optional[str] = None
    input_audio_format: Optional[str] = None
    output_audio_format: Optional[str] = None
    input_audio_transcription: Optional[InputAudioTranscription] = None
    turn_detection: Optional[TurnDetection] = None
    tools: Optional[list[Tool]] = None
    tool_choice: Optional[str] = None
    temperature: Optional[float] = None
    max_output_tokens: Optional[int] = None

class SessionUpdate(BaseEvent):
    type: Literal[ClientEventTypes.SESSION_UPDATE] = ClientEventTypes.SESSION_UPDATE
    session: Session

#### 오디오 버퍼
class InputAudioBufferAppend(BaseEvent):
    type: Literal[ClientEventTypes.INPUT_AUDIO_BUFFER_APPEND] = (
        ClientEventTypes.INPUT_AUDIO_BUFFER_APPEND
    )
    audio: str

class InputAudioBufferCommit(BaseEvent):
    type: Literal[ClientEventTypes.INPUT_AUDIO_BUFFER_COMMIT] = (
        ClientEventTypes.INPUT_AUDIO_BUFFER_COMMIT
    )

class InputAudioBufferClear(BaseEvent):
    type: Literal[ClientEventTypes.INPUT_AUDIO_BUFFER_CLEAR] = (
        ClientEventTypes.INPUT_AUDIO_BUFFER_CLEAR
    )

#### 메시지
class MessageContent(BaseModel):
    type: Literal["input_audio"]
    audio: str

class ConversationItemContent(BaseModel):
    type: Literal["input_text", "input_audio", "text", "audio"]
    text: Optional[str] = None
    audio: Optional[str] = None
    transcript: Optional[str] = None

class FunctionCallContent(BaseModel):
    call_id: str
    name: str
    arguments: str

class FunctionCallOutputContent(BaseModel):
    output: str

class ConversationItem(BaseModel):
    id: Optional[str] = None
    type: Literal["message", "function_call", "function_call_output"]
    status: Optional[Literal["completed", "in_progress", "incomplete"]] = None
    role: Literal["user", "assistant", "system"]
    content: list[
        Union[ConversationItemContent, FunctionCallContent, FunctionCallOutputContent]
    ]
    call_id: Optional[str] = None
    name: Optional[str] = None
    arguments: Optional[str] = None
    output: Optional[str] = None

class ConversationItemCreate(BaseEvent):
    type: Literal[ClientEventTypes.CONVERSATION_ITEM_CREATE] = (
        ClientEventTypes.CONVERSATION_ITEM_CREATE
    )
    item: ConversationItem

class ConversationItemTruncate(BaseEvent):
    type: Literal[ClientEventTypes.CONVERSATION_ITEM_TRUNCATE] = (
        ClientEventTypes.CONVERSATION_ITEM_TRUNCATE
    )
    item_id: str
    content_index: int
    audio_end_ms: int

class ConversationItemDelete(BaseEvent):
    type: Literal[ClientEventTypes.CONVERSATION_ITEM_DELETE] = (
        ClientEventTypes.CONVERSATION_ITEM_DELETE
    )
    item_id: str

#### 응답
class ResponseCreate(BaseEvent):
    type: Literal[ClientEventTypes.RESPONSE_CREATE] = ClientEventTypes.RESPONSE_CREATE

class ResponseCancel(BaseEvent):
    type: Literal[ClientEventTypes.RESPONSE_CANCEL] = ClientEventTypes.RESPONSE_CANCEL

# 모든 이벤트 유형이 포함되도록 Event 유니온 업데이트
ClientEvent = Union[
    SessionUpdate,
    InputAudioBufferAppend,
    InputAudioBufferCommit,
    InputAudioBufferClear,
    ConversationItemCreate,
    ConversationItemTruncate,
    ConversationItemDelete,
    ResponseCreate,
    ResponseCancel,
]

""" SERVER EVENTS """

class ServerEventTypes(str, Enum):
    ERROR = "error"
    RESPONSE_AUDIO_TRANSCRIPT_DONE = "response.audio_transcript.done"
    RESPONSE_AUDIO_TRANSCRIPT_DELTA = "response.audio_transcript.delta"
    RESPONSE_AUDIO_DELTA = "response.audio.delta"
    SESSION_CREATED = "session.created"
    SESSION_UPDATED = "session.updated"
    CONVERSATION_CREATED = "conversation.created"
    INPUT_AUDIO_BUFFER_COMMITTED = "input_audio_buffer.committed"
    INPUT_AUDIO_BUFFER_CLEARED = "input_audio_buffer.cleared"
    INPUT_AUDIO_BUFFER_SPEECH_STARTED = "input_audio_buffer.speech_started"
    INPUT_AUDIO_BUFFER_SPEECH_STOPPED = "input_audio_buffer.speech_stopped"
    CONVERSATION_ITEM_CREATED = "conversation.item.created"
    CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_COMPLETED = (
        "conversation.item.input_audio_transcription.completed"
    )
    CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_FAILED = (
        "conversation.item.input_audio_transcription.failed"
    )
    CONVERSATION_ITEM_TRUNCATED = "conversation.item.truncated"
    CONVERSATION_ITEM_DELETED = "conversation.item.deleted"
    RESPONSE_CREATED = "response.created"
    RESPONSE_DONE = "response.done"
    RESPONSE_OUTPUT_ITEM_ADDED = "response.output_item.added"
    RESPONSE_OUTPUT_ITEM_DONE = "response.output_item.done"
    RESPONSE_CONTENT_PART_ADDED = "response.content_part.added"
    RESPONSE_CONTENT_PART_DONE = "response.content_part.done"
    RESPONSE_TEXT_DELTA = "response.text.delta"
    RESPONSE_TEXT_DONE = "response.text.done"
    RESPONSE_AUDIO_DONE = "response.audio.done"
    RESPONSE_FUNCTION_CALL_ARGUMENTS_DELTA = "response.function_call_arguments.delta"
    RESPONSE_FUNCTION_CALL_ARGUMENTS_DONE = "response.function_call_arguments.done"
    RATE_LIMITS_UPDATED = "rate_limits.updated"

#### 오류
class ErrorDetails(BaseModel):
    type: Optional[str] = None
    code: Optional[str] = None
    message: Optional[str] = None
    param: Optional[str] = None

class ErrorEvent(BaseEvent):
    type: Literal[ServerEventTypes.ERROR] = ServerEventTypes.ERROR
    error: ErrorDetails

#### 세션
class SessionCreated(BaseEvent):
    type: Literal[ServerEventTypes.SESSION_CREATED] = ServerEventTypes.SESSION_CREATED
    session: Session

class SessionUpdated(BaseEvent):
    type: Literal[ServerEventTypes.SESSION_UPDATED] = ServerEventTypes.SESSION_UPDATED
    session: Session

#### 대화
class Conversation(BaseModel):
    id: str
    object: Literal["realtime.conversation"]

class ConversationCreated(BaseEvent):
    type: Literal[ServerEventTypes.CONVERSATION_CREATED] = (
        ServerEventTypes.CONVERSATION_CREATED
    )
    conversation: Conversation

class ConversationItemCreated(BaseEvent):
    type: Literal[ServerEventTypes.CONVERSATION_ITEM_CREATED] = (
        ServerEventTypes.CONVERSATION_ITEM_CREATED
    )
    previous_item_id: Optional[str] = None
    item: ConversationItem

class ConversationItemInputAudioTranscriptionCompleted(BaseEvent):
    type: Literal[
        ServerEventTypes.CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_COMPLETED
    ] = ServerEventTypes.CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_COMPLETED
    item_id: str
    content_index: int
    transcript: str

class ConversationItemInputAudioTranscriptionFailed(BaseEvent):
    type: Literal[
        ServerEventTypes.CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_FAILED
    ] = ServerEventTypes.CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_FAILED
    item_id: str
    content_index: int
    error: dict[str, Any]

class ConversationItemTruncated(BaseEvent):
    type: Literal[ServerEventTypes.CONVERSATION_ITEM_TRUNCATED] = (
        ServerEventTypes.CONVERSATION_ITEM_TRUNCATED
    )
    item_id: str
    content_index: int
    audio_end_ms: int

class ConversationItemDeleted(BaseEvent):
    type: Literal[ServerEventTypes.CONVERSATION_ITEM_DELETED] = (
        ServerEventTypes.CONVERSATION_ITEM_DELETED
    )
    item_id: str

#### 응답
class ResponseUsage(BaseModel):
    total_tokens: int
    input_tokens: int
    output_tokens: int
    input_token_details: Optional[dict[str, int]] = None
    output_token_details: Optional[dict[str, int]] = None

class ResponseOutput(BaseModel):
    id: str
    object: Literal["realtime.item"]
    type: str
    status: str
    role: str
    content: list[dict[str, Any]]

class ResponseContentPart(BaseModel):
    type: str
    text: Optional[str] = None

class ResponseOutputItemContent(BaseModel):
    type: str
    text: Optional[str] = None

class ResponseStatusDetails(BaseModel):
    type: str
    reason: str

class ResponseOutputItem(BaseModel):
    id: str
    object: Literal["realtime.item"]
    type: str
    status: str
    role: str
    content: list[ResponseOutputItemContent]

class Response(BaseModel):
    id: str
    object: Literal["realtime.response"]
    status: str
    status_details: Optional[ResponseStatusDetails] = None
    output: list[ResponseOutput]
    usage: Optional[ResponseUsage]

class ResponseCreated(BaseEvent):
    type: Literal[ServerEventTypes.RESPONSE_CREATED] = ServerEventTypes.RESPONSE_CREATED
    response: Response

class ResponseDone(BaseEvent):
    type: Literal[ServerEventTypes.RESPONSE_DONE] = ServerEventTypes.RESPONSE_DONE
    response: Response

class ResponseOutputItemAdded(BaseEvent):
    type: Literal[ServerEventTypes.RESPONSE_OUTPUT_ITEM_ADDED] = (
        ServerEventTypes.RESPONSE_OUTPUT_ITEM_ADDED
    )
    response_id: str
    output_index: int
    item: ResponseOutputItem

class ResponseOutputItemDone(BaseEvent):
    type: Literal[ServerEventTypes.RESPONSE_OUTPUT_ITEM_DONE] = (
        ServerEventTypes.RESPONSE_OUTPUT_ITEM_DONE
    )
    response_id: str
    output_index: int
    item: ResponseOutputItem

class ResponseContentPartAdded(BaseEvent):
    type: Literal[ServerEventTypes.RESPONSE_CONTENT_PART_ADDED] = (
        ServerEventTypes.RESPONSE_CONTENT_PART_ADDED
    )
    response_id: str
    item_id: str
    output_index: int
    content_index: int
    part: ResponseContentPart

class ResponseContentPartDone(BaseEvent):
    type: Literal[ServerEventTypes.RESPONSE_CONTENT_PART_DONE] = (
        ServerEventTypes.RESPONSE_CONTENT_PART_DONE
    )
    response_id: str
    item_id: str
    output_index: int
    content_index: int
    part: ResponseContentPart

#### 응답 텍스트
class ResponseTextDelta(BaseEvent):
    type: Literal[ServerEventTypes.RESPONSE_TEXT_DELTA] = (
        ServerEventTypes.RESPONSE_TEXT_DELTA
    )
    response_id: str
    item_id: str
    output_index: int
    content_index: int
    delta: str

class ResponseTextDone(BaseEvent):
    type: Literal[ServerEventTypes.RESPONSE_TEXT_DONE] = (
        ServerEventTypes.RESPONSE_TEXT_DONE
    )
    response_id: str
    item_id: str
    output_index: int
    content_index: int
    text: str

#### 응답 오디오
class ResponseAudioTranscriptDone(BaseEvent):
    type: Literal[ServerEventTypes.RESPONSE_AUDIO_TRANSCRIPT_DONE] = (
        ServerEventTypes.RESPONSE_AUDIO_TRANSCRIPT_DONE
    )
    transcript: str

class ResponseAudioTranscriptDelta(BaseEvent):
    type: Literal[ServerEventTypes.RESPONSE_AUDIO_TRANSCRIPT_DELTA] = (
        ServerEventTypes.RESPONSE_AUDIO_TRANSCRIPT_DELTA
    )
    delta: str

class ResponseAudioDelta(BaseEvent):
    type: Literal[ServerEventTypes.RESPONSE_AUDIO_DELTA] = (
        ServerEventTypes.RESPONSE_AUDIO_DELTA
    )
    response_id: str
    item_id: str
    delta: str

class ResponseAudioDone(BaseEvent):
    type: Literal[ServerEventTypes.RESPONSE_AUDIO_DONE] = (
        ServerEventTypes.RESPONSE_AUDIO_DONE
    )
    response_id: str
    item_id: str
    output_index: int
    content_index: int

class InputAudioBufferCommitted(BaseEvent):
    type: Literal[ServerEventTypes.INPUT_AUDIO_BUFFER_COMMITTED] = (
        ServerEventTypes.INPUT_AUDIO_BUFFER_COMMITTED
    )
    previous_item_id: Optional[str] = None
    item_id: Optional[str] = None
    event_id: Optional[str] = None

class InputAudioBufferCleared(BaseEvent):
    type: Literal[ServerEventTypes.INPUT_AUDIO_BUFFER_CLEARED] = (
        ServerEventTypes.INPUT_AUDIO_BUFFER_CLEARED
    )

class InputAudioBufferSpeechStarted(BaseEvent):
    type: Literal[ServerEventTypes.INPUT_AUDIO_BUFFER_SPEECH_STARTED] = (
        ServerEventTypes.INPUT_AUDIO_BUFFER_SPEECH_STARTED
    )
    audio_start_ms: int
    item_id: str

class InputAudioBufferSpeechStopped(BaseEvent):
    type: Literal[ServerEventTypes.INPUT_AUDIO_BUFFER_SPEECH_STOPPED] = (
        ServerEventTypes.INPUT_AUDIO_BUFFER_SPEECH_STOPPED
    )
    audio_end_ms: int
    item_id: str

#### 함수 호출
class ResponseFunctionCallArgumentsDelta(BaseEvent):
    type: Literal[ServerEventTypes.RESPONSE_FUNCTION_CALL_ARGUMENTS_DELTA] = (
        ServerEventTypes.RESPONSE_FUNCTION_CALL_ARGUMENTS_DELTA
    )
    response_id: str
    item_id: str
    output_index: int
    call_id: str
    delta: str

class ResponseFunctionCallArgumentsDone(BaseEvent):
    type: Literal[ServerEventTypes.RESPONSE_FUNCTION_CALL_ARGUMENTS_DONE] = (
        ServerEventTypes.RESPONSE_FUNCTION_CALL_ARGUMENTS_DONE
    )
    response_id: str
    item_id: str
    output_index: int
    call_id: str
    arguments: str

#### 요청 속도 제한
class RateLimit(BaseModel):
    name: str
    limit: int
    remaining: int
    reset_seconds: float

class RateLimitsUpdated(BaseEvent):
    type: Literal[ServerEventTypes.RATE_LIMITS_UPDATED] = (
        ServerEventTypes.RATE_LIMITS_UPDATED
    )
    rate_limits: list[RateLimit]

ServerEvent = Union[
    ErrorEvent,
    ConversationCreated,
    ResponseAudioTranscriptDone,
    ResponseAudioTranscriptDelta,
    ResponseAudioDelta,
    ResponseCreated,
    ResponseDone,
    ResponseOutputItemAdded,
    ResponseOutputItemDone,
    ResponseContentPartAdded,
    ResponseContentPartDone,
    ResponseTextDelta,
    ResponseTextDone,
    ResponseAudioDone,
    ConversationItemInputAudioTranscriptionCompleted,
    SessionCreated,
    SessionUpdated,
    InputAudioBufferCleared,
    InputAudioBufferSpeechStarted,
    InputAudioBufferSpeechStopped,
    ConversationItemCreated,
    ConversationItemInputAudioTranscriptionFailed,
    ConversationItemTruncated,
    ConversationItemDeleted,
    RateLimitsUpdated,
]

EVENT_TYPE_TO_MODEL = {
    ServerEventTypes.ERROR: ErrorEvent,
    ServerEventTypes.RESPONSE_AUDIO_TRANSCRIPT_DONE: ResponseAudioTranscriptDone,
    ServerEventTypes.RESPONSE_AUDIO_TRANSCRIPT_DELTA: ResponseAudioTranscriptDelta,
    ServerEventTypes.RESPONSE_AUDIO_DELTA: ResponseAudioDelta,
    ServerEventTypes.CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_COMPLETED: ConversationItemInputAudioTranscriptionCompleted,
    ServerEventTypes.SESSION_CREATED: SessionCreated,
    ServerEventTypes.SESSION_UPDATED: SessionUpdated,
    ServerEventTypes.CONVERSATION_CREATED: ConversationCreated,
    ServerEventTypes.INPUT_AUDIO_BUFFER_COMMITTED: InputAudioBufferCommitted,
    ServerEventTypes.INPUT_AUDIO_BUFFER_CLEARED: InputAudioBufferCleared,
    ServerEventTypes.INPUT_AUDIO_BUFFER_SPEECH_STARTED: InputAudioBufferSpeechStarted,
    ServerEventTypes.INPUT_AUDIO_BUFFER_SPEECH_STOPPED: InputAudioBufferSpeechStopped,
    ServerEventTypes.CONVERSATION_ITEM_CREATED: ConversationItemCreated,
    ServerEventTypes.CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_FAILED: ConversationItemInputAudioTranscriptionFailed,
    ServerEventTypes.CONVERSATION_ITEM_TRUNCATED: ConversationItemTruncated,
    ServerEventTypes.CONVERSATION_ITEM_DELETED: ConversationItemDeleted,
    ServerEventTypes.RESPONSE_CREATED: ResponseCreated,
    ServerEventTypes.RESPONSE_DONE: ResponseDone,
    ServerEventTypes.RESPONSE_OUTPUT_ITEM_ADDED: ResponseOutputItemAdded,
    ServerEventTypes.RESPONSE_OUTPUT_ITEM_DONE: ResponseOutputItemDone,
    ServerEventTypes.RESPONSE_CONTENT_PART_ADDED: ResponseContentPartAdded,
    ServerEventTypes.RESPONSE_CONTENT_PART_DONE: ResponseContentPartDone,
    ServerEventTypes.RESPONSE_TEXT_DELTA: ResponseTextDelta,
    ServerEventTypes.RESPONSE_TEXT_DONE: ResponseTextDone,
    ServerEventTypes.RESPONSE_AUDIO_DONE: ResponseAudioDone,
    ServerEventTypes.RATE_LIMITS_UPDATED: RateLimitsUpdated,
}

def parse_server_event(event_data: dict) -> ServerEvent:
    event_type = event_data.get("type")
    if not event_type:
        raise ValueError("Event data is missing 'type' field")

    model_class = EVENT_TYPE_TO_MODEL.get(event_type)
    if not model_class:
        raise ValueError(f"Unknown event type: {event_type}")

    try:
        return model_class(**event_data)
    except ValidationError as e:
        raise ValueError(f"Failed to parse event of type {event_type}: {str(e)}") from e
오디오 스트림 작성기(디스크 및 메모리 내)
다음 헬퍼 클래스는 스트리밍된 오디오 청크를 WAV 파일(또는 메모리 내 버퍼)에 버퍼링합니다. 이렇게 저장한 오디오는 나중에 Weave에 전달하여 로깅할 수 있습니다.class StreamingWavWriter:
"""Writes audio integer or byte array chunks to a WAV file."""
wav_file = None
buffer = None
in_memory = False
def __init__(
self,
filename=None,
channels=INPUT_DEVICE_CHANNELS,
sample_width=SAMPLE_WIDTH,
framerate=SAMPLE_RATE,
):
self.in_memory = filename is None
if self.in_memory:
self.buffer = io.BytesIO()
self.wav_file = wave.open(self.buffer, "wb")
else:
self.wav_file = wave.open(filename, "wb")
self.wav_file.setnchannels(channels)
self.wav_file.setsampwidth(sample_width)
self.wav_file.setframerate(framerate)
def append_int16_chunk(self, int16_data):
if int16_data is not None:
self.wav_file.writeframes(
int16_data.tobytes()
if isinstance(int16_data, np.ndarray)
else int16_data
)
def close(self):
self.wav_file.close()
def get_wav_buffer(self):
assert self.in_memory, "Buffer only available if stream is in memory."
return self.buffer
실시간 오디오 모델
실시간(RT) 오디오 모델은 웹소켓을 사용해 OpenAI의 Realtime API로 이벤트를 전송합니다. 이 모델은 다음과 같이 동작합니다.- init: 로컬 버퍼(입력 오디오)와 스트림(assistant 재생 스트림, 사용자 오디오 디스크 기록 스트림)을 초기화하고 Realtime API에 연결합니다.
- receive_messages_thread: 별도의 스레드가 API에서 오는 메시지 수신을 담당합니다. 코드에서 처리하는 주요 이벤트 유형은 다음 네 가지입니다.
RESPONSE_AUDIO_TRANSCRIPT_DONE: 서버가 assistant의 응답이 완료되었음을 알리고 전사본을 제공합니다.CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_COMPLETED: 서버가 사용자 오디오의 전사가 완료되었음을 알리고 해당 전사본을 전송합니다. 코드는 이 전사본을 Weave에 로깅하고 사용자에게 출력합니다.RESPONSE_AUDIO_DELTA: 서버가 assistant 응답 오디오의 새 청크를 전송합니다. 코드는 이 청크를 응답 ID 기준으로 진행 중인 응답 데이터에 이어 붙이고, 재생할 수 있도록 출력 스트림에 추가합니다.RESPONSE_DONE: 서버가 assistant 응답이 완료되었음을 알립니다. 코드는 해당 응답에 연결된 모든 오디오 청크와 전사본을 조회하여 Weave에 로깅합니다.
- send_audio: 핸들러가 사용자 오디오 청크를 버퍼에 추가하고, 오디오 버퍼가 일정 크기에 도달하면 오디오 청크를 전송합니다.
class RTAudioModel(weave.Model):
    """Model class for realtime e2e audio OpenAI model interaction with Whisper user transcription for logging."""

    realtime_model_name: str = "gpt-4o-realtime-preview-2024-10-01"  # 실시간 e2e 오디오 전용 모델 상호작용

    stop_event: Optional[threading.Event] = threading.Event()  # 모델 중지용 이벤트
    ws: Optional[websocket.WebSocket] = None  # OpenAI 통신용 WebSocket

    user_wav_writer: Optional[StreamingWavWriter] = (
        None  # 사용자 출력을 파일에 기록하는 스트림
    )
    input_audio_buffer: Optional[np.ndarray] = None  # 사용자 오디오 청크용 버퍼
    assistant_outputs: dict[str, StreamingWavWriter] = (
        None  # Weave로 전송할 assistant 출력 집계
    )
    playback_stream: Optional[pyaudio.Stream] = (
        None  # assistant 응답 재생용 스트림
    )

    def __init__(self):
        super().__init__()
        self.stop_event.clear()
        self.user_wav_writer = StreamingWavWriter(
            filename="user_audio.wav", framerate=SAMPLE_RATE
        )
        self.input_audio_buffer = np.array([], dtype=np.int16)
        self.ws = websocket.WebSocket()
        self.assistant_outputs = {}

        # 활성화된 경우 assistant 오디오 재생 스트림 열기
        if enable_audio_playback:
            self.playback_stream = pyaudio.PyAudio().open(
                format=pyaudio.paInt16,
                channels=OUTPUT_DEVICE_CHANNELS,
                rate=OAI_SAMPLE_RATE,
                output=True,
                output_device_index=OUTPUT_DEVICE_INDEX,
            )

        # WebSocket 연결
        try:
            self.ws.connect(
                f"wss://api.openai.com/v1/realtime?model={self.realtime_model_name}",
                header={
                    "Authorization": f"Bearer {os.environ.get('OPENAI_API_KEY')}",
                    "OpenAI-Beta": "realtime=v1",
                },
            )

            # 설정 메시지 전송
            config_event = SessionUpdate(
                session=Session(
                    modalities=["text", "audio"],  # 사용할 모달리티
                    input_audio_transcription=InputAudioTranscription(
                        model="whisper-1"
                    ),  # 전사에 whisper-1 사용
                    turn_detection=TurnDetection(
                        type="server_vad",
                        threshold=0.3,
                        prefix_padding_ms=300,
                        silence_duration_ms=600,
                    ),  # 서버 VAD로 무음 감지
                )
            )
            self.ws.send(config_event.model_dump_json(exclude_none=True))
            self.log_ws_message(config_event.model_dump_json(exclude_none=True), "Sent")

            # 리스너 시작
            websocket_thread = threading.Thread(target=self.receive_messages_thread)
            websocket_thread.daemon = True
            websocket_thread.start()

        except Exception as e:
            print(f"Error connecting to WebSocket: {e}")

    ##### Weave 인테그레이션 및 메시지 핸들러 #####
    def handle_assistant_response_audio_delta(self, data: ResponseAudioDelta):
        if data.response_id not in self.assistant_outputs:
            self.assistant_outputs[data.response_id] = StreamingWavWriter(
                framerate=OAI_SAMPLE_RATE
            )

        data_bytes = base64.b64decode(data.delta)
        self.assistant_outputs[data.response_id].append_int16_chunk(data_bytes)

        if enable_audio_playback:
            self.playback_stream.write(data_bytes)

        return {"assistant_audio": data_bytes}

    @weave.op()
    def handle_assistant_response_done(self, data: ResponseDone):
        wave_file_stream = self.assistant_outputs[data.response.id]
        wave_file_stream.close()
        wave_file_stream.buffer.seek(0)
        weave_payload = {
            "assistant_audio": wave.open(wave_file_stream.get_wav_buffer(), "rb"),
            "assistant_transcript": data.response.output[0]
            .content[0]
            .get("transcript", "Transcript Unavailable."),
        }
        return weave_payload

    @weave.op()
    def handle_user_transcription_done(
        self, data: ConversationItemInputAudioTranscriptionCompleted
    ):
        return {"user_transcript": data.transcript}

    ##### 메시지 수신기 및 전송기 #####
    def receive_messages_thread(self):
        while not self.stop_event.is_set():
            try:
                data = json.loads(self.ws.recv())
                self.log_ws_message(json.dumps(data, indent=2))

                parsed_event = parse_server_event(data)

                if parsed_event.type == ServerEventTypes.RESPONSE_AUDIO_TRANSCRIPT_DONE:
                    print("Assistant: ", parsed_event.transcript)
                elif (
                    parsed_event.type
                    == ServerEventTypes.CONVERSATION_ITEM_INPUT_AUDIO_TRANSCRIPTION_COMPLETED
                ):
                    print("User: ", parsed_event.transcript)
                    self.handle_user_transcription_done(parsed_event)
                elif parsed_event.type == ServerEventTypes.RESPONSE_AUDIO_DELTA:
                    self.handle_assistant_response_audio_delta(parsed_event)
                elif parsed_event.type == ServerEventTypes.RESPONSE_DONE:
                    self.handle_assistant_response_done(parsed_event)
                elif parsed_event.type == ServerEventTypes.ERROR:
                    print(
                        f"\nError from server: {parsed_event.error.model_dump_json(exclude_none=True)}"
                    )
            except websocket.WebSocketConnectionClosedException:
                print("\nWebSocket connection closed")
                break
            except json.JSONDecodeError:
                continue
            except Exception as e:
                print(f"\nError in receive_messages: {e}")
                break

    def send_audio(self, audio_chunk):
        if self.ws and self.ws.connected:
            self.input_audio_buffer = np.append(
                self.input_audio_buffer, np.frombuffer(audio_chunk, dtype=np.int16)
            )
            if len(self.input_audio_buffer) >= SAMPLE_RATE * CHUNK_DURATION:
                try:
                    # 오디오를 OAI 샘플링 레이트로 리샘플링
                    resampled_audio = (
                        resampy.resample(
                            self.input_audio_buffer, SAMPLE_RATE, OAI_SAMPLE_RATE
                        )
                        if SAMPLE_RATE != OAI_SAMPLE_RATE
                        else self.input_audio_buffer
                    )

                    # OAI API로 오디오 청크 전송
                    audio_event = InputAudioBufferAppend(
                        audio=base64.b64encode(
                            resampled_audio.astype(np.int16).tobytes()
                        ).decode("utf-8")  # 오디오 배열을 b64 바이트로 변환
                    )
                    self.ws.send(audio_event.model_dump_json(exclude_none=True))
                    self.log_ws_message(
                        audio_event.model_dump_json(exclude_none=True), "Sent"
                    )
                finally:
                    self.user_wav_writer.append_int16_chunk(self.input_audio_buffer)

                    # 오디오 버퍼 비우기
                    self.input_audio_buffer = np.array([], dtype=np.int16)
        else:
            print("Error sending audio: websocket not initialized.")

    ##### 일반 유틸리티 함수 #####
    def log_ws_message(self, message, direction="Received"):
        with open("websocket_log.txt", "a") as log_file:
            log_file.write(
                f"{time.strftime('%Y-%m-%d %H:%M:%S')} - {direction}: {message}\n"
            )

    def stop(self):
        self.stop_event.set()

        if self.ws:
            self.ws.close()

        self.user_wav_writer.close()
오디오 레코더
모델을 정의했으면 이제 마이크 입력을 모델에 전달할 방법이 필요합니다. 이 예제에서는 RTAudio 모델의send_audio 메서드에 핸들러를 연결한 PyAudio 입력 스트림을 사용합니다. 코드는 스트림을 메인 스레드로 반환하므로, 프로그램이 완료되면 안전하게 종료할 수 있습니다.
# 오디오 캡처 스트림
def record_audio(realtime_model: RTAudioModel) -> pyaudio.Stream:
    """Setup a Pyaudio input stream and use the RTAudioModel as a callback for streaming data."""

    def audio_callback(in_data, frame_count, time_info, status):
        realtime_model.send_audio(in_data)
        return (None, pyaudio.paContinue)

    p = pyaudio.PyAudio()
    stream = p.open(
        format=pyaudio.paInt16,
        channels=INPUT_DEVICE_CHANNELS,
        rate=SAMPLE_RATE,
        input=True,
        input_device_index=INPUT_DEVICE_INDEX,
        frames_per_buffer=CHUNK,
        stream_callback=audio_callback,
    )
    stream.start_stream()

    print("Recording started. Please begin speaking to your personal assistant...")
    return stream
메인 스레드
이 마지막 셀은 앞서 만든 컴포넌트를 하나로 묶어 실시간 assistant를 실행합니다. 메인 스레드는 Weave가 통합된 실시간 오디오 모델을 초기화합니다. 이어서 코드가 녹음을 시작하고 사용자의 키보드 인터럽트를 기다립니다. 셀을 중지하면 사용자와 assistant의 전사본 및 오디오를 포함해 대화 전체가 담긴 Weave 트레이스를 확인할 수 있습니다.weave.init(project_name="realtime-oai-audio-testing")
realtime_model = RTAudioModel()
if realtime_model.ws and realtime_model.ws.connected:
recording_stream: pyaudio.Stream = record_audio(realtime_model)
try:
while not realtime_model.stop_event.is_set():
time.sleep(1)
except KeyboardInterrupt:
pass
except Exception as e:
print(f"Error in main loop: {e}")
import traceback
traceback.print_exc()
finally:
print("Exiting...")
realtime_model.stop()
if recording_stream and recording_stream.is_active():
recording_stream.stop_stream()
recording_stream.close()
else:
print(
"WebSocket connection failed. Please check your API key and internet connection."
)