

데이터셋 CSV 파일 임포트 및 로깅
CSV 파일의 내용을 더 쉽게 재사용하려면 W&B Artifacts를 사용하는 것이 좋습니다.- 먼저 CSV 파일을 임포트하세요. 다음 코드 스니펫에서
iris.csv파일 이름을 사용할 CSV 파일 이름으로 바꾸세요.
- W&B 대시보드를 활용하려면 CSV 파일을 W&B Table로 변환하세요.
- 다음으로 W&B 아티팩트를 생성하고 table을 아티팩트에 추가하세요.
- 마지막으로
wandb.init()으로 새 W&B run을 시작하여 W&B에서 추적하고 로깅하세요.
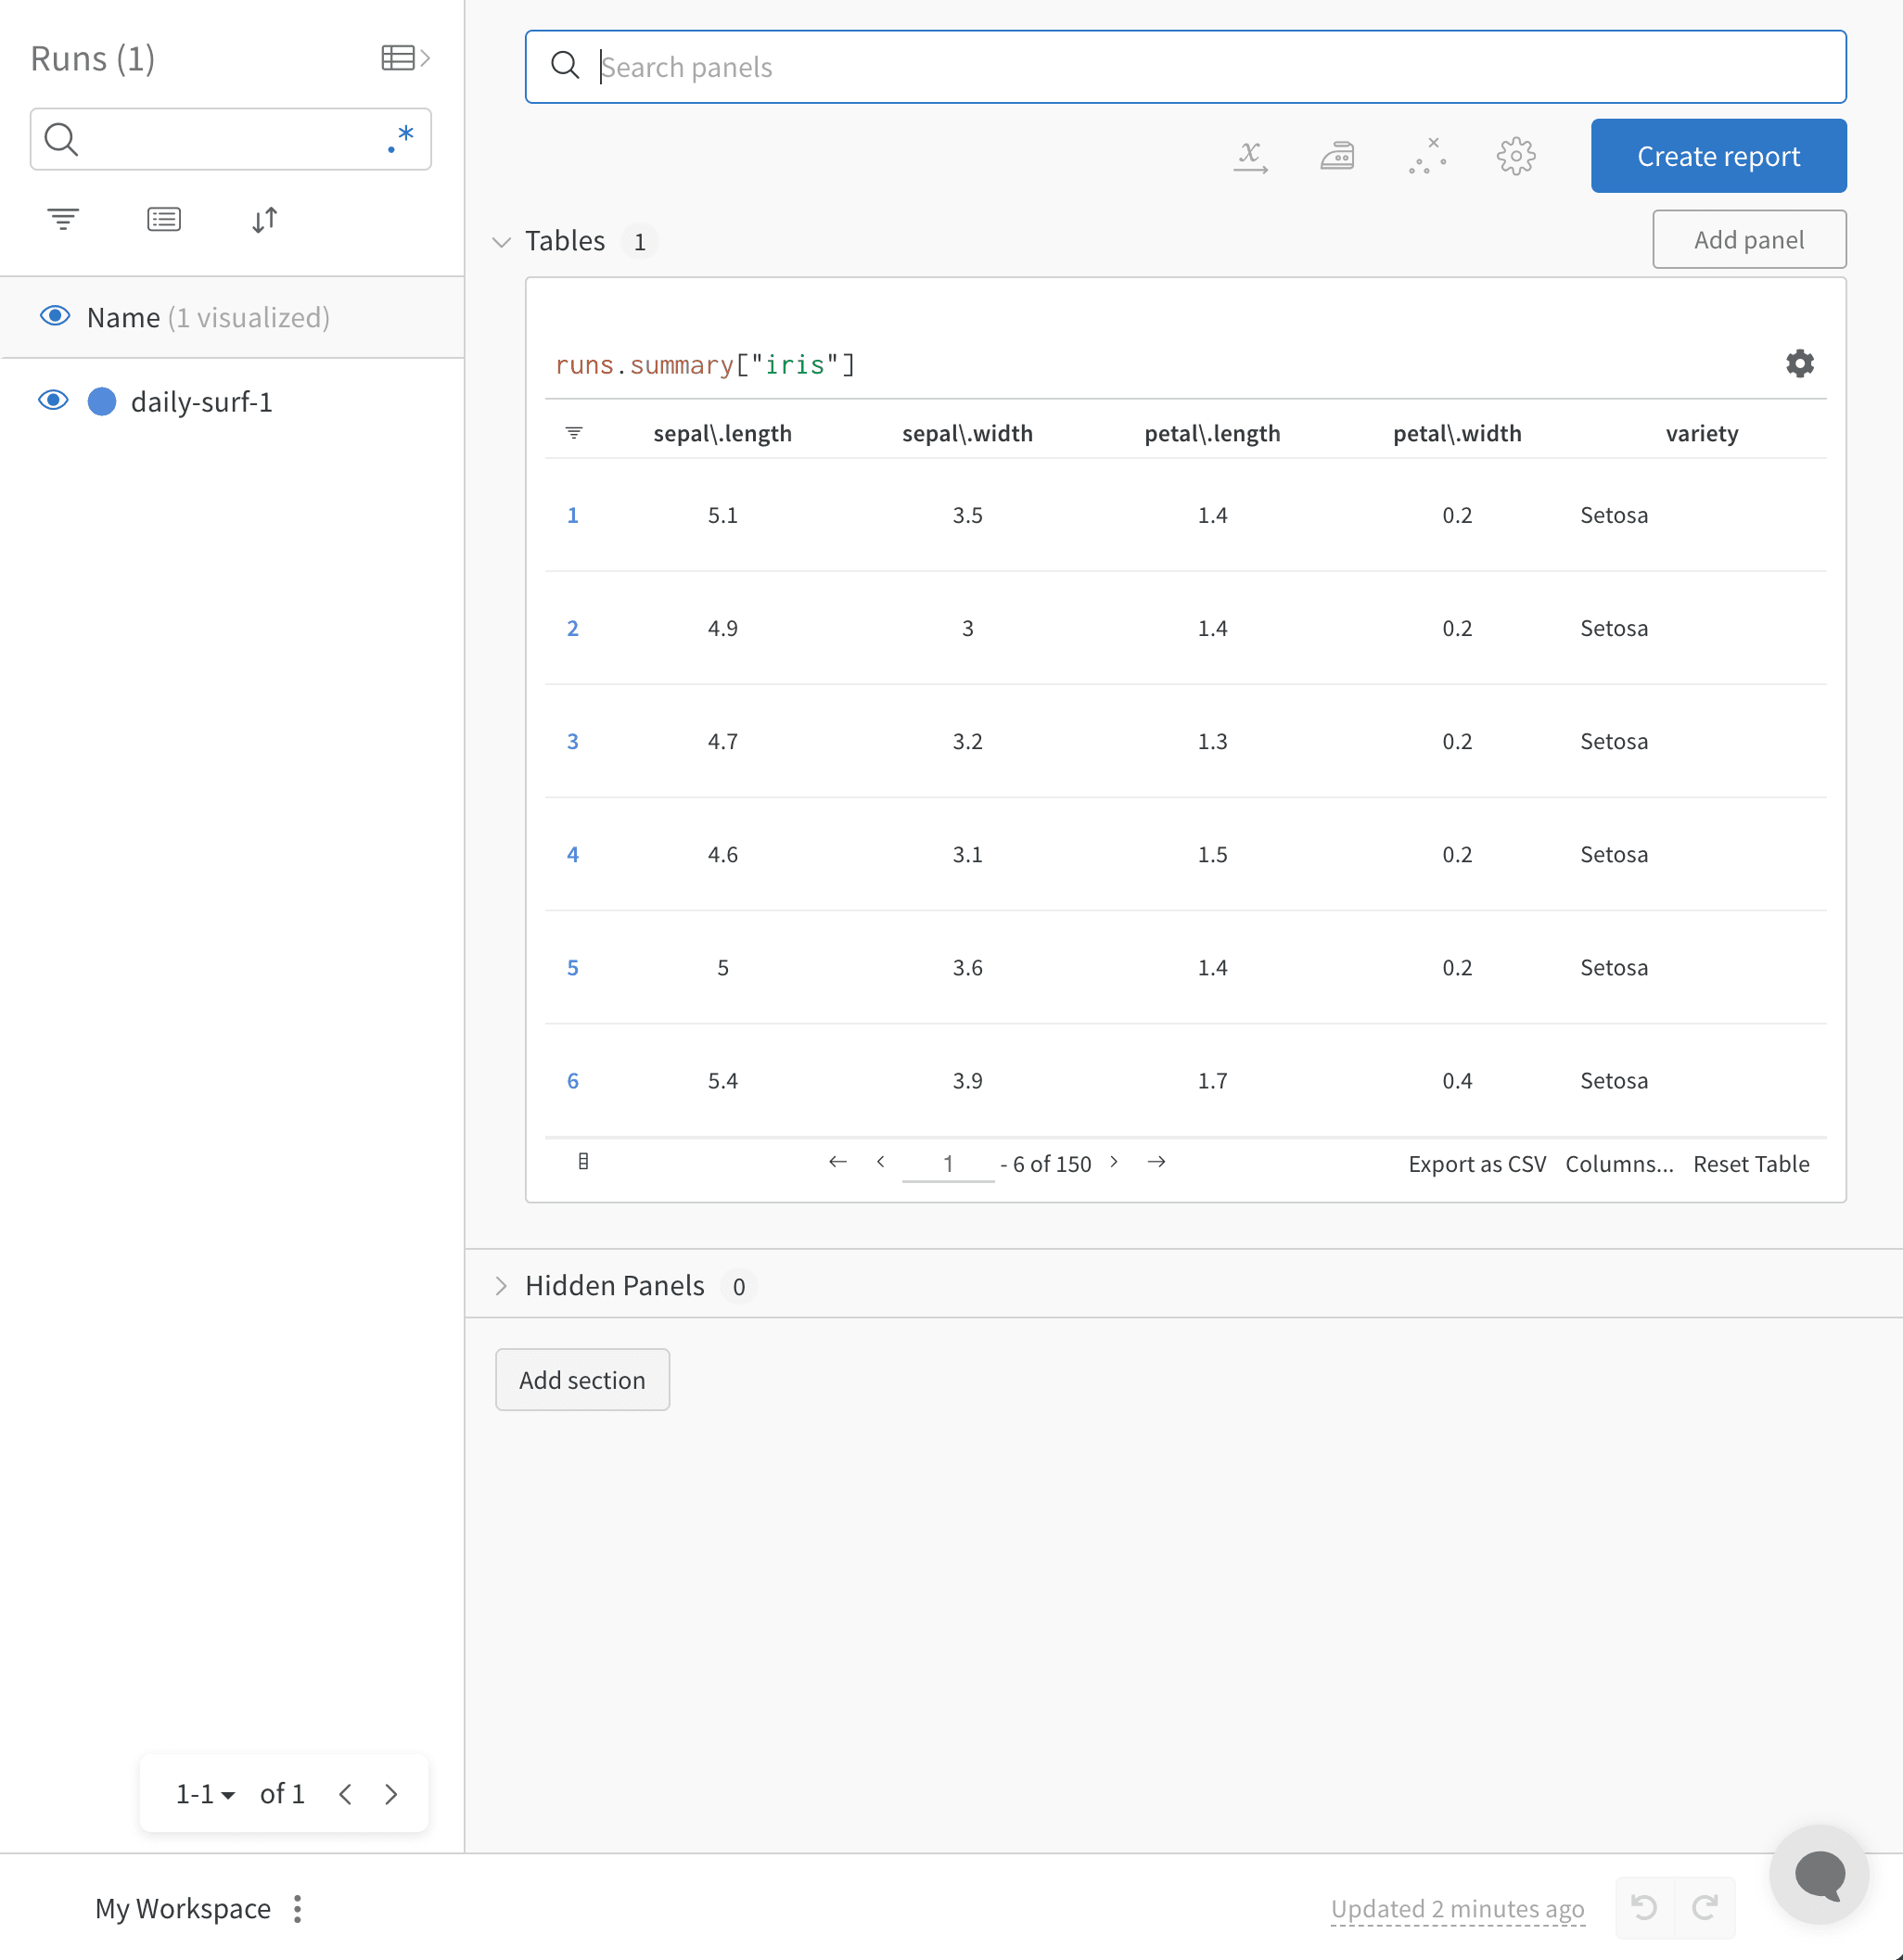
wandb.init() API는 run에 데이터를 로깅하는 새 백그라운드 프로세스를 생성하고, 기본적으로 데이터를 wandb.ai에 동기화합니다. W&B Workspace 대시보드에서 실시간 시각화를 확인하세요. 다음 이미지는 코드 스니펫 예시를 실행한 출력을 보여줍니다.
Experiments CSV 파일 임포트 및 로깅하기
실험 세부 정보가 CSV 파일에 저장되어 있는 경우도 있습니다. 이러한 CSV 파일에는 일반적으로 다음과 같은 세부 정보가 포함됩니다.- 실험 run의 이름
- 초기 노트
- 실험을 구분하기 위한 태그
- 실험에 필요한 설정(Sweeps 하이퍼파라미터 튜닝도 함께 활용할 수 있습니다)
W&B는 실험 CSV 파일을 W&B Experiment Run으로 변환할 수 있습니다. 다음 코드 스니펫과 스크립트에서는 실험 CSV 파일을 임포트하고 로깅하는 방법을 보여줍니다.
- 먼저 CSV 파일을 읽어 Pandas 데이터프레임으로 변환하세요.
"experiments.csv"는 실제 CSV 파일 이름으로 바꾸세요.
-
다음으로,
wandb.init()으로 새 W&B run을 시작하여 W&B에 추적하고 로깅하세요:
run.log() 명령을 사용하세요:
define_metric API를 사용해 최종 summary 메트릭을 로깅하여 run의 결과를 정의할 수 있습니다. 이 예제에서는 run.summary.update()를 사용해 run에 summary 메트릭을 추가합니다.