

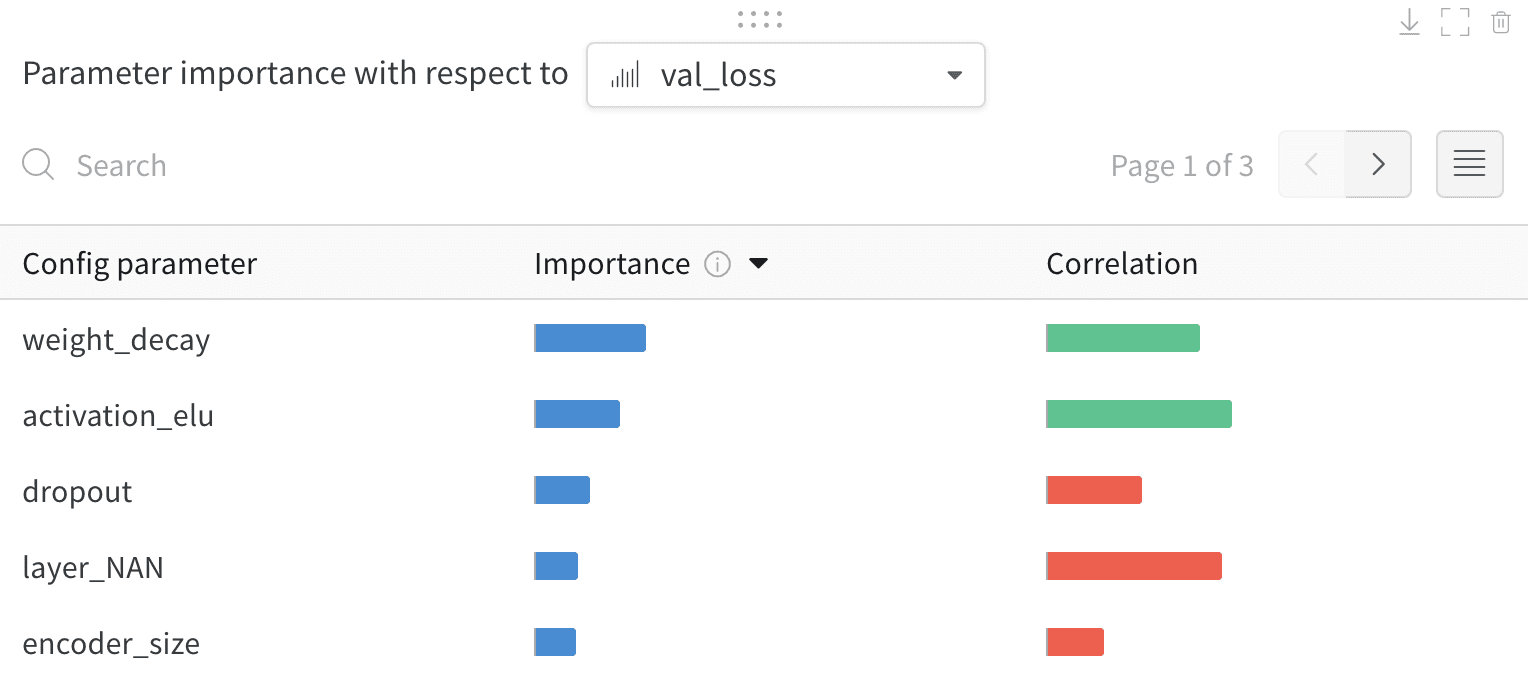
val_loss) 간의 선형 상관관계입니다. 상관관계가 높다는 것은 하이퍼파라미터 값이 높을수록 메트릭 값도 높아지고, 그 반대도 마찬가지라는 의미입니다. 상관관계는 유용한 메트릭이지만 입력 간의 2차 상호작용을 캡처할 수 없으며, 범위가 서로 다른 입력을 비교할 때는 결과를 해석하기 어려워질 수 있습니다.
W&B는 중요도 메트릭도 계산합니다. W&B는 하이퍼파라미터를 입력으로, 메트릭을 목표 출력으로 하여 랜덤 포레스트를 트레이닝한 다음, 해당 랜덤 포레스트의 특성 중요도 값을 보여 줍니다.
이 기법은 Jeremy Howard와의 대화에서 착안했습니다. Jeremy는 Fast.ai에서 랜덤 포레스트 특성 중요도를 활용해 하이퍼파라미터 공간을 탐색하는 방법을 처음 도입했습니다. 이 분석의 배경에 대한 자세한 내용은 Fast.ai 4강 강의와 Fast.ai 4강 포럼 노트를 참조하세요.
하이퍼파라미터 중요도 패널은 서로 상관관계가 높은 하이퍼파라미터 간의 복잡한 상호작용을 풀어냅니다. 모델 성능을 예측하는 데 가장 중요한 하이퍼파라미터가 무엇인지 보여 주므로, 하이퍼파라미터 검색을 더 정교하게 조정할 수 있습니다.
하이퍼파라미터 중요도 패널 만들기
하이퍼파라미터 중요도 패널을 workspace에 추가하려면:- W&B 프로젝트로 이동하세요.
- Add panels 버튼을 선택하세요.
- CHARTS 드롭다운을 확장한 다음 드롭다운에서 Parallel coordinates를 선택하세요.
빈 패널이 나타나면 run이 그룹화되지 않았는지 확인하세요.
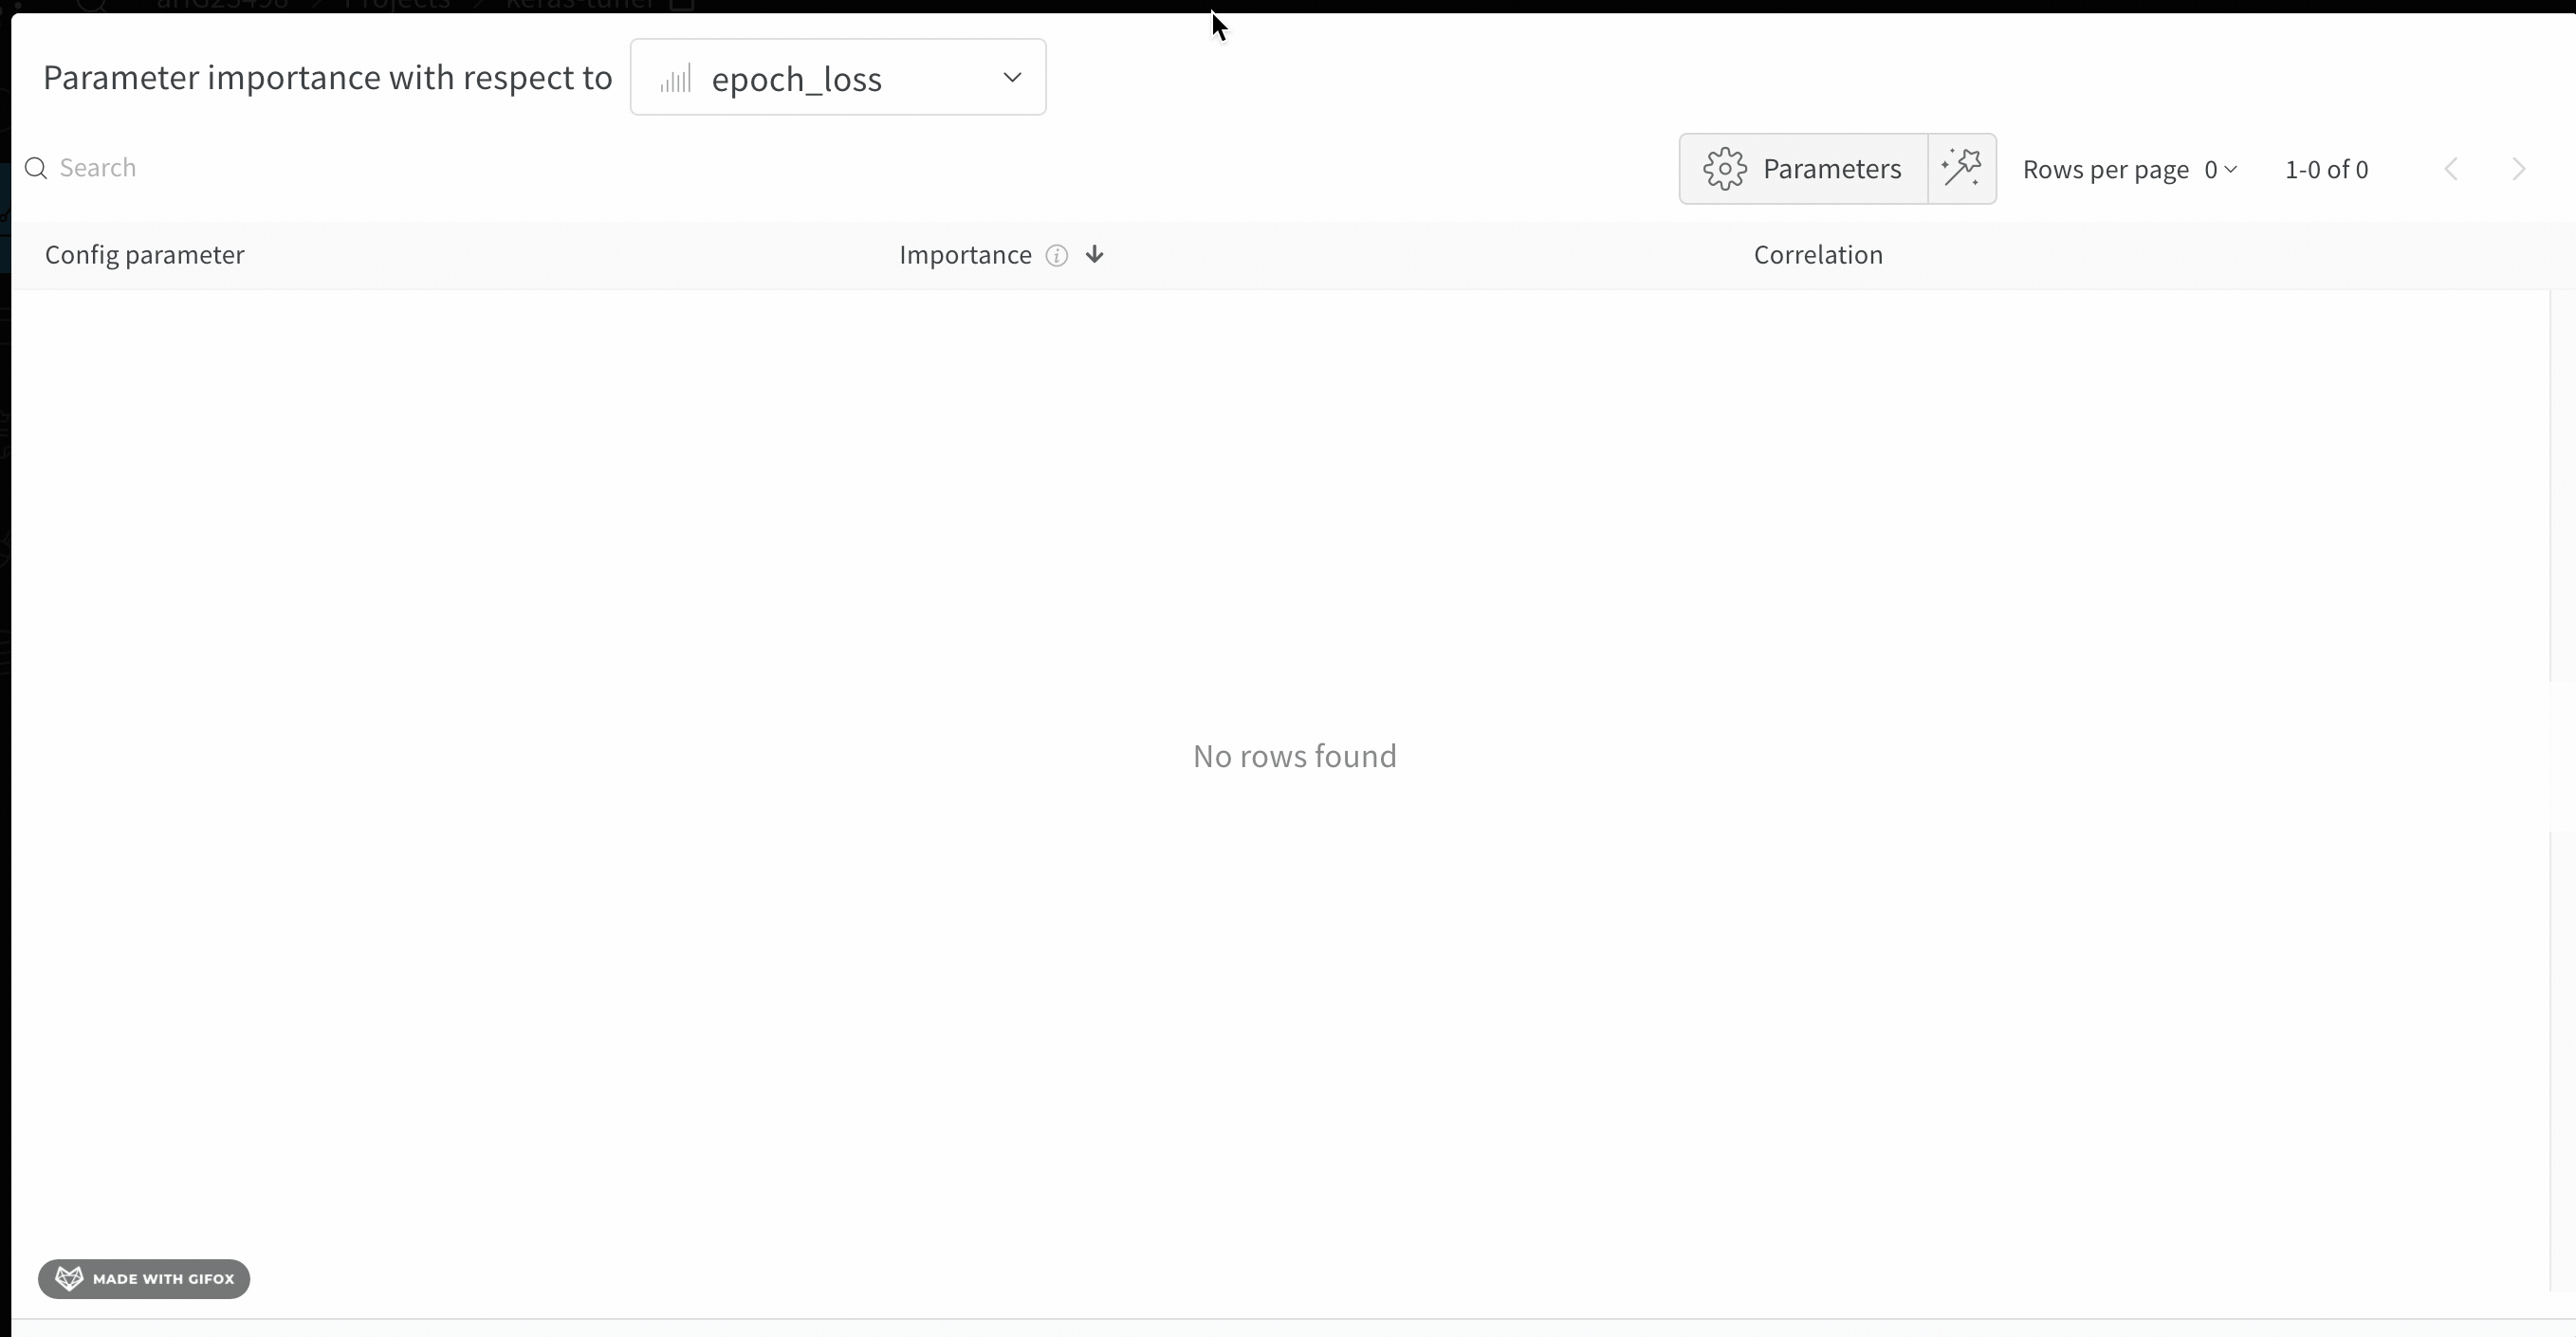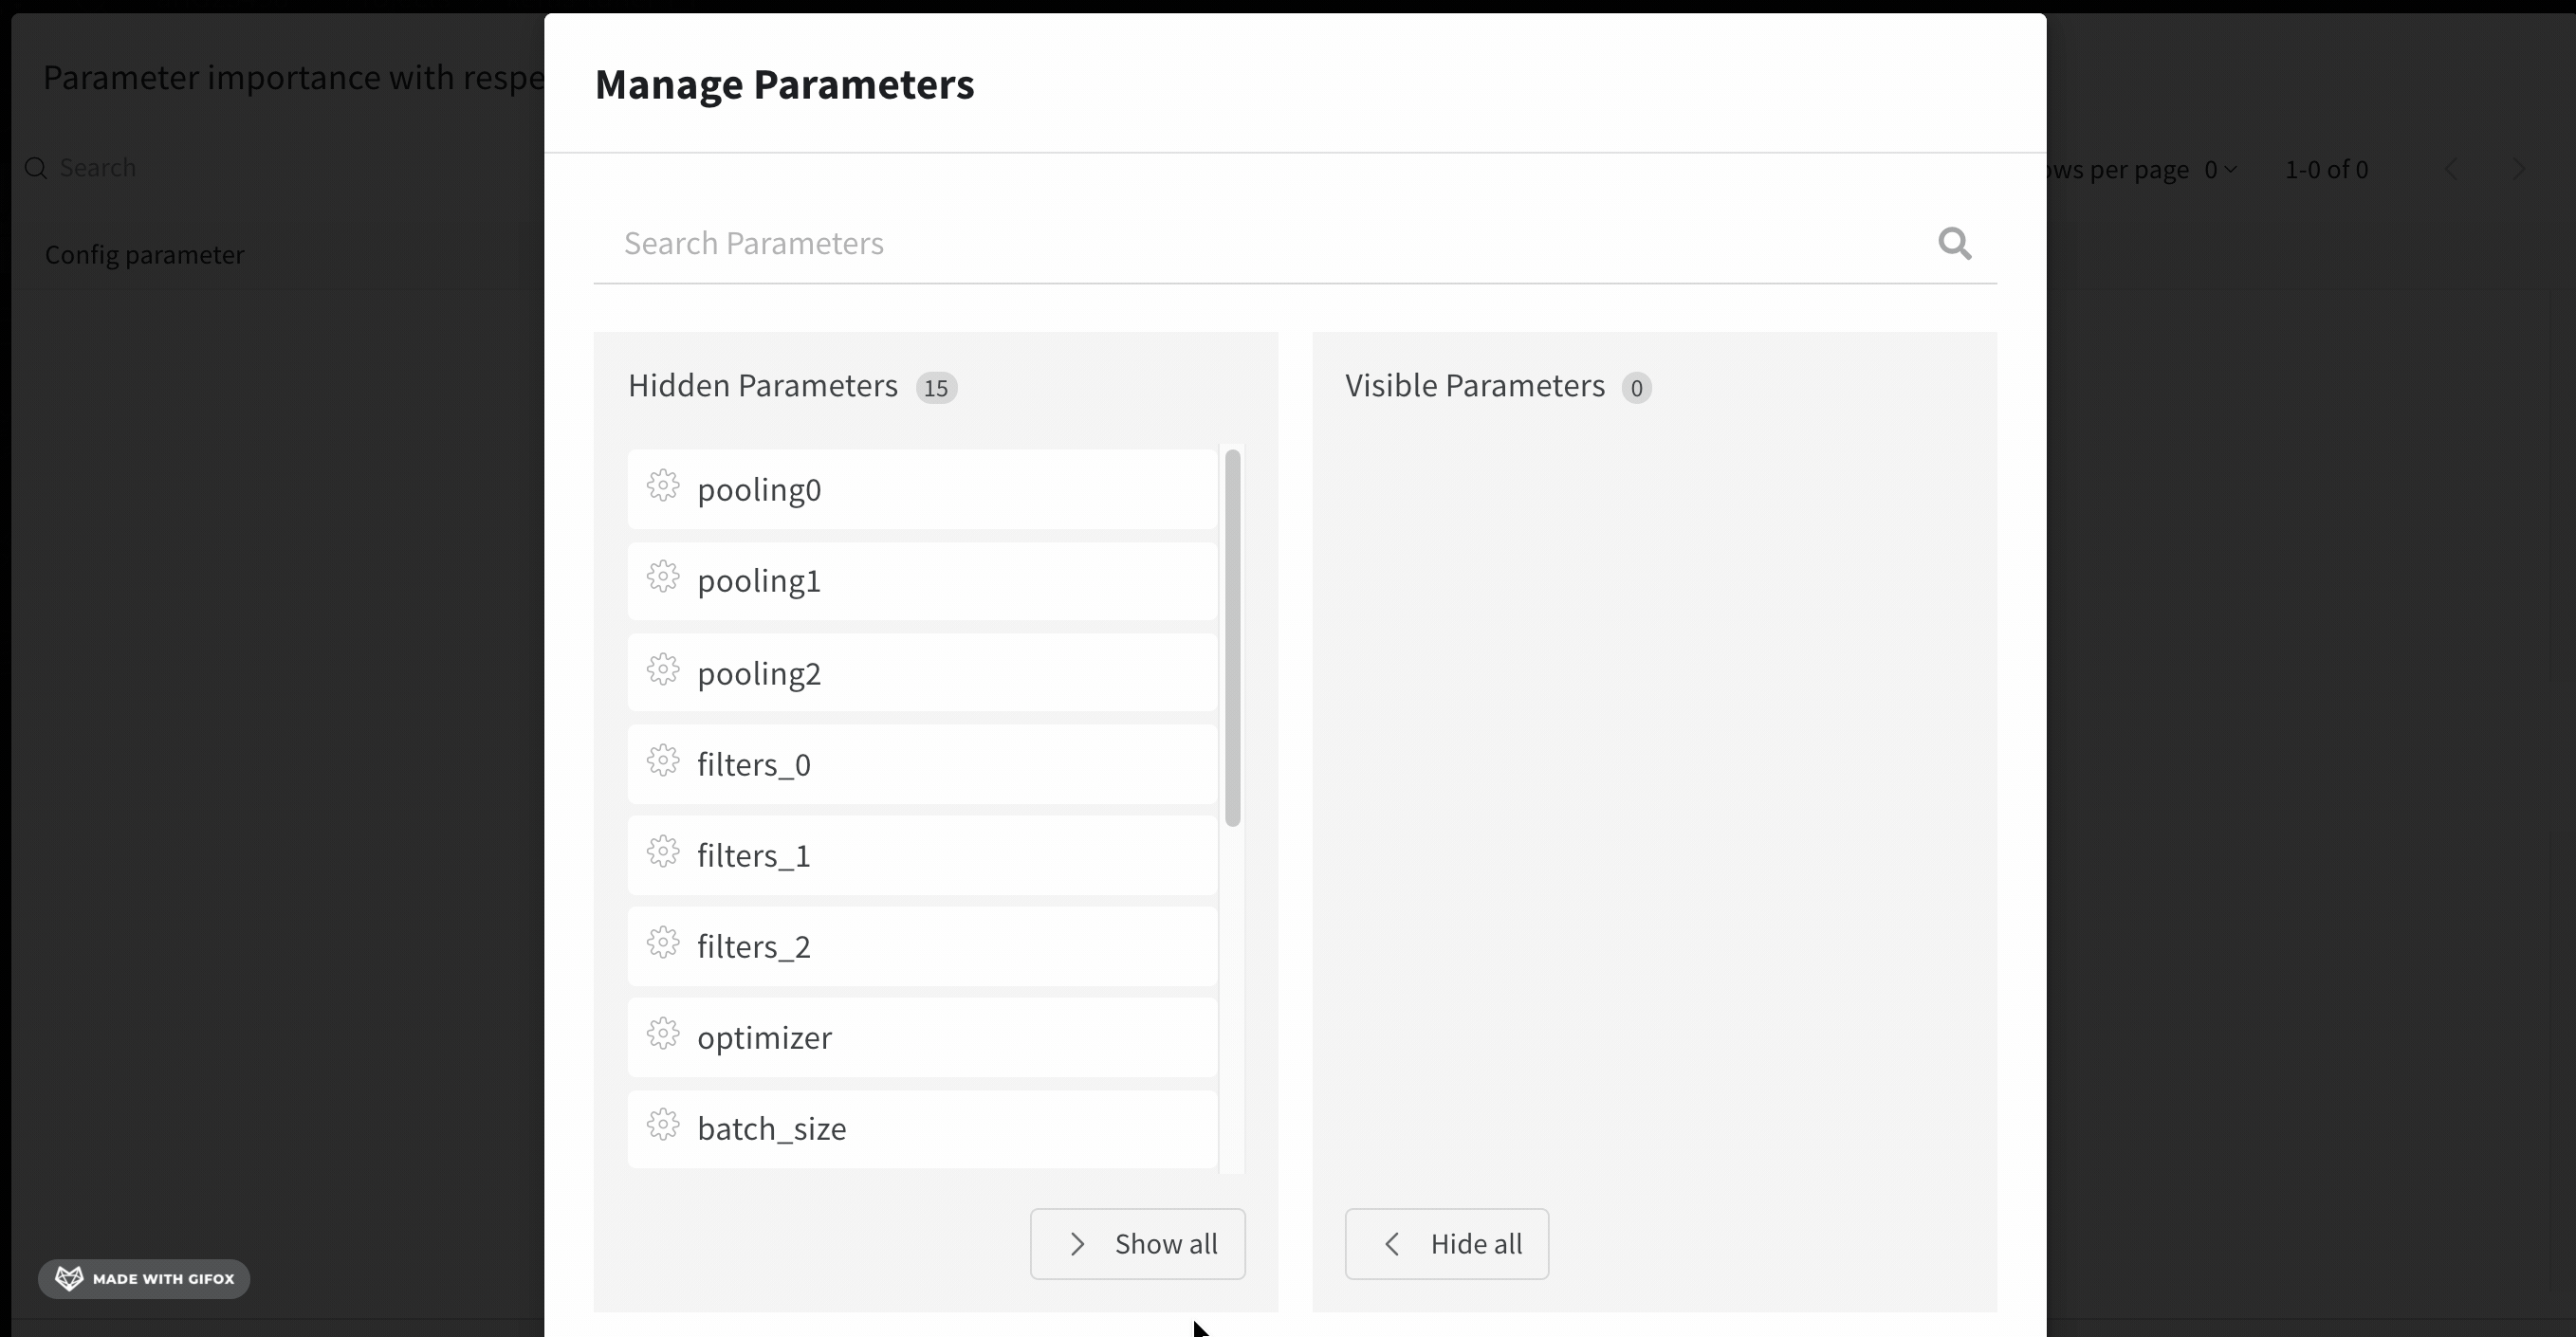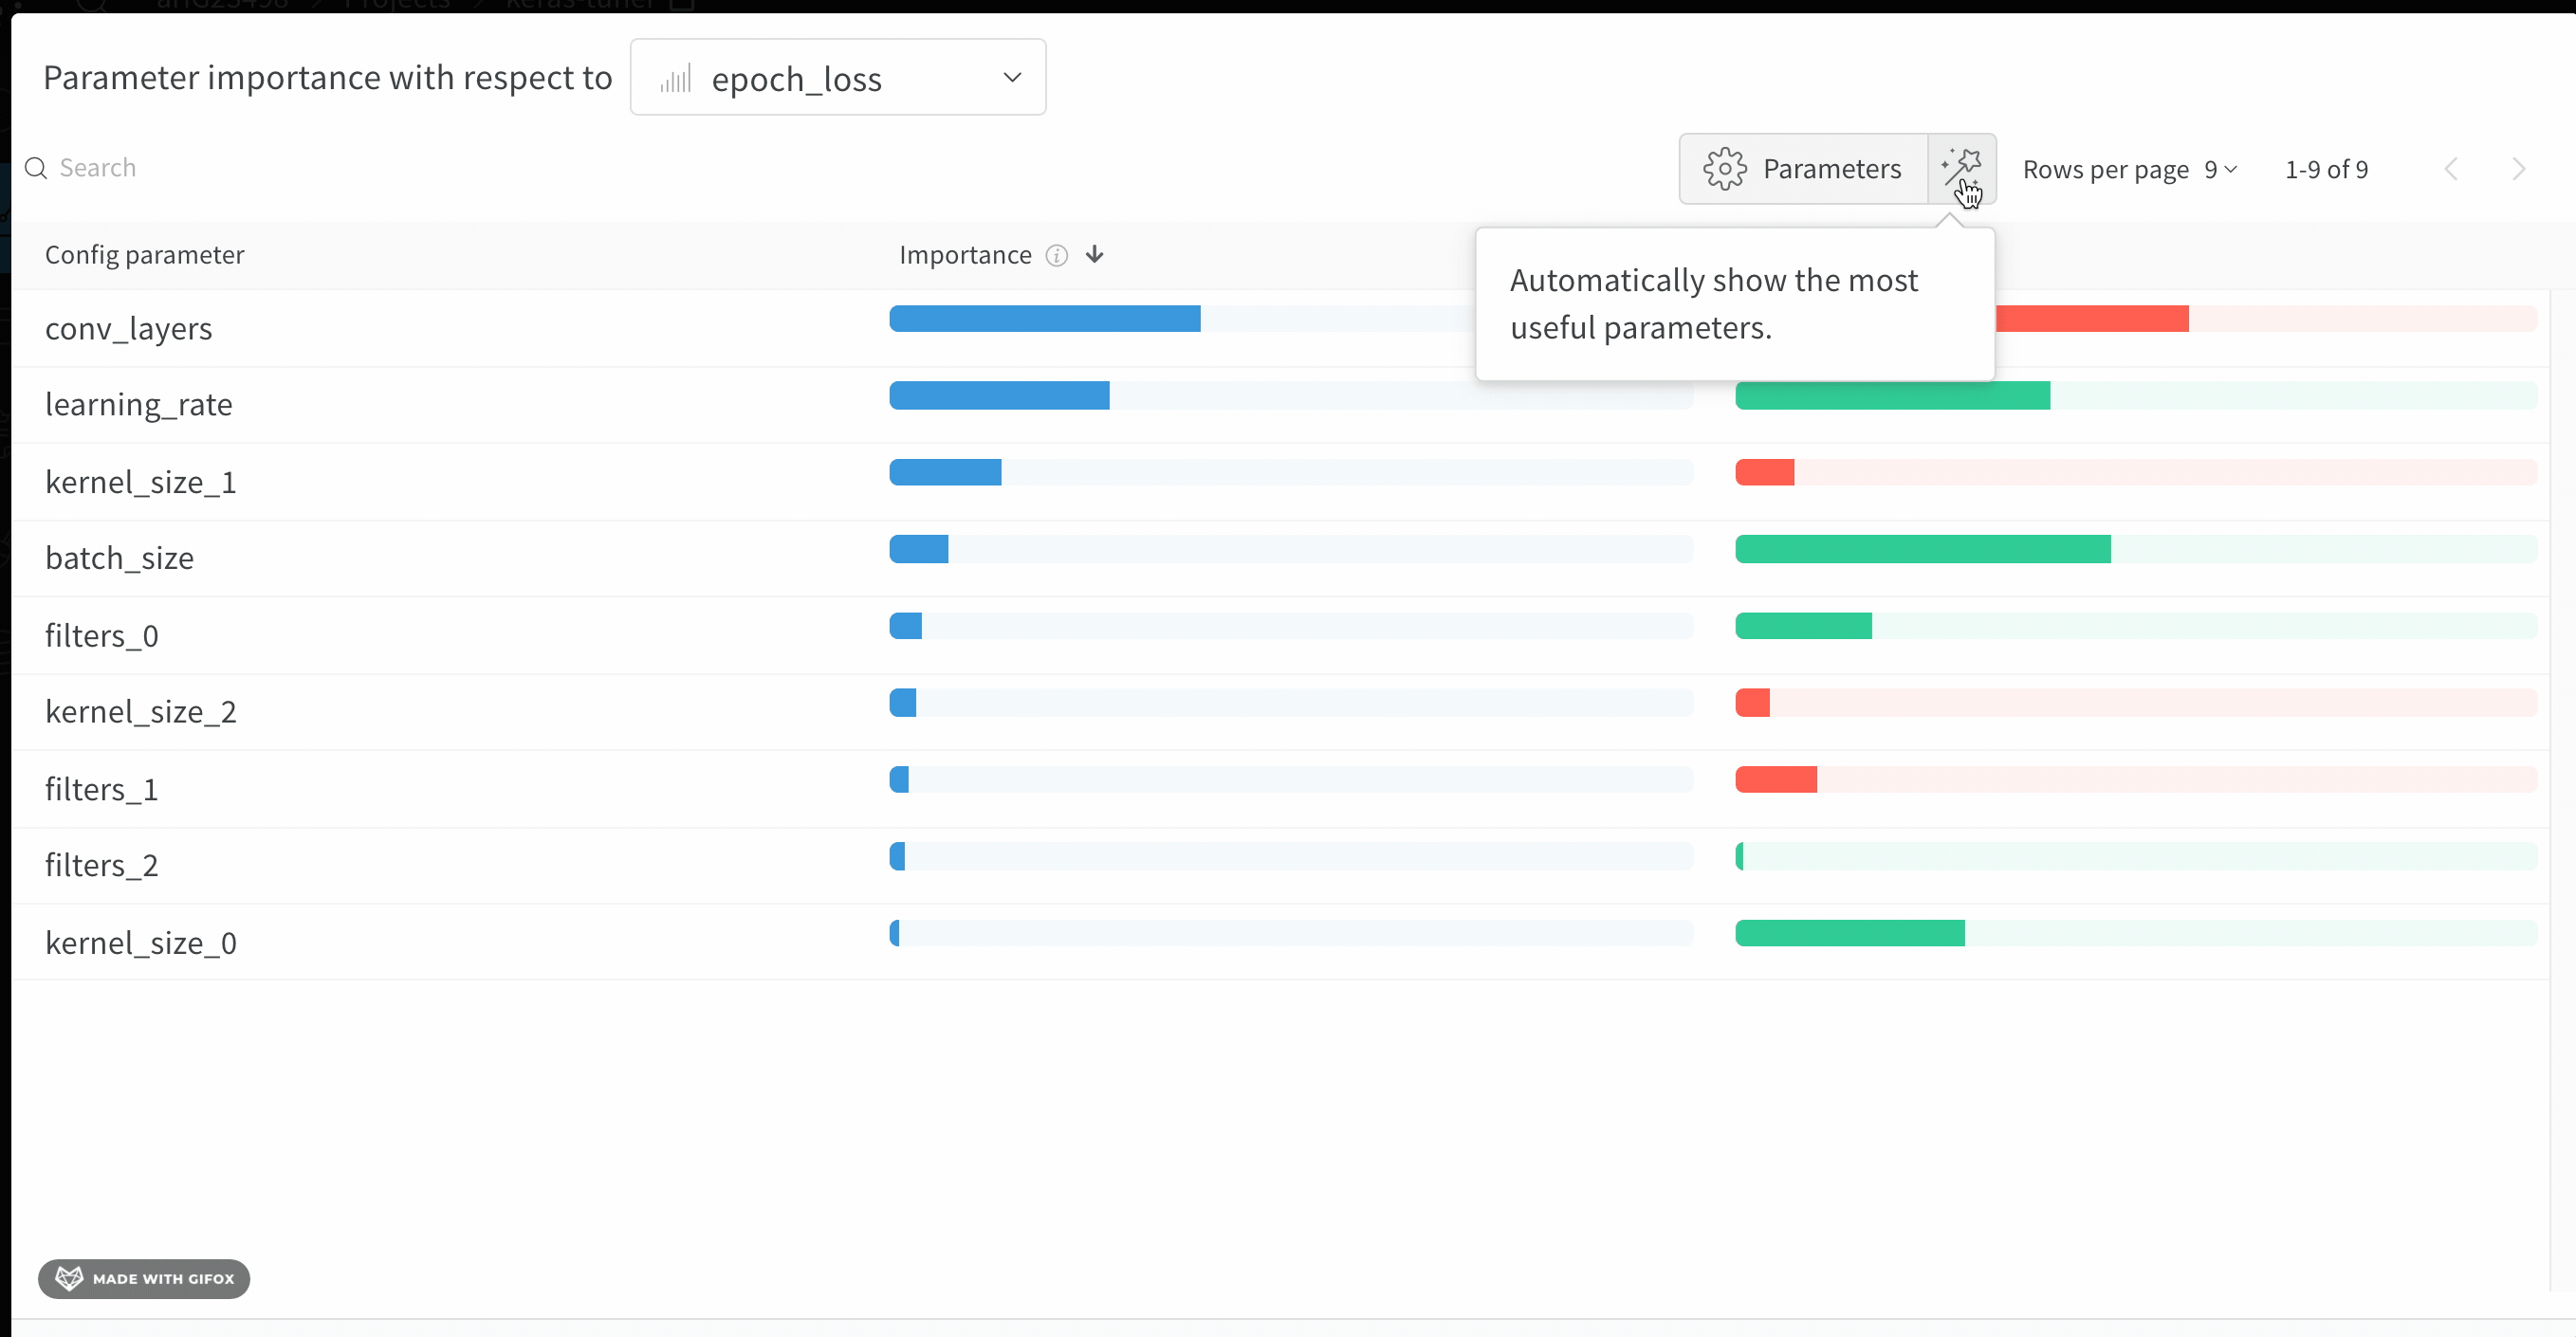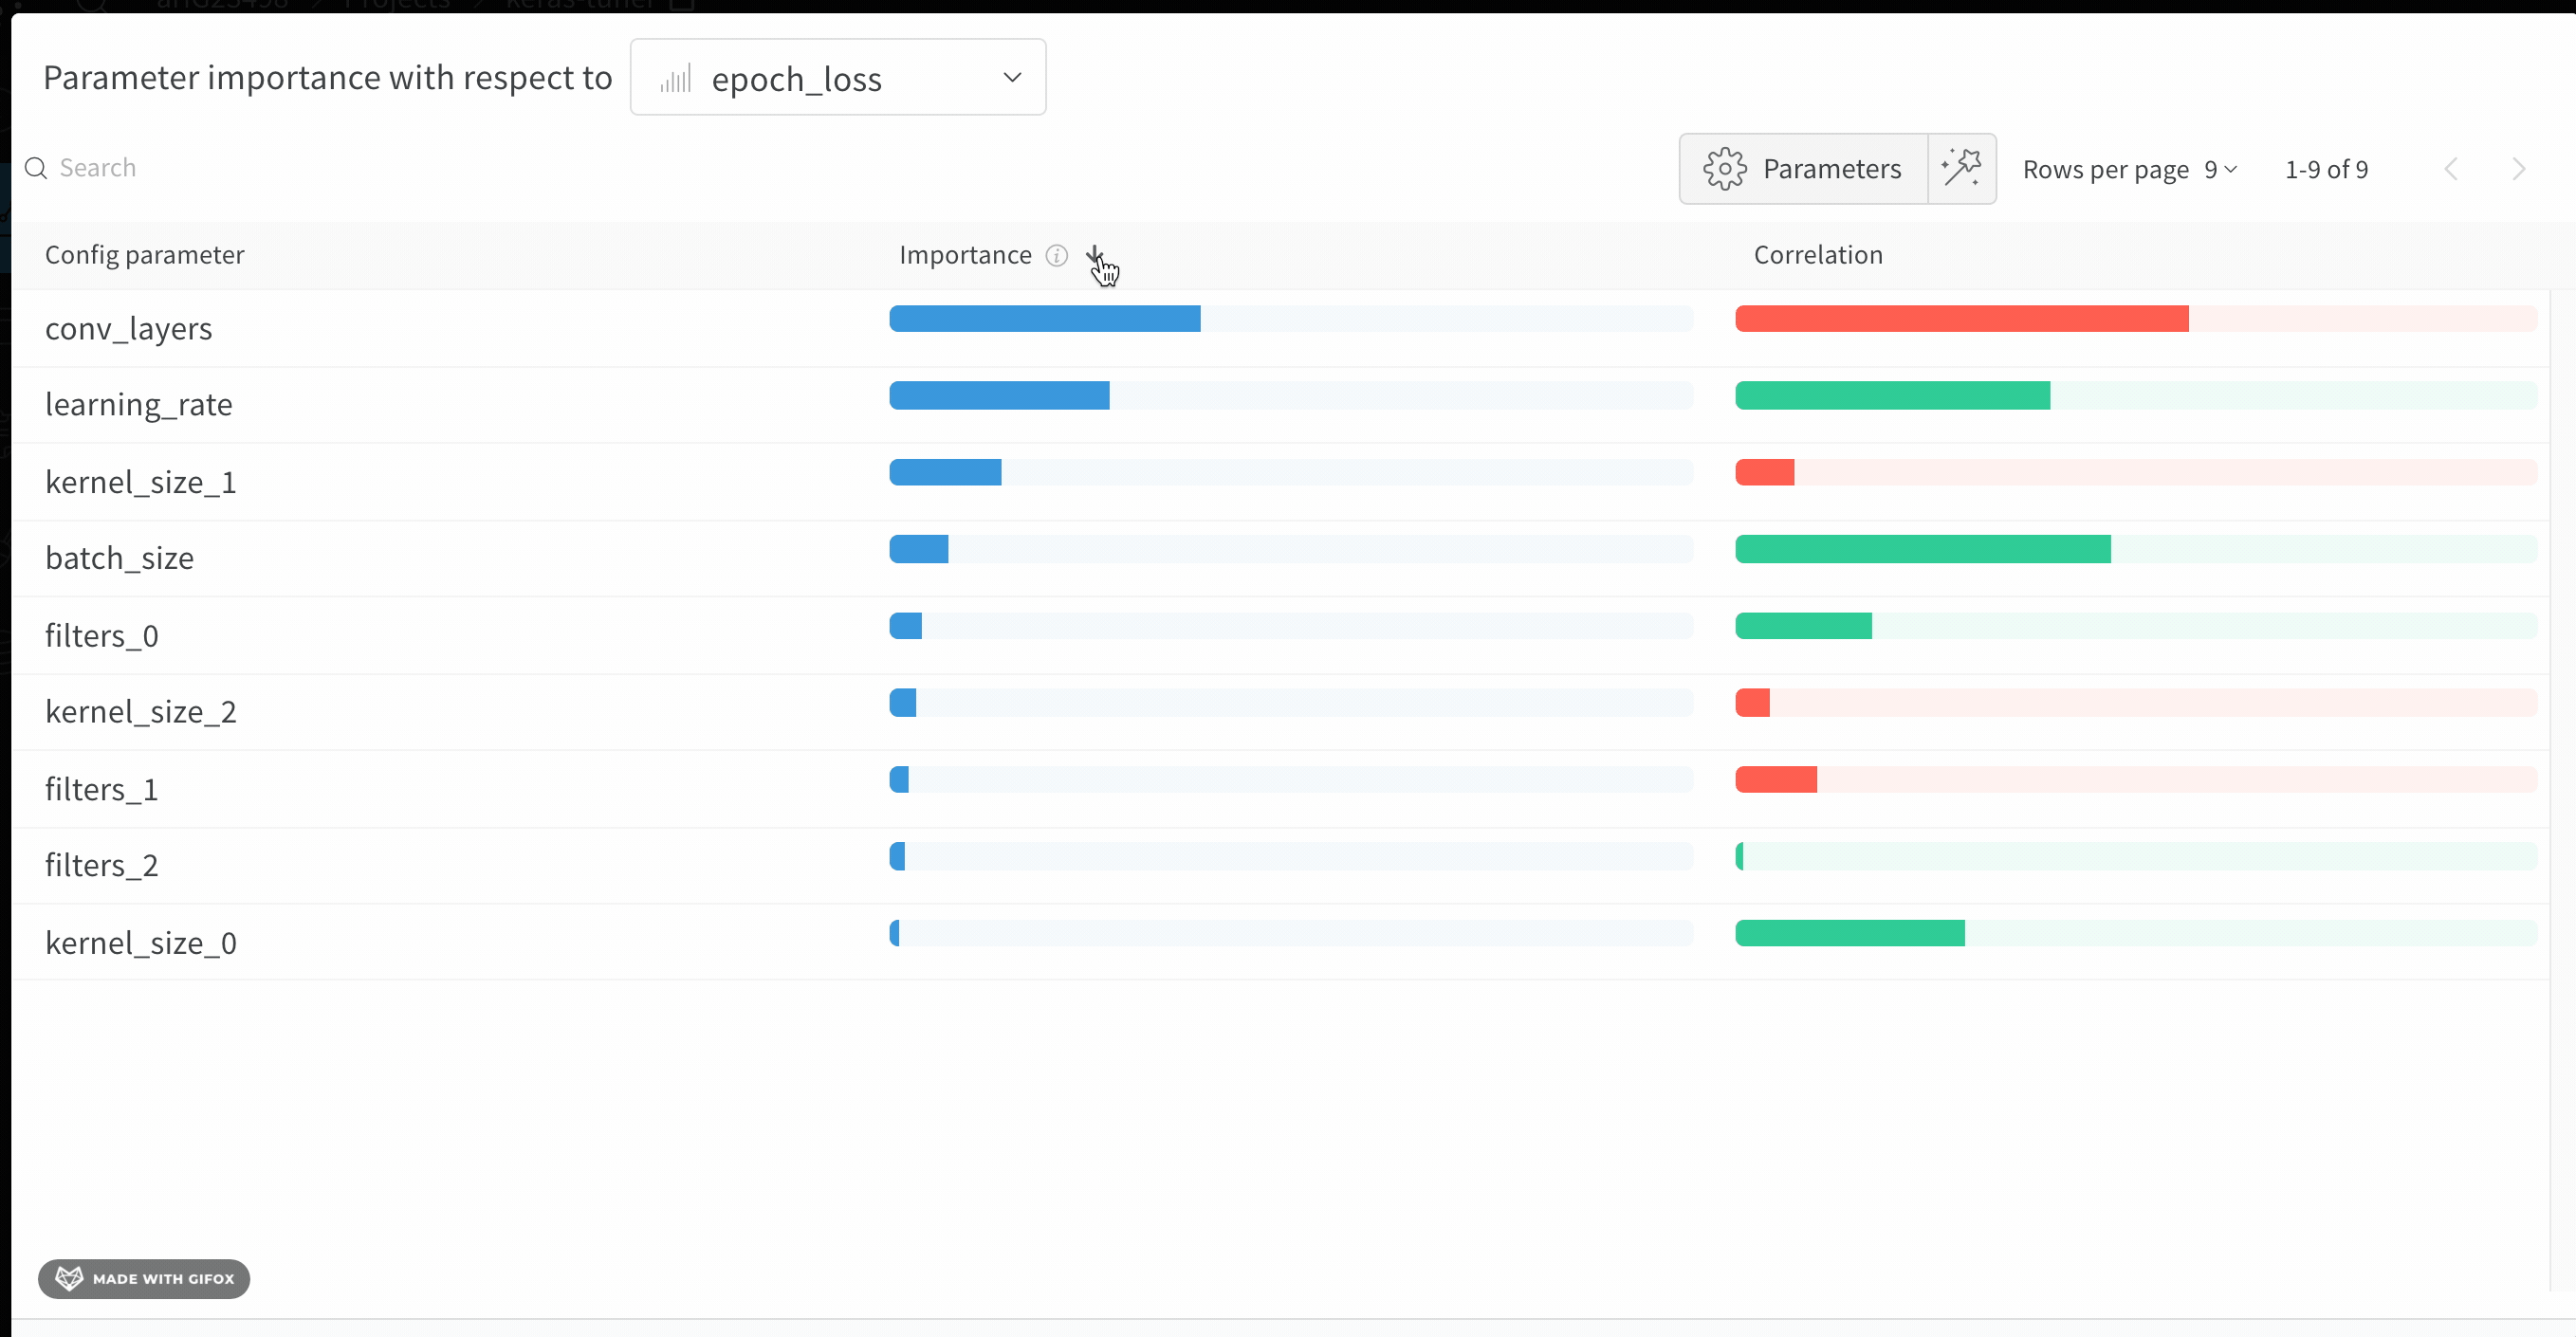
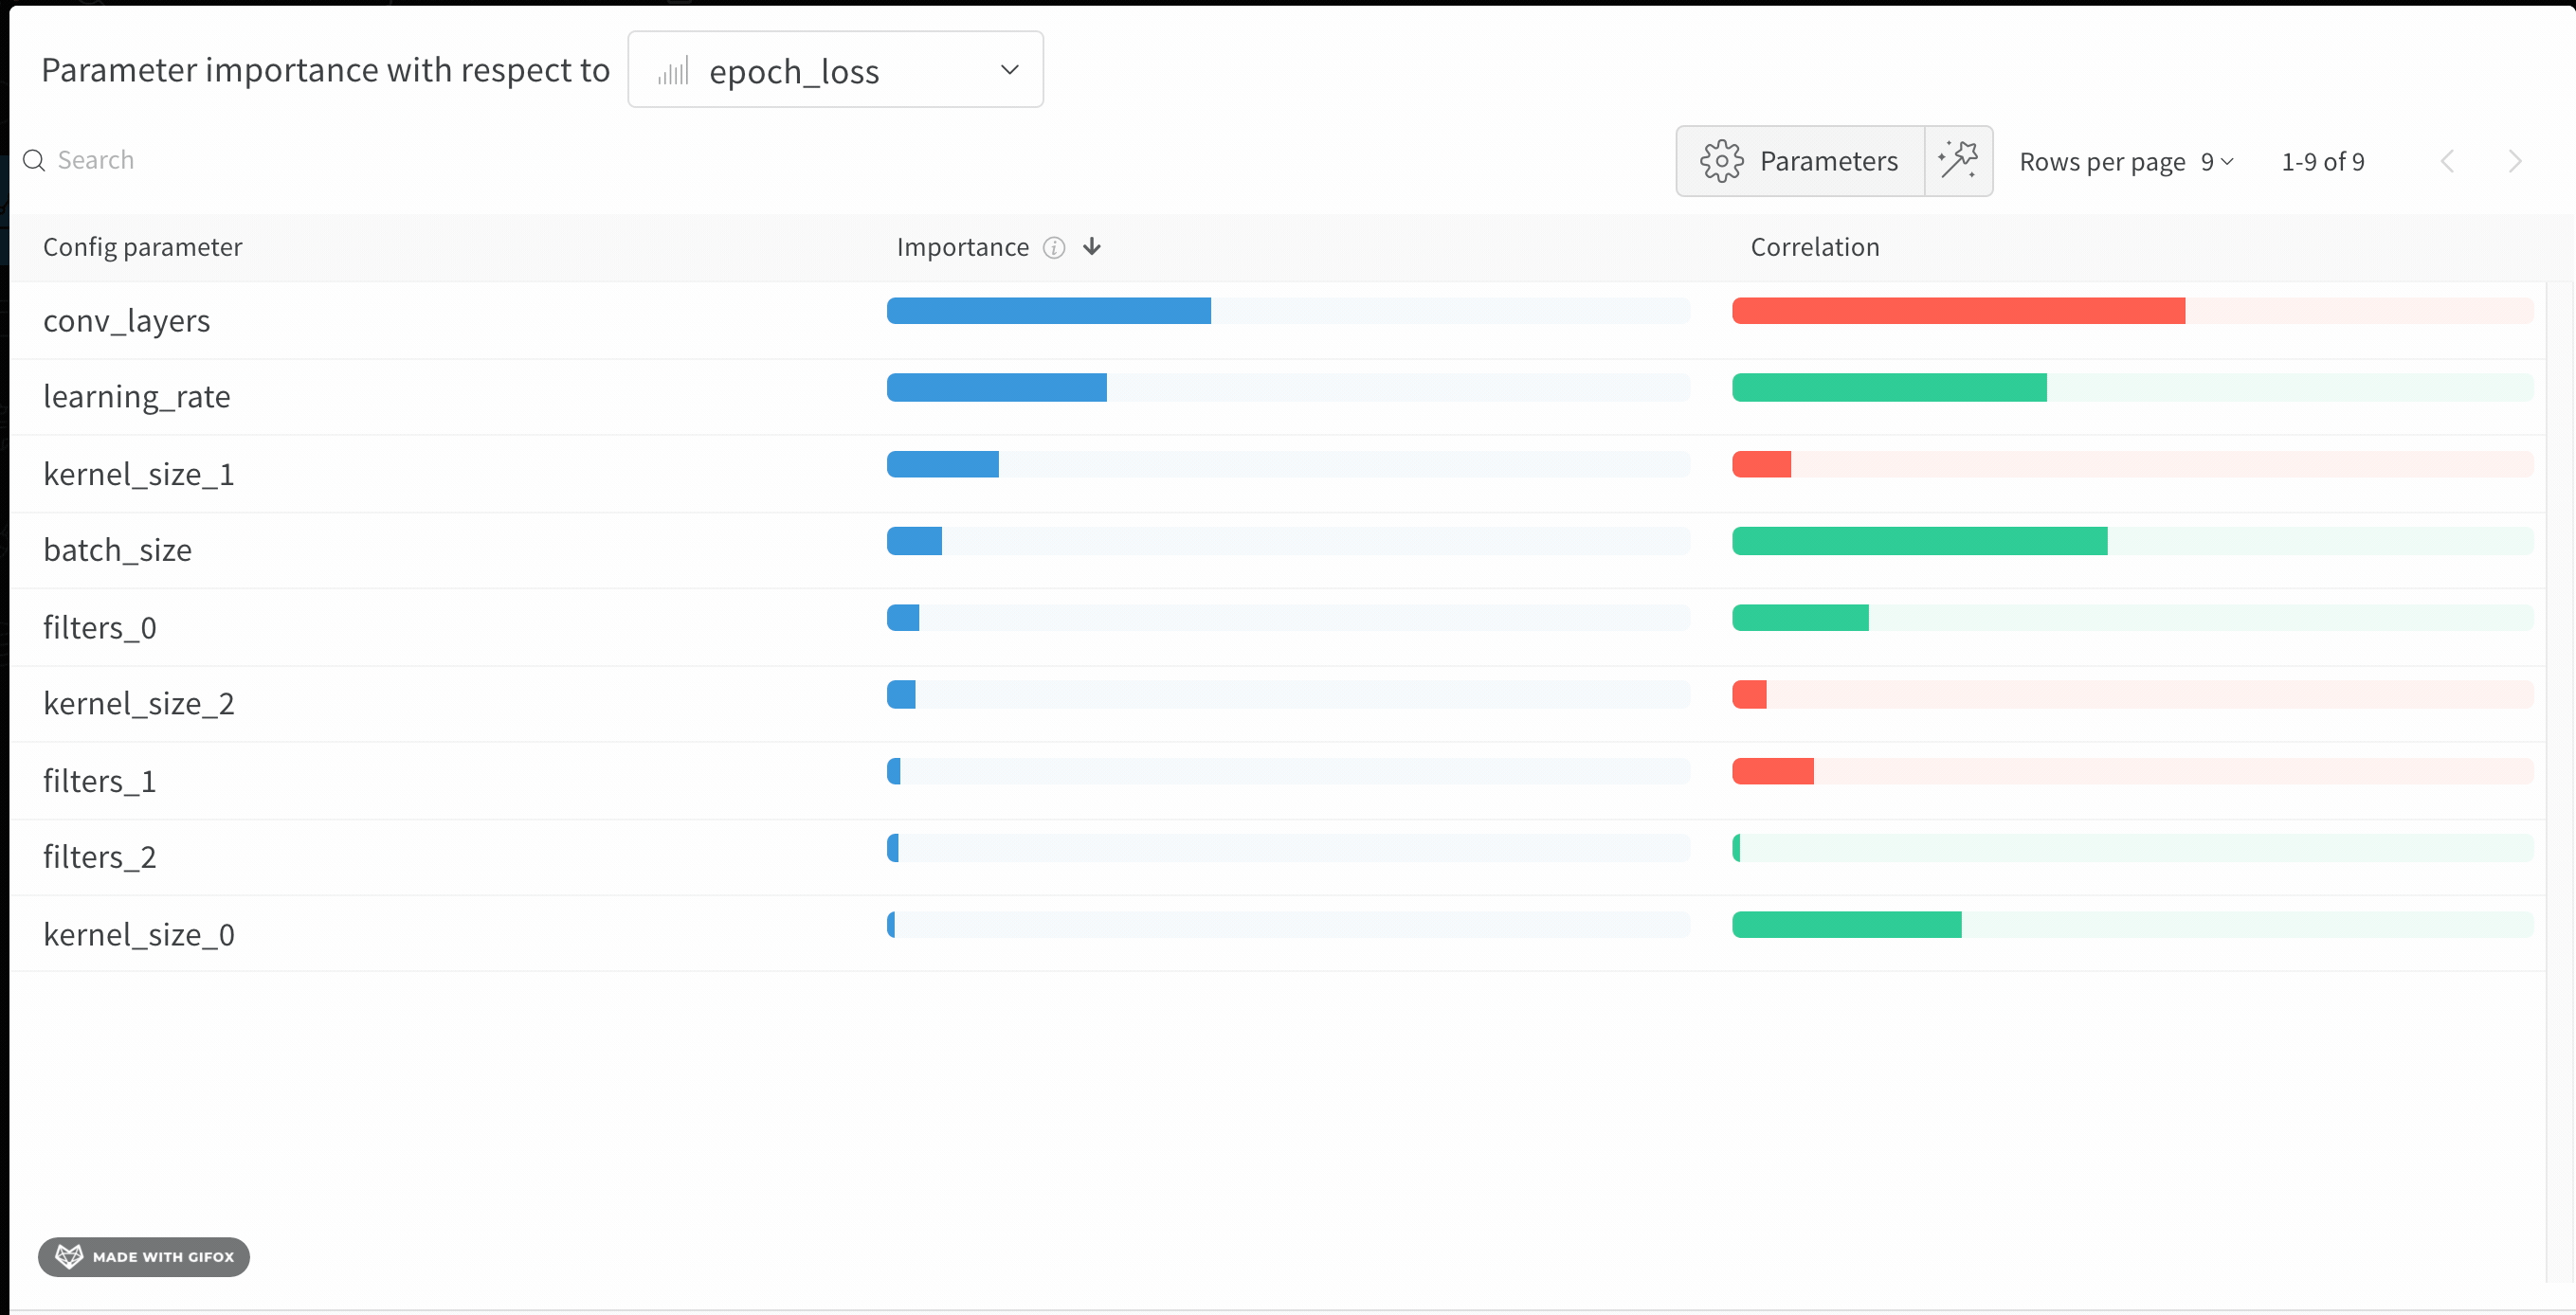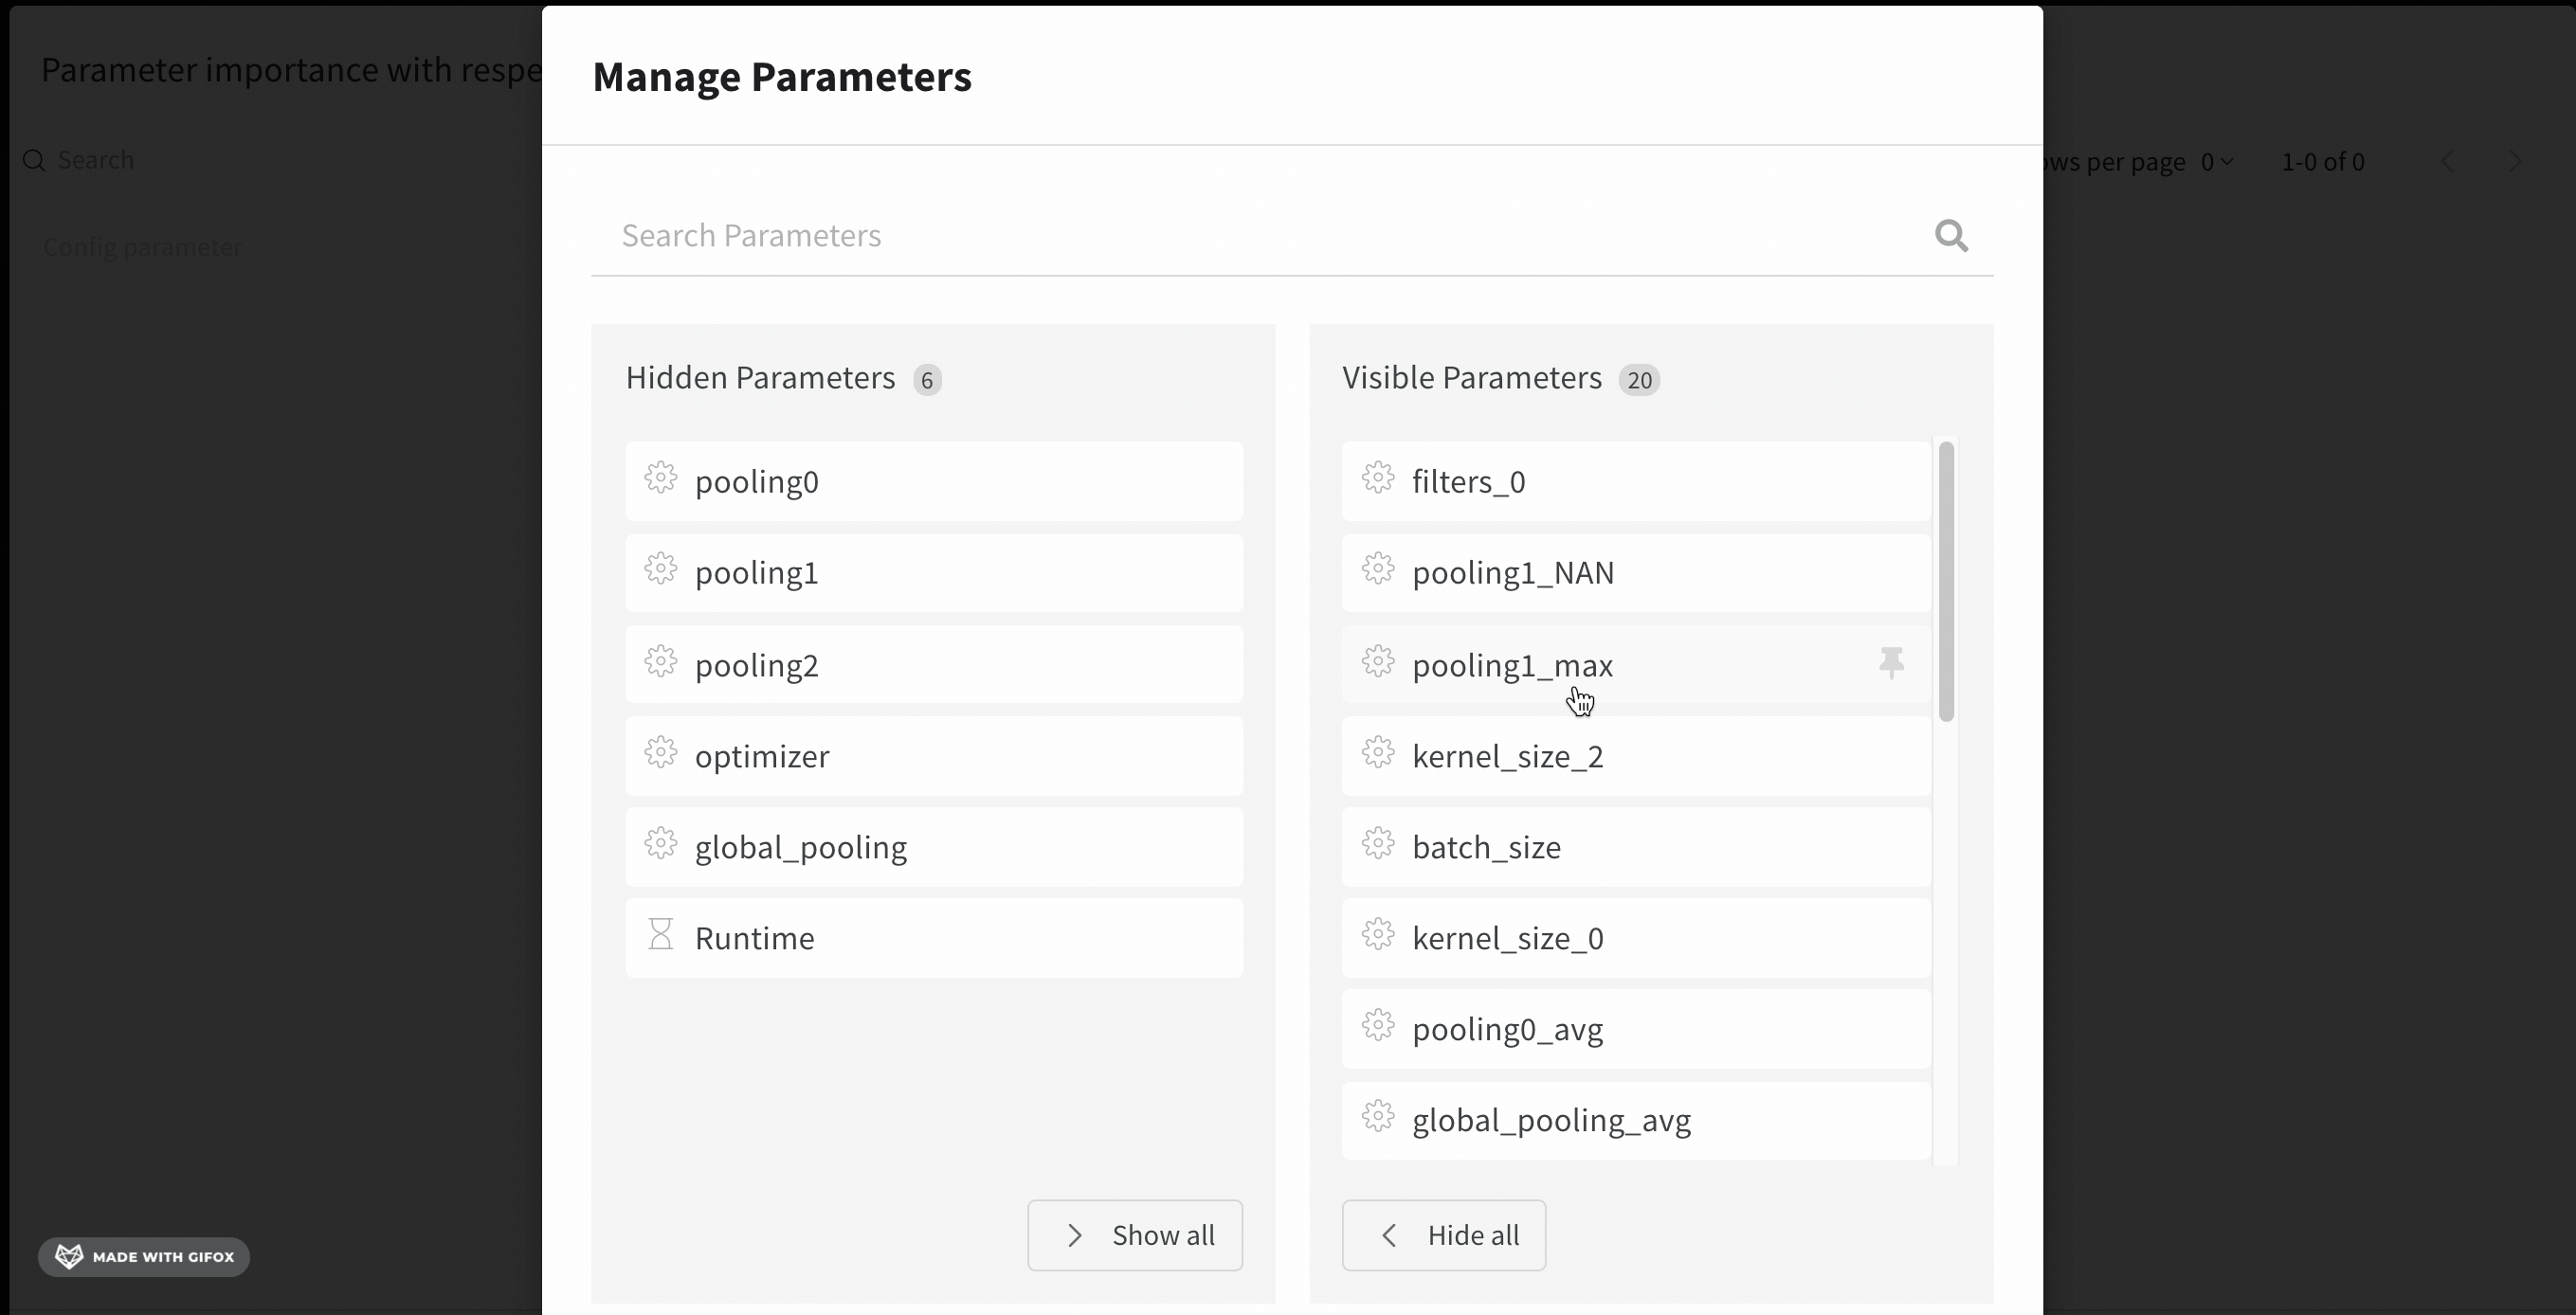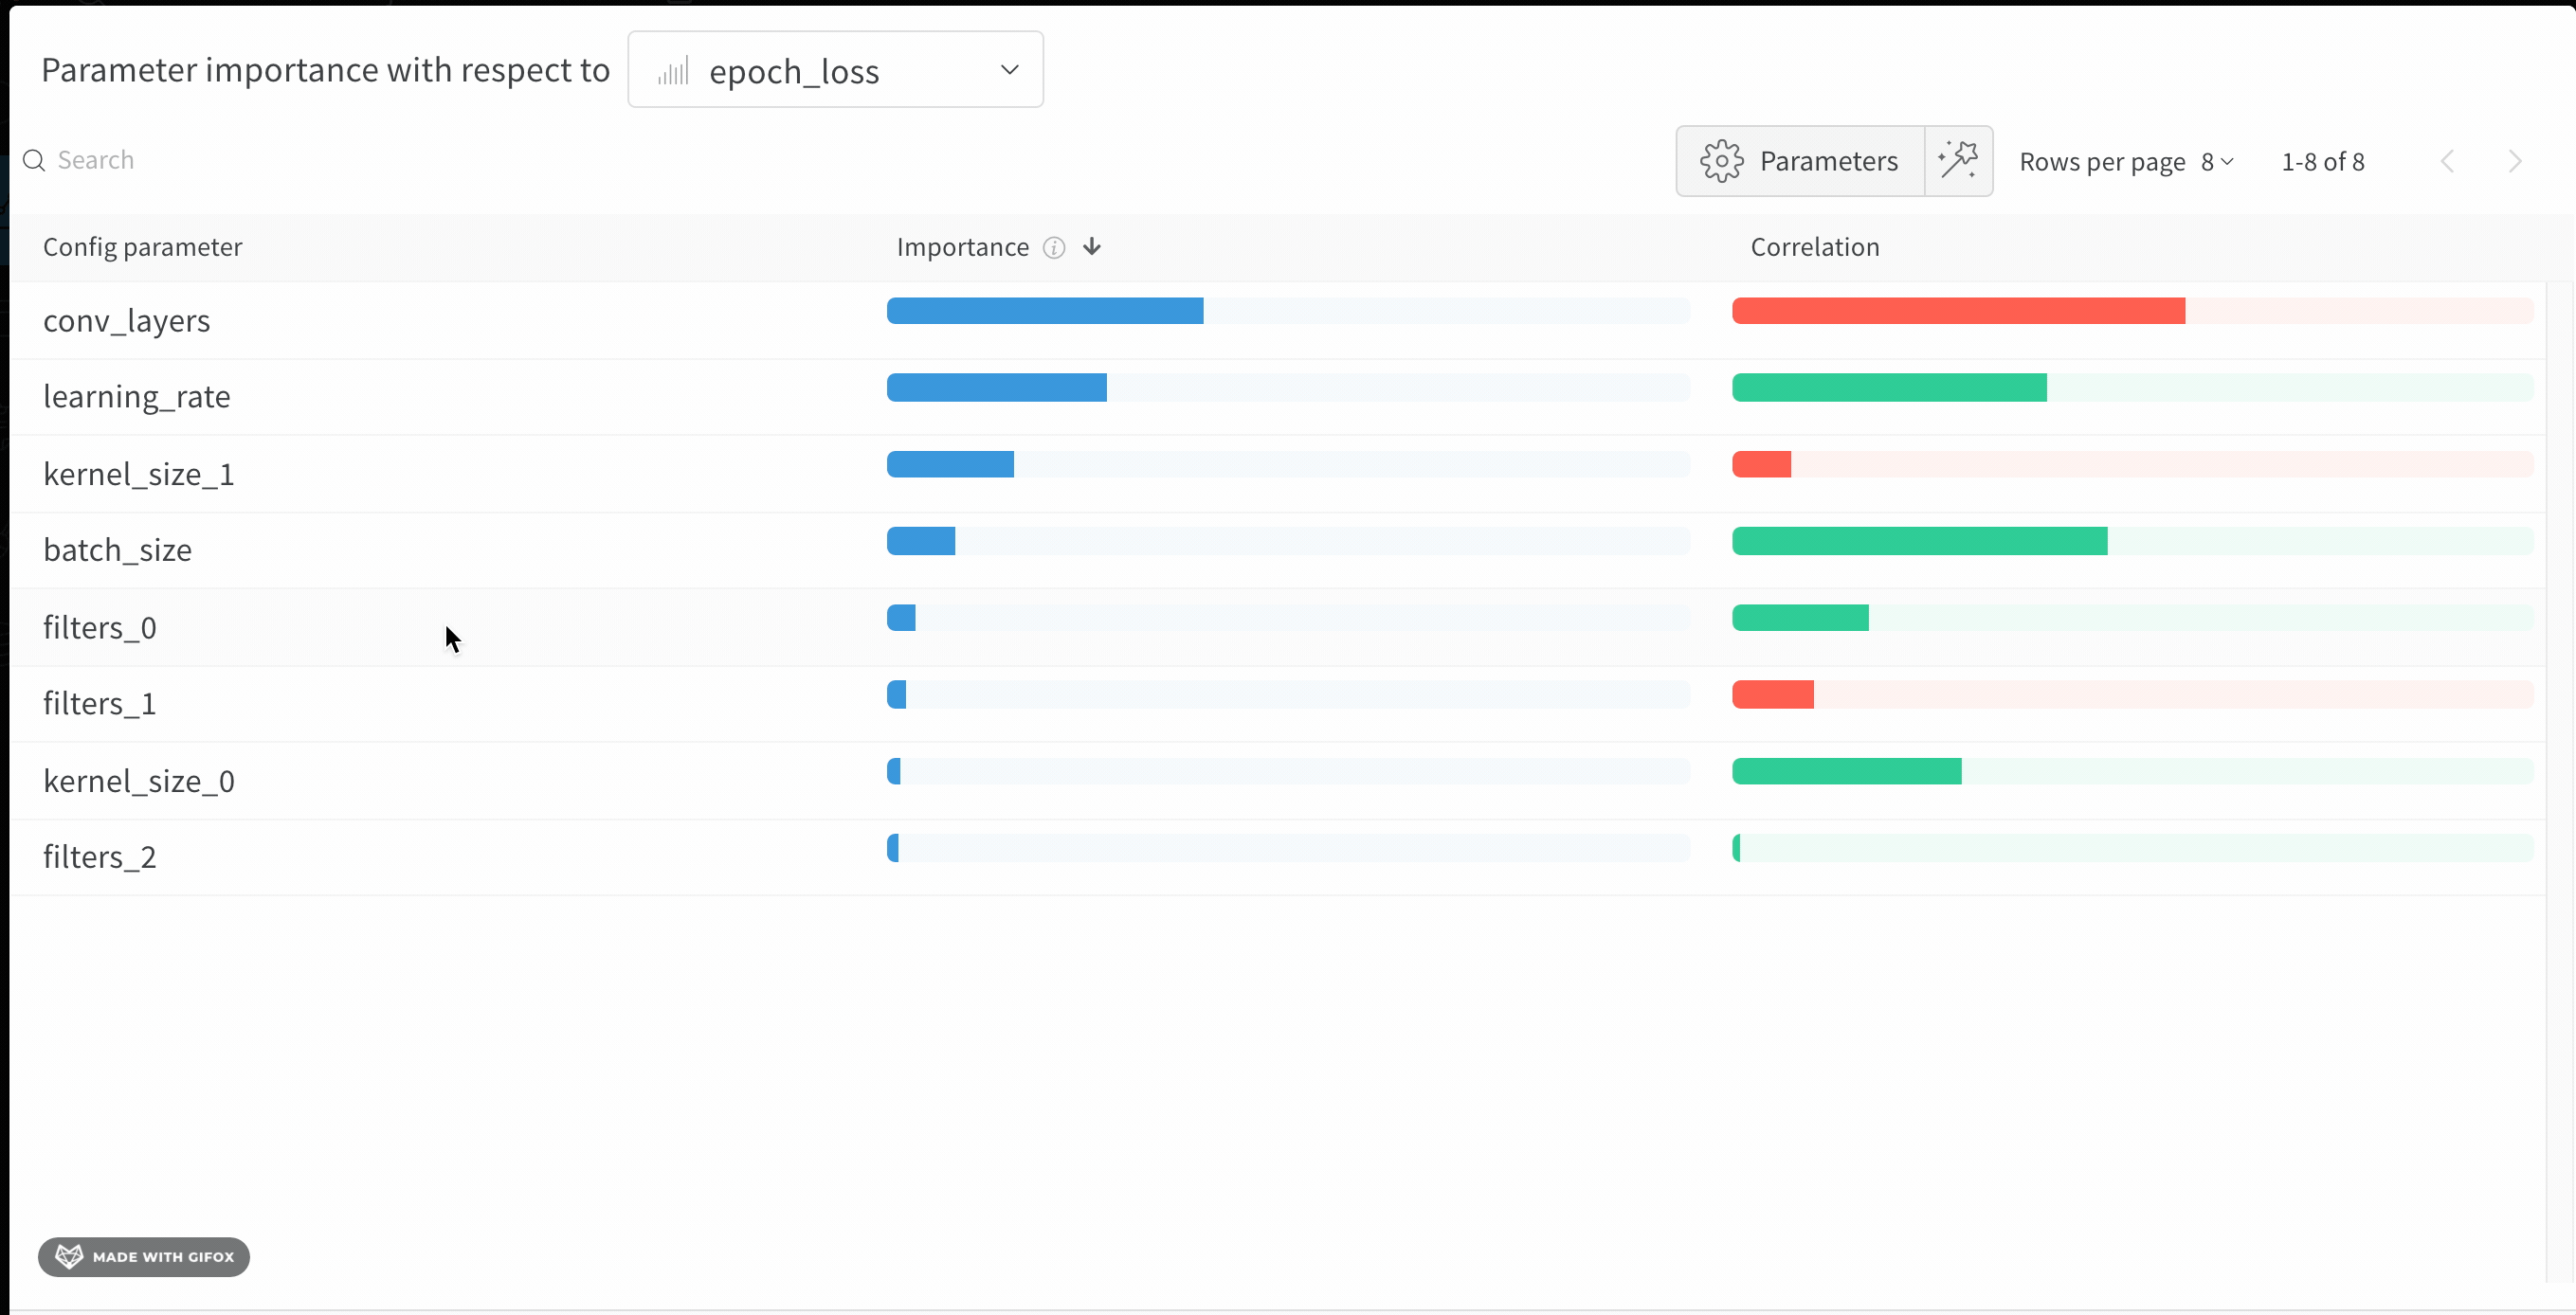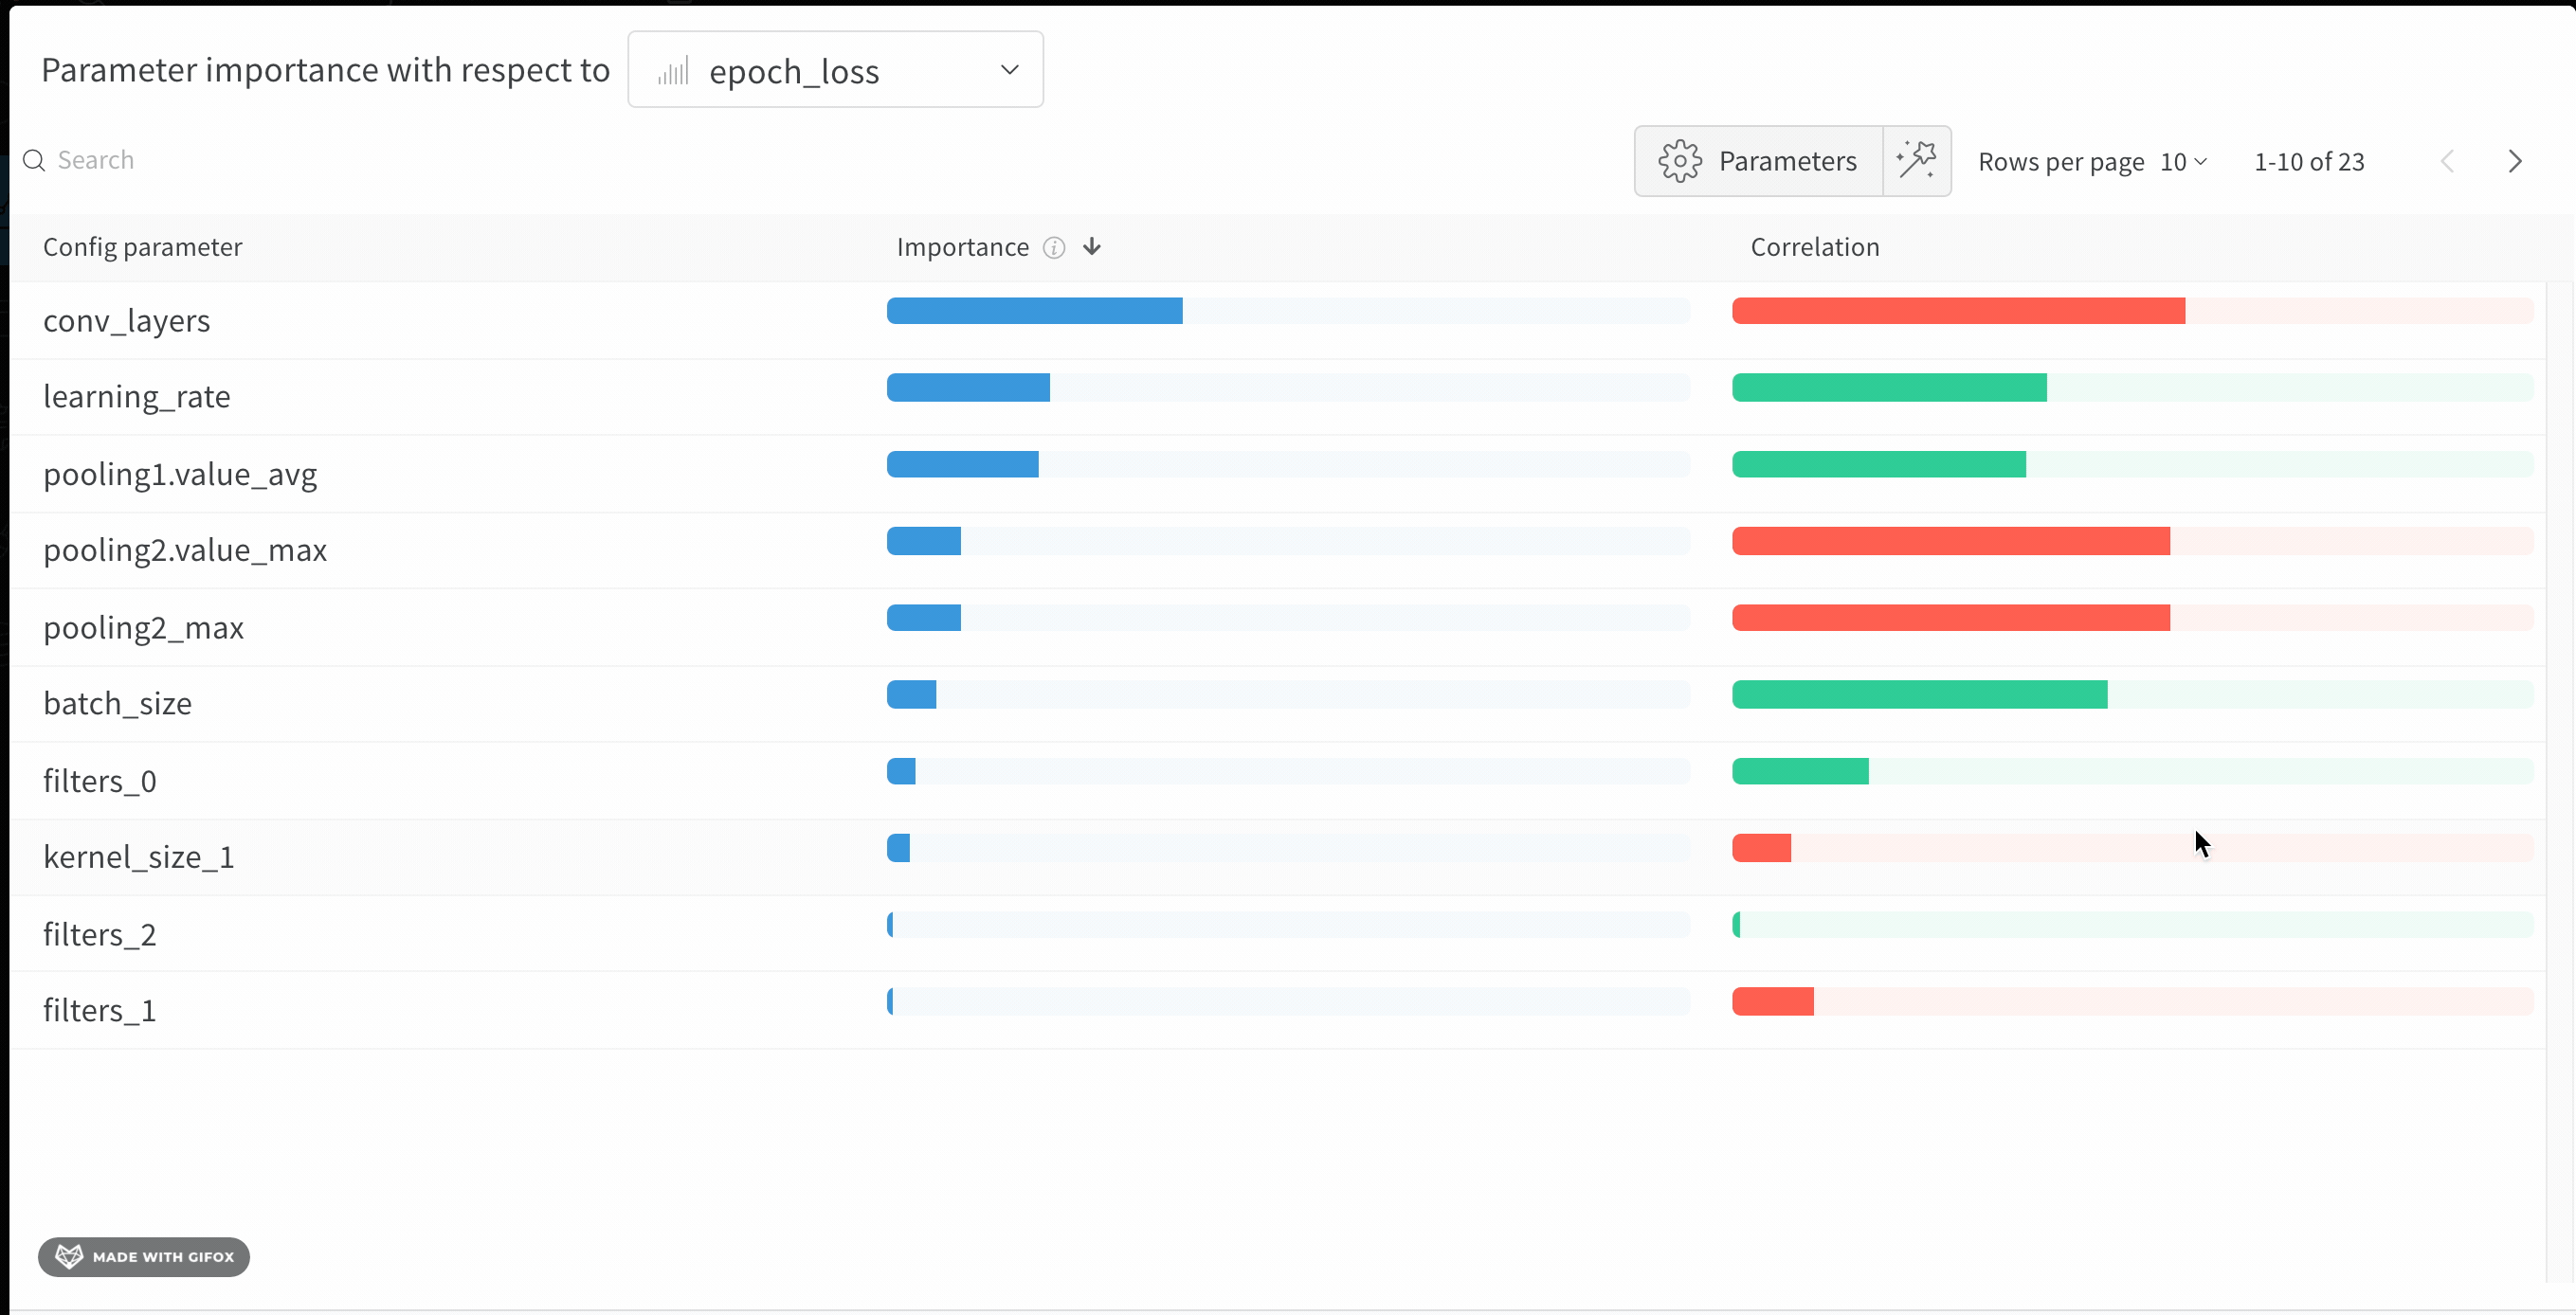
하이퍼파라미터 중요도 패널 해석
다음 섹션에서는 패널에 표시된 중요도와 상관관계 값을 읽는 방법을 설명하여 다음 스윕에서 이를 활용할 수 있도록 합니다.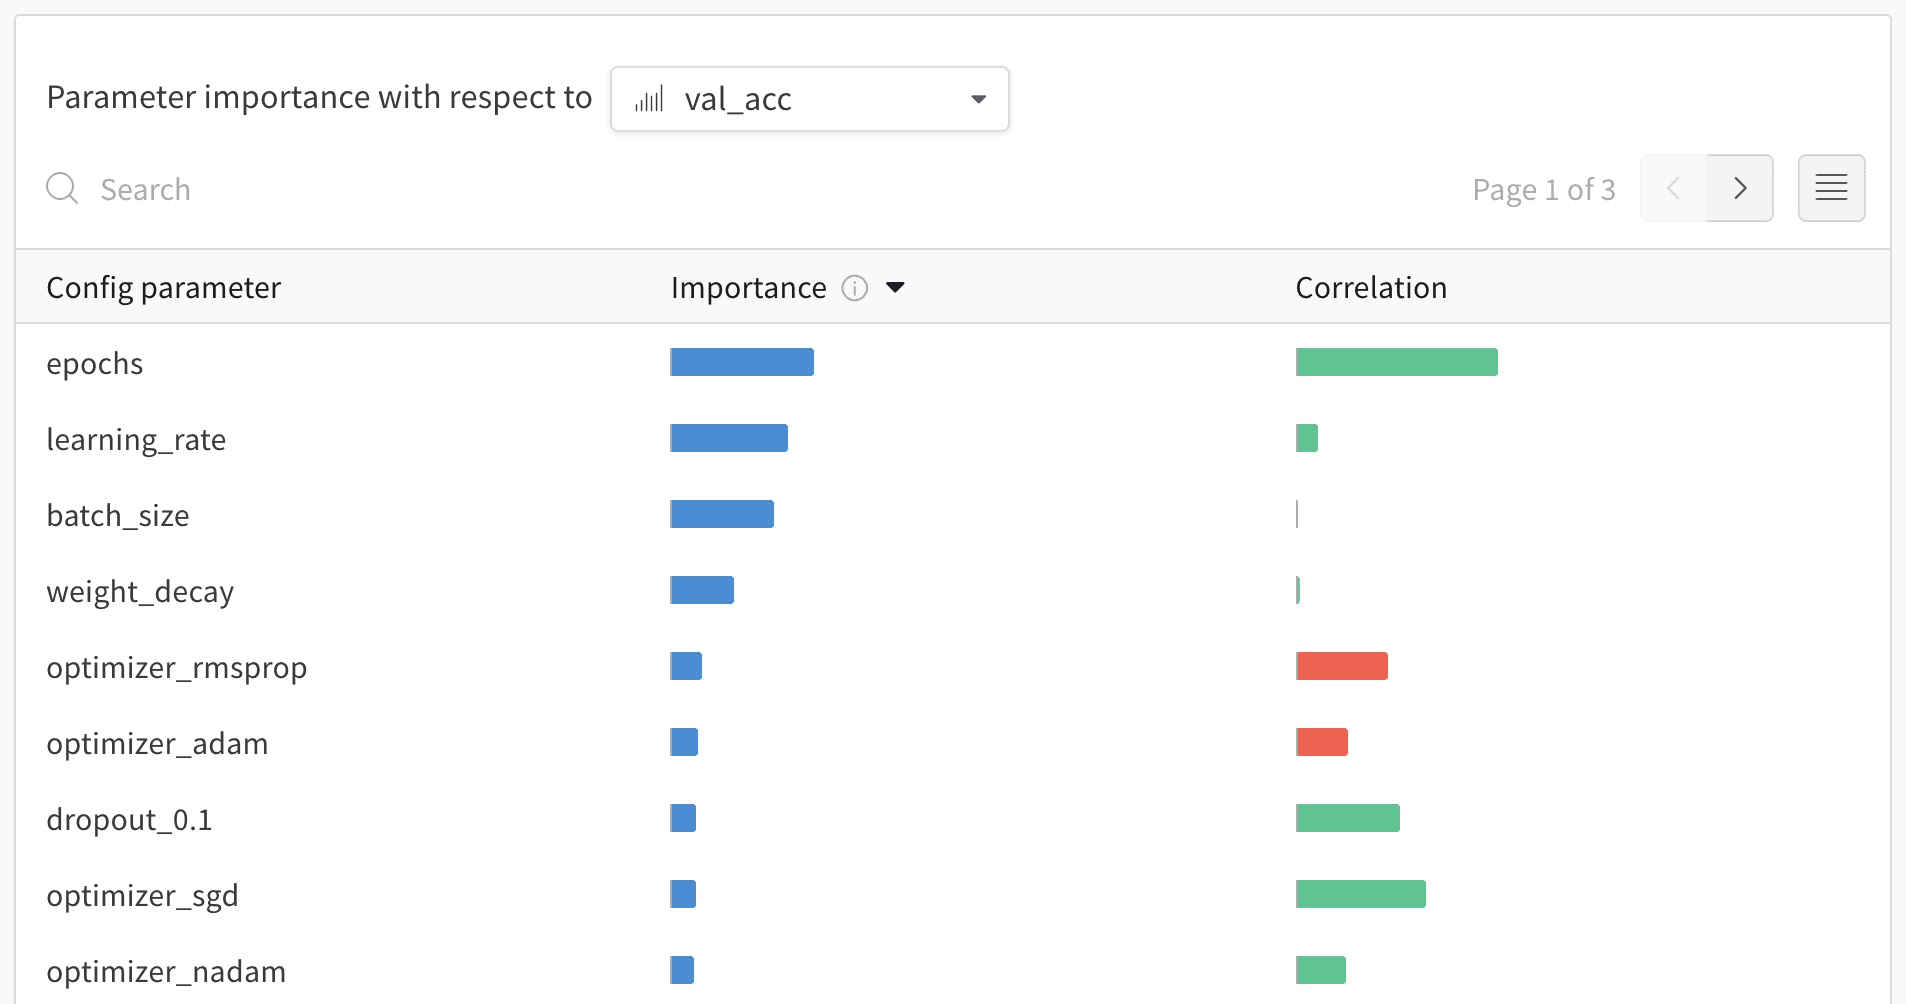
wandb.Run.config 객체에 전달된 모든 매개변수를 보여줍니다. 또한 선택한 모델 메트릭(val_loss의 경우)에 대한 이러한 설정 매개변수의 특성 중요도와 상관관계를 보여줍니다.
중요도
중요도 열은 각 하이퍼파라미터가 선택한 메트릭을 예측하는 데 얼마나 유용했는지를 보여 줍니다. 여러 하이퍼파라미터를 튜닝하기 시작한 상황에서 이 플롯을 사용해 추가로 탐색할 가치가 있는 하이퍼파라미터를 가려낸다고 가정해 보세요. 이후의 스윕을 가장 중요한 하이퍼파라미터로 좁히면 더 나은 모델을 더 빠르고 적은 비용으로 찾을 수 있습니다.W&B는 선형 모델이 아닌 트리 기반 모델로 중요도를 계산합니다. 트리 기반 모델이 범주형 데이터와 정규화되지 않은 데이터를 모두 더 잘 처리하기 때문입니다.
epochs, learning_rate, batch_size, weight_decay가 중요했음을 확인할 수 있습니다.
상관관계
상관관계는 개별 하이퍼파라미터와 메트릭 값 사이의 선형 관계를 캡처합니다. SGD 옵티마이저와 같은 하이퍼파라미터 사용과val_loss 사이에 관계가 존재하는지 여부에 대한 질문에 답합니다(이 경우 답은 yes입니다). 상관관계 값은 -1에서 1 사이이며, 양수 값은 양의 선형 상관관계를, 음수 값은 음의 선형 상관관계를, 0 값은 상관관계가 없음을 나타냅니다. 일반적으로 어느 방향으로든 0.7보다 큰 값은 강한 상관관계를 나타냅니다.
이 그래프를 사용하여 메트릭과 상관관계가 더 높은 값을 추가로 탐색하거나(이 경우 rmsprop 또는 nadam 대신 확률적 경사 하강법 또는 adam을 선택할 수 있음) 더 많은 에포크 동안 트레이닝할 수 있습니다.
- 상관관계는 연관성의 증거를 보여주며, 반드시 인과관계를 의미하지는 않습니다.
- 상관관계는 이상치에 민감하므로, 특히 시도한 하이퍼파라미터의 샘플 크기가 작을 때 강한 관계가 중간 정도로 바뀔 수 있습니다.
- 상관관계는 하이퍼파라미터와 메트릭 사이의 선형 관계만 캡처합니다. 상관관계는 강한 다항식 관계를 캡처하지 않습니다.