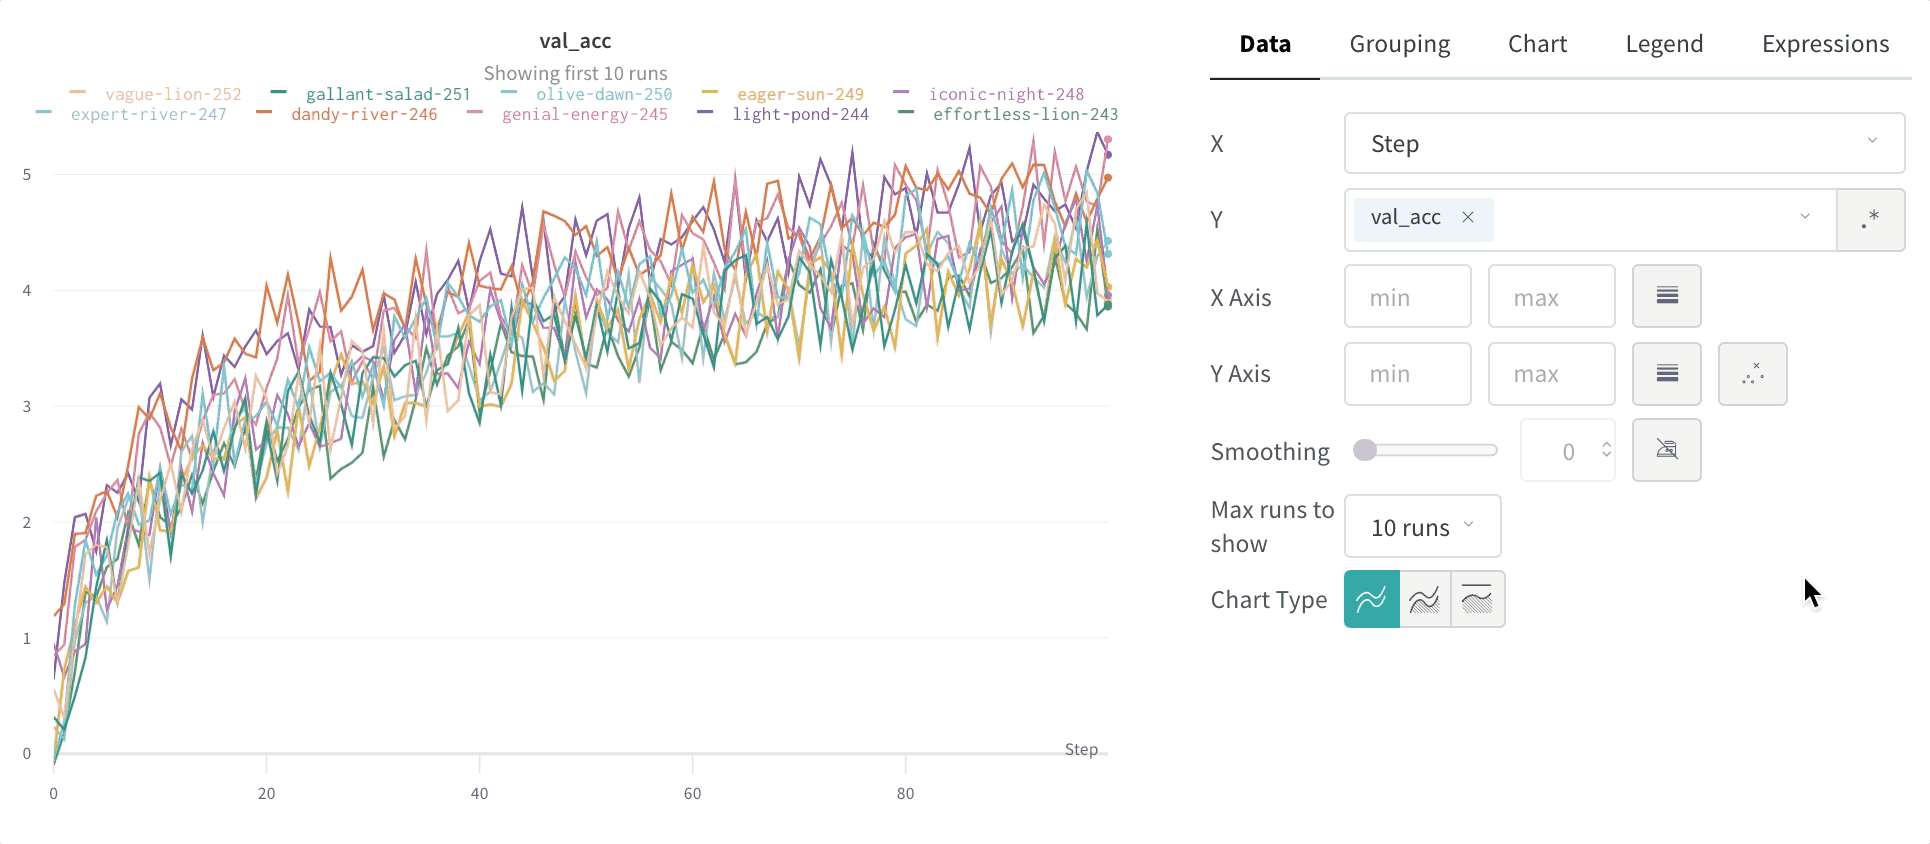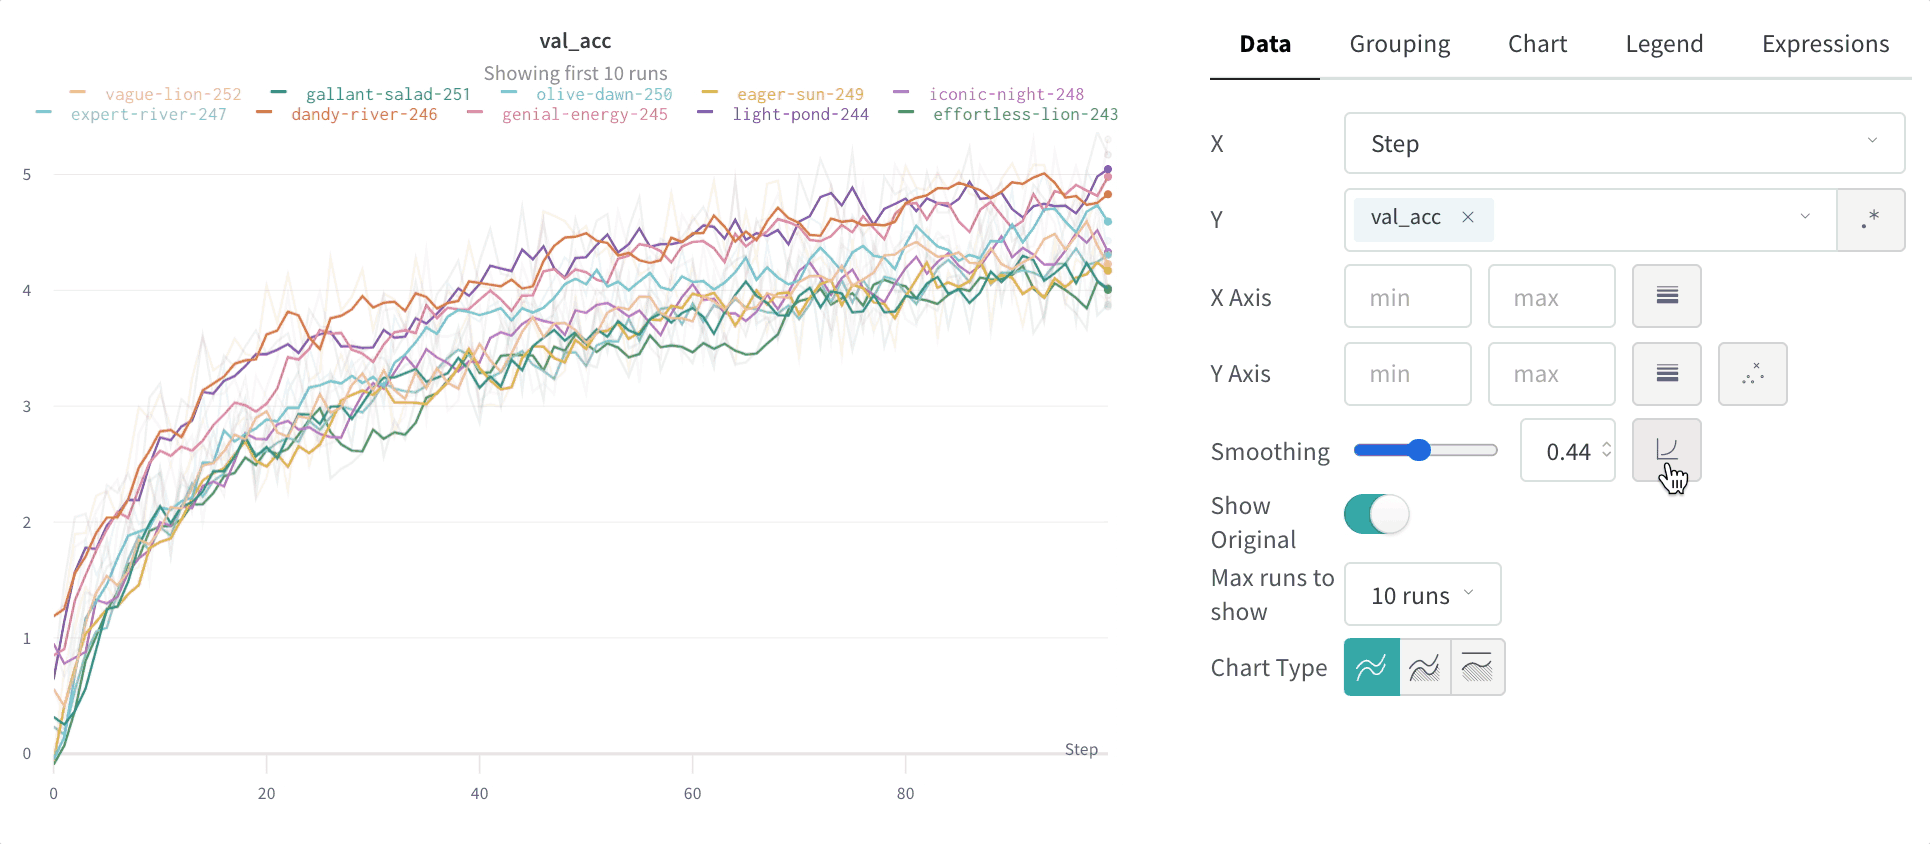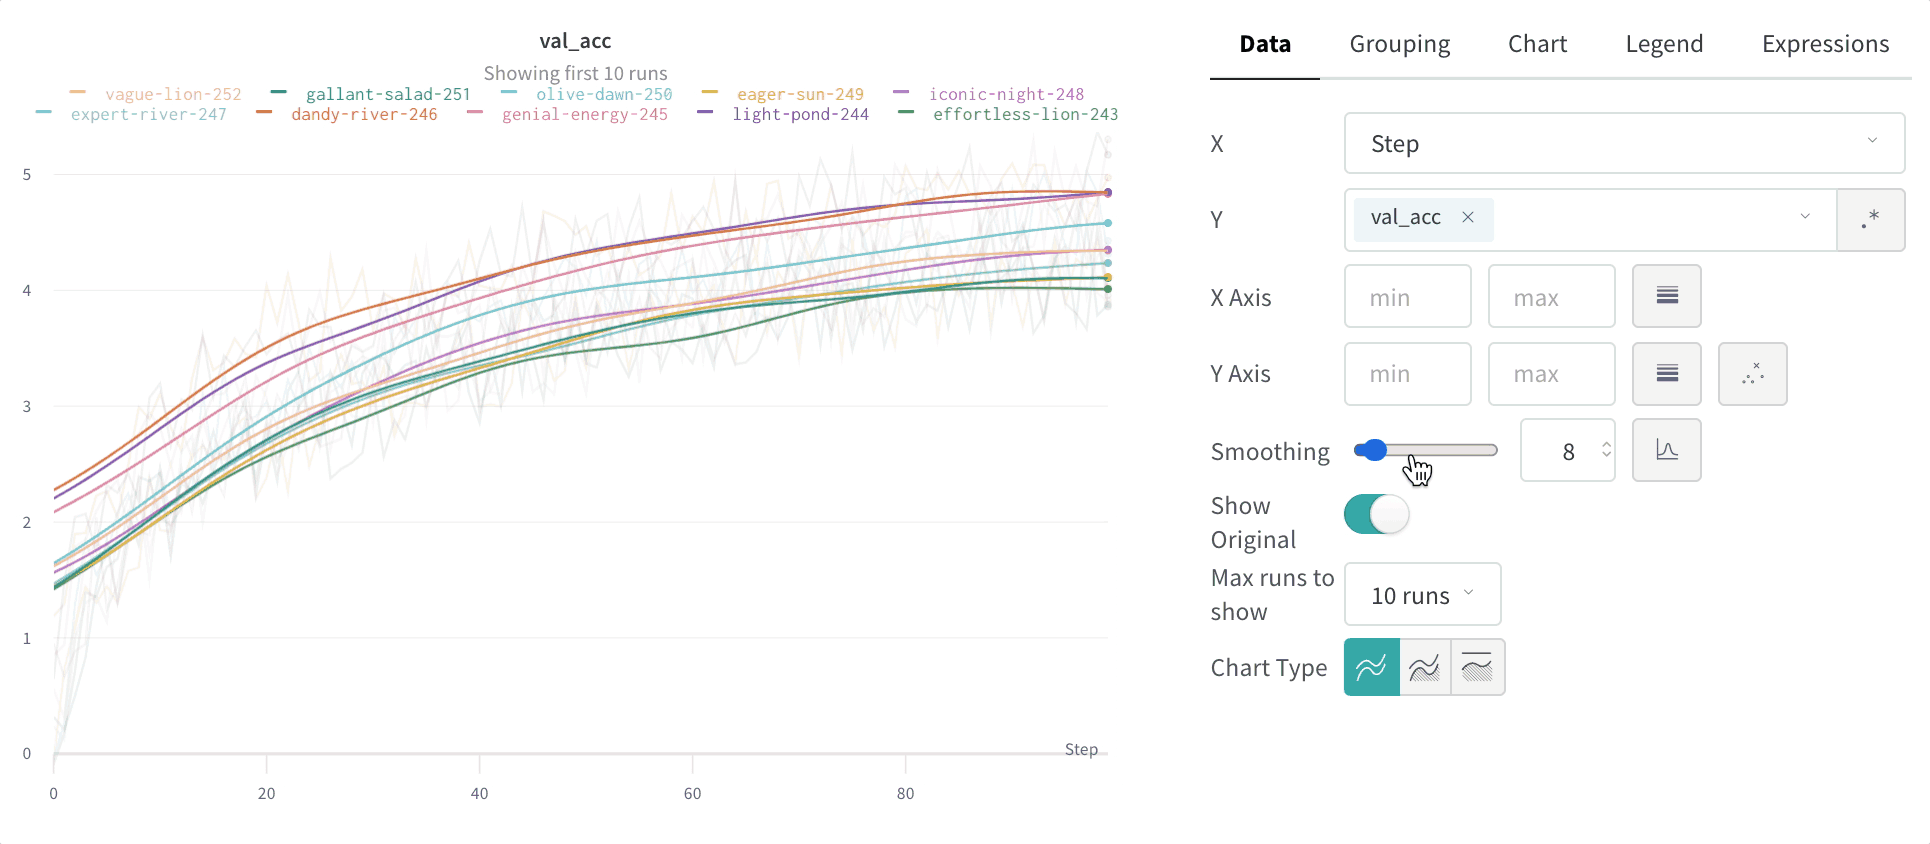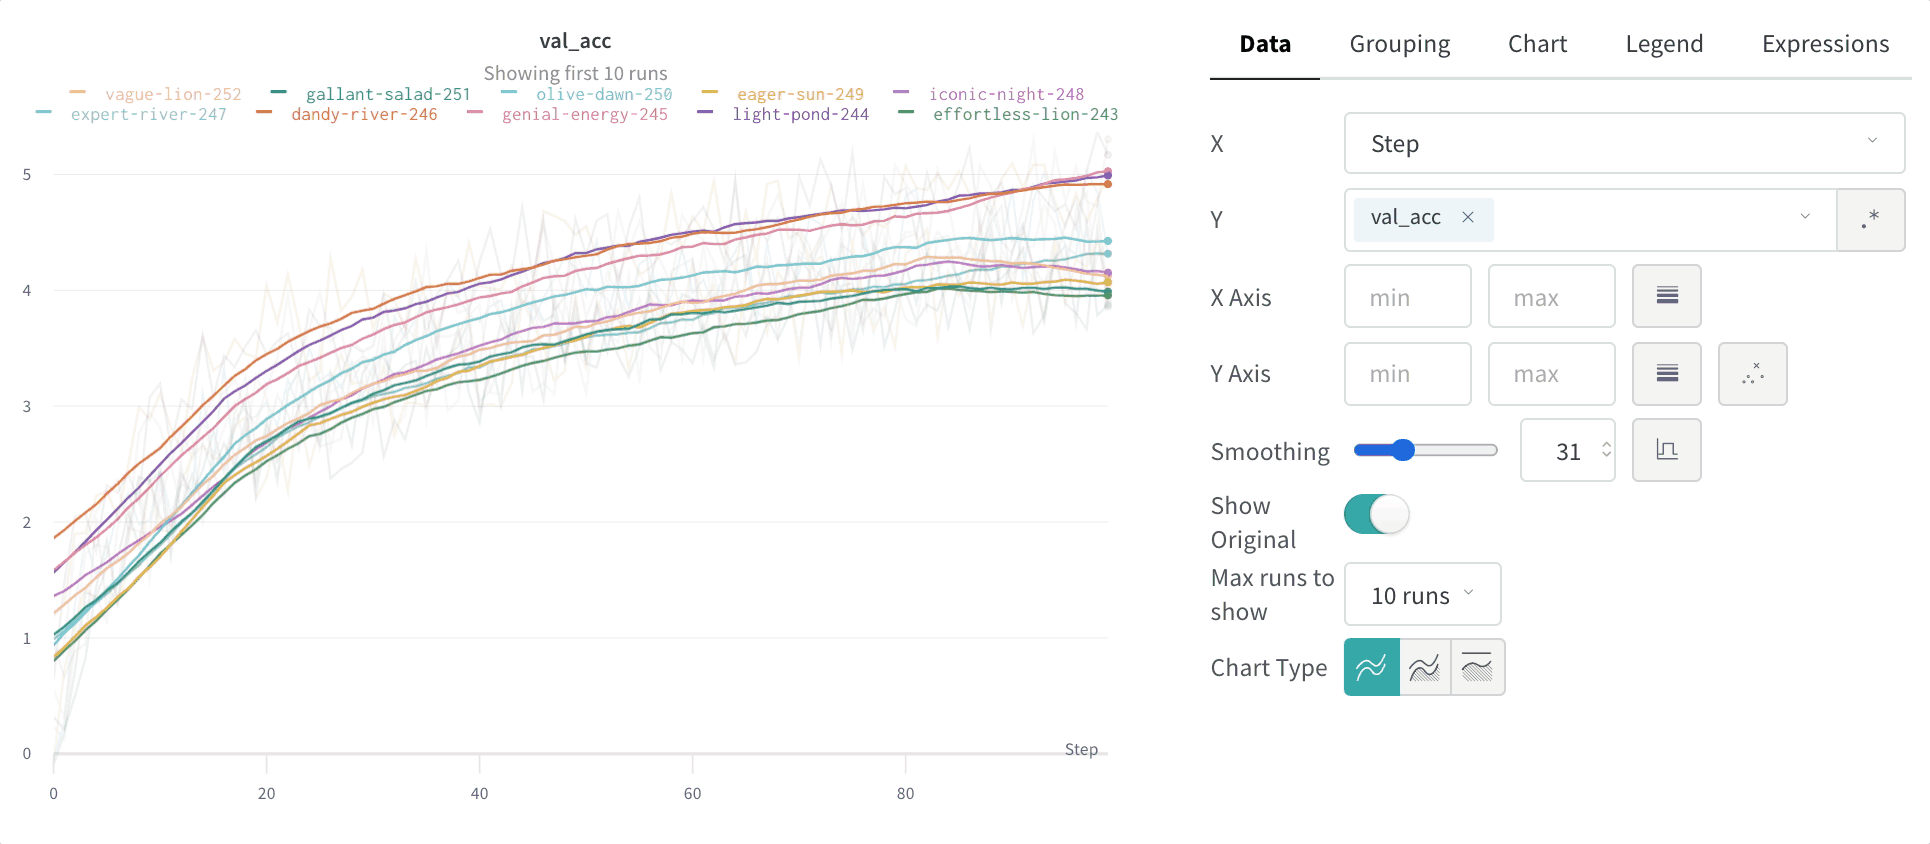
시간 가중 지수 이동 평균(TWEMA) 스무딩(기본값)
시간 가중 지수 이동 평균(TWEMA) 스무딩 알고리즘은 이전 points의 가중치를 지수적으로 감쇠시켜 시계열 데이터를 스무딩하는 기법입니다. 이 기법에 대한 자세한 내용은 지수 스무딩을 참조하세요. 범위는 0에서 1입니다. 시계열의 초기 값이 0으로 편향되지 않도록 편향 제거 항이 추가됩니다. TWEMA 알고리즘은 선 위 points의 밀도(x축 범위 단위당y 값의 수)를 고려합니다. 이를 통해 특성이 다른 여러 선을 동시에 표시할 때 일관된 스무딩이 가능합니다.
다음 샘플 코드는 내부에서 이 알고리즘이 어떻게 작동하는지 보여줍니다:
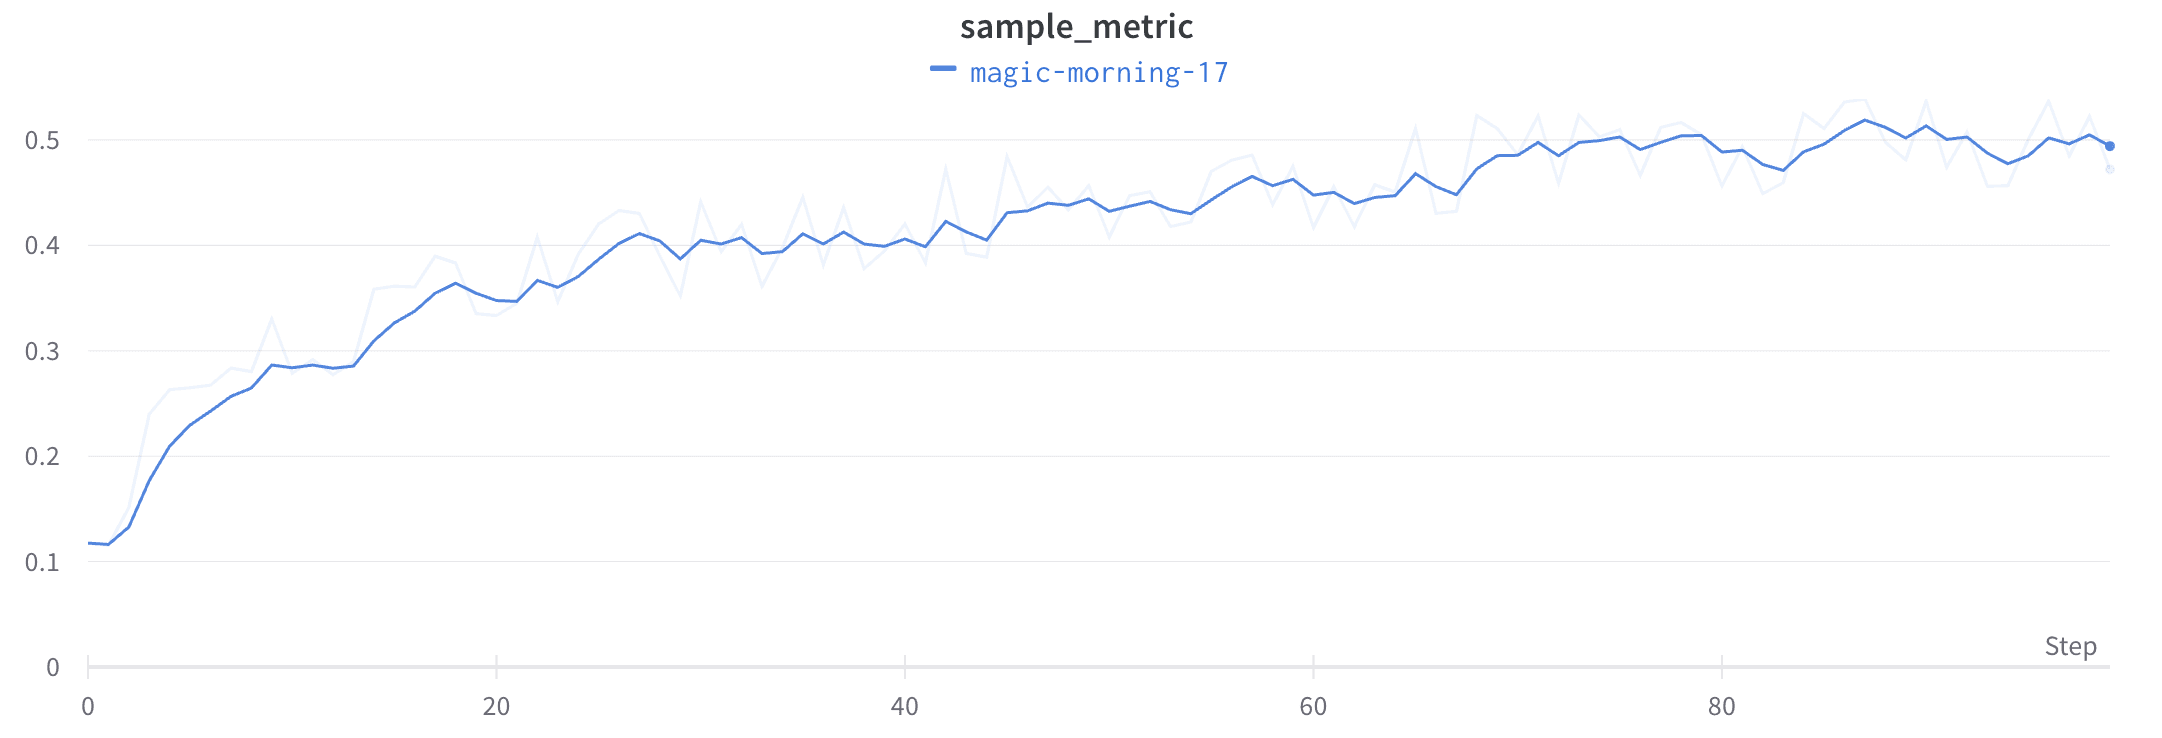
가우시안 스무딩
가우시안 스무딩(또는 가우시안 커널 스무딩)은 point의 가중 평균을 계산하며, 가중치는 스무딩 매개변수로 지정된 표준 편차를 가진 가우시안 분포에 해당합니다. W&B는 모든 입력x 값에 대해, 그 앞과 뒤에 있는 point를 기반으로 스무딩된 값을 계산합니다.
live data에 이 알고리즘이 적용된 예를 보려면 대화형 W&B 리포트의 가우시안 스무딩 section을 참조하세요.
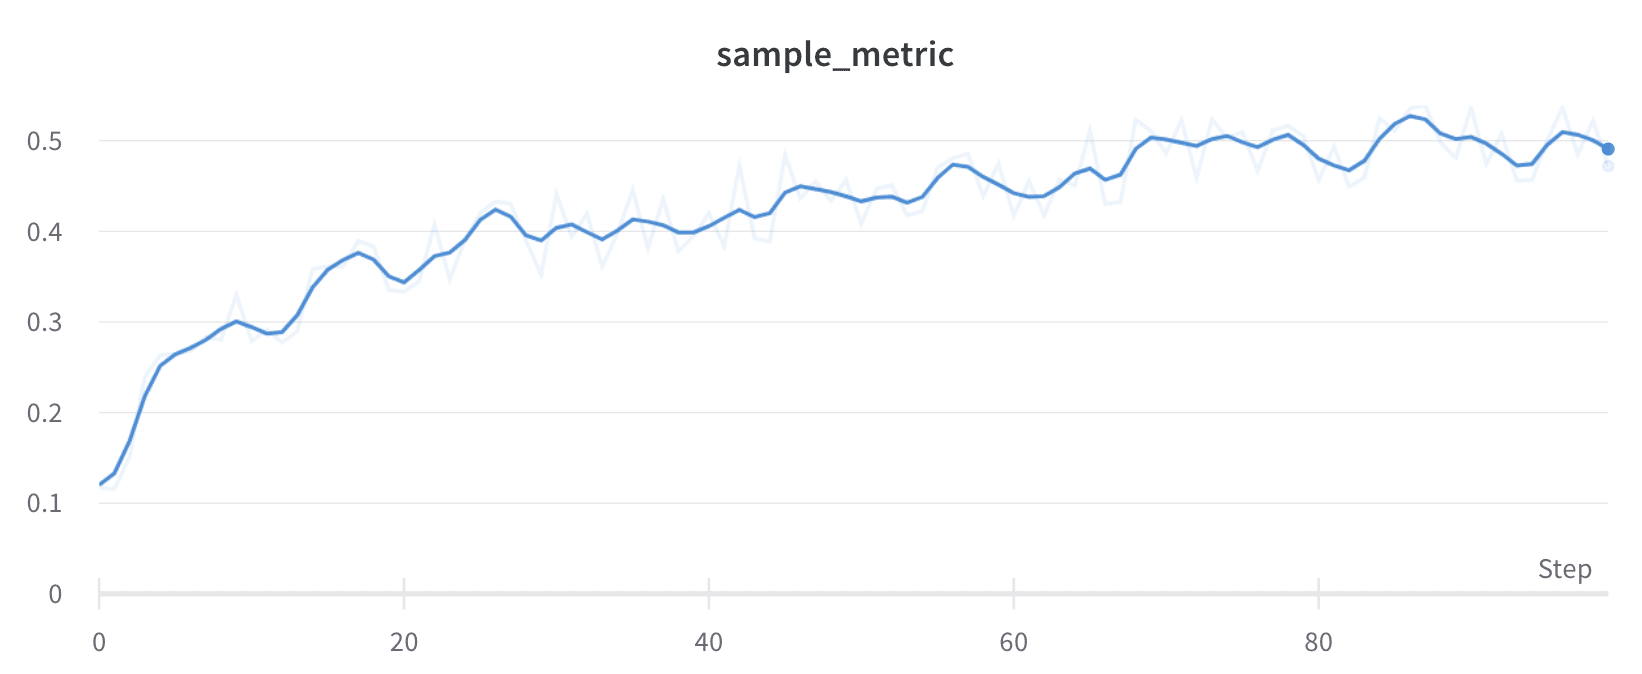
러닝 평균 스무딩
러닝 평균은x 값 전후의 윈도우 내 points 평균으로 point를 대체하는 스무딩 알고리즘입니다. “Boxcar Filter” on Wikipedia를 참조하세요. 러닝 평균에 대해 선택된 매개변수는 moving average에서 고려할 points 수를 지정합니다.
points가 x축에서 고르지 않게 배치된 경우, point 밀도가 달라질 때 고정 너비 윈도우가 오해의 소지가 있는 평균을 생성할 수 있으므로 가우시안 스무딩을 대신 사용하세요.
이 알고리즘이 live data에 적용된 것을 보려면 대화형 W&B 리포트의 러닝 평균 section을 참조하세요.
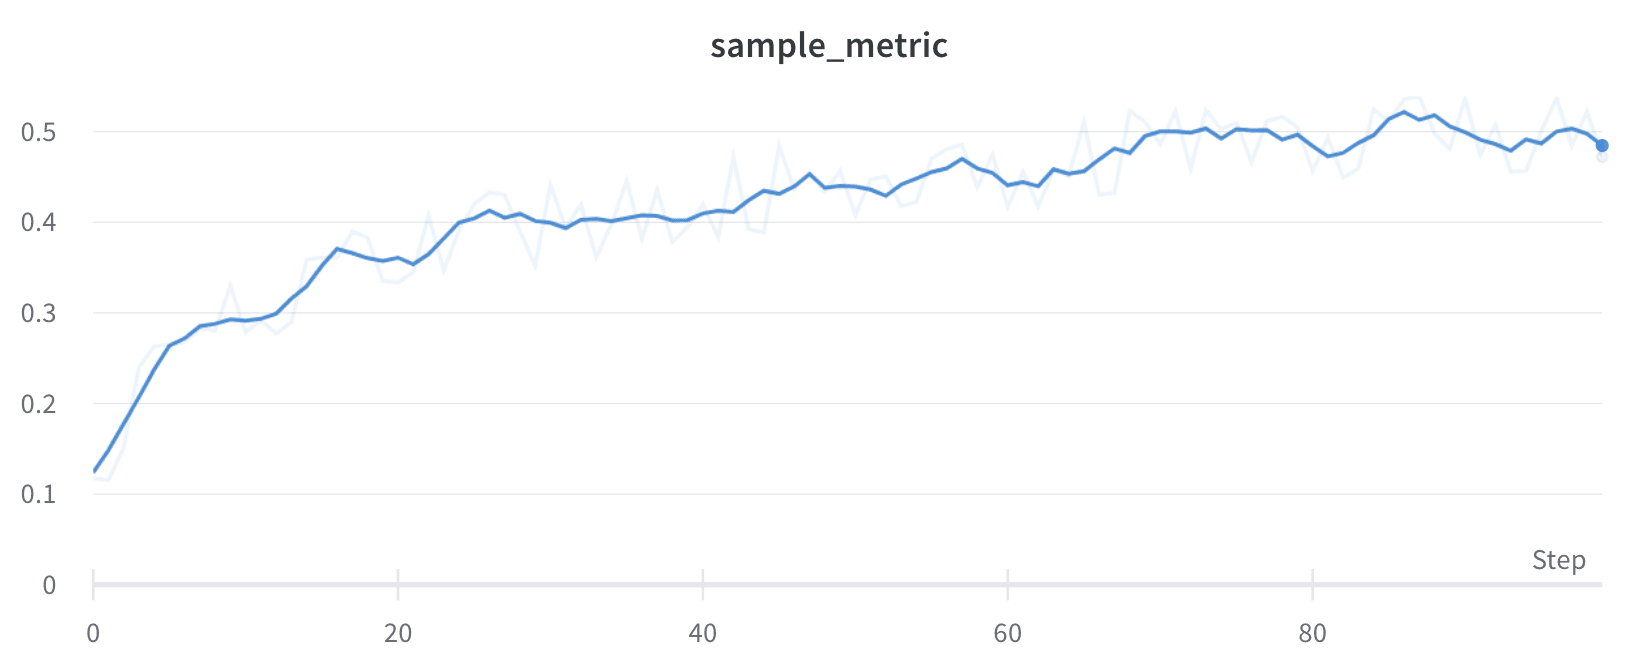
지수 이동 평균(EMA) 스무딩
지수 이동 평균(EMA) 스무딩 알고리즘은 지수 윈도우 함수를 사용하여 시계열 데이터를 스무딩하는 휴리스틱 기법입니다. 이 기법에 대한 자세한 내용은 지수 스무딩을 참조하세요. 범위는 0에서 1입니다. 편향 제거 항이 추가되어 시계열의 초기 값이 0으로 편향되지 않도록 합니다. 대부분의 경우 EMA 스무딩은 먼저 버킷팅을 수행한 후 스무딩하는 대신 전체 이력 스캔에 적용됩니다. 이는 일반적으로 더 정확한 스무딩을 생성합니다. 다음 상황에서는 대신 버킷팅 후에 EMA 스무딩이 적용됩니다:- 샘플링
- 그룹화
- 표현식
- 단조롭지 않은 x축
- 시간 기반 x축
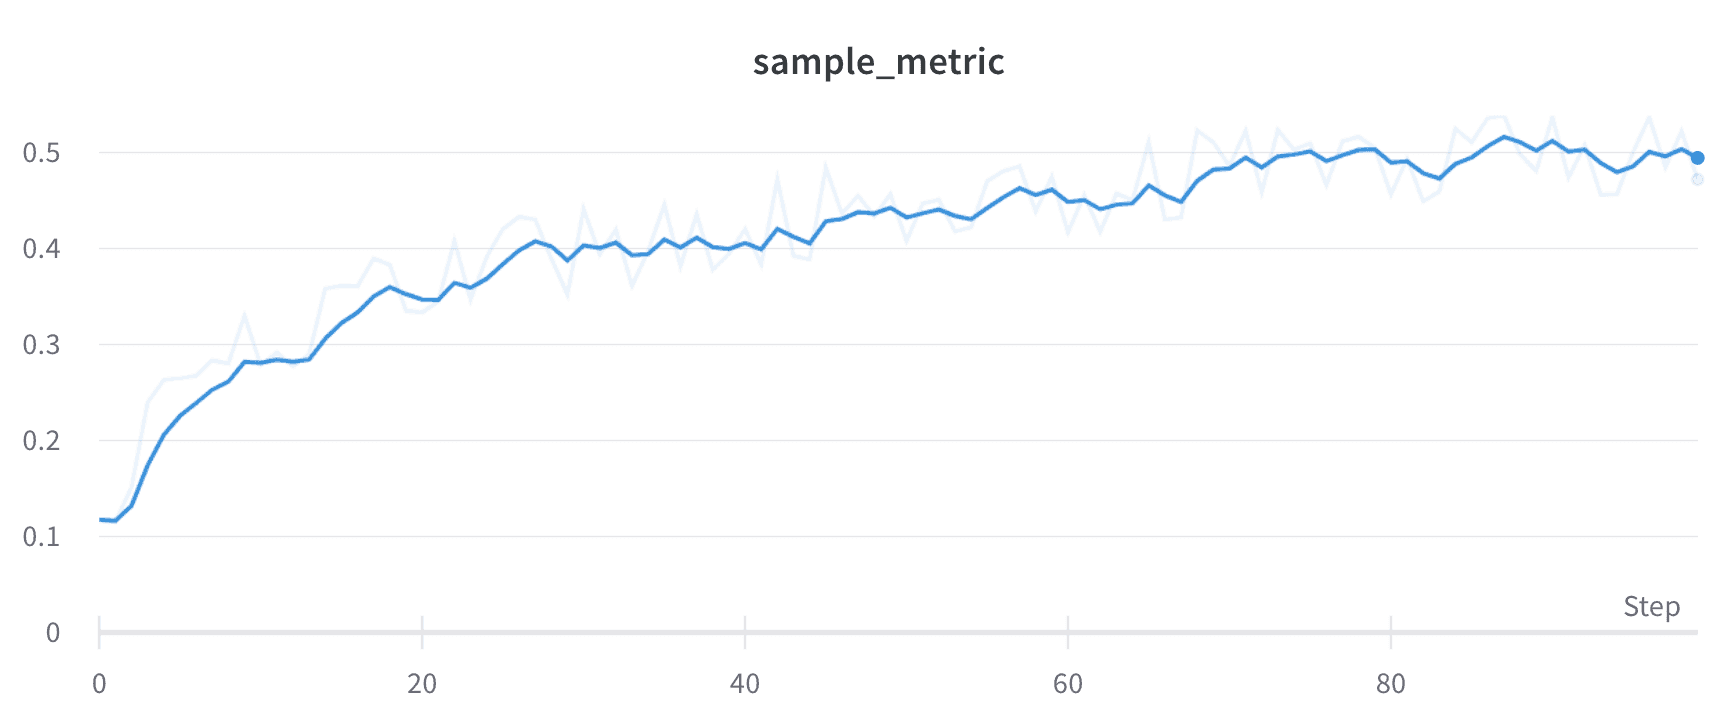
원본 데이터 숨기기
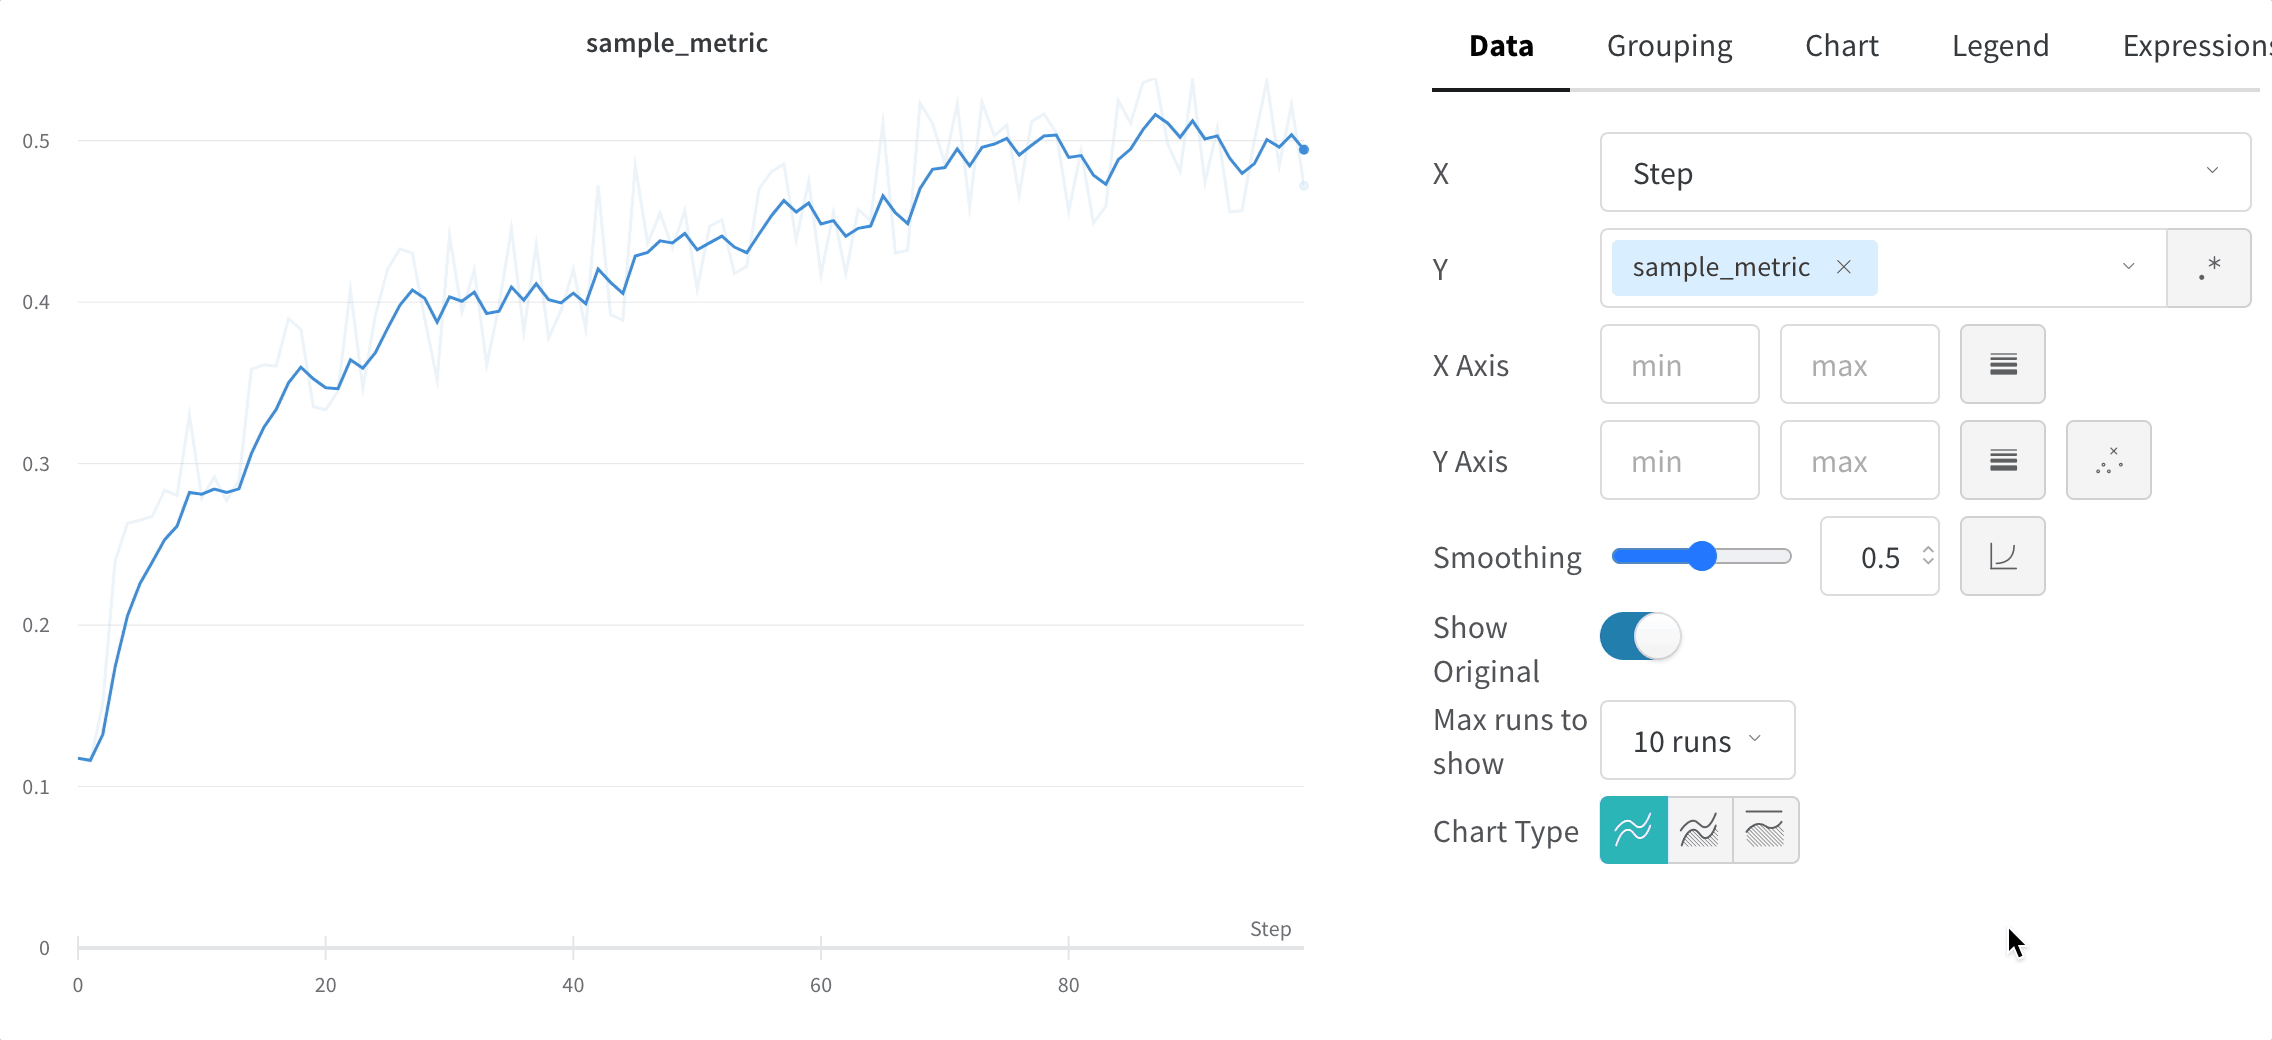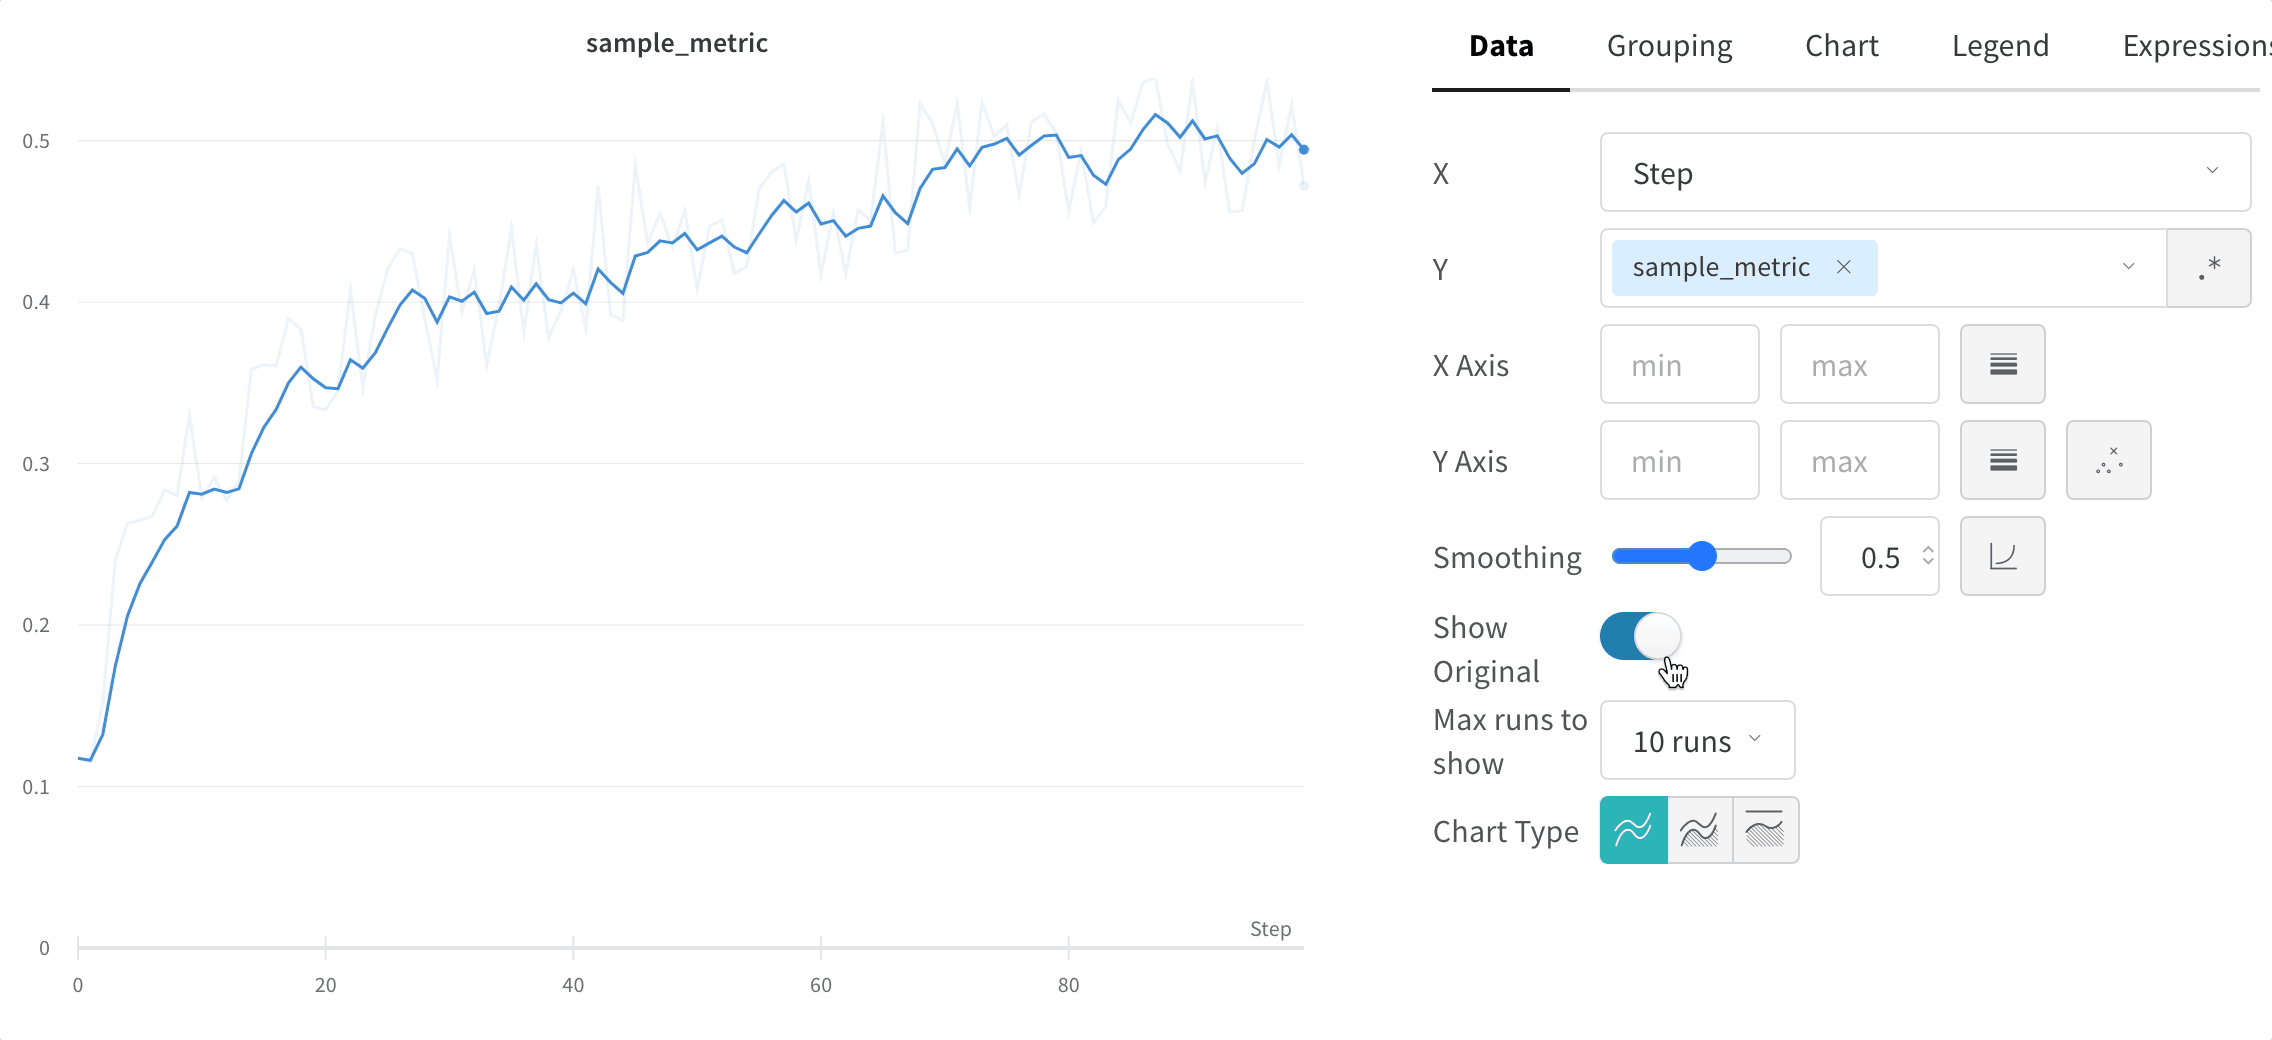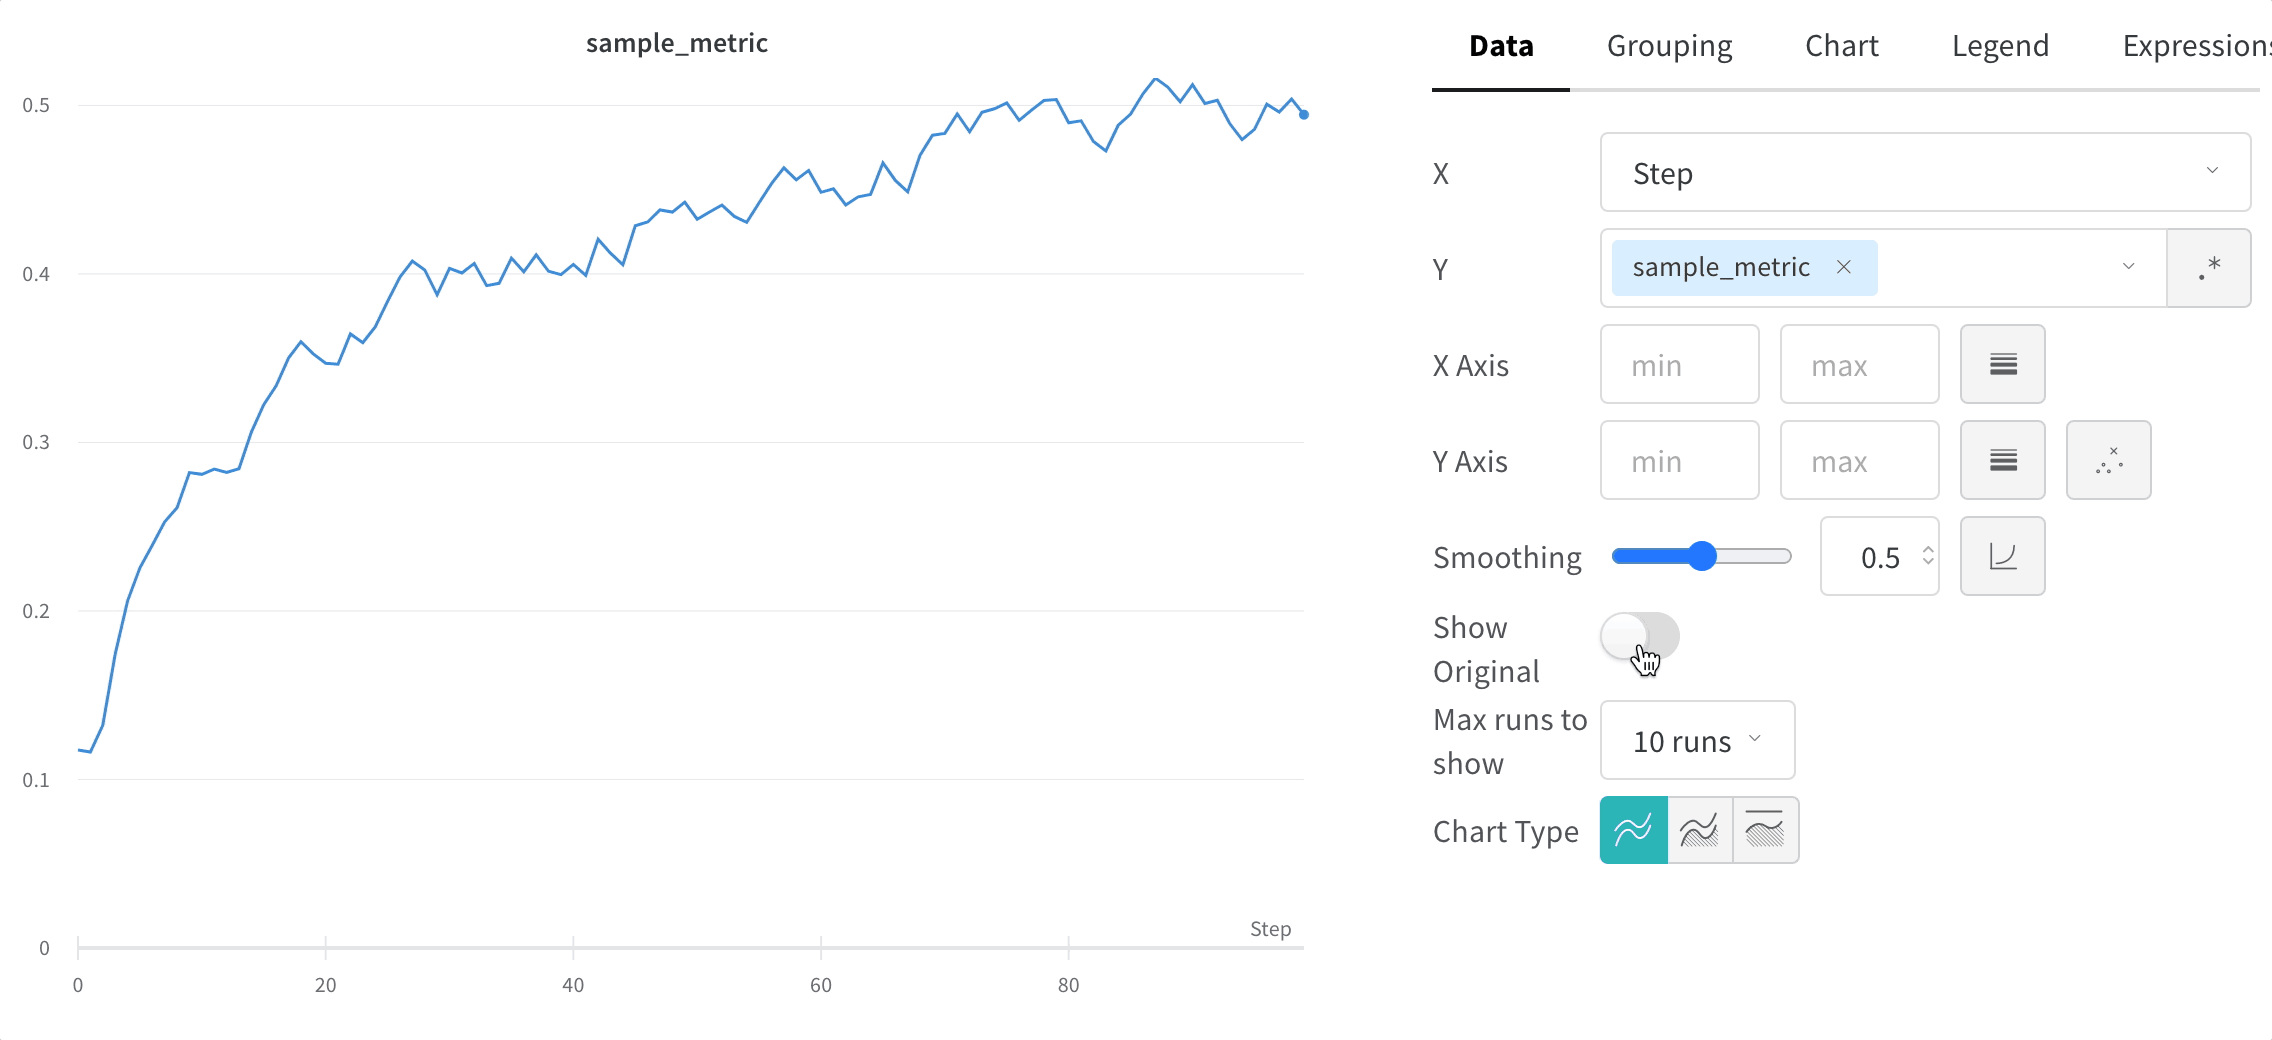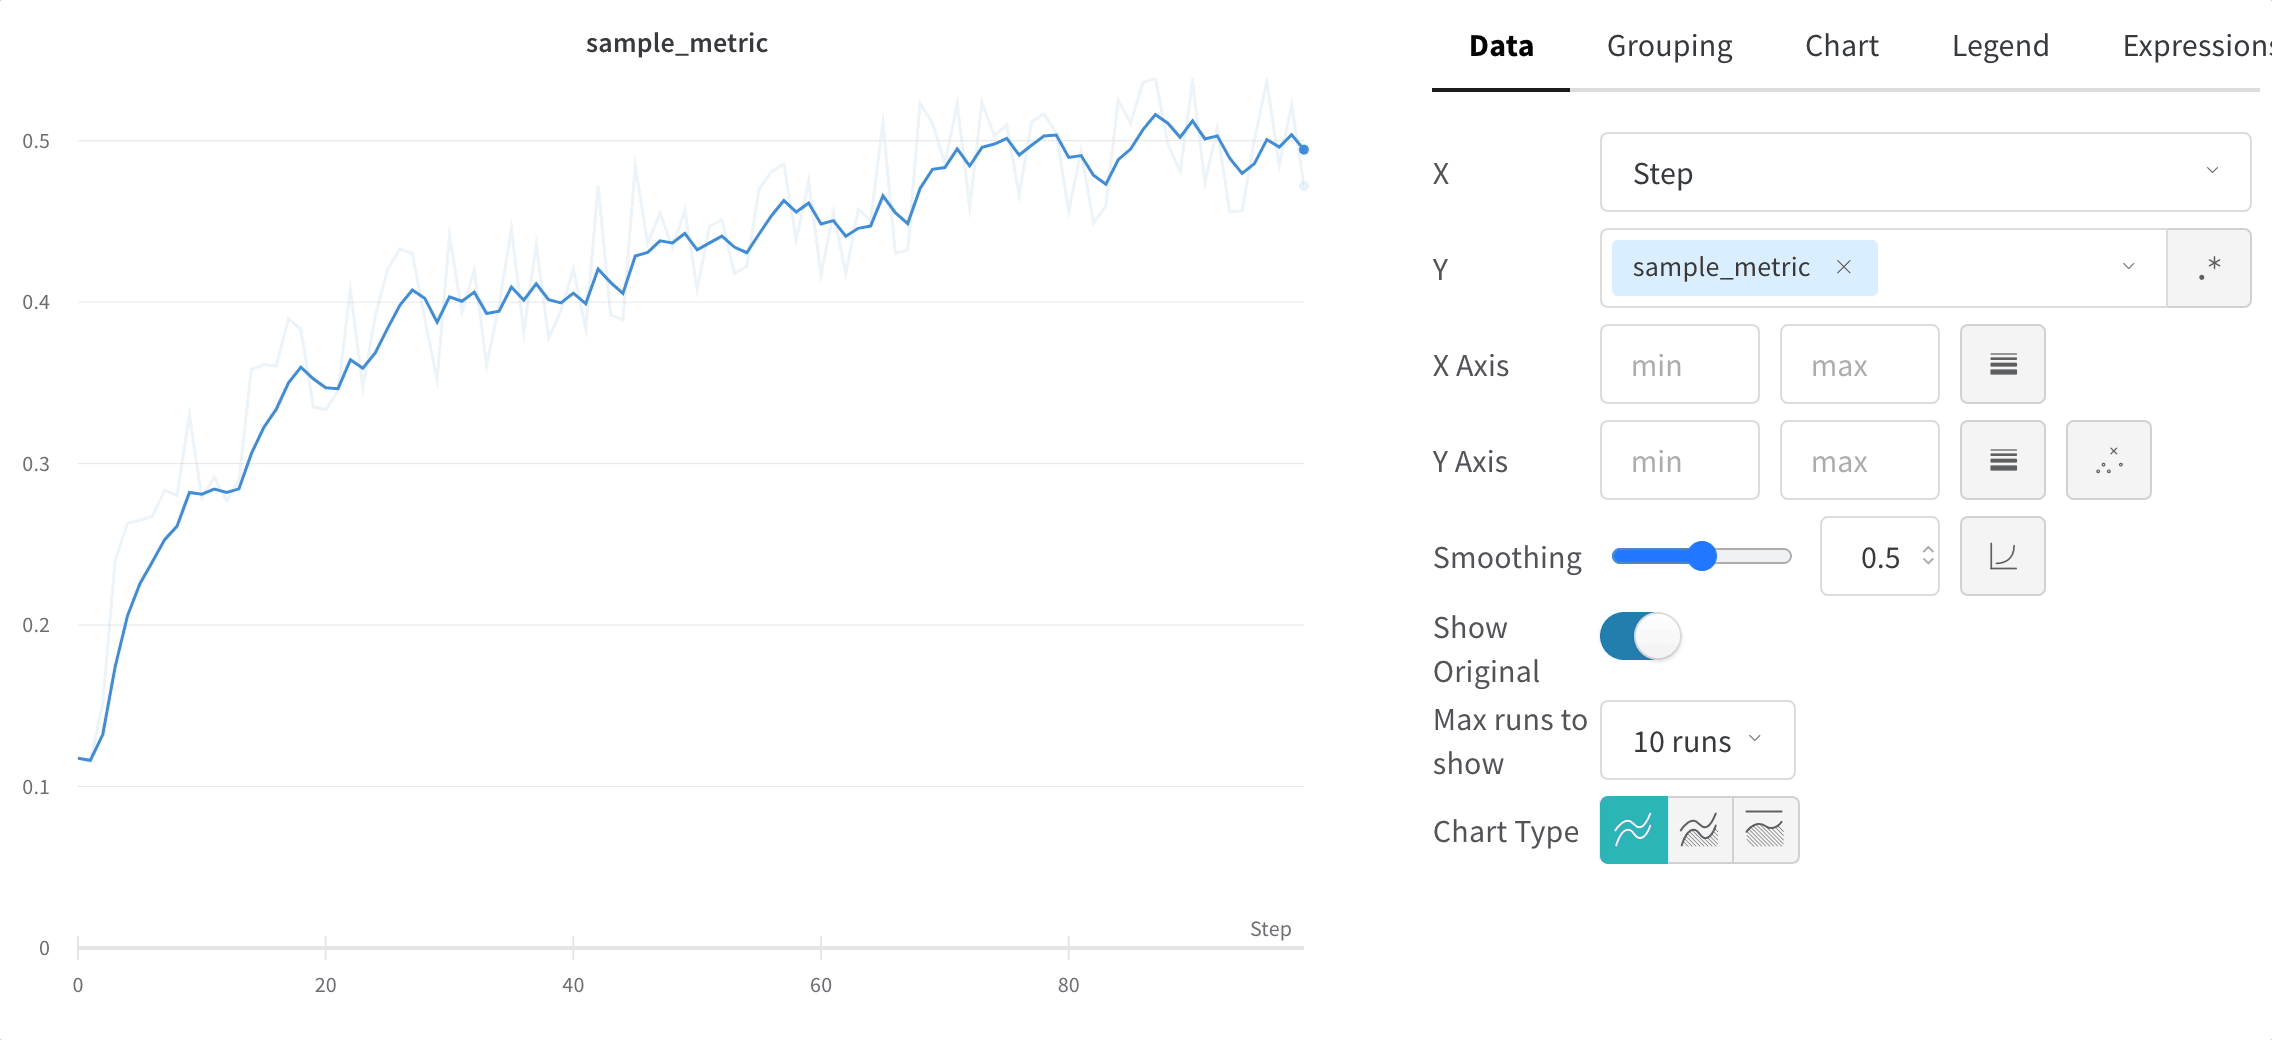
스무딩된 선을 원시 데이터와 비교하여 스무딩이 시그널을 얼마나 공격적으로 변경하는지 판단하세요. 기본적으로 원본 스무딩되지 않은 데이터가 플롯 배경에 희미한 선으로 표시됩니다. Show Original을 클릭하여 이 기능을 끄세요.