

weave.init() を呼び出すと、Weave は ChatNVIDIA ライブラリ経由の LLM Call を自動的にトラッキングしてログします。このガイドは ChatNVIDIA を使用する Python 開発者を対象に、トレースの取得、独自の関数の Op としてのラップ、Weave の Model クラスを使用した実験の整理について説明します。これらを活用することで、LLM アプリケーションのデバッグ、改善、比較をより効率的に行えます。
トレース
開発中も本番環境でも、LLM アプリケーションのトレースを一元管理されたデータベースに保存しておくと、問題のデバッグに役立つだけでなく、アプリケーションの改善時に評価に使える難しいサンプルのデータセットを構築できます。以下のセクションでは、ChatNVIDIA の Call に対して自動トレースを有効にする方法を説明します。- Python
- TypeScript
Weave は ChatNVIDIA Python ライブラリのトレースを自動的に取得できます。任意のプロジェクト名を指定して このコードを実行すると、Weave は指定したプロジェクト名で ChatNVIDIA の Call を取得します。取得した Call では、入力、出力、メタデータを確認できます。
weave.init([PROJECT-NAME]) を呼び出すと、取得が開始されます。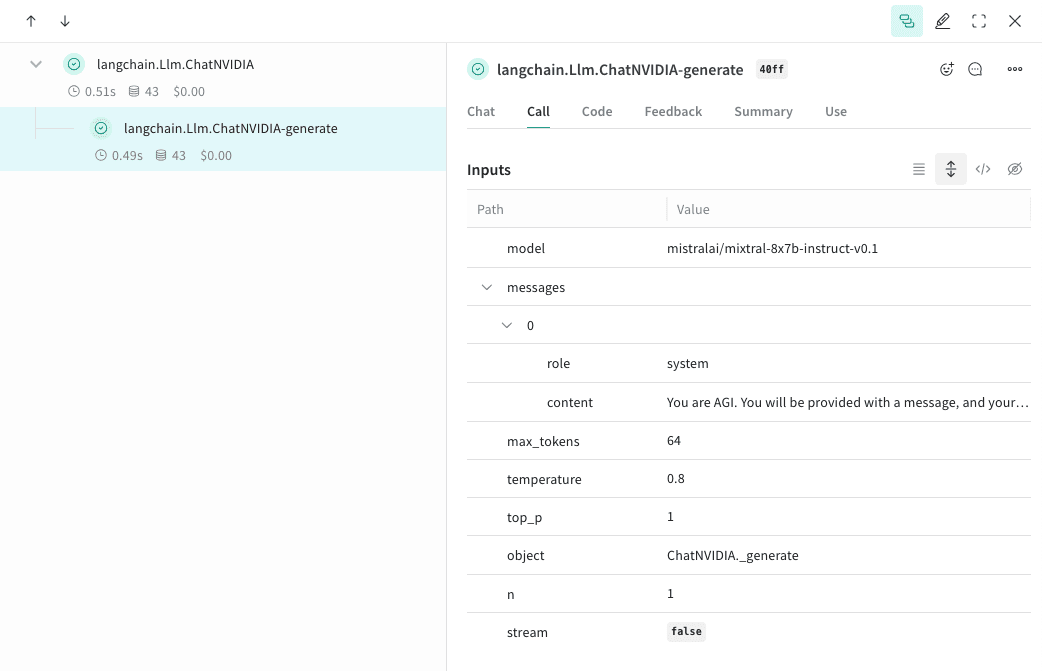
独自の Op をトラッキングする
- Python
- TypeScript
関数を Weave にアクセスし、UI で
@weave.op でラップすると、入力、出力、アプリのロジックの取得が始まり、アプリ内のデータの流れをデバッグできるようになります。Op は深くネストでき、トラッキングしたい関数のツリーを構築できます。さらに、実験中はコードの自動バージョン管理も行われるため、Git にコミットしていないその場限りの変更も記録できます。@weave.op でデコレートした関数を作成し、その中で ChatNVIDIA Python ライブラリ を呼び出します。次の例では、2 つの関数を op でラップしています。これにより、RAG アプリの取得ステップのような中間ステップが、アプリの動作にどう影響するかを確認できます。get_pokemon_data をクリックすると、そのステップの入力と出力を確認できます。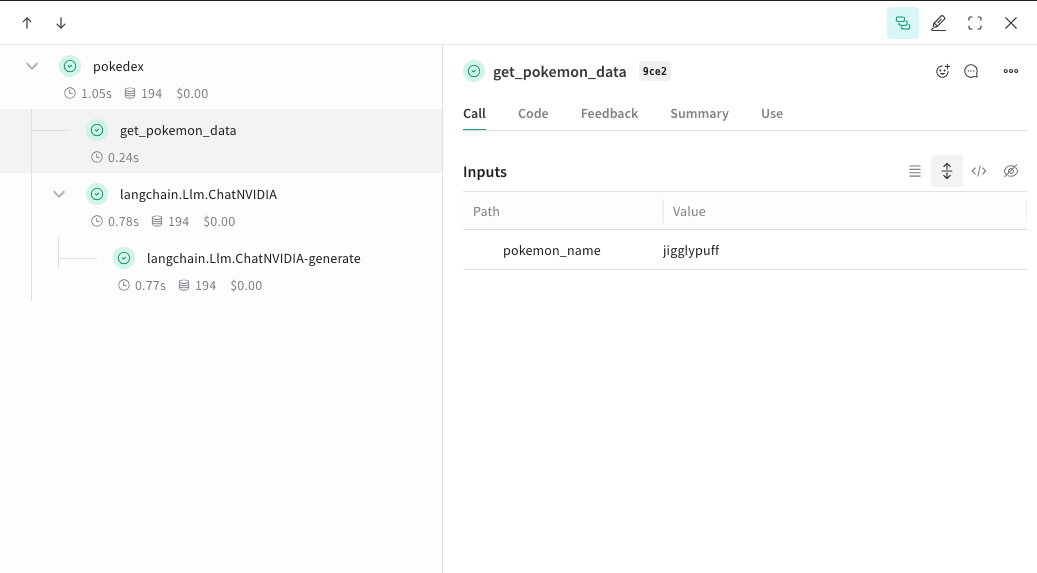
実験を効率化するために Model を作成する
- Python
- TypeScript
構成要素が多いと、実験の整理は難しくなります。
Model クラスを使用すると、システムプロンプトや使用しているモデルなど、アプリの実験に関する詳細を取得して整理できます。これにより、アプリのさまざまな反復処理を整理し、比較しやすくなります。Model は、コードのバージョン管理や入力と出力の取得に加えて、アプリケーションの動作を制御する構造化されたパラメーターも取得します。そのため、どのパラメーターが最も効果的だったかを簡単に検索できます。また、Weave モデルは serve や Evaluation と組み合わせて使用することもできます。次の例では、model と system_message を変更して実験できます。どちらかを変更するたびに、GrammarCorrectorModel の新しい バージョン が作成されます。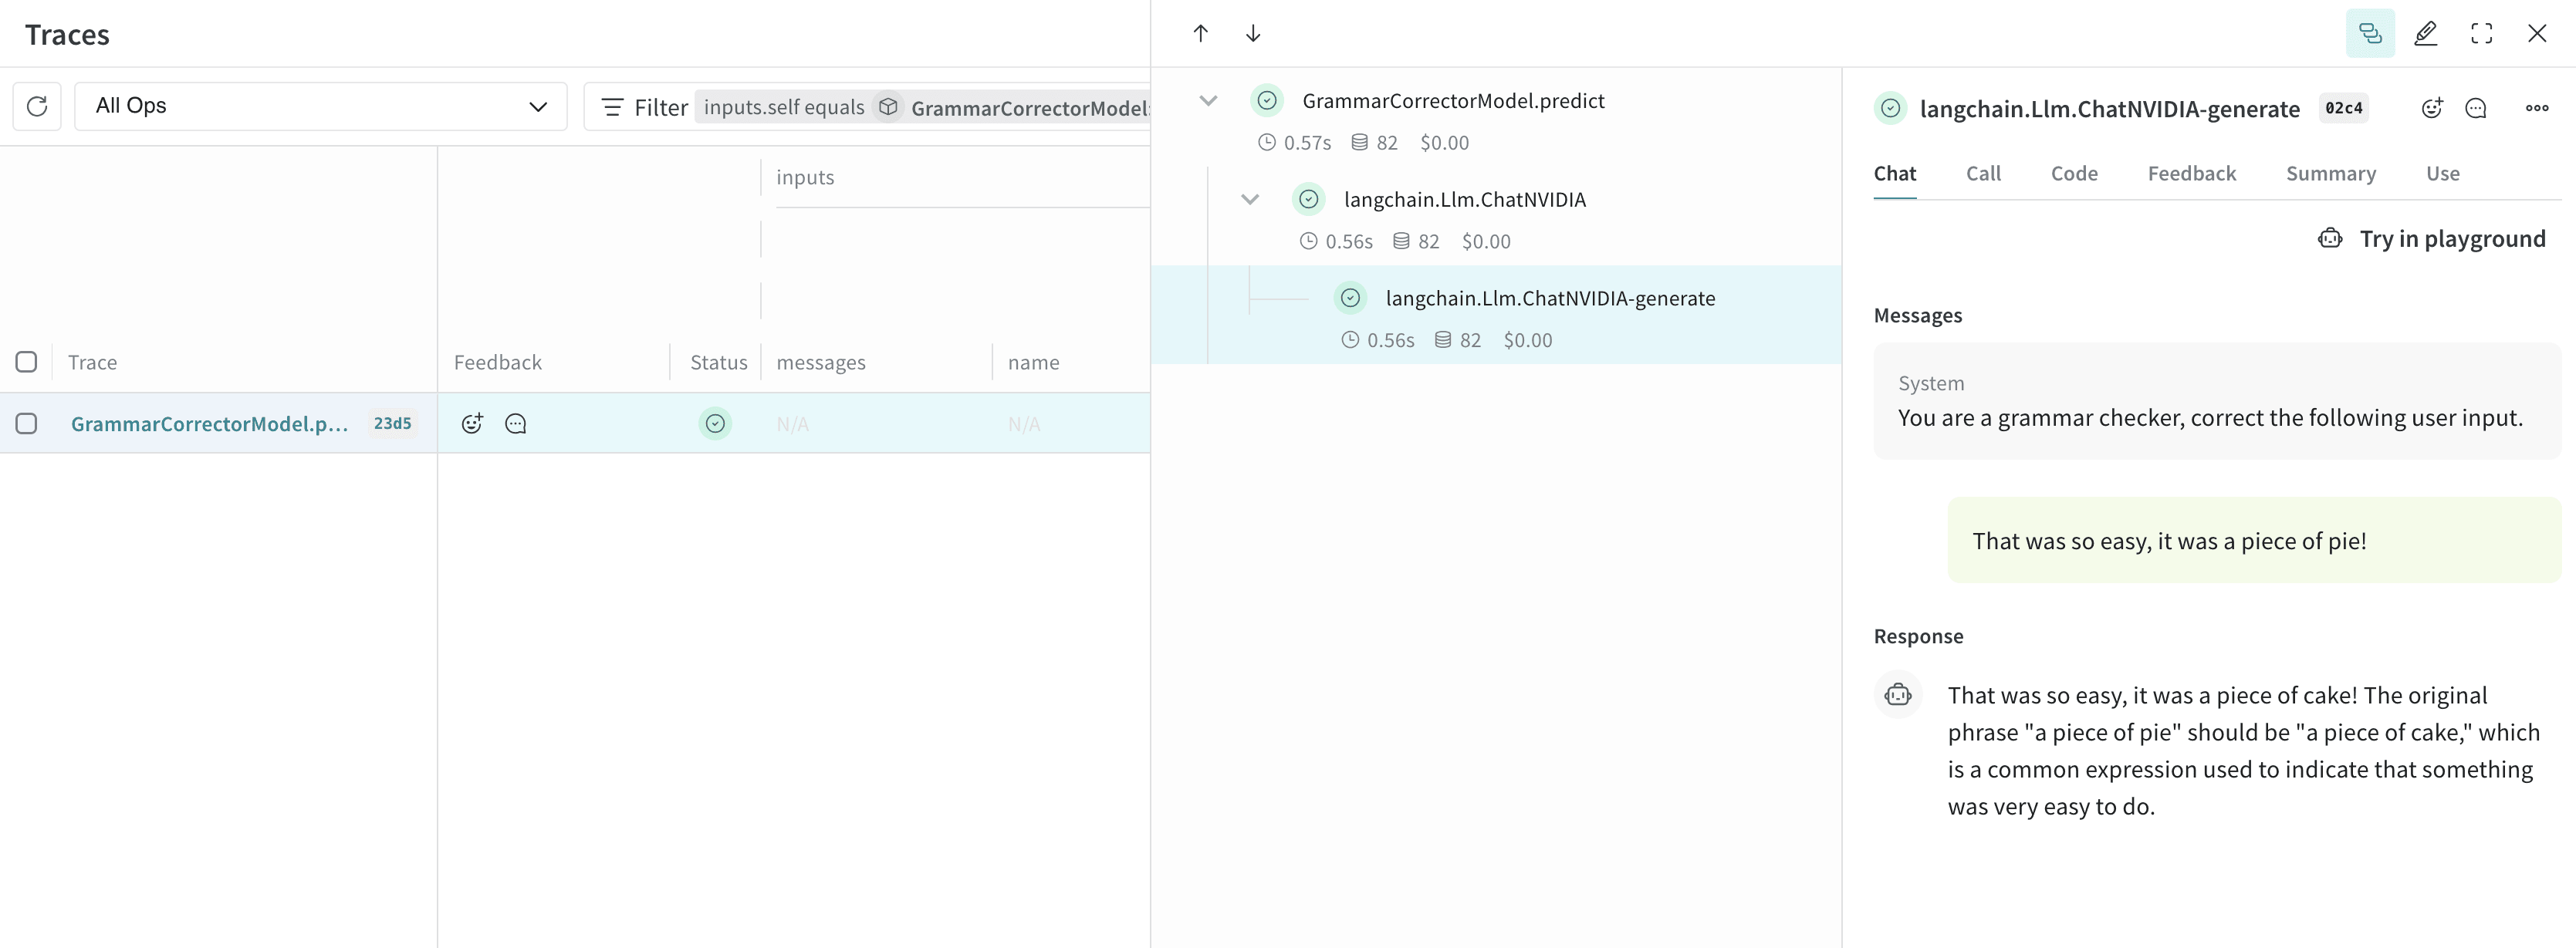
使用に関する情報
以下では、ChatNVIDIA インテグレーションがサポートする機能について説明します。 ChatNVIDIA インテグレーションは、invoke、stream、およびそれらの非同期版をサポートしています。ツールの使用もサポートしています。
ChatNVIDIA はさまざまなタイプのモデルでの使用を想定しているため、関数呼び出しはサポートしていません。