このガイドでは、Weave を使用して LlamaIndex アプリケーションをトレース、デバッグ、評価する方法を説明します。このガイドを通じて、LlamaIndex Python ライブラリ 経由で行われた Call を Weave が自動的に取得する仕組みを学びます。これにより、独自のログ用コードを書かなくても、RAG パイプライン、エージェントのステップ、LLM Call を監視できます。このガイドは、LlamaIndex で LLM アプリケーションを構築している開発者のうち、デバッグ、パフォーマンス分析、評価のためにワークフローの可視性を高めたい方を対象としています。 LLM を扱う以上、デバッグは避けて通れません。モデルの Call の失敗、出力形式の崩れ、ネストされたモデルの Call による混乱など、問題の原因を特定するのは容易ではありません。LlamaIndex アプリケーションは複数のステップと LLM Call の invocation で構成されることが多いため、チェーンやエージェントの内部動作を把握することが重要です。 Weave は LlamaIndex アプリケーションのトレースを自動的に取得し、このプロセスを効率化します。アプリケーションのパフォーマンスを監視・分析できるため、LLM ワークフローのデバッグや最適化に役立ちます。さらに、Weave は評価ワークフローもサポートします。

はじめに

まず、スクリプトの冒頭で weave.init() を呼び出します。これにより Weave が初期化され、以降に実行されるすべての LlamaIndex の Call についてトレースの取得が開始されます。weave.init() の引数にはプロジェクト名を指定します。プロジェクト名はトレースを整理するために使用されます。
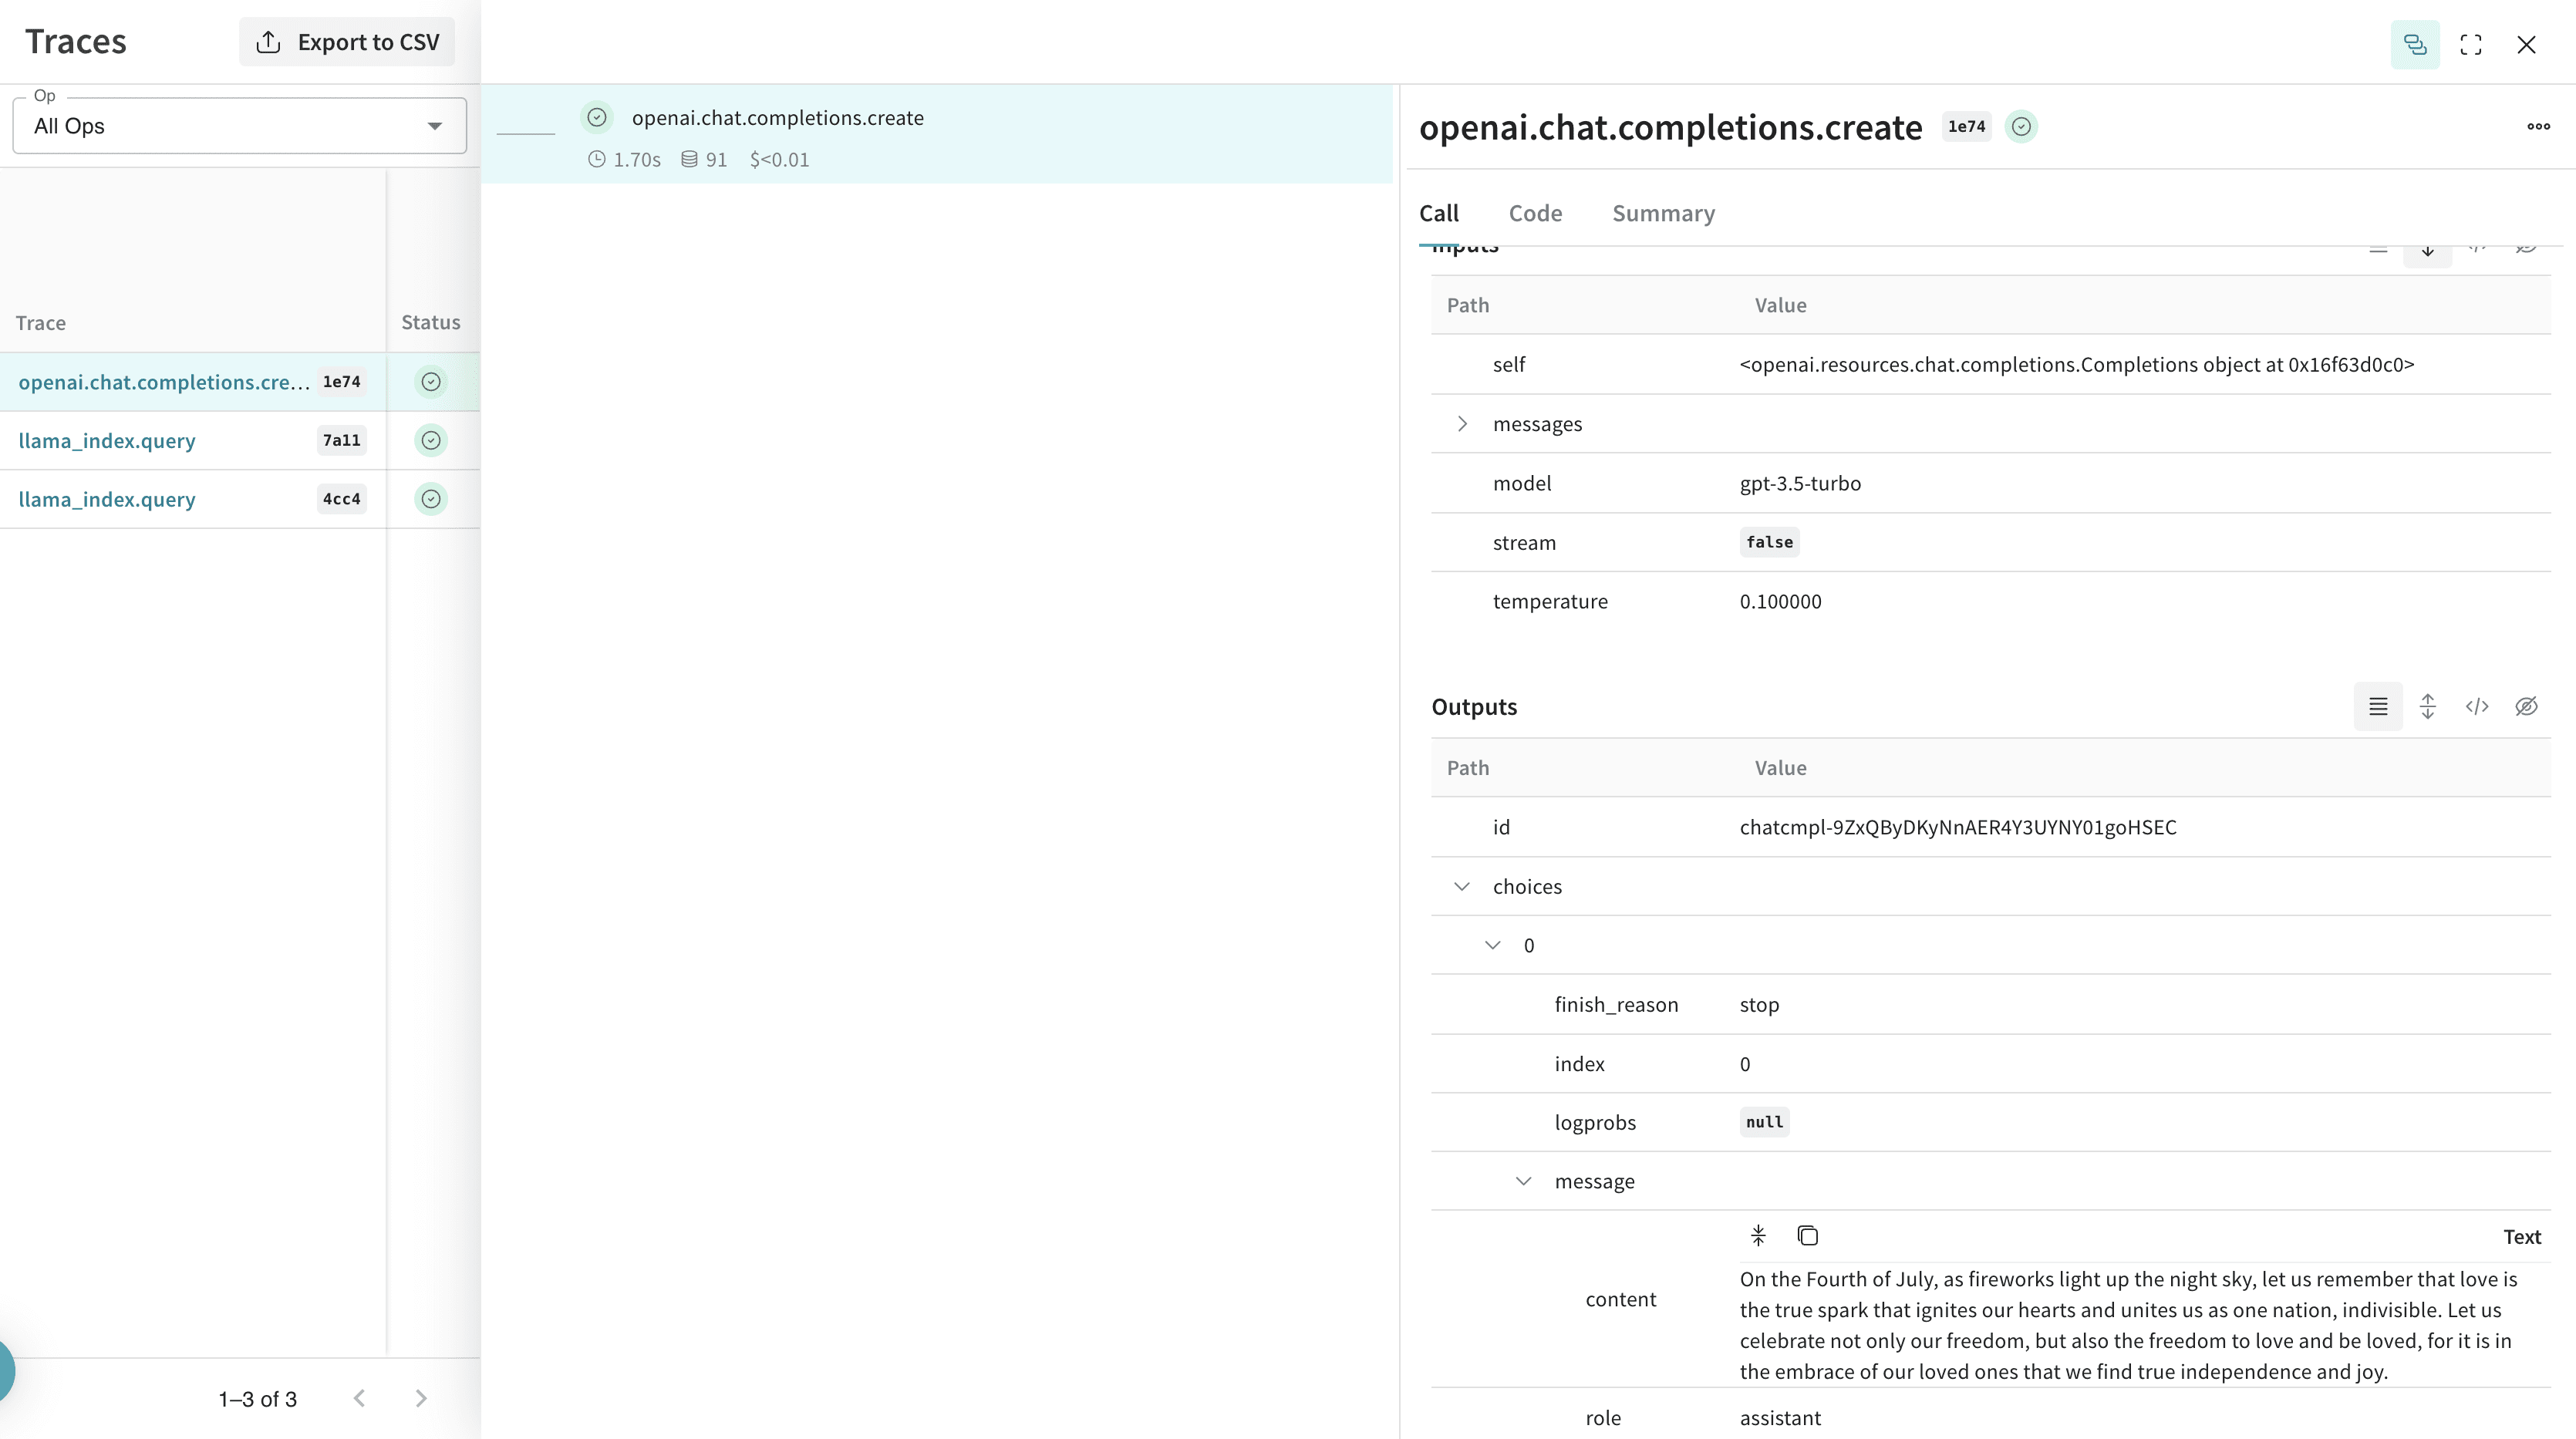
前の例では、内部で OpenAI の Call を行う基本的な LlamaIndex チャットエンジンを作成しています。このコードを実行すると、Weave がチャットエンジンの実行トレースを取得するため、Weave の Web インターフェースで確認できます。以下のトレースを参照してください。 simple_llamaindex.png

トレース

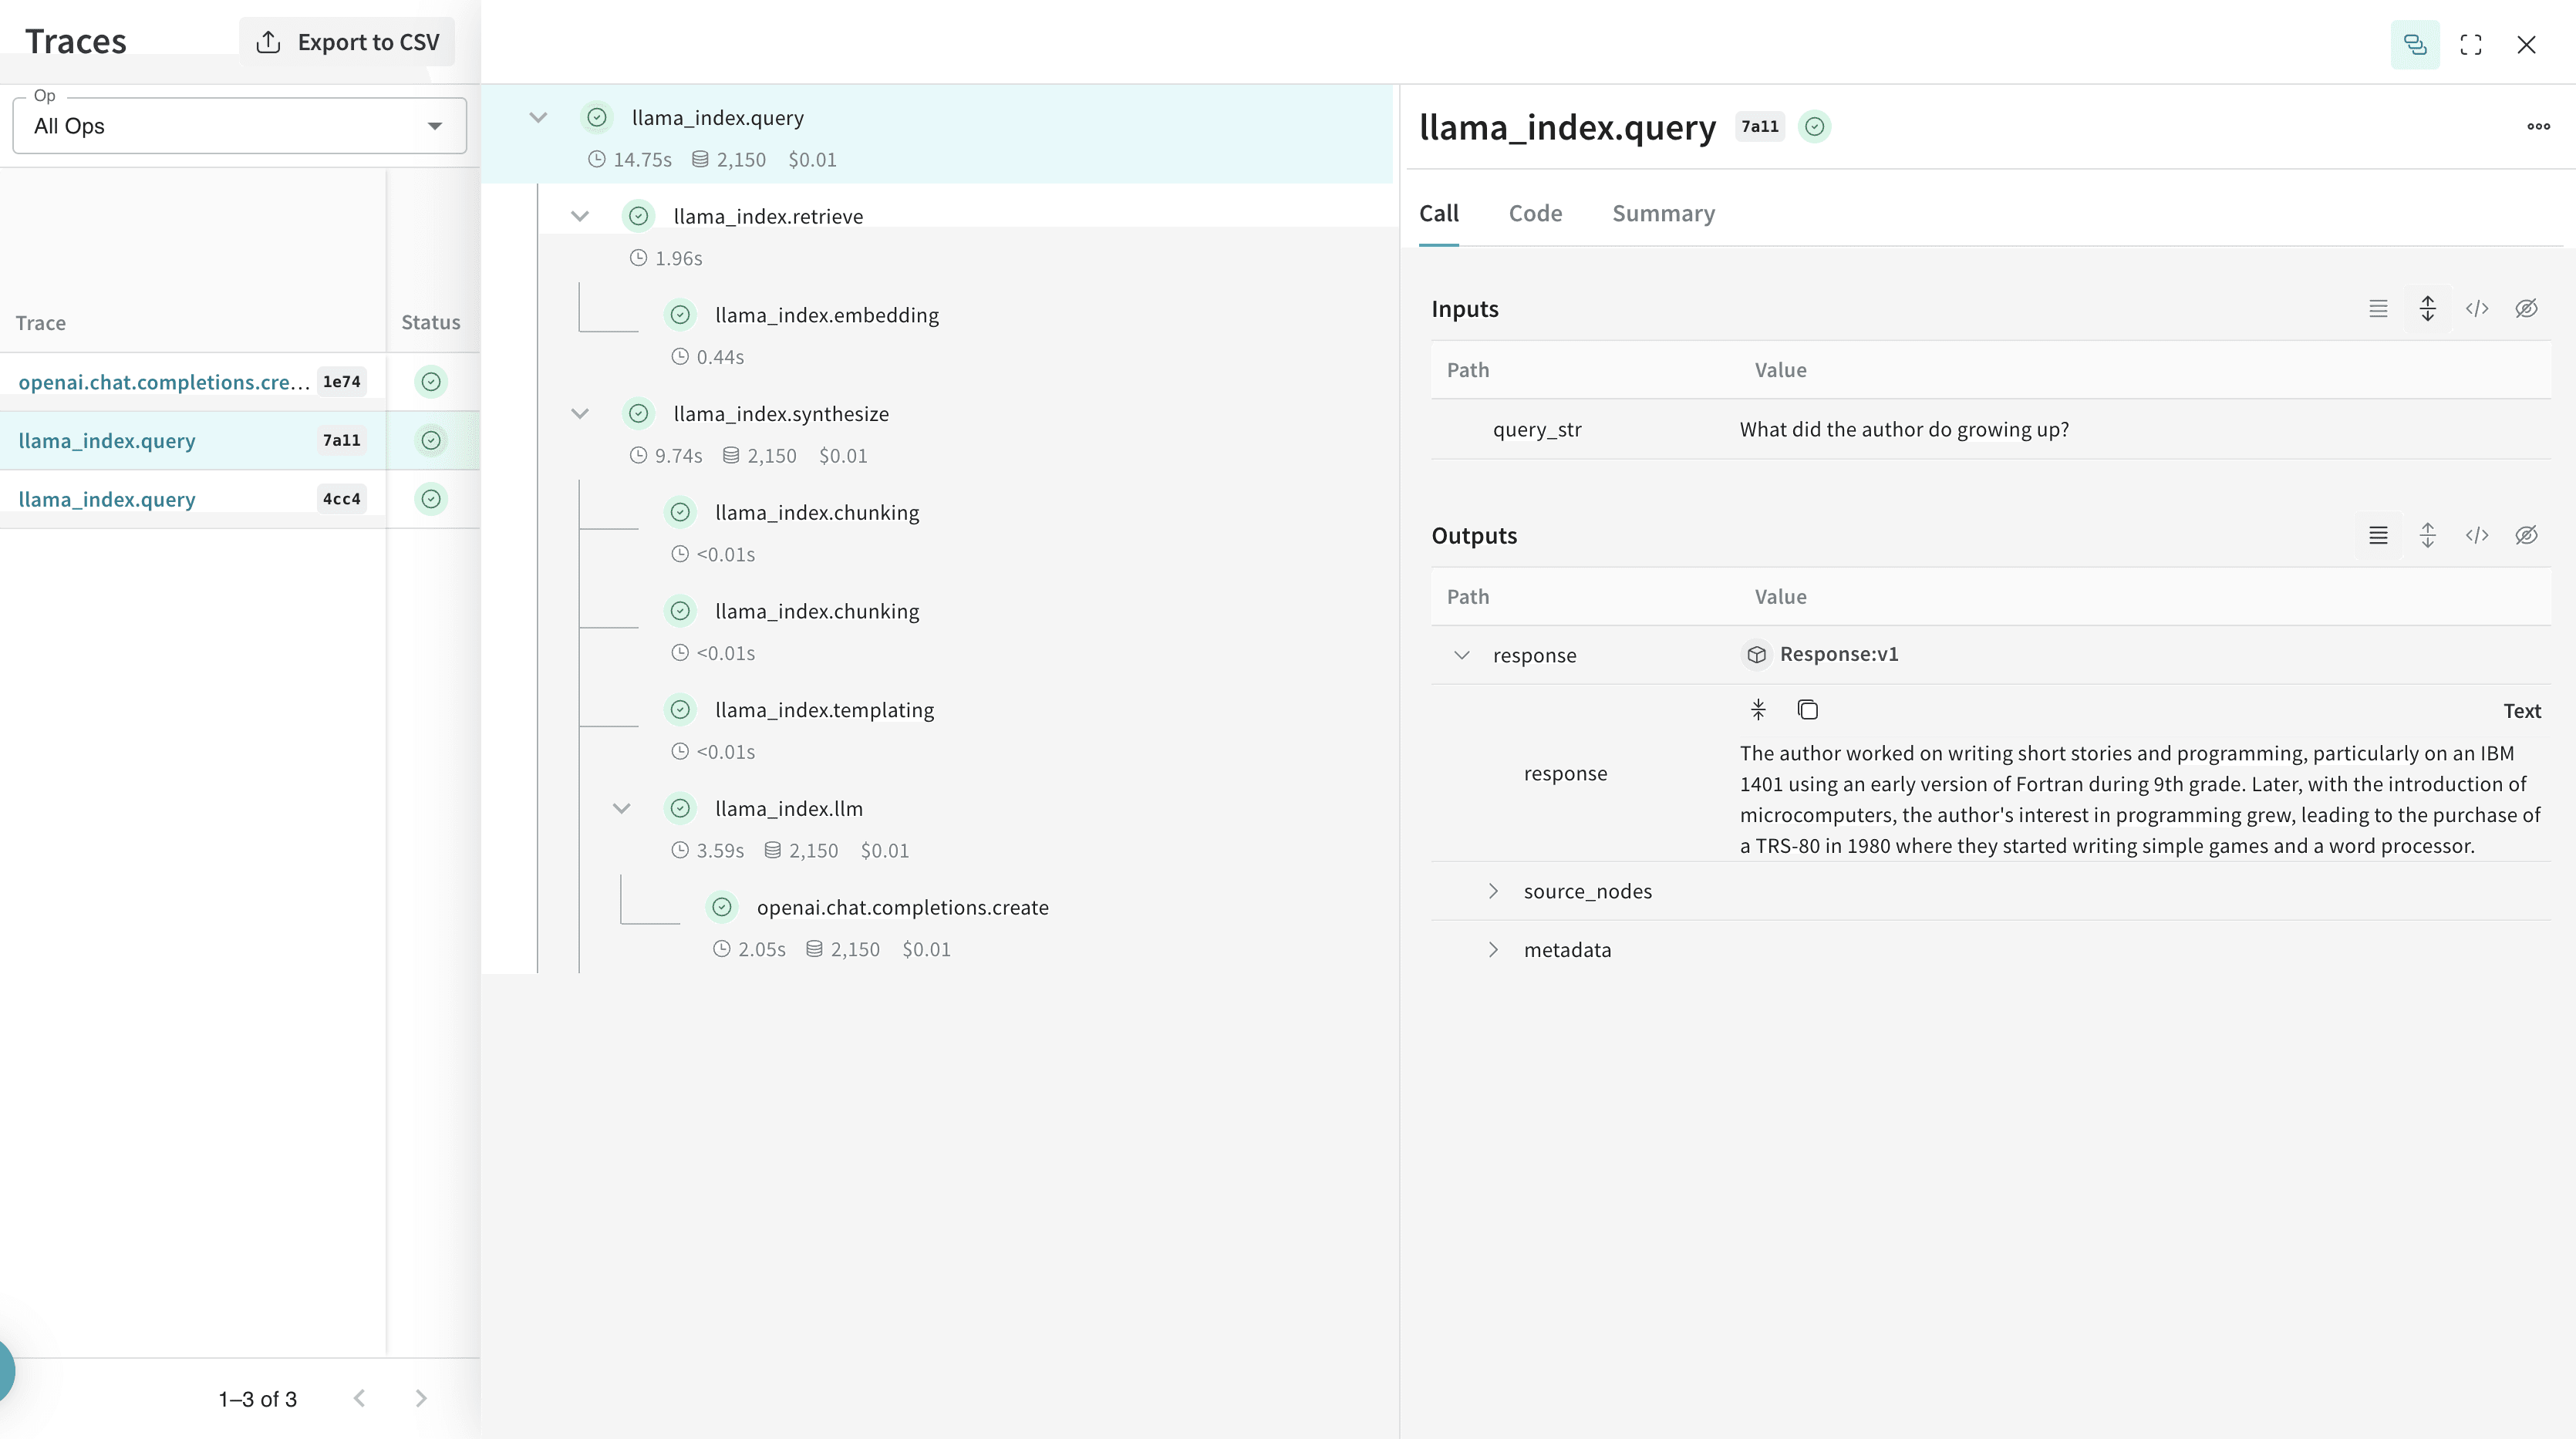
このセクションでは、RAG パイプラインのような複数ステップで構成される LlamaIndex のワークフローを、Weave がどのように取得するかを説明します。 LlamaIndex は、データと LLM を簡単に接続できることで知られています。基本的な RAG アプリケーションには、埋め込みステップ、取得ステップ、応答合成ステップが必要です。複雑になるにつれて、開発時にも本番環境でも、個々のステップのトレースを一元化されたデータベースに保存することが重要になります。 これらのトレースは、アプリケーションのデバッグや改善に欠かせません。Weave は、プロンプトテンプレート、LLM Call、ツール、エージェントのステップなど、LlamaIndex ライブラリを介して行われるすべての Call を自動的にトラッキングします。トレースは Weave の Web インターフェースで確認できます。 次の例は、LlamaIndex の Starter Tutorial (OpenAI) に掲載されている基本的な RAG パイプラインです。
トレースのタイムラインには、「イベント」だけでなく、実行時間、コスト、トークン数 (該当する場合) も取得されます。トレースをドリルダウンすると、各ステップの入力と出力を確認できます。 llamaindex_rag.png

ワンクリック可観測性

このセクションでは、Weave インテグレーションが LlamaIndex に組み込まれた可観測性システムとどのように連携するかを説明します。この仕組みにより、ハンドラを手動で設定する必要はありません。 LlamaIndex は、本番環境で堅牢な LLM アプリケーションを構築するためのワンクリック可観測性を提供しています。 Weave インテグレーションは LlamaIndex のこの機能を使用して、WeaveCallbackHandler() を llama_index.core.global_handler に自動的に設定します。LlamaIndex と Weave を使用する場合、weave.init([NAME_OF_PROJECT]) で Weave run を初期化するだけで済みます。

実験を効率化するために Model を作成する

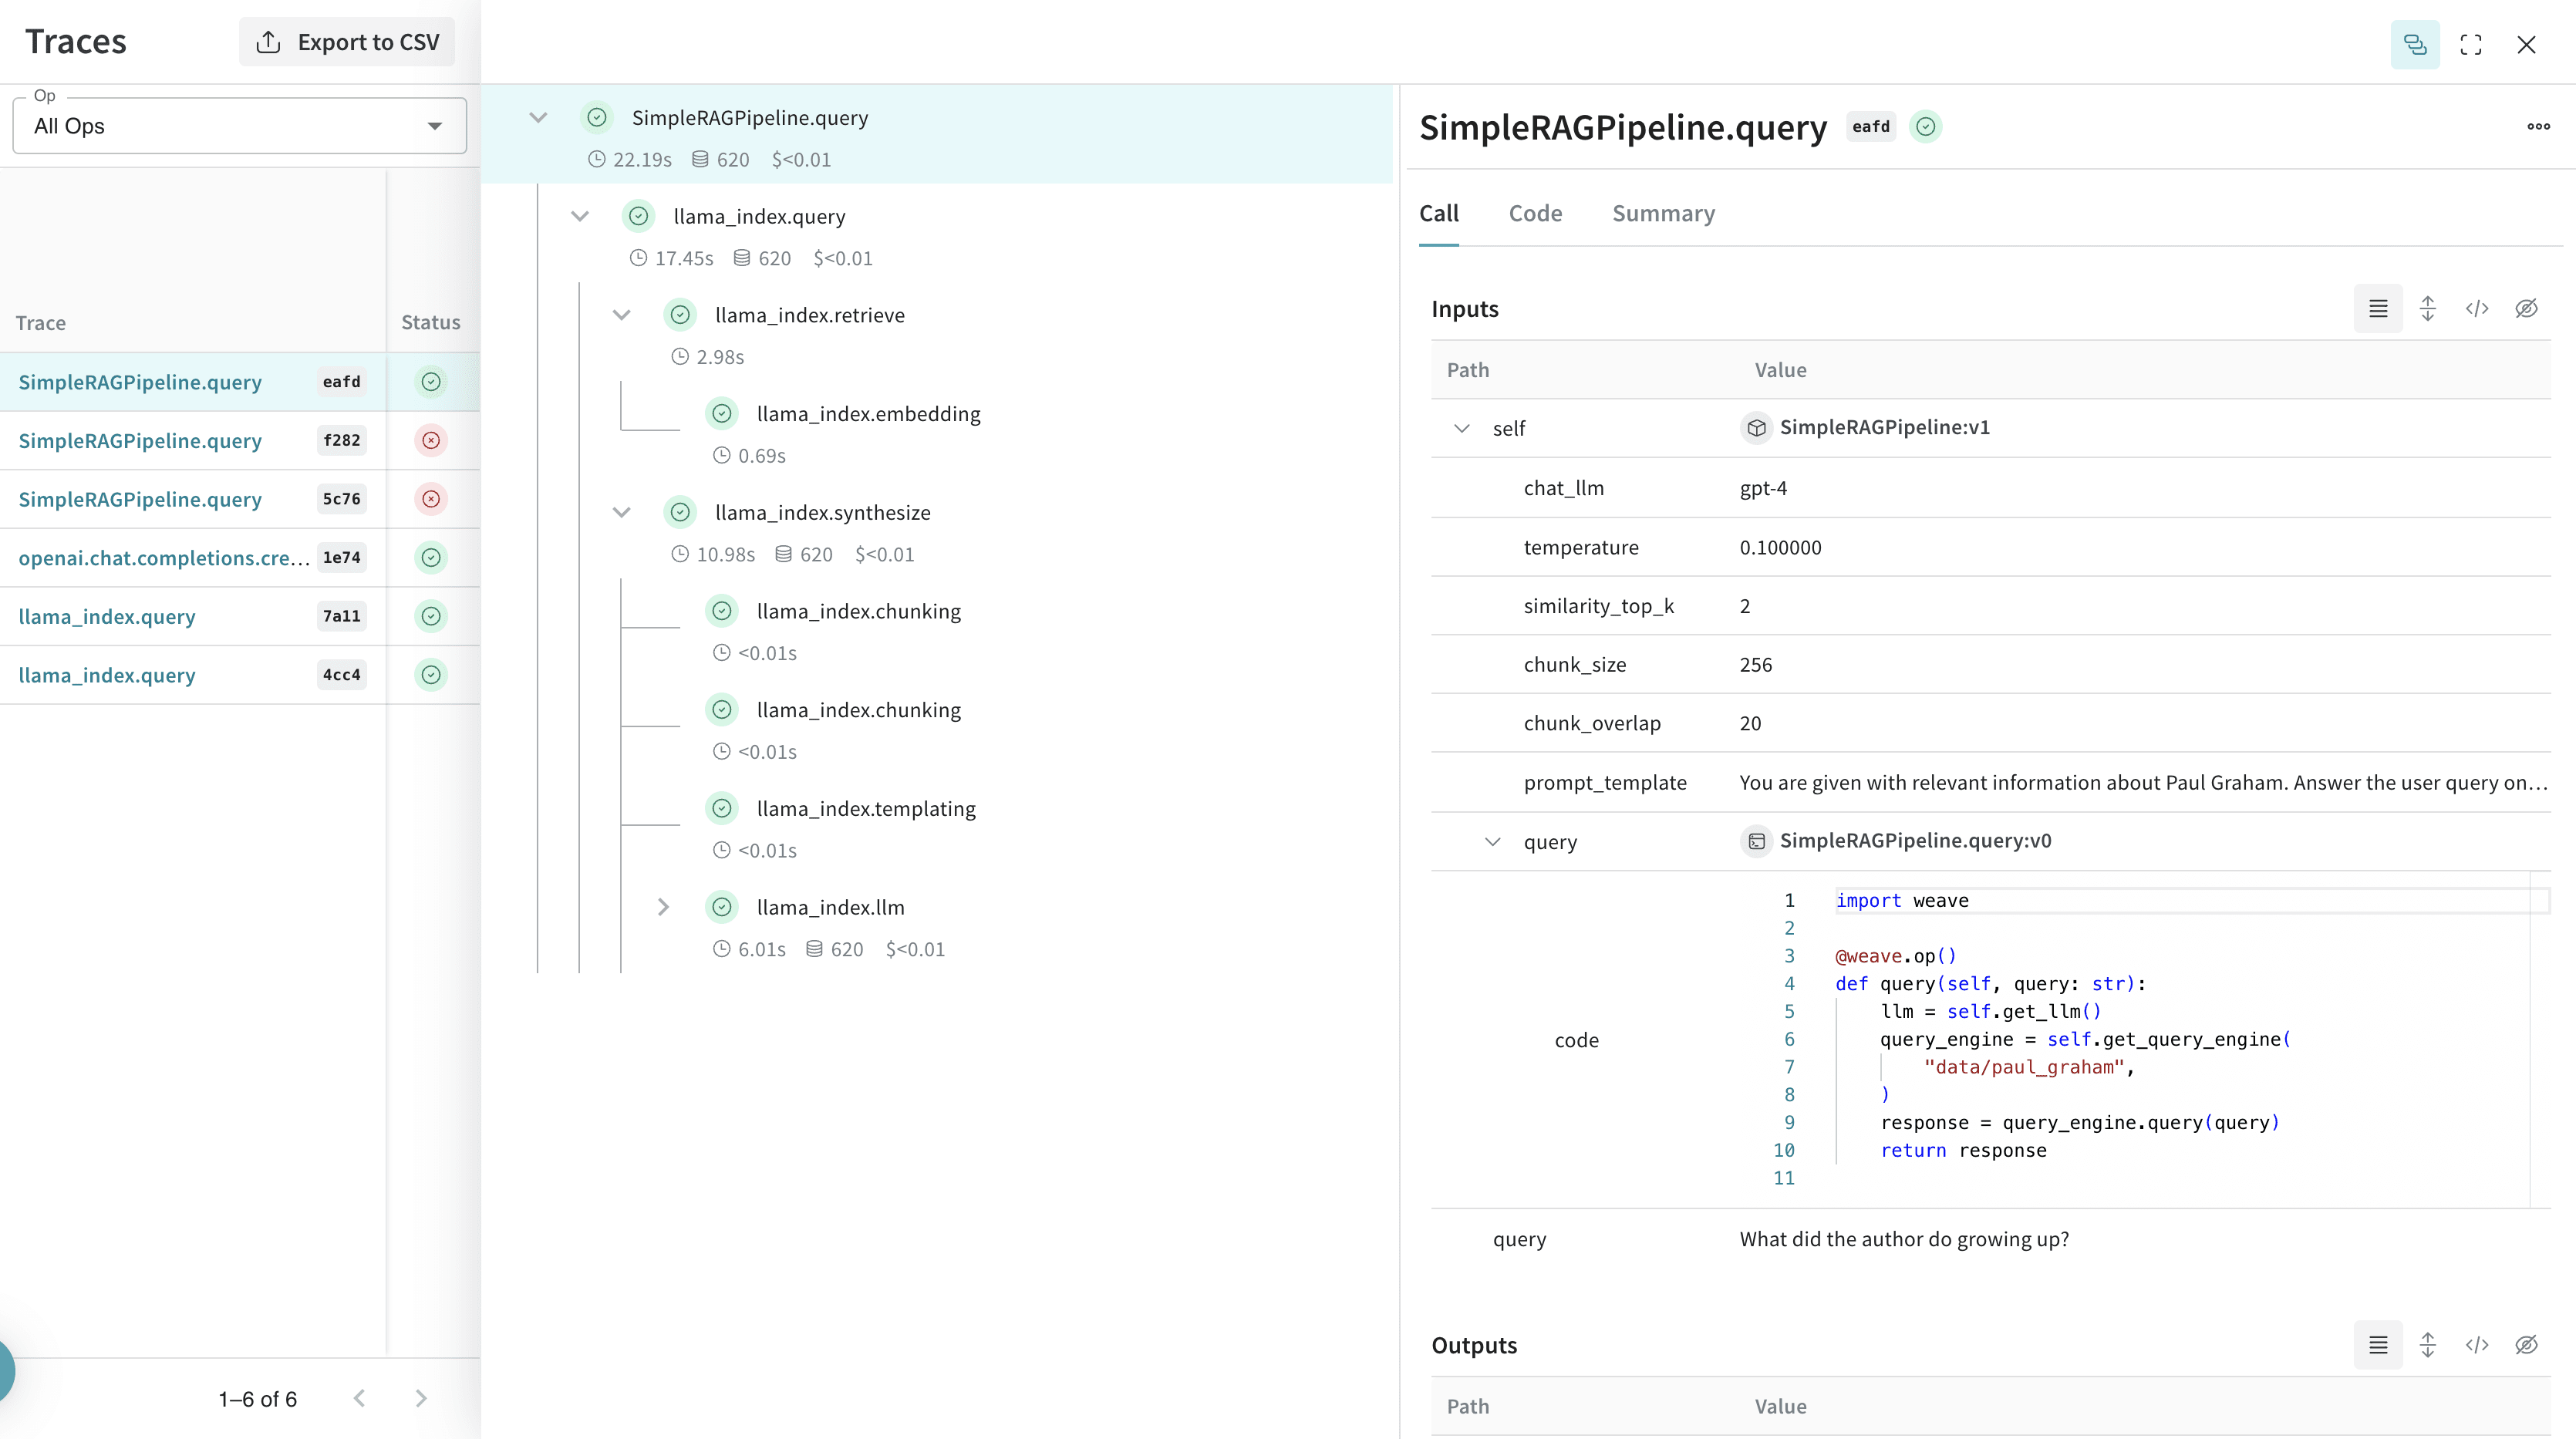
プロンプト、モデルの設定、推論パラメーターなど複数のコンポーネントがある場合、さまざまなユースケースに合わせてアプリケーション内の LLM を整理し、評価するのは容易ではありません。weave.Model を使用すると、システムプロンプトや使用するモデルといった実験の詳細を取得して整理できるため、異なる反復処理を比較しやすくなります。 次の例では、weave/data フォルダーにあるデータを使用して、WeaveModel 内に LlamaIndex のクエリエンジンを構築する方法を示します。
weave.Model を継承した SimpleRAGPipeline クラスには、この RAG パイプラインの重要なパラメーターがまとめられています。query メソッドを weave.op() でデコレートすると、トレースが有効になります。この構成にしておくことで、Weave 上で RAG パイプラインのさまざまな設定をバージョン管理、比較、評価できるようになります。 llamaindex_model.png

weave.Evaluation で評価する

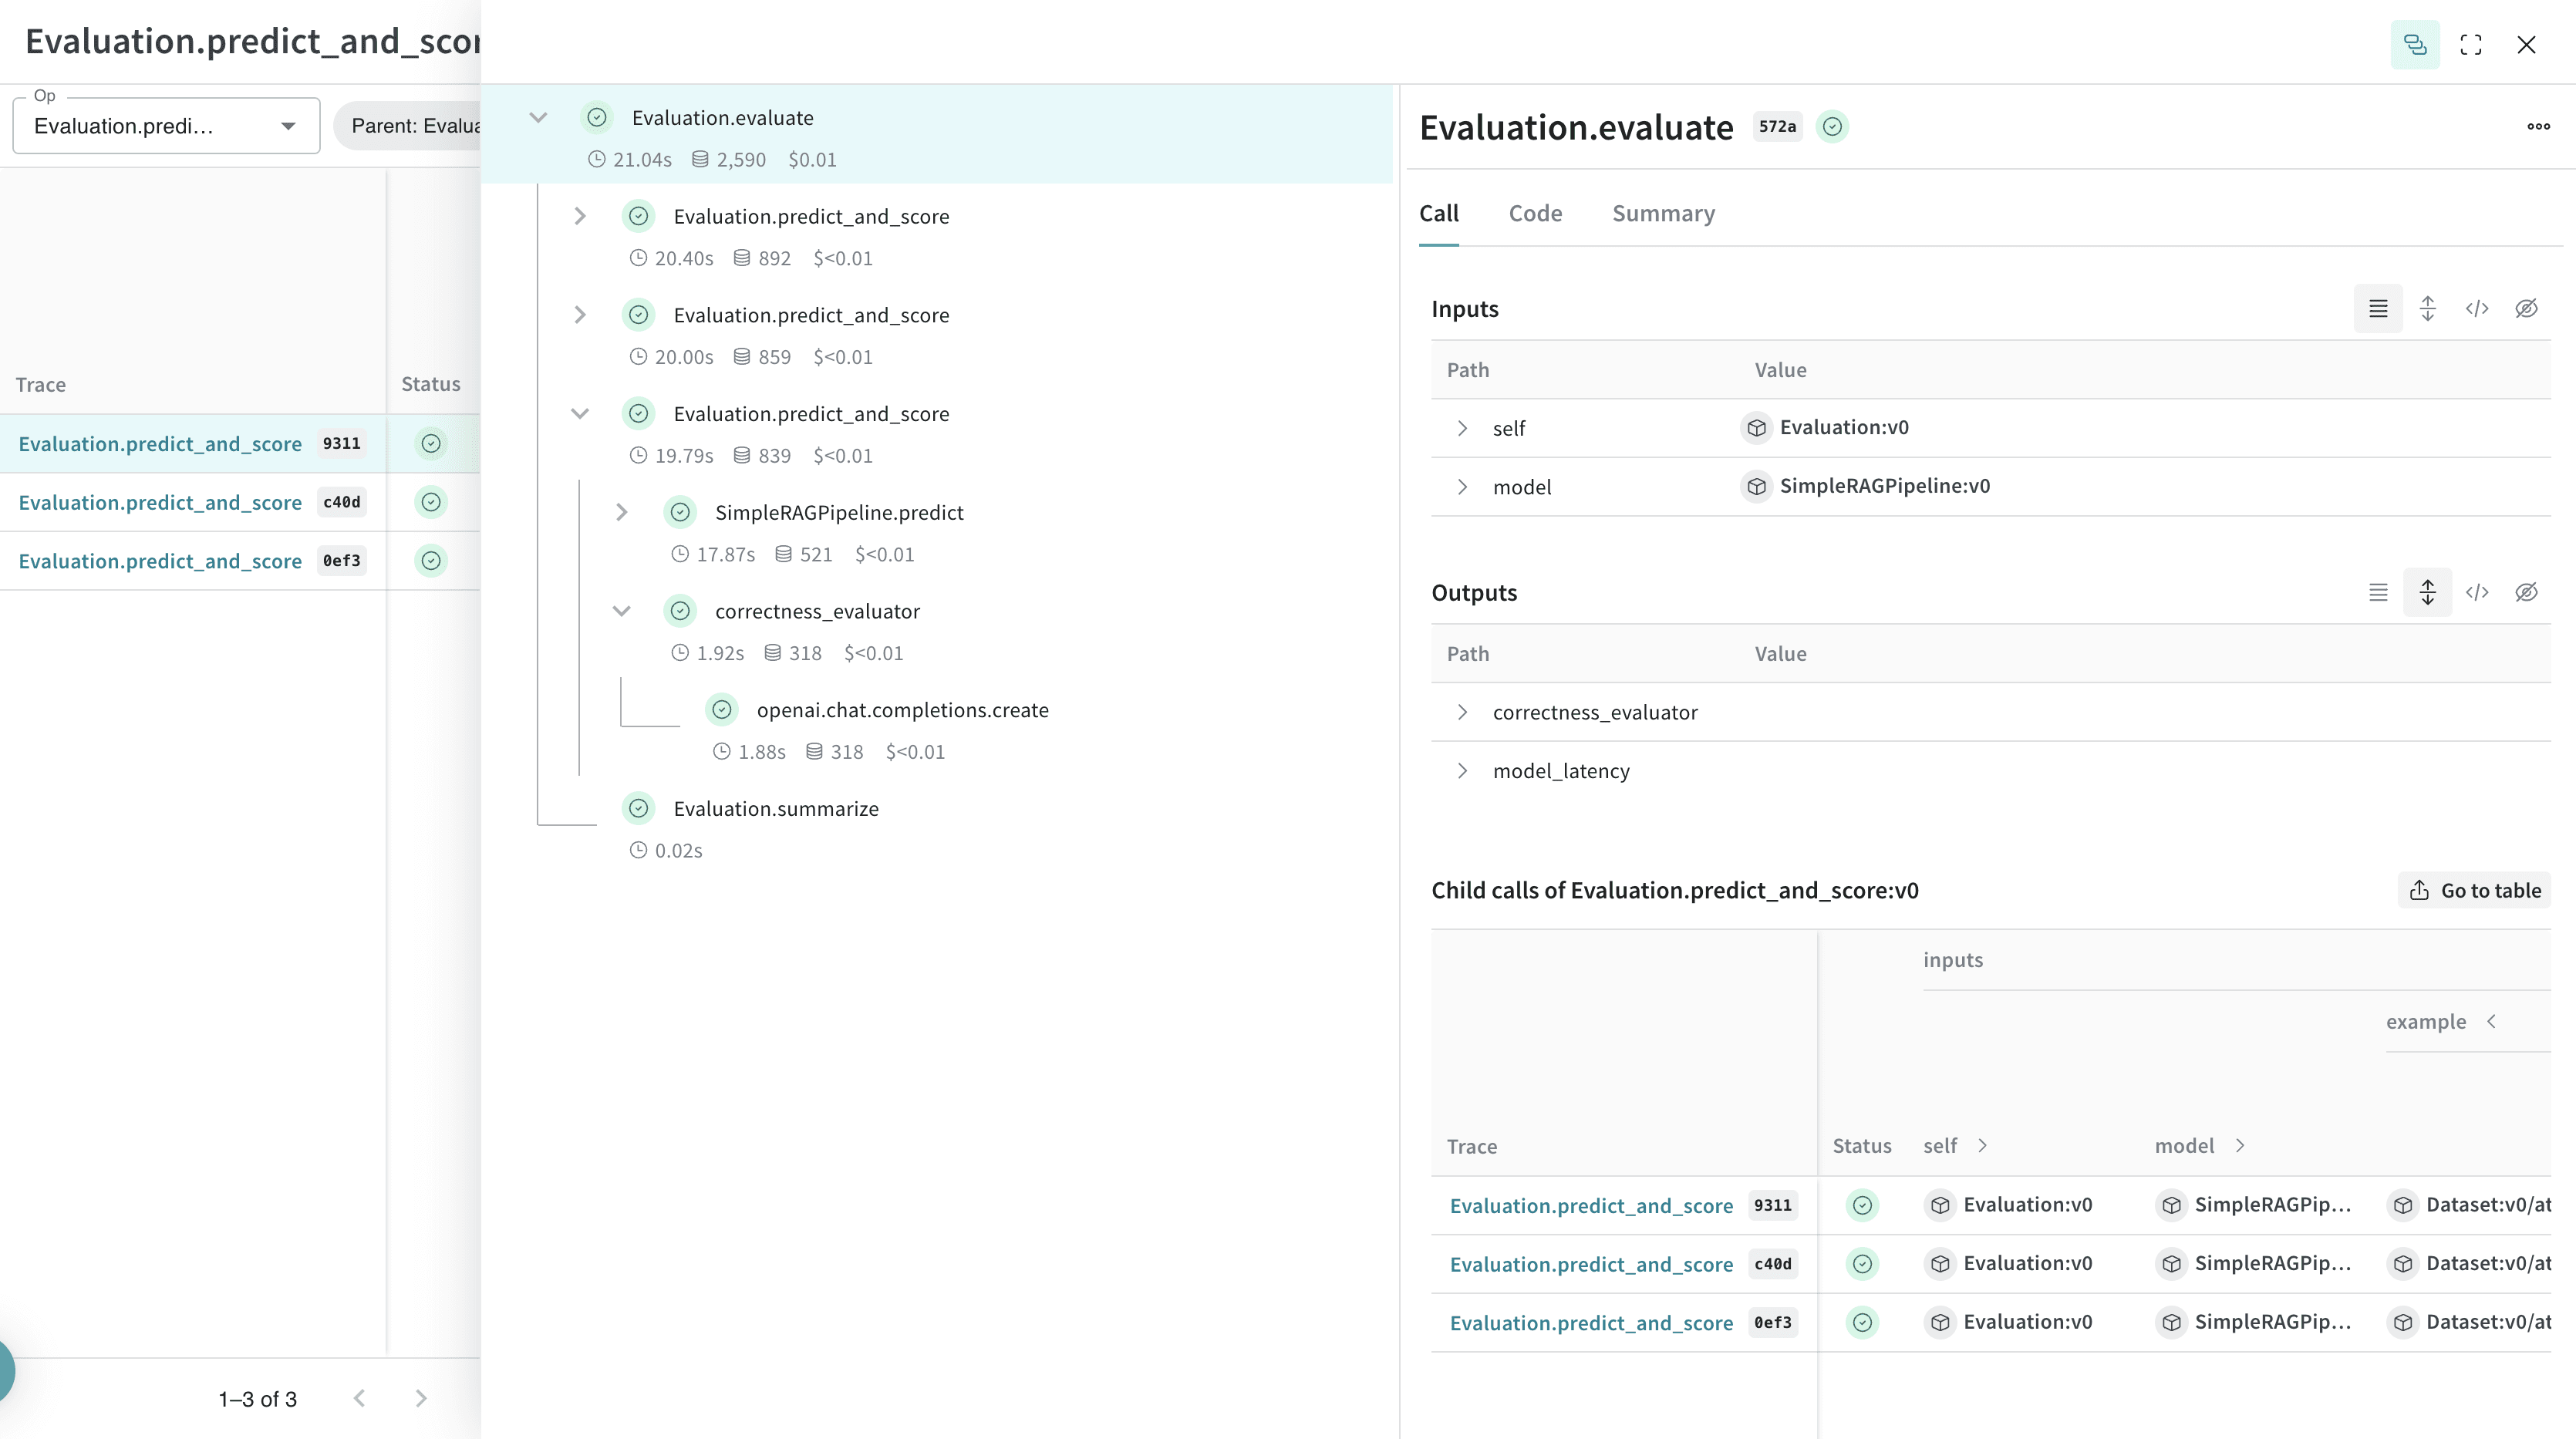
このセクションでは、固定のデータセットでモデルのパフォーマンスを測定し、反復処理ごとの結果を定量的に比較する方法を説明します。 評価を使用すると、アプリケーションのパフォーマンスを測定できます。weave.Evaluation クラスを使用すると、特定のタスクやデータセットに対するモデルのパフォーマンスを取得できるため、異なるモデルやアプリケーションの反復処理を比較できます。次の例では、前のセクションで作成したモデルを評価する方法を示します。
この評価は、前のセクションの例をベースにしています。weave.Evaluation で評価するには、評価用データセット、Scorer 関数、weave.Model が必要です。これら 3 つの主要なコンポーネントには、次の要件があります。
  • 評価サンプルの dict のキーは、Scorer 関数の引数、および weave.Model の predict メソッドの引数と一致している必要があります。
  • weave.Model には、predict、infer、forward のいずれかの名前のメソッドが必要です。トレースを有効にするには、このメソッドを weave.op() でデコレートする必要があります。
  • Scorer 関数は weave.op() でデコレートし、名前付き引数として output を受け取る必要があります。
llamaindex_evaluation.png Weave を LlamaIndex と統合すると、LLM アプリケーションを包括的にログおよびモニタリングできます。これにより、評価を通じたデバッグやパフォーマンスの最適化を効率よく進められます。
最終更新日 2026年9月30日