このページのコードサンプルはすべて Python です。
Google Colab で Hugging Face Hub と Weave を試す
セットアップなしで Hugging Face Hub と Weave を試してみたい場合は、ここで紹介するコードサンプルを Google Colab 上の Jupyter ノートブックで実行できます。
概要
Hugging Face Hub は、クリエイターやコラボレーターのための機械学習プラットフォームです。さまざまなタイプのプロジェクトに活用できる、事前トレーニング済みモデルとデータセットの大規模なコレクションを提供しています。huggingface_hub Python ライブラリは、Hub でホストされているモデルに対して、複数のサービスをまたいで推論を実行するための統一されたインターフェースを提供します。これらのモデルは InferenceClient を使用して呼び出せます。
Weave は InferenceClient のトレースを自動的に取得します。トラッキングを開始するには、weave.init() を呼び出してから、通常どおりライブラリを使用します。
前提条件
始める前に、次のセットアップ手順を実行して、必要なライブラリをインストールし、Hugging Face Hub へのアクセスを設定してください。-
Weave で
huggingface_hubを使用するには、必要なライブラリをインストールするか、最新バージョンにアップグレードする必要があります。次のコマンドは、huggingface_hubとweaveをインストールします (すでにインストールされている場合は最新バージョンにアップグレードします) 。また、インストール時の出力を抑制します。 -
Hugging Face Hub 上のモデルで推論を使用するには、User Access Token を設定します。トークンは Hugging Face Hub の設定ページで設定することも、プログラムから設定することもできます。次のコードサンプルは、
HUGGINGFACE_TOKENの入力を求め、入力されたトークンを環境変数として設定します。
基本的なトレース
言語モデルアプリケーションのトレースを一か所に集約して保存することは、開発時にも本番環境でも欠かせません。トレースはデバッグに役立つだけでなく、アプリケーションを改善するためのデータセットとしても活用できます。 Weave はInferenceClient のトレースを自動的に取得します。トラッキングを開始するには、weave.init() を呼び出して Weave を初期化し、あとは通常どおりライブラリを使用してください。
次の例では、Weave を使用して Hugging Face Hub への推論 Call をログする方法を示します。
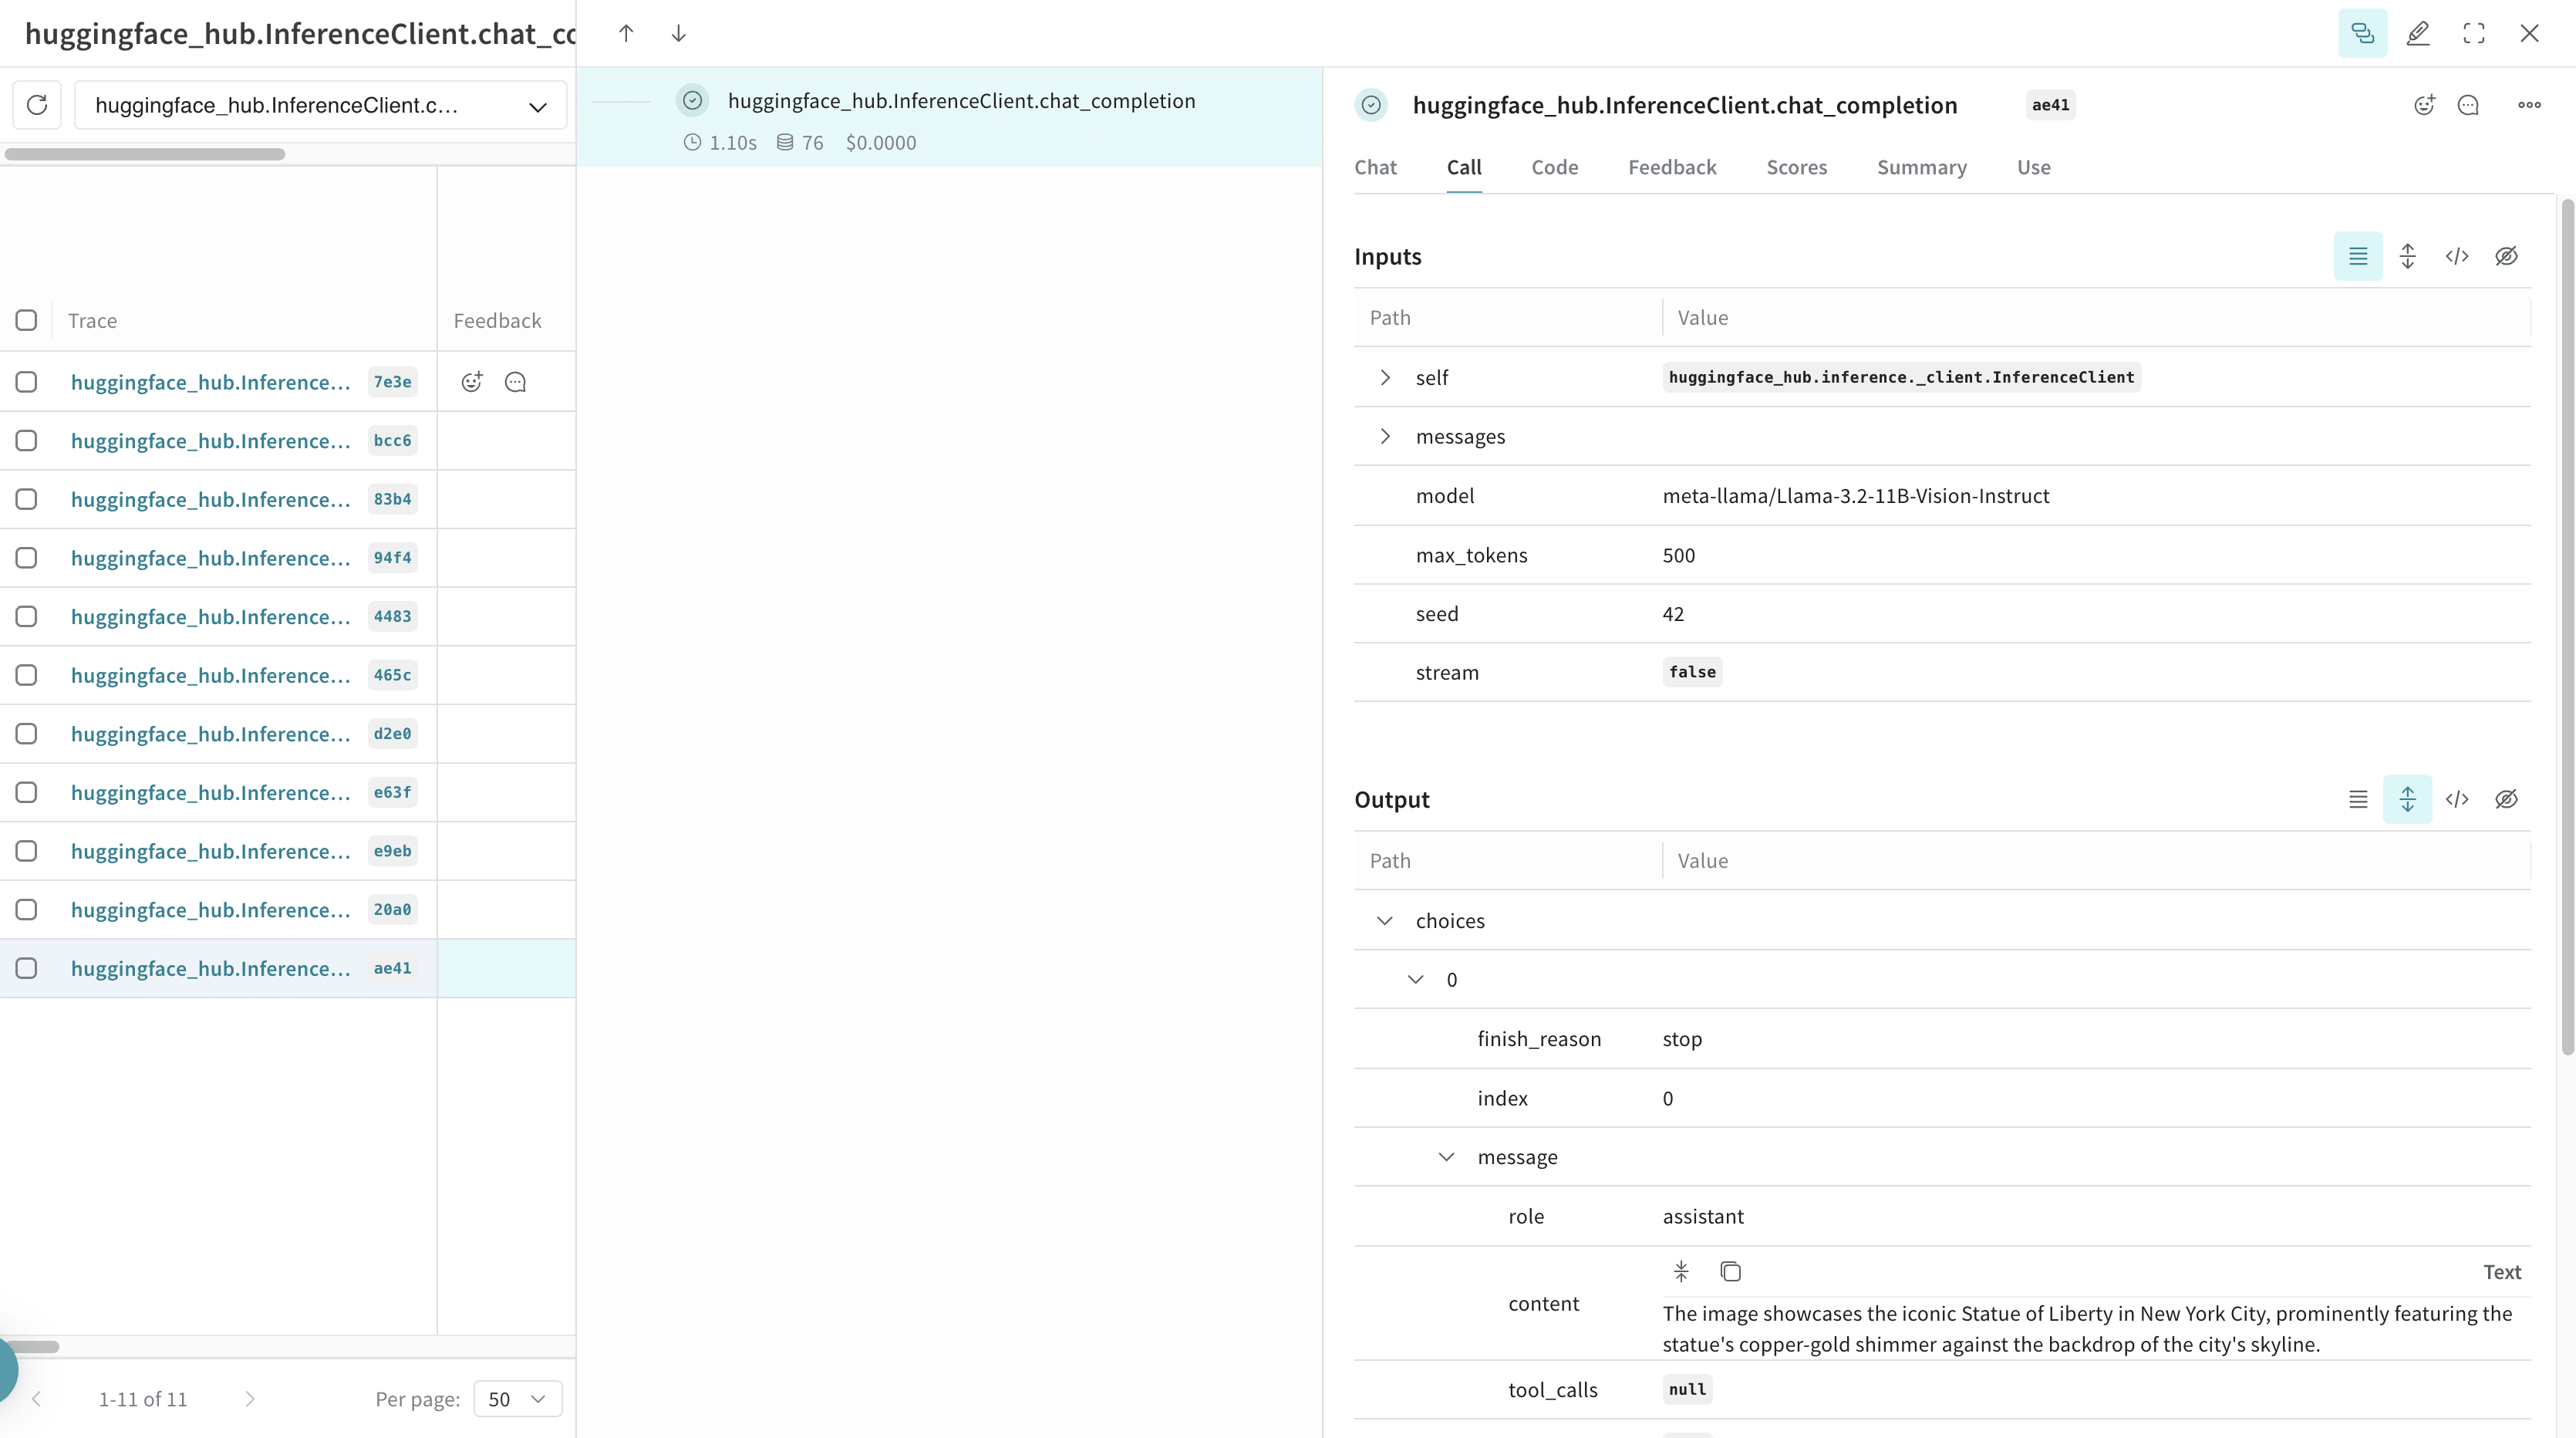
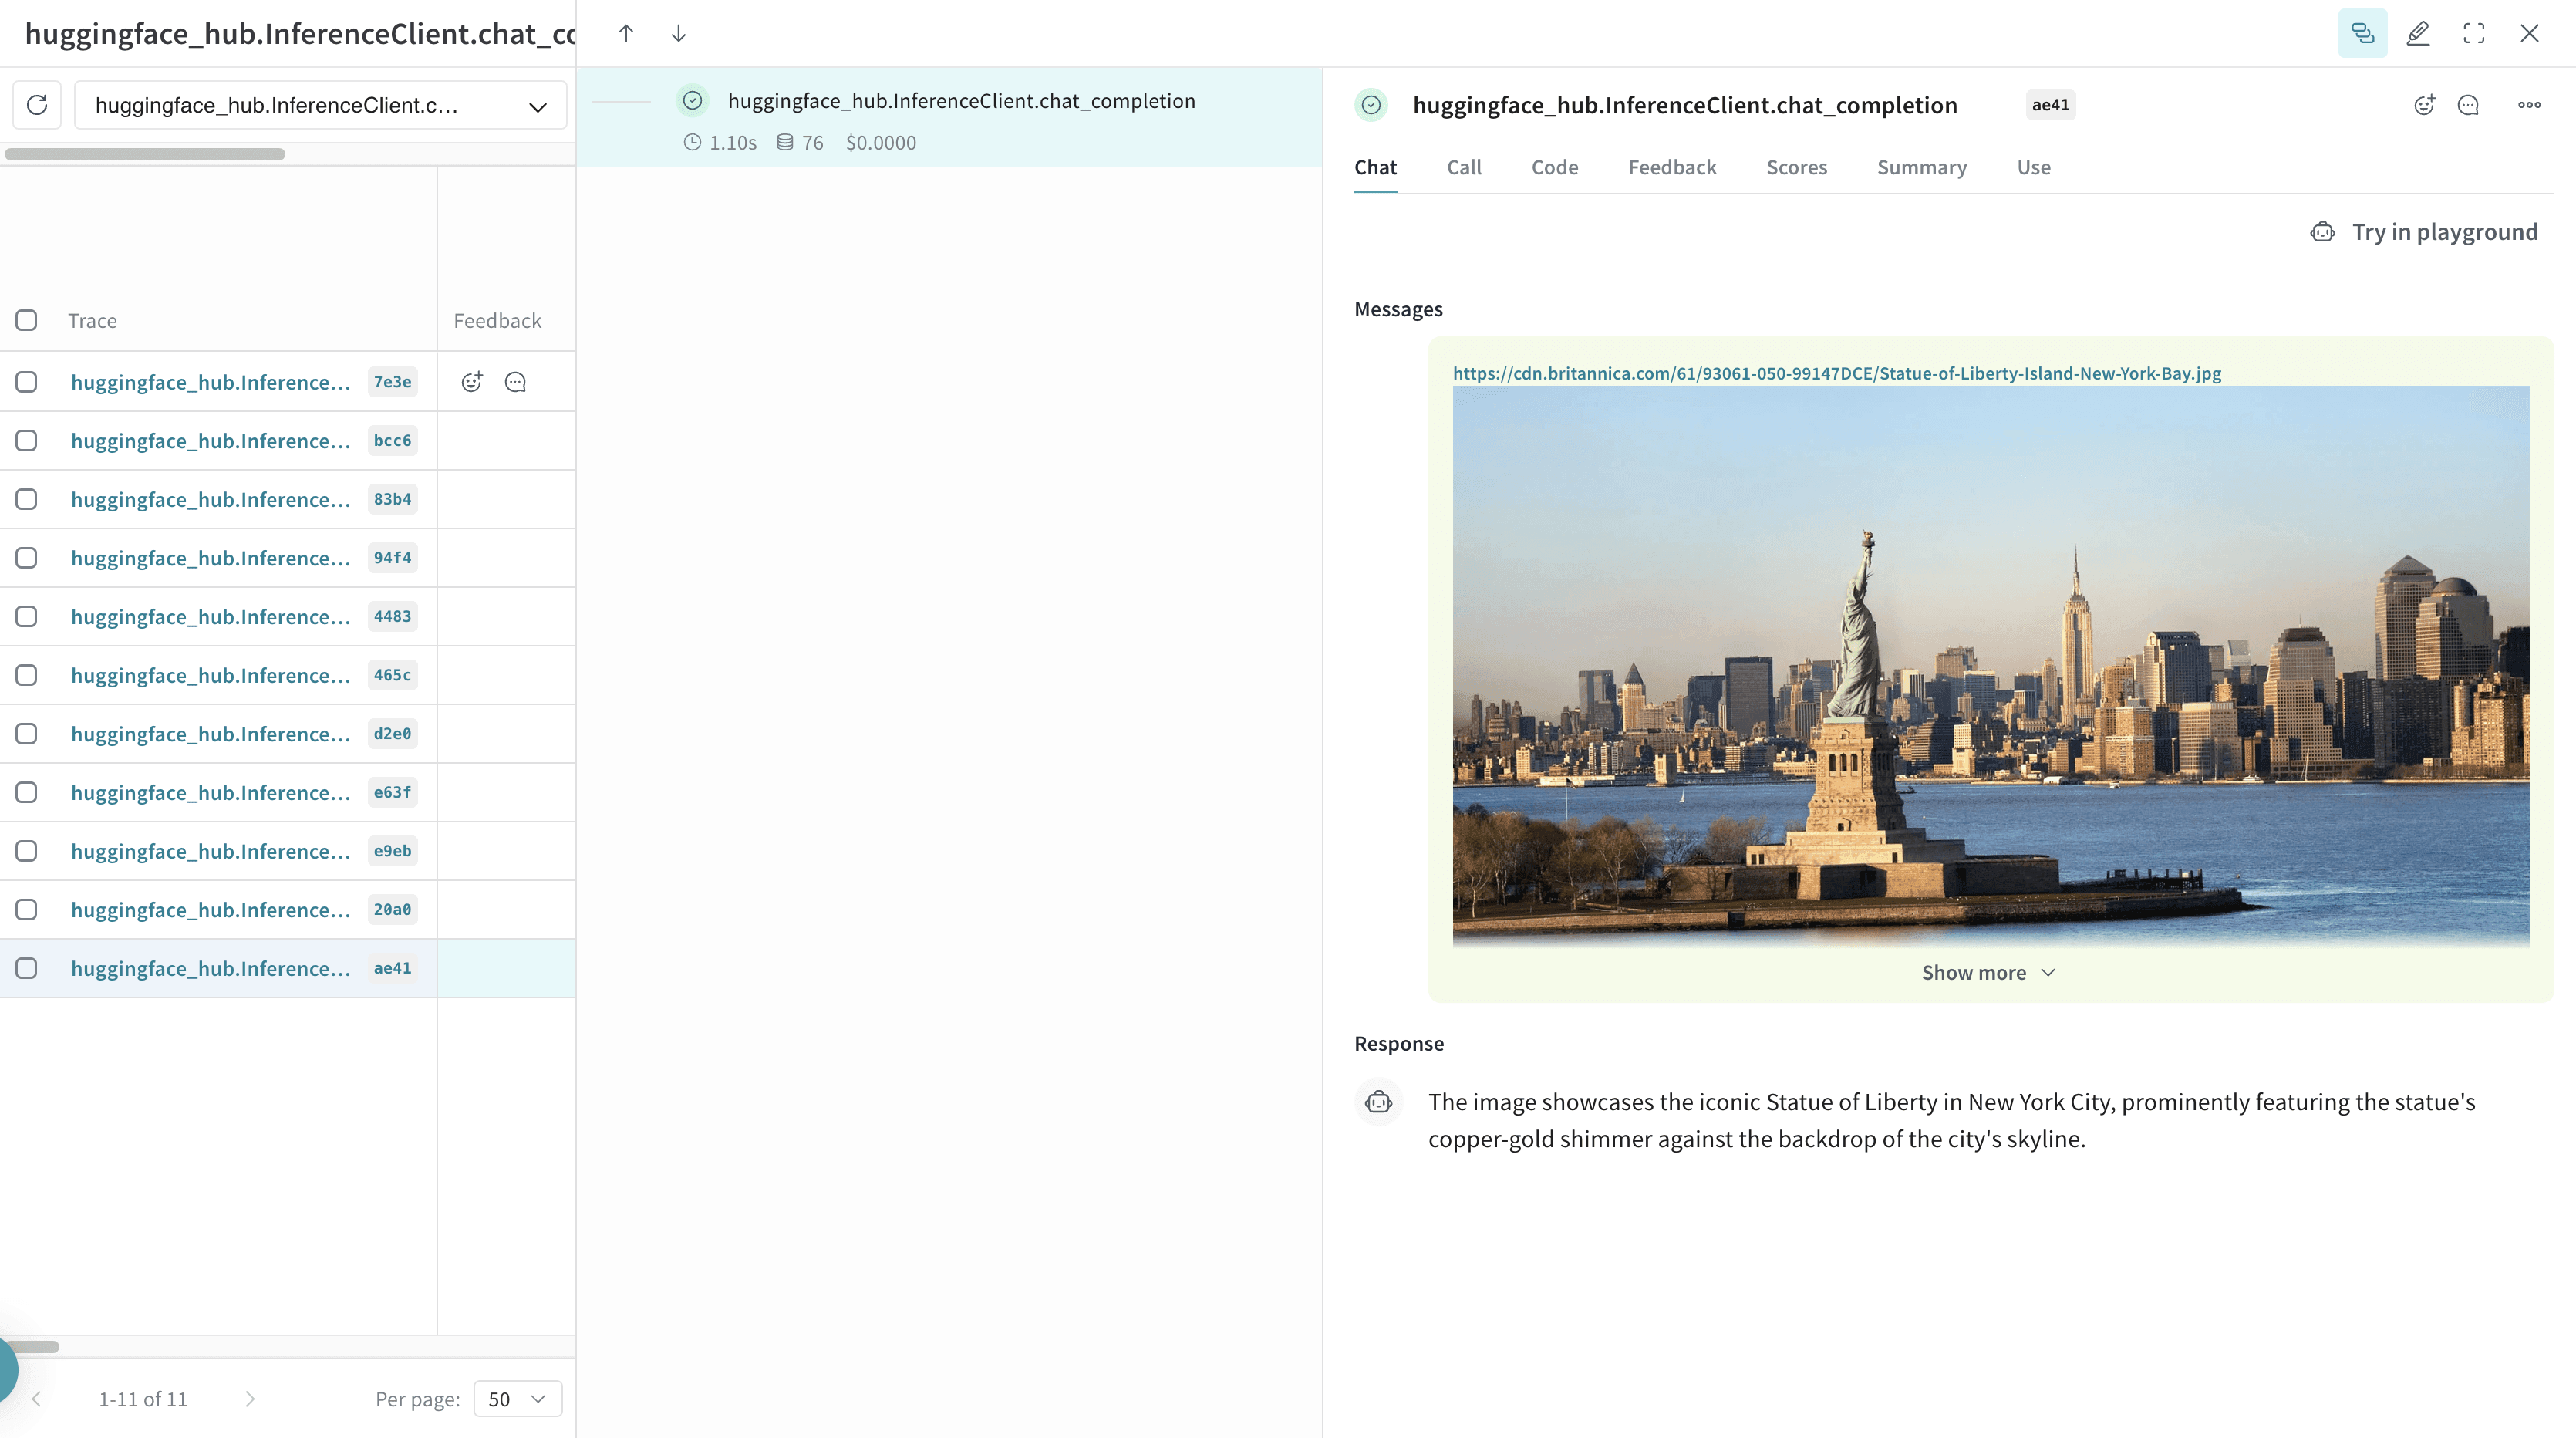 さらに Weave は、UI 上で Call をチャットビューとしてレンダリングし、モデルとのチャット履歴全体を表示します。
関数をトレースする
アプリケーション内でデータがどのように流れるかをより深く把握するには、@weave.op を使用して関数の Call をトラッキングします。これにより入力、出力、実行ロジックが取得され、デバッグやパフォーマンス分析に役立ちます。
複数の Op をネストすると、追跡対象の関数を構造化されたツリーとして構成できます。さらに Weave はコードを自動的にバージョン管理するため、Git に変更をコミットする前でも、実験中の中間状態が保持されます。
トラッキングを開始するには、トラッキングしたい関数を @weave.op でデコレートします。
次の例では、Weave は generate_image、check_image_correctness、generate_image_and_check_correctness の 3 つの関数をトラッキングします。これらの関数は画像を生成し、その画像が指定されたプロンプトと一致しているかを検証します。
@weave.op でラップされたすべての関数の Call をログするようになったため、Weights & Biases UI で実行の詳細を分析できます。
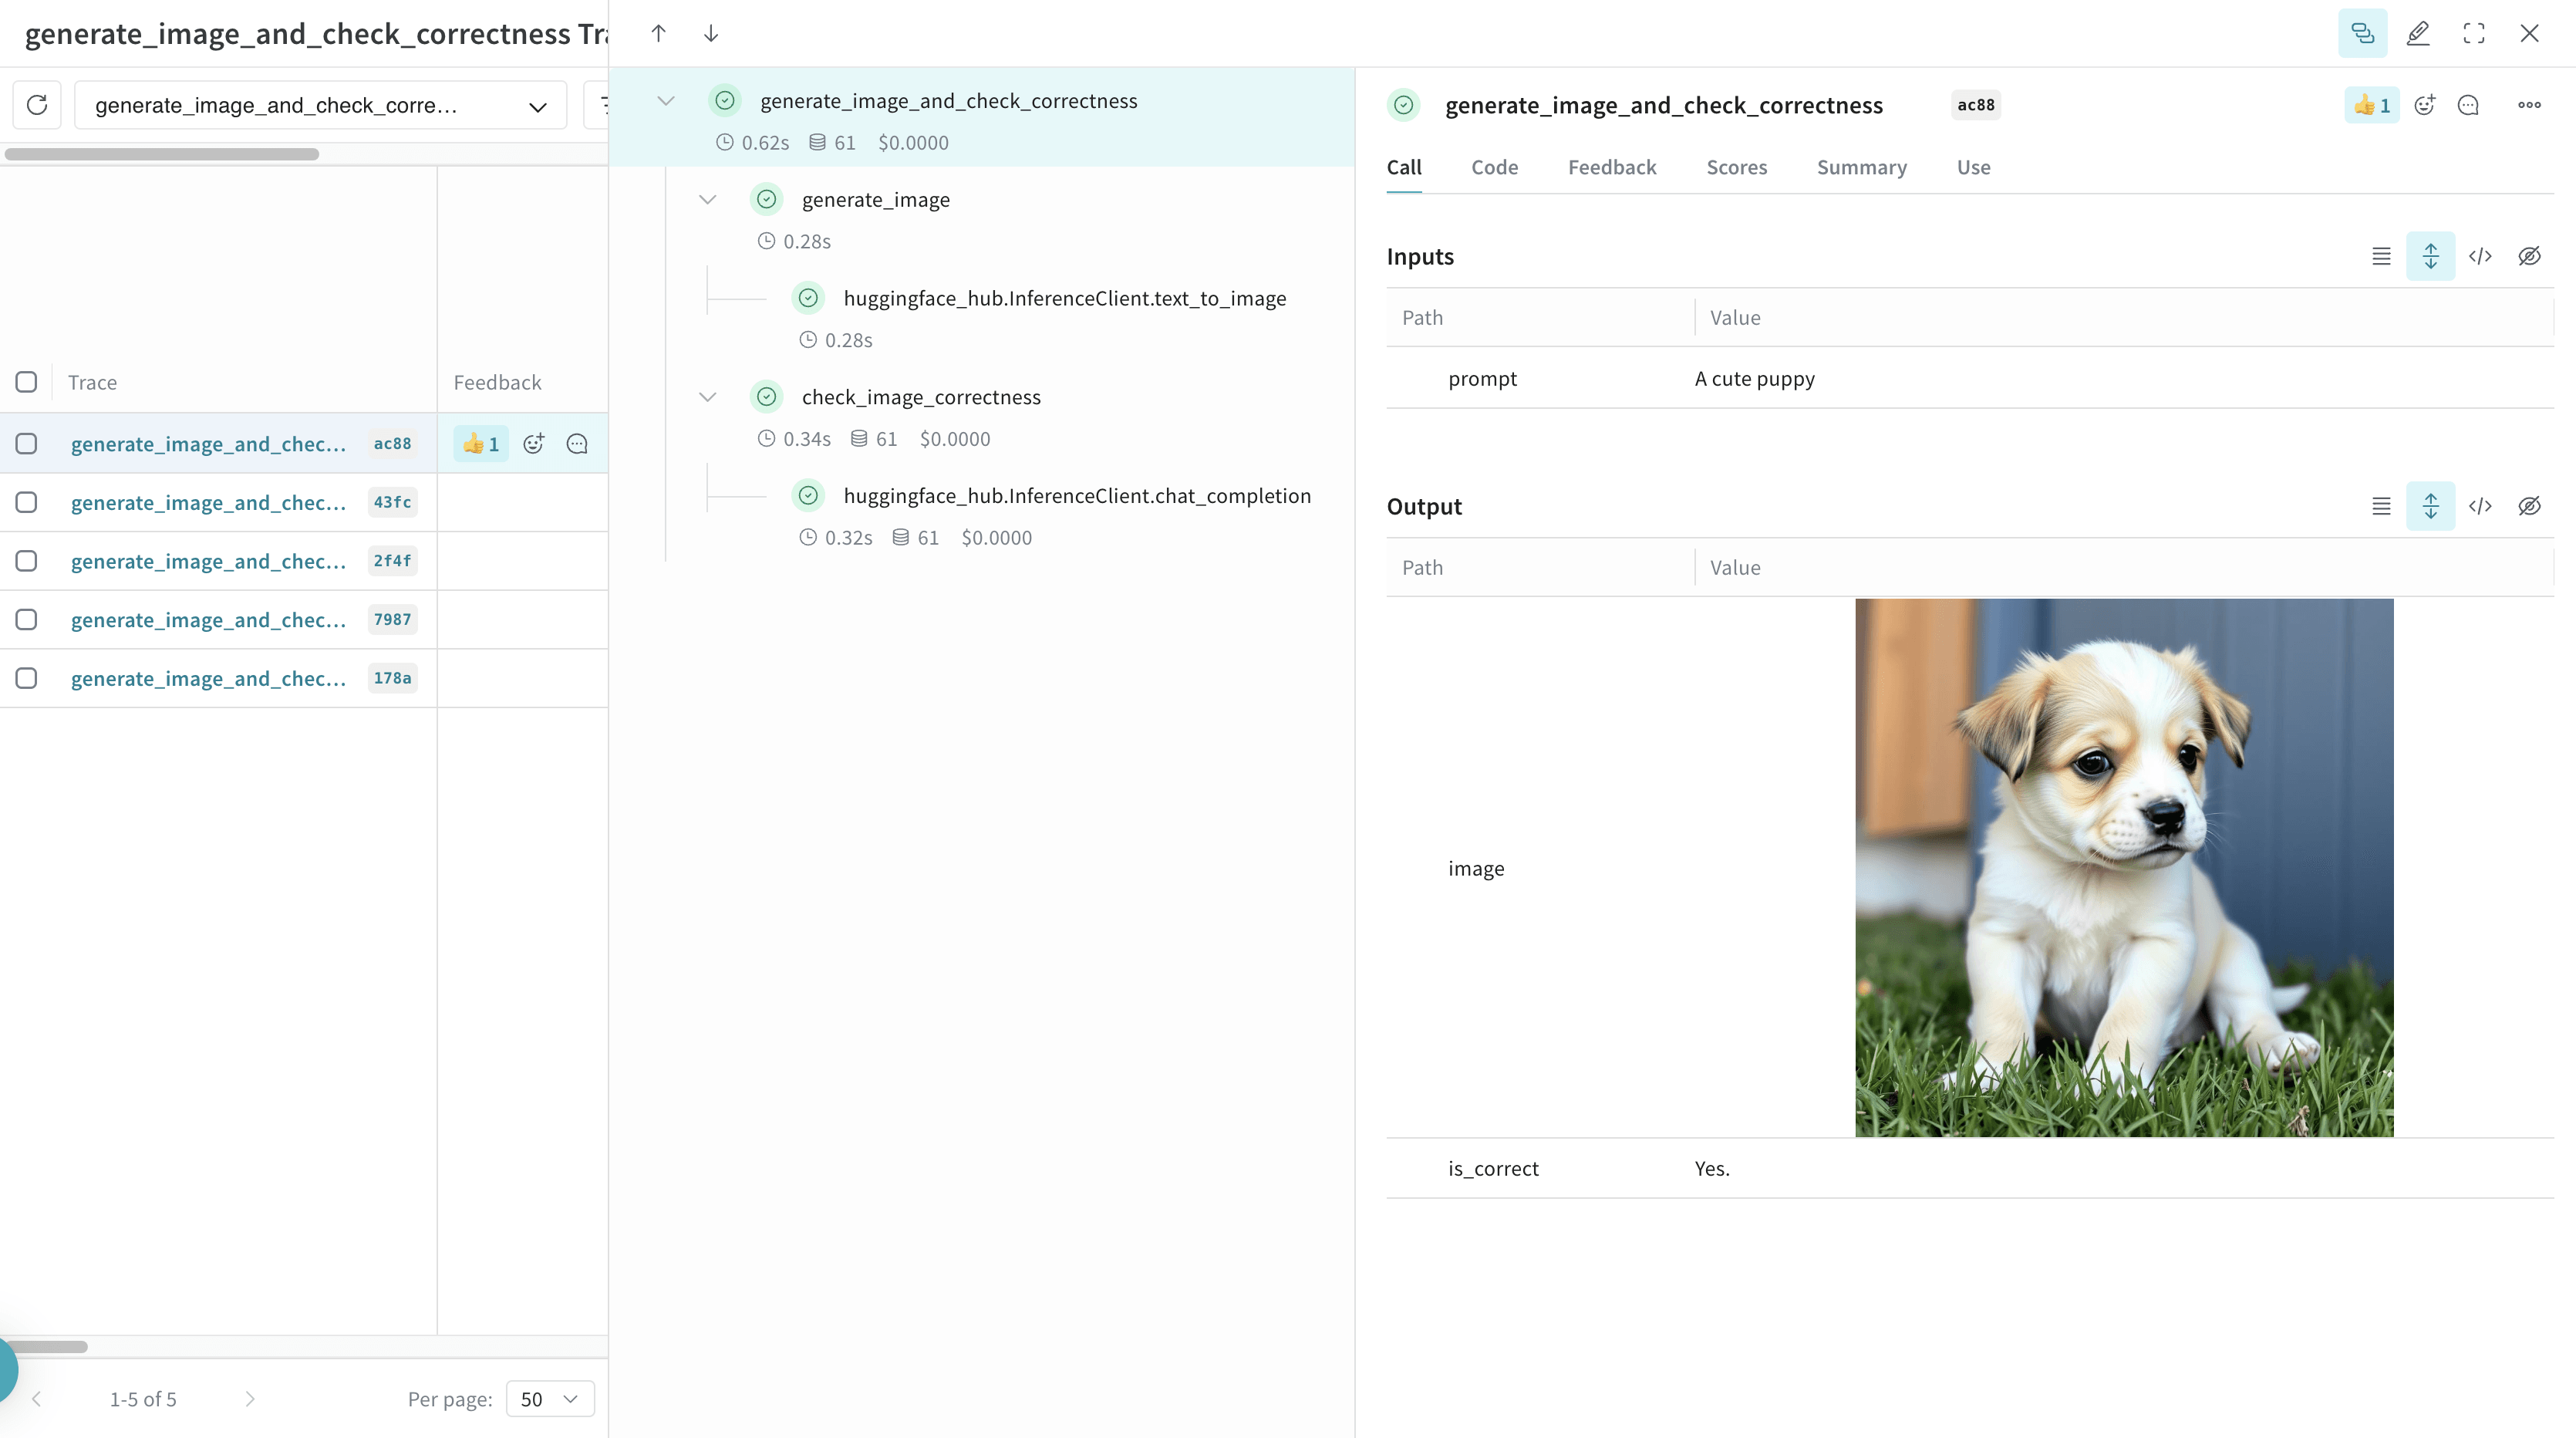 また、Weave は関数の実行を取得して可視化するため、アプリケーション内のデータの流れやロジックを把握しやすくなります。
実験に Model を使用する
複数のコンポーネントが関係する LLM の実験は、管理が難しくなりがちです。Weave の Model クラスを使用すると、システムプロンプトやモデルの設定といった実験の詳細を取得して整理できるため、さまざまな反復処理を比較できます。
Model は、コードのバージョン管理や入力と出力の取得に加えて、アプリケーションの動作を制御する構造化されたパラメーターも保存します。これにより、どの設定で最良の結果が得られたかをトラッキングできます。さらに、Weave Model を Weave の Serve や 評価 と統合すれば、より深い知見を得ることもできます。
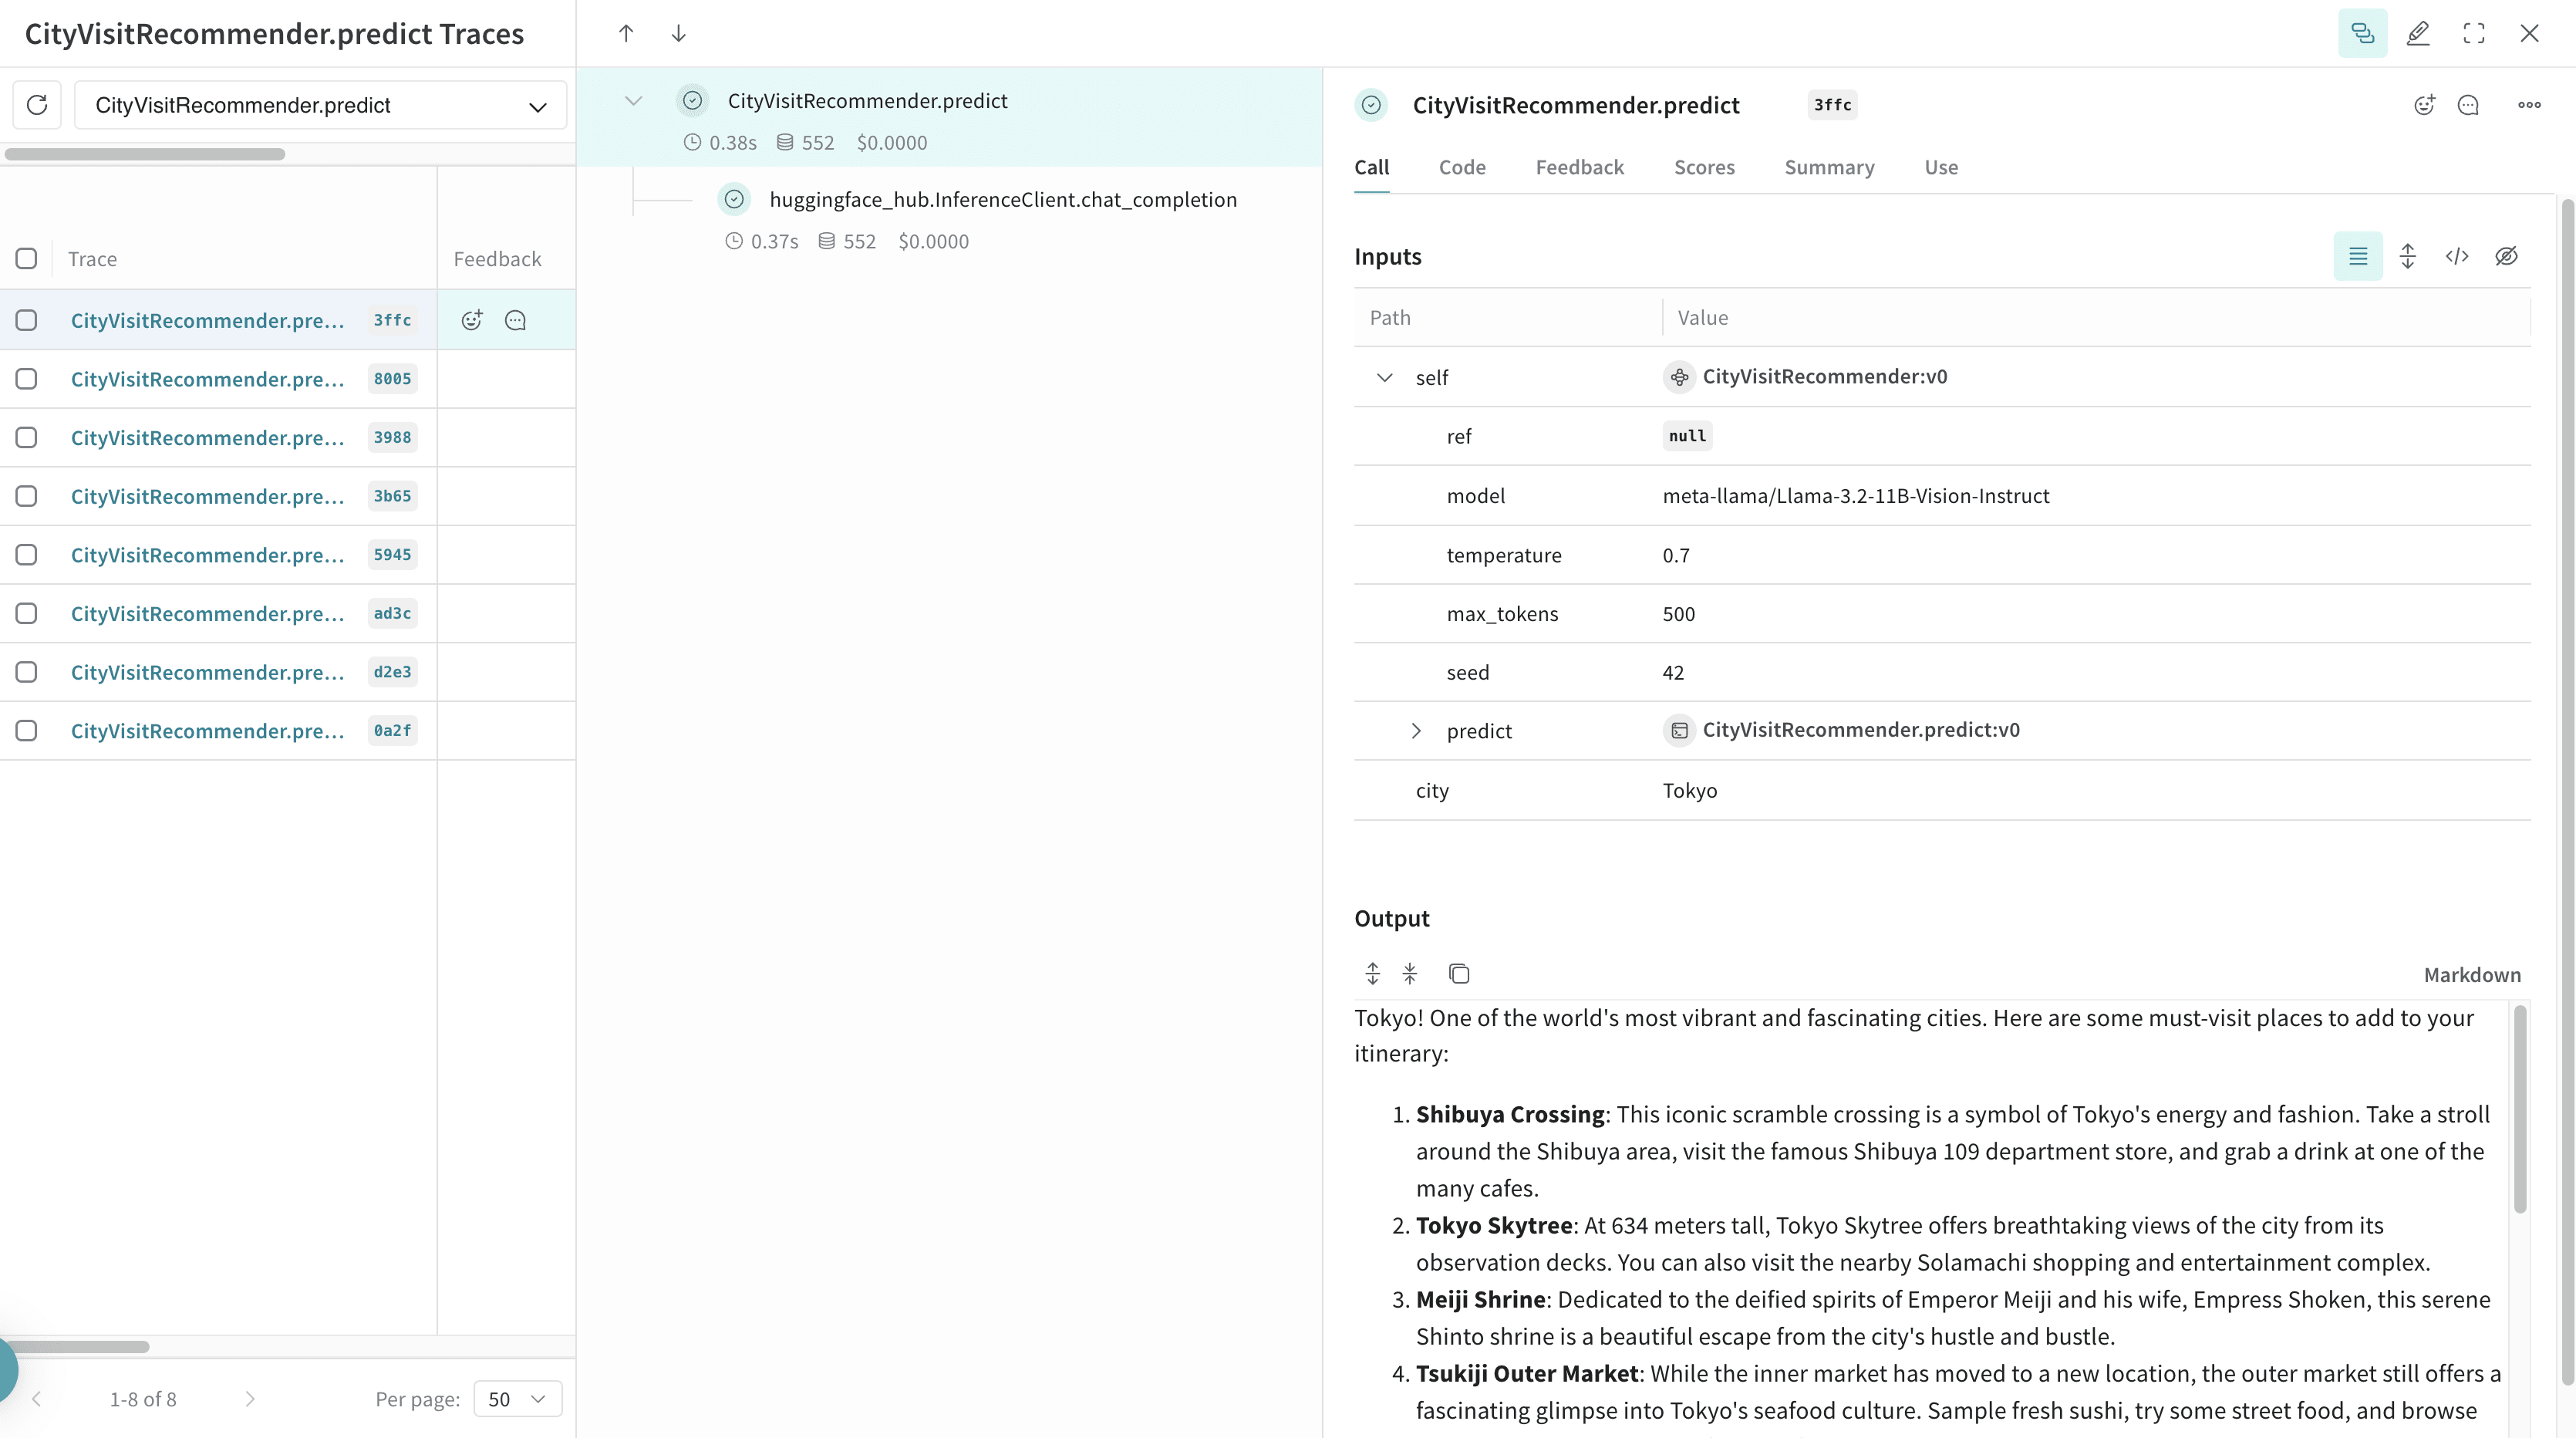
次の例では、旅行先のおすすめを提示する CityVisitRecommender モデルを定義します。パラメーターを変更するたびに新しいバージョンが生成されるため、反復的に実験を進められます。