

EvaluationLogger を使用して、既存の Python または TypeScript のコードから予測とスコアを記録する方法を説明します。この方法を使えば、完全なデータセットと Scorer 一式を事前に定義しなくても、Weave でモデル性能を評価できます。データセットや Scorer が事前に定義されていない場合や、ワークフローの実行中に評価データを段階的にログする必要がある場合に、この方法を使用してください。
標準の Evaluation オブジェクトでは、事前定義された Dataset と Scorer オブジェクトのリストが必要です。一方、EvaluationLogger では、個々の予測とそれに関連するスコアを、得られた時点で段階的にログできます。
より構造化された評価を行いたい場合データセットと Scorer を事前に定義する、より規定の明確な評価フレームワークを使用したい場合は、標準の評価フレームワークを参照してください。
EvaluationLogger は柔軟性に優れ、標準のフレームワークは明確な構造とガイダンスを備えています。基本的なワークフロー
以下の手順を実行すると、予測ごとのスコアと集計サマリーを含む完全な評価が Weave に記録され、Weights & Biases UI で確認できるようになります。- ロガーを初期化する:
EvaluationLoggerのインスタンスを作成します。必要に応じて、modelとdatasetに関するメタデータを指定できます。省略した場合、Weave はデフォルト値を使用します。LLM Call (OpenAI など) のトークン使用量とコストを取得するには、LLM の invocation より前にEvaluationLoggerを初期化してください。 先に LLM を呼び出してから予測をログした場合、Weave はトークンとコストのデータを取得しません。 - 予測をログする: システムの入力と出力のペアごとに
log_prediction()を呼び出します。 - スコアをログする: 返された
ScoreLoggerのlog_score()を使用して、その予測のスコアをログします。1 つの予測に複数のスコアをログできます。 - 予測を完了する: 予測のスコアをログした後は、必ず
finish()を呼び出して予測を確定してください。 - サマリーをログする: すべての予測を処理した後、
log_summary()を呼び出してスコアを集計します。必要に応じてカスタムメトリクスを追加することもできます。
log_example() を使用して、ステップ 2 から 4 を 1 回の呼び出しにまとめることができます。
基本的な例
次の例では、EvaluationLogger を使用して、既存のコード内で予測とスコアをインラインでログする方法を示します。[YOUR-TEAM]/[YOUR-PROJECT] は、ご自身の W&B の entity と project に置き換えてください。
- Python
- TypeScript
user_model 関数を定義し、入力のリストに適用します。各例では、次の処理が行われます。log_predictionを使用して、入力と出力をログします。log_scoreを使用して、正確性スコア (correctness_score) をログします。finish()を呼び出すと、その予測のログが確定します。
log_summary で集計メトリクスを記録し、Weave でのスコアの自動集計をトリガーします。log_example() による簡易ログ
log_example() を使用すると、入力、出力、スコアを 1 回の呼び出しでログできます。この便利なメソッドは log_prediction()、log_score()、finish() を 1 つのステップにまとめたものです。バッチ評価やオフライン評価のように、ログする入力、モデル出力、スコアがすでに揃っている場合に便利です。
log_example() の呼び出しは、次のコードと同等です。
log_example() は Weave TypeScript SDK では使用できません。TypeScript をご利用の場合は、基本的な例で示している logPrediction() と logScore() のパターンを使用してください。高度な使い方
EvaluationLogger は、基本的なワークフローにとどまらず、より複雑な評価シナリオに対応できる柔軟なパターンを提供します。以下のセクションでは、コンテキストマネージャーを使用したリソースの自動管理、エージェントのトレースと評価の行の関連付け、モデルの実行とログ処理の分離、リッチメディアデータの扱い方、複数のモデル評価の並列比較など、高度な手法について説明します。
コンテキストマネージャーを使用する
EvaluationLogger は、予測とスコアの両方でコンテキストマネージャー (with ステートメント) をサポートしています。これにより、コードがより簡潔になり、リソースのクリーンアップが自動化され、LLM ジャッジモデルの Call などのネストされた操作をより正確に追跡できます。
この場面で with ステートメントを使用すると、次のメリットがあります。
- コンテキストを抜けると
finish()が自動的に呼び出されます。 - ネストされた LLM Call のトークンとコストをより正確にトラッキングできます。
- 予測コンテキスト内で、モデルの実行後に出力を設定できます。
- Python
- TypeScript
エージェントのトレースを評価にリンクする
Python では、トレース対象の各エージェント呼び出しを、それぞれのlog_prediction() コンテキスト内で実行してください。EvaluationLogger は、そのコンテキスト内で作成されたスパンに評価 run、サンプル、試行のメタデータを設定します。Weave はこのメタデータを使用して、トレースを評価結果にリンクします。
評価とエージェント スパンの自動リンクは Python でのみ利用できます。TypeScript の
EvaluationLogger と Evaluation.evaluate() はいずれも、エージェント スパンをリンクするための実行中の評価スコープを作成しません。TypeScript でスパンをリンクするには、このセクションで説明する OTel 属性を直接設定する必要があります。また、これは両方の Call ID がすでに取得できている場合にのみ可能です。[YOUR-TEAM]/[YOUR-PROJECT] は、ご自身の W&B entity と project に置き換えてください。
- Python
- TypeScript
log_prediction() コンテキスト内で実行され、Weave インテグレーションによってトレースされる場合は、Weave がトレースを評価結果に自動的にリンクします。それ以外の場合は、リンク用の 2 つの ID をエージェント スパンに自分で設定する必要があります。設定方法は、スパンが作成される場所によって異なります。
- 同一プロセスで独自のインストルメンテーションを使用する場合: 各スパンに属性を直接設定します。
- 別のサービスでスパンが作成される場合: 両方の ID をそのサービスに送信し、そのサービスが作成するスパンに設定します。
自分でインストルメントしたスパンをリンクする
log_prediction() コンテキスト内で作成されたスパンには、EvaluationLogger がすべての属性を自動的に設定します。ただし、独自の OpenTelemetry (OTel) インストルメンテーションでスパンを送信する場合は、リンクする各スパンに属性を直接設定する必要があります。評価用に設定できる属性は次のとおりです。
スパンは、
/agents/otel/v1/traces エンドポイント経由で評価と同じ Weave プロジェクトに送信してください。OTel のスパン属性は親スパンから子スパンに伝播しないため、リンクするすべてのスパンに属性を設定する必要があります。
エンドポイントの詳細については、以下を参照してください。
- 既存の OTel パイプラインからスパンを送信する方法については、Agents ビューに OpenTelemetry スパンを送信するを参照してください。
- エンドポイントの仕様については、GenAI トレースをエクスポートするを参照してください。
weave.eval.run_id と weave.eval.predict_and_score_call_id だけです。行ダイジェスト、サンプル ID、試行インデックス、種類、評価名はコンテキストを付加し、フィルタリングに役立ちますが、これらだけではリンクは作成されません。リンク用の 2 つの属性には、OTel のトレース ID やスパン ID ではなく、Weave の Call ID を使用してください。
どちらの ID も 評価結果クエリ API から取得できます。応答内の各評価には evaluation_call_id が、各試行には predict_and_score_call_id が含まれています。
以下のサンプルでは、span がエージェント操作の OTel スパンであることを前提としています。角括弧で囲まれた各値は、そのスパンが属する 評価 run と結果のメタデータに置き換えてください。
TypeScript のサンプルは、予測スコープに依存せず OTel 属性を直接設定するため、正しく動作します。ただし、両方の Call ID がすでに取得できている場合にのみ使用してください。
- Python
- TypeScript
別のサービスで実行されるエージェントをリンクする
エージェントが別のサービスとして実行される場合、評価プロセスとエージェントはメモリを共有しません。そのため、Weave はリンク用の属性を自動的に設定できず、エージェントのスパンオブジェクトに直接アクセスすることもできません。代わりに、評価プロセスで両方の Call ID を取得してサービスに送信し、サービス側で作成されるスパンに設定します。この分散型のEvaluationLogger パターンは Python でのみ利用できます。
- Python
- TypeScript
log_prediction() コンテキストに入ると、コンテキストの本体が実行される前に Evaluation.predict_and_score Call が作成されます。このコンテキストは、両方の Call ID を公開する ScoreLogger (以下の例では prediction にバインド) を返します。サービスの出力とスコアを同じ評価結果にログできるよう、サービスから応答が返るまでコンテキストを開いたままにしてください。評価プロセスで、[AGENT-SERVICE-URL] をエージェントを実行するエンドポイントに、[YOUR-TEAM]/[YOUR-PROJECT] もそれぞれ適切な値に置き換えます。[YOUR-TEAM]/[YOUR-PROJECT] にスパンをエクスポートするよう、サービスを設定してください。eval_context をコピーしてください。OTel では、スパン属性はラッパーから継承されません。評価にリンクされたエージェント スパンを表示する
Weights & Biases UI でリンクされたスパンを確認するには、次の手順を実行します。- Forge にアクセスします。
- Weave のサイドバーメニューで Evals をクリックします。
- 対象の評価 run を選択します。
- 評価の詳細パネルが開いたら、Evaluation タブで スパンを表示 をクリックします。Agents ページが開き、その評価で絞り込まれた状態の Spans タブが表示されます。
既存のデータセットにリンクする
log_prediction に生のデータセットを inputs として渡すと、Weave は 評価 run のたびにデータを再インポートします。その結果、重複したデータが保存されるため、データセットが大きい場合や多くの評価で同じデータセットを再利用する場合には、ストレージ容量を無駄に消費する可能性があります。
この重複を避けるには、評価を実行する前にデータセットを Weave にパブリッシュし、パブリッシュしたデータセットの行を inputs として渡します。Weave は、パブリッシュ済みの行への参照を、データを再インポートすることなく内部参照によって解決します。この手法を使うと、標準の評価フレームワークと同じようにリンクされた状態を実現でき、Weights & Biases UI 上で各予測が特定のデータセット行に紐づけられます。
次の例では、データセットをパブリッシュして EvaluationLogger でリンクし、通常のデータセットと同じように取得して反復処理します。
- Python
- TypeScript
ログする前に出力を取得する
先にモデル出力を計算しておき、その後で予測とスコアを個別にログすることもできます。この方法では評価ロジックとログのロジックが分離されるため、予測の生成とスコアリングをシステム内の別々の部分が担当する場合に、コードのテストや保守がしやすくなります。- Python
- TypeScript
リッチメディアをログする
入力、出力、スコアには、画像、動画、オーディオ、構造化された表などのリッチメディアを含めることができます。リッチメディアをログすると、Weights & Biases UI でスコアと並べて実際のコンテンツを確認できるため、マルチモーダルモデルの定性分析に役立ちます。log_prediction メソッドまたは log_score メソッドに、dict またはメディアオブジェクトを渡してください。
- Python
- TypeScript
複数の評価をログして比較する
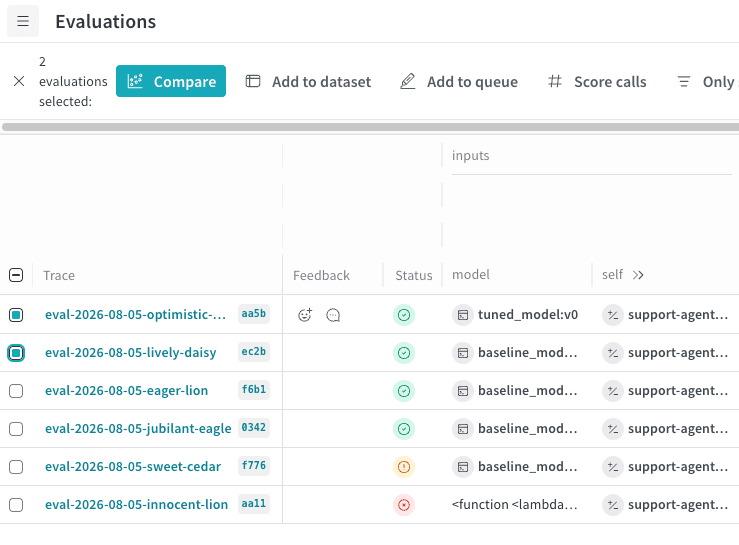
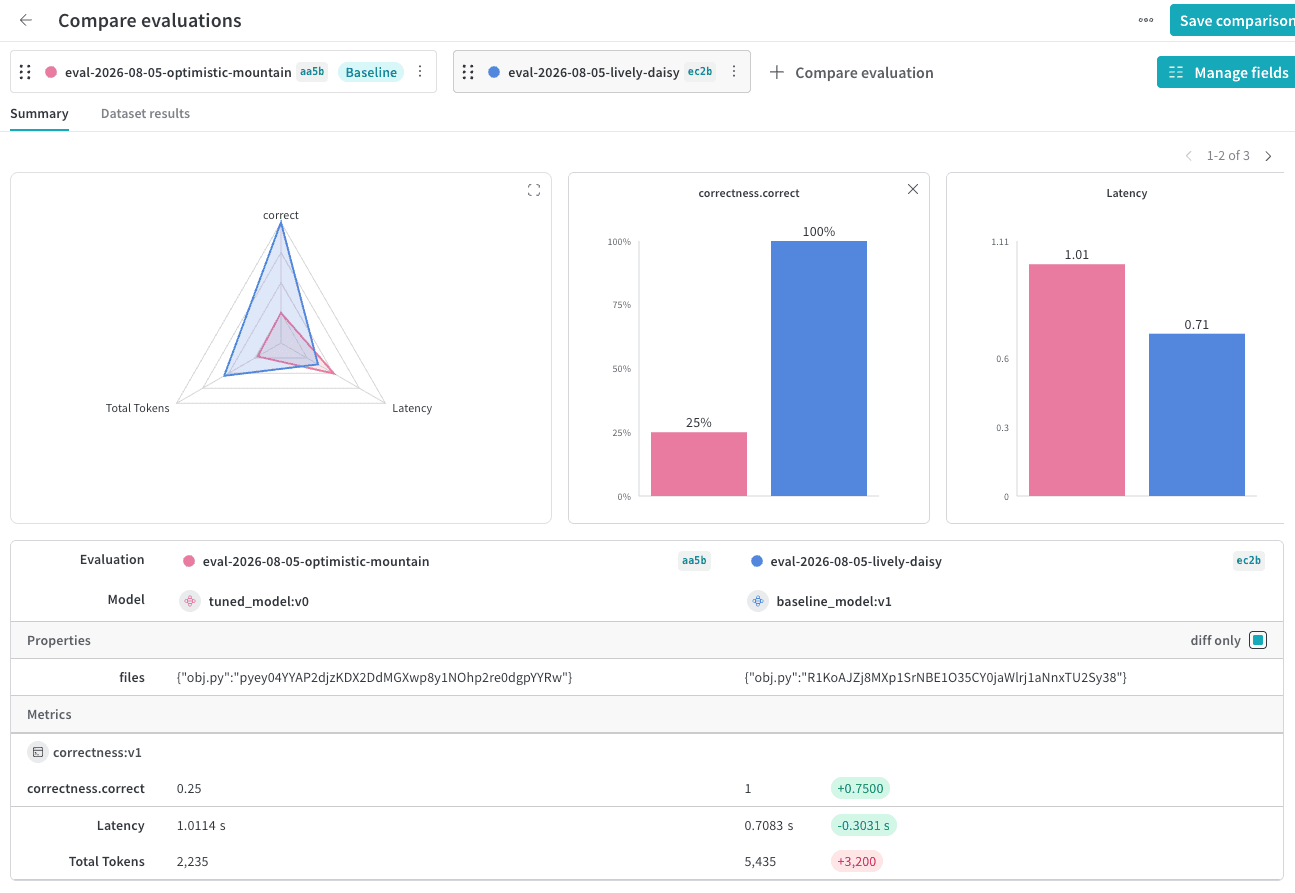
EvaluationLogger を使用すると、複数の評価をログし、Weights & Biases UI で並べて比較できます。同じデータセットに対する複数のモデルの性能を比較評価したい場合に便利です。
- 次のコードサンプルを実行します。
- Weights & Biases UI で Evals タブを開きます。
- 比較する評価を選択します。
- Compare をクリックします。Compare ビューでは、次の操作を行えます。
- 評価を追加または削除する。
- メトリクスの表示と非表示を切り替える。
- 特定のサンプルをページ送りで確認し、データセット内の同じ入力に対して各モデルがどのような結果を出したかを確認する。
- Python
- TypeScript
使用上のヒント
以下のヒントを参考にすると、EvaluationLogger を最大限に活用できます。
- Python
- TypeScript
- 各予測が完了したら、すぐに
finish()を呼び出してください。 - 個々の予測に紐づかないメトリクス (例: 全体のレイテンシー) を取得するには、
log_summaryを使用します。 - リッチメディアのログ記録は、定性的な分析に役立ちます。