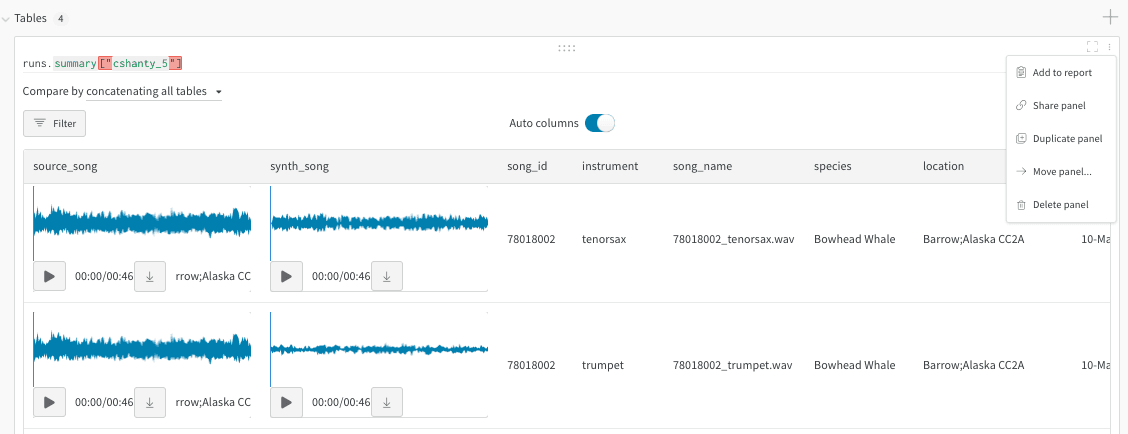
- アーティファクトのバージョンとしてログされた 2 つの W&B 表を比較して、データやモデル性能の変化を分析します。
- データの大局的なパターンを把握します
- 表にログする値が run を通じてどのように変化するかを確認します。
W&B 表には次の動作があります。
- アーティファクトのコンテキストではステートレス: アーティファクトのバージョンとともにログされた表は、ブラウザーのウィンドウを閉じるとデフォルトの状態にリセットされます
- Workspace または report のコンテキストではステートフル: 単一の run の Workspace、複数の run を含むプロジェクトの Workspace、または report 内の表に加えた変更は保持されます。
表の比較オプション
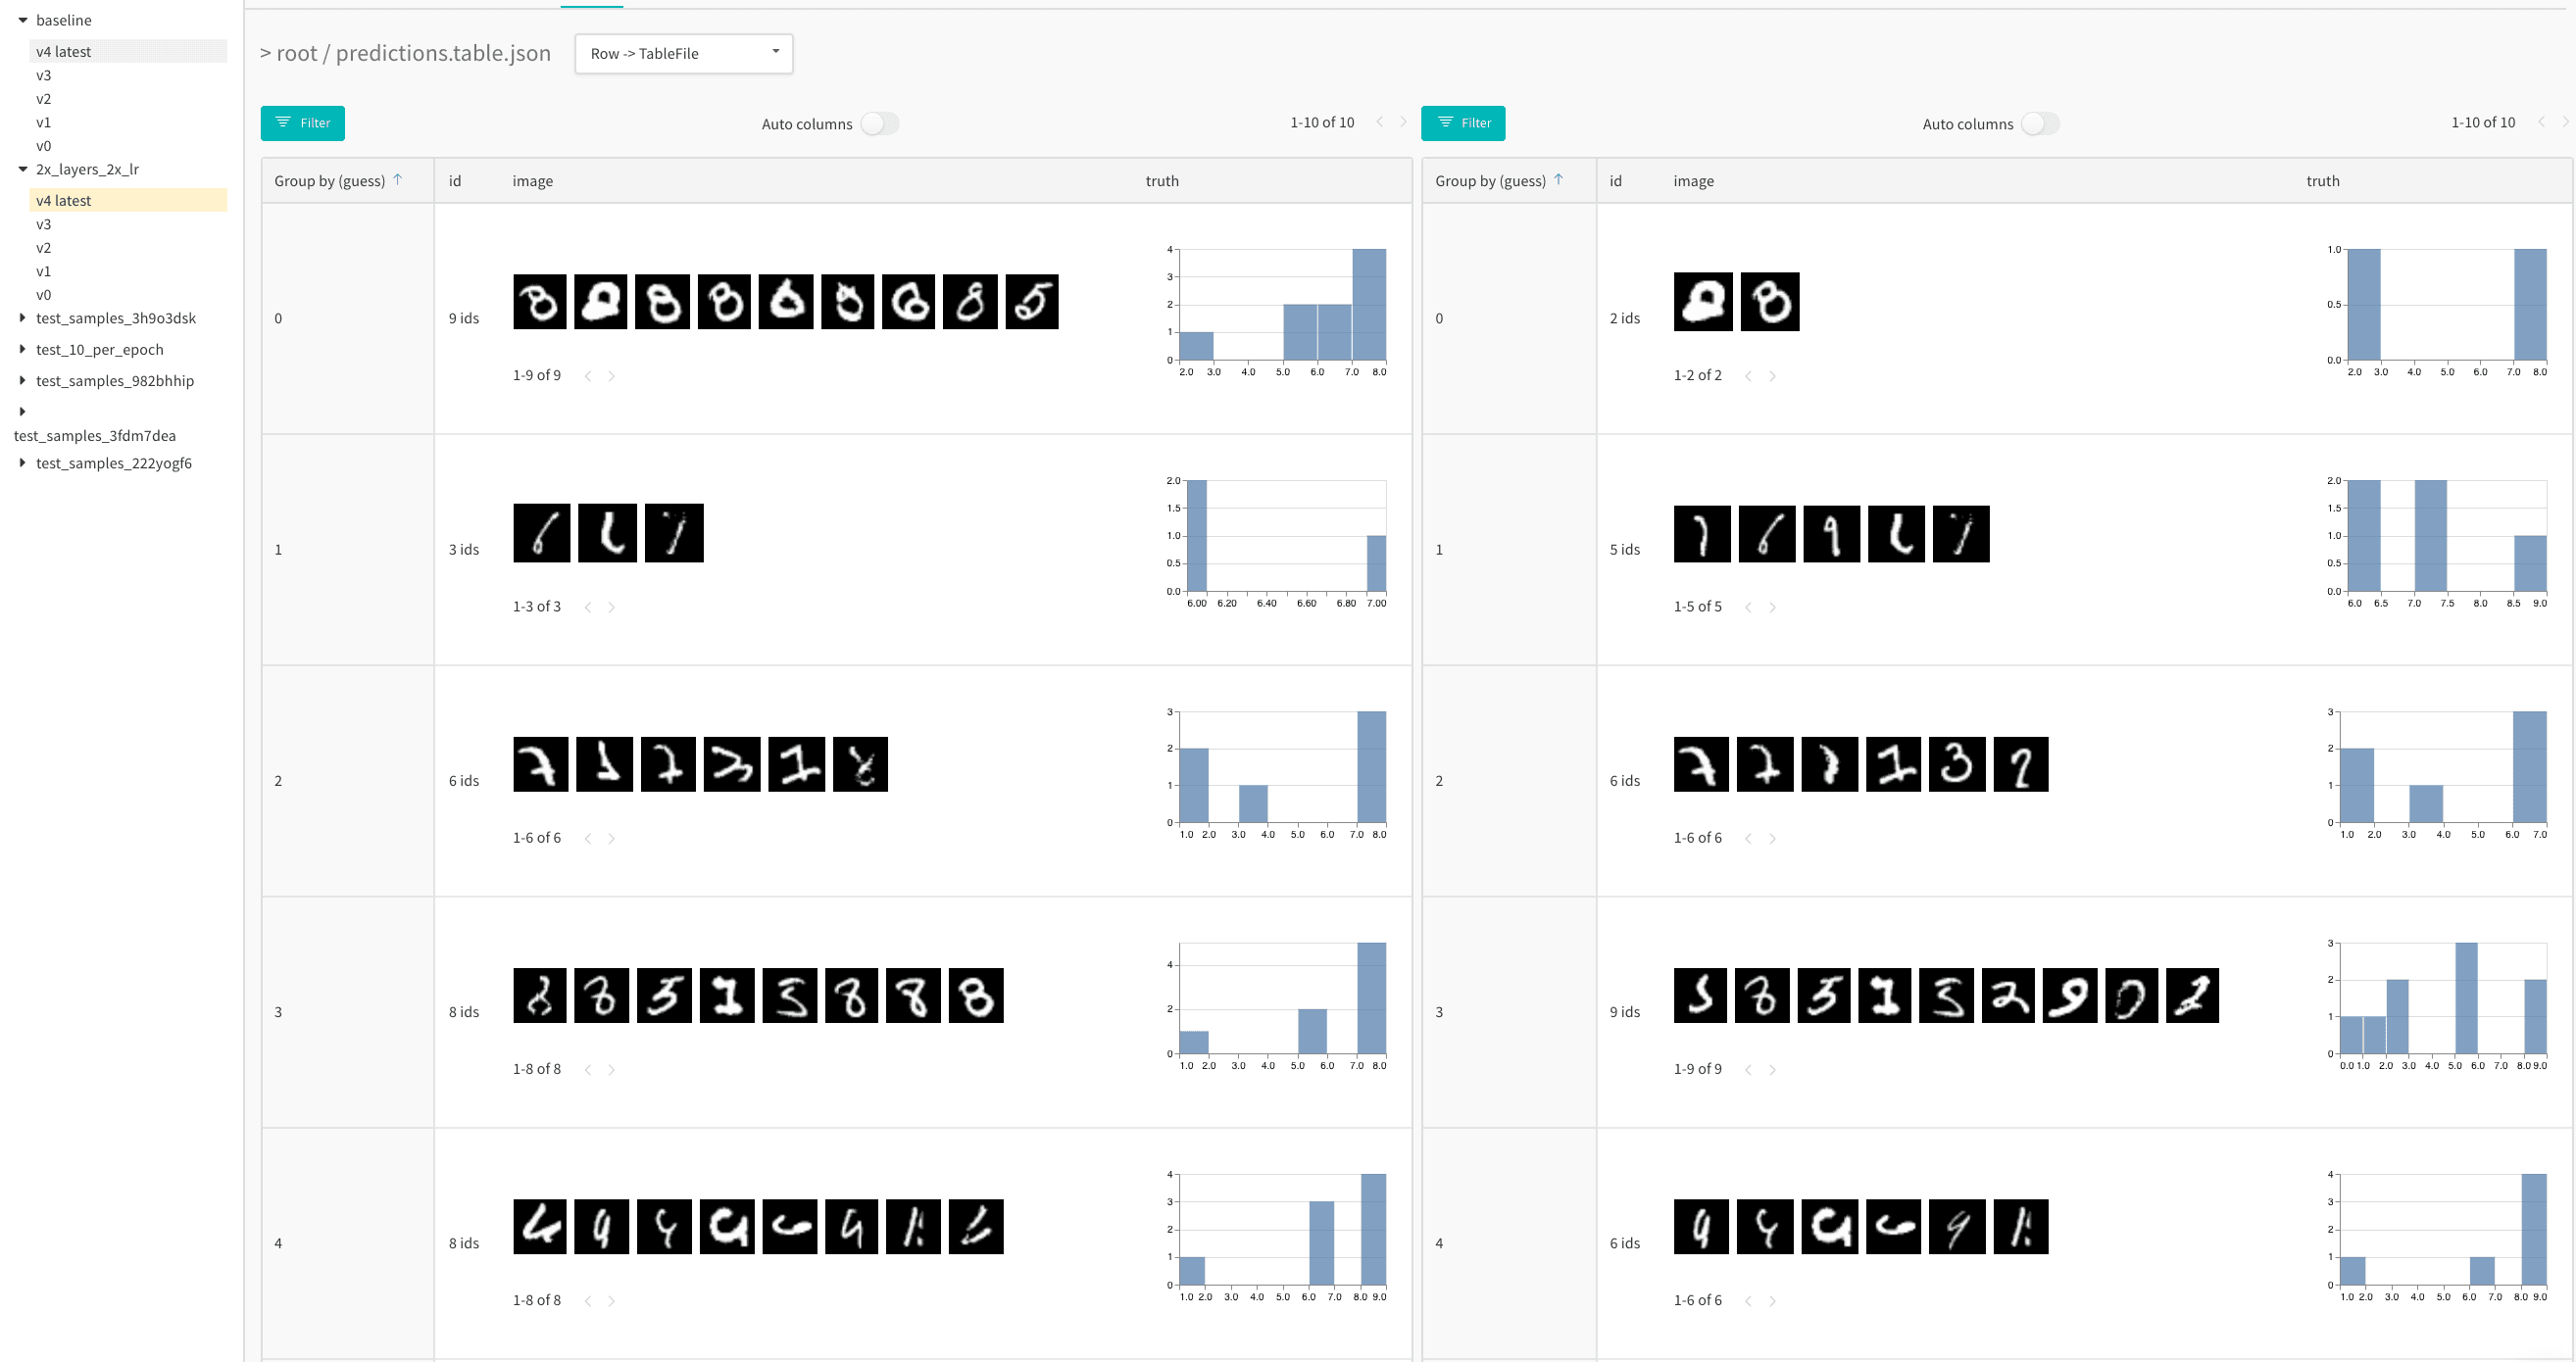
マージ ビューまたは並列ビューで 2 つの表を比較します。たとえば、以下の画像は MNIST データの表の比較を示しています。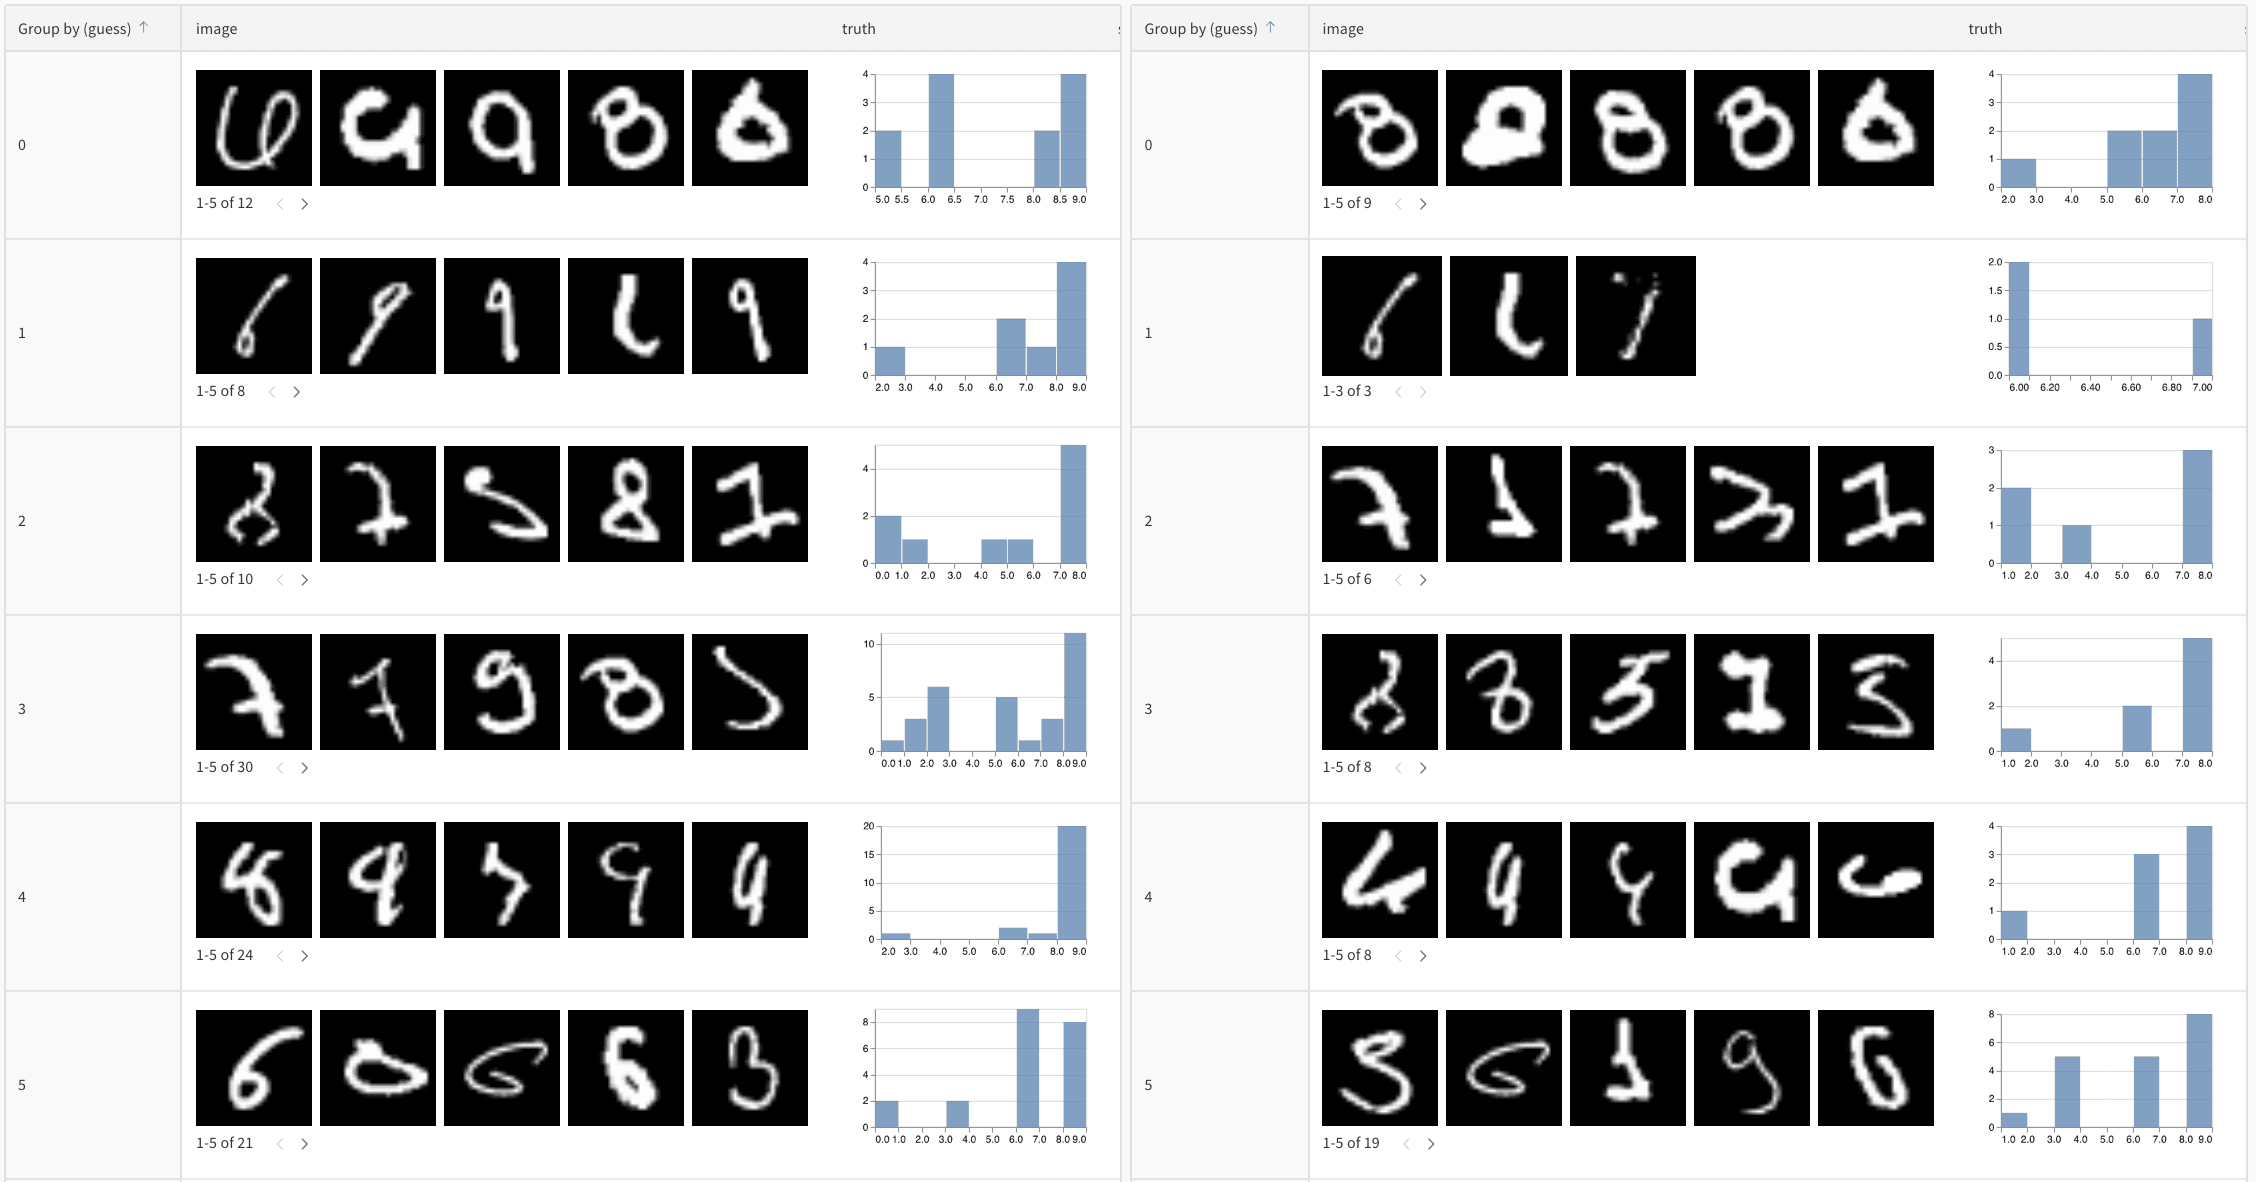
- W&B アプリで project に移動します。
- プロジェクトのサイドバーでアーティファクトのアイコンを選択します。
- アーティファクトのバージョンを選択します。
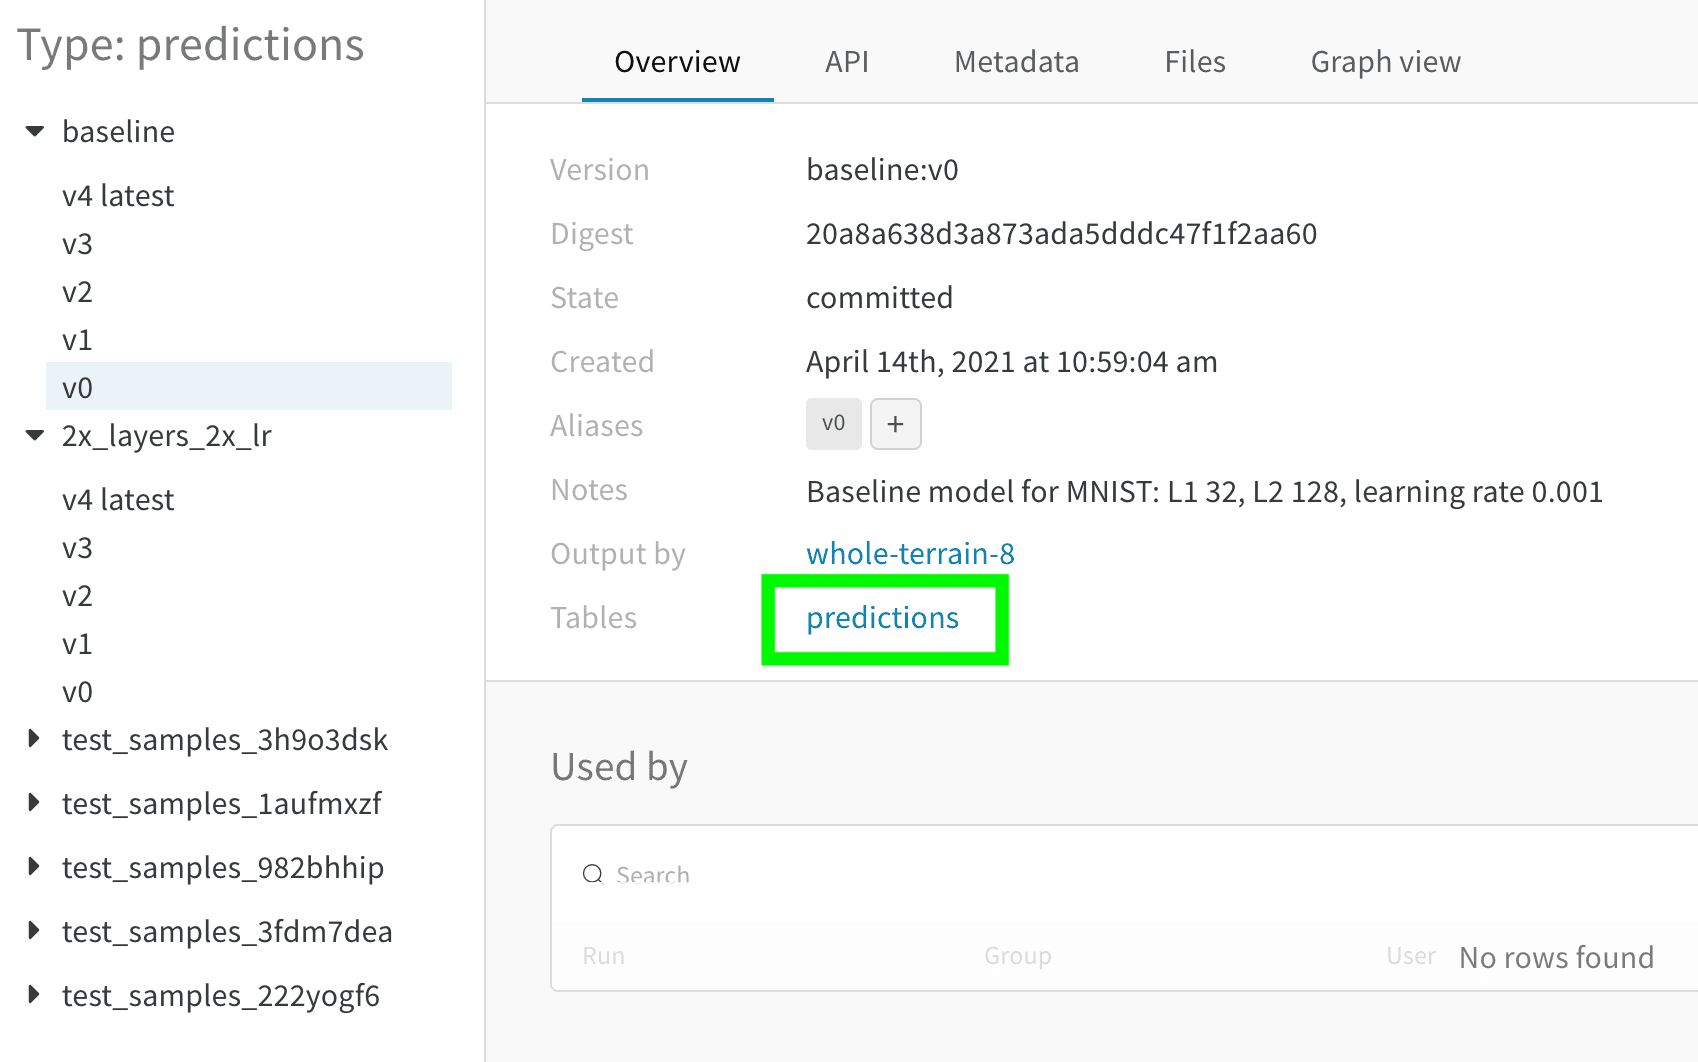
- サイドバーで比較したい 2 つ目のアーティファクトのバージョンにカーソルを合わせ、表示された Compare をクリックします。たとえば、以下の画像では「v4」というラベルのバージョンを選択し、同じモデルが 5 エポックのトレーニング後に行った MNIST の予測と比較しています。
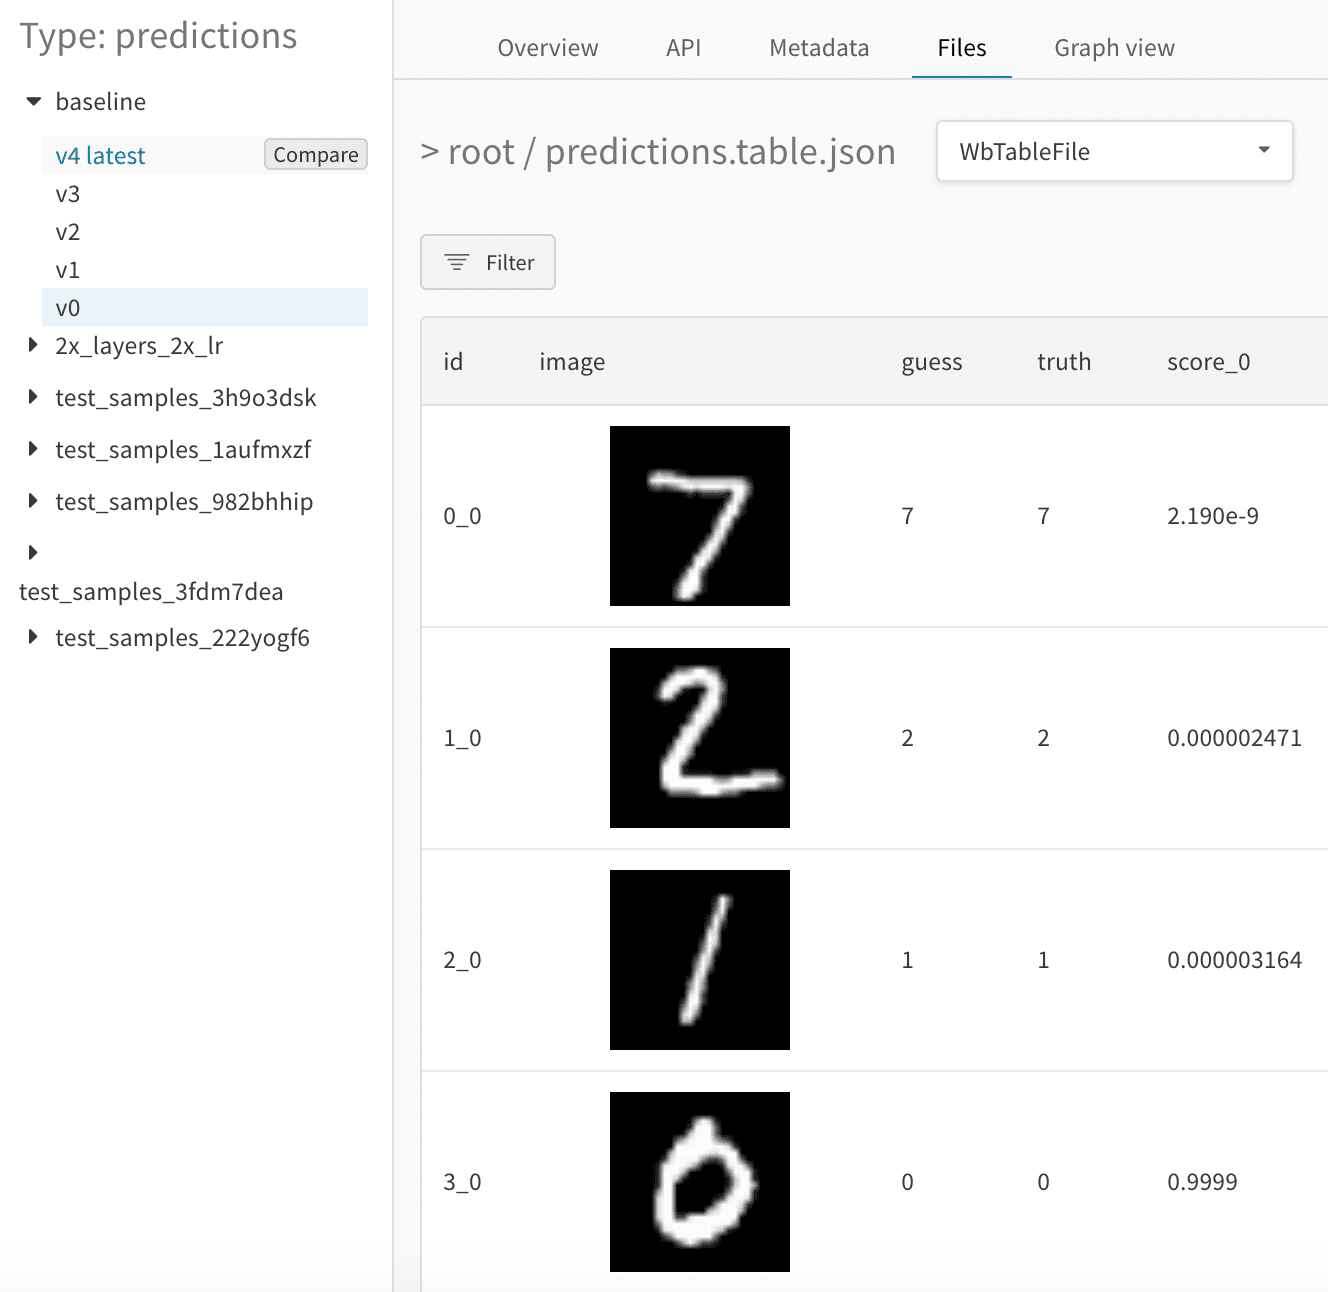
マージ ビュー
最初に、両方の表がマージされて表示されます。最初に選択された表のインデックスは 0 で青くハイライトされ、2 番目の表のインデックスは 1 で黄色くハイライトされます。マージされた表のライブ例はこちらからご覧ください.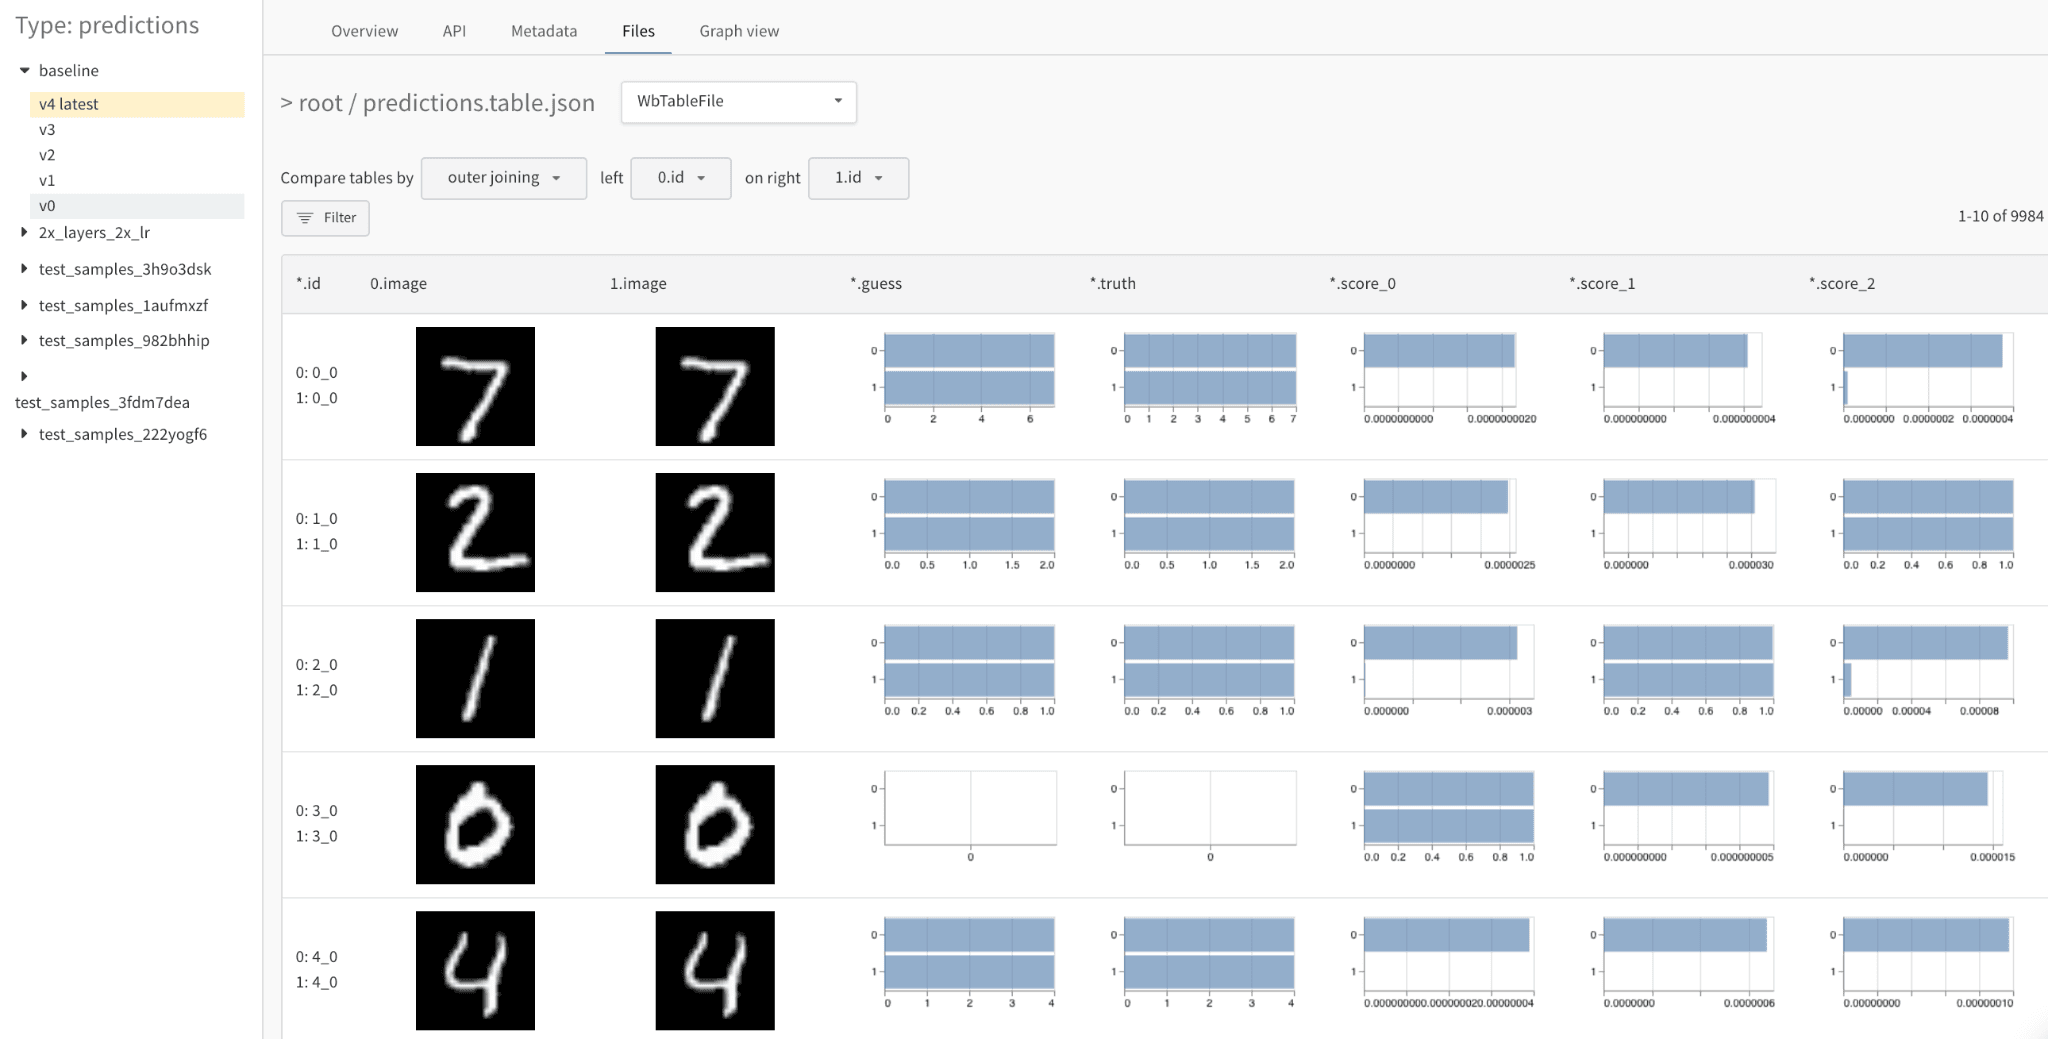
- 結合キーを選択する: 左上のドロップダウンを使用して、2 つの表の結合キーとして使用する列を設定します。通常、これは各行の一意の ID であり、データセット内の特定のサンプルのファイル名や、生成されたサンプル上のインクリメント インデックスなどが該当します。現在は 任意の 列を選択可能ですが、表が見にくくなったりクエリが遅くなったりする可能性があります。
- 結合ではなく連結する: このドロップダウンで「すべての表を連結」を選択すると、列を結合するのではなく、両方の表からすべての行を union して 1 つの大きな 表 にします。
- 各 表 を明示的に参照する: フィルター式で 0、1、* を使用して、1 つまたは両方の表インスタンス内の列を明示的に指定します。
- 数値の詳細な差分をヒストグラムとして視覚化する: 任意のセルの値を一目で比較します。
並列ビュー
2 つの表を横に並べて表示するには、最初のドロップダウンを “Merge Tables: Table” から “List of: Table” に変更し、“Page size” をそれぞれ更新します。最初に選択した表が左側に、2 番目の表が右側に表示されます。また、“Vertical” チェックボックスをクリックすると、表を縦に並べて比較することもできます。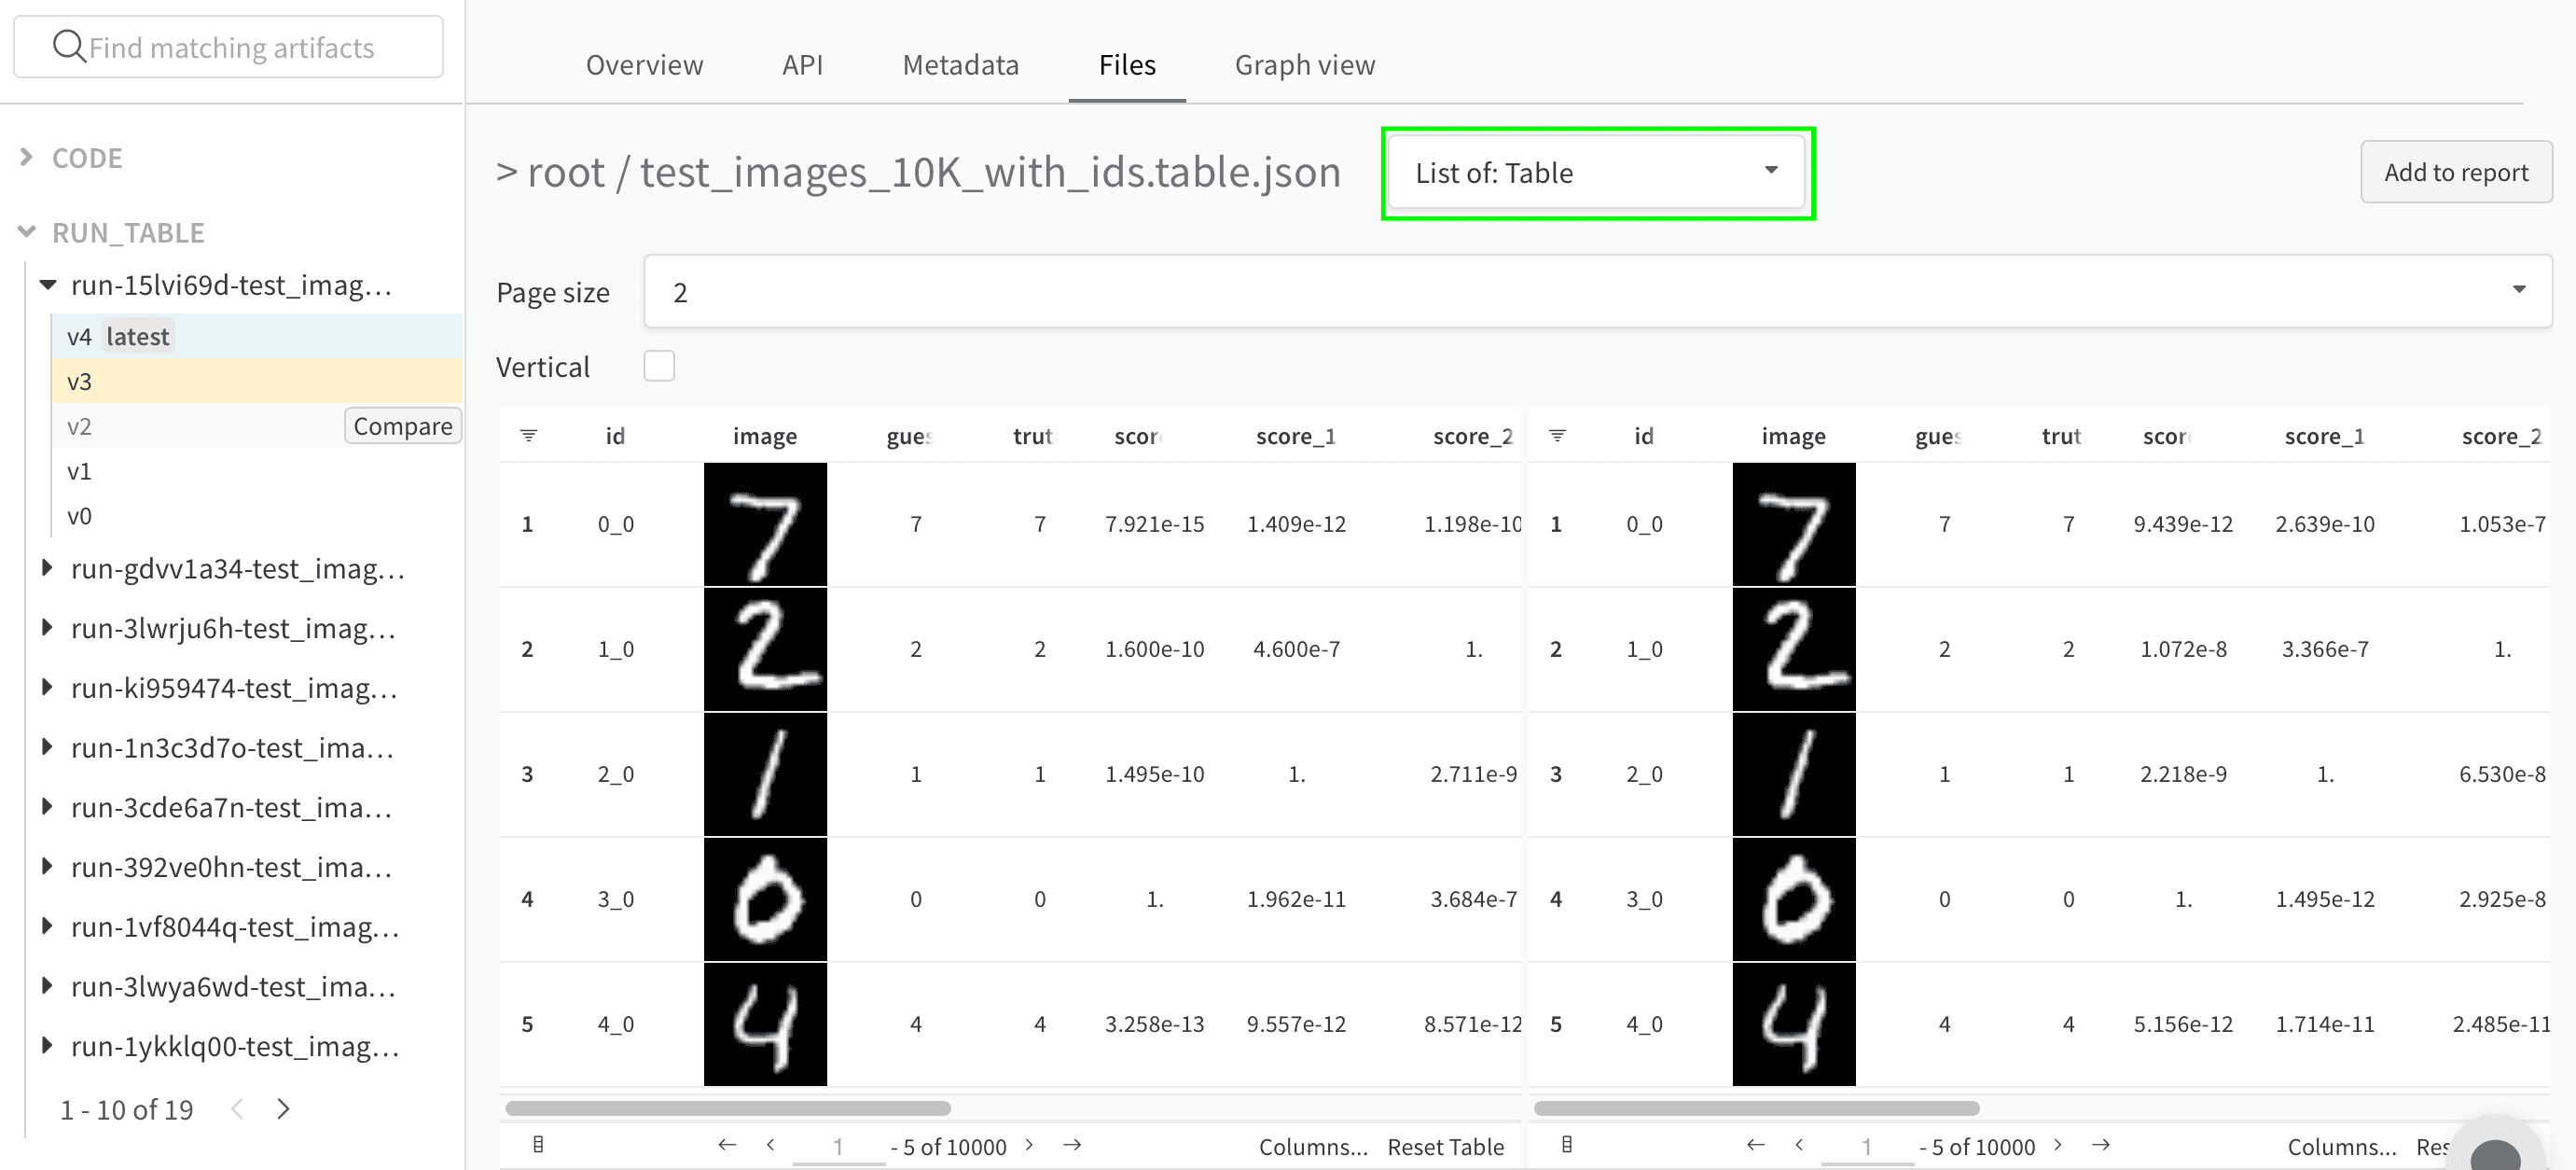
- 表を一目で比較する: 両方の表に同じ操作 (並べ替え、フィルター、グループ化) を適用し、変化や違いをすばやく見つけます。たとえば、推測値でグループ化した誤った予測、全体で最も判別が難しい負例、正解ラベル別の信頼度スコアの分布などを確認できます。
- 2 つの表を個別に調べる: スクロールして、関心のある側や行に注目します
アーティファクトを比較する
アーティファクトのバージョンとしてログされた 2 つの W&B 表を比較して、データやモデル性能の変化を分析します。マージ ビューまたは並列ビューを使用して、表を比較します。時間経過に沿って表を比較する
トレーニング中のモデル性能の推移を分析するには、トレーニングの重要なステップごとにアーティファクトに表をログします。たとえば、各検証ステップの終了時、トレーニングの50エポックごと、またはパイプラインに適した頻度で表をログできます。並列ビューを使用して、モデルの予測の変化を可視化します。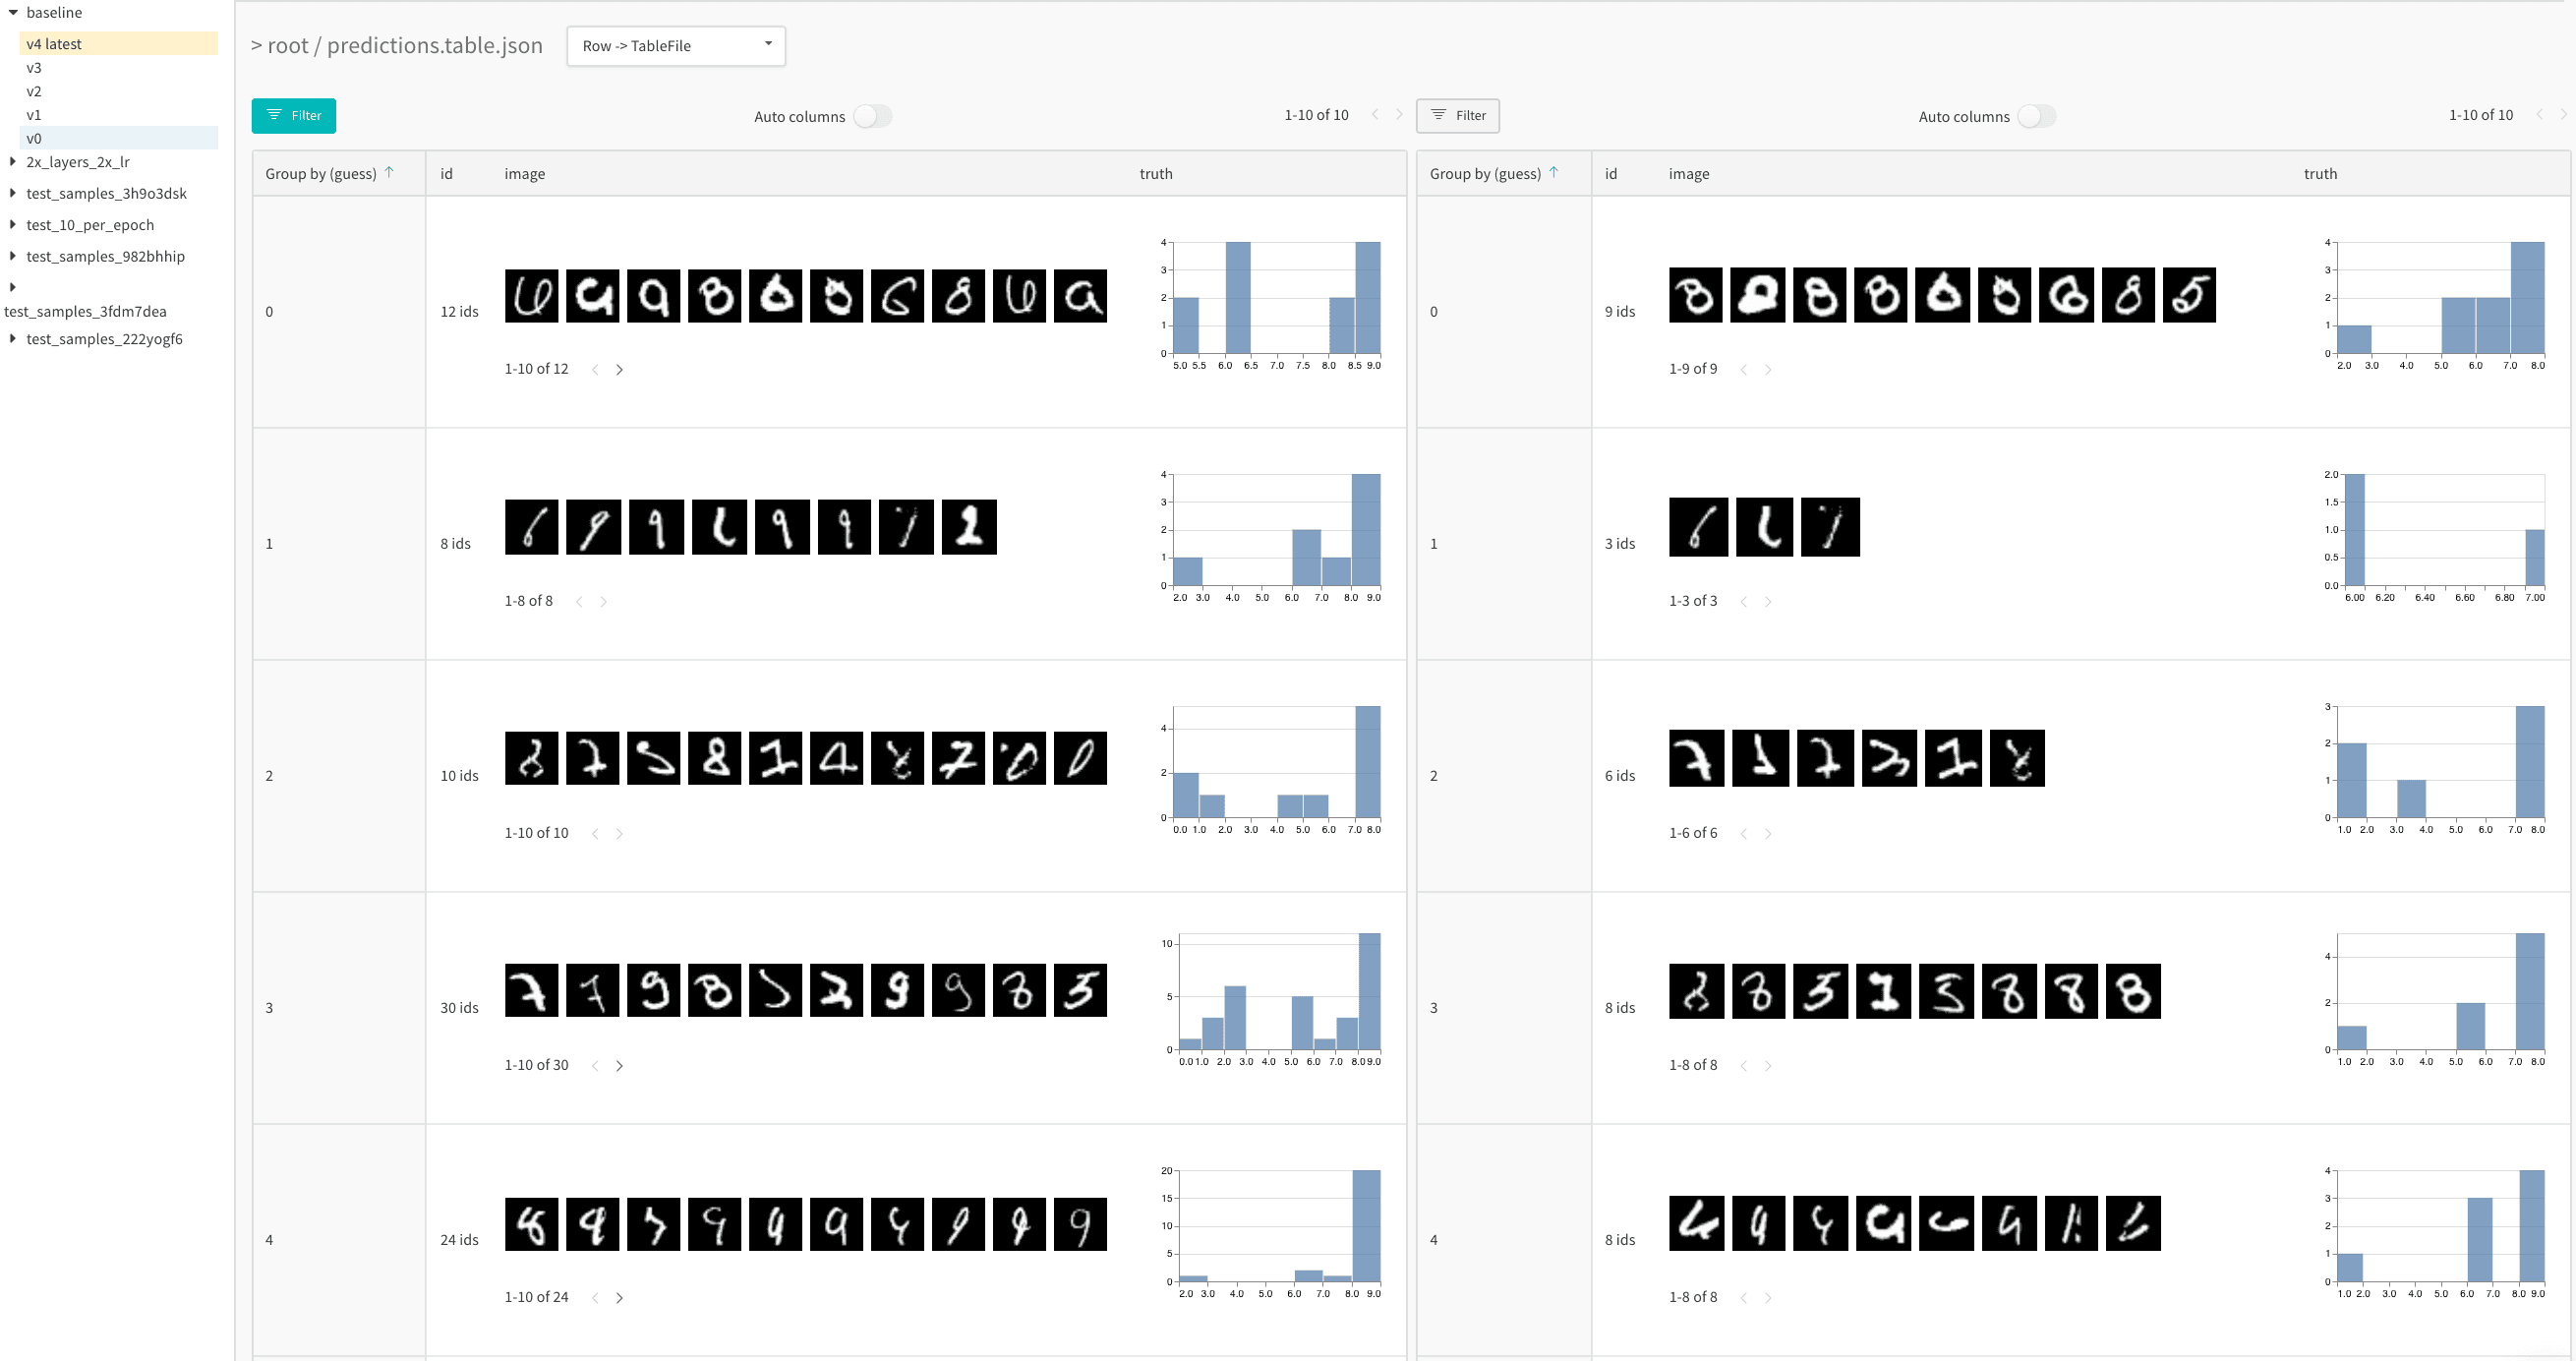
モデルのバリエーション間で表を比較する
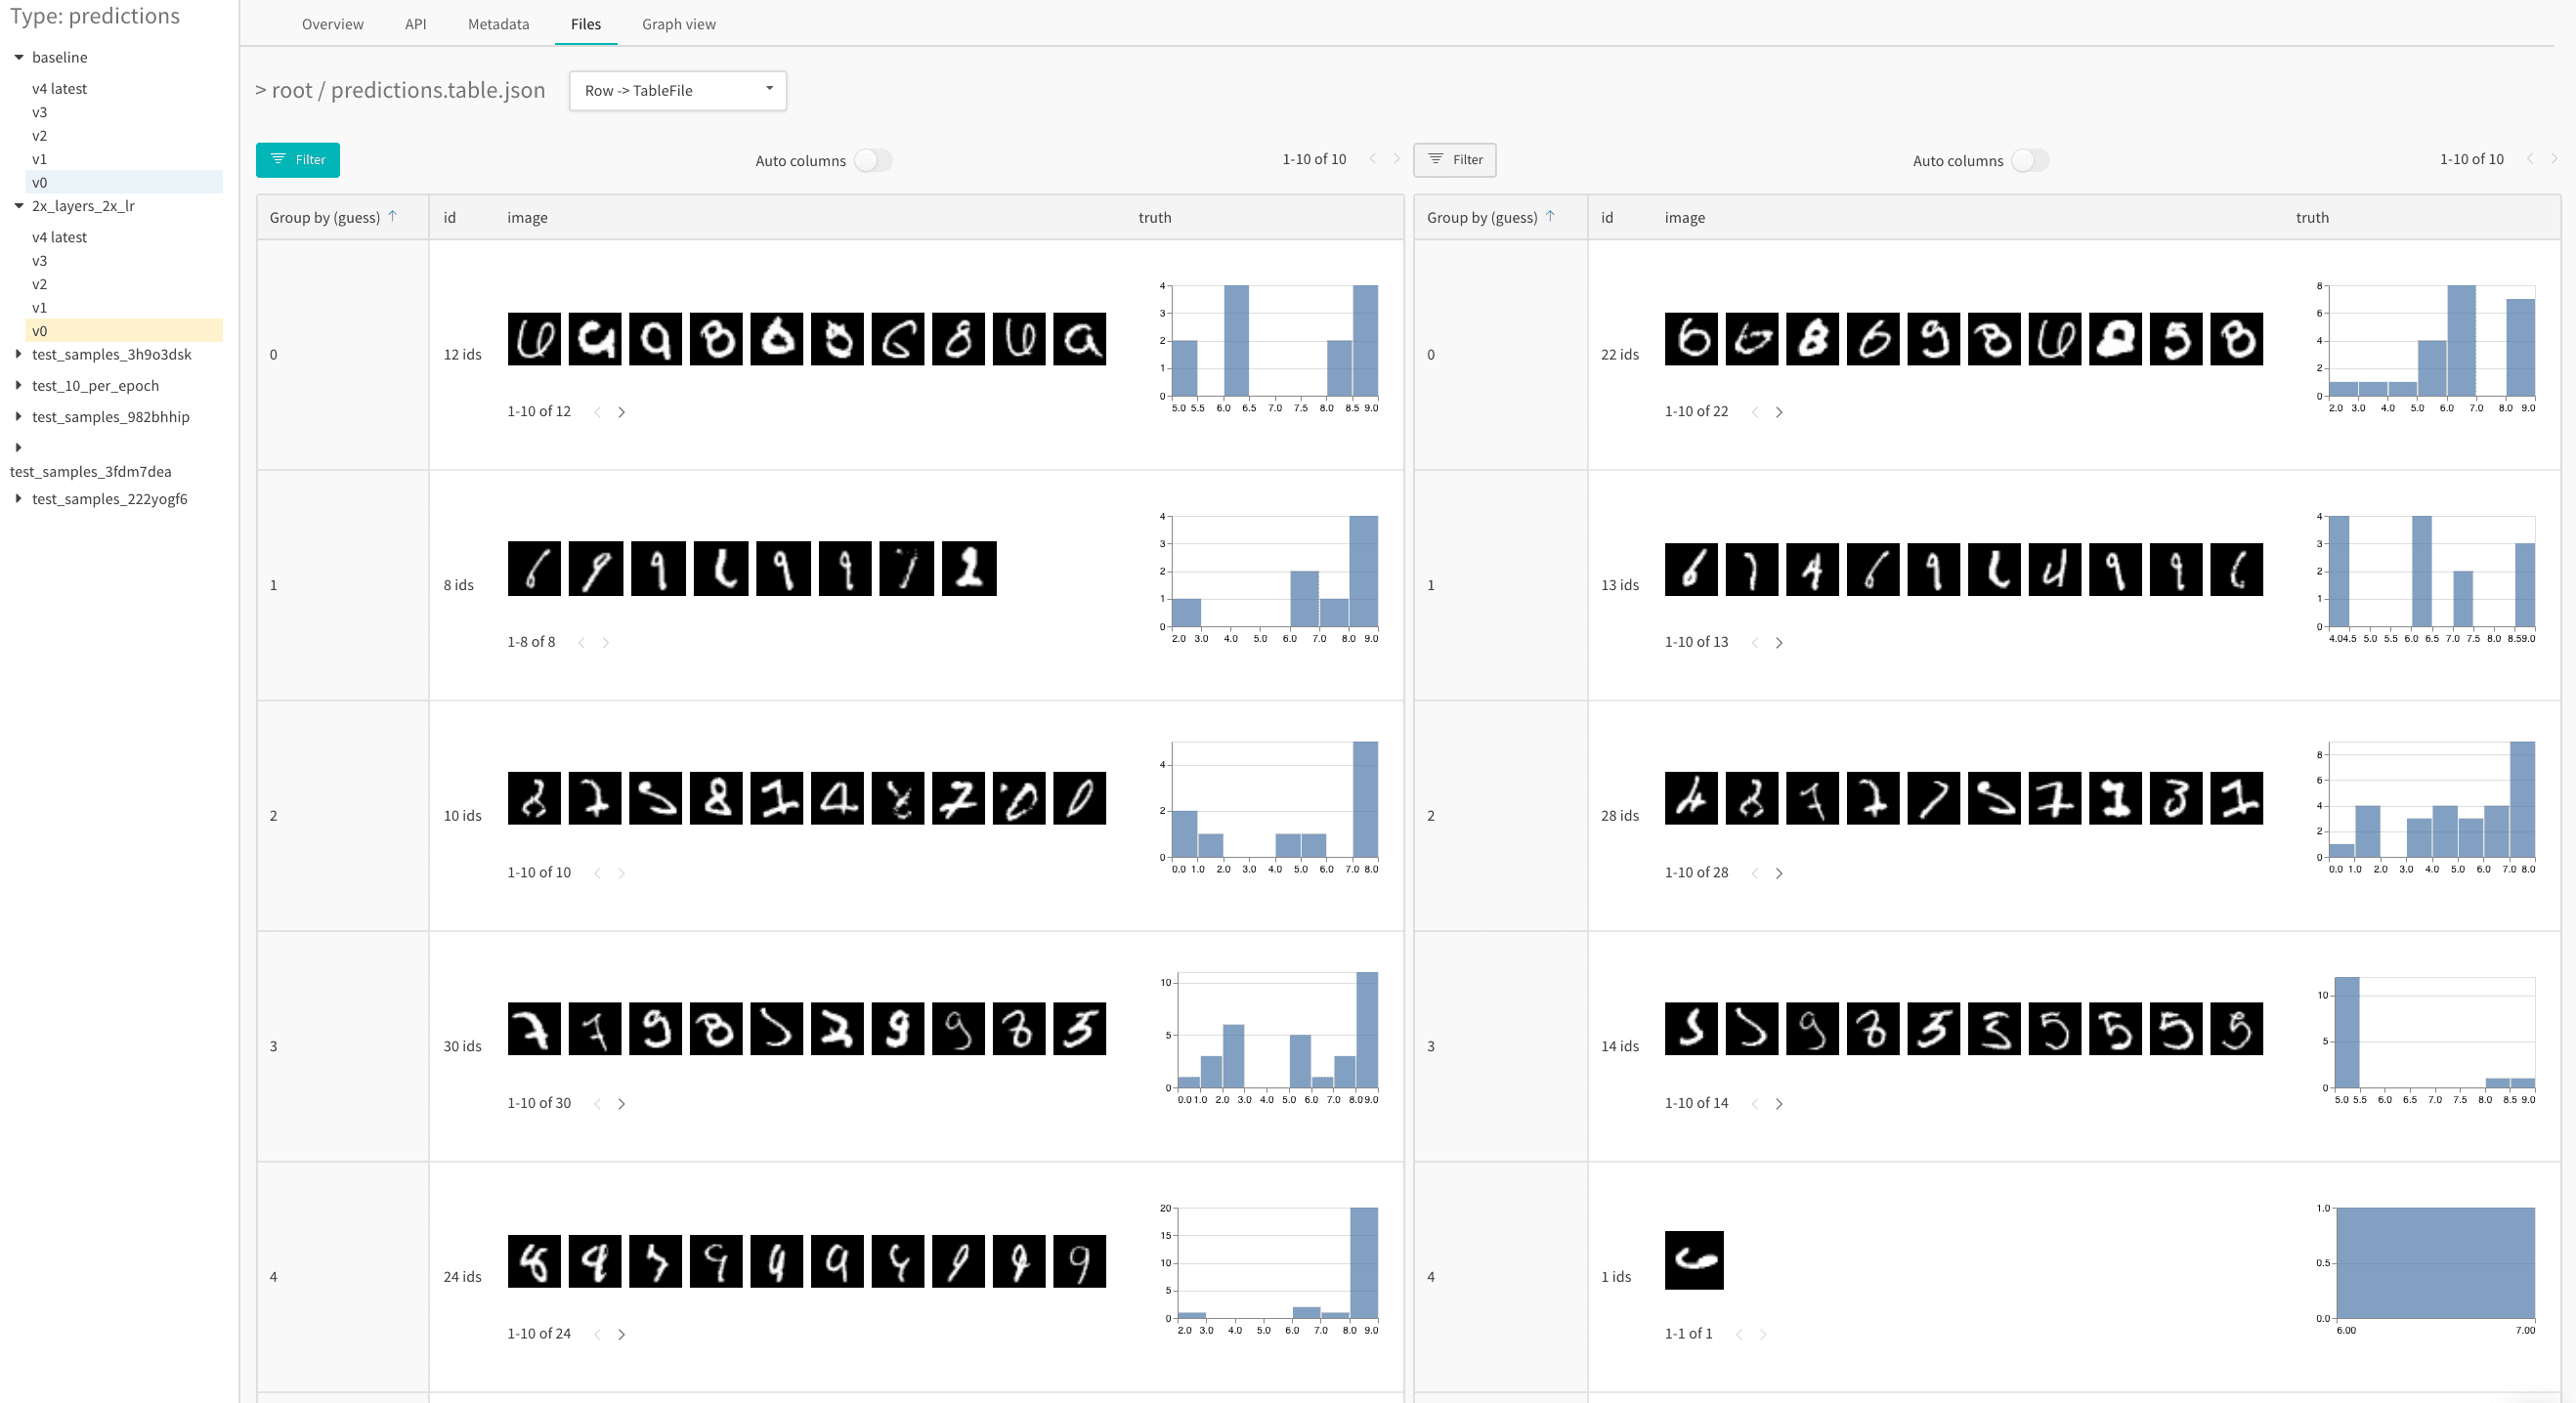
異なる 2 つのモデルで同じステップにログされた 2 つのアーティファクトのバージョンを比較し、異なる設定 (ハイパーパラメーター、基本アーキテクチャなど) におけるモデル性能を分析します。 例えば、baseline と新しいモデルのバリエーション 2x_layers_2x_lr の予測を比較します。このバリエーションでは、最初の畳み込み層を 32 から 64 に、2 番目を 128 から 256 に、学習率を 0.001 から 0.002 にそれぞれ倍増させています。この実際の例で並列ビューを使用し、トレーニング 1 エポック後 (左のタブ) と 5 エポック後 (右のタブ) の誤った予測にフィルターで絞り込みます。
- トレーニング 1 エポック
- トレーニング 5 エポック
run 全体で値がどのように変化するかを視覚化する
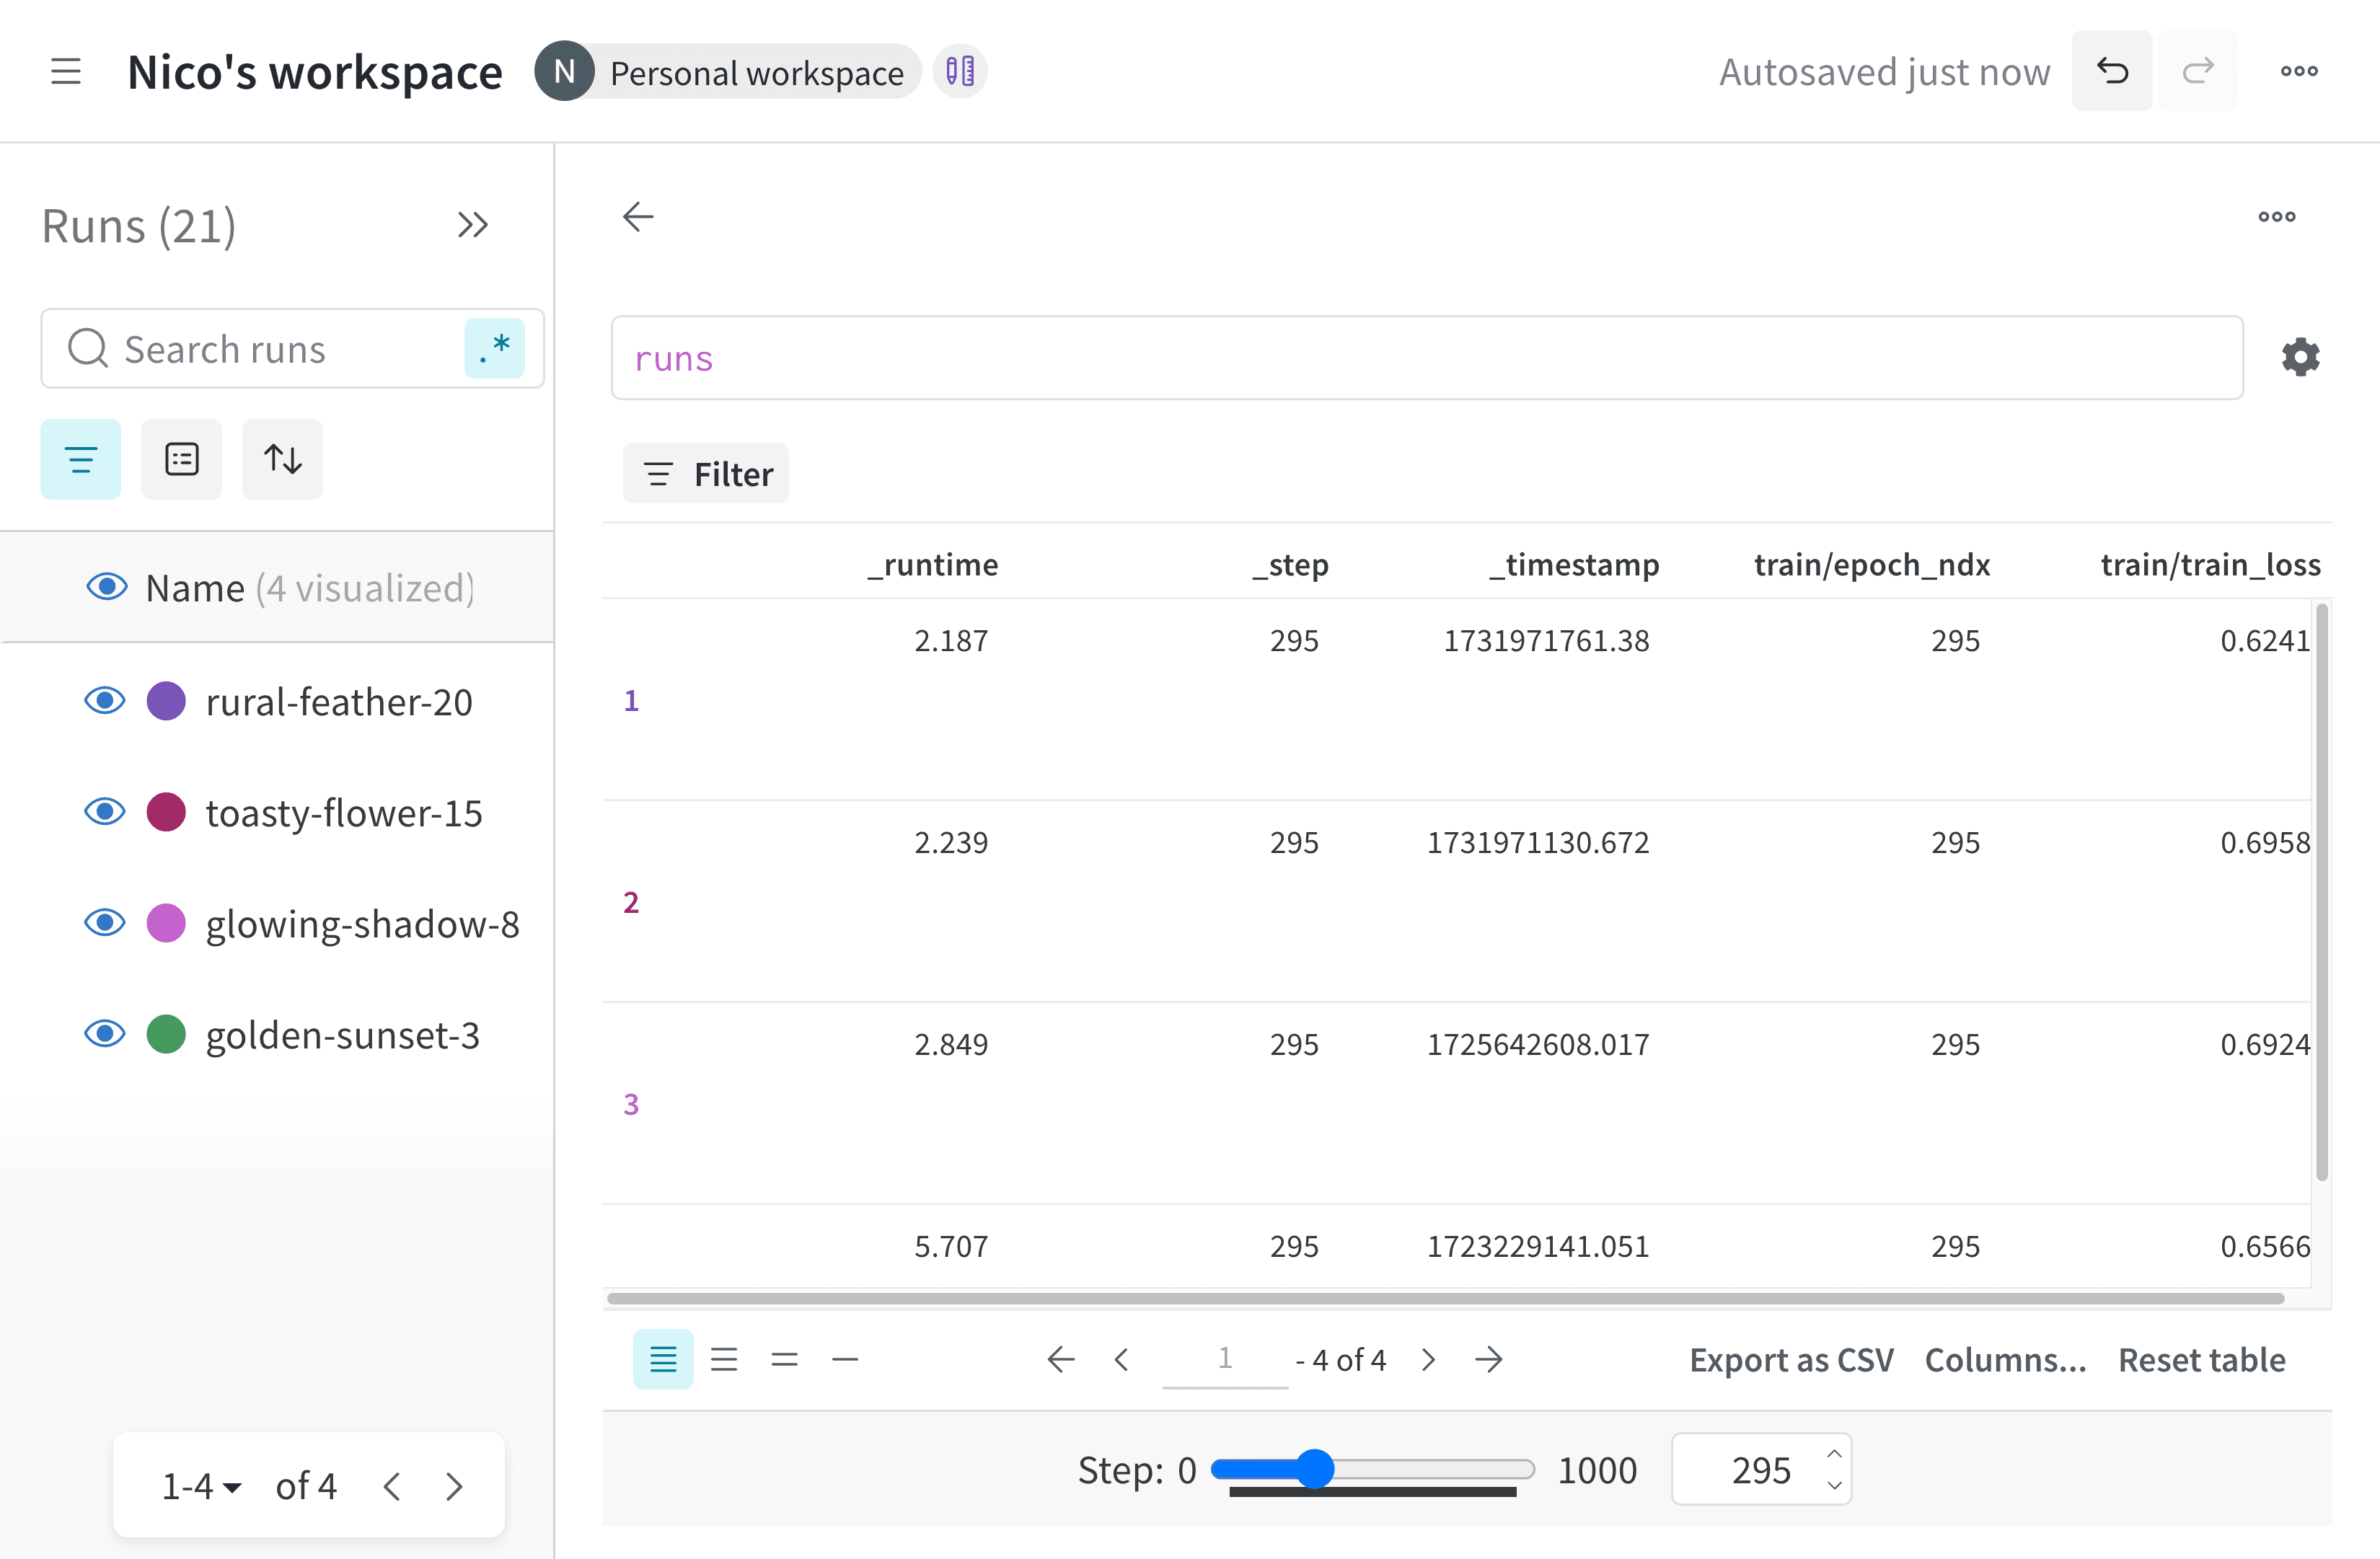
ステップスライダーを使用すると、表にログした値が run 全体でどのように変化するかを表示できます。ステップスライダーをスライドさせて、さまざまなステップでログされた値を表示します。たとえば、各 run で損失、精度、その他のメトリクスがどのように変化するかを表示できます。 スライダーは、ステップ値を決定するためにキーを使用します。スライダーのデフォルトのキーは_step です。これは、W&B が自動的にログする特別なキーです。_step キーは、コード内で wandb.Run.log() を呼び出すたびに 1 ずつ増加する整数です。
W&B 表にステップスライダーを追加するには、次の手順を実行します。
- project の Workspace にアクセスします。
- Workspace の右上隅にある Add panel をクリックします。
- Query panel を選択します。
- クエリ式エディター内で
runsを選択し、キーボードの Enter キーを押します。 - 歯車アイコンをクリックして、パネルの設定を表示します。
- Render As セレクターを Stepper に設定します。
- Stepper Key を
_step、またはステップスライダーの単位として使用するキーに設定します。
カスタムステップキー
ステップキーには、epoch や global_step など、run でログする任意の数値メトリクスを使用できます。カスタムステップキーを使用すると、W&B はそのキーの各値を run 内のステップ (_step) に対応付けます。
この表は、カスタムステップキー epoch が、serene-sponge、lively-frog、vague-cloud という 3 つの run の _step 値にどのように対応するかを示しています。各行は、run 内の特定の _step での wandb.Run.log() の呼び出しを表します。各列には、そのステップでログされたエポック値がある場合に、その値を示しています。スペースを節約するため、一部の _step 値は省略しています。
wandb.Run.log() が最初に呼び出されたとき、どの run も epoch 値をログしていないため、表の epoch の値は空欄になっています。
ここで、スライダーを
epoch = 1 に設定すると、次のようになります。
vague-cloudはepoch = 1を検索し、_step = 5でログされた値を返しますlively-frogはepoch = 1を検索し、_step = 4でログされた値を返しますserene-spongeはepoch = 1を検索し、_step = 2でログされた値を返します
epoch = 9 に設定した場合:
vague-cloudもepoch = 9をログしていないため、W&B はそれ以前の最新の値epoch = 3を使用し、_step = 20でログされた値を返しますlively-frogはepoch = 9をログしていませんが、それ以前の最新の値はepoch = 5であるため、_step = 20でログされた値を返しますserene-spongeはepoch = 9を検索し、_step = 18でログされた値を返します
ビューを保存する
run の Workspace、プロジェクトの Workspace、または report で操作した表では、ビューの状態が自動的に保存されます。表に対して操作を適用した後にブラウザーを閉じても、次にその表にアクセスした際には、最後に表示していた設定が保持されます。アーティファクトのコンテキストで操作した表は、ステートレスのままです。
- Workspace の可視化パネルの右上隅にある action () メニューを選択します。
- Share panel または Add to report のいずれかを選択します。