

ファインチューンできるモデルの一覧については、OpenAI ドキュメントを参照してください。
OpenAI Python API のインストールまたは更新
ファインチューニングの結果を同期する前に、互換性のあるバージョンの OpenAI Python クライアントがインストールされていることを確認してください。W&B の OpenAI ファインチューニングインテグレーションは、OpenAI バージョン 1.0 以降に対応しています。OpenAI Python API ライブラリの最新バージョンについては、PyPI のドキュメントを参照してください。 OpenAI Python API をインストールするには、次のコマンドを実行します。OpenAI のファインチューニング結果を同期する
このセクションでは、OpenAI のファインチューニングジョブのメトリクスと設定を W&B に送信し、他の実験と並べて確認できるようにする方法を説明します。そのためには、wandb.integration.openai.fine_tuning モジュールの WandbLogger クラスを使用します。
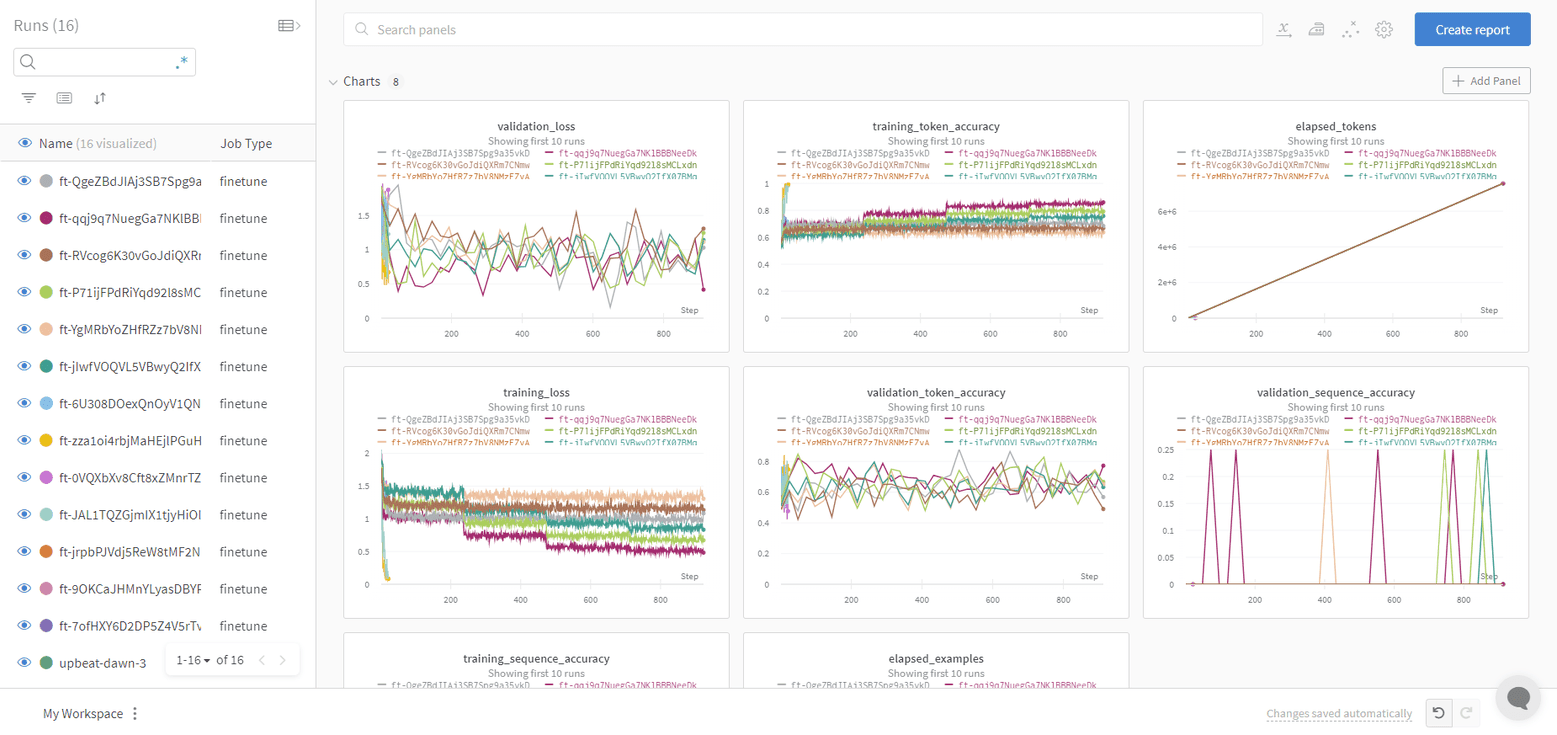
ファインチューンを同期する
スクリプトから結果を同期します。次の例では、1 行だけの最小限の呼び出しと、同期の動作を制御するために指定できるすべてのオプションのパラメーターの両方を示します。リファレンス
次の表は、WandbLogger.sync が受け付ける各引数の説明です。
データセットのバージョン管理と可視化
ファインチューニングジョブを同期すると、W&B はトレーニングデータと検証データも取得します。これにより、データのバージョン管理やインタラクティブな探索が可能になります。以下のサブセクションでは、W&B がトラッキングする内容と、その確認方法について説明します。バージョン管理
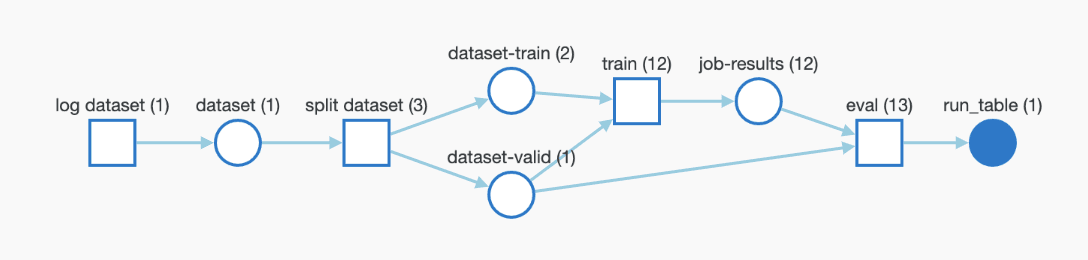
ファインチューニングのために OpenAI にアップロードしたトレーニングデータと検証データは、W&B Artifacts として自動的にログされるため、バージョン管理が容易になります。次の画像は、Artifacts でトレーニングファイルを表示した例です。このファイルをログした W&B run、ログされた日時、データセットのバージョン、メタデータ、そしてトレーニングデータからトレーニング済みモデルに至る DAG リネージを確認できます。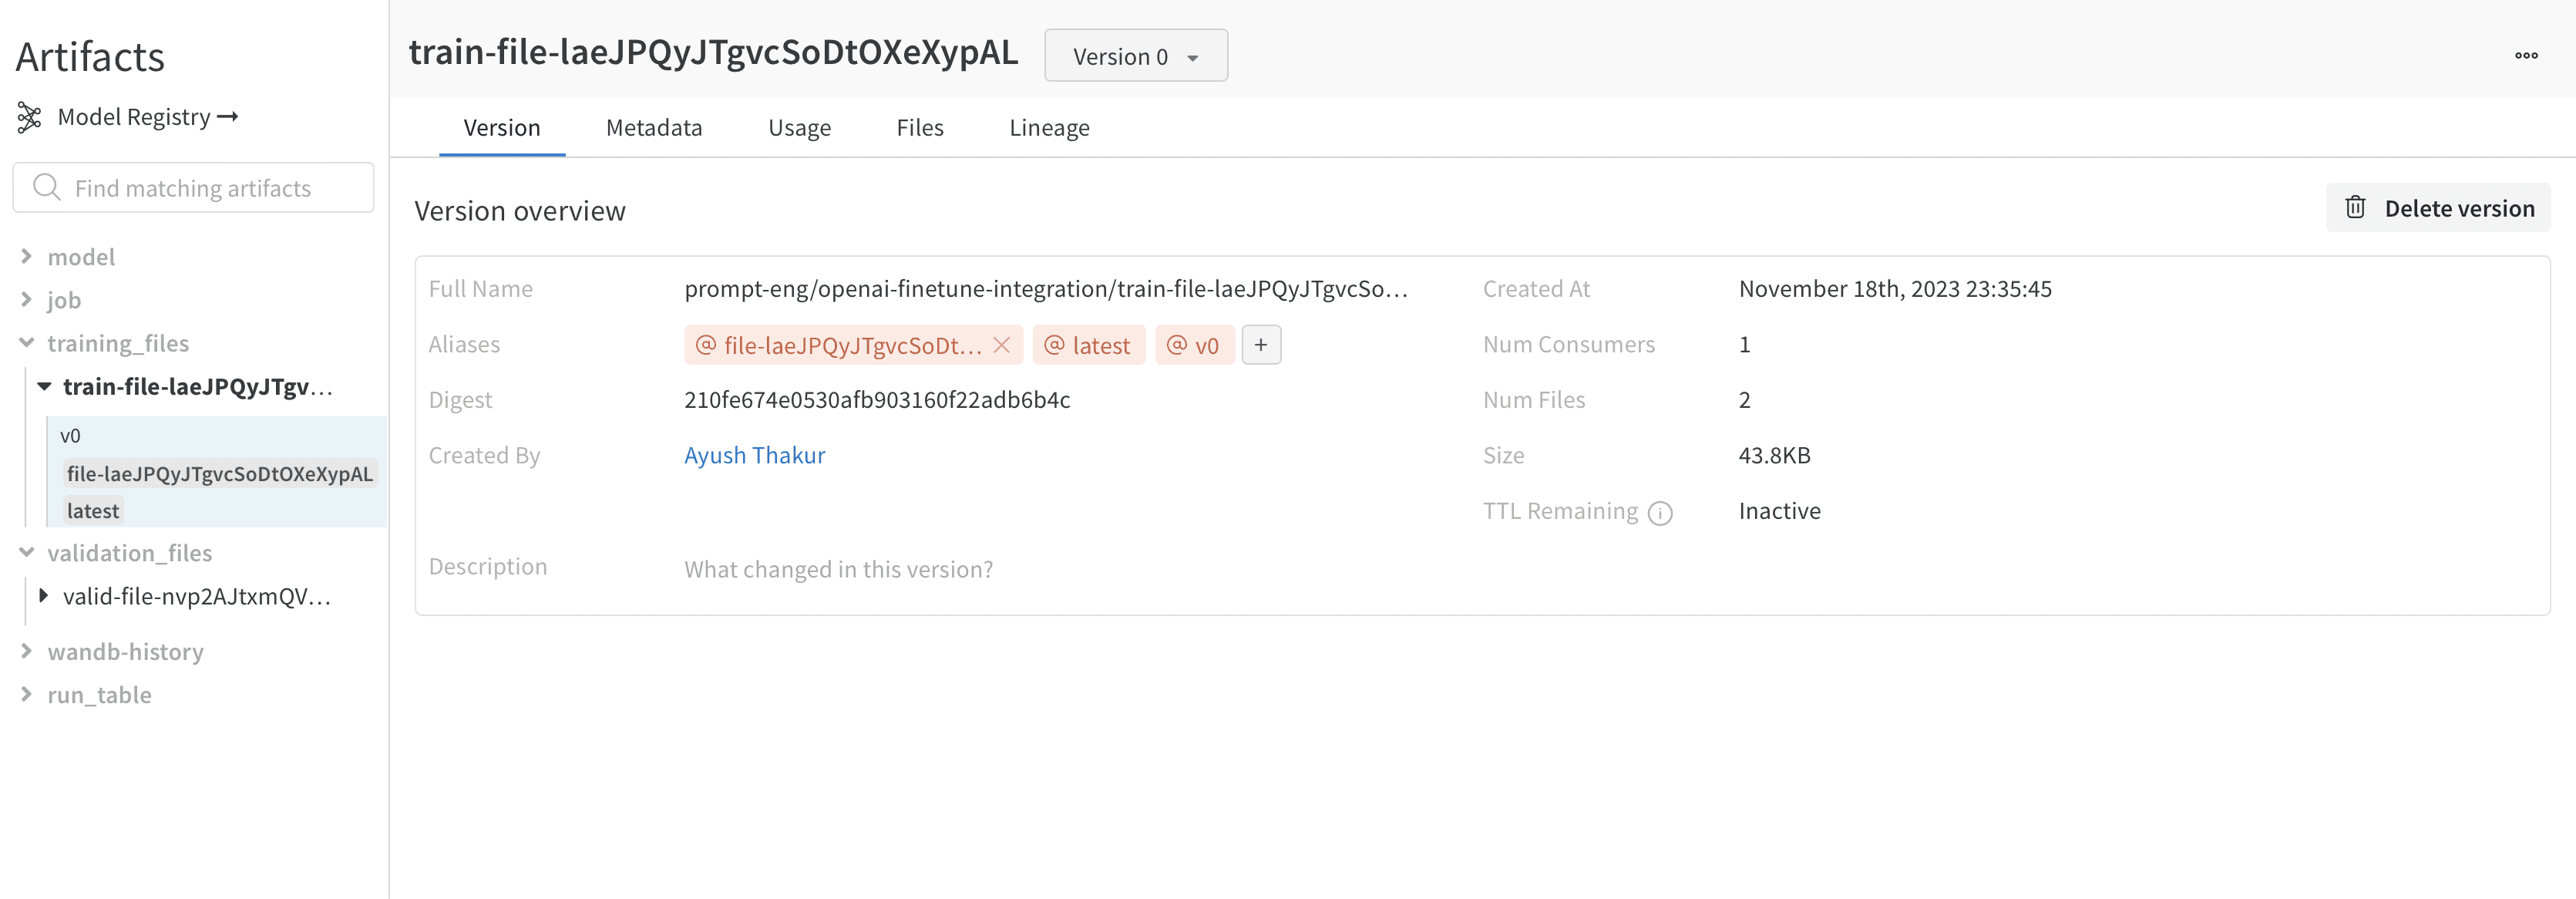
可視化
W&B はデータセットを W&B 表として可視化するため、データセットの探索や検索、インタラクティブな操作が可能です。次の画像は、W&B 表で可視化したトレーニングサンプルの例です。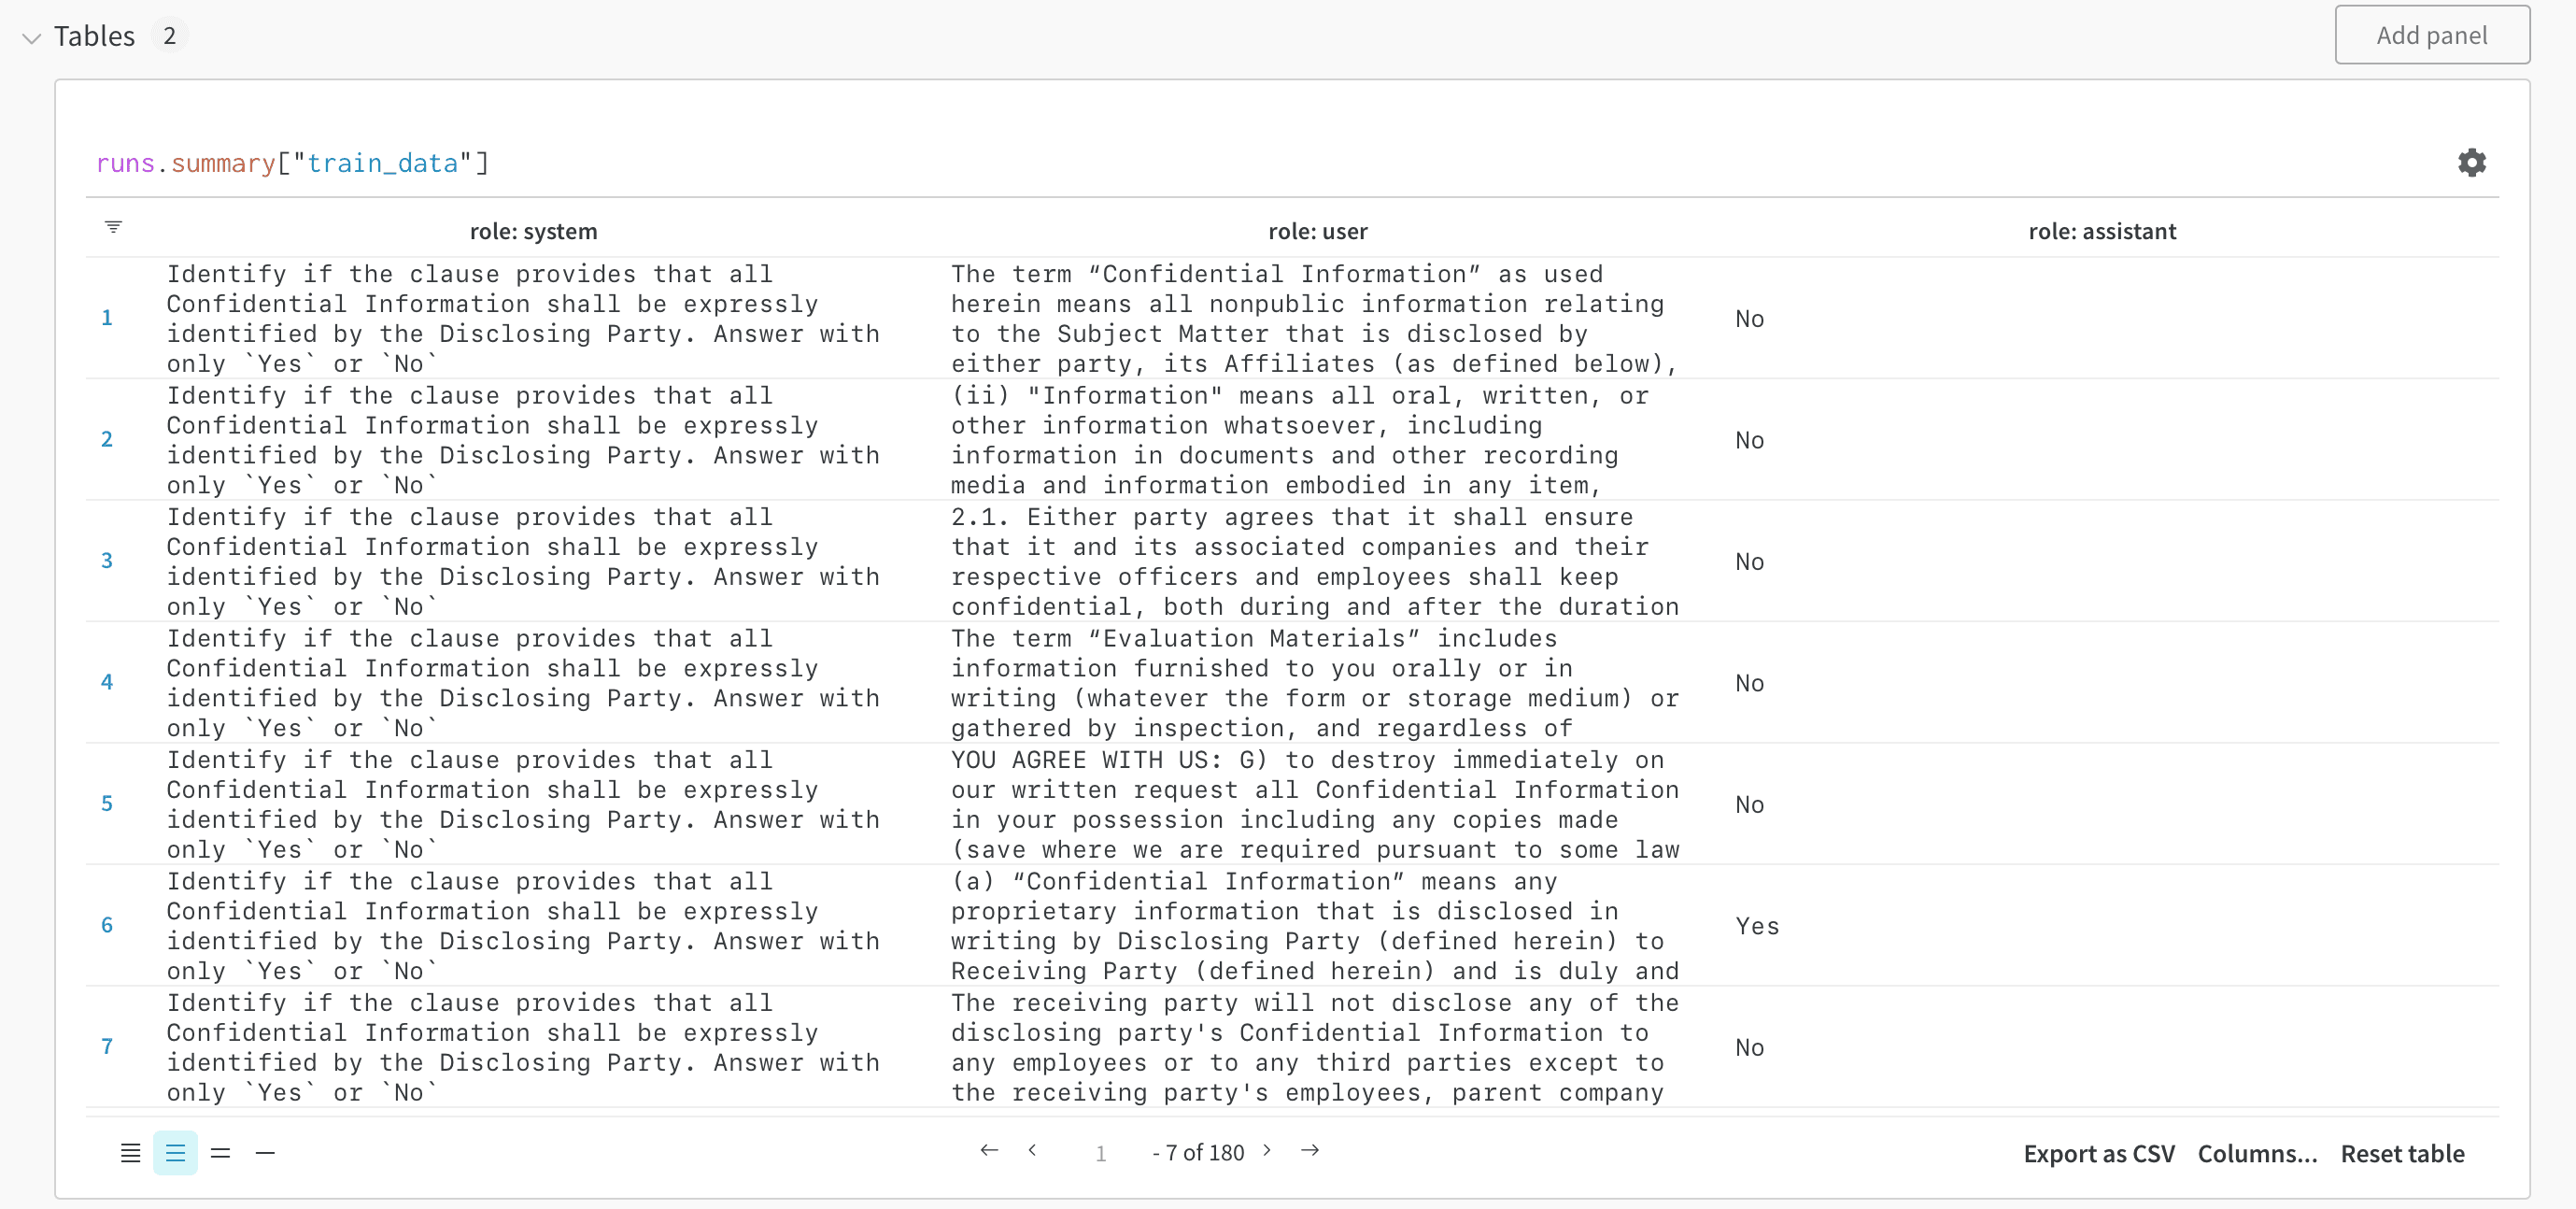
ファインチューニングしたモデルとモデルのバージョン管理
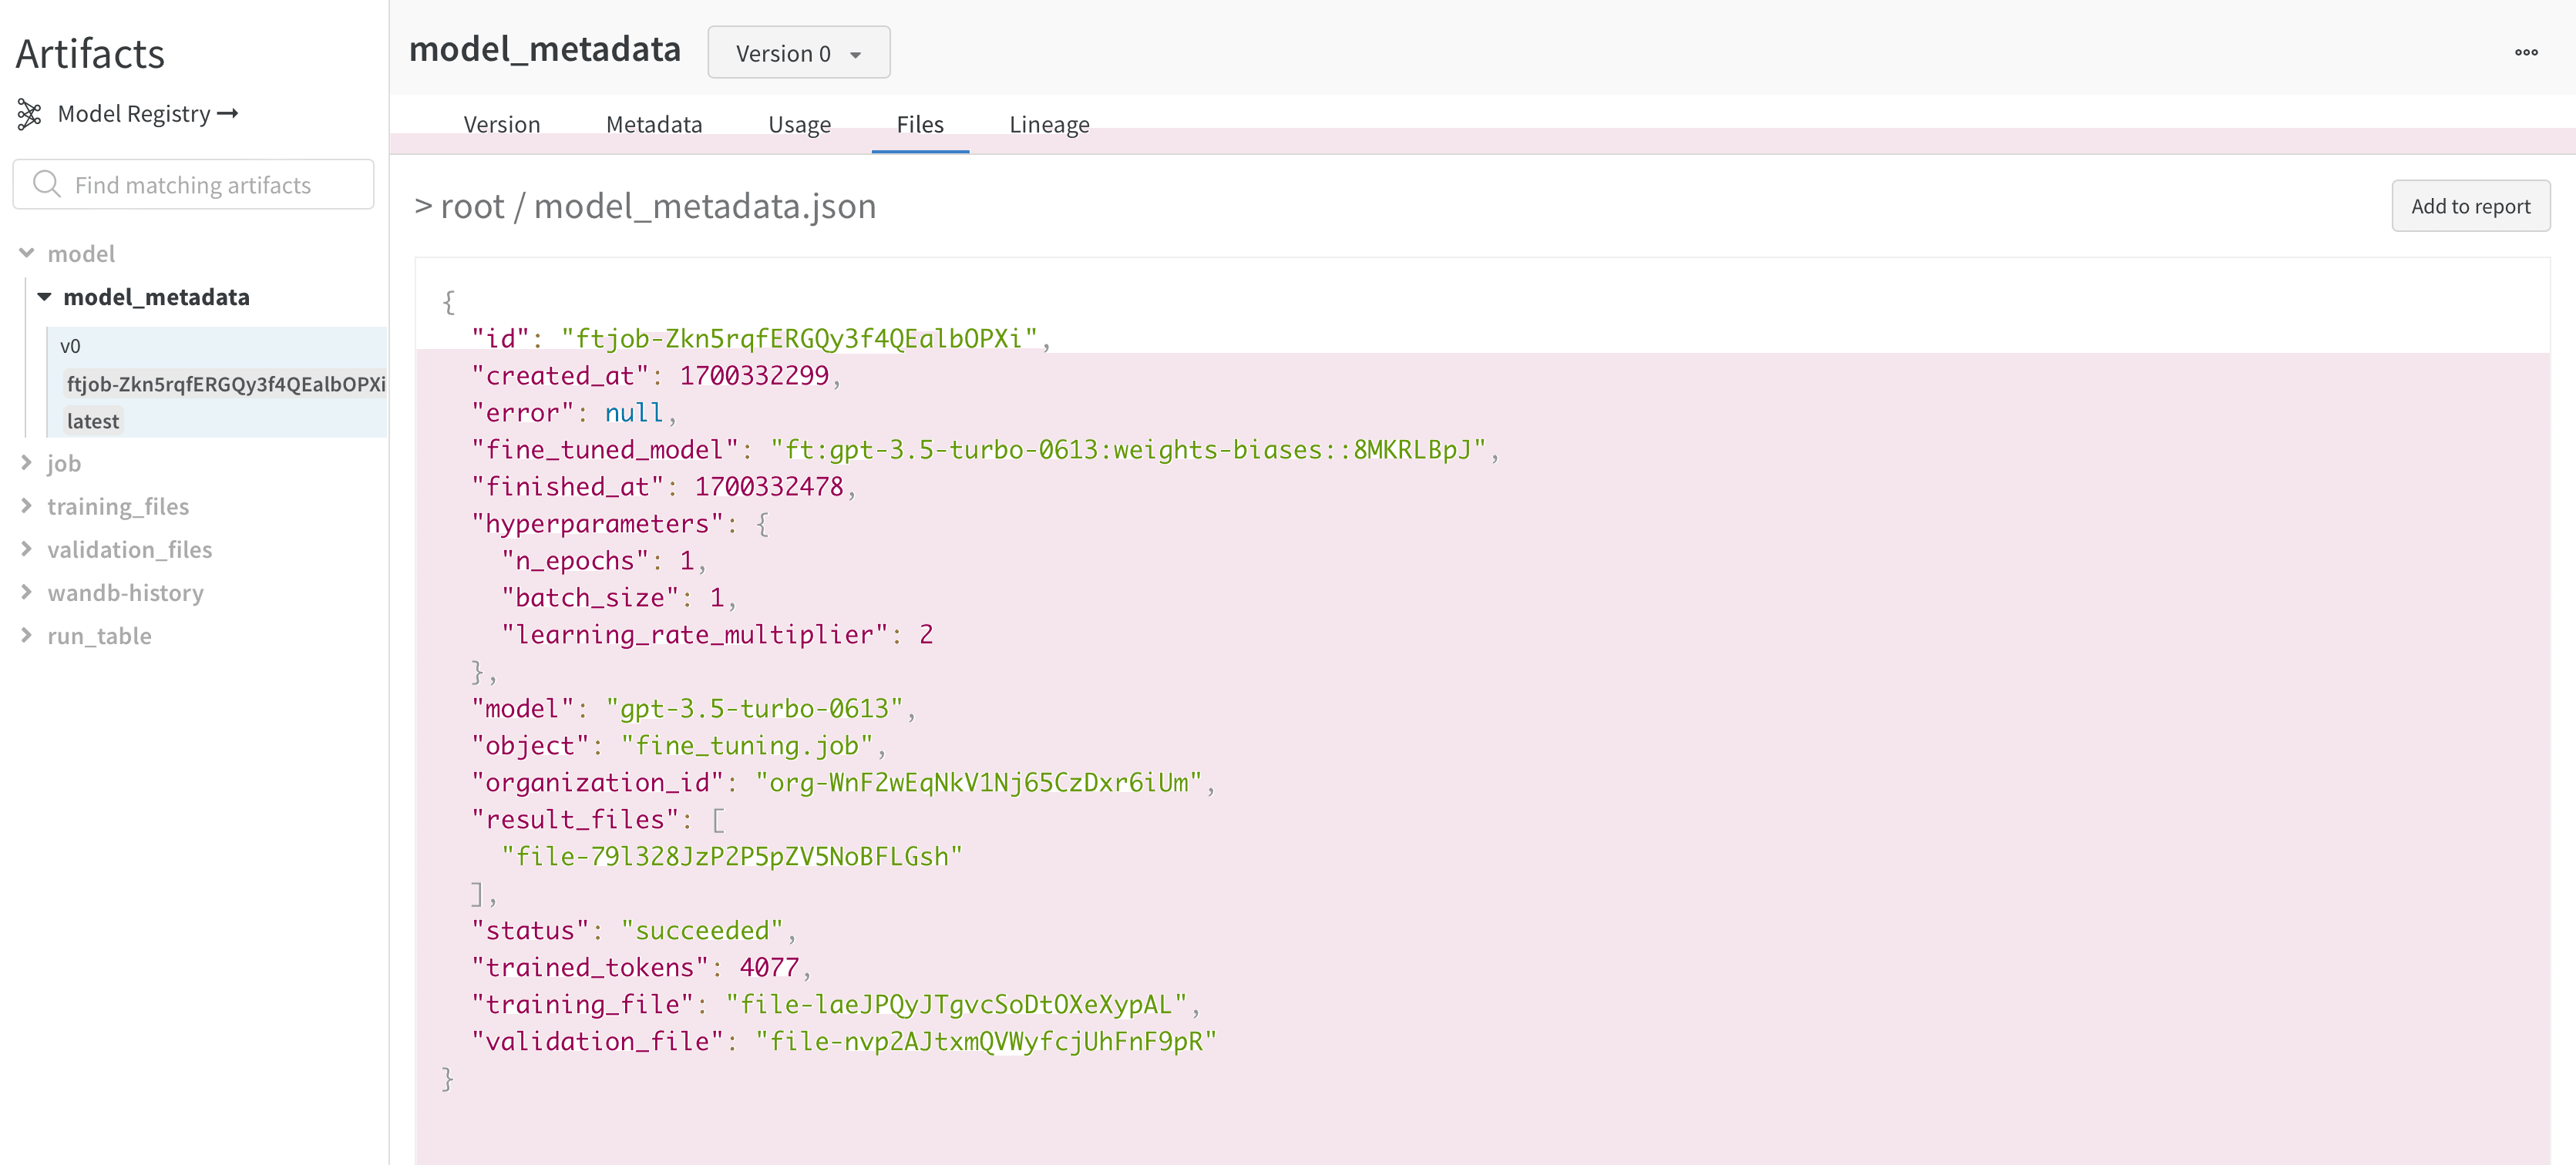
OpenAI はファインチューニングしたモデルの基盤となる重みを公開していないため、W&B は代わりにモデルのメタデータを取得してトラッキングします。OpenAI からは、ファインチューニングしたモデルの ID が提供されます。モデルの重みにはアクセスできないため、WandbLogger はモデルの詳細情報 (ハイパーパラメーター、データファイル ID など) を fine_tuned_model ID とあわせて model_metadata.json ファイルにまとめ、W&B Artifactsとしてログします。
このモデル (メタデータ) アーティファクトは、Registry 内のモデルにリンクできます。
よくある質問
以下のセクションでは、OpenAI から同期したファインチューニングの run の共有、整理、復元に関するよくある質問にお答えします。ファインチューンの結果をチームと共有する
次のコードで、ファインチューンジョブをチームアカウントにログします。run を整理する
W&B は run を自動的に整理します。ジョブタイプ、ベースモデル、学習率、トレーニングファイル名、その他のハイパーパラメーターなど、任意の設定パラメーターに基づいて run をフィルターしたり並べ替えたりできます。 また、run をリネームしたり、メモを追加したり、タグを作成して run をグループ化したりすることもできます。 満足のいく状態になったら、Workspace を保存し、それを使って report を作成しましょう。その際、run や保存済みのアーティファクト (トレーニングファイルと検証ファイル) からデータをインポートできます。ファインチューニングしたモデルにアクセスする
W&B は、ファインチューニングしたモデルのモデル ID を、アーティファクト (model_metadata.json) と設定の両方にログします。
<version> プレースホルダーには、次のいずれかを指定します。
v2などのバージョン番号ft-xxxxxxxxxなどのファインチューニング IDlatestなどの自動的に追加されるエイリアス、または手動で追加したエイリアス
model_metadata.json ファイルを読み込むと、fine_tuned_model ID を取得できます。
同期されなかったファインチューンを復旧する
ファインチューンが W&B に正常にログされなかった場合は、overwrite=True を使用して、ファインチューンジョブ ID を渡します。
W&B でデータセットとモデルをトラッキングする
W&B は、トレーニングデータと検証データをアーティファクトとして自動的にログします。ファインチューニングしたモデルの ID などのメタデータも、アーティファクトとしてログします。wandb.Artifact や wandb.Run.log などの低レベルの wandb API を使用して、パイプラインを制御することもできます。これにより、データとモデルの完全なトレーサビリティを確保できます。
リソース
より詳しい背景情報やエンドツーエンドのサンプルについては、以下のリソースを参照してください。- OpenAI ファインチューニング Documentation: 詳細なガイダンスとヒントを確認できます。
- デモ Colab
- How to Fine-Tune Your OpenAI GPT-3.5 and GPT-4 Models with W&B report