Eval Tables を使用すると、複数の run にわたって、集計スコアや、サンプル単位のモデルの入力、出力、スコアを比較できます。Eval Table では、モデルのバージョンやトレーニングステップの比較、集計スコアの変化の確認、モデル性能の変化の原因となったサンプルの調査を行えます。
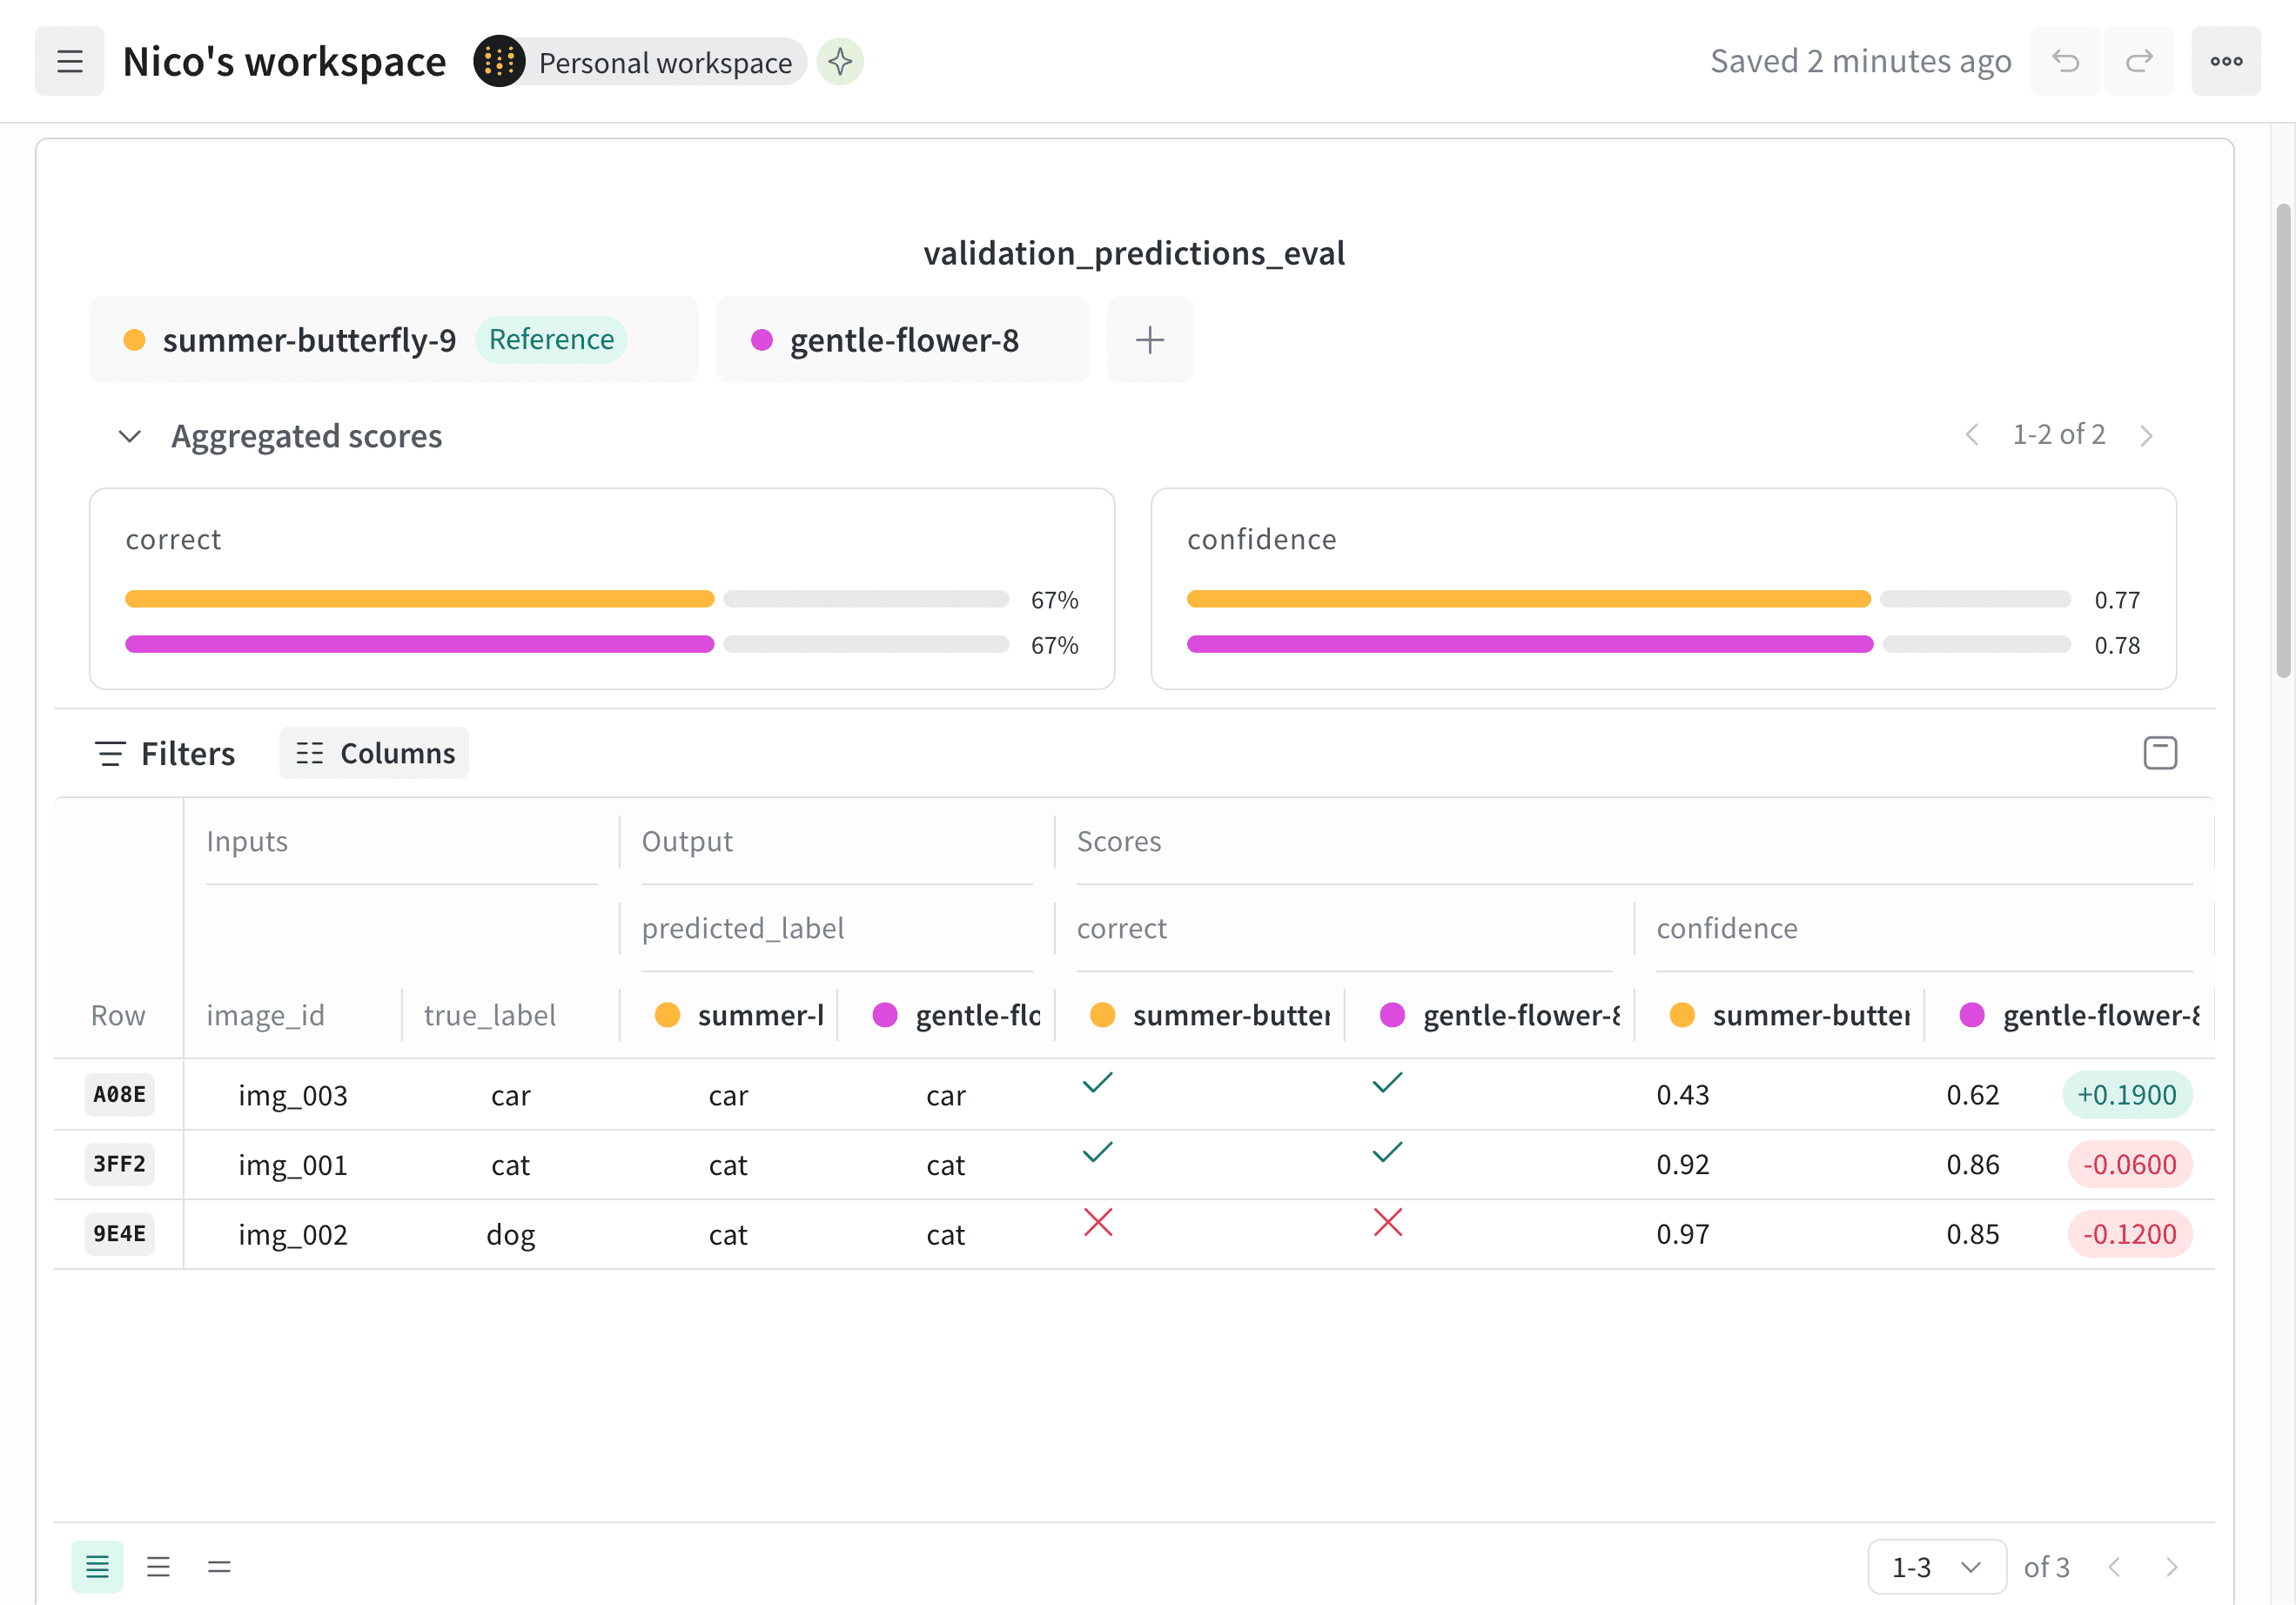
次の画像は、2 つの run "summer-butterfly-9" と "gentle-flower-8" を比較する、"validation_prediction_eval" という名前の Eval Table を示しています。
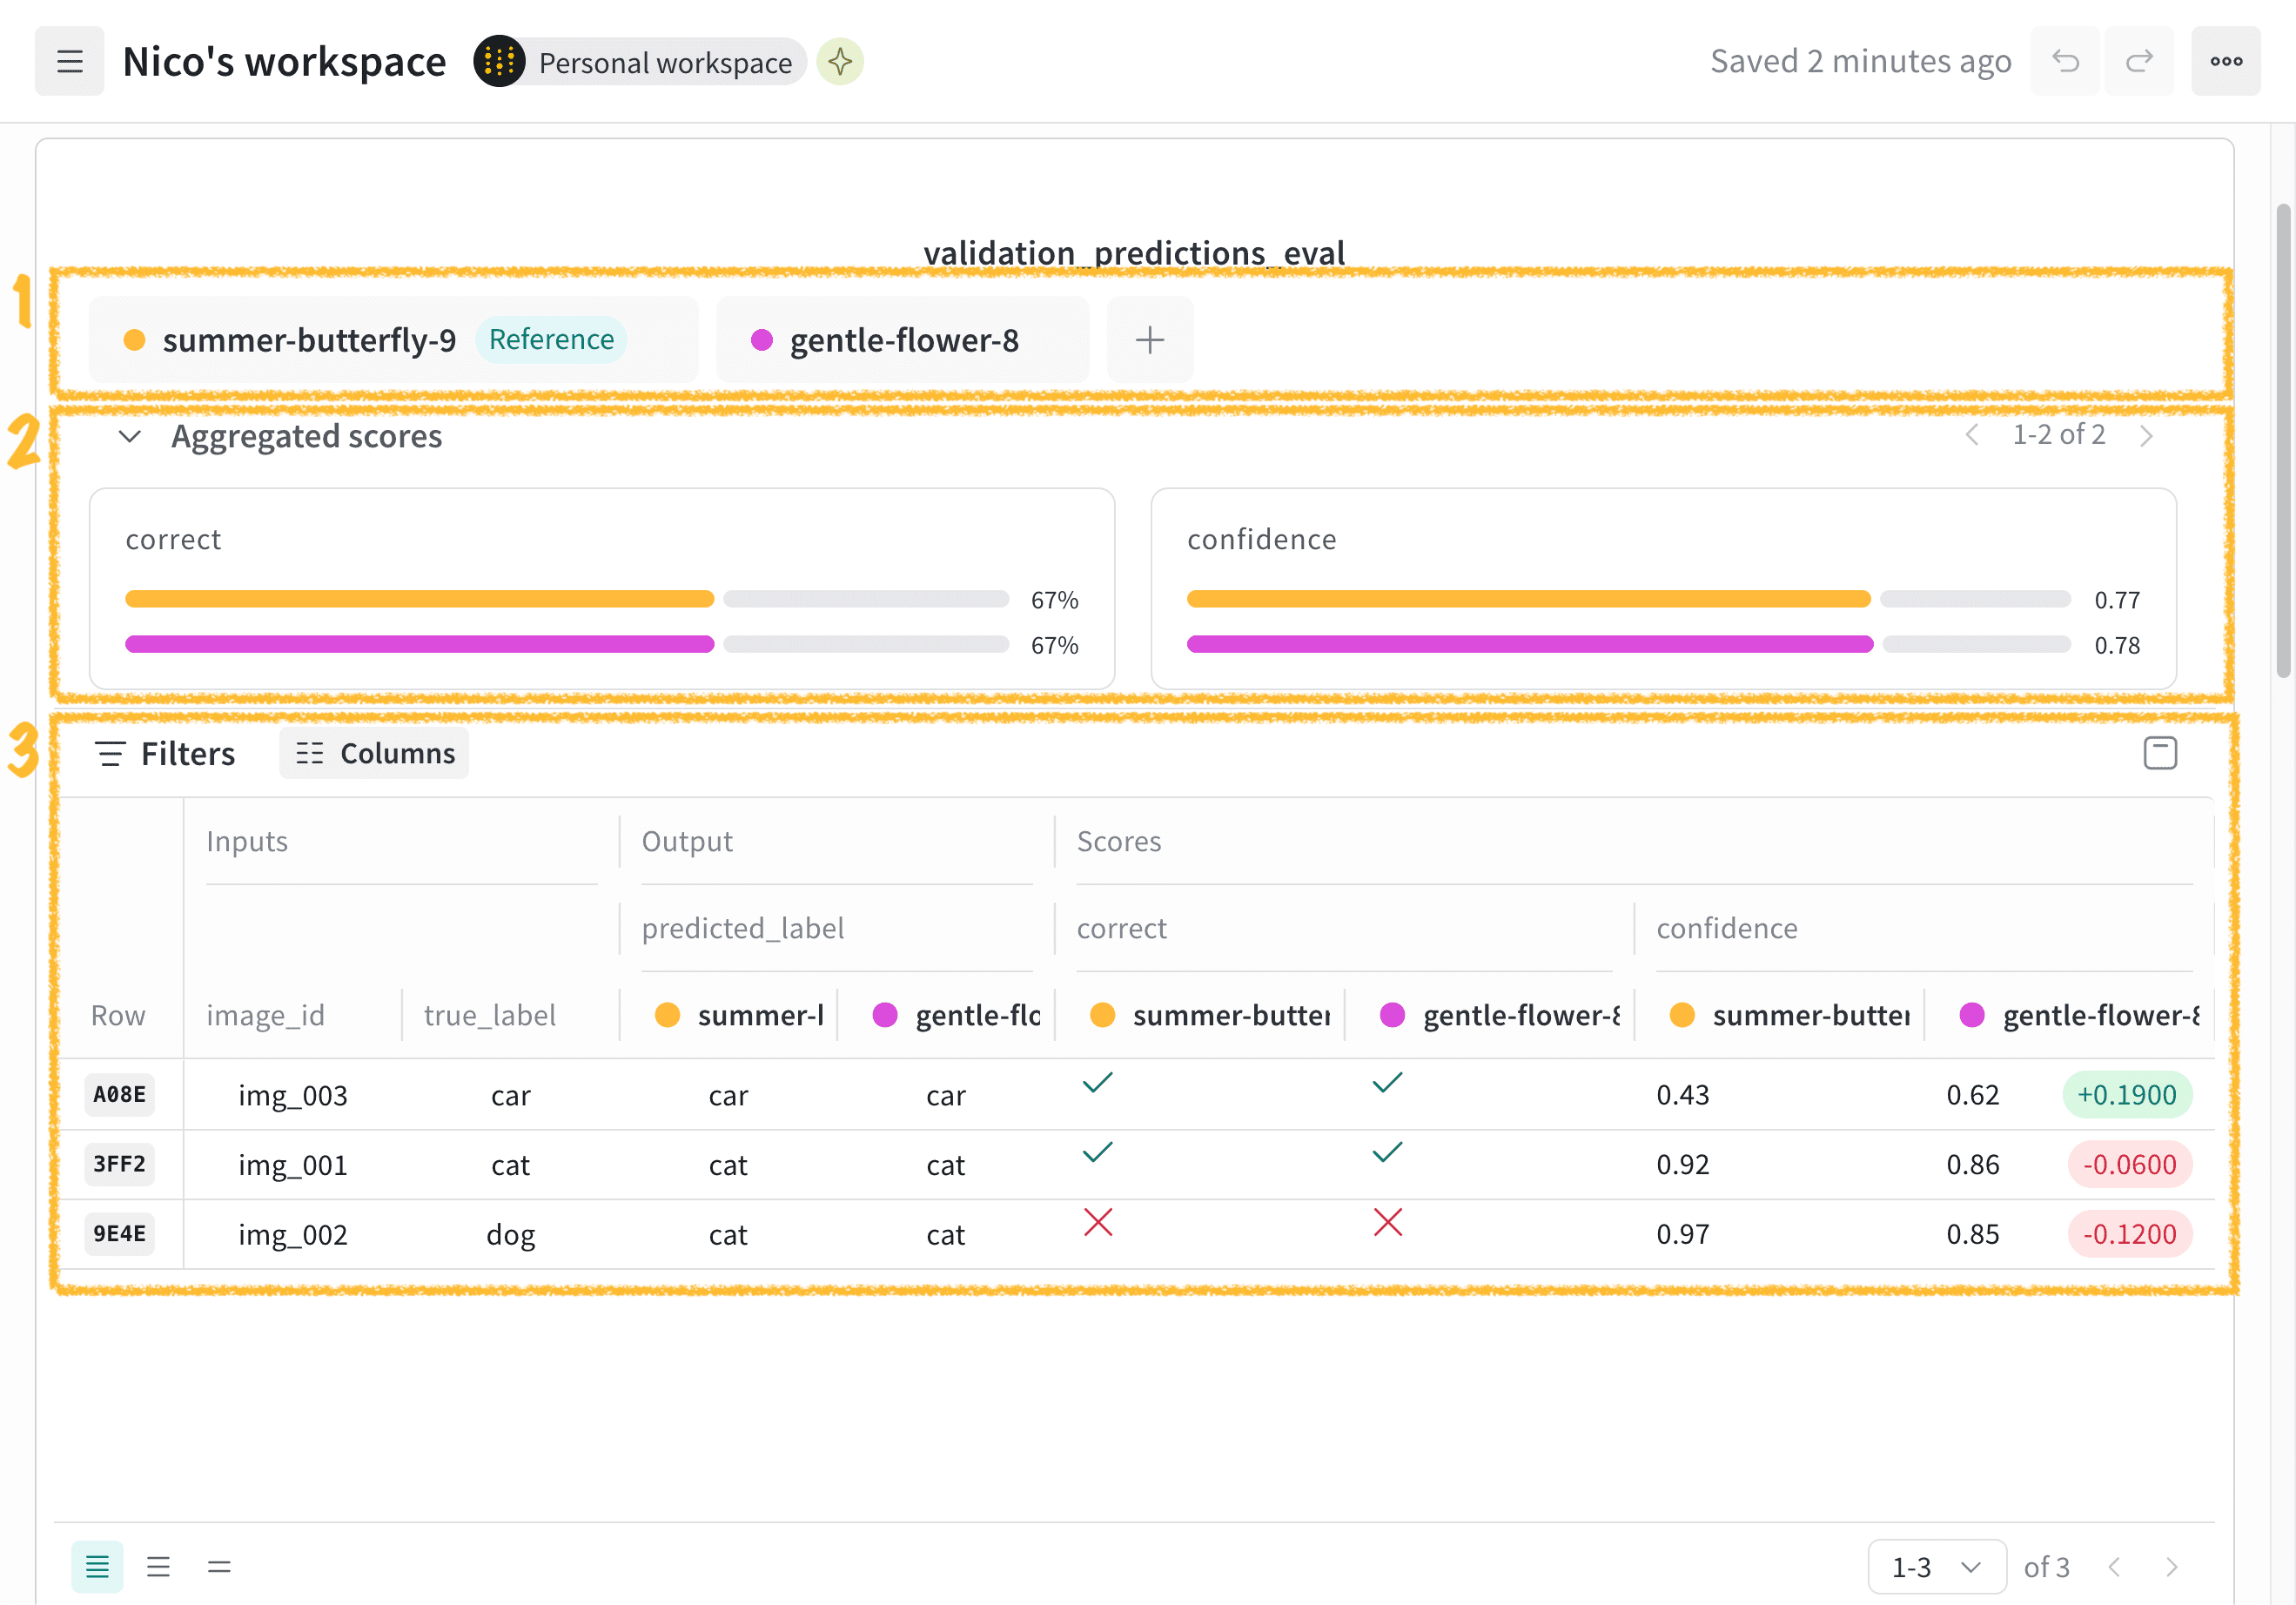
Eval Table パネルは、次の 3 つのセクションで構成されています。
- run 比較セレクター: 比較する run を選択します。
- 集計スコア: 選択した run の集計スコアを確認し、run 間の差を比較します。詳細については、集計スコアを表示する を参照してください。
- サンプル: 選択した run 間で、各サンプルの入力、出力、スコアを比較します。
次の画像では、パネルの各セクションを強調表示しています。
W&B Python SDK の EvalTable クラスを使用して Eval Table を作成します。
既存の W&B 表 は、ARIA を使用して Eval Tables に変換することもできます。詳細については、W&B 表を Eval Table に変換する を参照してください。
既存の W&B 表を Eval Tables に変換すると、レンダリングのパフォーマンスが向上し、さらに多くの比較機能を利用できるようになります。