Tous les exemples de code présentés sur cette page sont en Python.
Aperçu
Smolagents est un framework qui propose des abstractions minimales pour créer des applications agentiques. Il prend en charge plusieurs fournisseurs de LLM, tels qu’OpenAI, Hugging Face Transformers et Anthropic.
Weave capture automatiquement les traces de Smolagents. Pour commencer le suivi, appelez weave.init(), puis utilisez la bibliothèque comme d’habitude.
Prérequis
Avant de commencer, vous devez installer les bibliothèques requises et configurer l’accès au fournisseur de LLM de votre choix.
-
Pour utiliser Smolagents avec Weave, vous devez d’abord installer les bibliothèques requises ou les mettre à niveau vers leurs dernières versions. La commande suivante installe ou met à niveau
smolagents, openai et weave, sans afficher de sortie :
-
Smolagents prend en charge plusieurs fournisseurs de LLM, tels qu’OpenAI, Hugging Face Transformers et Anthropic. Définissez la clé API du fournisseur choisi pour permettre à Smolagents de s’authentifier lors de l’appel au modèle. Pour cela, définissez la variable d’environnement correspondante :
Traçage de base
Cette section montre comment Weave capture automatiquement les traces d’un flux de travail Smolagents de base.
Il est essentiel de stocker les traces des applications de modèles de langage dans un emplacement centralisé, aussi bien en développement qu’en production. Ces traces facilitent le débogage et servent de datasets pour améliorer votre application.
Weave capture automatiquement les traces de Smolagents. Pour commencer à suivre, initialisez Weave en appelant weave.init(), puis utilisez la bibliothèque comme d’habitude.
L’exemple suivant montre comment journaliser avec Weave les appels d’inférence d’un agent LLM qui utilise des outils. Dans ce scénario :
- Vous définissez un modèle de langage (
gpt-4o d’OpenAI) à l’aide de la classe OpenAIServerModel de Smolagents.
- Vous configurez un outil de recherche (
DuckDuckGoSearchTool) que l’agent peut invoquer au besoin.
- Vous construisez un
ToolCallingAgent en lui transmettant l’outil et le modèle.
- Vous exécutez via l’agent une requête qui déclenche l’outil de recherche.
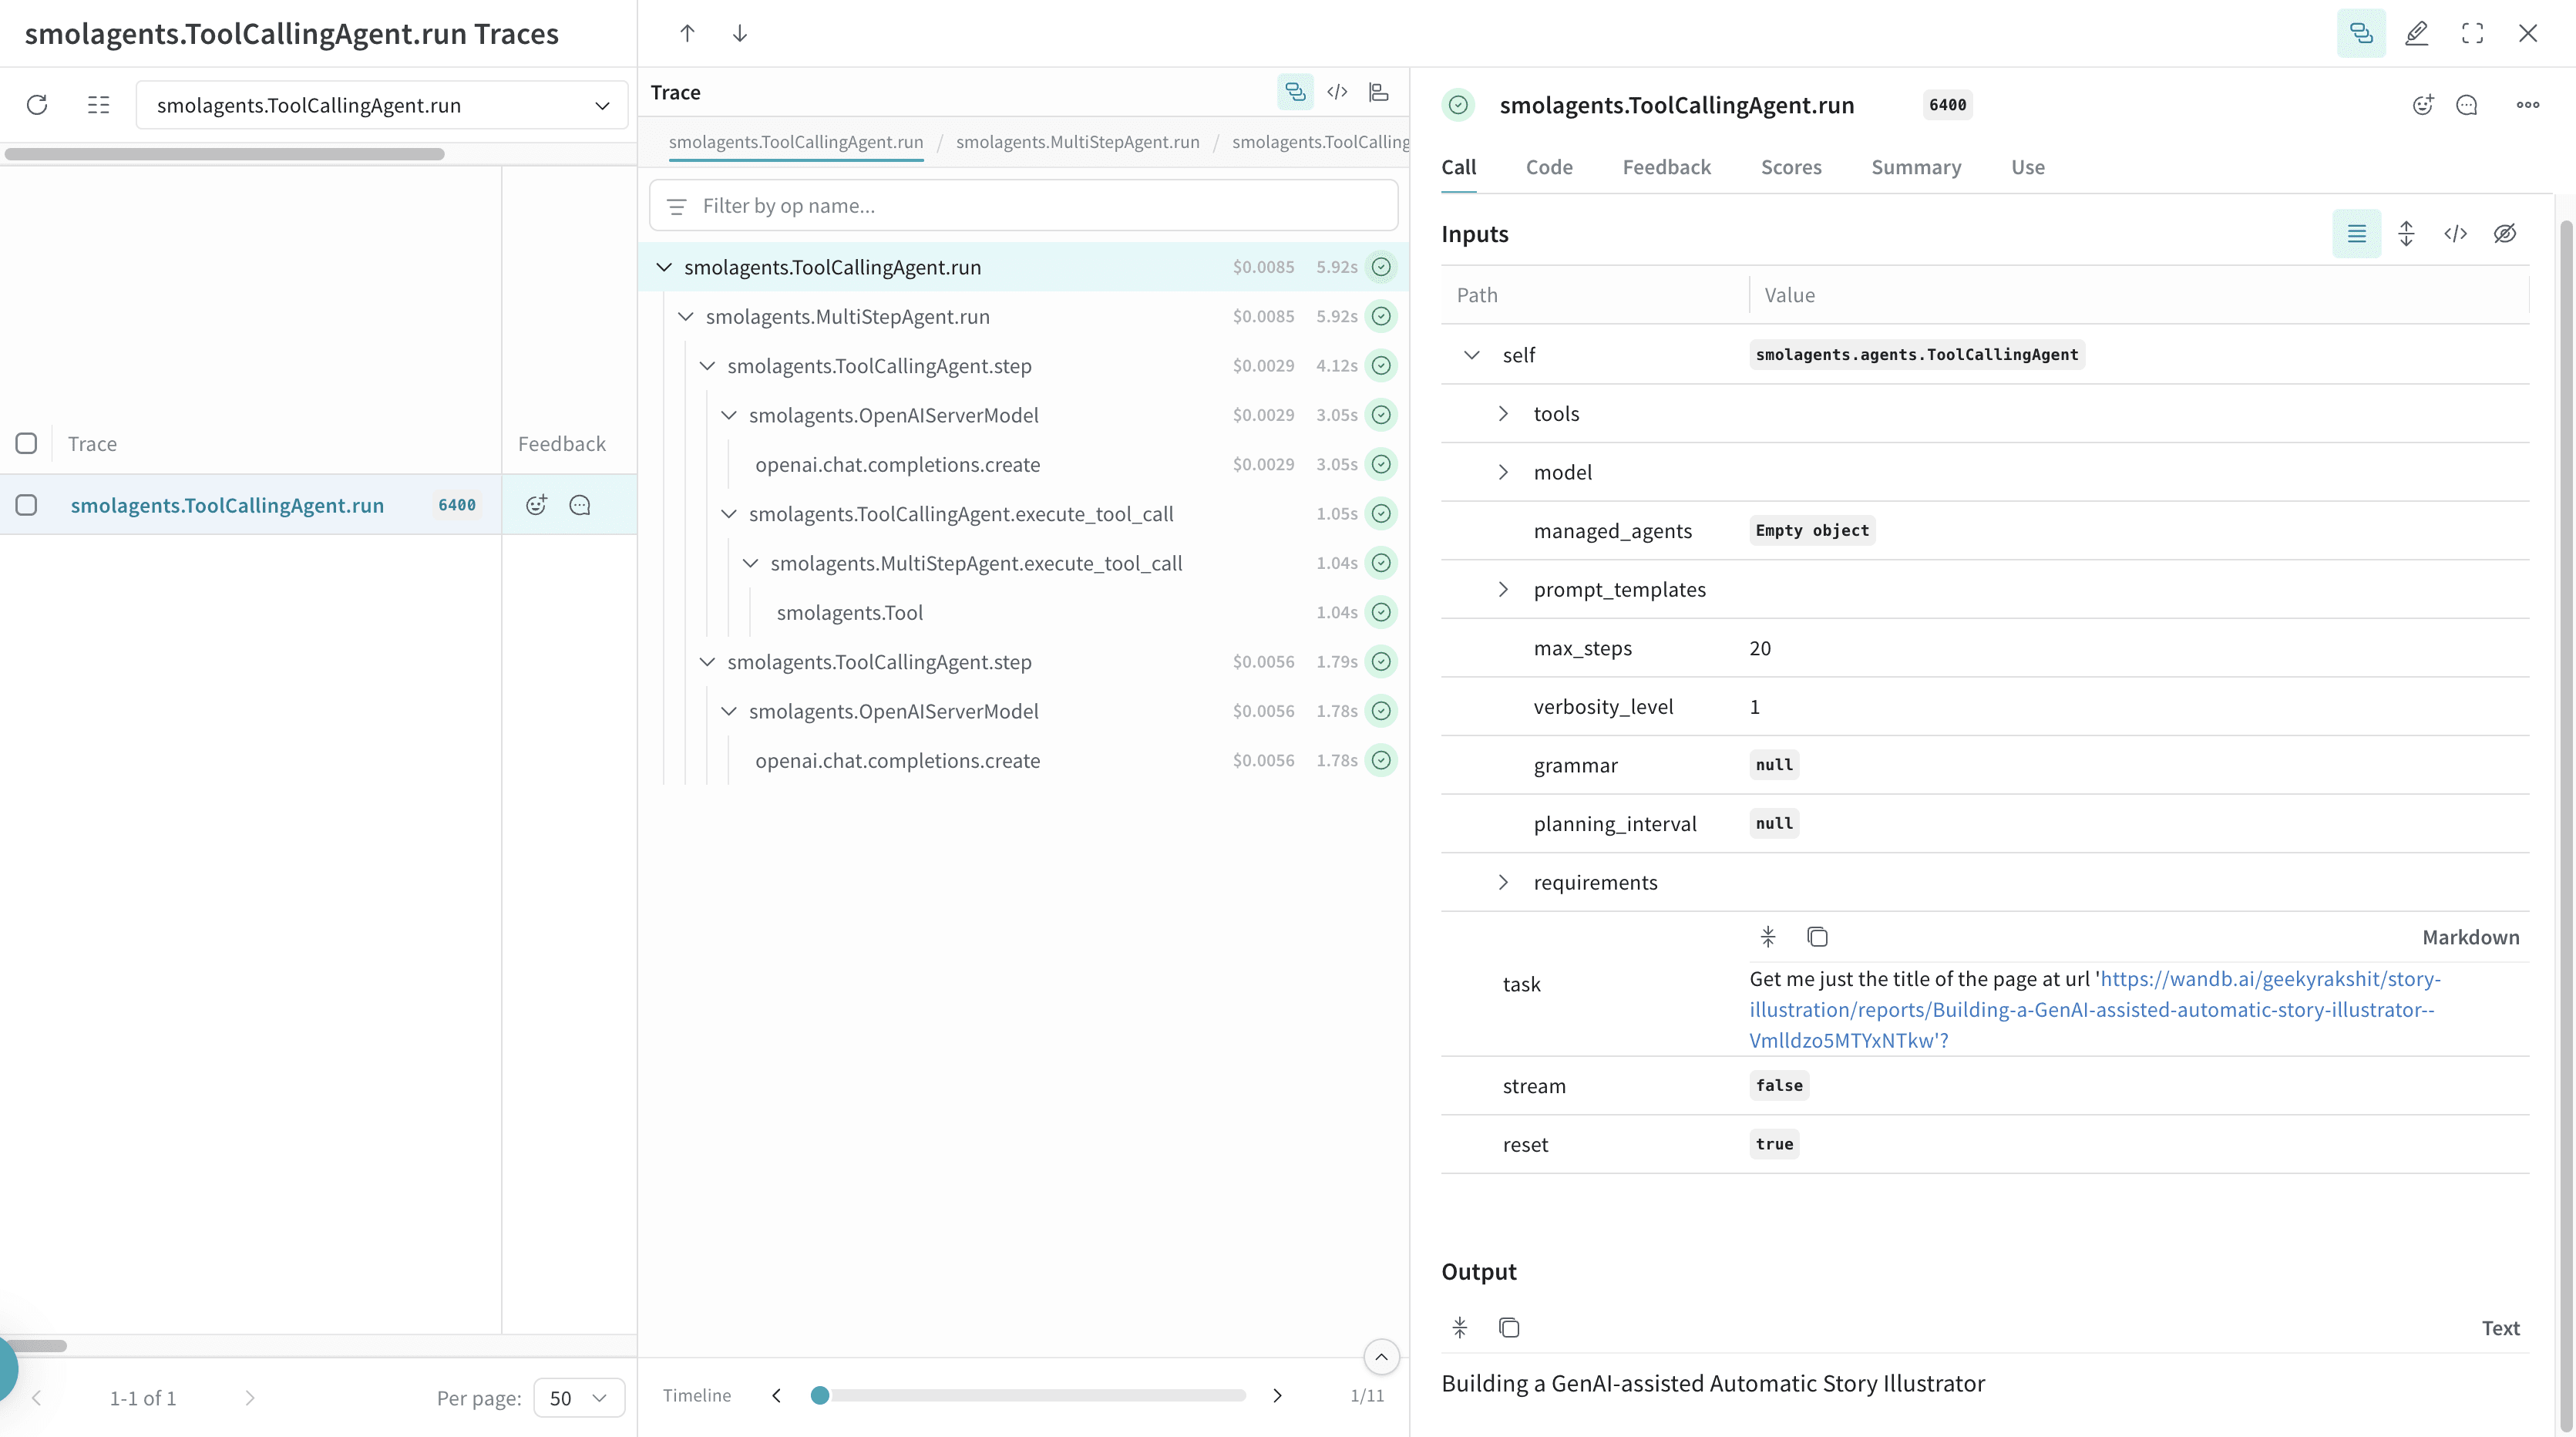
- Weave journalise chaque invocation de fonction et de modèle, que vous pouvez ensuite inspecter dans son interface web.
Après avoir exécuté l’exemple de code, accédez au tableau de bord de votre projet Weave pour consulter les traces.
Outre les outils intégrés, vous pouvez enrichir vos agents avec des outils personnalisés et faire en sorte que Weave trace également ces appels.
Vous pouvez déclarer des outils personnalisés pour vos flux de travail agentiques en décorant une fonction avec @tool de smolagents ou en héritant de la classe smolagents.Tool.
Weave suit automatiquement les appels d’outils personnalisés dans vos flux de travail Smolagents. L’exemple suivant montre comment journaliser avec Weave un appel d’outil Smolagents personnalisé :
- Vous définissez une fonction personnalisée
get_weather et la décorez avec @tool de Smolagents, ce qui permet à l’agent de l’appeler au cours de son processus de raisonnement.
- La fonction accepte un emplacement et un indicateur facultatif pour obtenir une sortie en degrés Celsius.
- Vous instanciez un modèle de langage à l’aide de
OpenAIServerModel.
- Vous créez un
ToolCallingAgent avec l’outil personnalisé et le modèle.
- Lorsque l’agent exécute la requête, il sélectionne et appelle l’outil
get_weather.
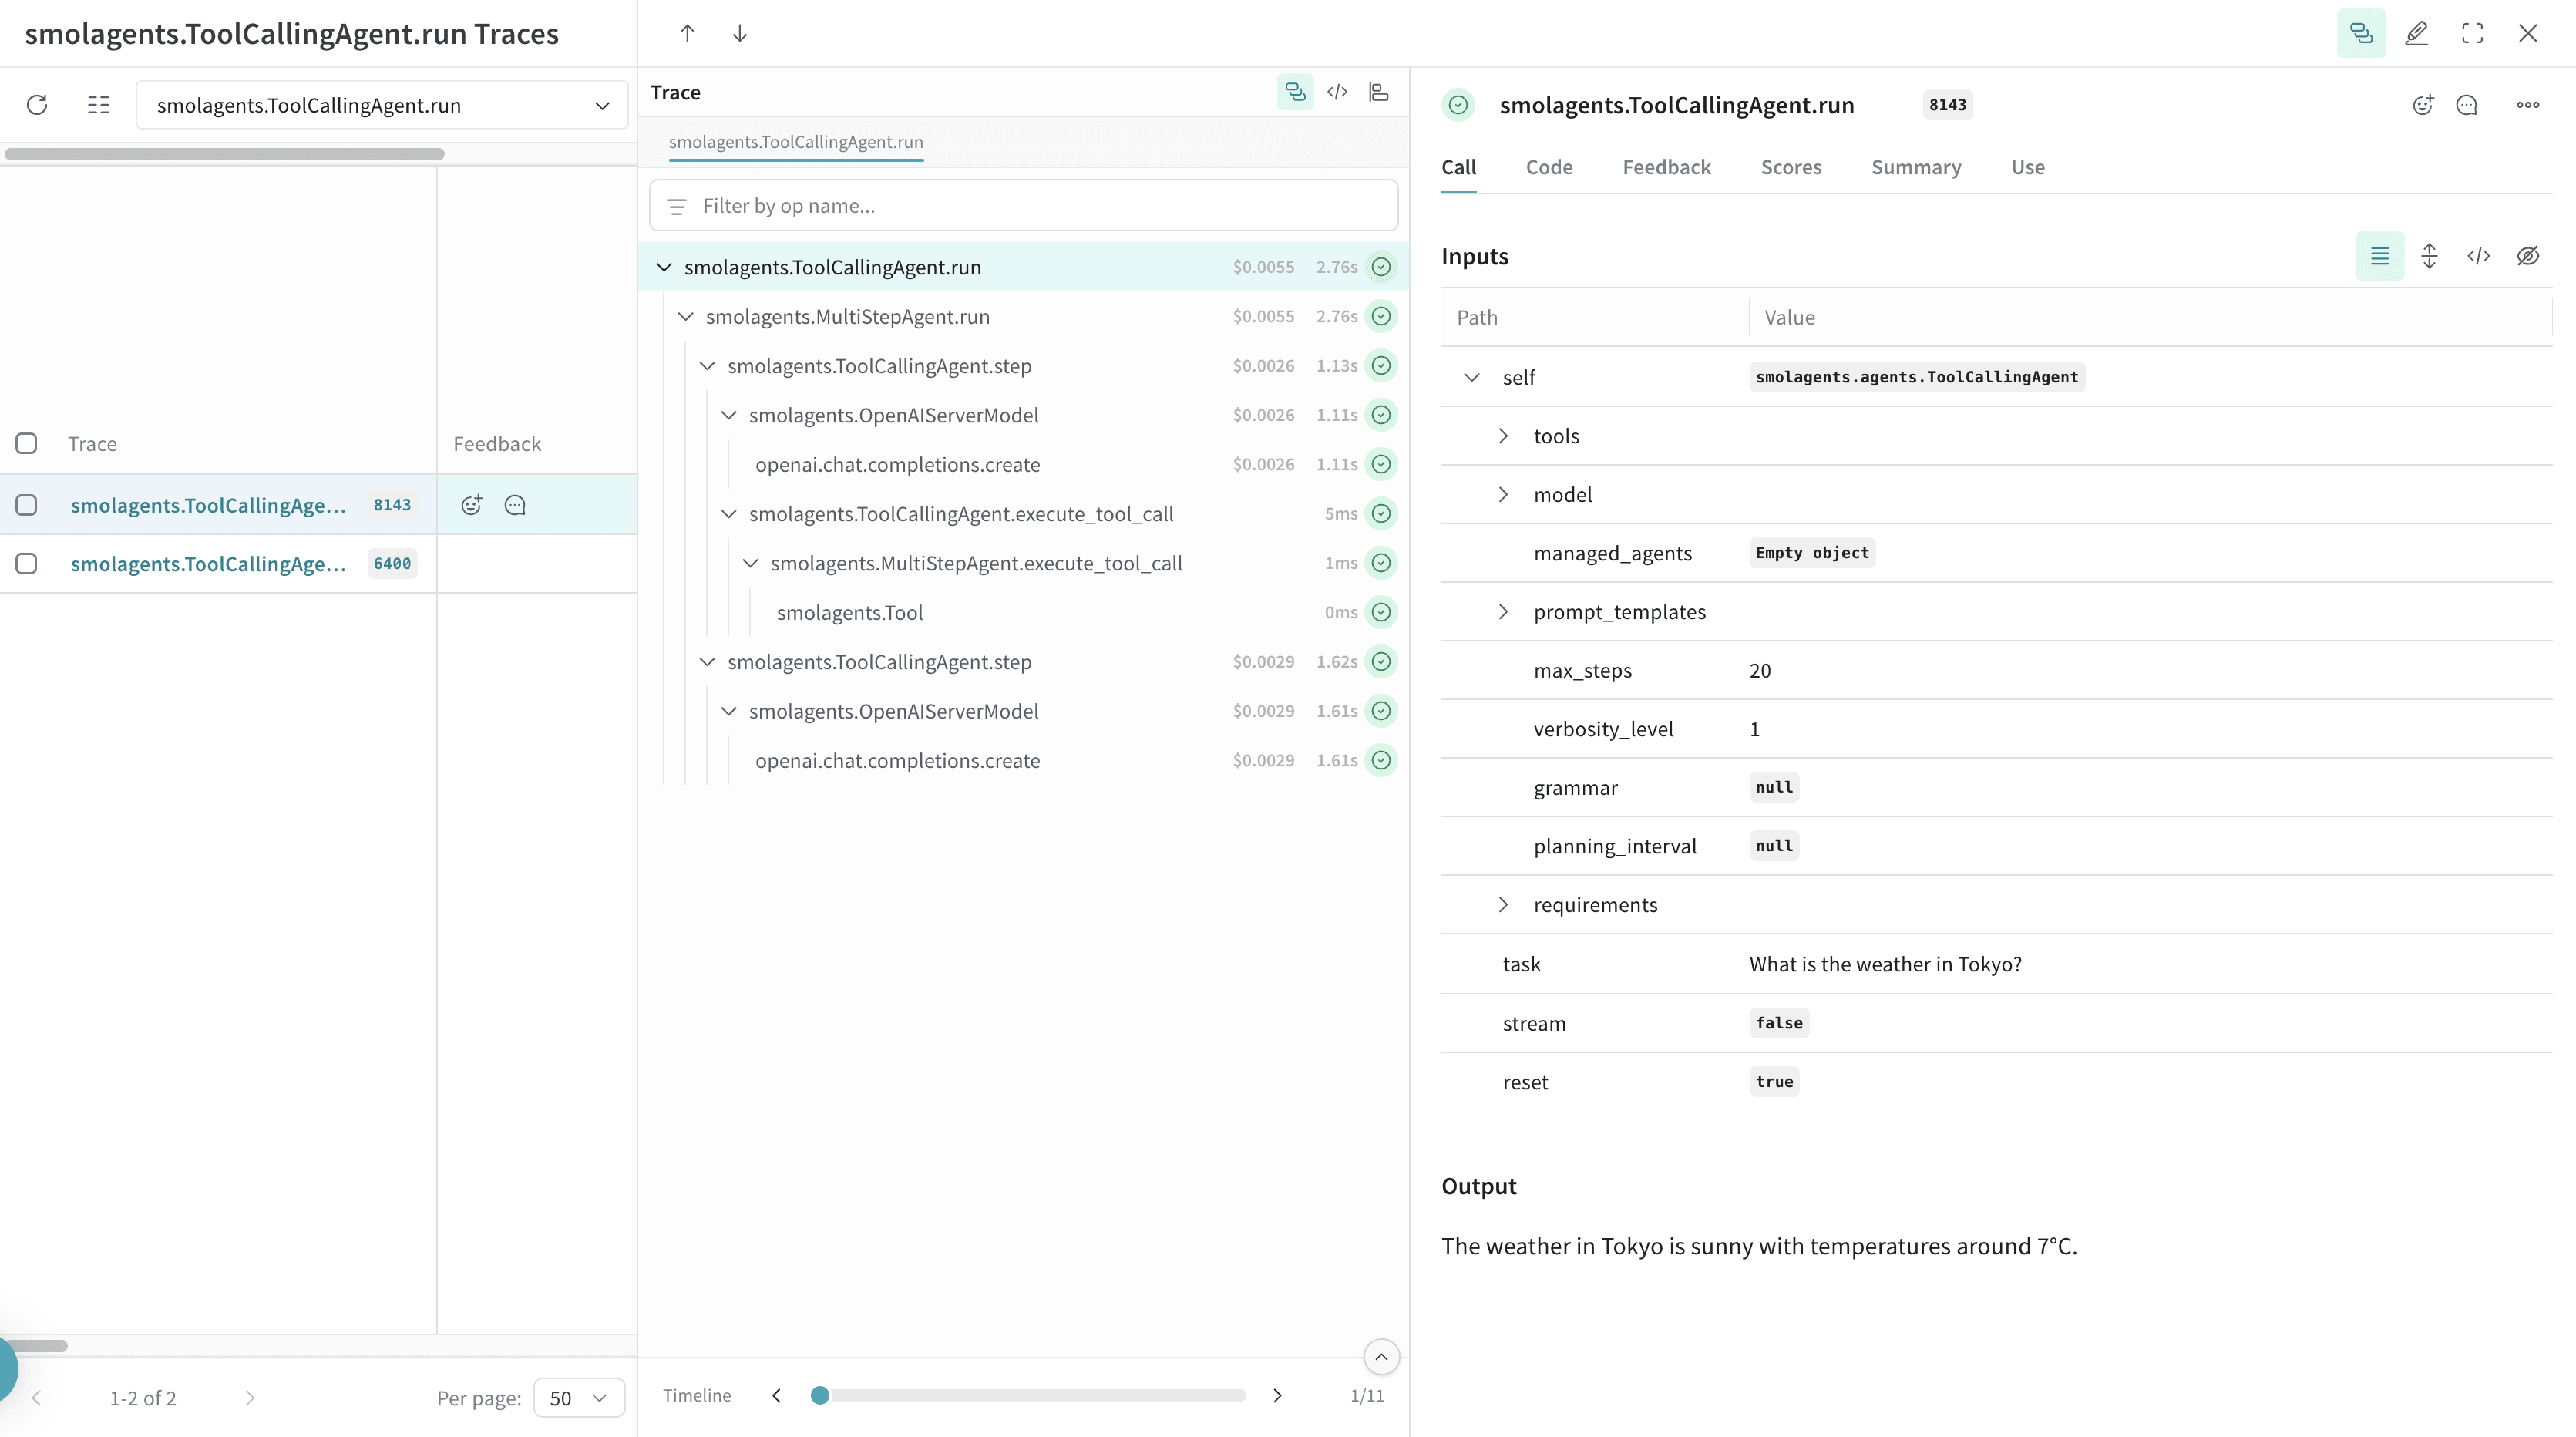
- Weave journalise à la fois l’inférence du modèle et l’invocation de l’outil personnalisé, y compris les arguments et les valeurs de retour.
Après avoir exécuté l’exemple de code, accédez au tableau de bord de votre projet Weave pour consulter les traces.