Ce guide explique comment utiliser Weave pour tracer, déboguer et évaluer des applications LlamaIndex. Vous y découvrirez comment Weave capture automatiquement les appels effectués via la bibliothèque Python LlamaIndex, afin de surveiller les pipelines RAG, les étapes des agents et les appels LLM sans écrire de code de journalisation personnalisé. Ce guide s’adresse aux développeurs qui créent des applications LLM avec LlamaIndex et souhaitent gagner en visibilité sur leurs flux de travail pour le débogage, l’analyse des performances et l’évaluation.
Lorsque vous travaillez avec des LLM, le débogage est inévitable. Qu’un appel de modèle échoue, qu’une sortie soit mal formatée ou que des appels de modèle imbriqués sèment la confusion, localiser les problèmes peut s’avérer difficile. Les applications LlamaIndex comportent souvent plusieurs étapes et de nombreux appels LLM, d’où l’importance de comprendre le fonctionnement interne de vos chaînes et de vos agents.
Weave simplifie ce processus en capturant automatiquement les traces de vos applications LlamaIndex. Vous pouvez ainsi surveiller et analyser les performances de votre application, afin de déboguer et d’optimiser vos flux de travail LLM. Weave vous accompagne également dans vos flux de travail d’évaluation.
Premiers pas
Pour commencer, appelez weave.init() au début de votre script. Cette fonction initialise Weave et lance la capture des traces de tous les appels LlamaIndex effectués ensuite. L’argument passé à weave.init() est un nom de projet qui vous permet d’organiser vos traces.
L’exemple précédent crée un moteur de chat LlamaIndex de base qui effectue, en interne, un appel OpenAI. Une fois ce code exécuté, Weave capture une trace de l’exécution du moteur de chat, que vous pouvez examiner dans l’interface web de Weave. Voir la trace suivante :
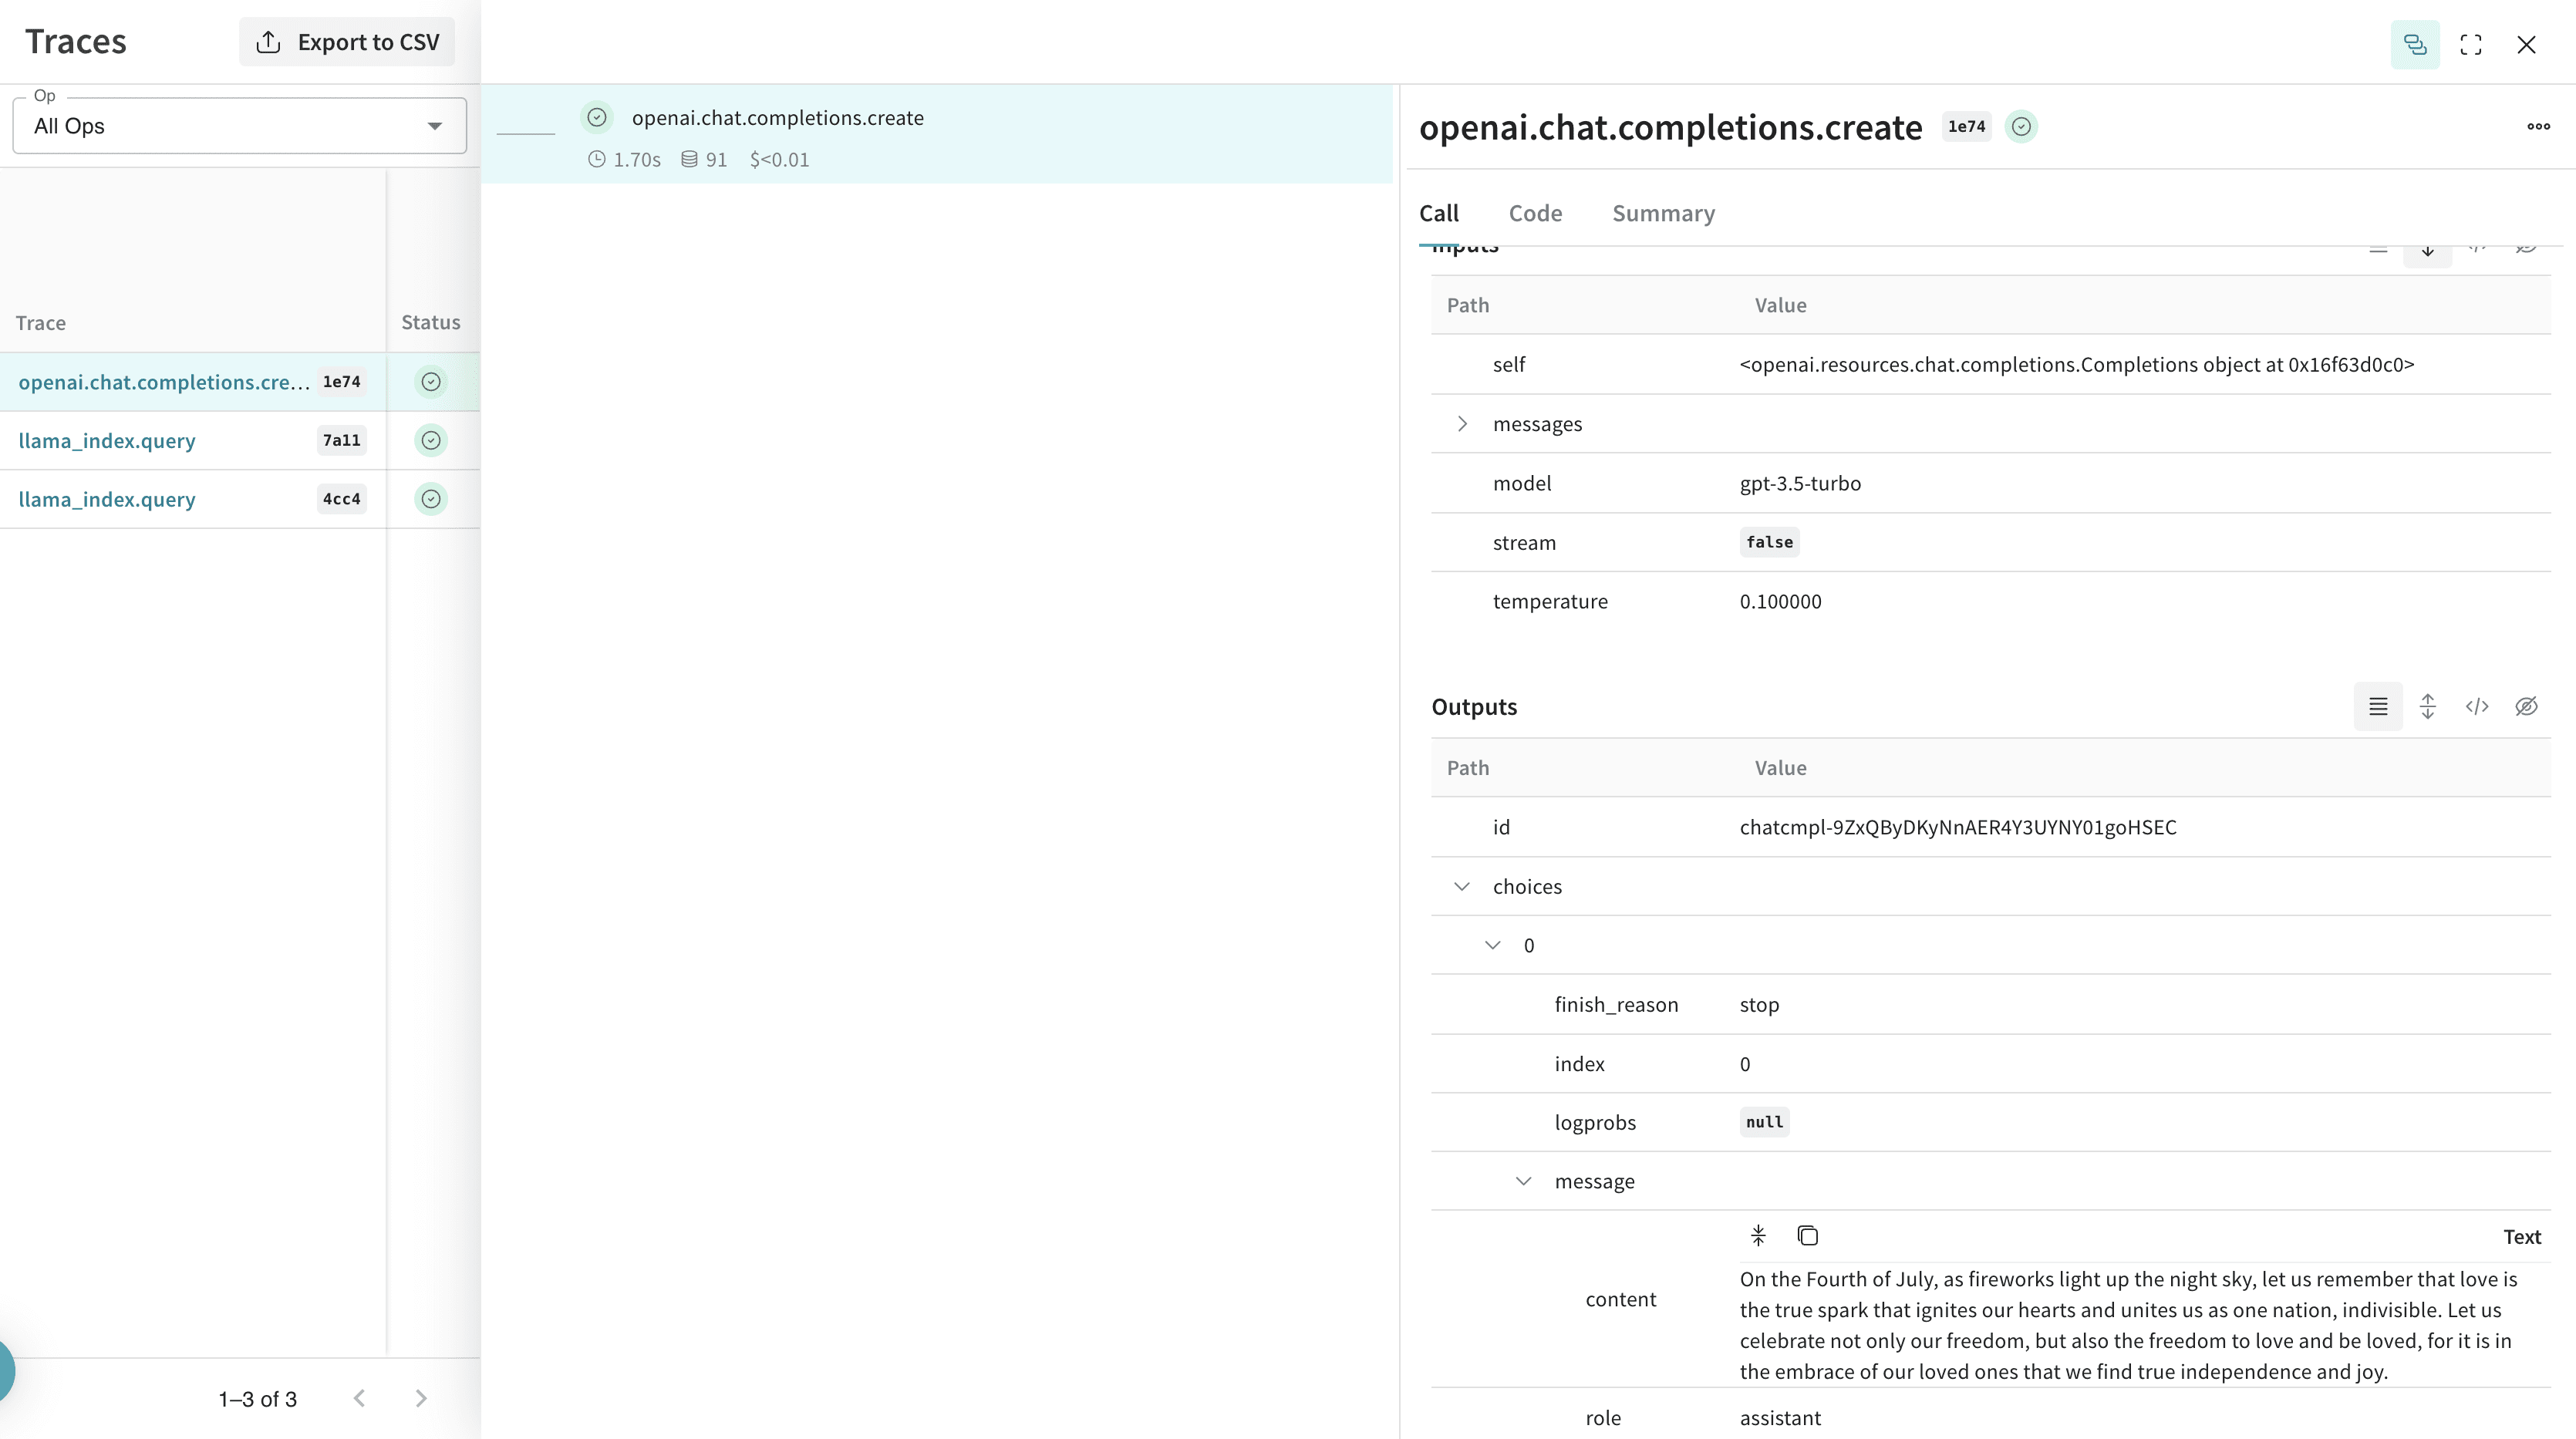
Traces
Cette section explique comment Weave capture les flux de travail LlamaIndex en plusieurs étapes, comme les pipelines RAG.
LlamaIndex est réputé pour la facilité avec laquelle il permet de connecter des données à des LLM. Une application RAG de base nécessite une étape d’embedding, une étape de récupération et une étape de synthèse de la réponse. À mesure que la complexité augmente, il devient essentiel de stocker les traces de chaque étape dans une base de données centralisée, aussi bien pendant le développement qu’en production.
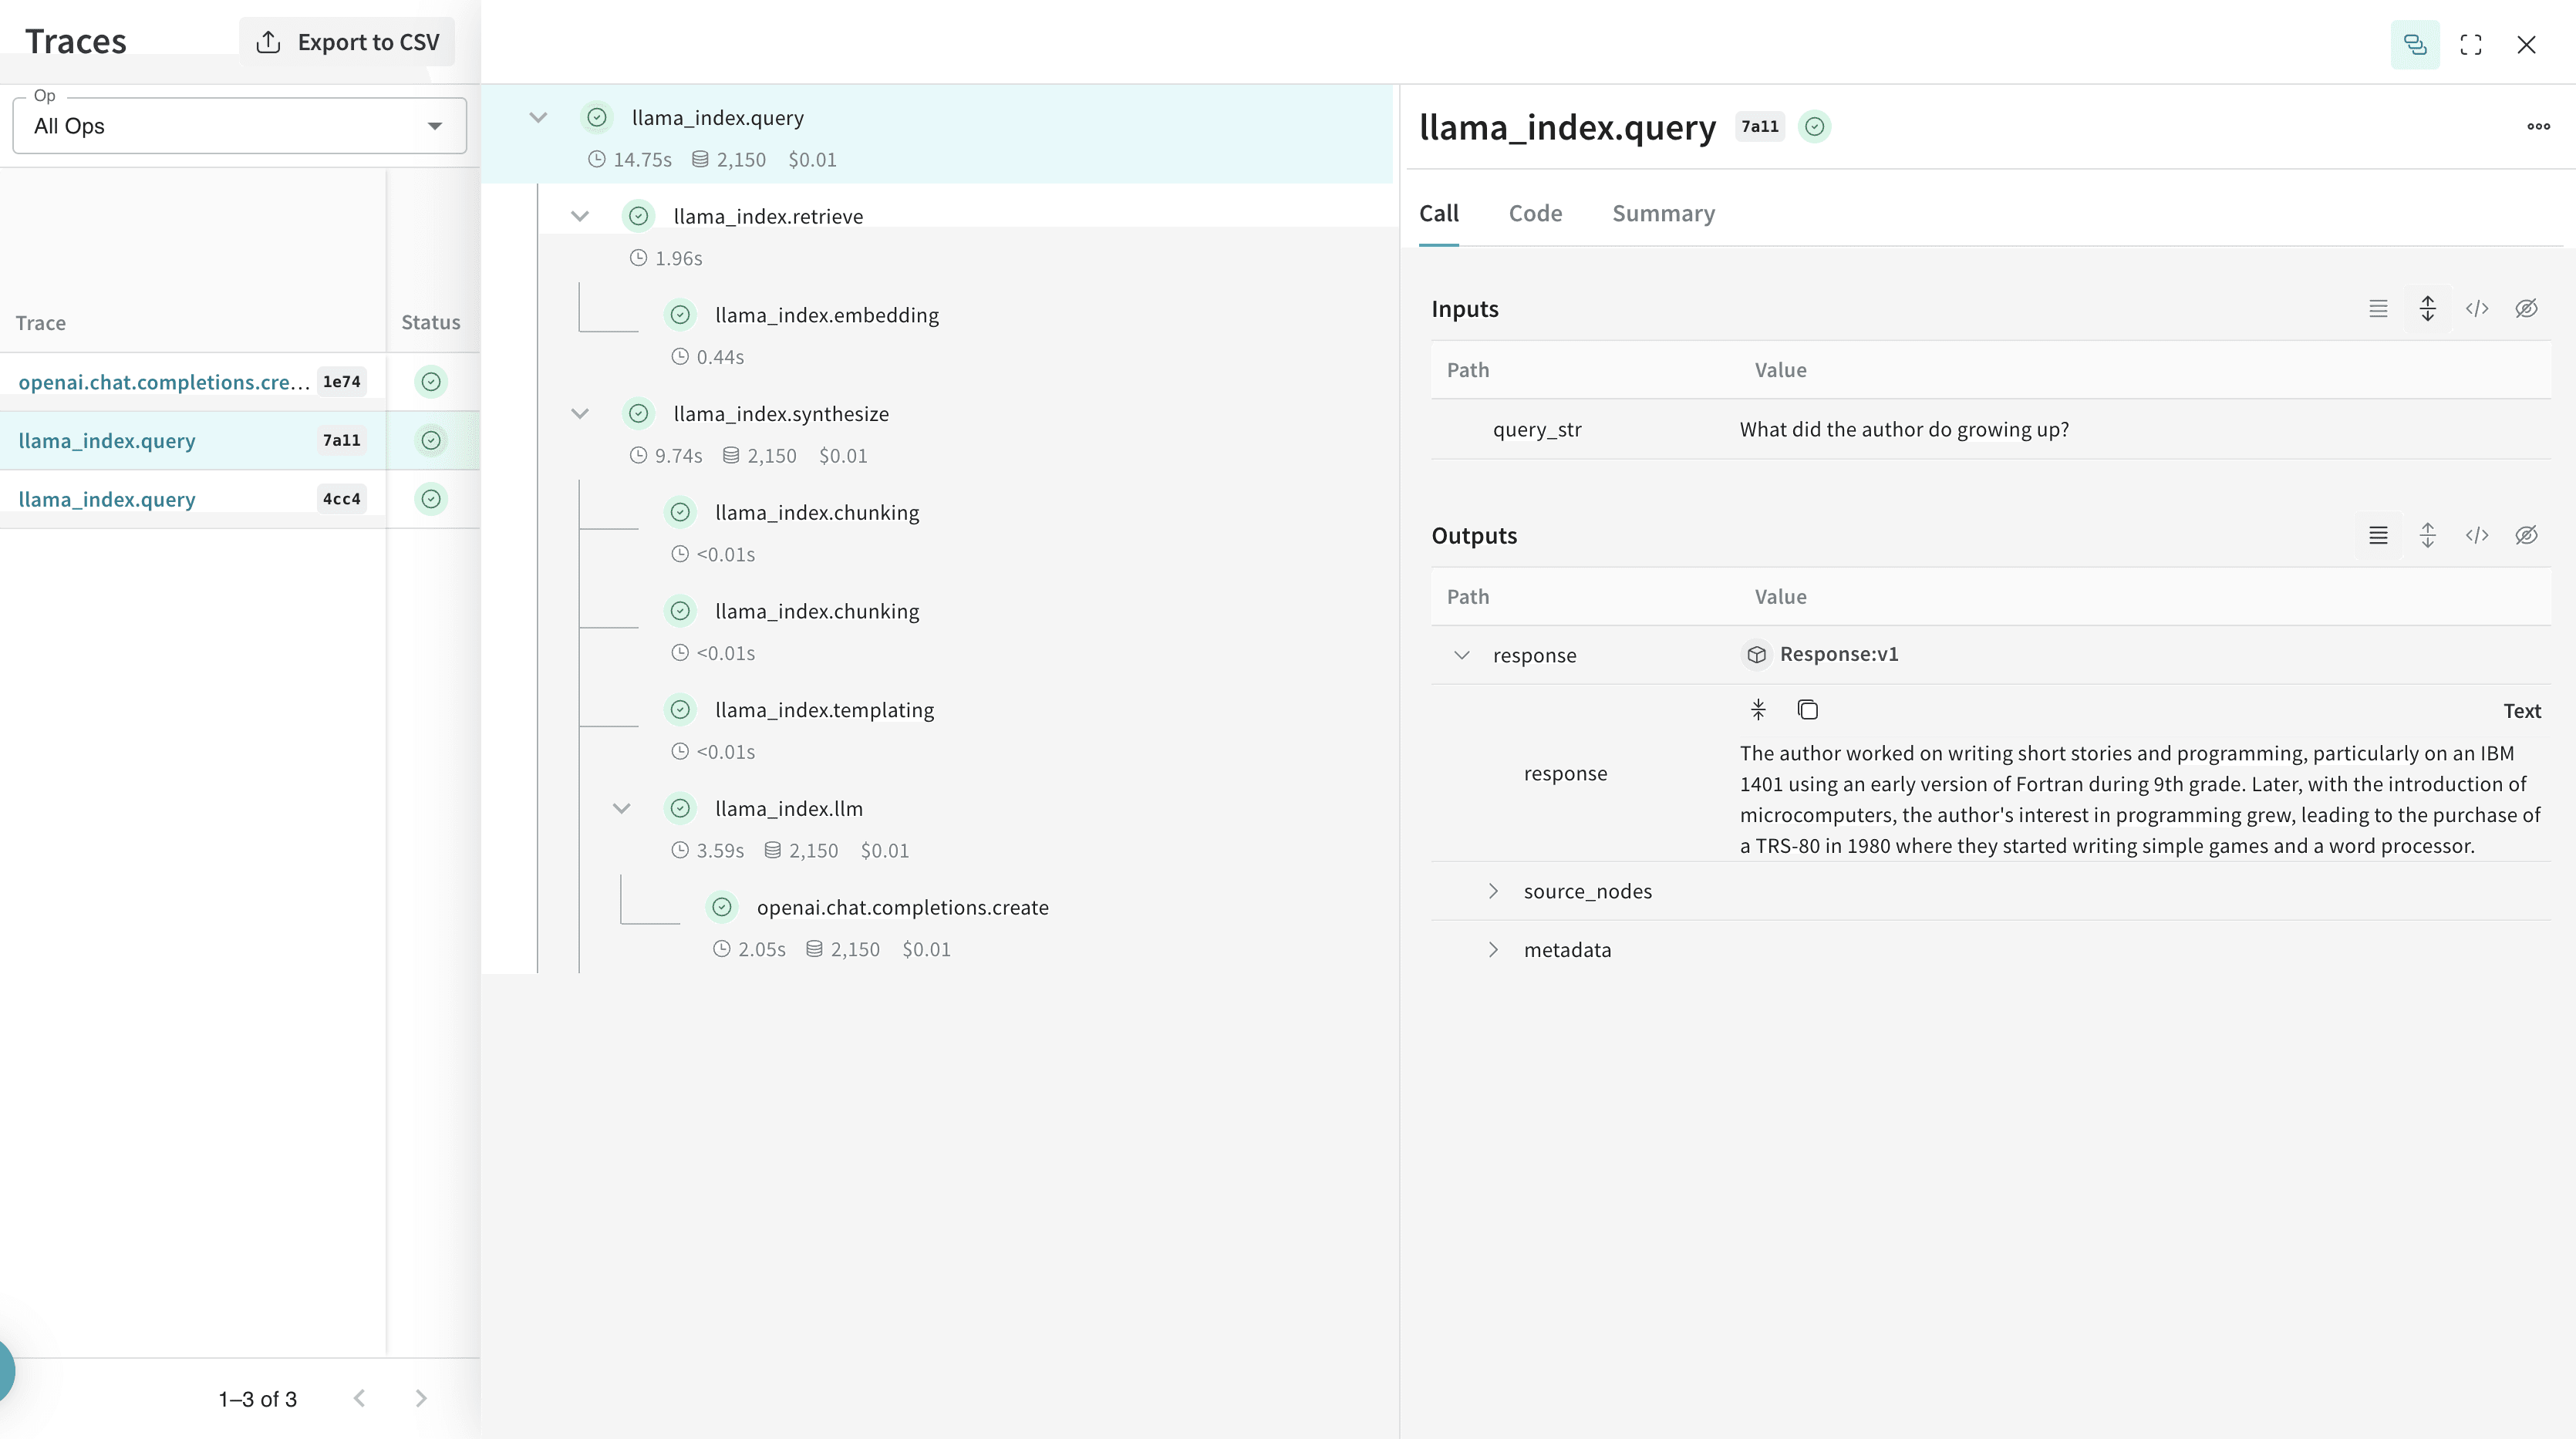
Ces traces sont indispensables pour déboguer et améliorer votre application. Weave suit automatiquement tous les appels effectués via la bibliothèque LlamaIndex, y compris les modèles de prompt, les appels LLM, les outils et les étapes d’agent. Vous pouvez consulter les traces dans l’interface web de Weave.
L’exemple suivant présente un pipeline RAG de base tiré du Starter Tutorial (OpenAI) de LlamaIndex :
La chronologie de la trace enregistre non seulement les « événements », mais aussi le temps d’exécution, le coût et le nombre de jetons, le cas échéant. Explorez la trace en détail pour afficher les entrées et les sorties de chaque étape.
Observabilité en un clic
Cette section explique comment l’intégration Weave se connecte au système d’observabilité intégré de LlamaIndex, ce qui vous évite de configurer les gestionnaires manuellement.
LlamaIndex propose une observabilité en un clic qui vous permet de créer des applications LLM rigoureuses en environnement de production.
L’intégration Weave s’appuie sur cette fonctionnalité de LlamaIndex et affecte automatiquement WeaveCallbackHandler() à llama_index.core.global_handler. En tant qu’utilisateur de LlamaIndex et de Weave, il vous suffit d’initialiser un run Weave avec weave.init([NAME_OF_PROJECT]).
Créer un Model pour faciliter l’expérimentation
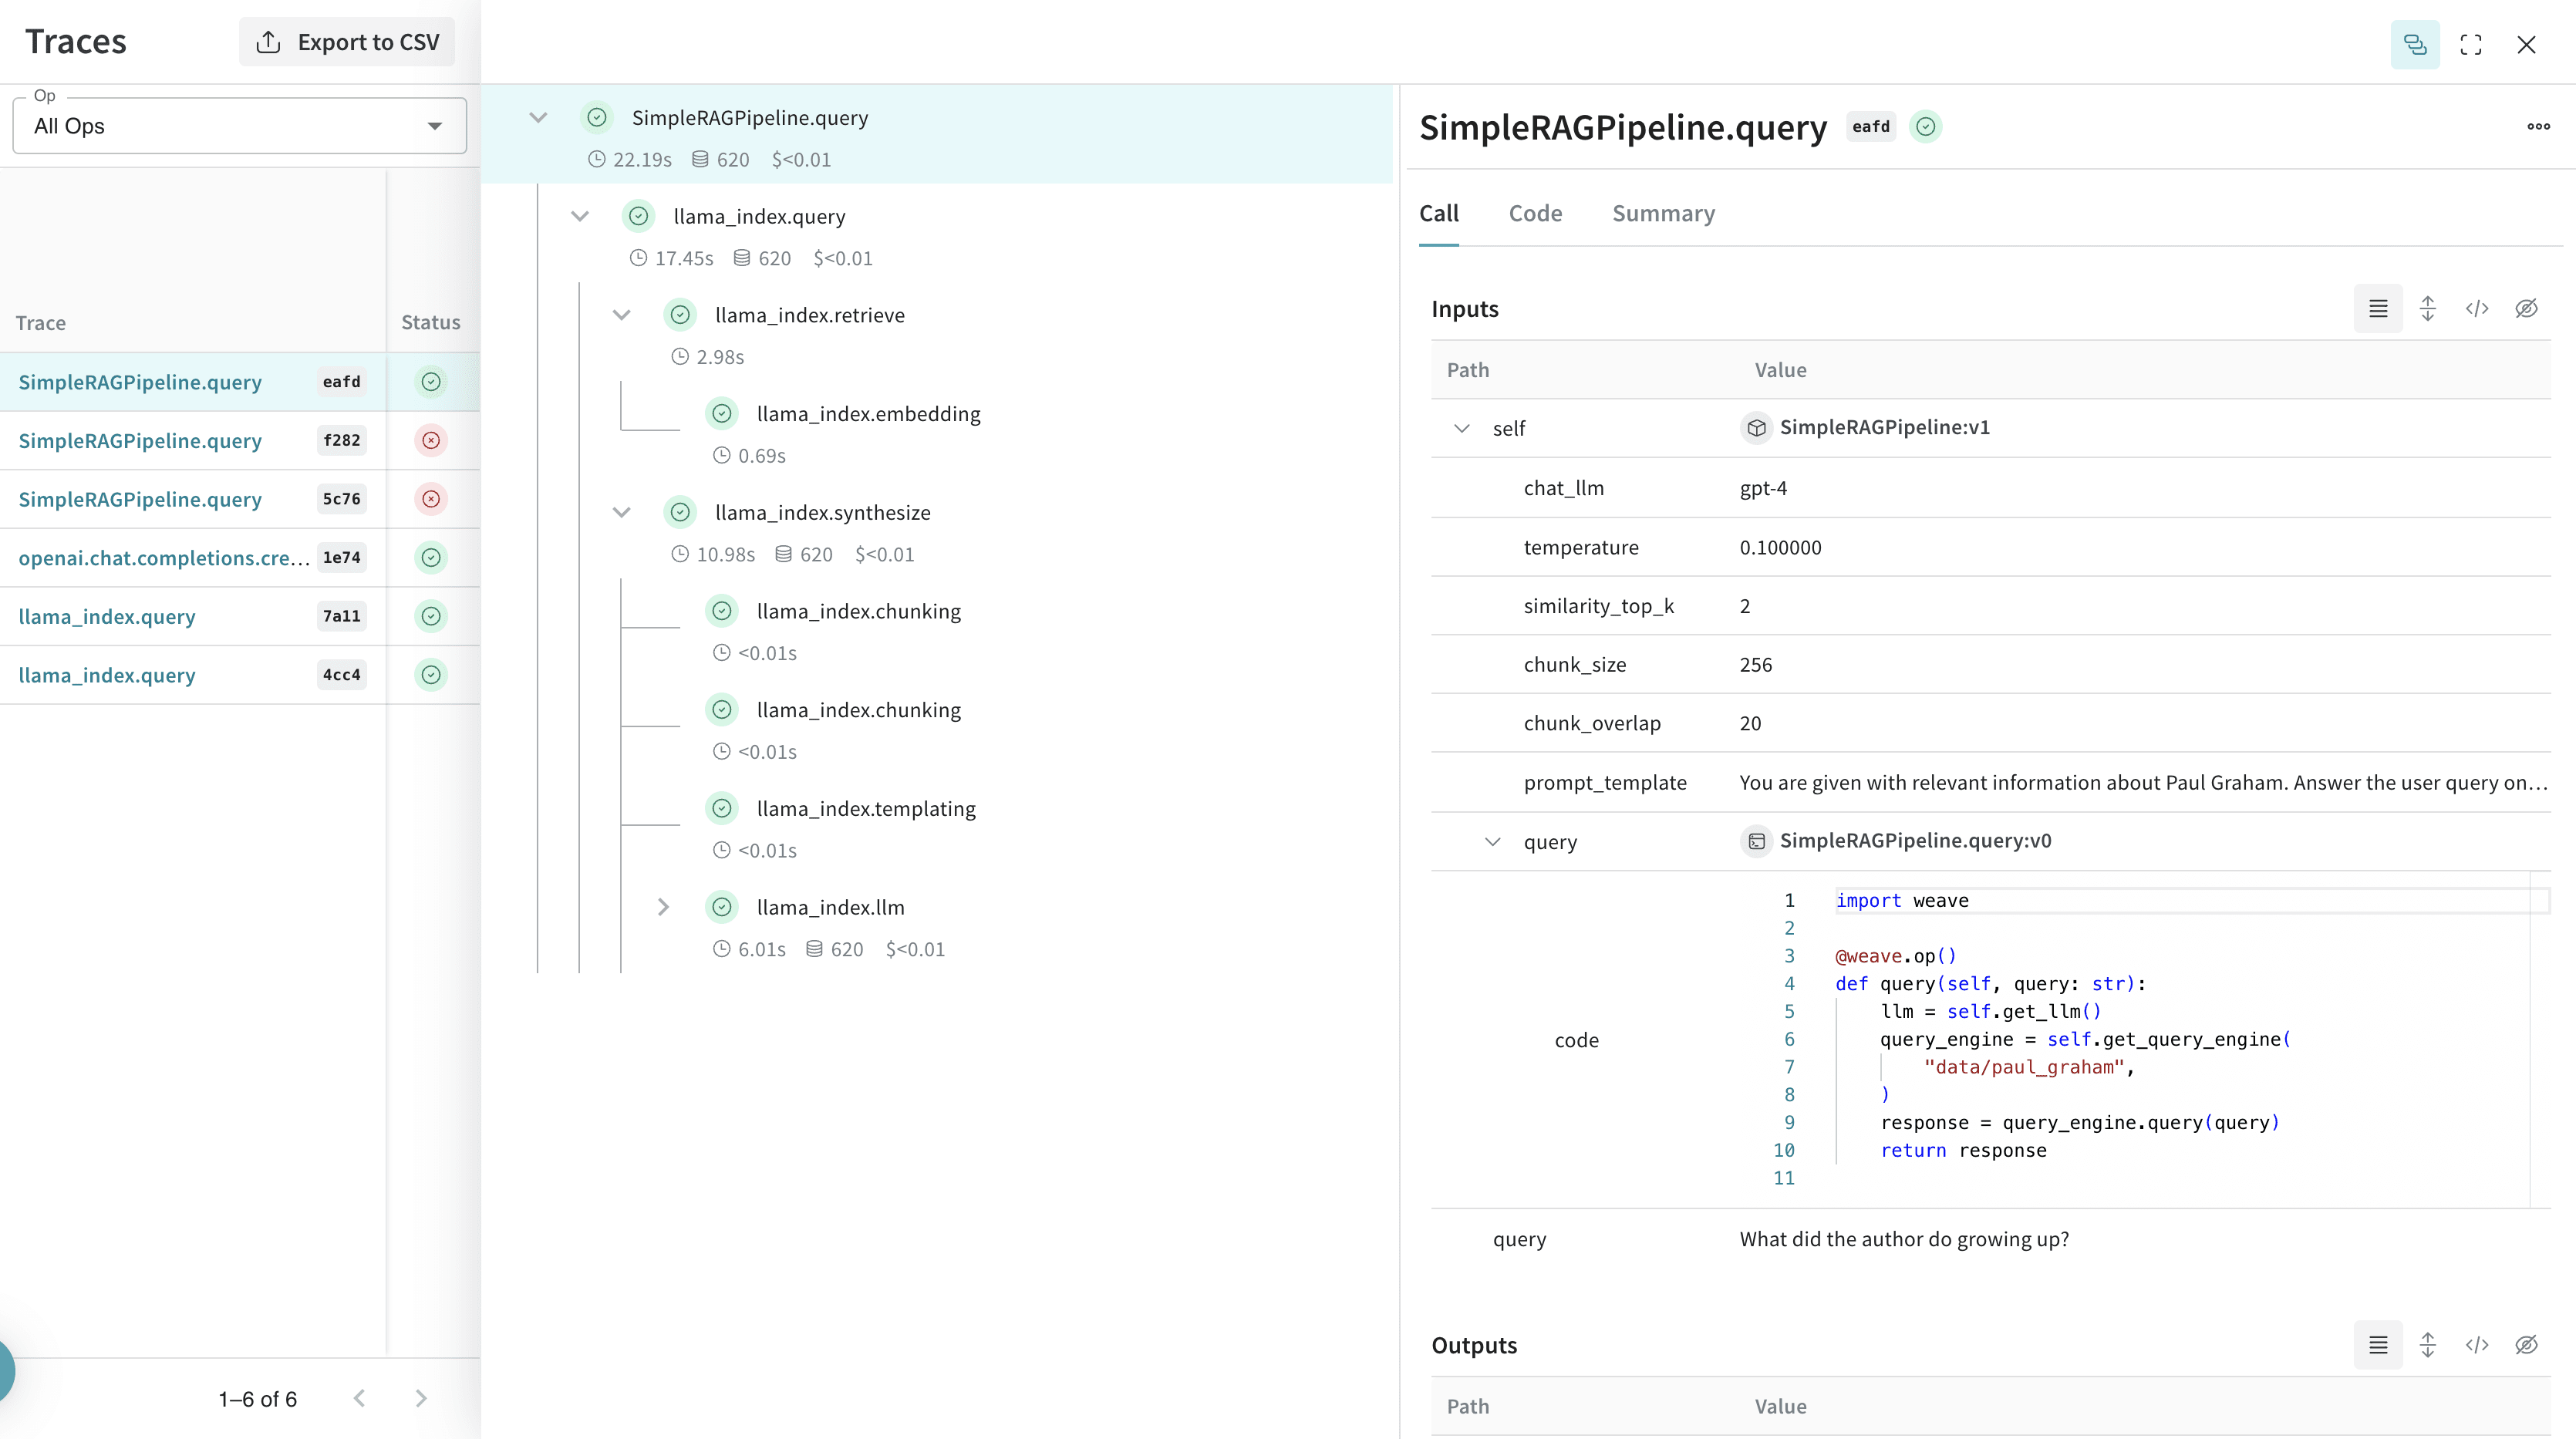
Organiser et évaluer des LLM au sein d’applications destinées à divers cas d’usage s’avère complexe lorsque vous manipulez plusieurs composants, tels que des prompts, des configurations de modèle et des paramètres d’inférence. Avec weave.Model, vous pouvez capturer et organiser les détails de vos expériences, comme les prompts système ou les modèles utilisés, ce qui facilite la comparaison entre différentes itérations.
L’exemple suivant montre comment créer un moteur de requête LlamaIndex dans un WeaveModel, à partir des données disponibles dans le dossier weave/data :
La classe SimpleRAGPipeline, sous-classe de weave.Model, regroupe les paramètres importants de ce pipeline RAG. Le fait de décorer la méthode query avec weave.op() active le traçage. Grâce à cette structure, vous pouvez désormais versionner, comparer et évaluer différentes configurations de votre pipeline RAG dans Weave.
Évaluez avec weave.Evaluation
Cette section explique comment mesurer les performances de votre modèle sur un dataset fixe afin de comparer vos itérations de manière quantitative.
Les évaluations vous permettent de mesurer les performances de vos applications. La classe weave.Evaluation vous permet de capturer les performances de votre modèle sur des tâches ou des datasets spécifiques, et ainsi de comparer différents modèles et différentes itérations de votre application. L’exemple suivant montre comment évaluer le modèle créé dans la section précédente :
Cette évaluation reprend l’exemple de la section précédente. Pour évaluer avec weave.Evaluation, vous avez besoin d’un dataset d’évaluation, d’une fonction de scorer et d’un weave.Model. Ces trois composants clés doivent respecter les exigences suivantes :
- Les clés des dicts d’échantillons d’évaluation doivent correspondre aux arguments de la fonction de scorer et de la méthode
predict du weave.Model.
- Le
weave.Model doit disposer d’une méthode nommée predict, infer ou forward. Vous devez décorer cette méthode avec weave.op() pour permettre le traçage.
- La fonction de scorer doit être décorée avec
weave.op() et accepter output comme argument nommé.
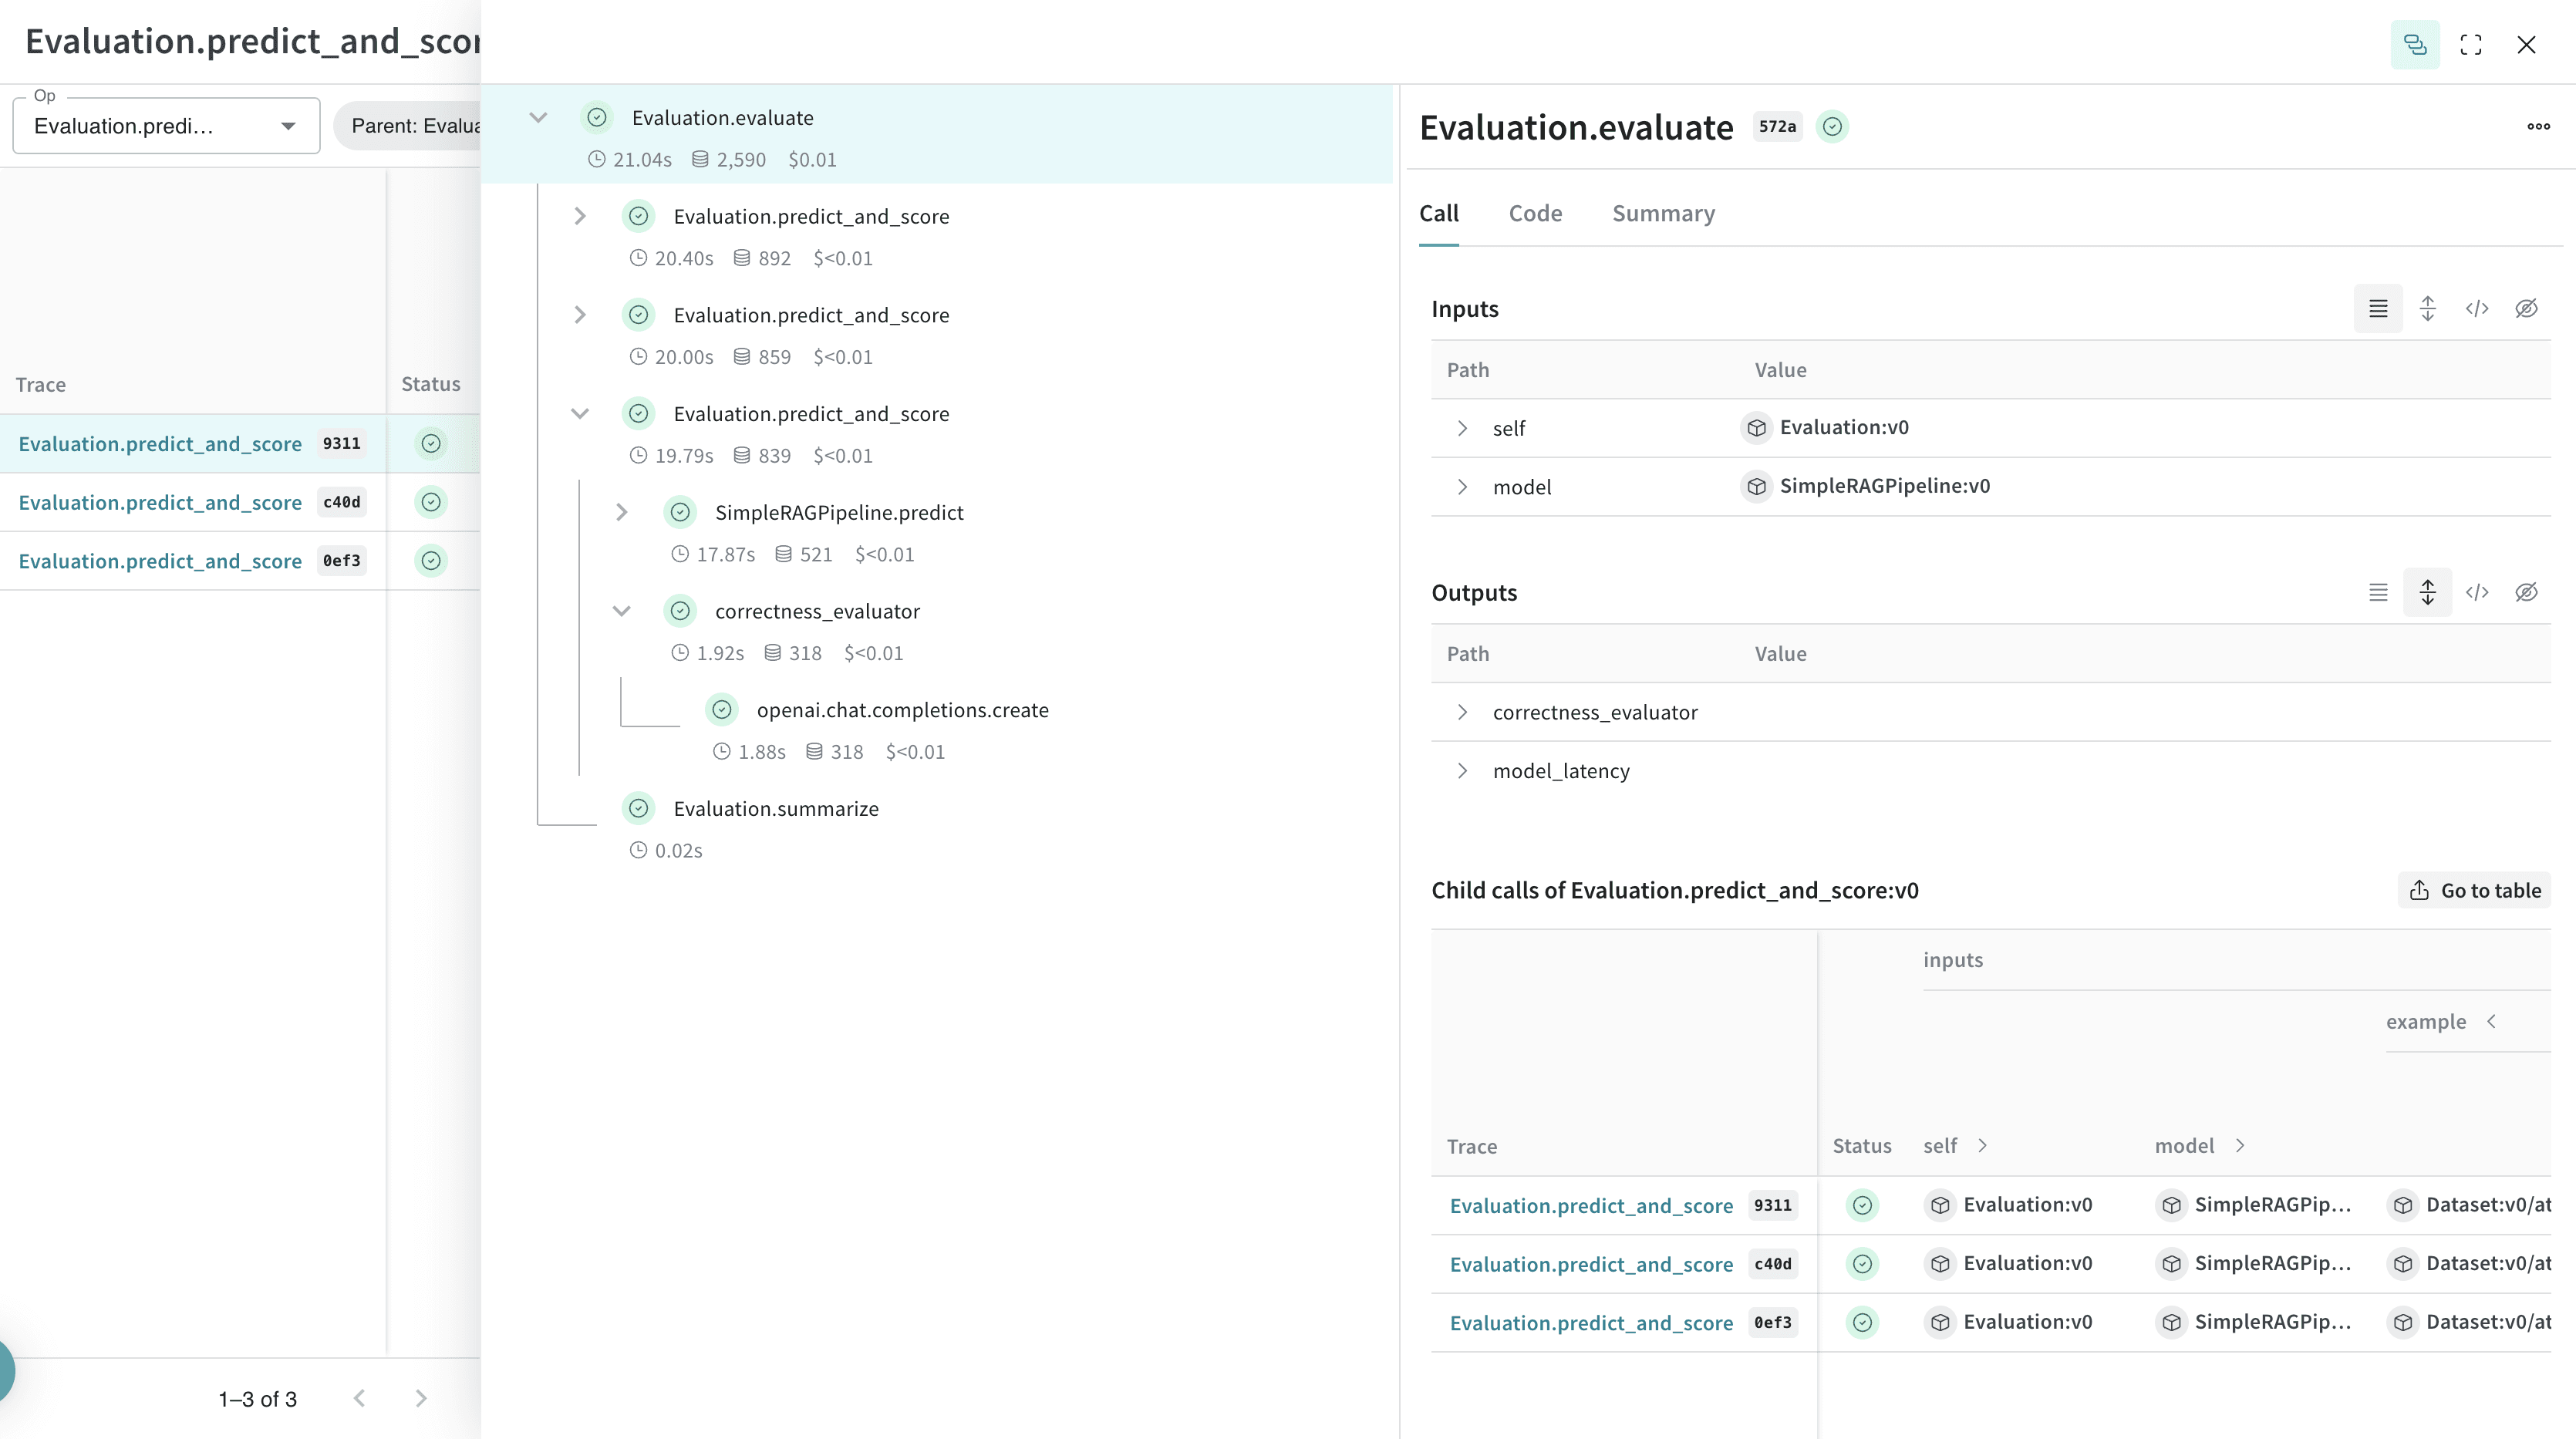 En intégrant Weave à LlamaIndex, vous bénéficiez d’une journalisation et d’une surveillance complètes de vos applications LLM. L’évaluation facilite ainsi le débogage et l’optimisation des performances.
Dernière modification le 30 septembre 2026

