

 Weave suit et journalise les appels effectués via la bibliothèque Python LangChain.
Lorsque vous travaillez avec des LLM, le débogage fait partie du quotidien. Qu’un appel de modèle échoue, qu’une sortie soit mal formatée ou que des appels de modèle imbriqués prêtent à confusion, il peut être difficile d’identifier précisément l’origine des problèmes. Les applications LangChain comportent souvent plusieurs étapes et de nombreux appels LLM ; il est donc utile de comprendre le fonctionnement interne de vos chaînes et de vos agents.
Weave capture automatiquement les traces de vos applications LangChain. Vous pouvez ainsi surveiller et analyser les performances de votre application, ce qui facilite le débogage et l’optimisation de vos flux de travail LLM.
Ce guide s’adresse aux développeurs qui créent des applications LangChain et souhaitent y ajouter le traçage, l’évaluation et l’observabilité avec Weave. Il explique comment activer le traçage automatique, joindre des métadonnées, contrôler manuellement le traçage et encapsuler des chaînes LangChain sous forme de modèles Weave afin de les évaluer.
Premiers pas
Pour commencer, appelezweave.init() au début de votre script. weave.init() prend en argument un nom de projet, que Weave utilise pour organiser vos traces.
Suivre les métadonnées des appels
Les métadonnées personnalisées vous permettent de filtrer et d’analyser les traces dans l’interface de Weights & Biases. Pour suivre les métadonnées de vos appels LangChain, utilisez le gestionnaire de contexteweave.attributes. Ce gestionnaire de contexte vous permet de définir des métadonnées personnalisées pour un bloc de code précis, comme une chaîne ou une requête individuelle.
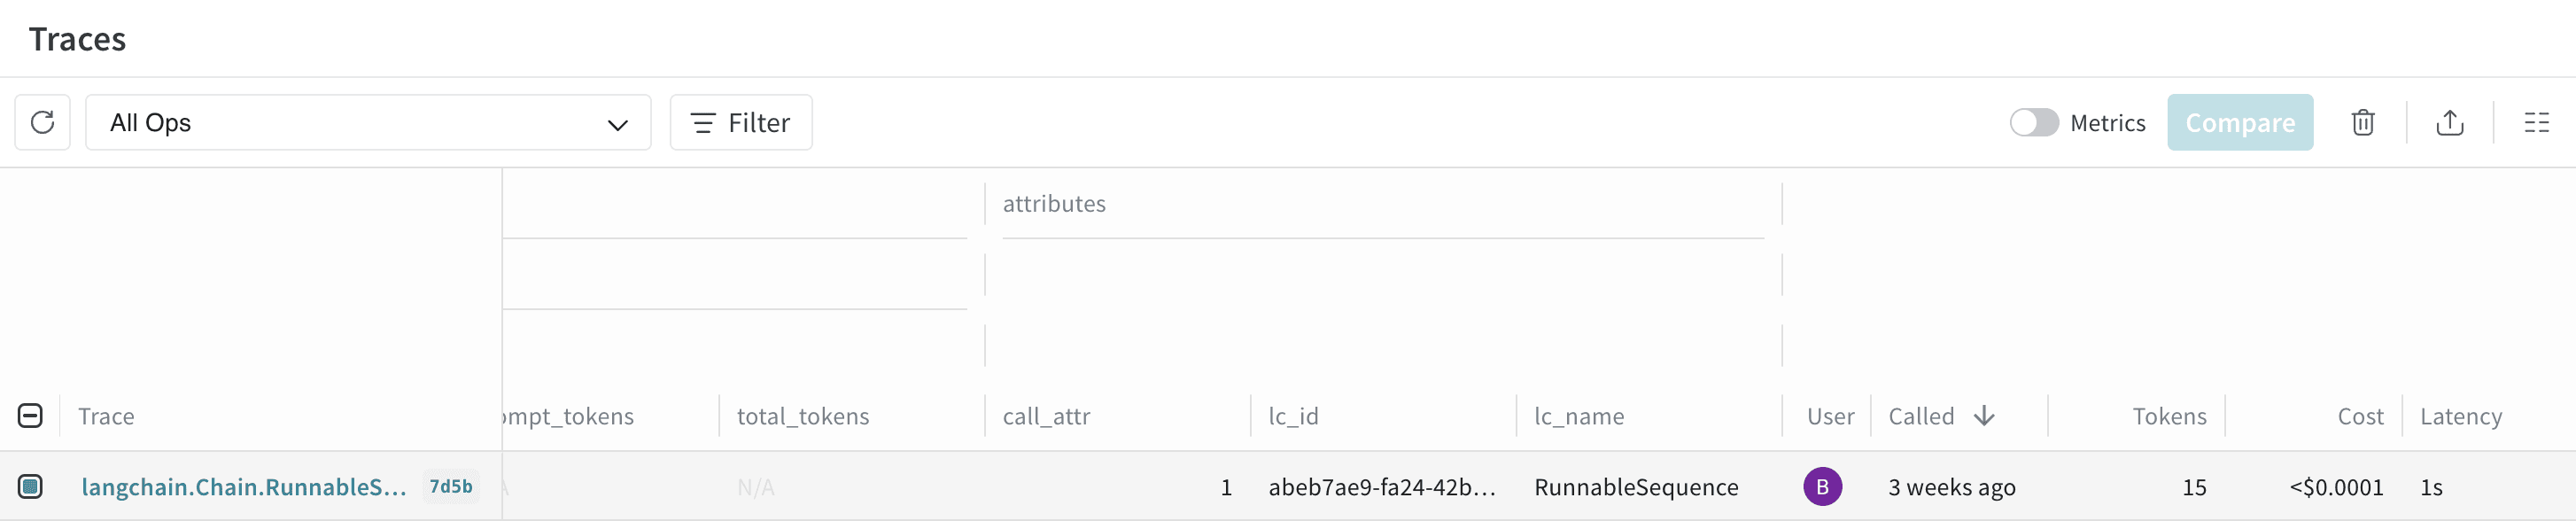
Traces
Stocker les traces de vos applications LLM dans une base de données centralisée s’avère utile aussi bien en développement qu’en production. Ces traces constituent un jeu de données qui vous permet de déboguer et d’améliorer votre application. Weave capture automatiquement les traces de vos applications LangChain. Weave suit et journalise les appels effectués via la bibliothèque LangChain, notamment les modèles de prompt, les chaînes, les appels LLM, les outils et les étapes des agents. Vous pouvez consulter les traces dans l’interface web de Weave.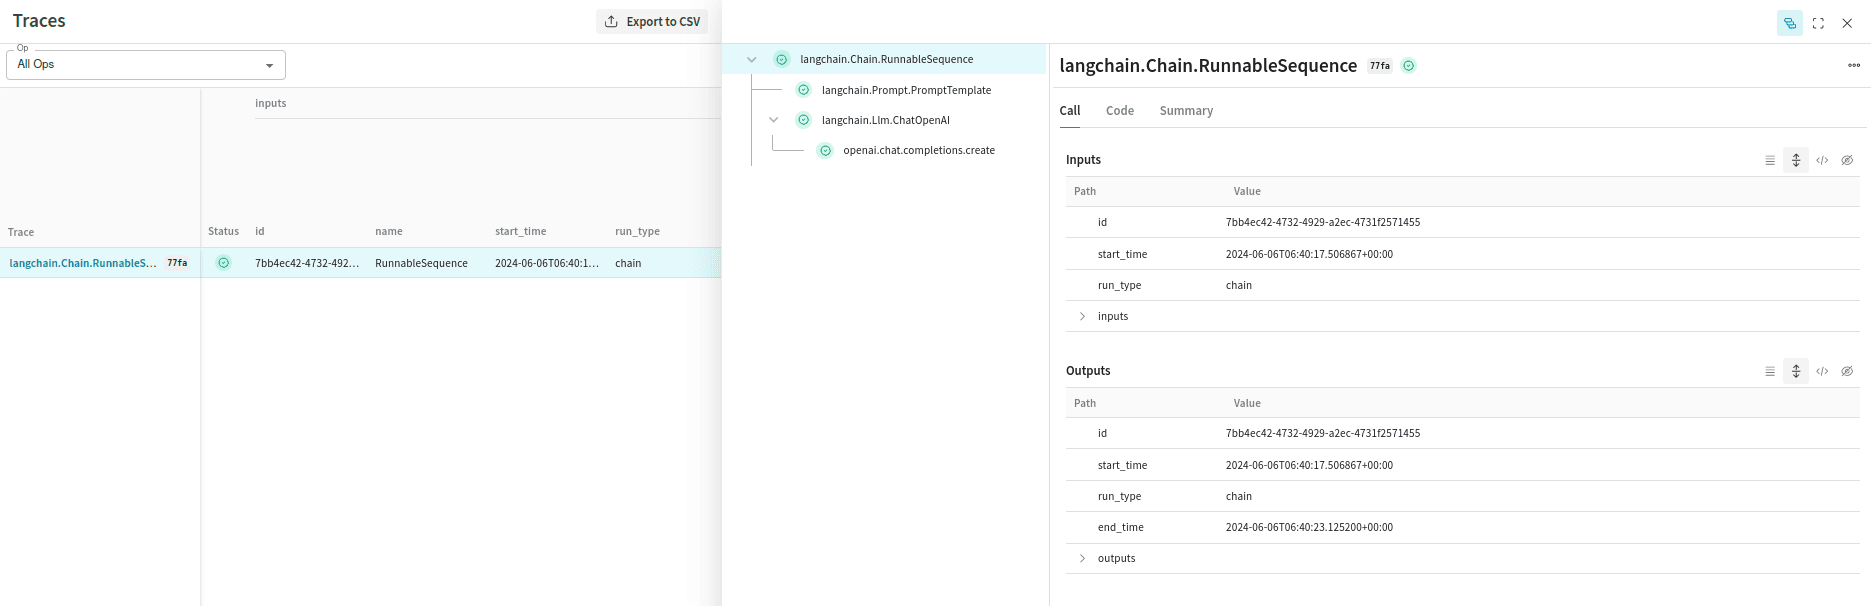
Tracer manuellement les appels
Outre le traçage automatique, vous pouvez tracer manuellement les appels à l’aide du callbackWeaveTracer ou du gestionnaire de contexte weave_tracing_enabled. Ces méthodes s’apparentent à l’utilisation de callbacks de requête dans certaines parties d’une application LangChain. Utilisez-les lorsque vous souhaitez tracer des chaînes ou des invocations précises plutôt que l’ensemble de votre application.
Les sections suivantes décrivent chaque approche.
Remarque : par défaut, Weave trace les Runnables LangChain dès que vous appelez weave.init(). Vous pouvez désactiver ce comportement en définissant la variable d’environnement WEAVE_TRACE_LANGCHAIN sur "false" avant d’appeler weave.init(). Vous pouvez ainsi contrôler le comportement de traçage de certaines chaînes, voire de requêtes individuelles, dans votre application.
Utiliser WeaveTracer
Vous pouvez transmettre le callback WeaveTracer à des composants LangChain précis pour tracer certaines requêtes spécifiques.
Utiliser le gestionnaire de contexte weave_tracing_enabled
Vous pouvez également utiliser le gestionnaire de contexte weave_tracing_enabled pour activer le traçage sur des blocs de code précis.
Configuration
Lorsque vous appelezweave.init(), Weave active le traçage en définissant la variable d’environnement WEAVE_TRACE_LANGCHAIN sur "true". Weave peut ainsi capturer automatiquement les traces de vos applications LangChain. Pour désactiver ce comportement, définissez cette variable d’environnement sur "false".
Lien avec les callbacks LangChain
Cette section explique comment le traçage de Weave s’intègre au système de callbacks de LangChain, afin que vous puissiez choisir l’approche la plus adaptée à votre application.Journalisation automatique
La journalisation automatique fournie parweave.init() équivaut à transmettre un callback de constructeur à chaque composant d’une application LangChain. Weave suit ainsi toutes les interactions de manière globale dans l’ensemble de votre application, notamment les modèles de prompts, les chaînes, les appels LLM, les outils et les étapes des agents.
Journalisation manuelle
Les méthodes de journalisation manuelle (WeaveTracer et weave_tracing_enabled) s’apparentent à l’utilisation de callbacks de requête dans certaines parties d’une application LangChain. Elles vous permettent de contrôler plus finement les parties de votre application tracées par Weave :
- Callbacks de constructeur : s’appliquent à l’ensemble de la chaîne ou du composant et journalisent toutes les interactions de manière uniforme.
- Callbacks de requête : s’appliquent à des requêtes spécifiques et fournissent un traçage détaillé de certaines invocations.
Modèles et évaluations
Organiser et évaluer des LLM pour différents cas d’usage devient plus difficile à mesure que vous ajoutez des composants tels que des prompts, des configurations de modèle et des paramètres d’inférence. Avecweave.Model, vous pouvez capturer et organiser les détails de vos expériences, comme les prompts système ou les modèles utilisés, ce qui facilite la comparaison des itérations.
Les sections suivantes montrent comment encapsuler une chaîne LangChain dans un weave.Model, puis l’évaluer.
L’exemple suivant montre comment encapsuler une chaîne LangChain dans un WeaveModel :
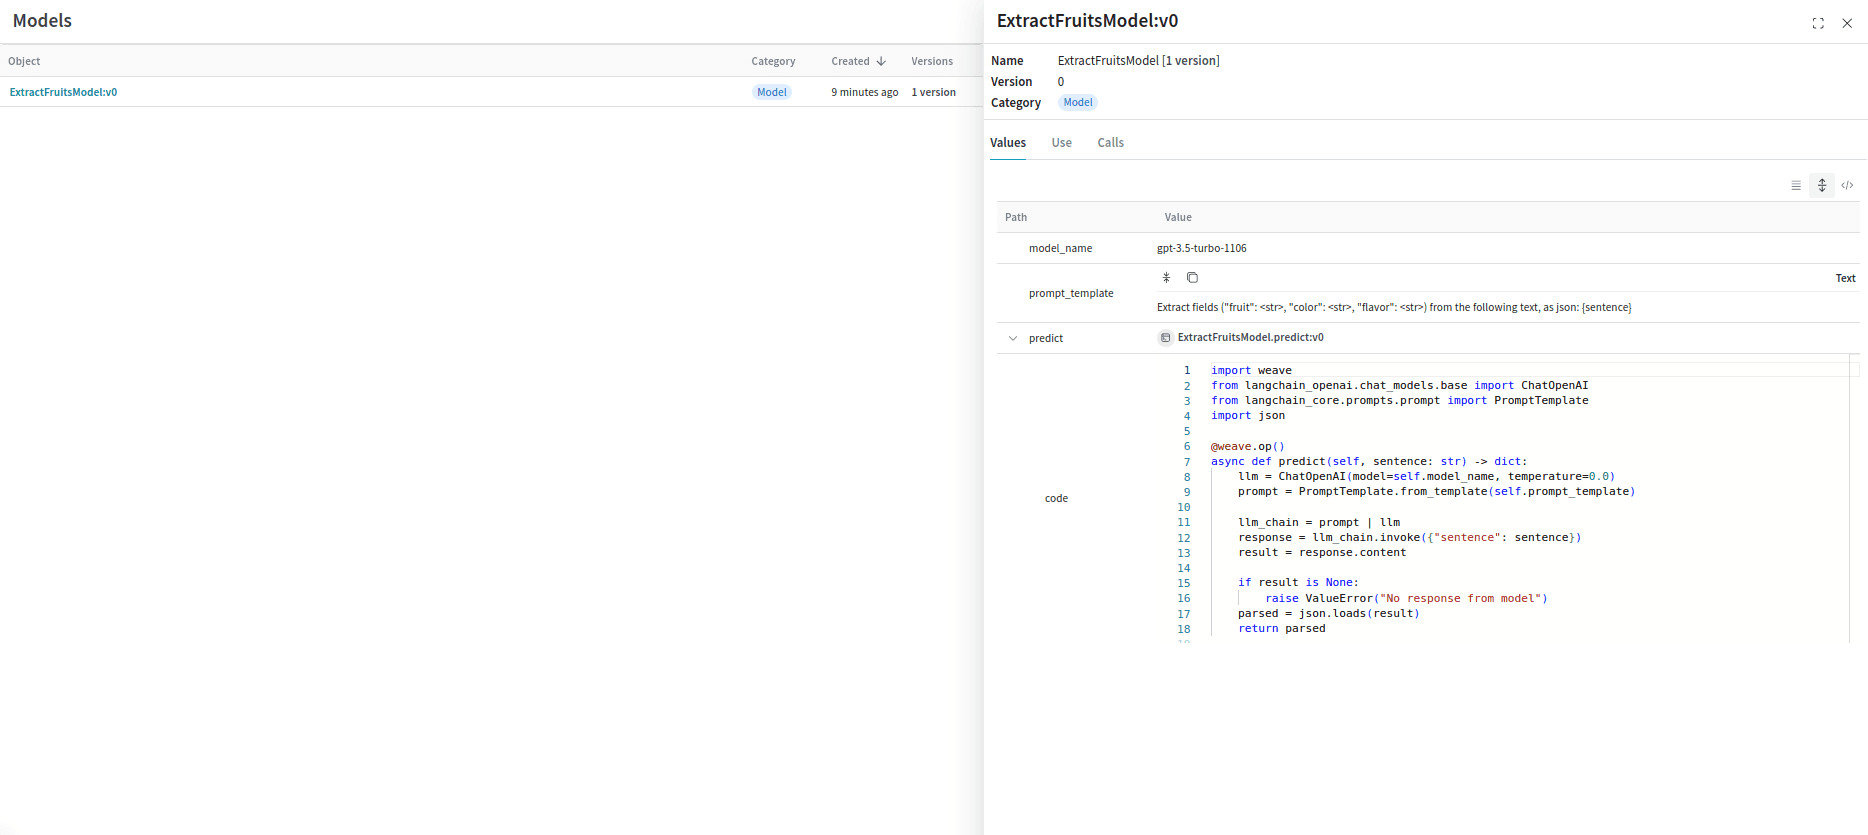 Vous pouvez également utiliser les modèles Weave avec
serve et avec les Evaluations.
Évaluations
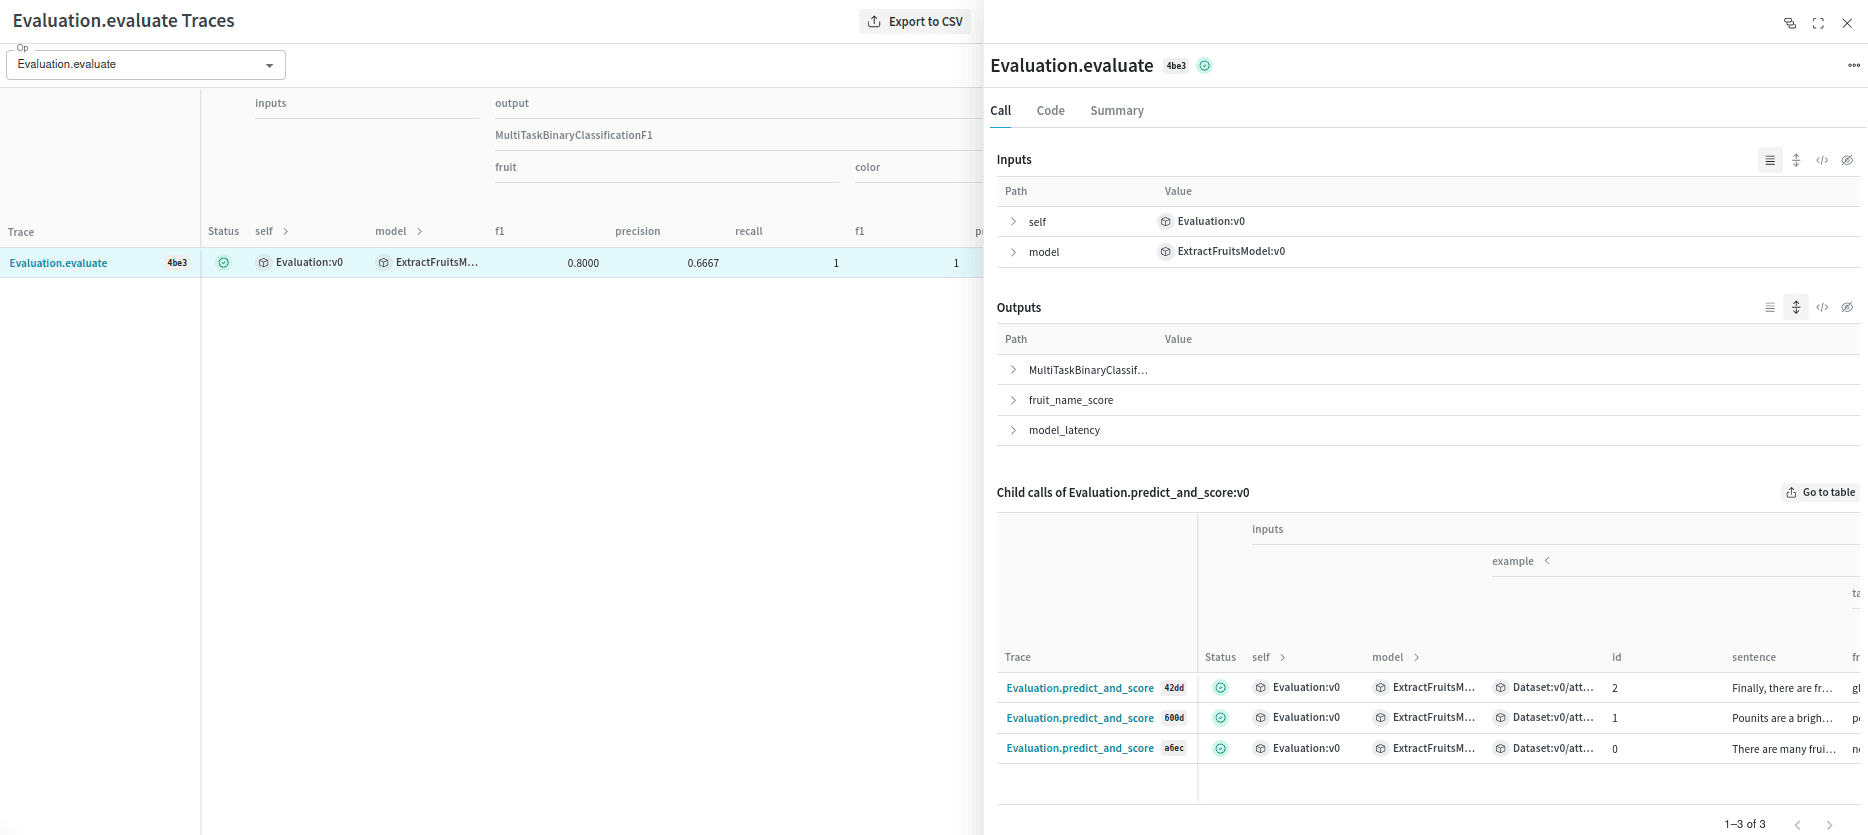
Les évaluations vous aident à mesurer les performances de vos modèles. La classeweave.Evaluation permet de capturer les performances de votre modèle sur des tâches ou des jeux de données spécifiques. Vous pouvez ainsi comparer plus facilement différents modèles et différentes itérations de votre application. L’exemple suivant montre comment évaluer le modèle précédent :
Problèmes connus
Traçage des appels asynchrones : en raison d’un bug dans l’implémentation de l’AsyncCallbackManager de LangChain, les appels asynchrones ne sont pas tracés dans le bon ordre. Weave a soumis une PR pour corriger ce problème. En attendant, l’ordre des appels dans la trace peut être inexact lorsque vous utilisez les méthodes ainvoke, astream et abatch dans les Runnables LangChain.