Ceci est un notebook interactif. Vous pouvez l’exécuter localement ou utiliser les liens ci-dessous :
Prérequis
Avant de commencer, installez et importez les bibliothèques requises, obtenez votre clé API W&B et initialisez votre projet Weave. Cette étape permet à votre environnement de s’authentifier auprès de W&B et de journaliser des traces dans votre projet Weave.Créer des prompts et les faire évoluer avec Weave
Une bonne ingénierie de prompts est essentielle pour que le modèle extraie correctement les entités. Dans cette section, vous rédigez un prompt initial, vous le publiez dans Weave pour suivre ses modifications au fil du temps, puis vous l’affinez avec des règles de validation plus strictes. Commencez par créer un prompt de base qui indique au modèle ce qu’il doit extraire des données d’image et comment mettre en forme le résultat. Ensuite, stockez le prompt dans Weave pour en assurer le suivi et le faire évoluer par itérations.Obtenir le dataset
Une fois le prompt en place, il vous faut des données d’entrée à faire passer dans le pipeline. Récupérez le dataset de notes manuscrites qui servira d’entrée au pipeline d’OCR. Les images du dataset sont déjà encodées enbase64, ce qui permet au LLM de les utiliser sans aucun prétraitement.
Créer le pipeline NER
Maintenant que vous disposez d’un prompt et d’un dataset, créez le pipeline NER qui les relie au VLM. Le pipeline se compose de deux fonctions :- Une fonction
encode_imagequi prend en entrée une image PIL issue du dataset et renvoie une représentation de l’image sous forme de chaîne encodée enbase64, pouvant être transmise au VLM. - Une fonction
extract_named_entities_from_imagequi prend en entrée une image et un prompt système, puis renvoie les entités extraites de cette image selon les consignes du prompt système.
named_entity_recognation qui :
- Transmet les données d’image au pipeline NER.
- Renvoie un JSON correctement formaté contenant les résultats.
@weave.op() pour suivre et tracer automatiquement l’exécution de la fonction dans l’interface Weights & Biases.
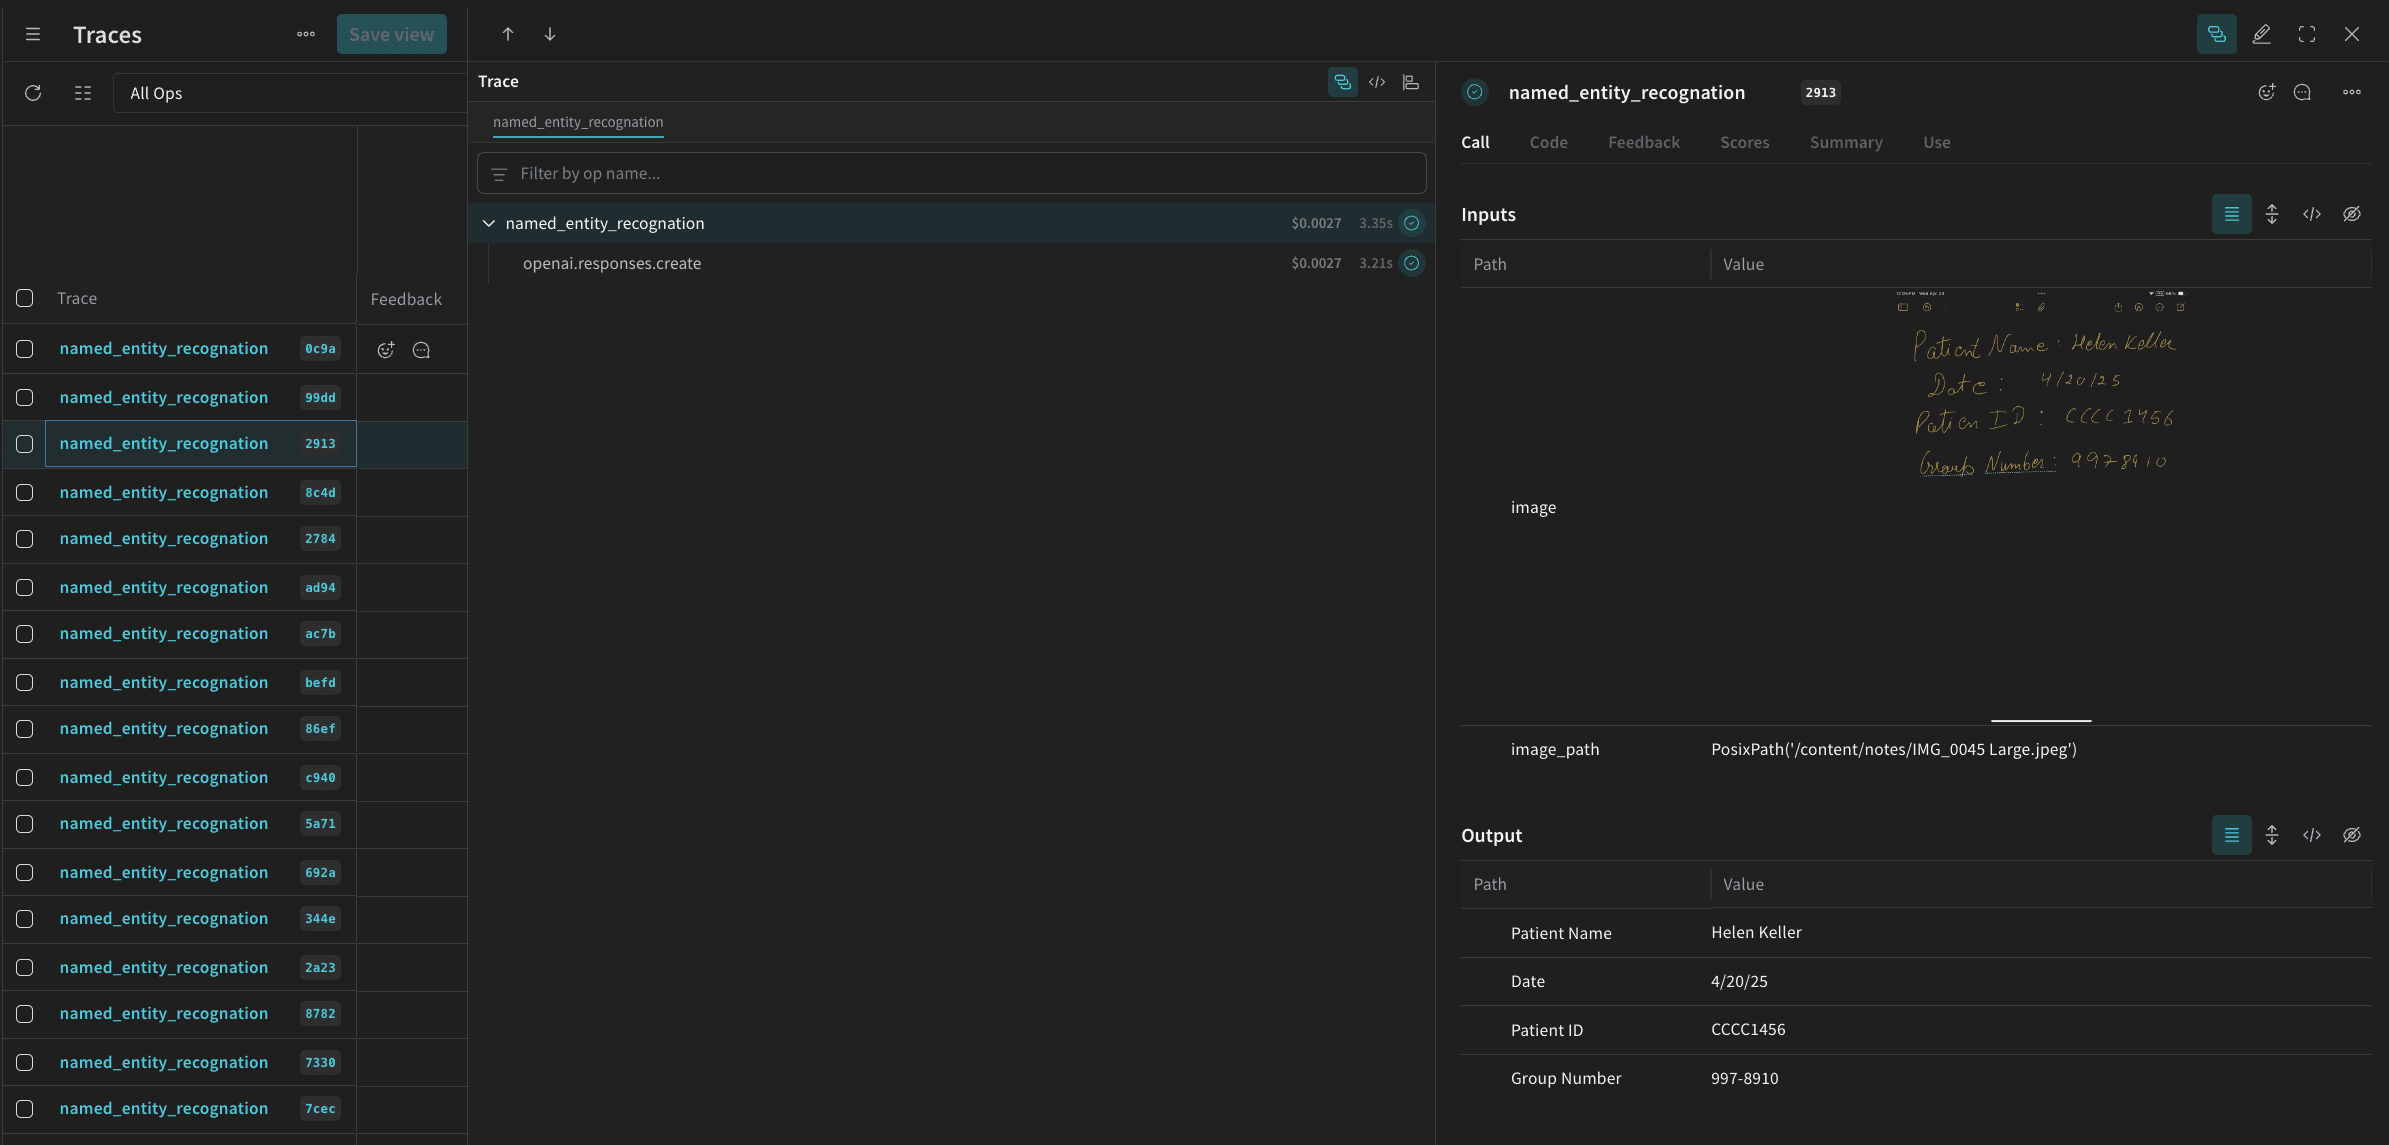
À chaque exécution de named_entity_recognation, les résultats complets de la trace s’affichent dans l’interface Weights & Biases. Pour consulter les traces, accédez à l’onglet Traces de votre projet Weave.
processing_results.json. Vous pouvez également consulter les résultats dans l’interface utilisateur de Weights & Biases.
Évaluez le pipeline avec Weave
Maintenant que vous avez créé un pipeline de reconnaissance d’entités nommées (NER) à l’aide d’un VLM, vous pouvez utiliser Weave pour l’évaluer de manière systématique et mesurer ses performances. L’évaluation du pipeline vous permet de mesurer la qualité de l’extraction sur l’ensemble du dataset, plutôt que de vous fier à des vérifications ponctuelles. Pour plus d’informations sur les évaluations dans Weave, consultez Aperçu des évaluations. L’Évaluateur est un élément fondamental d’une Évaluation Weave. Les évaluateurs analysent les sorties de l’IA et renvoient des métriques d’évaluation. Ils prennent la sortie de l’IA, l’analysent et renvoient un dictionnaire de résultats. Si nécessaire, les évaluateurs peuvent s’appuyer sur vos données d’entrée comme référence et produire des informations supplémentaires, comme des explications ou le raisonnement issu de l’évaluation. Dans cette section, vous allez créer deux évaluateurs pour évaluer le pipeline :- Évaluateur programmatique.
- Évaluateur LLM-as-a-judge.
Évaluateur programmatique
Le premier évaluateur est une vérification déterministe qui s’exécute sans LLM. L’évaluateur programmatique,check_for_missing_fields_programatically, prend en entrée la sortie du modèle (celle de la fonction named_entity_recognition) et identifie les keys manquantes ou vides dans les résultats.
Cette vérification permet d’identifier les échantillons pour lesquels le modèle n’a pas réussi à capturer certains champs.
Évaluateur LLM-as-a-judge
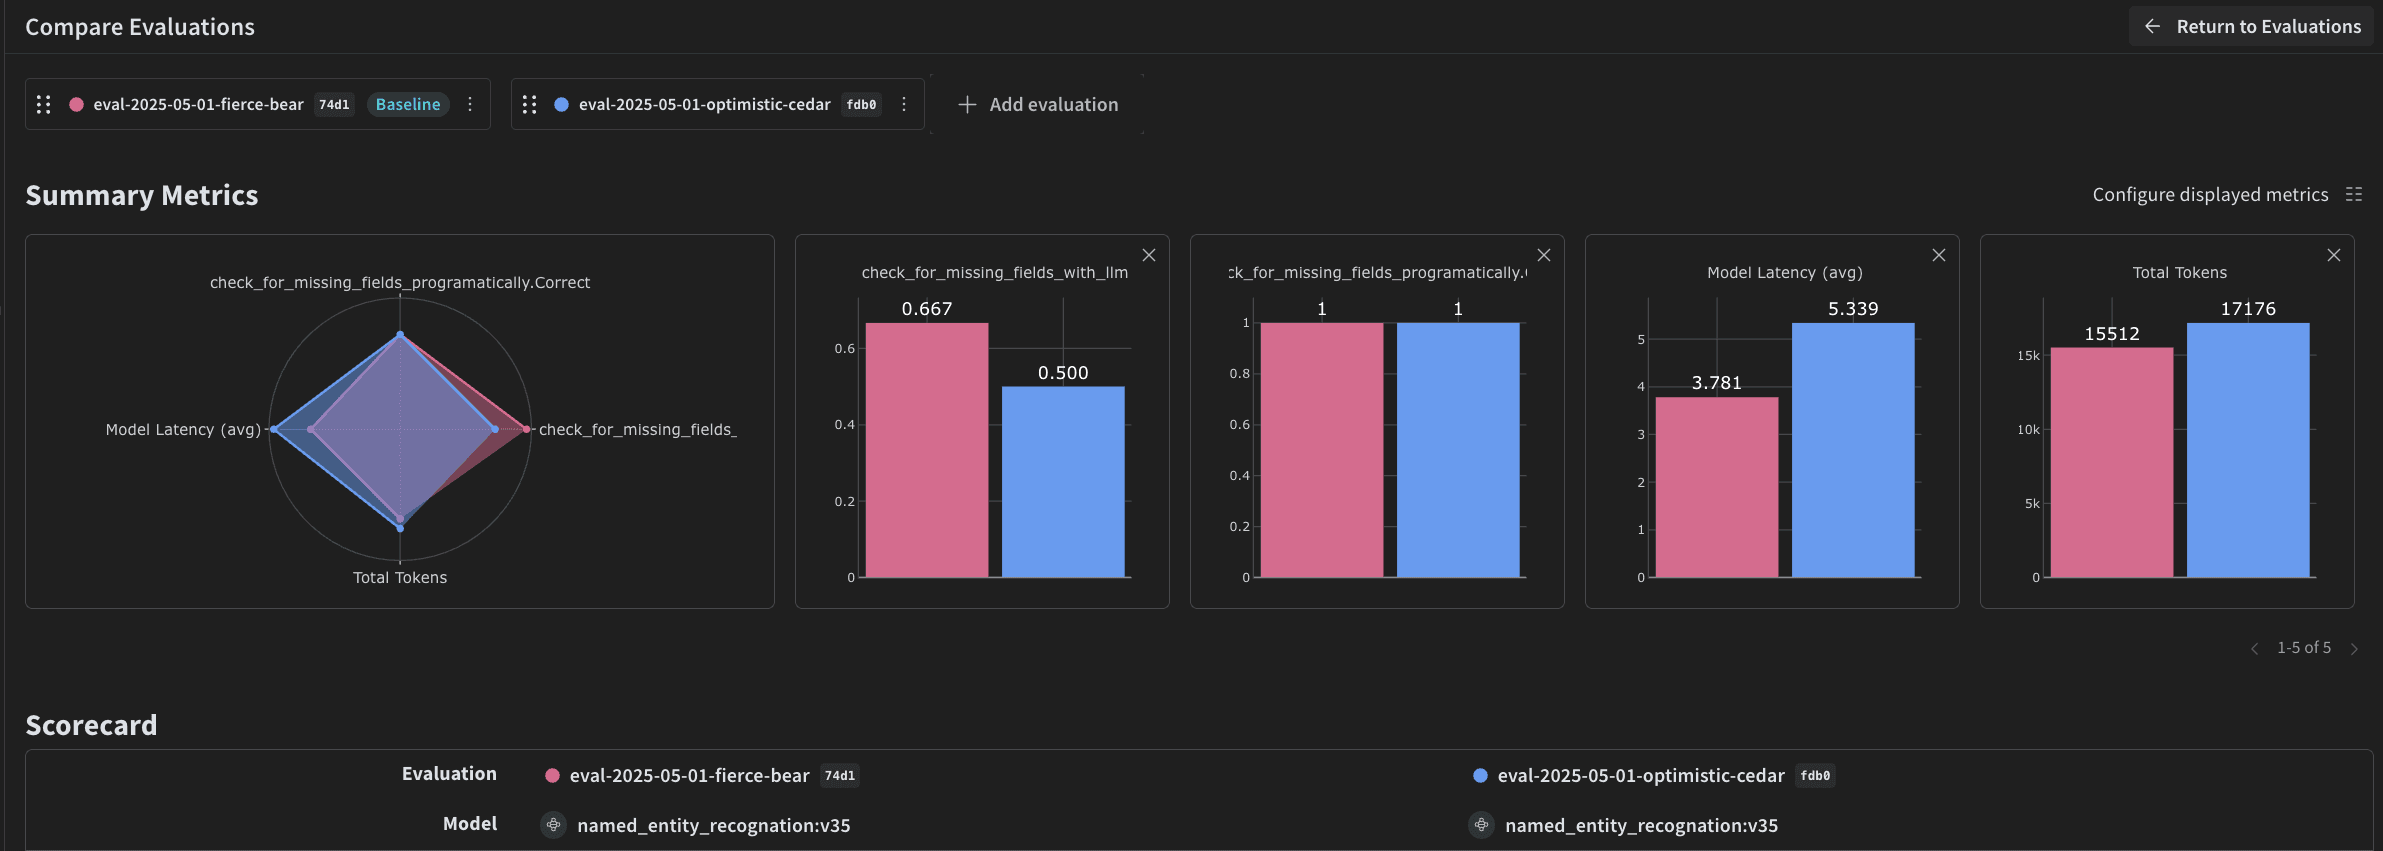
Comme l’évaluateur programmatique ne détecte que les champs manquants ou vides, un second évaluateur est nécessaire pour vérifier que les valeurs extraites correspondent bien au contenu de l’image. À cette étape de l’évaluation, vous fournissez à la fois les données de l’image et la sortie du modèle, afin que l’évaluation reflète les performances réelles de la reconnaissance d’entités nommées (NER). Le contenu de l’image est explicitement pris en compte, et pas uniquement la sortie du modèle. L’évaluateur utilisé pour cette étape,check_for_missing_fields_with_llm, s’appuie sur un LLM pour effectuer la notation (en l’occurrence gpt-4o d’OpenAI). Comme le définit le contenu de eval_prompt, check_for_missing_fields_with_llm produit une valeur Boolean. Si tous les champs correspondent aux informations de l’image et que le formatage est correct, l’évaluateur renvoie true. Si un champ est manquant, vide, incorrect ou ne concorde pas, le résultat est false, et l’évaluateur renvoie également un message expliquant le problème.
Exécuter l’évaluation
Une fois les deux évaluateurs définis, vous pouvez exécuter l’évaluation. Définissez un appel d’évaluation qui parcourt automatiquement ledataset fourni et journalise l’ensemble des résultats dans l’interface utilisateur de Weights & Biases.
Le code suivant lance l’évaluation et applique les deux évaluateurs à chaque sortie du pipeline NER. Les résultats s’affichent dans l’onglet Evals de l’interface utilisateur de Weights & Biases.