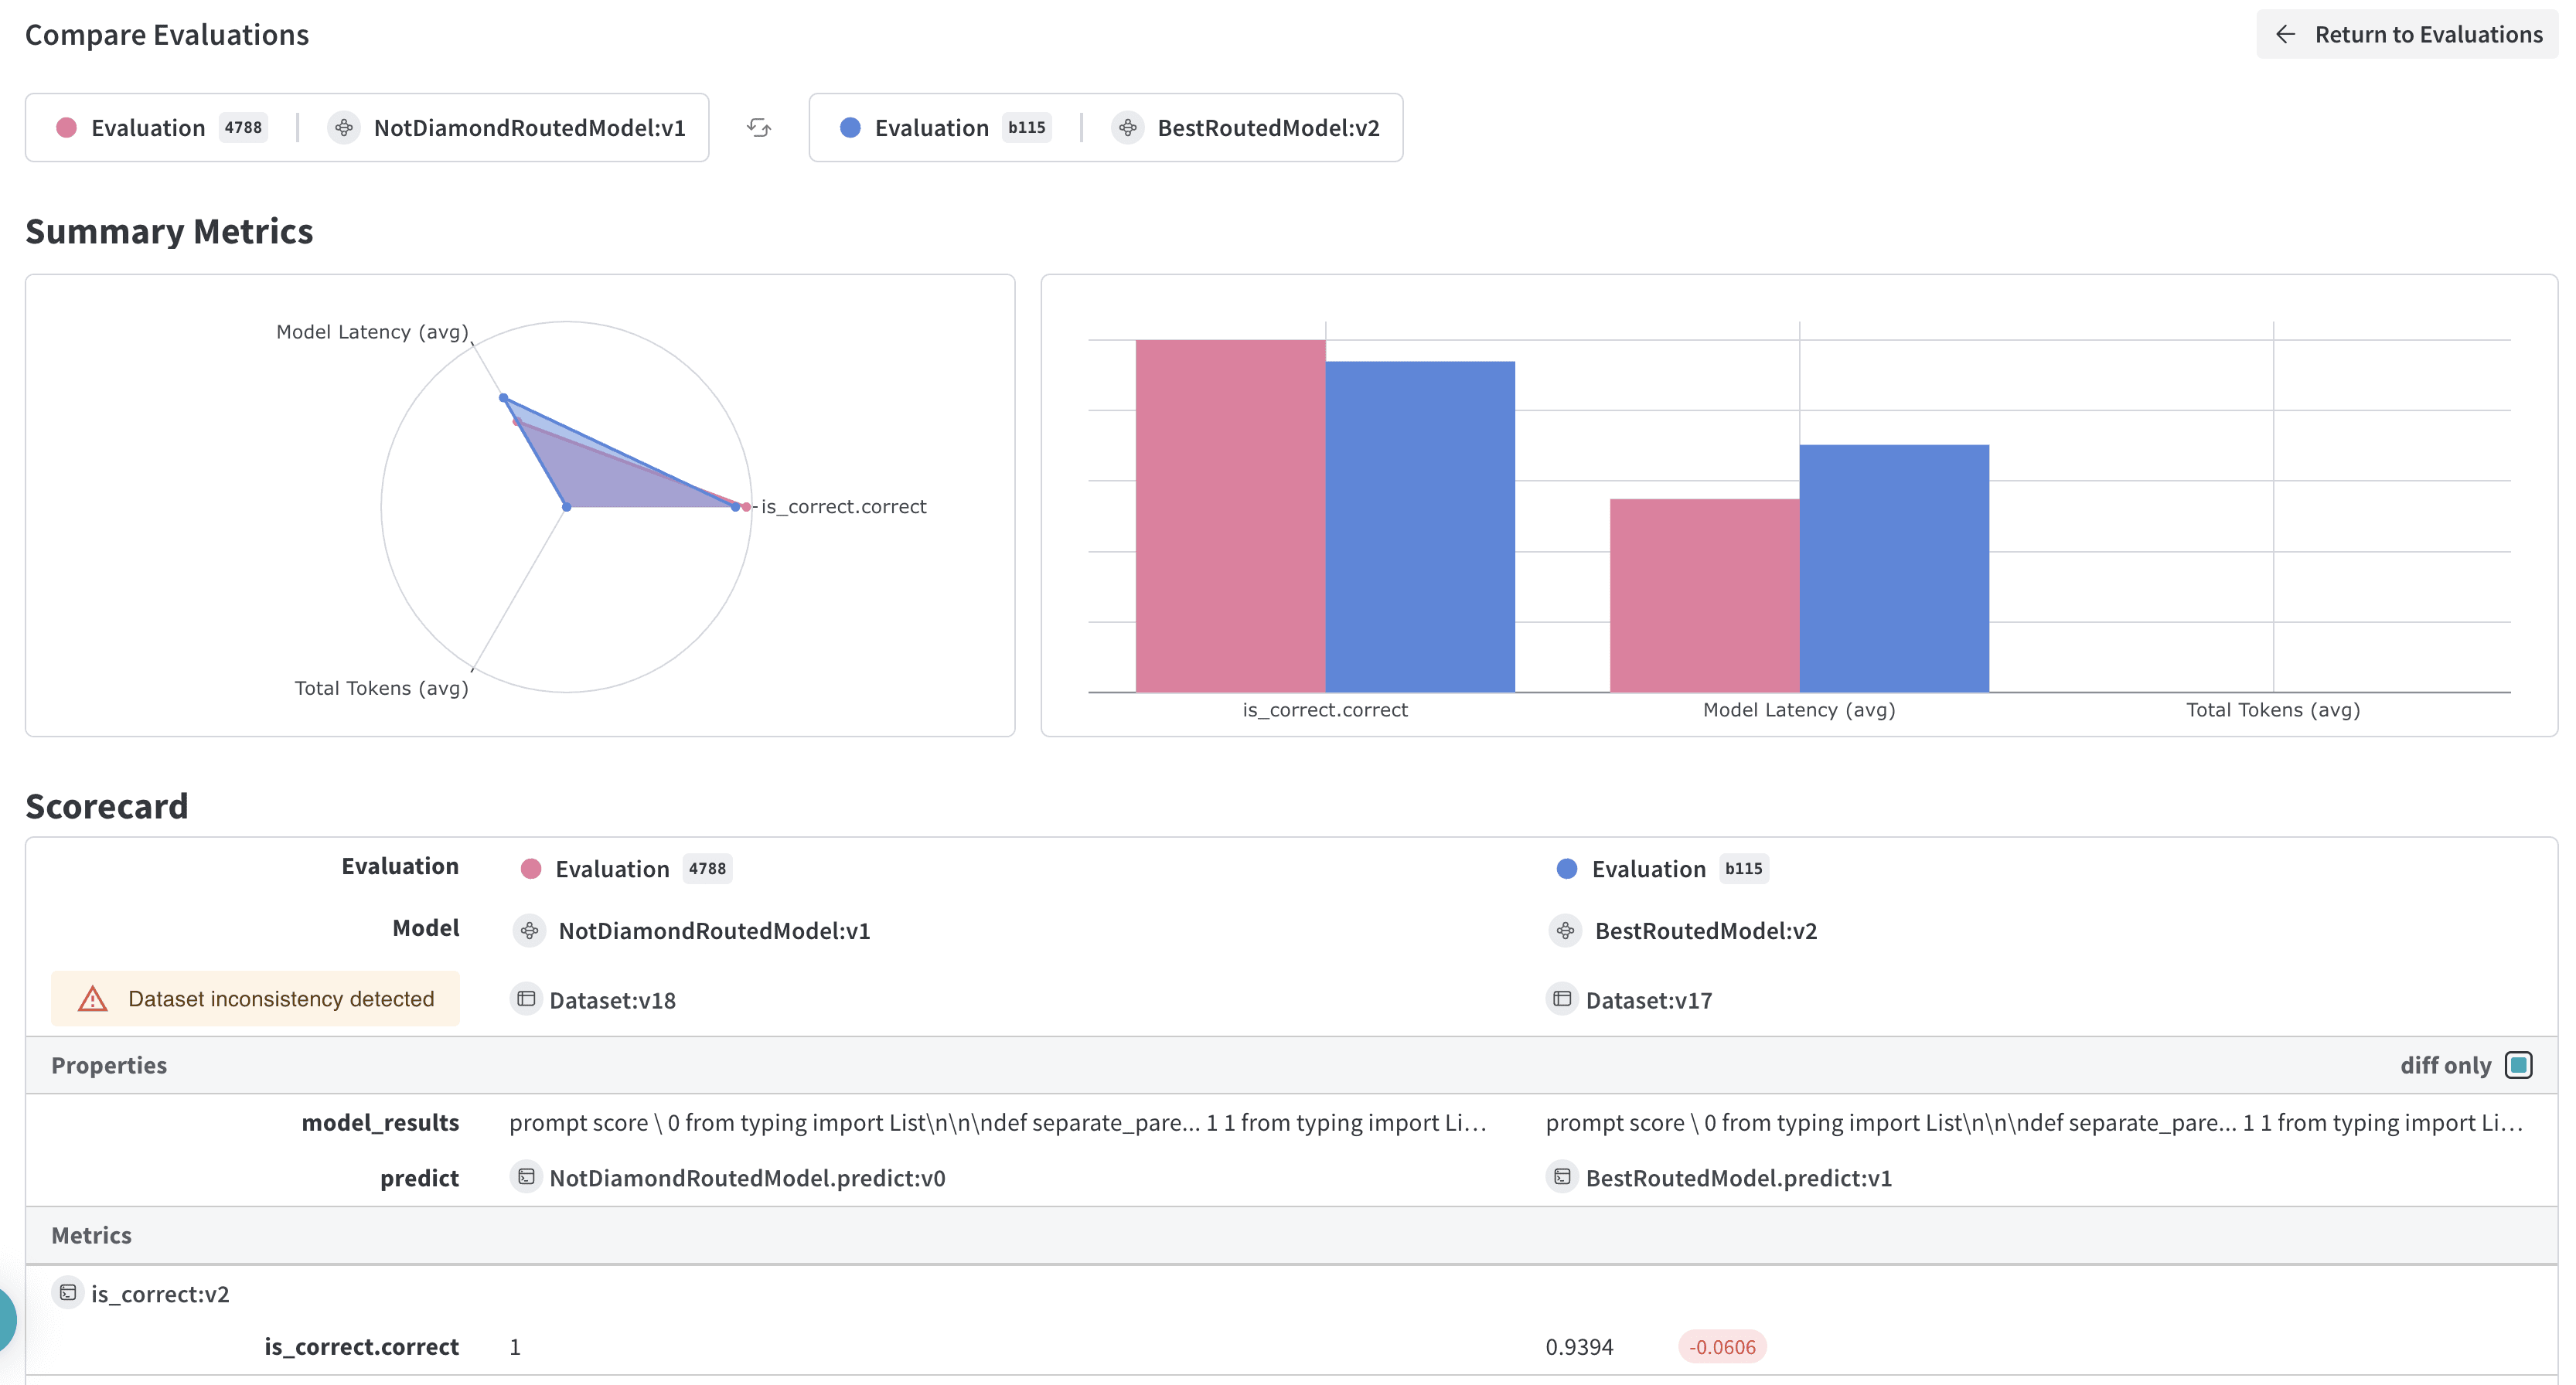
Ceci est un notebook interactif. Vous pouvez l’exécuter localement ou utiliser les liens suivants :
Acheminement des prompts
Cette section explique l’intérêt d’un acheminement personnalisé lorsque vous travaillez avec plusieurs LLM. Lorsque vous créez des flux de travail LLM complexes, vous pouvez avoir besoin d’envoyer des prompts à différents modèles en fonction de la précision, du coût ou de la latence des appels. Vous pouvez utiliser Not Diamond pour acheminer les prompts de ces flux de travail vers le modèle le mieux adapté à vos besoins, afin de maximiser la précision tout en réduisant les coûts liés aux modèles. Quelle que soit la distribution des données, il est rare qu’un seul modèle surpasse tous les autres sur chaque requête. En combinant plusieurs modèles au sein d’un « méta-modèle » qui apprend quand appeler chaque LLM, vous pouvez dépasser les performances de chaque modèle pris individuellement, et même réduire les coûts et la latence.Acheminement personnalisé
Pour entraîner un routeur personnalisé pour vos prompts, vous devez fournir les entrées suivantes :- Un ensemble de prompts de LLM : les prompts doivent être des chaînes de caractères représentatives des prompts utilisés dans votre application.
- Réponses des LLM : les réponses des LLM candidats pour chaque entrée. Les LLM candidats peuvent inclure aussi bien des LLM pris en charge que vos propres modèles personnalisés.
- Scores d’évaluation des réponses des LLM candidats aux entrées : les scores sont des nombres et peuvent correspondre à n’importe quelle métrique adaptée à vos besoins.
Configurer les données d’entraînement
Dans cette section, vous préparez les données d’entraînement et de test sur lesquelles le routeur personnalisé s’appuie pour apprendre. En pratique, vous utilisez vos propres évaluations pour entraîner un routeur personnalisé. Dans ce notebook d’exemple, en revanche, vous utilisez des réponses de LLM sur le dataset HumanEval afin d’entraîner un routeur personnalisé pour des tâches de programmation. Commencez par télécharger le dataset préparé pour cet exemple, puis analysez les réponses des LLM pour les convertir enEvaluationResults pour chaque modèle. Cette répartition entre données d’entraînement et de test sert dans les sections suivantes à entraîner le routeur et à évaluer ses performances hors échantillon.
Entraîner un routeur personnalisé
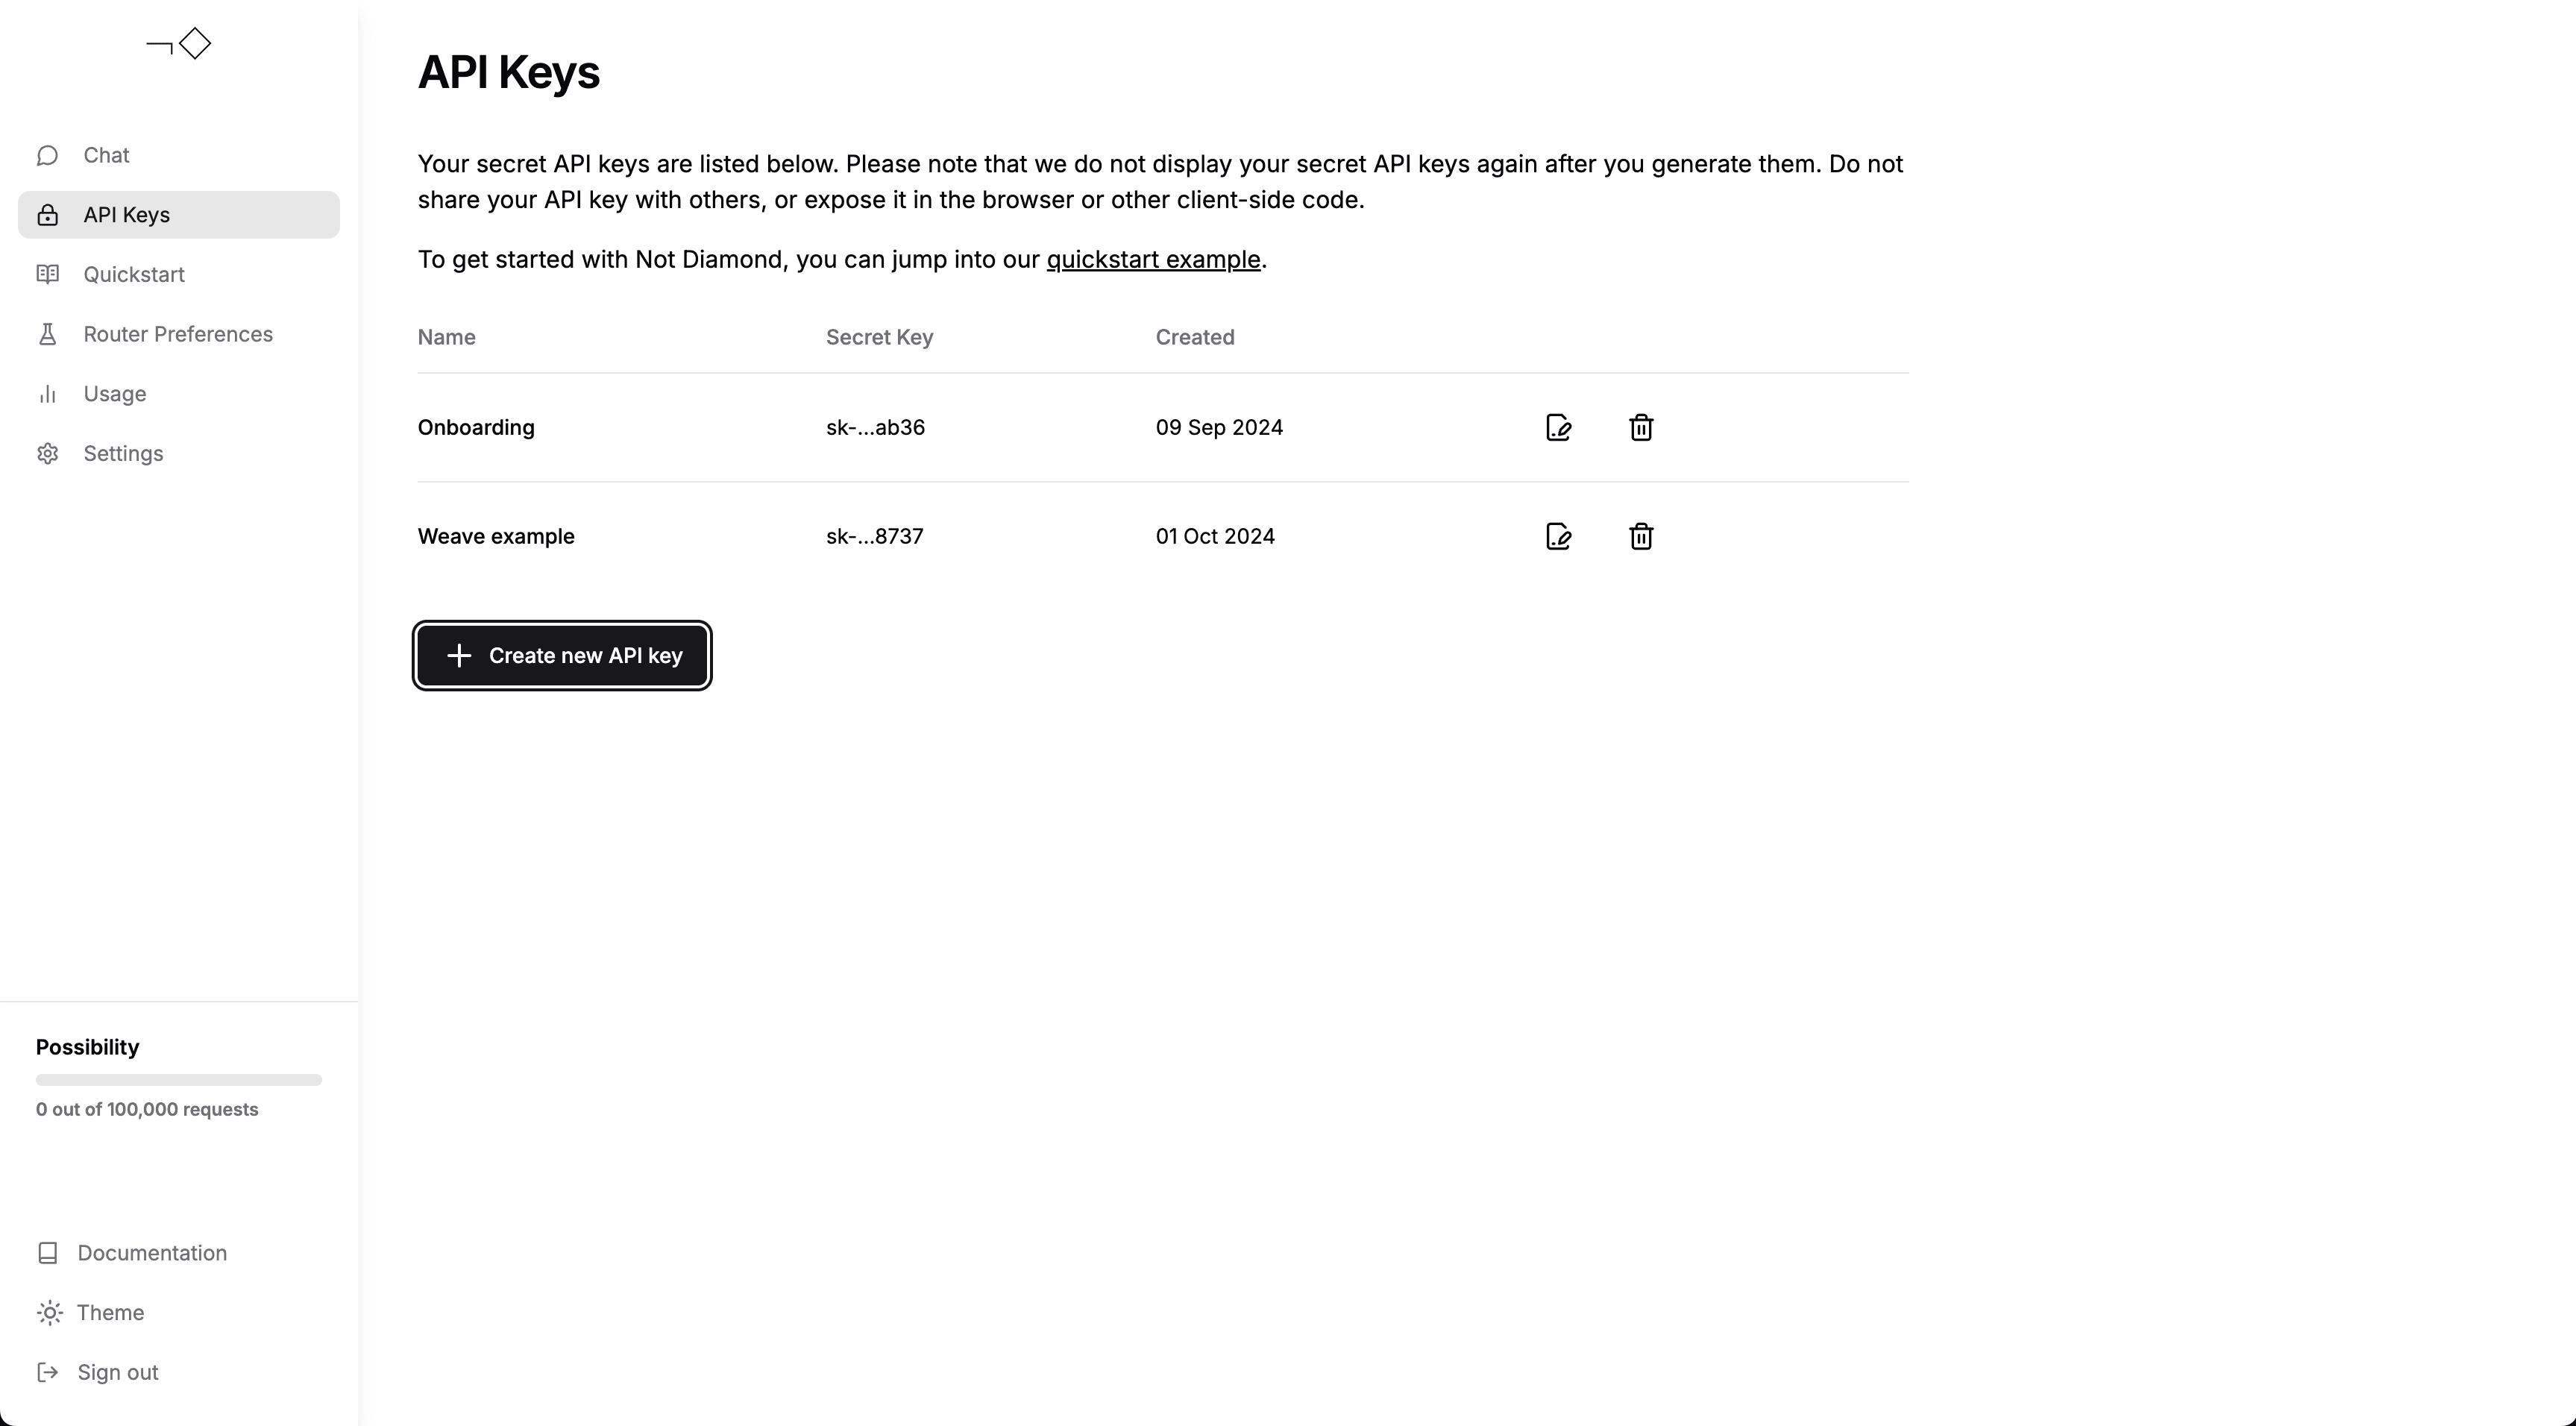
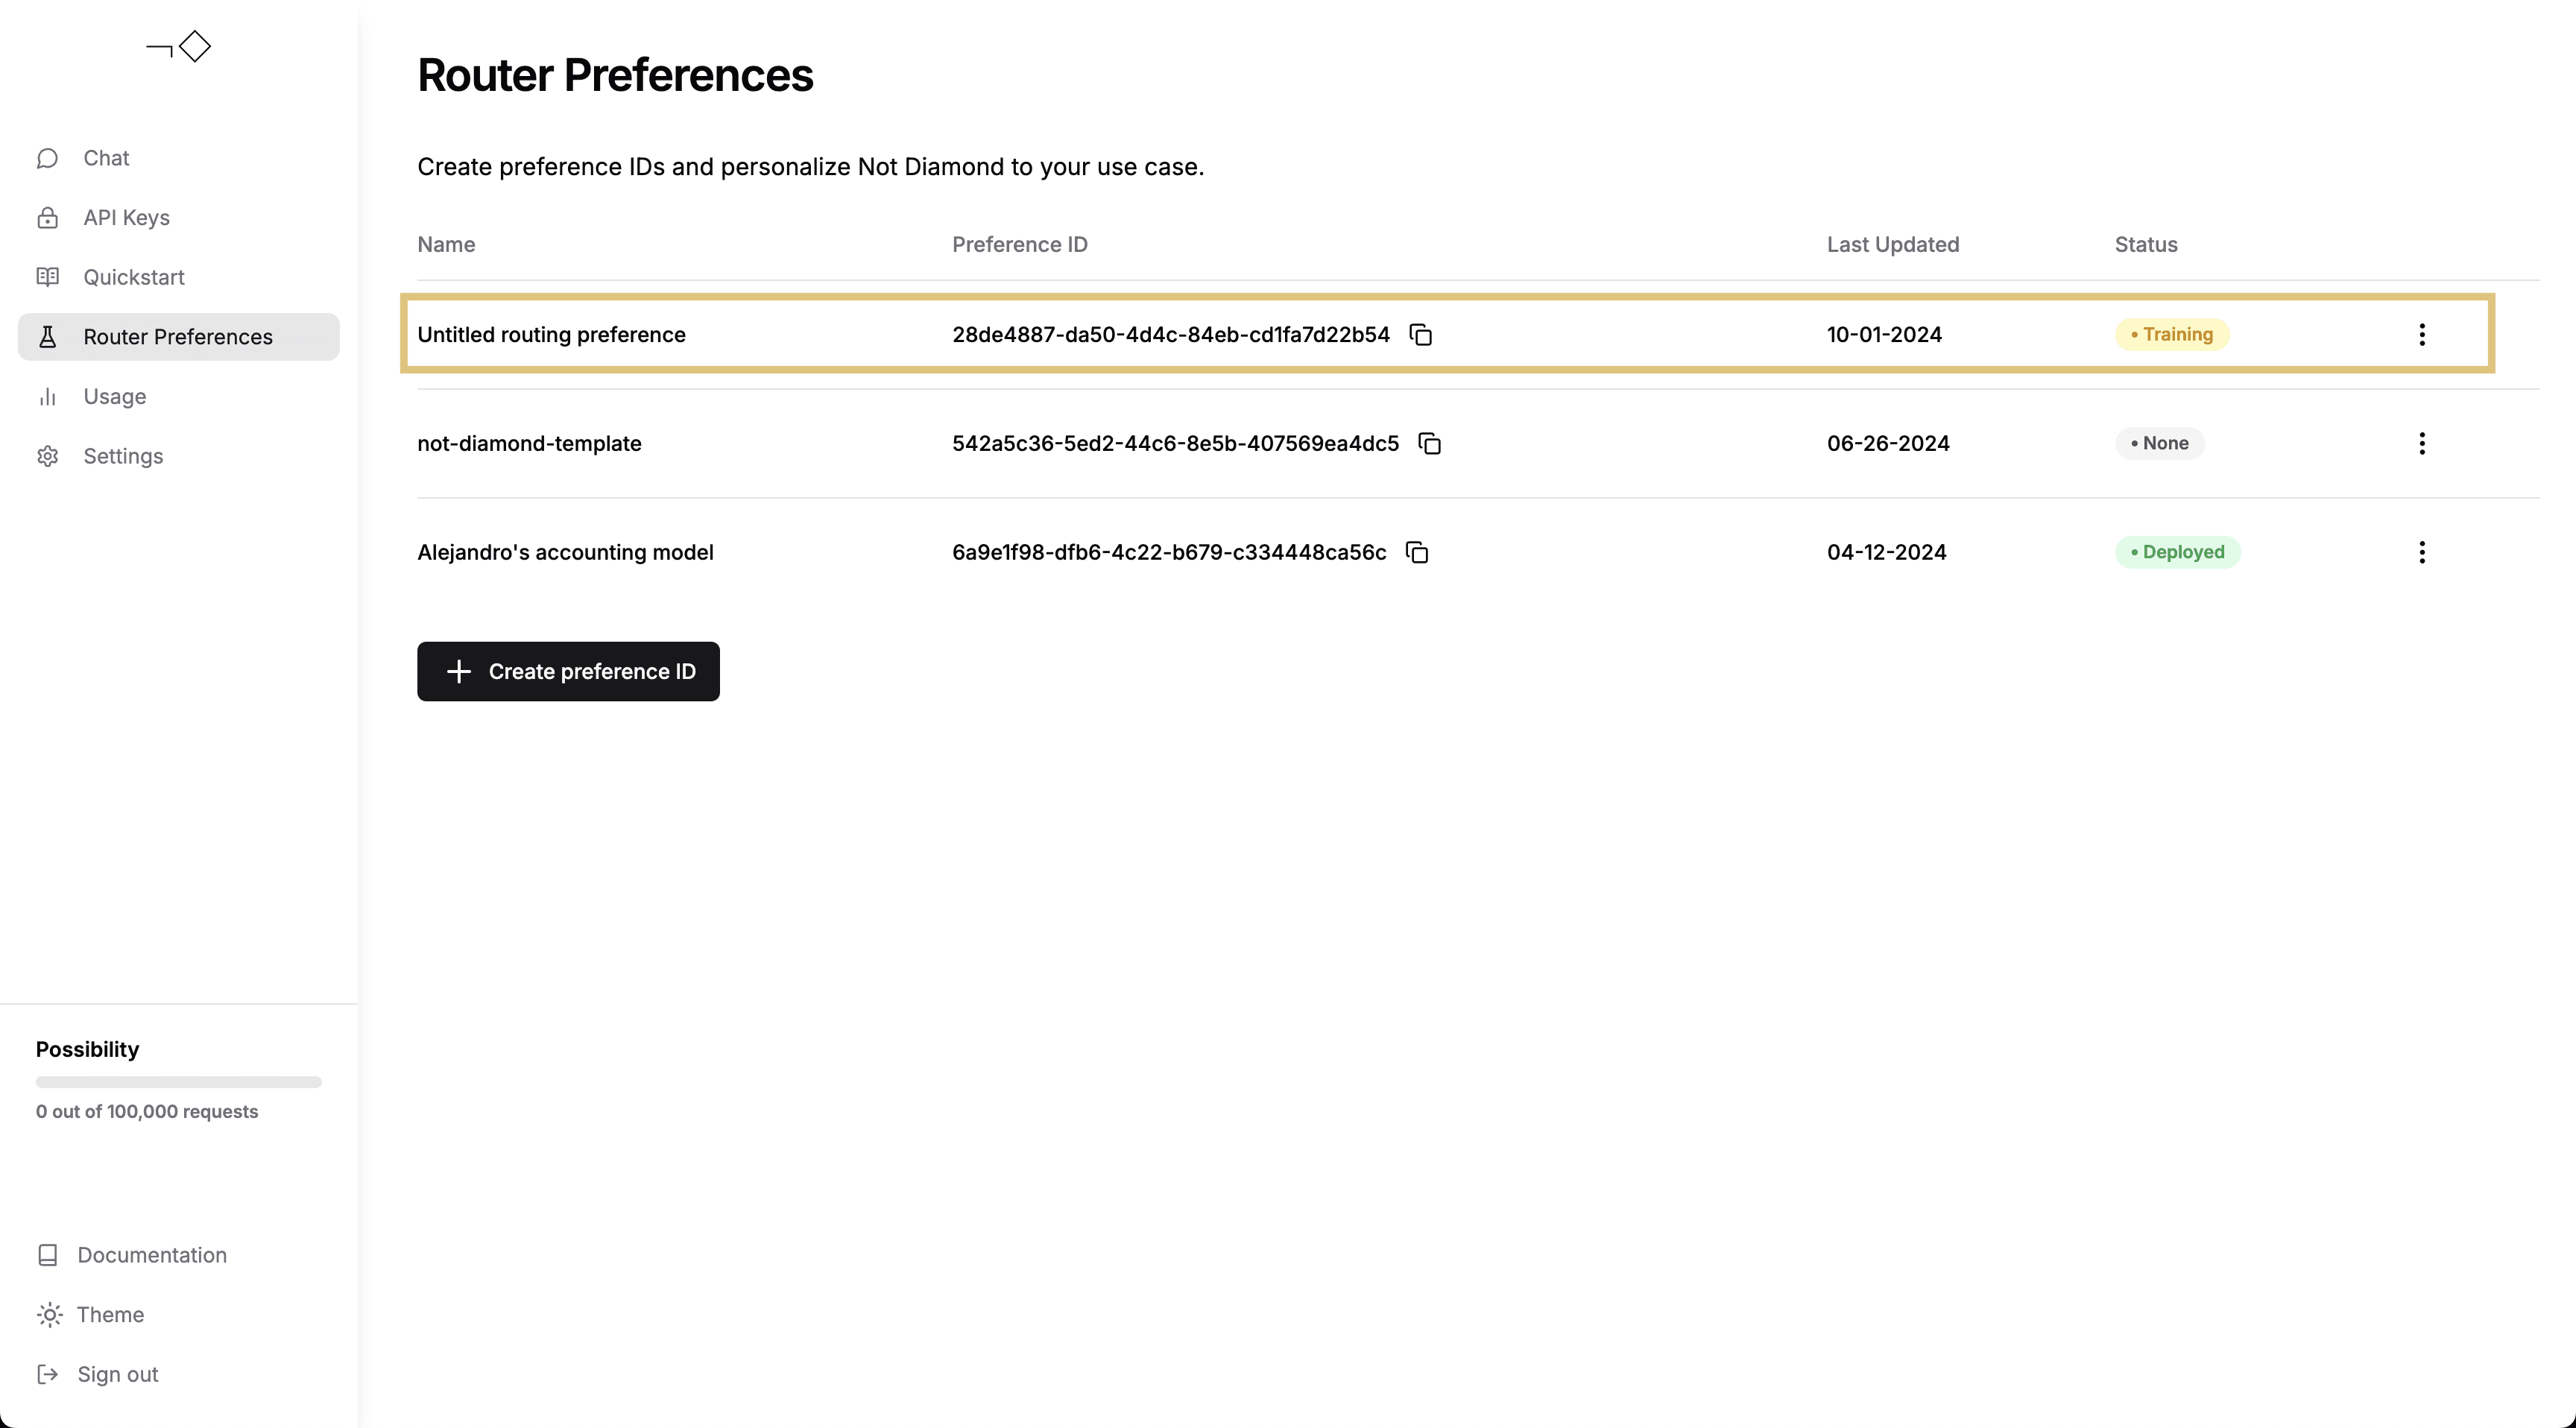
Une fois lesEvaluationResults préparés, vous pouvez les soumettre à Not Diamond pour entraîner un routeur personnalisé. Assurez-vous d’avoir créé un compte et
généré une clé API, puis insérez votre clé API dans le code ci-dessous. Cette clé API sert à authentifier la requête d’entraînement.
Évaluez votre routeur personnalisé
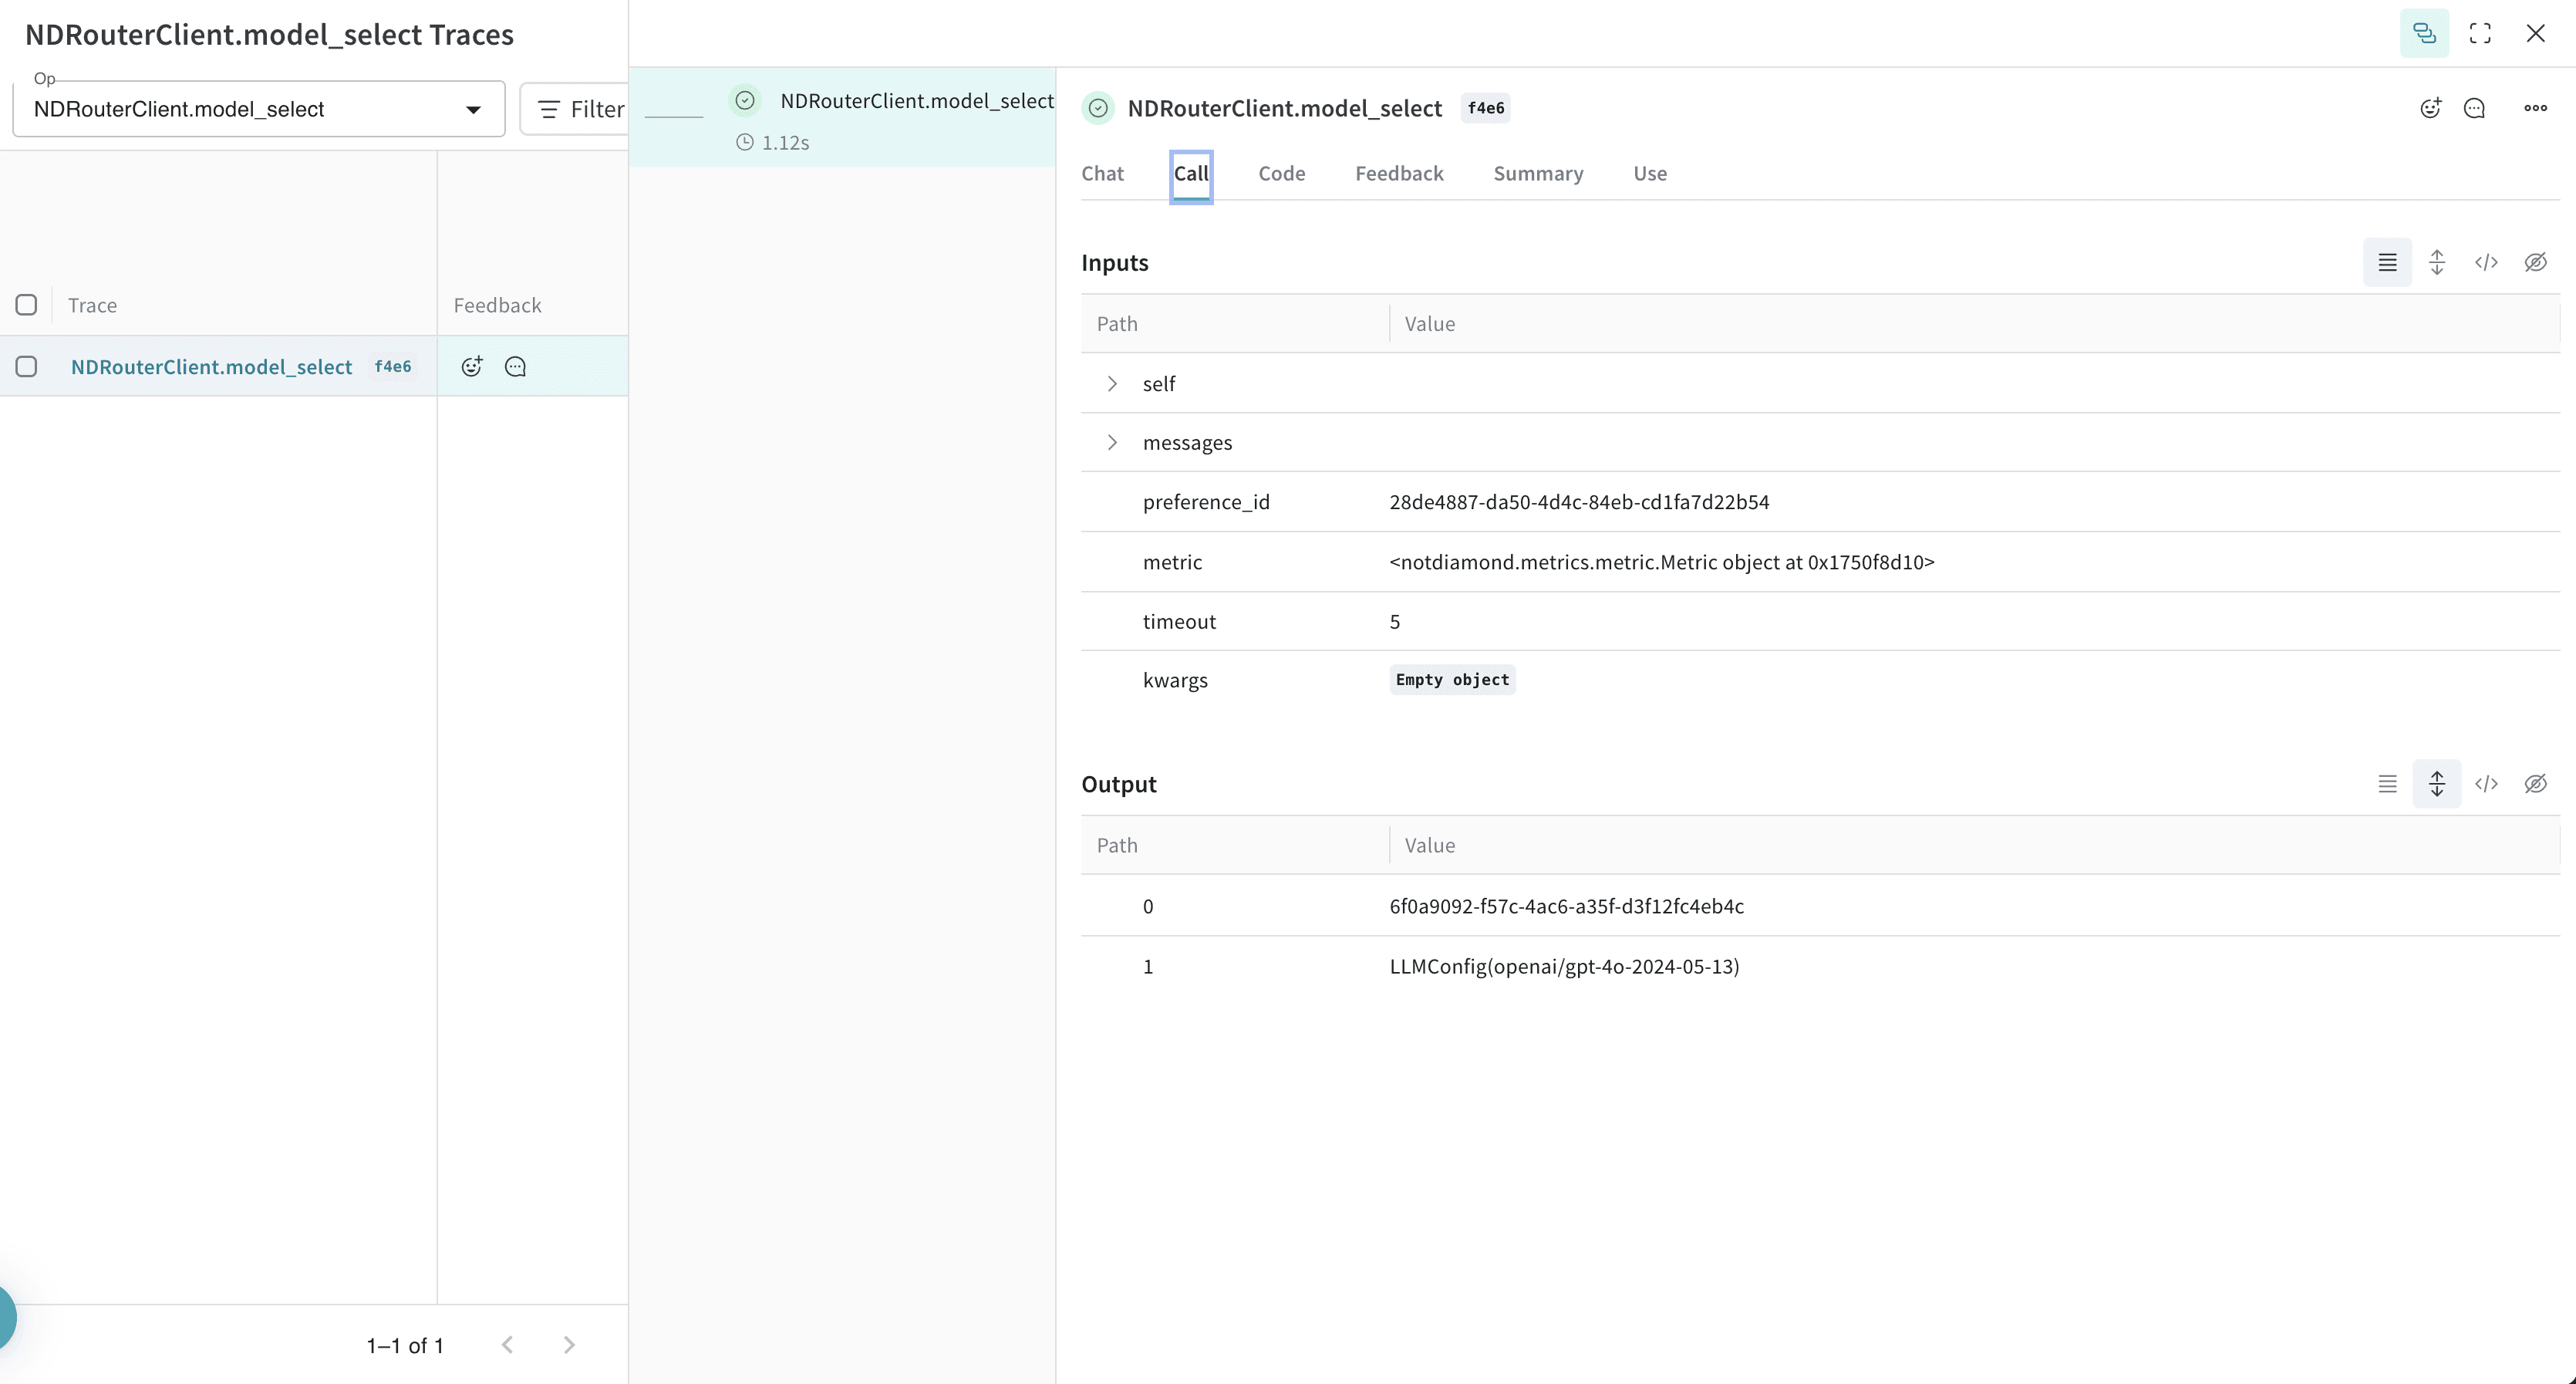
Cette section explique comment déterminer si le routeur personnalisé fait mieux que le meilleur modèle pris individuellement. Une fois votre routeur personnalisé entraîné, vous pouvez évaluer ses performances de l’une des manières suivantes :- Performances sur l’échantillon d’entraînement, en soumettant les prompts d’entraînement.
- Performances hors échantillon, en soumettant de nouveaux prompts ou des prompts réservés à la validation.