

Ceci est un notebook interactif. Vous pouvez l’exécuter localement ou utiliser les liens suivants :
Pourquoi utiliser Weave
Ce tutoriel utilise Weave pour mettre en œuvre et évaluer un pipeline de génération de code. Vous apprendrez à :- Suivre votre pipeline LLM : journalisez les entrées, les sorties et les étapes intermédiaires de votre processus de génération de code.
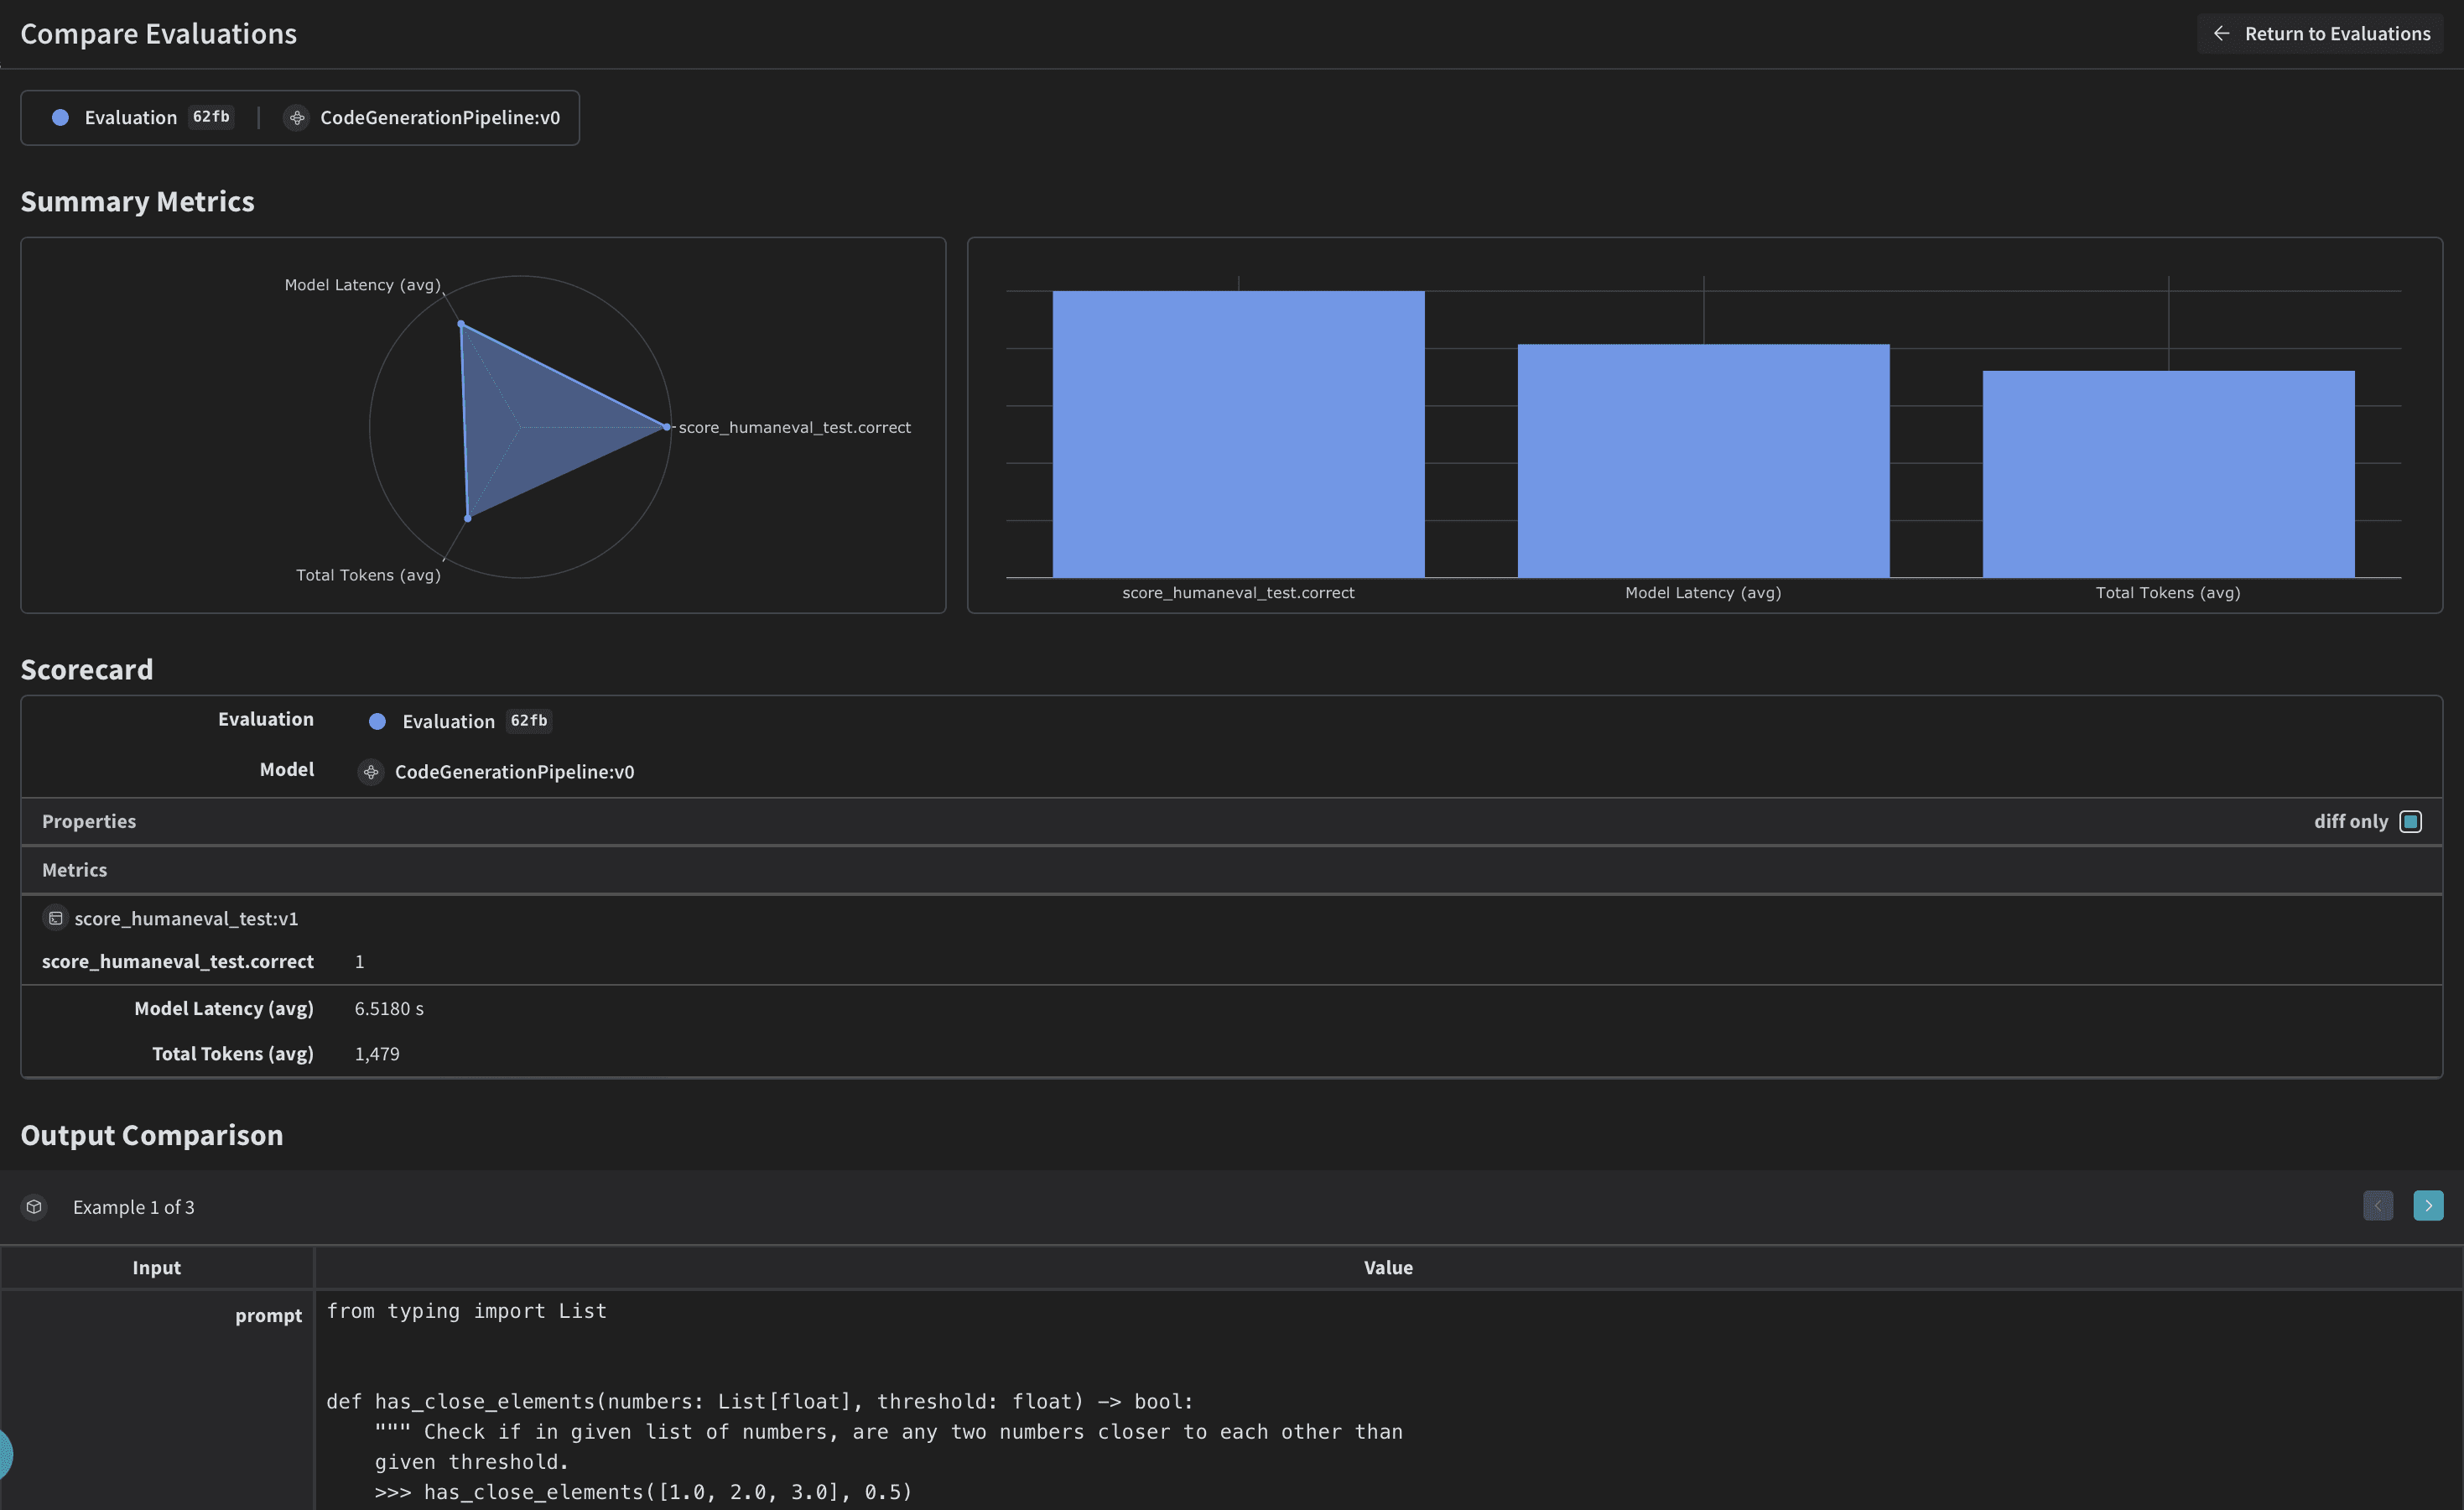
- Évaluer les sorties du LLM : créez et comparez des évaluations du code généré à l’aide d’outils de débogage et de visualisations.
Configurer l’environnement
Configurez votre environnement et importez les bibliothèques nécessaires. Ces dépendances fournissent les outils de mise en forme, le chargeur de dataset ainsi que les clients OpenAI et Weave utilisés tout au long du pipeline.Weave suit automatiquement les appels d’API OpenAI, y compris leurs entrées, leurs sorties et leurs métadonnées. Vous n’avez besoin d’ajouter aucun code de journalisation supplémentaire pour vos interactions avec OpenAI : Weave s’en charge en arrière-plan.
Sorties structurées et modèles Pydantic
Ce pipeline de génération de code utilise le mode de sorties structurées d’OpenAI ainsi que des modèles Pydantic pour obtenir du modèle de langage des réponses cohérentes et bien formatées. Cette approche présente plusieurs avantages :- Sécurité des types : définir des modèles Pydantic pour les sorties attendues permet d’appliquer une structure stricte au code généré, aux runners de programmes et aux tests unitaires.
- Analyse simplifiée : le mode de sorties structurées convertit directement la réponse du modèle en instances des modèles Pydantic prédéfinis, ce qui limite le recours à des post-traitements complexes.
- Fiabilité accrue : en spécifiant précisément le format attendu, vous réduisez le risque que le modèle de langage produise des sorties inattendues ou mal formées.
Implémenter un formateur de code
Pour obtenir du code propre et cohérent, implémentez une classeCodeFormatter à l’aide d’opérations Weave. Ce formateur applique des règles de linting et de style au code généré, au runner du programme et aux tests unitaires.
CodeFormatter fournit plusieurs opérations Weave permettant de nettoyer et de formater le code généré :
- Remplacement des sauts de ligne échappés par de véritables sauts de ligne.
- Suppression des imports et des variables inutilisés.
- Tri des imports.
- Application du formatage PEP 8.
- Ajout des imports manquants.
Définir le CodeGenerationPipeline
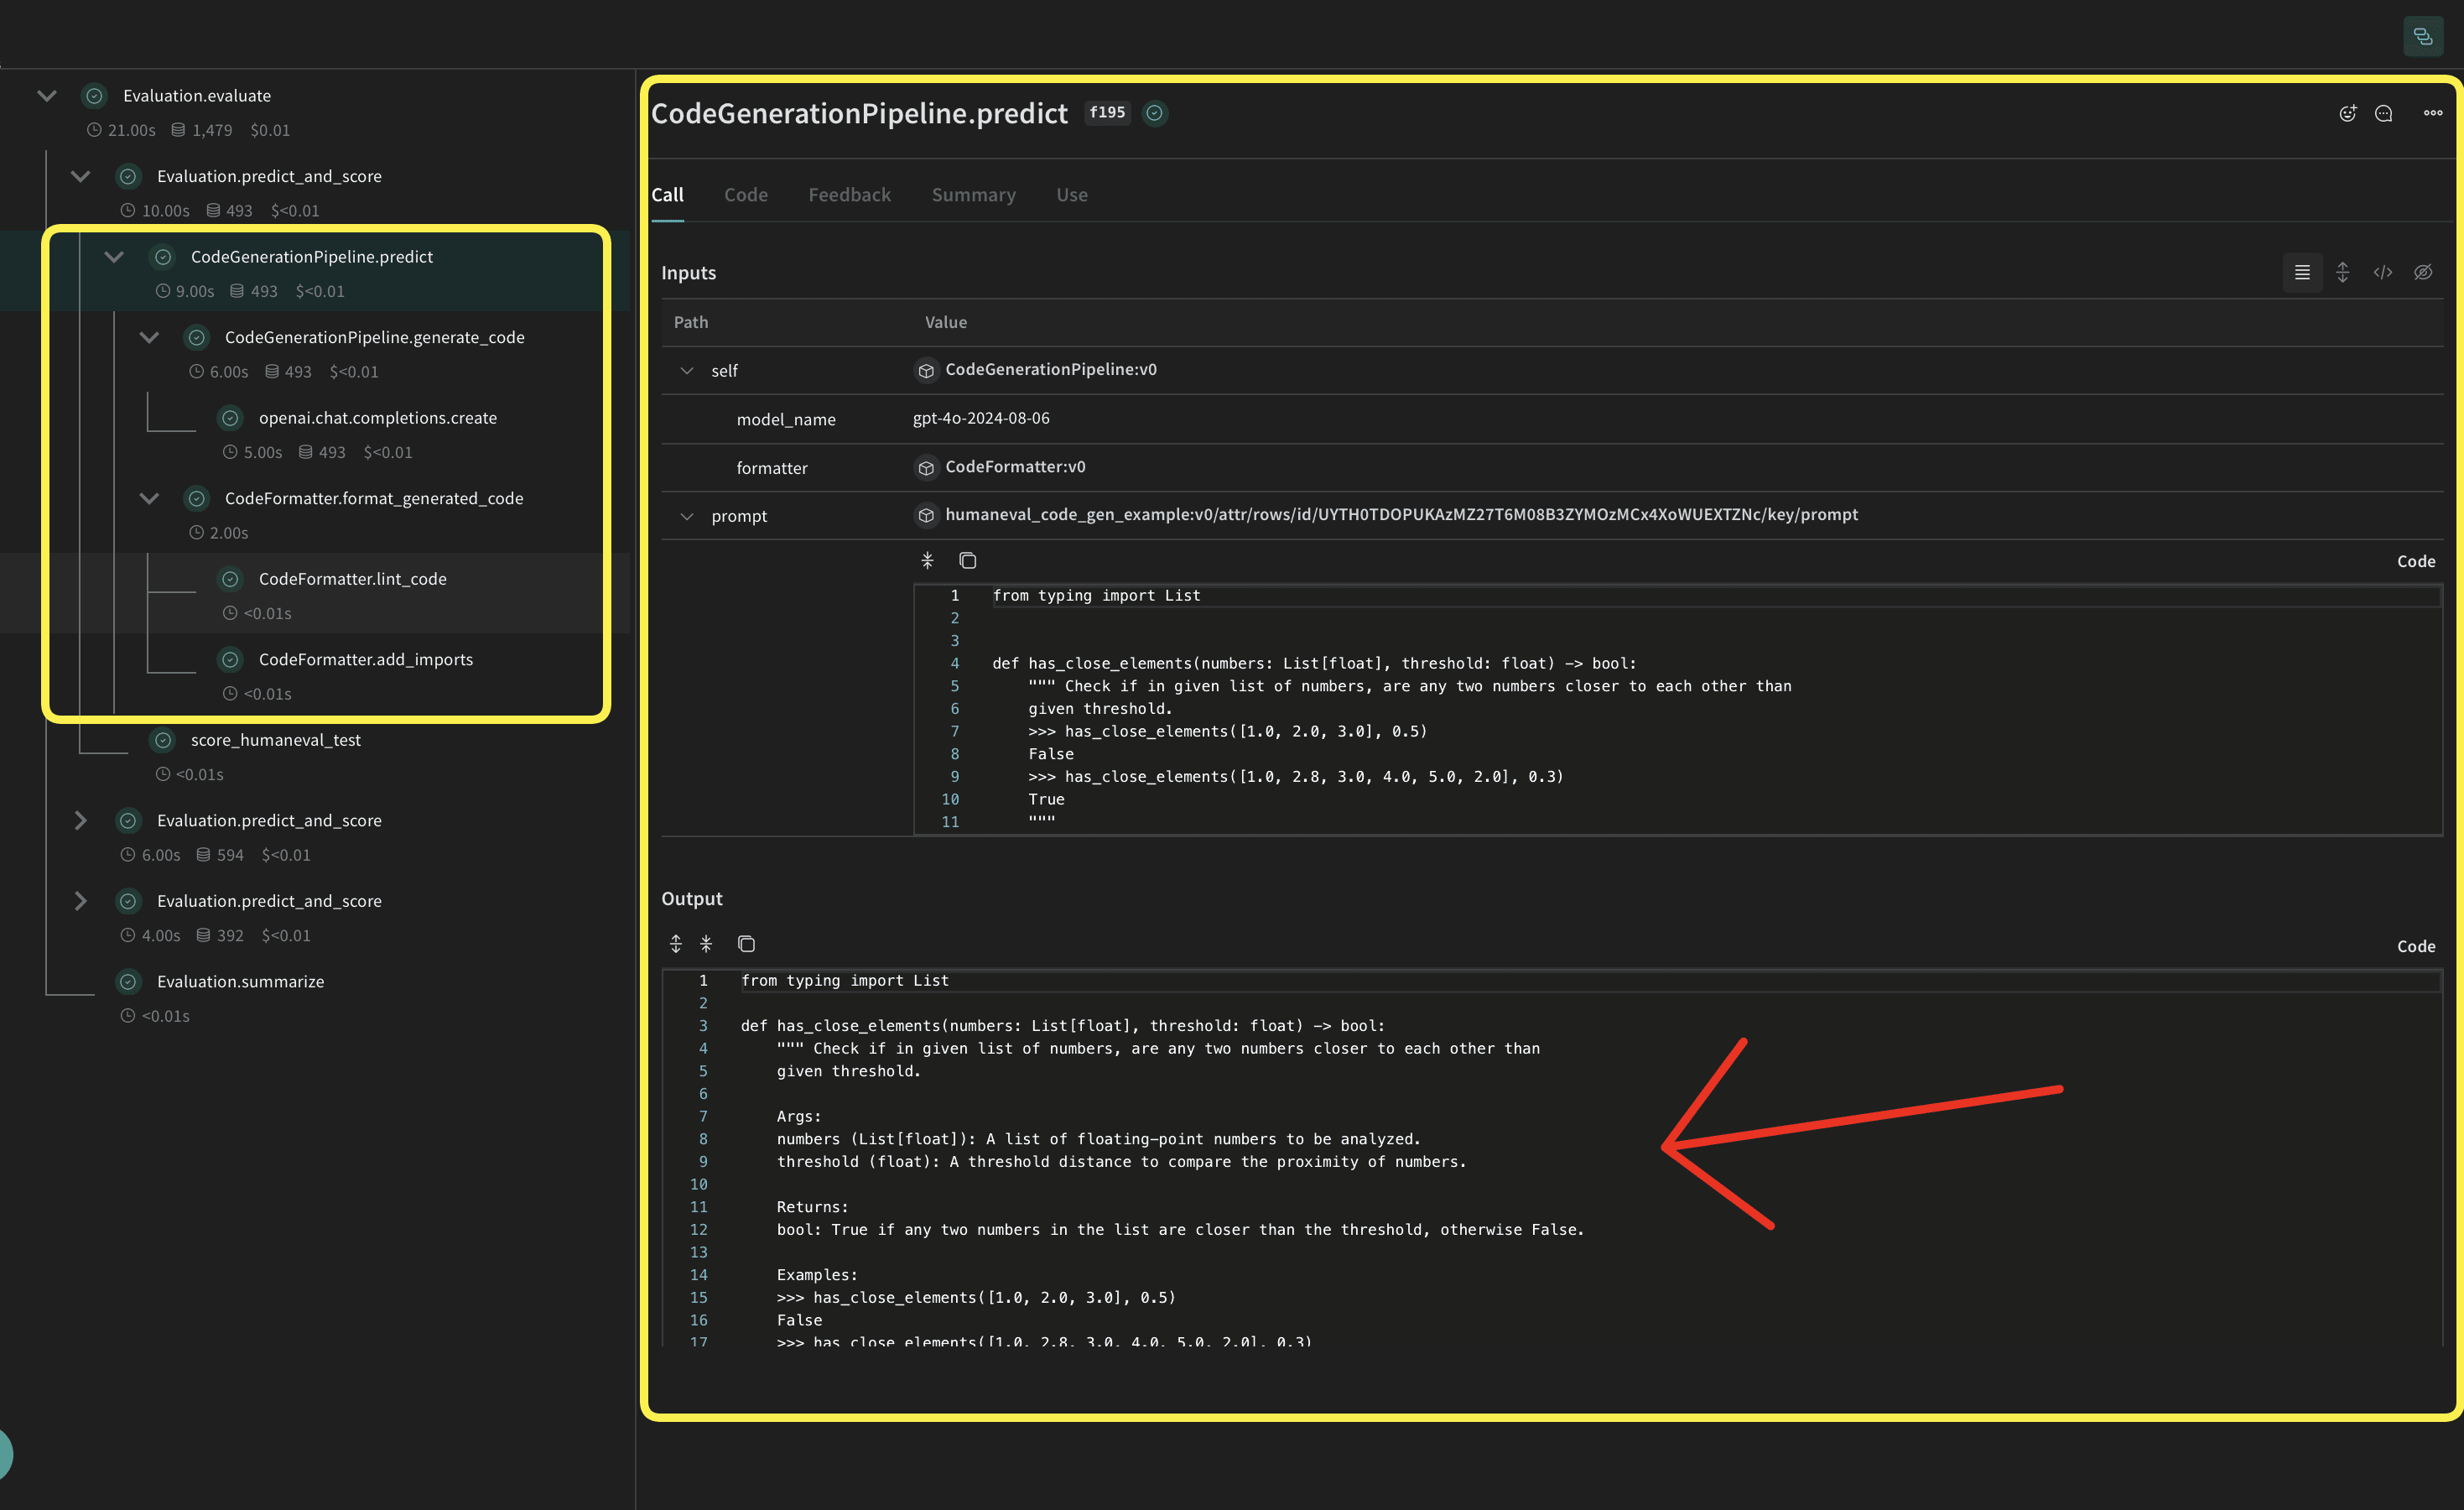
weave.Model afin que le modèle soit automatiquement versionné à chaque modification. Le model_name est défini comme attribut : vous pouvez ainsi l’expérimenter, puis examiner ses différences et le comparer dans Weave. Les appels de fonctions sont suivis avec @weave.op : leurs entrées et leurs sorties sont ainsi journalisées, ce qui facilite le suivi des erreurs et le débogage.
CodeGenerationPipeline encapsule la logique de génération de code sous la forme d’un Weave Model, ce qui présente plusieurs avantages :
- Suivi automatique des expériences : Weave capture les entrées, les sorties et les paramètres de chaque run du modèle.
- Gestion des versions : toute modification des attributs ou du code du modèle est automatiquement versionnée, ce qui constitue un historique de l’évolution de votre pipeline de génération de code au fil du temps.
- Reproductibilité : grâce à la gestion des versions et au suivi, vous pouvez reproduire n’importe quel résultat ou configuration antérieurs de votre pipeline de génération de code.
- Gestion des hyperparamètres : les attributs du modèle (comme
model_name) sont définis et suivis d’un run à l’autre, ce qui facilite l’expérimentation. - Intégration à l’écosystème Weave :
weave.Modelrelie votre pipeline aux autres outils Weave, comme les évaluations et les fonctionnalités de déploiement.
Implémenter des métriques d’évaluation
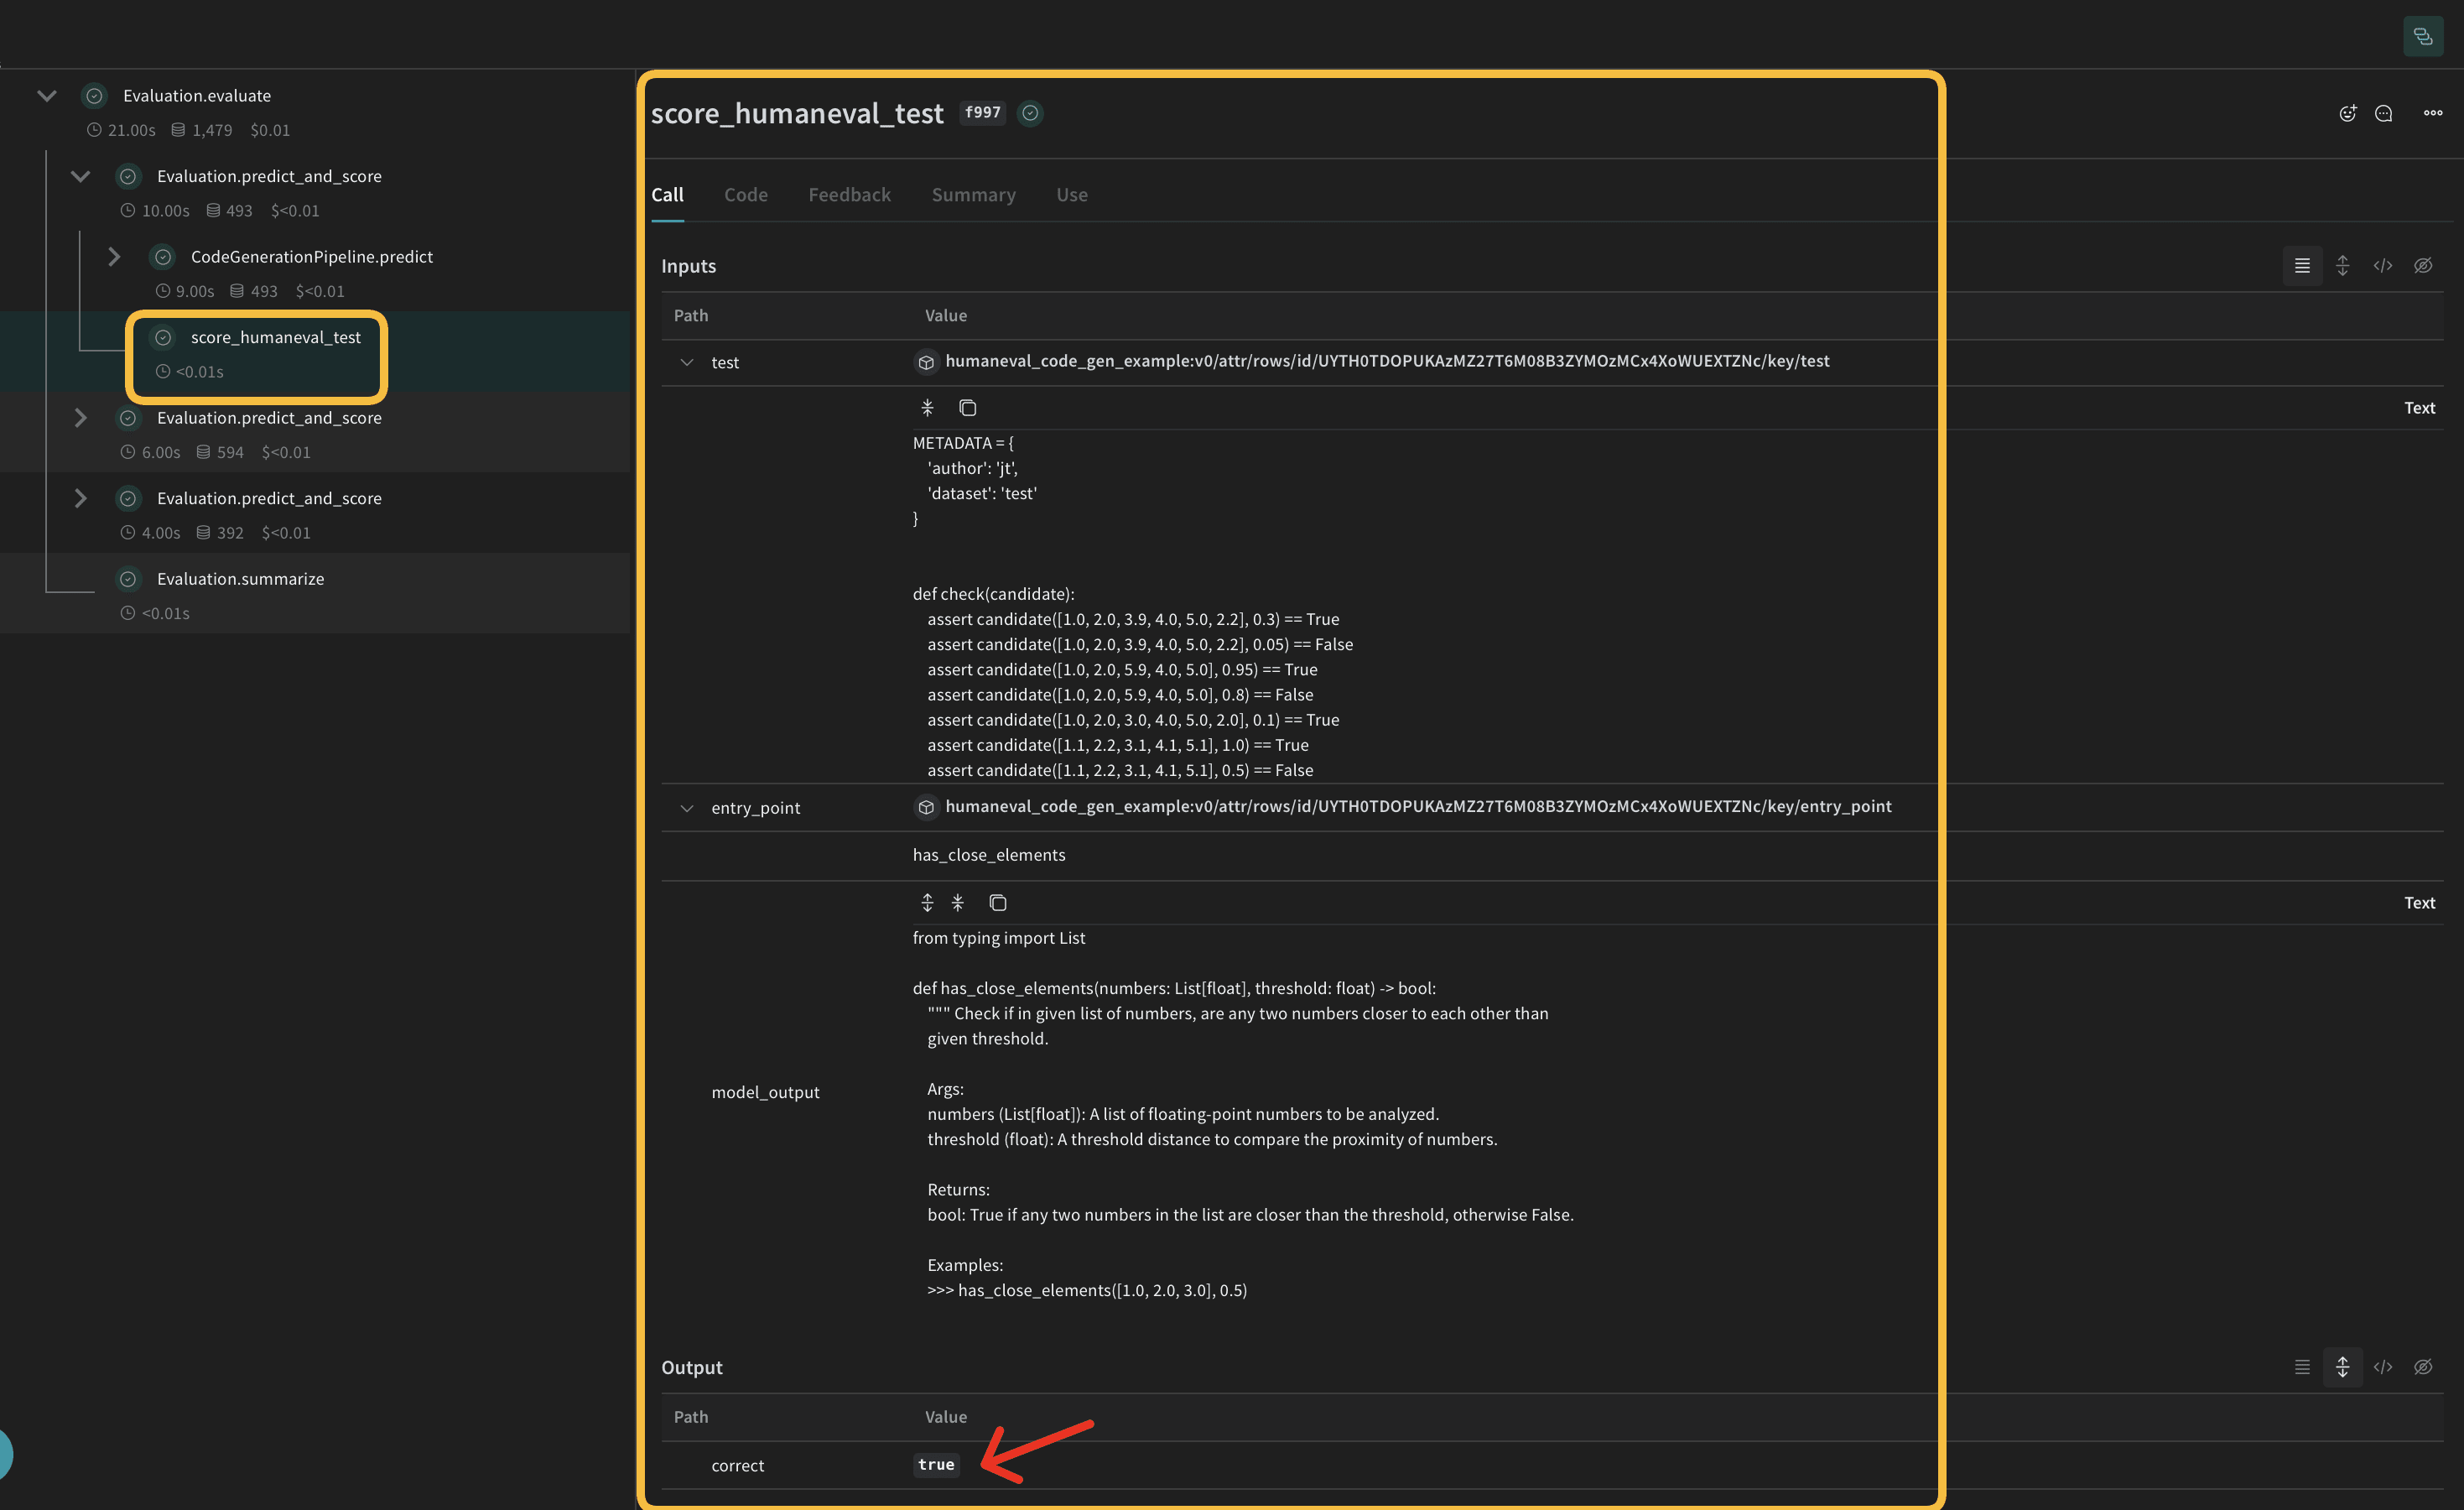
Pour évaluer la qualité du code généré, implémentez des métriques d’évaluation à l’aide d’une sous-classe deweave.Scorer. Celle-ci exécute score sur chaque model_output du dataset. model_output correspond à la sortie de la fonction predict de weave.Model. prompt provient du dataset human-eval.
Créer un dataset Weave et exécuter l’évaluation
Une fois le pipeline et le scorer définis, la dernière étape consiste à constituer le dataset d’évaluation et à exécuter l’évaluation de bout en bout. Pour évaluer le pipeline, créez un dataset Weave et lancez une évaluation :Conclusion
Cet exemple montre comment implémenter un pipeline de génération de code avec Weave et les modèles de langage d’OpenAI. Vous avez appris à :- Créer des opérations Weave pour chaque étape du processus de génération de code.
- Encapsuler le pipeline dans un Weave Model pour simplifier le suivi et l’évaluation.
- Implémenter des métriques d’évaluation personnalisées à l’aide d’opérations Weave.
- Créer un dataset et lancer une évaluation du pipeline.