

Ceci est un notebook interactif. Vous pouvez l’exécuter localement ou utiliser les liens ci-dessous :
Qu’est-ce que la synthèse Chain of Density ?
 Chain of Density (CoD) est une technique de synthèse itérative qui produit des synthèses de plus en plus concises et riches en informations. Elle fonctionne comme suit :
- Partir d’une synthèse initiale
- Affiner la synthèse par itérations successives, en la rendant plus concise tout en conservant les informations clés
- Augmenter la densité d’entités et de détails techniques à chaque itération
Pourquoi utiliser Weave
Dans ce tutoriel, vous allez utiliser Weave pour implémenter et évaluer un pipeline de synthèse Chain of Density appliqué à des articles ArXiv. Vous apprendrez à :- Suivre votre pipeline LLM : utilisez Weave pour consigner automatiquement les entrées, les sorties et les étapes intermédiaires de votre processus de synthèse.
- Évaluer les sorties du LLM : créez des évaluations cohérentes de vos synthèses à l’aide des outils intégrés de Weave.
- Concevoir des opérations composables : combinez et réutilisez des opérations Weave dans différentes parties de votre pipeline de synthèse.
- Intégrer Weave à votre code existant : ajoutez Weave à votre code Python existant avec un minimum d’effort.
Configurer l’environnement
Commencez par configurer l’environnement et importer les bibliothèques nécessaires. Cette étape installe les dépendances requises par le pipeline, notamment Weave pour le suivi, Anthropic pour le LLM et PyPDF2 pour la lecture des PDF d’ArXiv.Pour obtenir une clé API Anthropic :
- Créez un compte sur https://www.anthropic.com.
- Accédez à la section API dans les paramètres de votre compte.
- Générez une nouvelle clé API.
- Enregistrez la clé API de manière sécurisée dans votre fichier
.env.
weave.init([PROJECT_NAME]) crée un nouveau projet Weave pour la tâche de synthèse.
Définir le modèle ArxivPaper
Une fois l’environnement prêt, l’étape suivante consiste à définir la structure de données que traite le pipeline. Créez une classeArxivPaper pour représenter les données :
Charger le contenu des PDF
Le modèleArxivPaper contient des métadonnées et l’URL d’un PDF, mais le pipeline de synthèse a besoin du texte complet de l’article. Pour exploiter l’intégralité de l’article, ajoutez une fonction qui charge les PDF et en extrait le texte :
Implémenter la synthèse Chain of Density
Implémentez maintenant la logique principale de synthèse CoD à l’aide d’opérations Weave :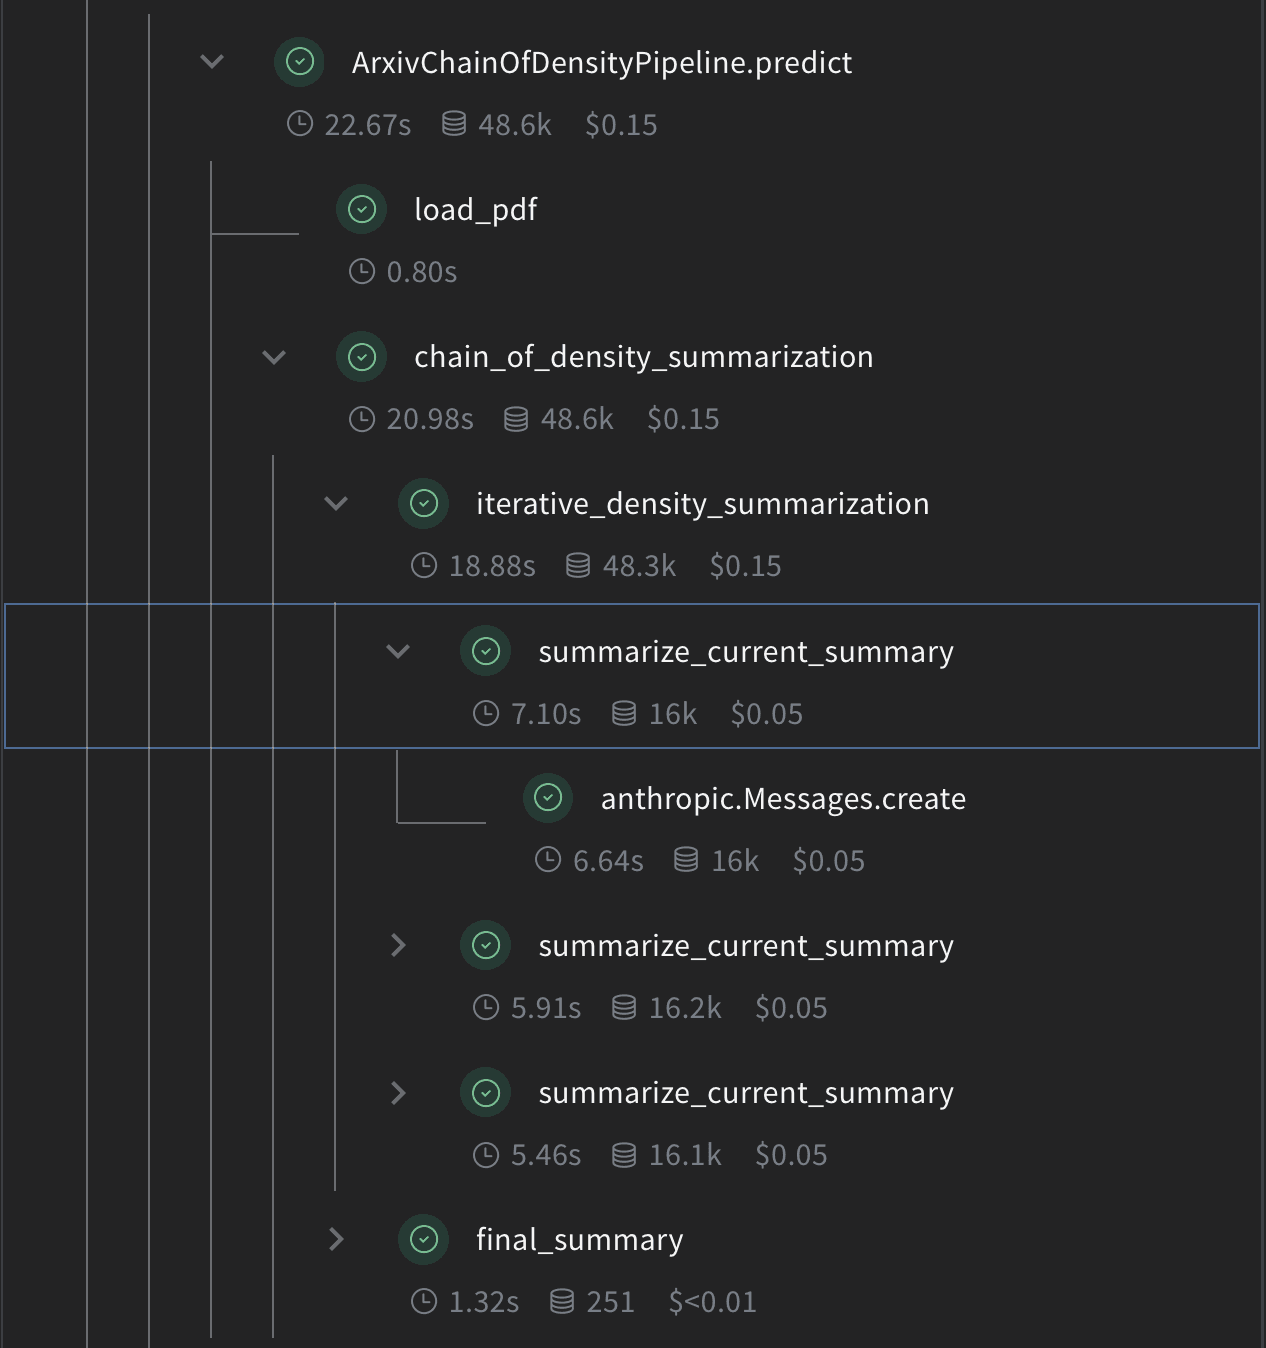
summarize_current_summary: génère une seule itération de synthèse basée sur l’état actuel.iterative_density_summarization: applique la technique CoD en appelant plusieurs foissummarize_current_summary.chain_of_density_summarization: orchestre l’ensemble du processus de synthèse et renvoie les résultats.
@weave.op() garantissent que Weave suit les entrées, les sorties et l’exécution de ces fonctions.
Créer un Weave Model
Une fois les fonctions de synthèse en place, l’étape suivante consiste à les regrouper dans un Weave Model afin de suivre ensemble les runs, les paramètres et les versions. Encapsulez maintenant le pipeline de synthèse dans un Weave Model :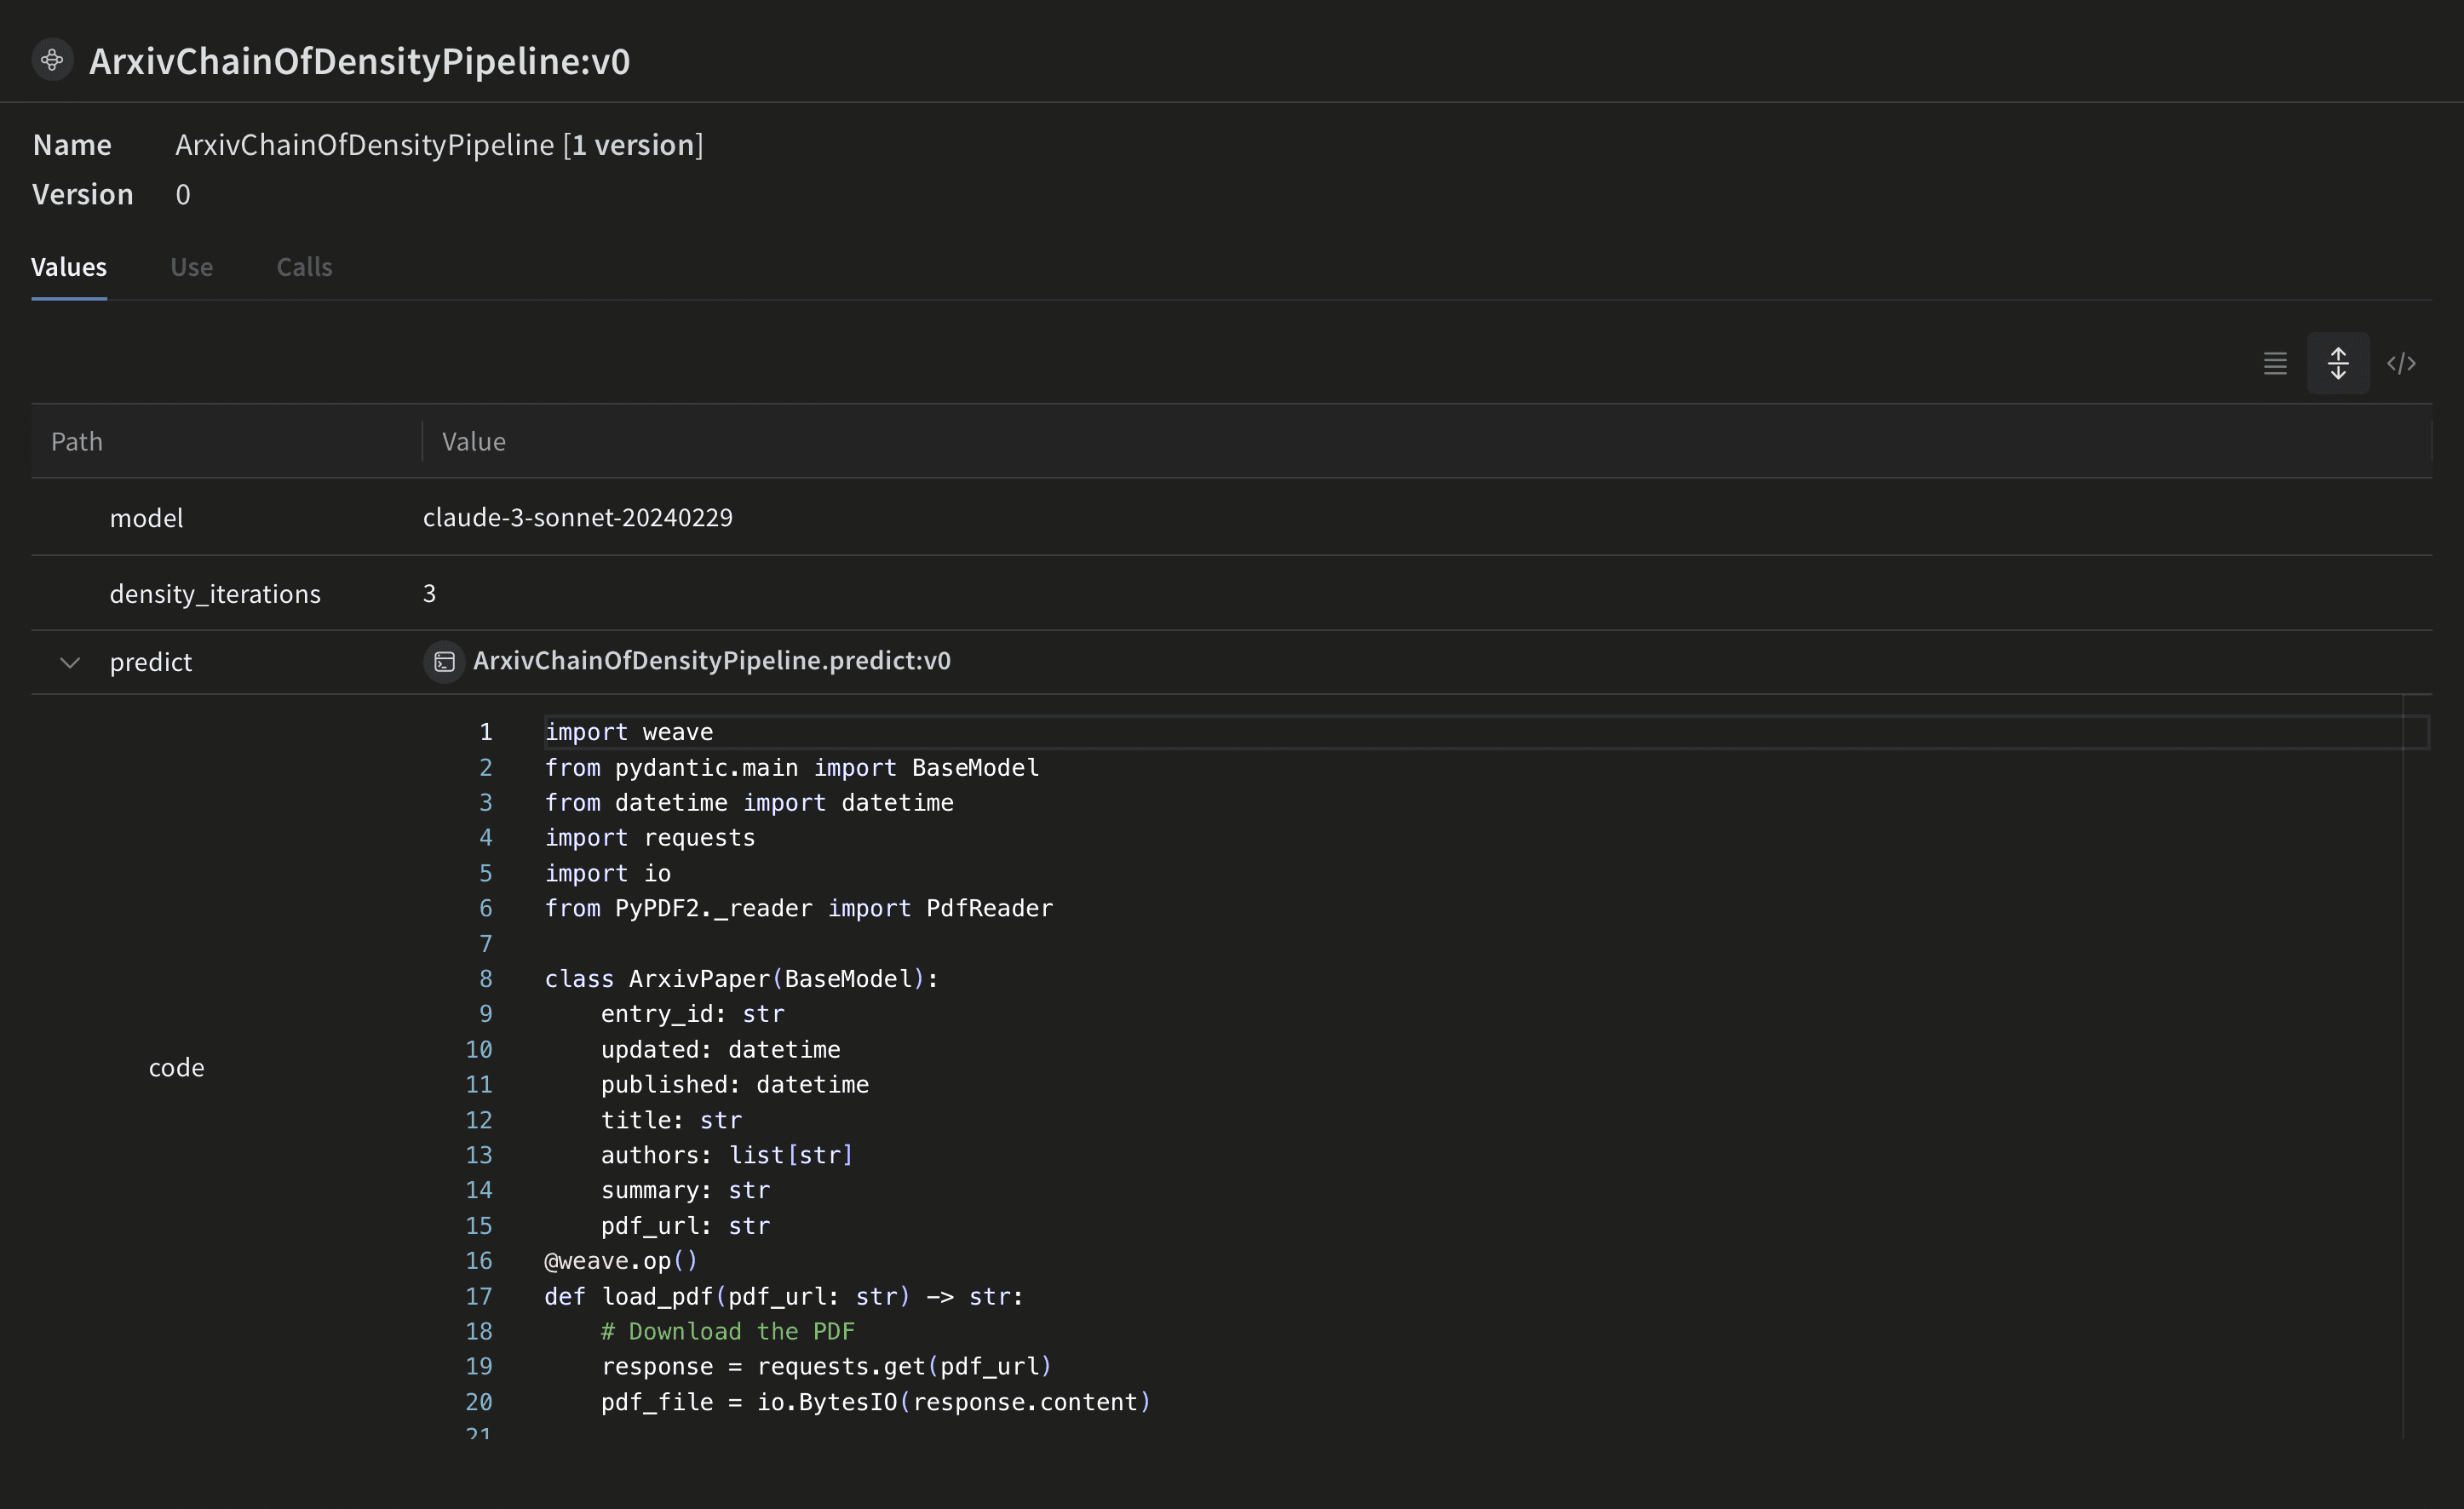
ArxivChainOfDensityPipeline encapsule la logique de synthèse sous forme de Weave Model, ce qui présente plusieurs avantages clés :
- Suivi automatique des expériences : Weave capture les entrées, les sorties et les paramètres de chaque run du modèle.
- Gestion des versions : toute modification des attributs ou du code du modèle est automatiquement versionnée, ce qui fournit un historique clair de l’évolution de votre pipeline de synthèse au fil du temps.
- Reproductibilité : grâce à la gestion des versions et au suivi, vous pouvez reproduire n’importe quel résultat ou n’importe quelle configuration antérieure de votre pipeline de synthèse.
- Gestion des hyperparamètres : les attributs du modèle (comme
modeletdensity_iterations) sont clairement définis et suivis d’un run à l’autre, ce qui facilite l’expérimentation. - Intégration à l’écosystème Weave :
weave.Models’utilise avec les autres outils Weave, comme les évaluations et les fonctionnalités de mise en service.
Implémenter des métriques d’évaluation
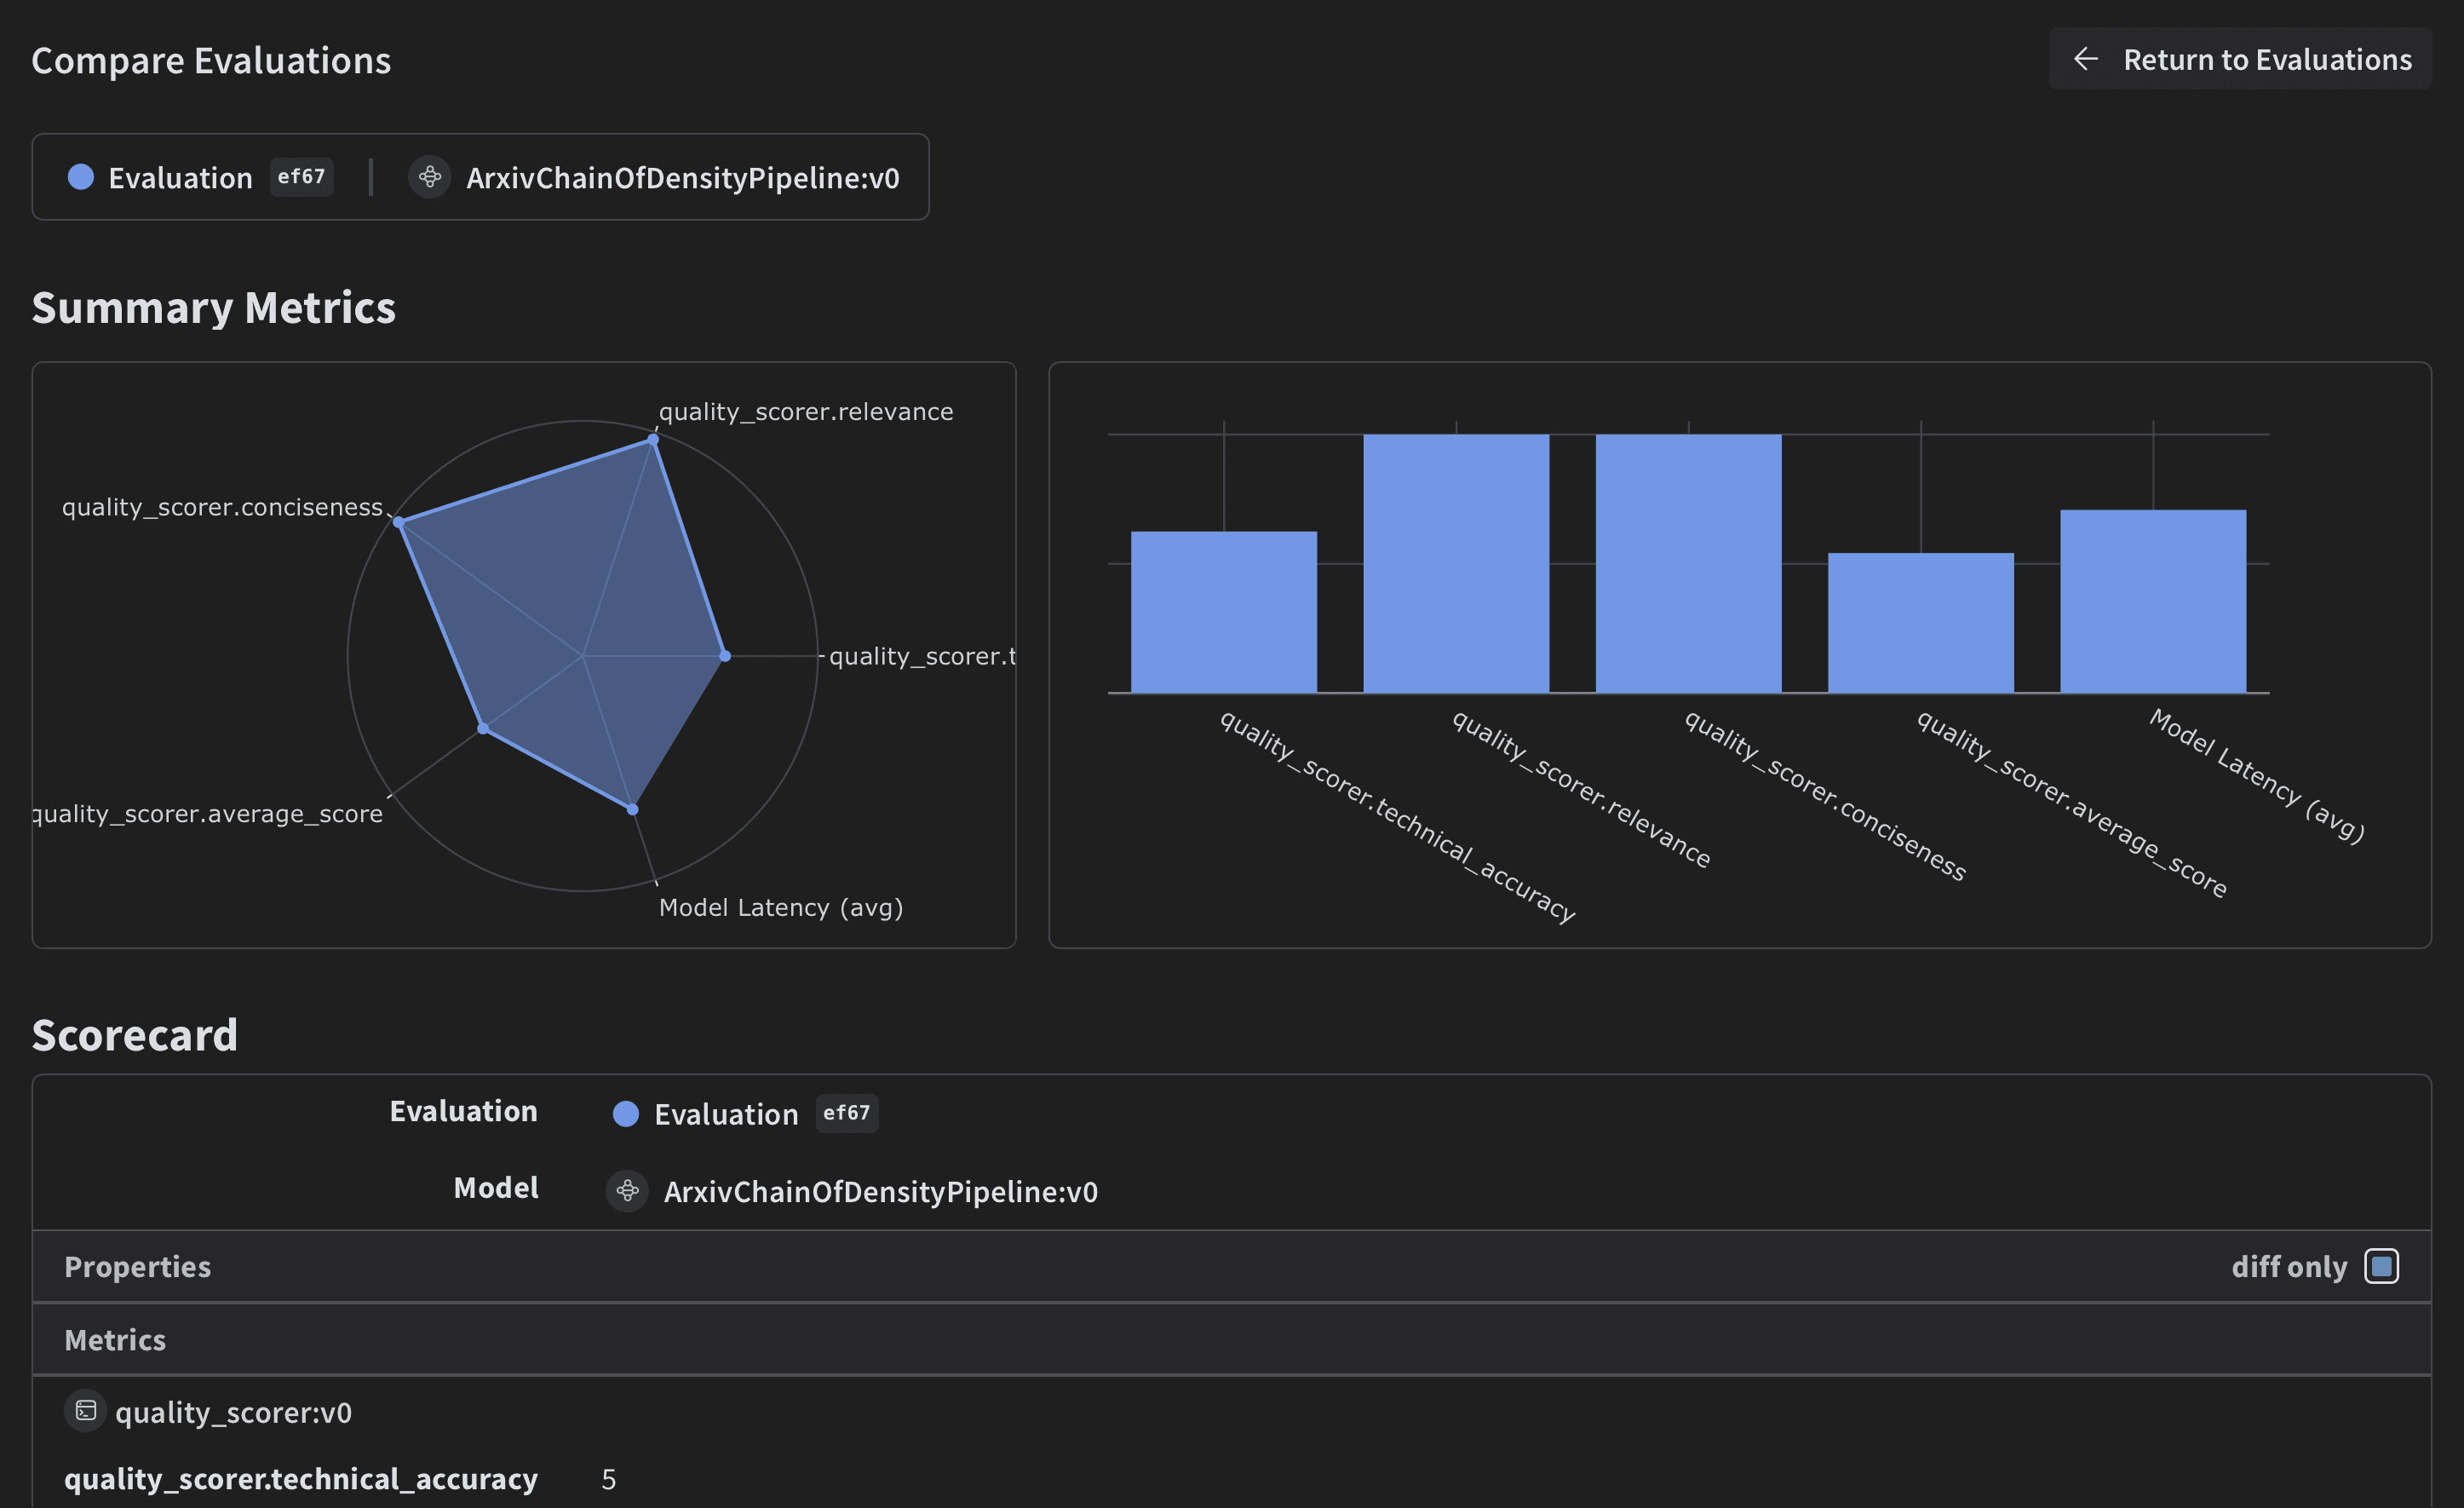
Maintenant que le pipeline produit des synthèses, il vous faut un moyen de mesurer systématiquement leur qualité. Pour évaluer la qualité des synthèses, implémentez des métriques d’évaluation simples :Créer un dataset Weave et exécuter l’évaluation
Maintenant que la fonction de score est définie, il ne reste plus qu’à l’appliquer à des exemples d’entrées et à exécuter l’évaluation. Pour évaluer le pipeline, créez un dataset Weave et lancez une évaluation :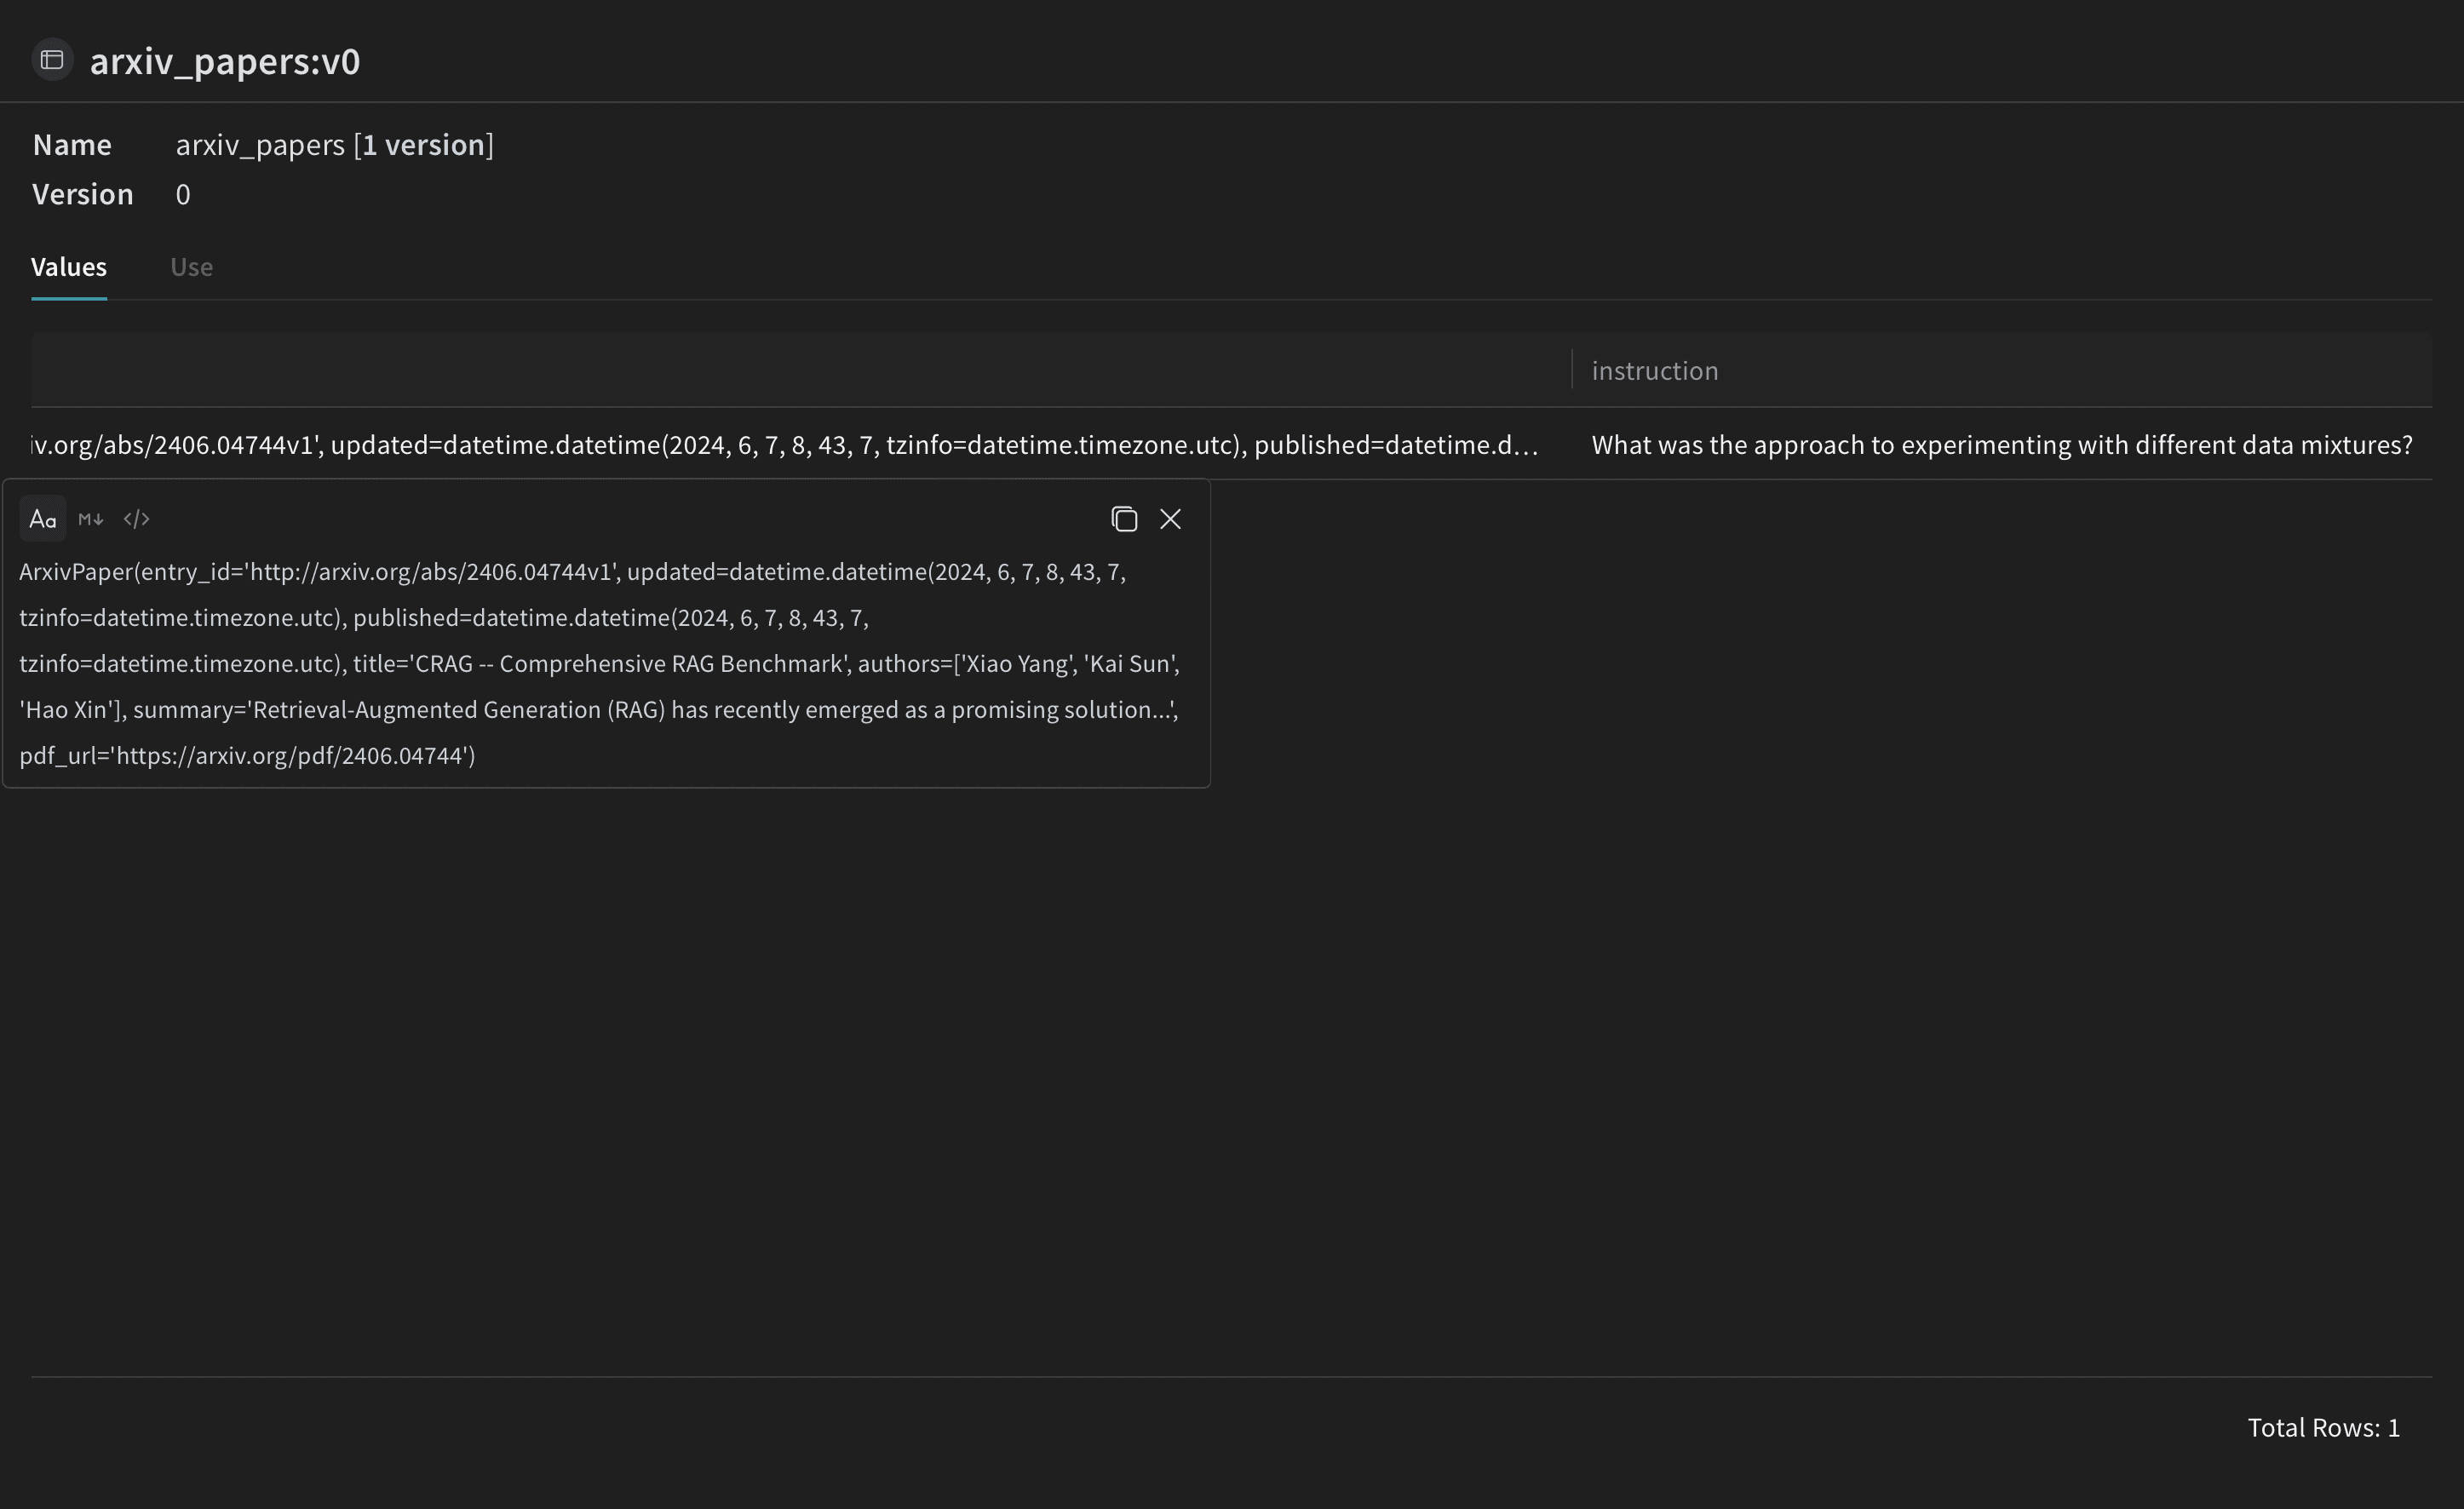

Conclusion
Cet exemple a montré comment implémenter un pipeline de synthèse Chain of Density pour des articles ArXiv à l’aide de Weave. Vous avez appris à :- Créer des opérations Weave pour chaque étape du processus de synthèse
- Encapsuler le pipeline dans un Weave Model pour le suivi et l’évaluation
- Implémenter des métriques d’évaluation personnalisées à l’aide d’opérations Weave
- Créer un dataset et lancer une évaluation du pipeline