> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Serverless Inference
> Weave로 Serverless Inference를 사용하여 OpenAI 호환 API를 통해 오픈 소스 파운데이션 모델 Call을 트레이스하고 모니터링하세요.
Serverless Inference
\_Serverless Inference\_는 W\&B Weave와 OpenAI 호환 API를 통해 오픈 소스 파운데이션 모델에 대한 액세스를 제공합니다. 이 가이드에서는 API와 Weights & Biases UI에서 Serverless Inference를 호출하는 방법과 Weave로 해당 Call을 추적, 평가, 모니터링하는 방법을 설명합니다. Serverless Inference로 다음 작업을 수행할 수 있습니다:
* 호스팅 공급자에 가입하거나 모델을 직접 호스팅하지 않고 AI 애플리케이션과 에이전트를 개발합니다.
* Weave 플레이그라운드에서 지원되는 모델을 사용해 봅니다.
한시적으로 Free, Pro, Academic 플랜에 Serverless Inference 크레딧이 포함됩니다. Enterprise에서는 제공 여부가 다를 수 있습니다. 크레딧을 모두 사용한 후에는:
* Free 계정은 Inference를 계속 사용하려면 Pro 플랜으로 업그레이드해야 합니다.
* Pro 플랜 사용자는 모델별 가격에 따라 Inference 초과 사용량에 대해 매월 요금이 청구됩니다.
자세한 내용은 [가격 페이지](https://coreweave.com/forge-pricing)와 [Serverless Inference 모델 비용](https://wandb.ai/site/pricing/inference)을 참조하세요.
Weave를 사용하면 Serverless Inference 기반 애플리케이션을 추적, 평가, 모니터링하고 반복적으로 개선할 수 있습니다.
| 모델 | 모델 ID (API 사용 시) | 유형 | 컨텍스트 윈도우 | 매개변수 | 설명 |
| - | - | - | - | - | - |
| DeepSeek R1-0528 | deepseek-ai/DeepSeek-R1-0528 | 텍스트 | 161K | 37B - 680B (활성 - 전체) | 복잡한 코딩, 수학, 구조화된 문서 분석 등 정밀한 추론 작업에 최적화되어 있습니다. |
| DeepSeek V3-0324 | deepseek-ai/DeepSeek-V3-0324 | 텍스트 | 161K | 37B - 680B (활성 - 전체) | 고난도 언어 처리와 종합적인 문서 분석에 특화된 강력한 전문가 혼합(Mixture-of-Experts) 모델입니다. |
| Llama 3.1 8B | meta-llama/Llama-3.1-8B-Instruct | 텍스트 | 128K | 8B (전체) | 응답성이 뛰어난 다국어 챗봇 상호작용에 최적화된 효율적인 대화형 모델입니다. |
| Llama 3.3 70B | meta-llama/Llama-3.3-70B-Instruct | 텍스트 | 128K | 70B (전체) | 대화 작업, 세부 지시 이행, 코딩에 뛰어난 다국어 모델입니다. |
| Llama 4 Scout | meta-llama/Llama-4-Scout-17B-16E-Instruct | 텍스트, 비전 | 64K | 17B - 109B (활성 - 전체) | 텍스트와 이미지 이해를 통합한 멀티모달 모델로, 시각적 작업과 복합 분석에 적합합니다. |
| Phi 4 Mini | microsoft/Phi-4-mini-instruct | 텍스트 | 128K | 3.8B (활성 - 전체) | 리소스가 제한된 환경에서 빠른 응답을 제공하기에 적합한 작고 효율적인 모델입니다. |
이 가이드에서는 다음 정보를 제공합니다:
* [사전 요구 사항](#prerequisites)
* [Python으로 API를 사용하기 위한 추가 사전 요구 사항](#additional-prerequisites-for-using-the-api-via-python)
* [API 사양](#api-specification)
* [엔드포인트](#endpoint)
* [사용 가능한 메서드](#available-methods)
* [Chat Completion](#chat-completions)
* [지원되는 모델 목록](#list-supported-models)
* [사용 예시](#usage-examples)
* [UI](#ui)
* [Inference 서비스 액세스](#access-the-inference-service)
* [플레이그라운드에서 모델 사용해 보기](#try-a-model-in-the-playground)
* [여러 모델 비교](#compare-multiple-models)
* [결제 및 사용 정보 보기](#view-billing-and-usage-information)
* [사용 정보 및 제한](#usage-information-and-limits)
* [API 오류](#api-errors)
사전 요구 사항
Serverless Inference 서비스에 API 또는 Weights & Biases UI를 통해 액세스하려면 다음이 필요합니다:
1. CoreWeave Forge 계정. [계정에 가입하세요](https://id.coreweave.com/signup).
2. API 키. [User Settings](https://forge.coreweave.com/settings)에서 API 키를 생성하세요.
3. Weights & Biases 프로젝트.
4. Python을 통해 Inference 서비스를 사용하는 경우, [Python에서 API를 사용하기 위한 추가 사전 요구 사항](#additional-prerequisites-for-using-the-api-via-python)을 참조하세요.
Python에서 API를 사용하기 위한 추가 사전 요구 사항
Python에서 Inference API를 사용하려면 먼저 일반 사전 요구 사항을 완료하세요. 그런 다음 로컬 환경에 `openai` 및 `weave` 라이브러리를 설치하세요. `openai` 라이브러리는 Inference 엔드포인트를 호출하는 데 사용하는 OpenAI 호환 클라이언트를 제공하며, `weave` 라이브러리로는 이러한 Call을 트레이스하고 평가할 수 있습니다.
```bash theme={"system"}
pip install openai weave
```
`weave` 라이브러리는 Weave를 사용하여 LLM application을 트레이스할 때만 필요합니다. Weave 시작에 대한 정보는 [Weave 퀵스타트](/ko/products/wandb/weave/quickstart)를 참조하세요.
Weave로 Serverless Inference 서비스를 사용하는 방법을 보여주는 사용 예시는 [API 사용 예시](#usage-examples)를 참조하세요.
API 사양
다음 섹션에서는 API 사양 정보와 API 사용 예시를 제공하므로, Inference 서비스를 자체 애플리케이션이나 스크립트에서 프로그래밍 방식으로 호출할 수 있습니다.
* [엔드포인트](#endpoint)
* [사용 가능한 메서드](#available-methods)
* [사용 예시](#usage-examples)
엔드포인트
다음 엔드포인트를 통해 Inference 서비스에 액세스하세요:
```plaintext theme={"system"}
https://api.inference.wandb.ai/v1
```
이 엔드포인트에 액세스하려면 Inference 서비스 크레딧이 할당된 CoreWeave Forge 계정, 유효한 API 키, CoreWeave Forge entity("팀"이라고도 함) 및 프로젝트가 있어야 합니다. 이 가이드의 코드 예제에서는 entity(팀)와 프로젝트를 `/`로 표기합니다.
사용 가능한 메서드
Inference 서비스는 다음 API 메서드를 지원합니다:
* [Chat Completion](#chat-completions)
* [지원되는 모델 목록](#list-supported-models)
Chat Completion
주요 API 방법은 `/chat/completions`이며, 지원되는 모델에 메시지를 보내고 Chat Completion을 받기 위한 OpenAI 호환 요청 형식을 지원합니다. Weave로 Serverless Inference 서비스를 사용하는 방법을 보여 주는 사용 예시는 [API 사용 예시](#usage-examples)를 참조하세요.
Chat Completion을 생성하려면 다음이 필요합니다:
* Inference 서비스의 기본 URL `https://api.inference.wandb.ai/v1`
* W\&B API 키 ``
* W\&B entity 및 프로젝트 이름 `/`
* 사용할 모델의 ID로, 다음 중 하나:
* `meta-llama/Llama-3.1-8B-Instruct`
* `deepseek-ai/DeepSeek-V3-0324`
* `meta-llama/Llama-3.3-70B-Instruct`
* `deepseek-ai/DeepSeek-R1-0528`
* `meta-llama/Llama-4-Scout-17B-16E-Instruct`
* `microsoft/Phi-4-mini-instruct`
```bash theme={"system"}
curl https://api.inference.wandb.ai/v1/chat/completions \
-H "Content-Type: application/json" \
-H "Authorization: Bearer " \
-H "OpenAI-Project: /" \
-d '{
"model": "",
"messages": [
{ "role": "system", "content": "You are a helpful assistant." },
{ "role": "user", "content": "Tell me a joke." }
]
}'
```
```python lines theme={"system"}
import openai
client = openai.OpenAI(
# 맞춤형 기본 URL은 Serverless Inference를 가리킵니다
base_url='https://api.inference.wandb.ai/v1',
# https://forge.coreweave.com/settings 에서 API 키를 생성하세요
# 안전을 위해 환경에 OPENAI_API_KEY로 설정하는 것을 고려하세요
api_key="",
# 사용량 추적에는 팀과 프로젝트가 필요합니다
project="/",
)
# 를 다음 값 중 하나로 바꾸세요:
# meta-llama/Llama-3.1-8B-Instruct
# deepseek-ai/DeepSeek-V3-0324
# meta-llama/Llama-3.3-70B-Instruct
# deepseek-ai/DeepSeek-R1-0528
# meta-llama/Llama-4-Scout-17B-16E-Instruct
# microsoft/Phi-4-mini-instruct
response = client.chat.completions.create(
model="",
messages=[
{"role": "system", "content": ""},
{"role": "user", "content": ""}
],
)
print(response.choices[0].message.content)
```
지원되는 모델 목록
API를 사용하여 사용 가능한 모든 모델과 해당 ID를 쿼리하세요. 이는 모델을 동적으로 선택하거나 환경에서 사용 가능한 항목을 검사하는 데 유용합니다.
```bash theme={"system"}
curl https://api.inference.wandb.ai/v1/models \
-H "Content-Type: application/json" \
-H "Authorization: Bearer " \
-H "OpenAI-Project: /" \
```
```python lines theme={"system"}
import openai
client = openai.OpenAI(
base_url="https://api.inference.wandb.ai/v1",
api_key="",
project="/"
)
response = client.models.list()
for model in response.data:
print(model.id)
```
사용 예시
다음 섹션에서는 Weave로 Serverless Inference를 사용하는 방법을 보여주는 여러 예시를 제공합니다. 기본 예시에서 단일 모델 Call을 트레이싱한 다음, 고급 예시에서 여러 모델을 평가하고 비교하세요.
* [기본 예시: Weave로 Llama 3.1 8B 트레이싱](#basic-example-trace-llama-31-8b-with-weave)
* [고급 예시: Inference 서비스에서 Weave Evaluations 및 Leaderboards 사용](#advanced-example-use-weave-evaluations-and-leaderboards-with-the-inference-service)
기본 예시: Weave로 Llama 3.1 8B 트레이스
다음 Python 코드 샘플은 Serverless Inference API를 사용하여 **Llama 3.1 8B** 모델에 프롬프트를 전송하고 Weave에서 Call을 트레이스하는 방법을 보여줍니다. 트레이싱을 통해 LLM Call의 전체 입력과 출력을 캡처하고, 성능을 모니터링하며, Weights & Biases UI에서 결과를 분석할 수 있습니다.
[Weave의 트레이싱](/ko/products/wandb/weave/guides/tracking/tracing)에 대해 자세히 알아보세요.
이 예제에서는:
* `@weave.op()`로 데코레이션된 `run_chat` 함수를 정의하며, 이 함수는 OpenAI 호환 클라이언트를 사용하여 Chat Completion 요청을 수행합니다.
* Weave는 트레이스를 기록하고 W\&B entity 및 `project="/"` 프로젝트와 연결합니다.
* Weave는 함수를 자동으로 트레이스하여 입력, 출력, 지연 시간, 메타데이터(예: 모델 ID)를 로깅합니다.
* 결과는 터미널에 출력되며, 트레이스는 지정된 프로젝트 아래 [Forge](https://forge.coreweave.com/wandb)의 **Traces** 탭에 표시됩니다.
이 예제를 사용하려면 [일반 사전 요구 사항](#prerequisites)과 [Python으로 API를 사용하기 위한 추가 사전 요구 사항](#additional-prerequisites-for-using-the-api-via-python)을 완료해야 합니다.
```python lines theme={"system"}
import weave
import openai
# 트레이싱을 위해 Weave 팀과 프로젝트를 설정하세요
weave.init("/")
client = openai.OpenAI(
base_url='https://api.inference.wandb.ai/v1',
# https://forge.coreweave.com/settings 에서 API 키를 생성하세요
api_key="",
# W&B Inference 사용량 추적에 필요합니다
project="wandb/inference-demo",
)
# Weave에서 모델 Call을 트레이스하세요
@weave.op()
def run_chat():
response = client.chat.completions.create(
model="meta-llama/Llama-3.1-8B-Instruct",
messages=[
{"role": "system", "content": "You are a helpful assistant."},
{"role": "user", "content": "Tell me a joke."}
],
)
return response.choices[0].message.content
# 트레이스된 호출을 실행하고 로깅하세요
output = run_chat()
print(output)
```
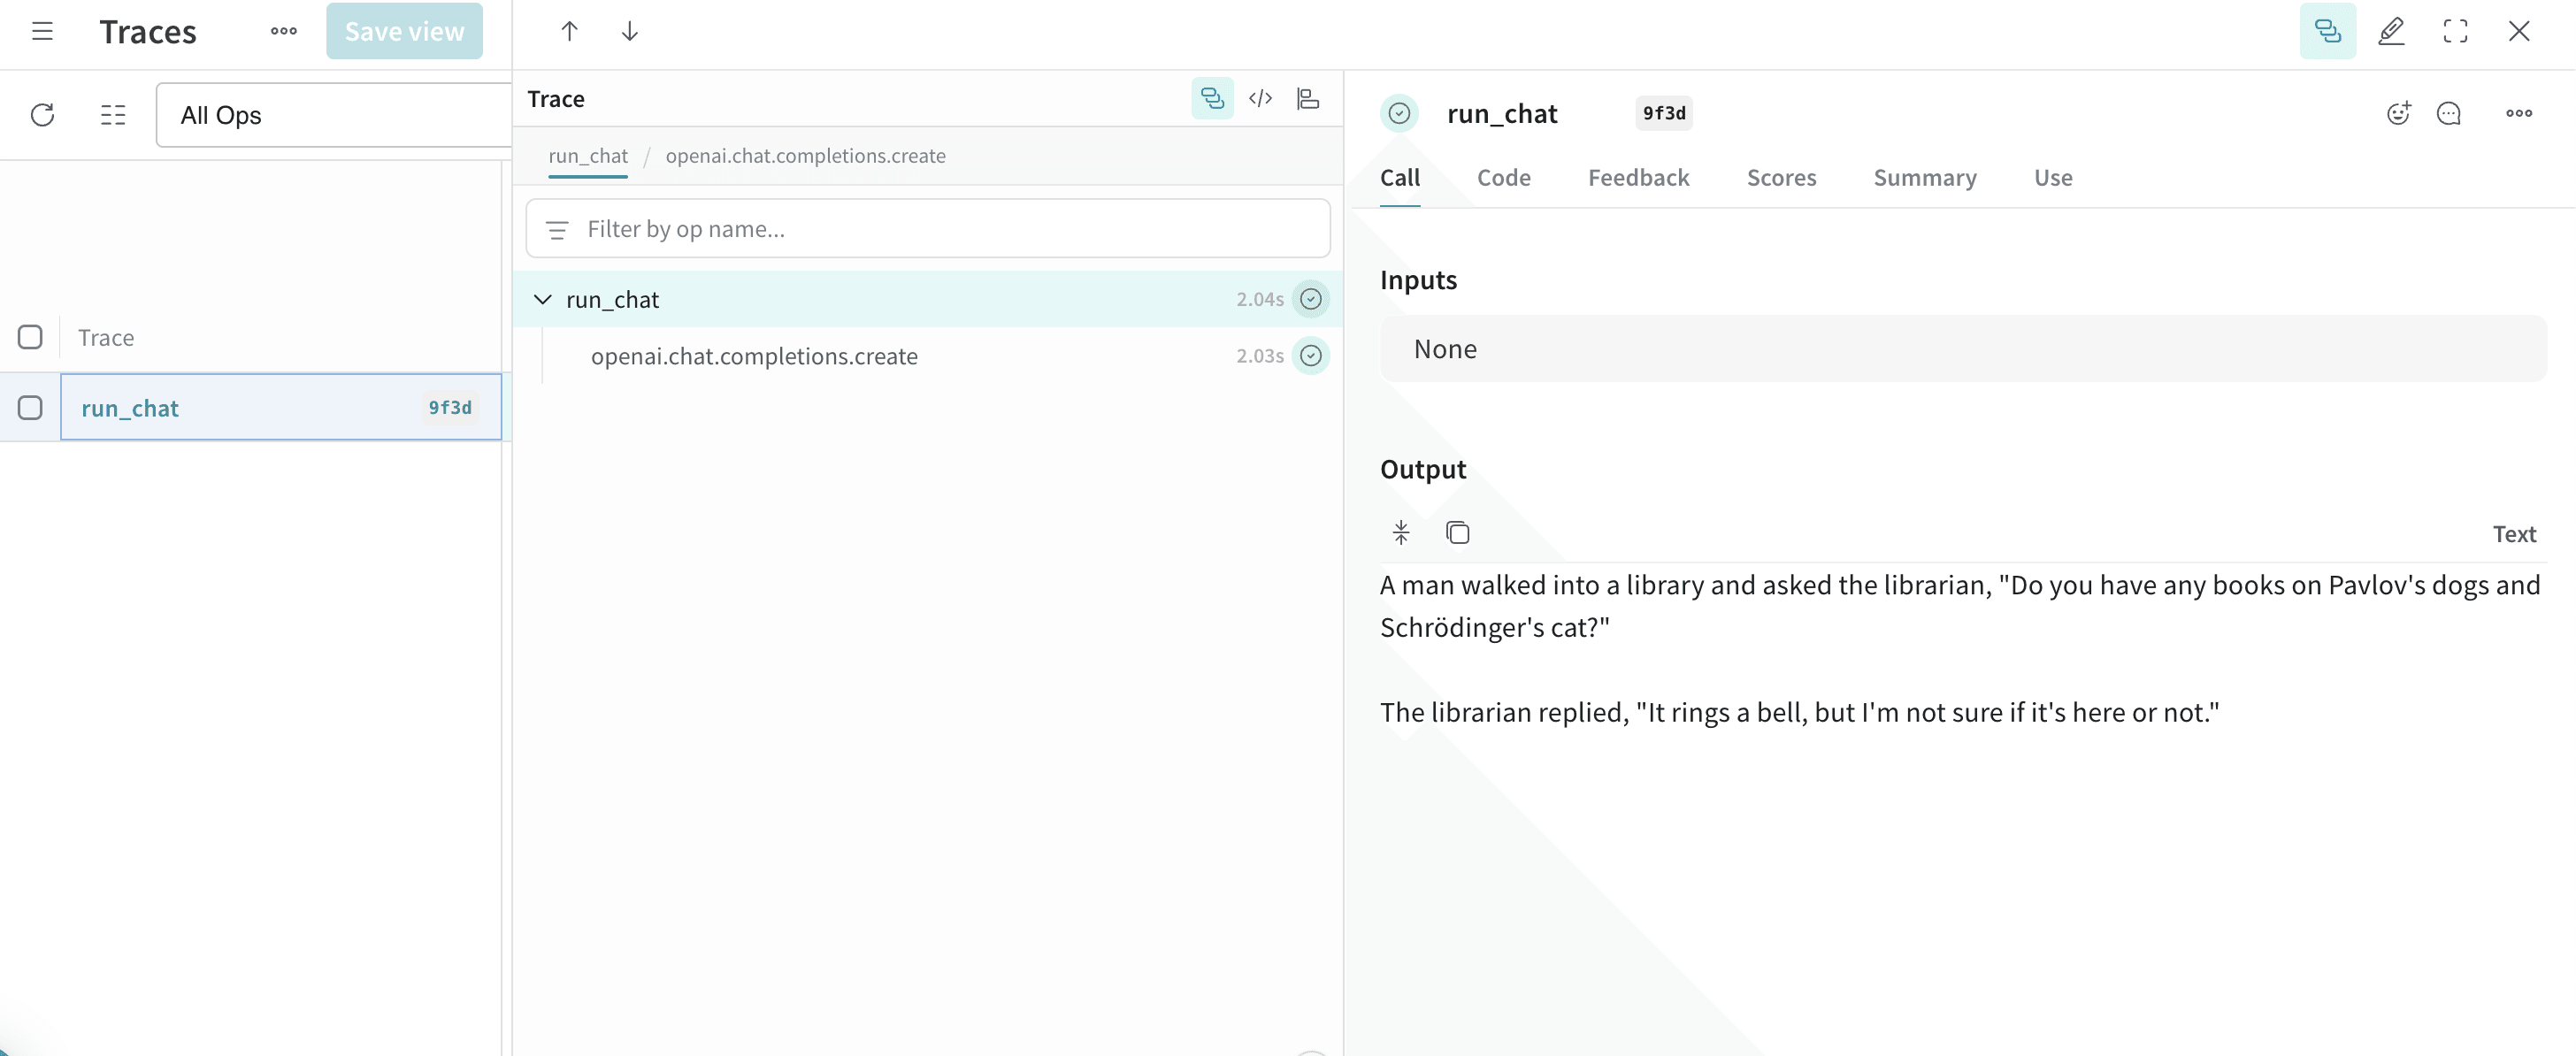
코드 샘플을 실행하면 모델 응답이 터미널에 출력되고 Call이 Weave 트레이스로 로깅됩니다. Weave에서 트레이스를 보려면 터미널에 출력된 링크(예: `https://forge.coreweave.com/wandb///r/call/01977f8f-839d-7dda-b0c2-27292ef0e04g`)를 클릭하거나:
1. [Forge](https://forge.coreweave.com/wandb)로 이동합니다.
2. Weave 트레이스를 보려면 **Traces** 탭을 선택합니다.
다음으로 [고급 예시](#advanced-example-use-weave-evaluations-and-leaderboards-with-the-inference-service)를 사용해 여러 모델을 평가하고 비교해 보세요.
고급 예시: Inference 서비스에서 Weave Evaluations 및 Leaderboards 사용하기
또한 Inference 서비스에서 Weave를 사용하여 [모델 Call을 트레이스](/ko/products/wandb/weave/guides/tracking/tracing)하고, [성능을 평가](/ko/products/wandb/weave/guides/core-types/evaluations)하고, [leaderboard를 게시](/ko/products/wandb/weave/guides/core-types/leaderboards)할 수 있습니다. 다음 Python 코드 샘플은 질의응답 데이터셋으로 두 모델을 비교합니다.
이 예제를 사용하려면 [일반 사전 요구 사항](#prerequisites)과 [Python에서 API를 사용하기 위한 추가 사전 요구 사항](#additional-prerequisites-for-using-the-api-via-python)을 완료해야 합니다.
```python lines theme={"system"}
import os
import asyncio
import openai
import weave
from weave.flow import leaderboard
from weave.trace.ref_util import get_ref
# 트레이싱에 사용할 Weave 팀과 프로젝트를 설정합니다
weave.init("/")
dataset = [
{"input": "What is 2 + 2?", "target": "4"},
{"input": "Name a primary color.", "target": "red"},
]
@weave.op
def exact_match(target: str, output: str) -> float:
return float(target.strip().lower() == output.strip().lower())
class WBInferenceModel(weave.Model):
model: str
@weave.op
def predict(self, prompt: str) -> str:
client = openai.OpenAI(
base_url="https://api.inference.wandb.ai/v1",
# https://forge.coreweave.com/settings 에서 API 키를 생성하세요
api_key="",
# W&B Inference 사용량 추적에 필요합니다
project="/",
)
resp = client.chat.completions.create(
model=self.model,
messages=[{"role": "user", "content": prompt}],
)
return resp.choices[0].message.content
llama = WBInferenceModel(model="meta-llama/Llama-3.1-8B-Instruct")
deepseek = WBInferenceModel(model="deepseek-ai/DeepSeek-V3-0324")
def preprocess_model_input(example):
return {"prompt": example["input"]}
evaluation = weave.Evaluation(
name="QA",
dataset=dataset,
scorers=[exact_match],
preprocess_model_input=preprocess_model_input,
)
async def run_eval():
await evaluation.evaluate(llama)
await evaluation.evaluate(deepseek)
asyncio.run(run_eval())
spec = leaderboard.Leaderboard(
name="Inference Leaderboard",
description="Compare models on a QA dataset",
columns=[
leaderboard.LeaderboardColumn(
evaluation_object_ref=get_ref(evaluation).uri(),
scorer_name="exact_match",
summary_metric_path="mean",
)
],
)
weave.publish(spec)
```
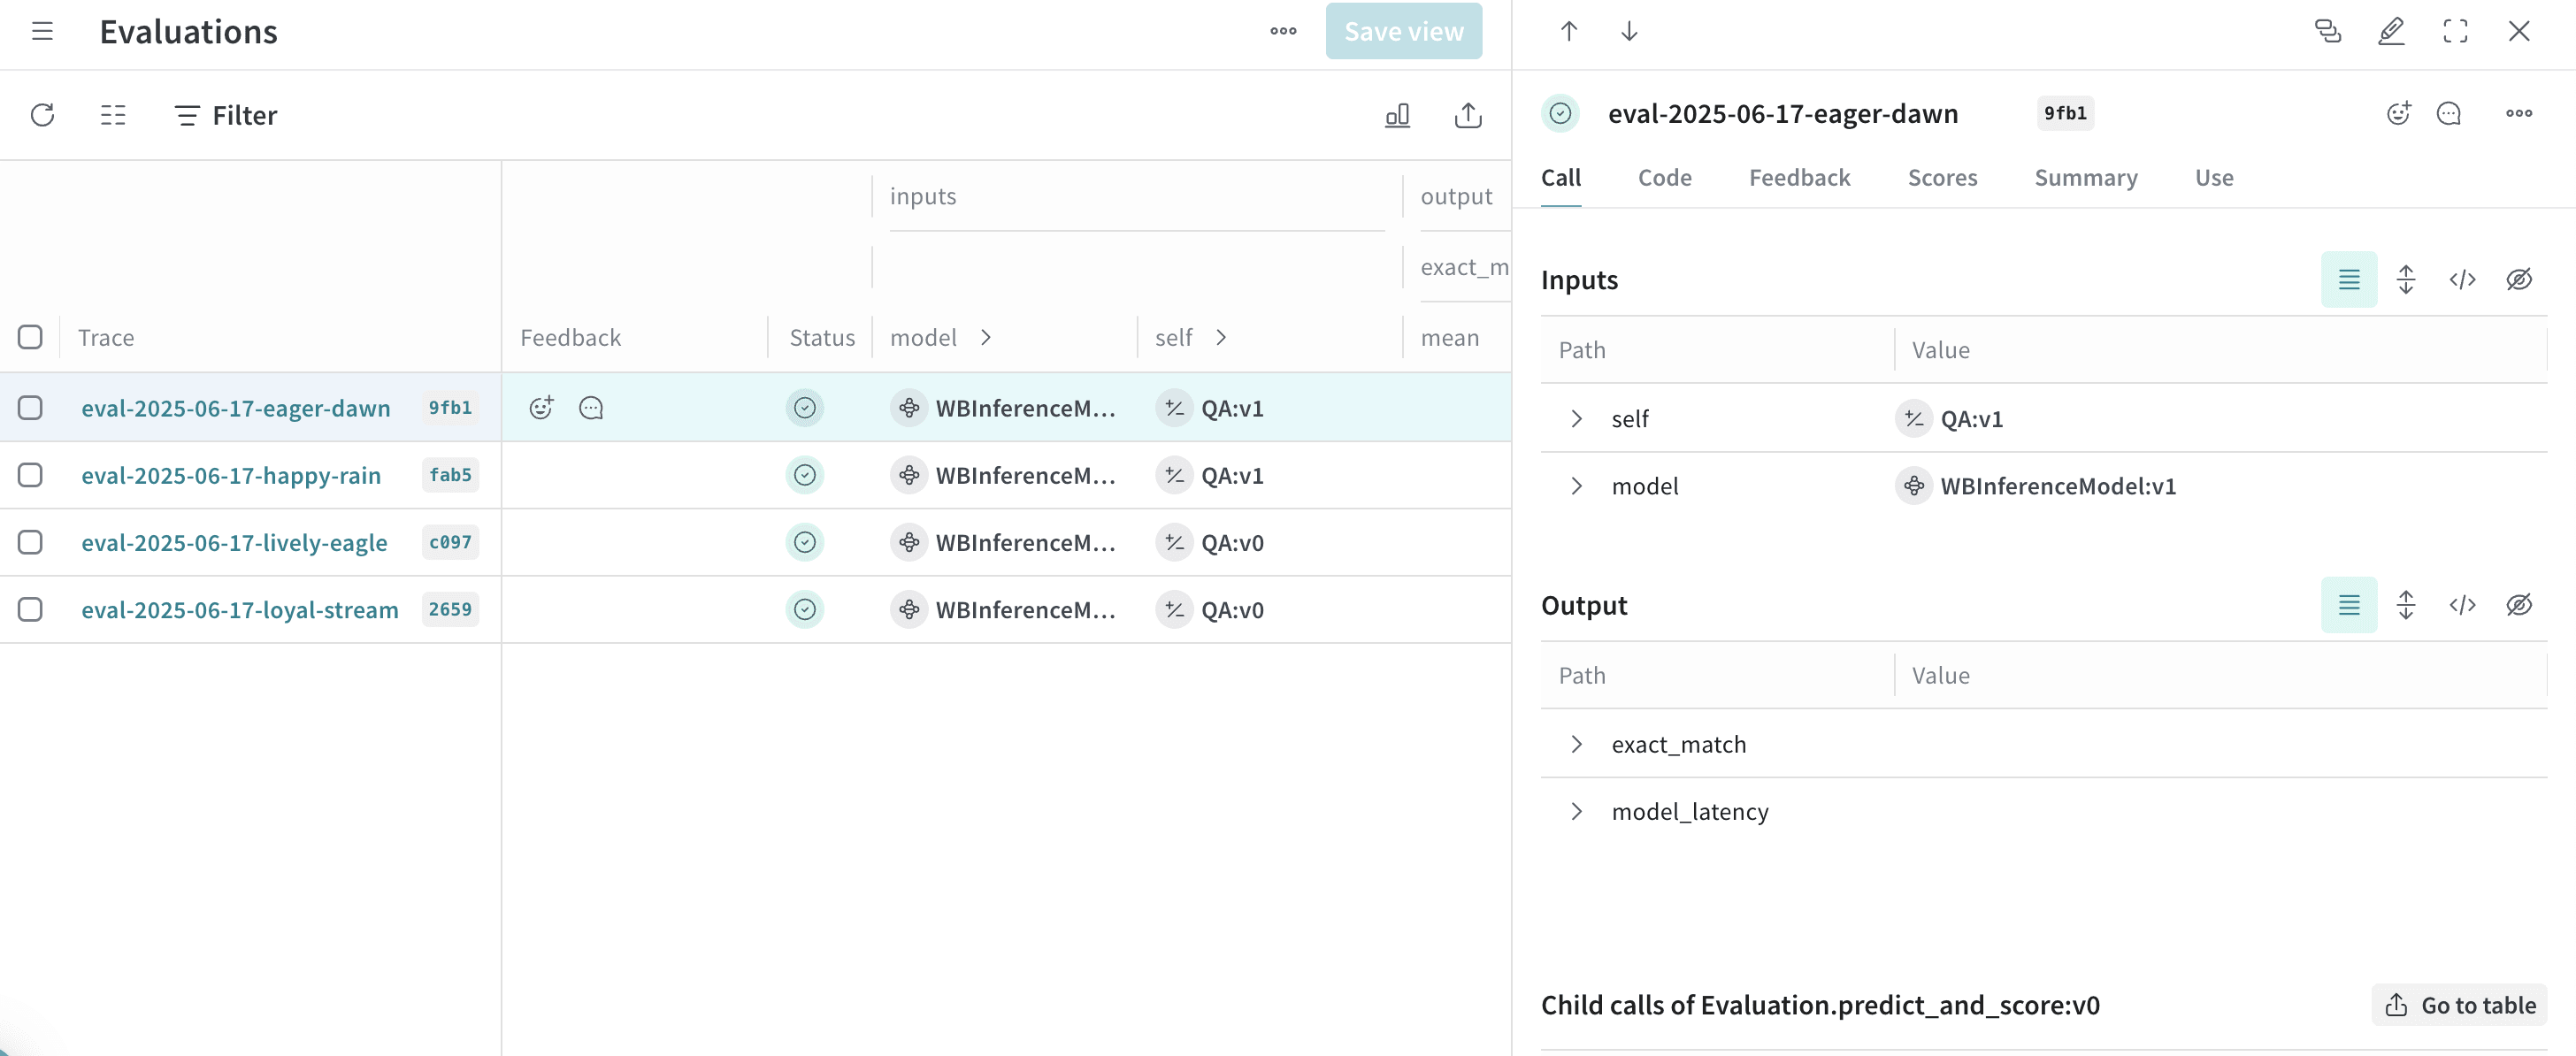
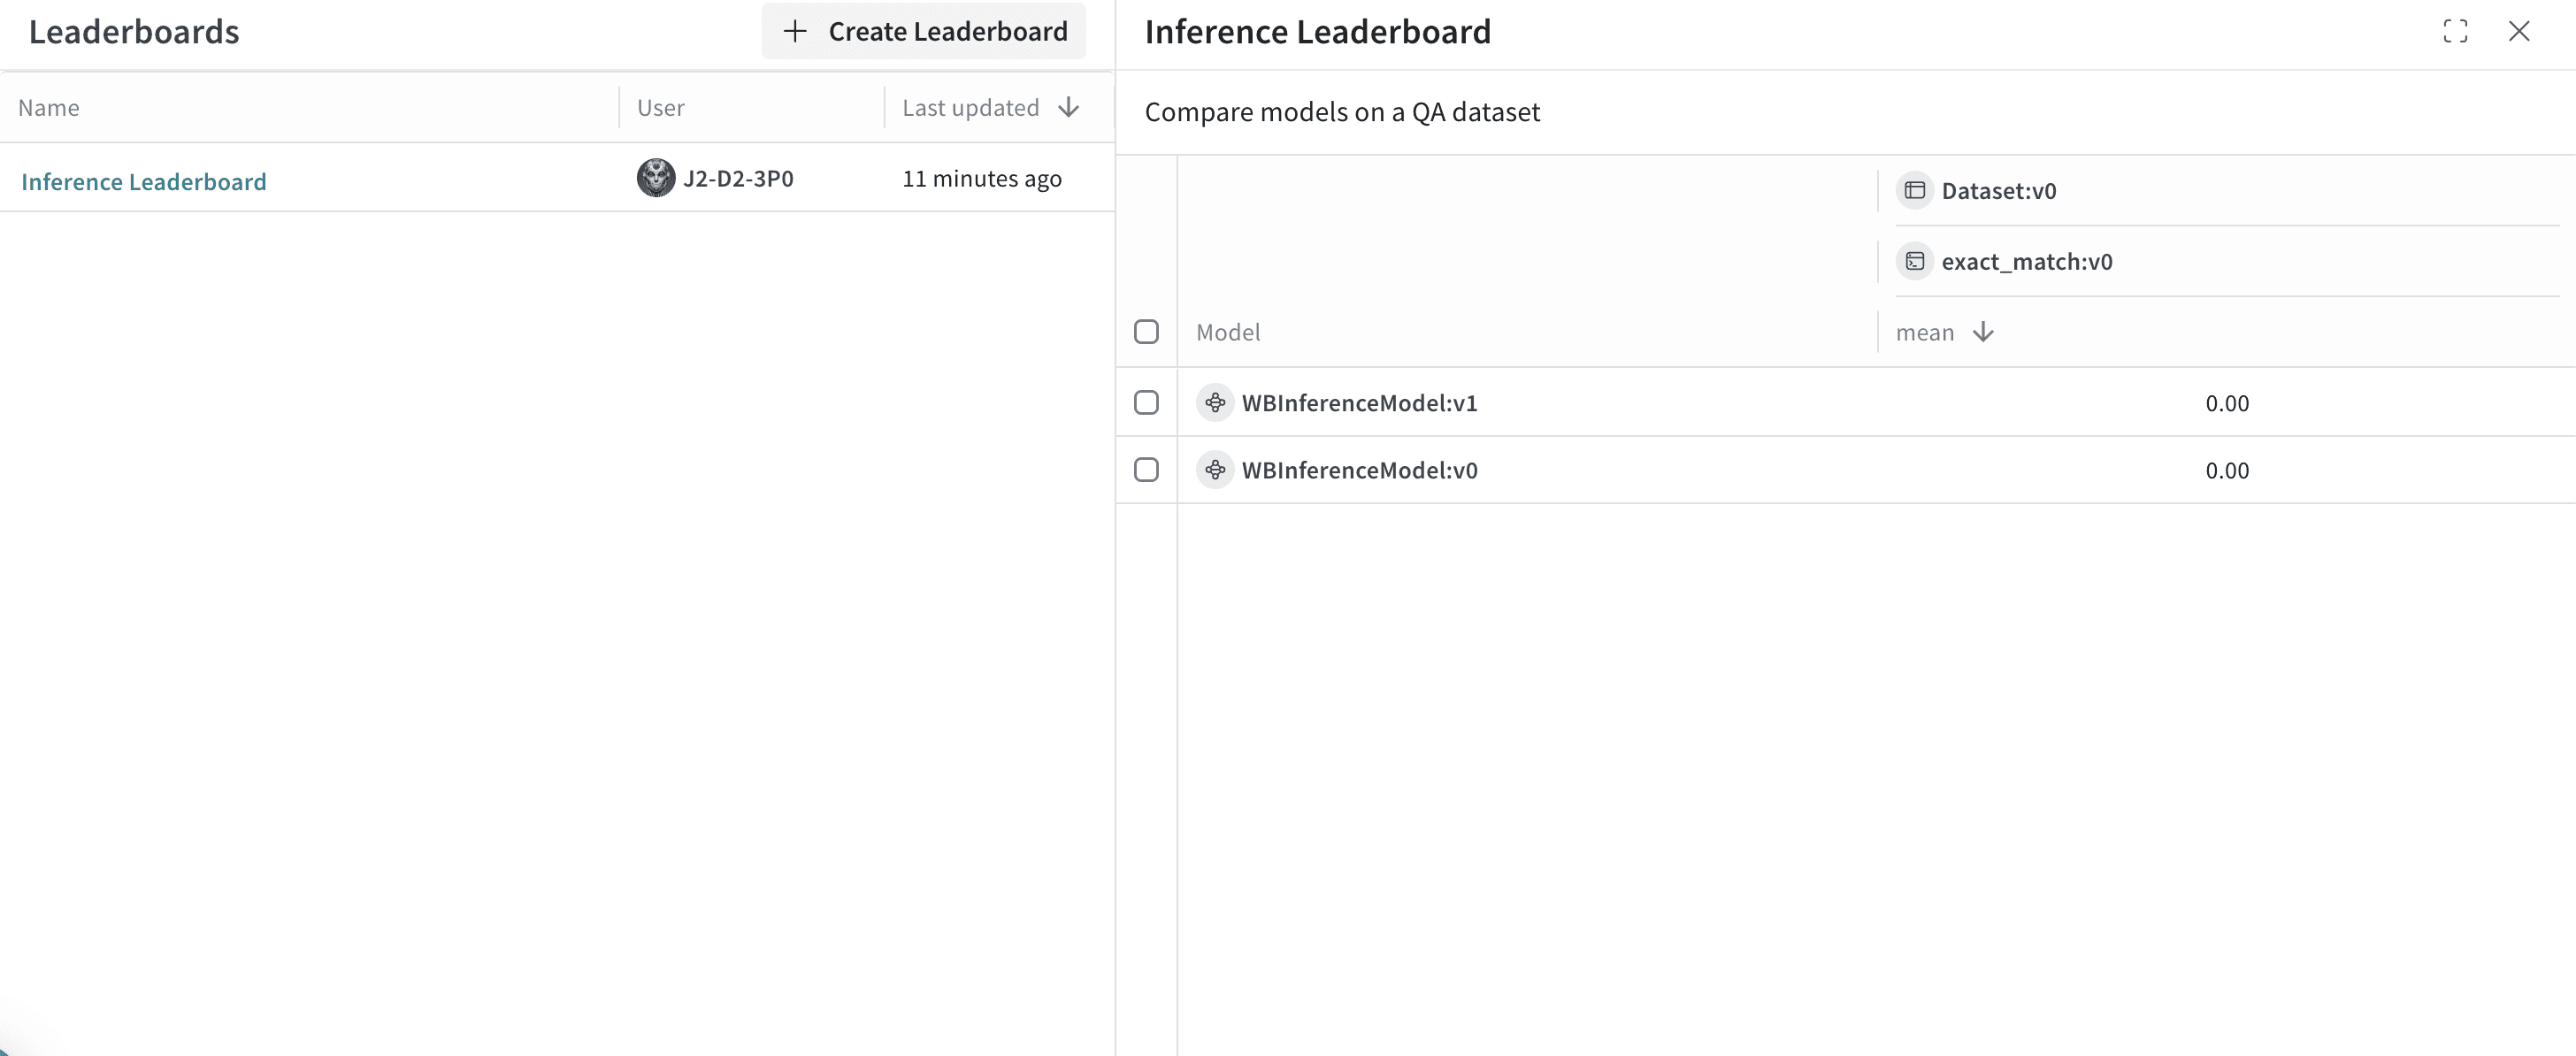
앞의 코드 샘플을 실행하면 Weave가 평가 결과, 트레이스, 두 모델을 비교하는 leaderboard를 Weights & Biases 프로젝트에 게시합니다. 게시된 결과를 보려면 [Forge](https://forge.coreweave.com/wandb)에서 CoreWeave Forge 계정으로 이동한 후 다음을 수행하세요.
* **Traces** 탭으로 이동하여 [트레이스를 확인하세요](/ko/products/wandb/weave/guides/tracking/tracing).
* **Evals** 탭으로 이동하여 [모델 평가를 확인하세요](/ko/products/wandb/weave/guides/core-types/evaluations).
* **Leaders** 탭으로 이동하여 [생성된 leaderboard를 확인하세요](/ko/products/wandb/weave/guides/core-types/leaderboards).
UI
다음 섹션에서는 Weights & Biases UI에서 Inference 서비스를 사용하는 방법을 설명합니다. UI에서 Inference 서비스에 액세스하려면 먼저 [사전 요구 사항](#prerequisites)을 완료하세요.
Inference 서비스 액세스
다음 위치에서 Weights & Biases UI를 통해 Inference 서비스에 액세스할 수 있습니다:
* [직접 연결](#direct-link)
* [Inference 탭에서](#from-the-inference-tab)
* [플레이그라운드 탭에서](#from-the-playground-tab)
직접 링크
[https://forge.coreweave.com/inference](https://forge.coreweave.com/inference)로 이동하세요.
Inference 탭에서 접근하기
1. [Forge](https://forge.coreweave.com/wandb)에서 CoreWeave Forge 계정으로 이동하세요.
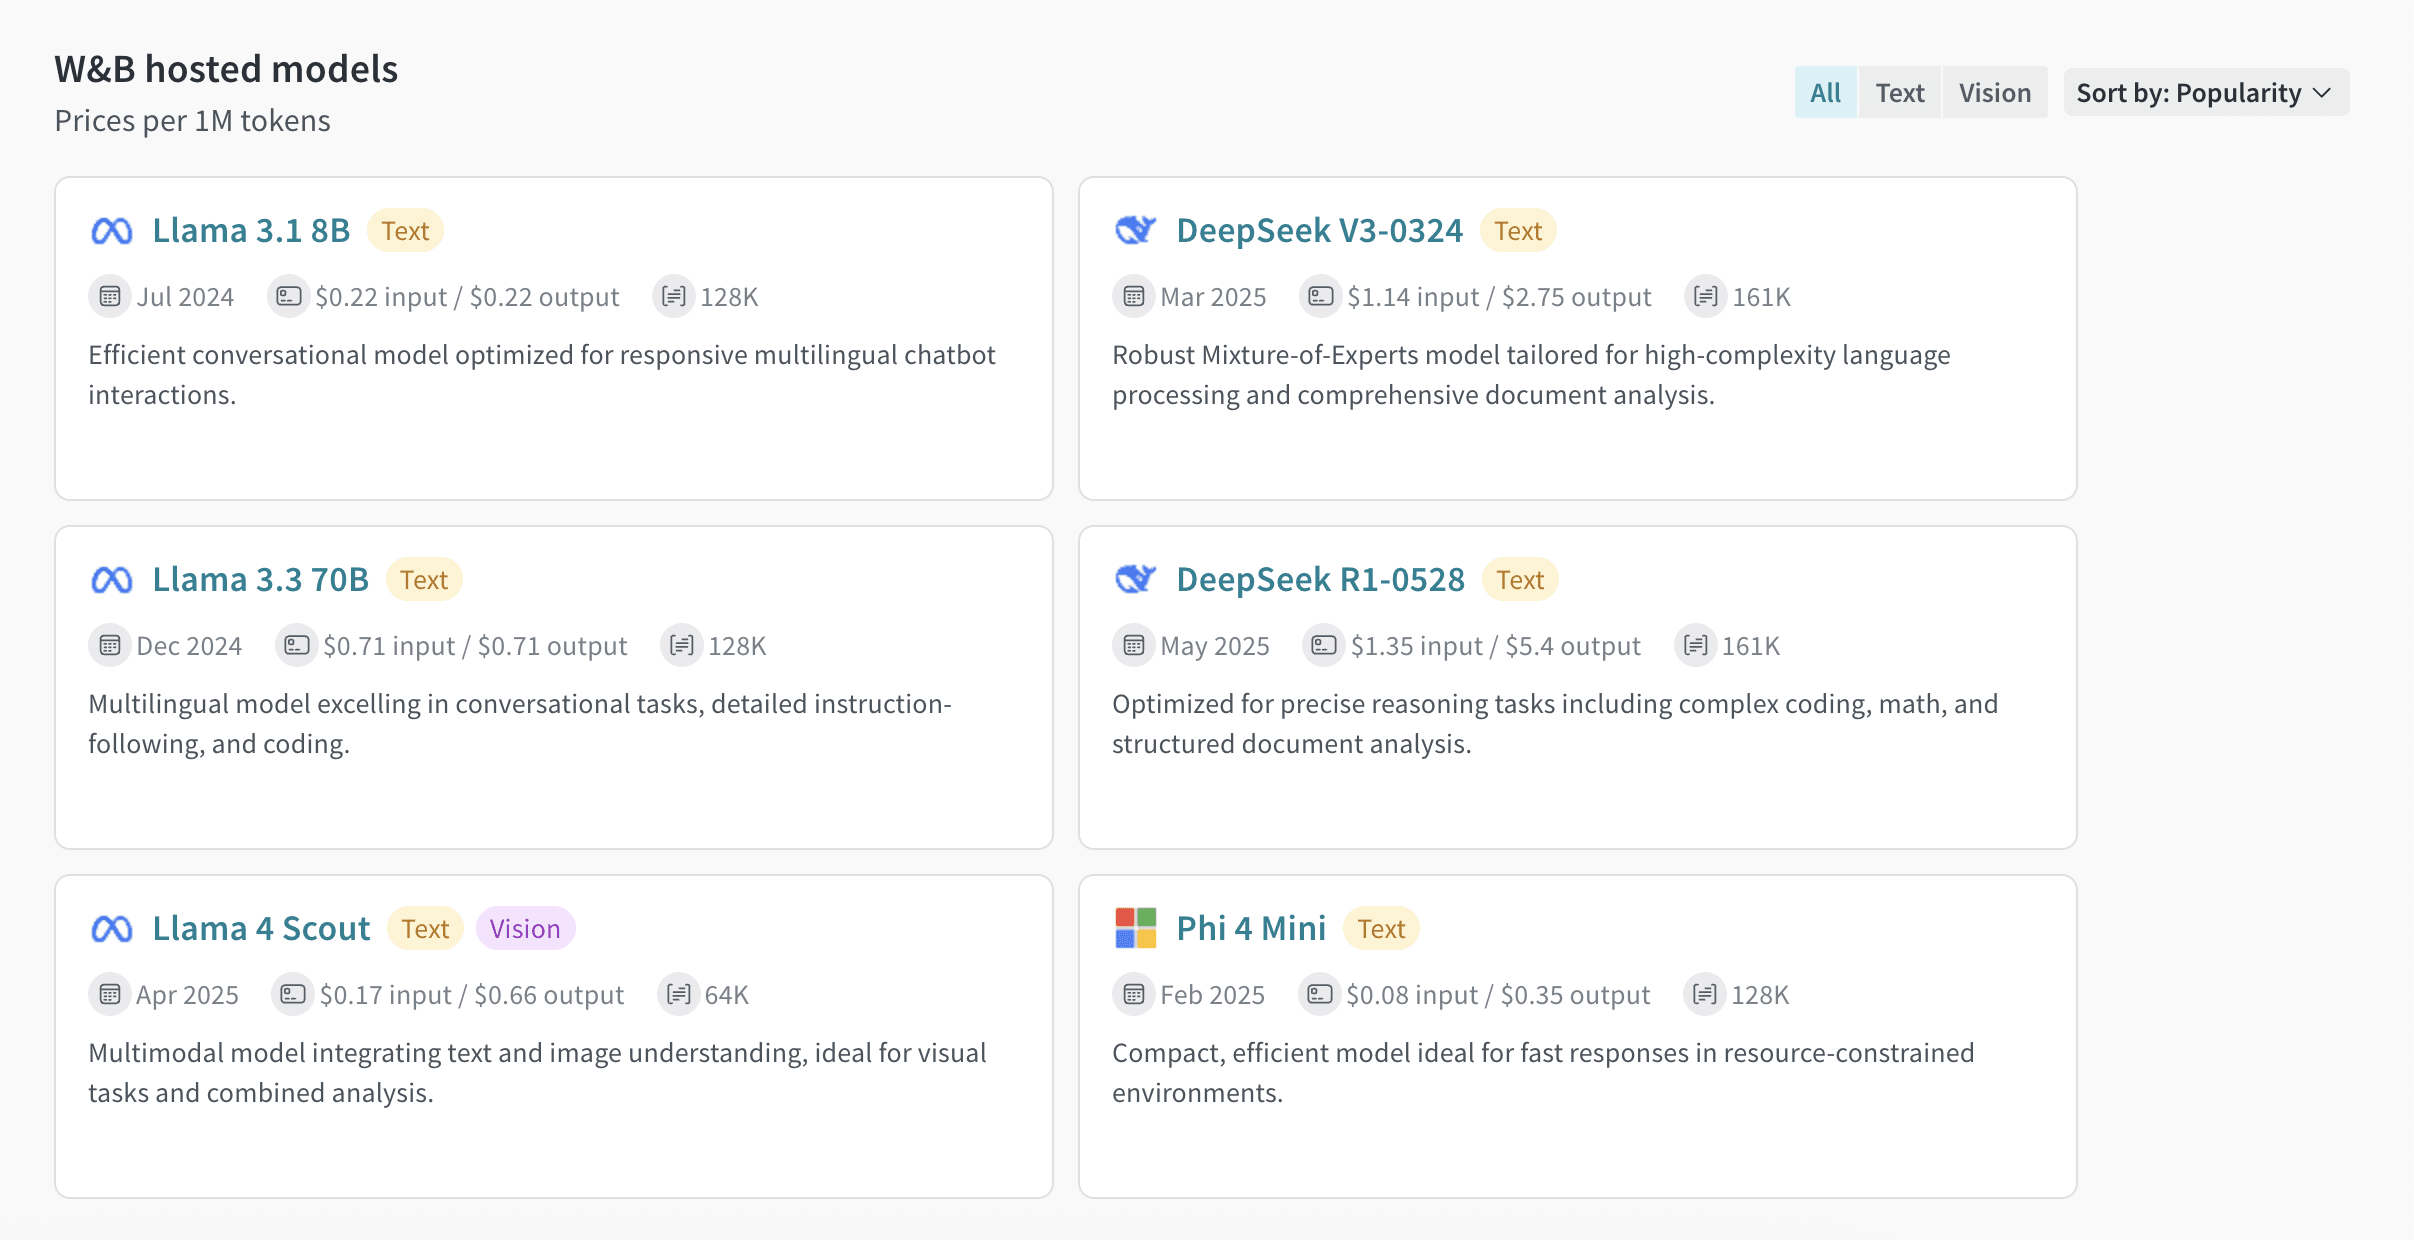
2. 왼쪽 사이드바에서 **Inference**를 선택하세요. 사용 가능한 모델과 모델 정보를 보여 주는 페이지가 표시됩니다.
플레이그라운드 탭에서
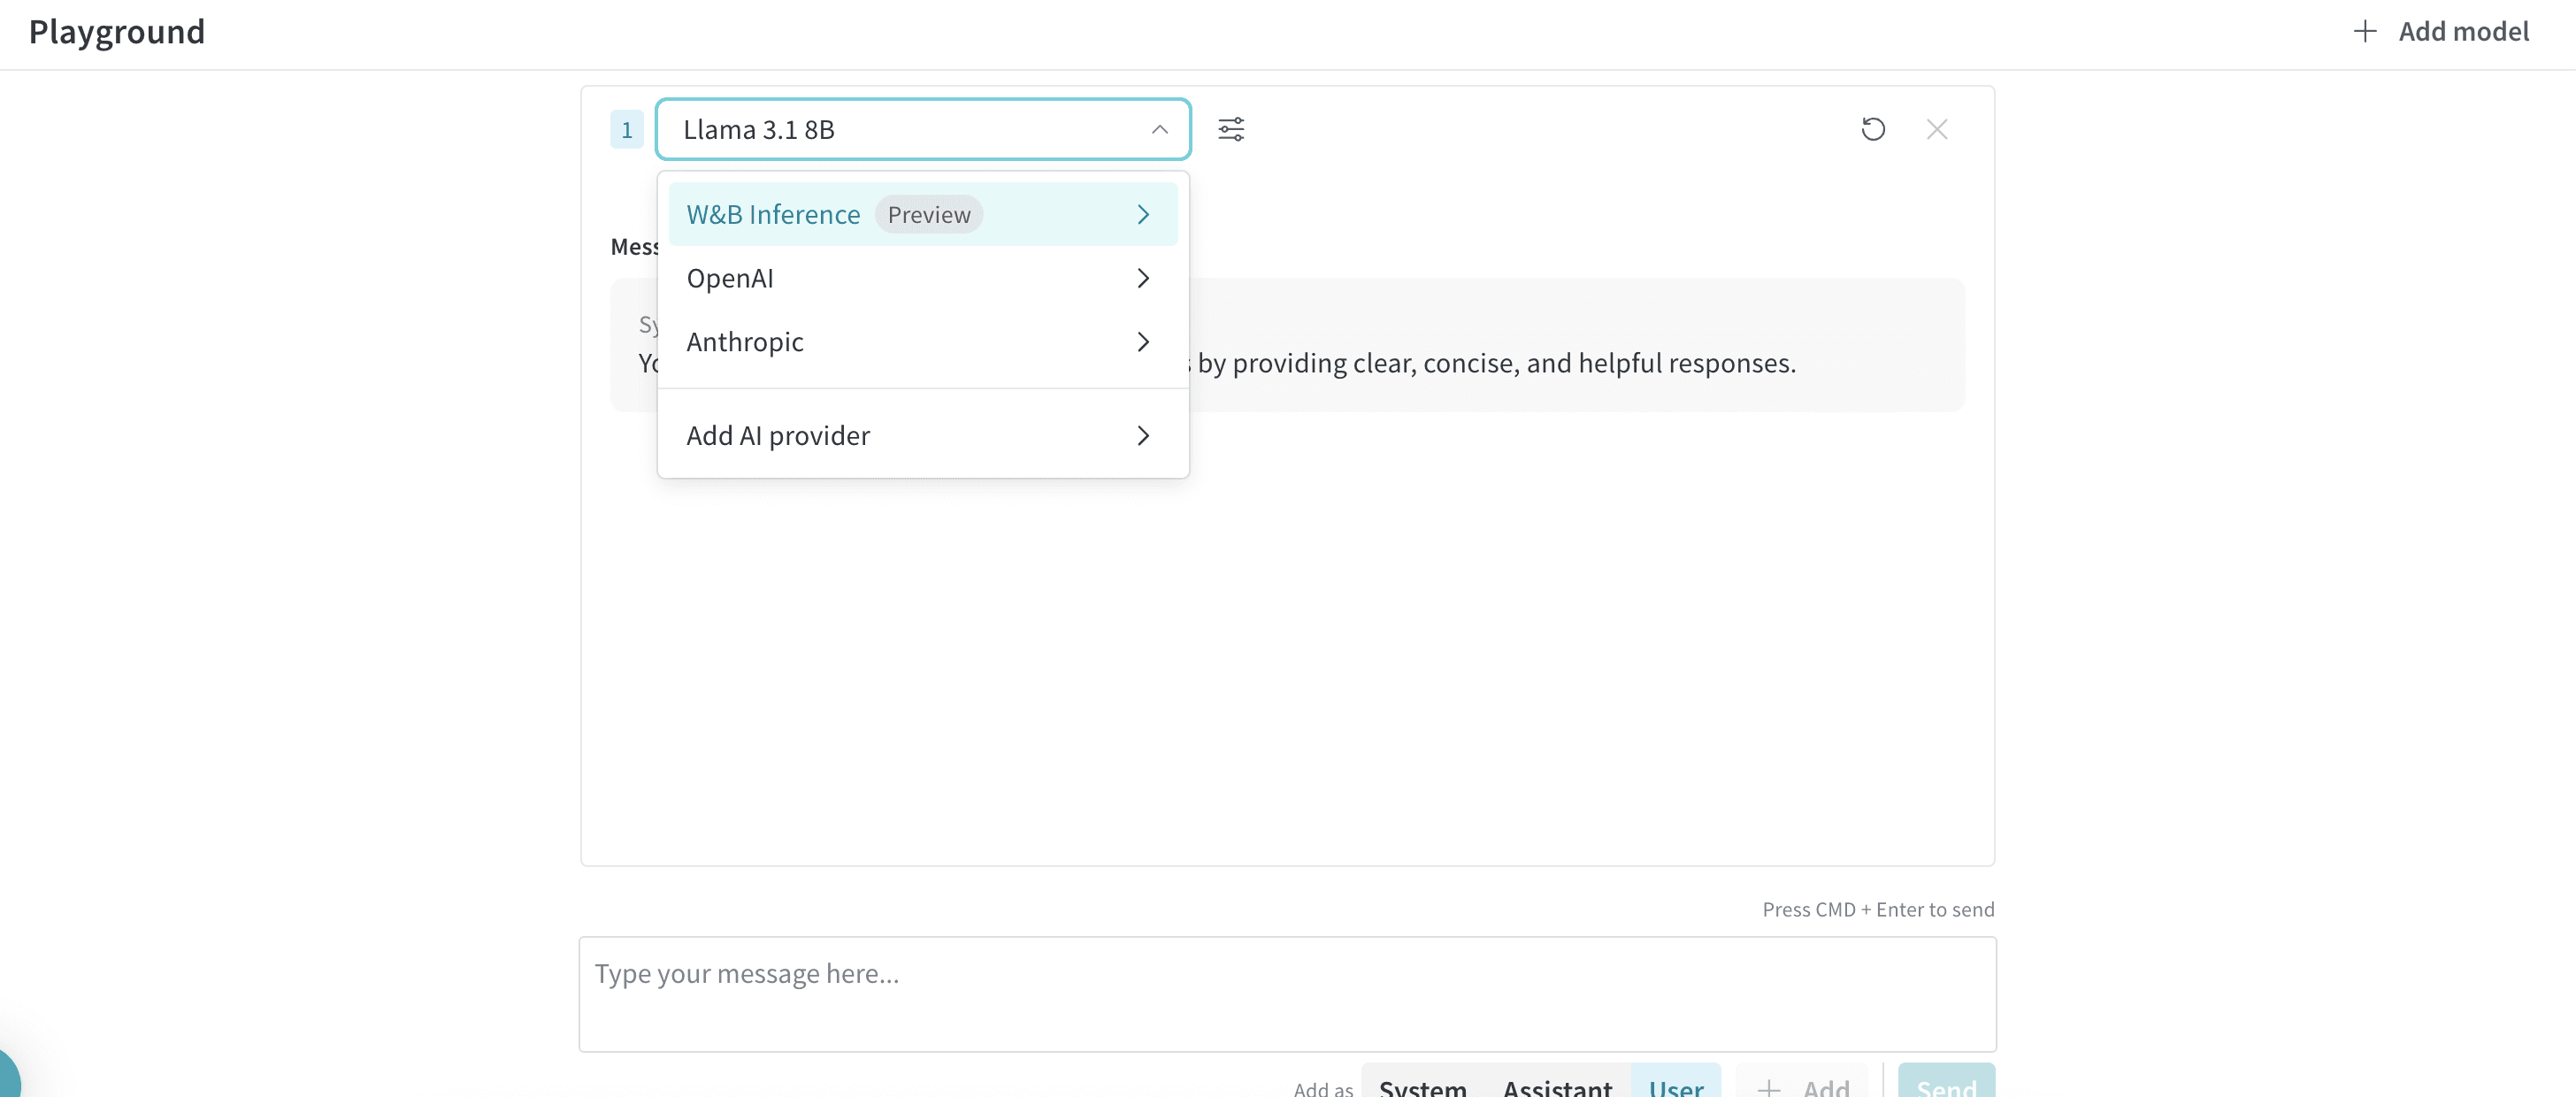
1. 왼쪽 사이드바에서 **플레이그라운드**를 선택하세요. 플레이그라운드 채팅 UI가 표시됩니다.
2. LLM 드롭다운 목록에서 **Serverless Inference**에 마우스를 올리세요. 사용 가능한 Serverless Inference 모델이 있는 드롭다운이 오른쪽에 표시됩니다.
3. Serverless Inference 모델 드롭다운에서 다음을 수행할 수 있습니다:
* 사용 가능한 모델의 이름을 클릭하여 [플레이그라운드에서 사용해 보세요](#try-a-model-in-the-playground).
* [플레이그라운드에서 하나 이상의 모델을 비교하세요](#compare-multiple-models).
플레이그라운드에서 모델 사용해 보기
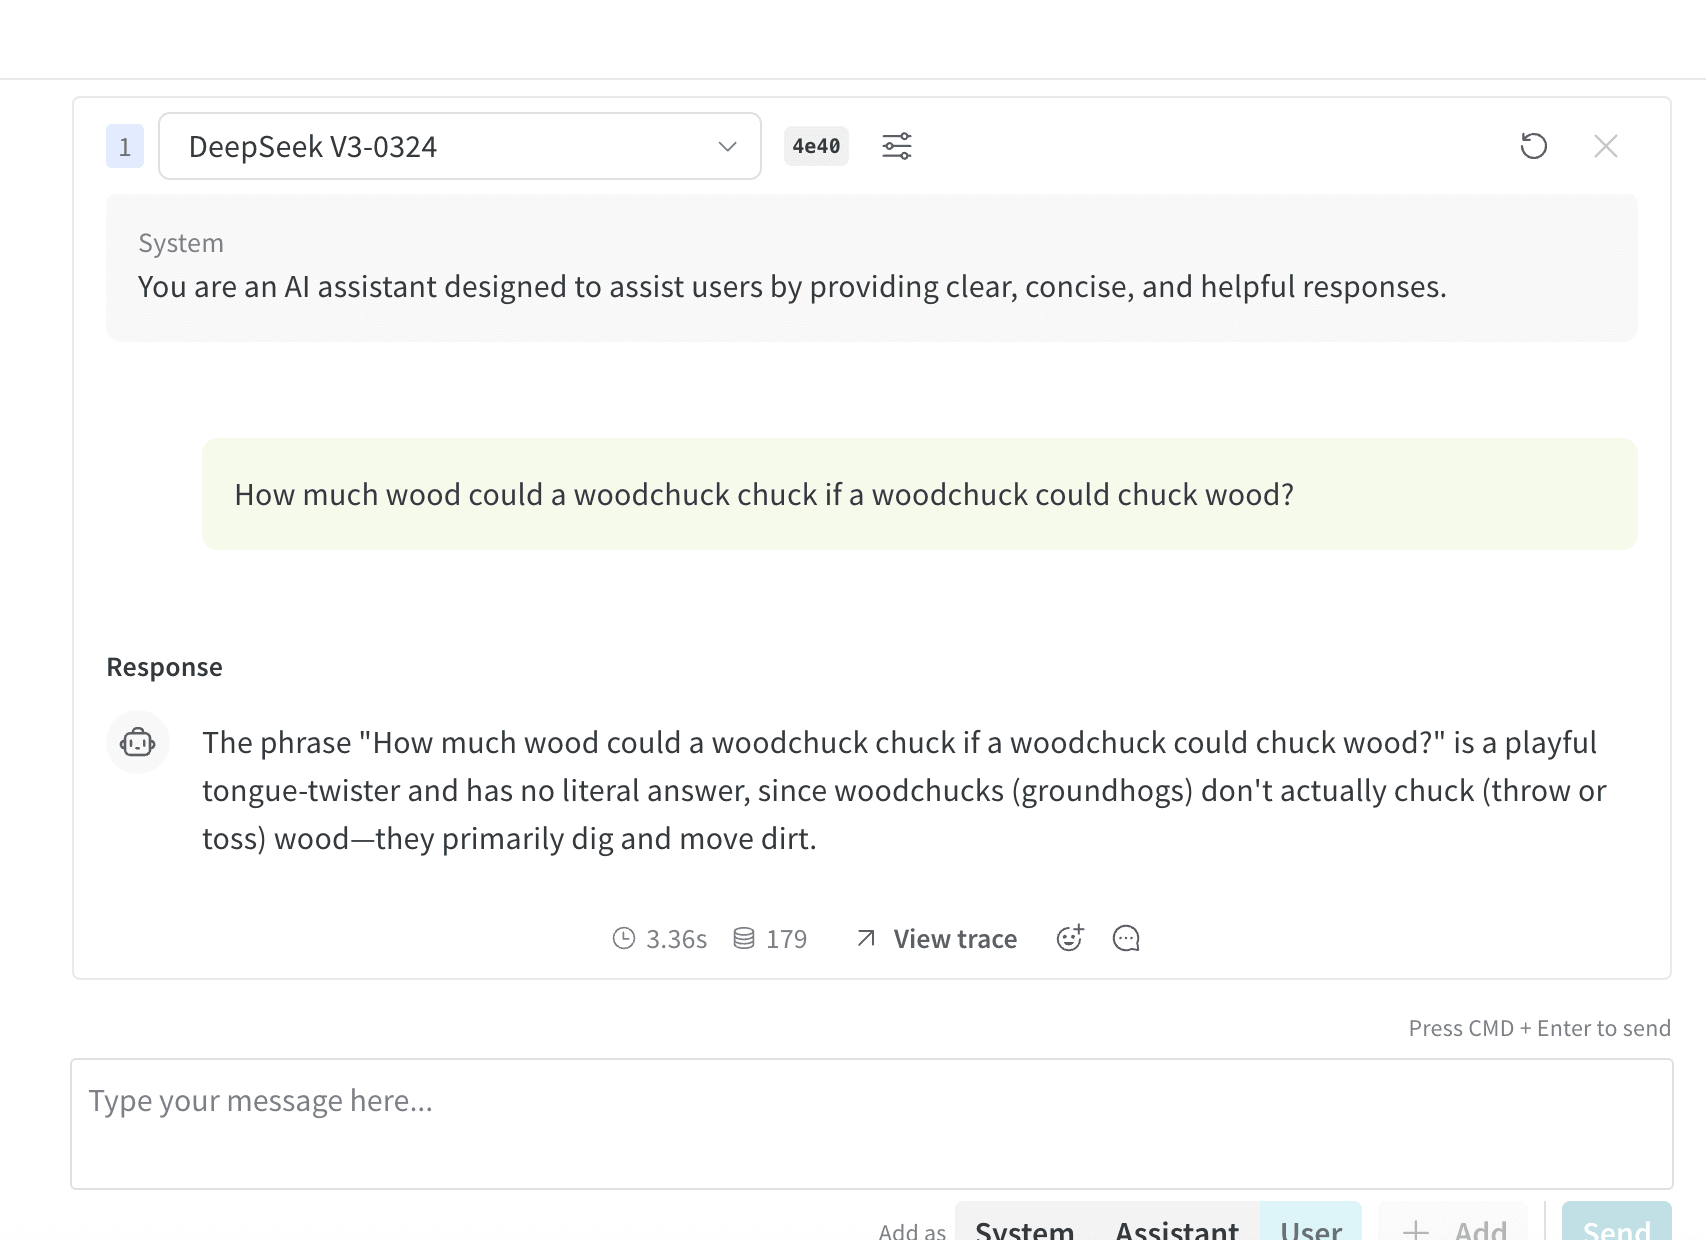
[액세스 옵션 중 하나를 사용하여 모델을 선택](#access-the-inference-service)한 후, 플레이그라운드에서 모델을 사용해 볼 수 있습니다. 다음 작업을 수행할 수 있습니다:
* [모델 설정 및 매개변수 사용자 지정](/ko/products/wandb/weave/guides/tools/playground#customize-settings)
* [메시지 추가, 재시도, 편집 및 삭제](/ko/products/wandb/weave/guides/tools/playground#message-controls)
* [맞춤형 설정이 적용된 모델 저장 및 재사용](/ko/products/wandb/weave/guides/tools/playground#saved-models)
* [여러 모델 비교](#compare-multiple-models)
여러 모델 비교
플레이그라운드에서 여러 Inference 모델을 비교할 수 있습니다. Compare 뷰는 두 가지 다른 위치에서 액세스할 수 있습니다:
* [Inference 탭에서 Compare 뷰 액세스](#access-the-compare-view-from-the-inference-tab)
* [플레이그라운드 탭에서 Compare 뷰 액세스](#access-the-compare-view-from-the-playground-tab)
Inference 탭에서 Compare 뷰에 액세스하기
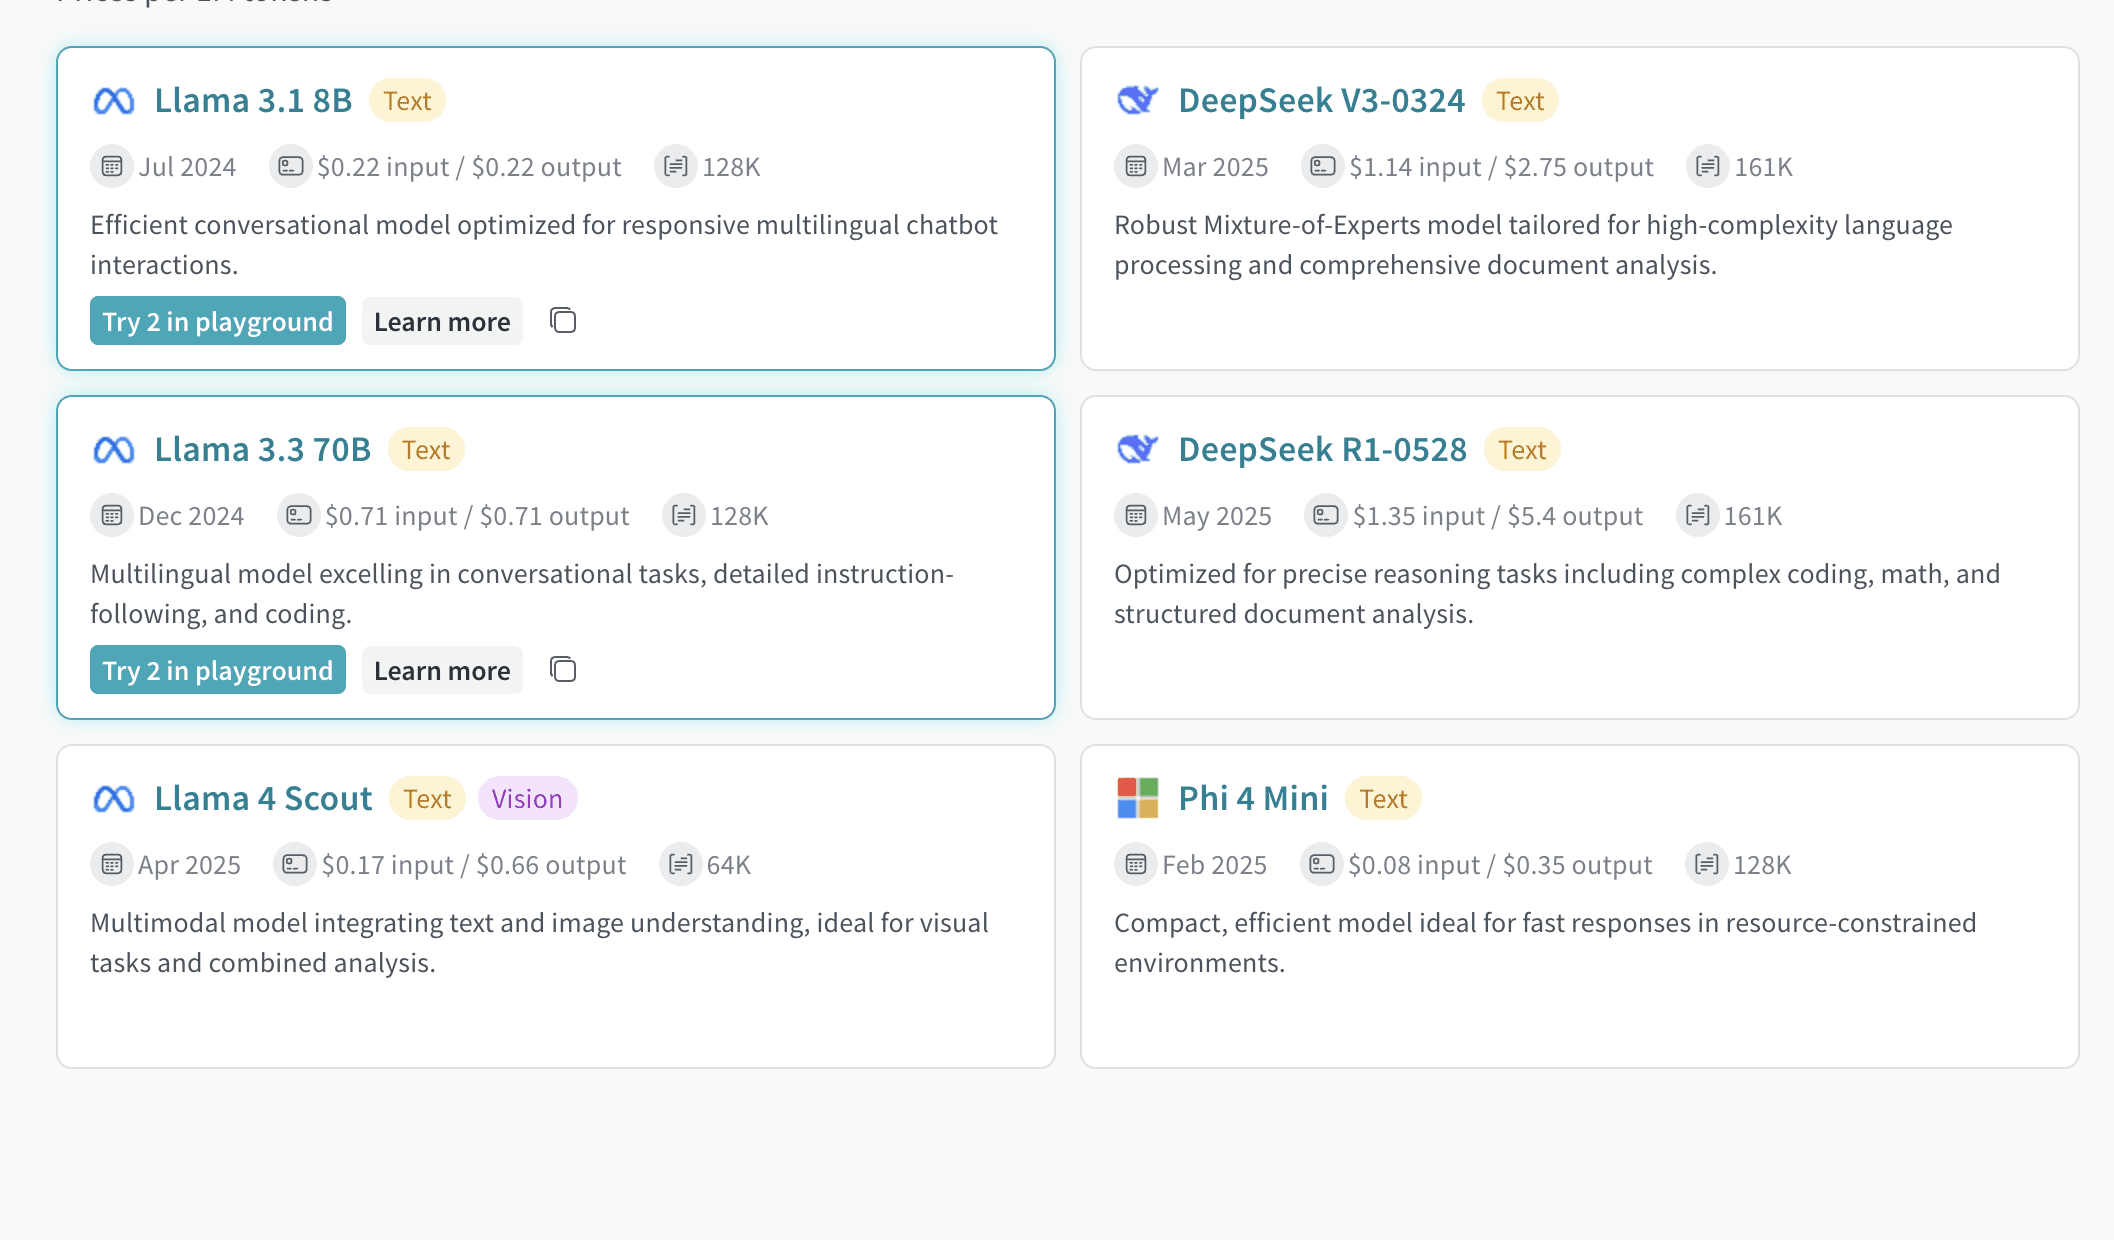
1. 왼쪽 사이드바에서 **Inference**를 선택하세요. 사용 가능한 모델과 모델 정보가 표시된 페이지가 나타납니다.
2. 비교할 모델을 선택하려면 모델 Card의 아무 곳이나 클릭하세요(모델 이름은 제외). 선택을 나타내기 위해 모델 Card의 테두리가 파란색으로 강조 표시됩니다.
3. 비교하려는 각 모델에 대해 단계 2를 반복하세요.
4. 선택한 Card 중 하나에서 **플레이그라운드에서 N개 모델 비교** 버튼을 클릭하세요(`N`은 비교 중인 모델 수입니다. 예를 들어 3개 모델을 선택하면 버튼이 **플레이그라운드에서 3개 모델 비교**로 표시됩니다). 뷰가 열립니다.
이제 플레이그라운드에서 모델을 비교할 수 있으며, [플레이그라운드에서 모델 사용해 보기](#try-a-model-in-the-playground)에 설명된 기능을 모두 사용할 수 있습니다.
플레이그라운드 탭에서 Compare 뷰에 액세스하기
1. 왼쪽 사이드바에서 **플레이그라운드**를 선택하세요. 플레이그라운드 chat UI가 표시됩니다.
2. LLM 드롭다운 목록에서 **Serverless Inference** 위에 마우스를 올리세요. 사용 가능한 Serverless Inference 모델의 드롭다운이 오른쪽에 표시됩니다.
3. 드롭다운에서 **비교**를 선택하세요. **Inference** 탭이 표시됩니다.
4. 비교할 모델을 선택하려면 모델 Card의 아무 곳이나 클릭하세요(모델 이름 제외). 선택을 나타내기 위해 모델 Card의 테두리가 파란색으로 강조 표시됩니다.
5. 비교하려는 각 모델에 대해 4단계를 반복하세요.
6. 선택한 Card 중 하나에서 **플레이그라운드에서 N개 모델 비교** 버튼을 클릭하세요(`N`은 비교 중인 모델 수입니다. 예를 들어, 3개 모델을 선택하면 버튼이 **플레이그라운드에서 3개 모델 비교**로 표시됩니다). 뷰가 열립니다.
이제 플레이그라운드에서 모델을 비교할 수 있으며, [플레이그라운드에서 모델 사용해 보기](#try-a-model-in-the-playground)에 설명된 기능을 모두 사용할 수 있습니다.
조직 관리자는 Weights & Biases UI에서 현재 Inference 크레딧 잔액, 사용 이력, 예정된 청구 금액(해당하는 경우)을 직접 확인할 수 있습니다.
1. Weights & Biases UI에서 W\&B **Billing** 페이지로 이동하세요.
2. 오른쪽 하단에 Inference 결제 정보 Card가 표시됩니다. 여기에서 다음 작업을 할 수 있습니다.
* Inference 결제 정보 Card에서 **View usage** 버튼을 클릭하여 시간 경과별 사용량을 확인하세요.
* 유료 플랜을 사용 중이라면 예정된 Inference 요금을 확인하세요.
모델별 가격 세부 정보는 [Inference 가격 페이지](https://wandb.ai/site/pricing/inference)에서 확인하세요.
다음 섹션에서는 지리적 제한, 동시성 한도 및 가격을 포함한 중요한 사용 정보 및 한도에 대해 설명합니다. 서비스를 사용하기 전에 이 정보를 숙지하세요.
지리적 제한
Inference 서비스는 지원되는 지리적 위치에서만 액세스할 수 있습니다. 자세한 내용은 [Terms of Service](/policies/terms-of-service/terms-of-use#geographic-restrictions)를 참조하세요.
동시성 한도
공정한 사용과 안정적인 성능을 보장하기 위해 Serverless Inference API는 사용자 및 프로젝트 수준에서 요청 속도 제한을 강제 적용합니다. 이러한 제한은 다음과 같은 역할을 합니다.
* 오용을 방지하고 API 안정성을 보호합니다.
* 모든 사용자의 액세스를 보장합니다.
* 인프라 부하를 효과적으로 관리합니다.
요청 속도 제한을 초과하면 API는 `429 Concurrency limit reached for requests` 응답을 반환합니다. 이 오류를 해결하려면 동시 요청 수를 줄이세요.
가격
모델 가격 정보는 [https://wandb.ai/site/pricing/inference](https://wandb.ai/site/pricing/inference)를 방문하세요.
API 오류
다음 table은 Inference API가 반환할 수 있는 오류와 각 오류의 원인 및 권장 해결 방법을 정리한 것입니다.
| 오류 코드 | 메시지 | 원인 | 해결 방법 |
| - | - | - | - |
| 401 | Invalid Authentication | 인증 자격 증명이 유효하지 않거나 Weights & Biases 프로젝트 entity 또는 이름이 올바르지 않습니다. | 올바른 API 키를 사용하고 있는지, Weights & Biases 프로젝트 이름과 entity가 올바른지 확인하세요. |
| 403 | Country, region, or territory not supported | 지원되지 않는 위치에서 API에 액세스하고 있습니다. | [지리적 제한](#geographic-restrictions)을 참조하세요. |
| 429 | Concurrency limit reached for requests | 동시 요청이 너무 많습니다. | 동시 요청 수를 줄이세요. |
| 429 | You exceeded your current quota, please check your plan and billing details | 크레딧이 소진되었거나 월간 지출 한도에 도달했습니다. | 크레딧을 추가로 구매하거나 한도를 늘리세요. |
| 500 | The server had an error while processing your request | 내부 서버 오류입니다. | 잠시 후 다시 시도하고, 문제가 계속되면 지원팀에 문의하세요. |
| 503 | The engine is currently overloaded, please try again later | 서버에 트래픽이 몰려 있습니다. | 잠시 후 요청을 다시 시도하세요. |
## Related topics
- [Serverless Inference](/ko/products/inference/serverless.md)