> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Hugging Face Hub
> Hugging Face Hub를 W&B Weave와 통합하여 머신러닝 애플리케이션을 추적하고 분석하세요
이 페이지의 모든 코드 샘플은 Python으로 작성되었습니다.
이 페이지에서는 [Hugging Face Hub](https://huggingface.co/)를 W\&B Weave와 통합하여 머신러닝 애플리케이션을 추적하고 분석하는 방법을 설명합니다. Weave의 트레이싱 및 버전 관리 기능을 사용하여 모델 추론을 로깅하고, 함수 Call을 모니터링하고, 실험을 체계적으로 관리하는 방법을 알아봅니다. 예시를 따라 하면 인사이트를 캡처하고, 애플리케이션을 디버깅하고, 다양한 모델 설정을 비교하는 작업을 모두 Weave 웹 인터페이스에서 할 수 있습니다.
**Google Colab에서 Weave로 Hugging Face Hub 사용해 보기**
별도의 설정 없이 Hugging Face Hub와 Weave를 바로 실험해 보고 싶으신가요? 이 페이지의 코드 샘플을 Google Colab에서 Jupyter Notebook으로 사용해 볼 수 있습니다.

개요
Hugging Face Hub는 크리에이터와 협업자를 위한 머신러닝 플랫폼으로, 다양한 유형의 프로젝트에 활용할 수 있는 사전 트레이닝된 모델과 데이터셋을 폭넓게 제공합니다.
`huggingface_hub` Python 라이브러리는 Hub에 호스팅된 모델을 여러 서비스에서 추론할 수 있도록 통합 인터페이스를 제공합니다. [`InferenceClient`](https://huggingface.co/docs/huggingface_hub/en/package_reference/inference_client)를 사용하면 이러한 모델을 호출할 수 있습니다.
Weave는 `InferenceClient`의 트레이스를 자동으로 캡처합니다. 추적을 시작하려면 `weave.init()`을 호출한 뒤 평소처럼 라이브러리를 사용하세요.
사전 요구 사항
시작하기 전에 다음 설정 단계에 따라 필요한 라이브러리를 설치하고 Hugging Face Hub에 대한 액세스를 설정하세요.
1. Weave로 `huggingface_hub`를 사용하려면 먼저 필요한 라이브러리를 설치하거나 최신 버전으로 업그레이드해야 합니다. 다음 명령은 `huggingface_hub`와 `weave`를 설치하고, 이미 설치되어 있으면 최신 버전으로 업그레이드합니다. 또한 설치 출력을 최소화합니다.
```python lines theme={"system"}
pip install -U huggingface_hub weave -qqq
```
2. Hugging Face Hub의 모델로 추론을 실행하려면 [User Access Token](https://huggingface.co/docs/hub/security-tokens)을 설정하세요. 토큰은 [Hugging Face Hub 설정 페이지](https://huggingface.co/login?next=%2Fsettings%2Ftokens)에서 설정하거나 프로그래밍 방식으로 설정할 수 있습니다. 다음 코드 샘플은 `HUGGINGFACE_TOKEN`을 입력하라는 메시지를 표시한 뒤, 입력한 토큰을 환경 변수로 설정합니다.
```python lines theme={"system"}
import os
import getpass
os.environ["HUGGINGFACE_TOKEN"] = getpass.getpass("Enter your Hugging Face Hub Token: ")
```
기본 트레이싱
개발 및 프로덕션 단계에서는 언어 모델 애플리케이션의 트레이스를 한곳에 모아 저장하는 것이 필수적입니다. 이러한 트레이스는 디버깅에 유용하며, 애플리케이션 개선을 위한 데이터셋으로도 활용할 수 있습니다.
Weave는 `InferenceClient`의 트레이스를 자동으로 캡처합니다. 추적을 시작하려면 `weave.init()`을 호출하여 Weave를 초기화한 후 평소처럼 라이브러리를 사용하세요.
다음 예시는 Weave를 사용하여 Hugging Face Hub에 대한 추론 Call을 로깅하는 방법을 보여줍니다.
```python lines theme={"system"}
import weave
from huggingface_hub import InferenceClient
# Weave 초기화
weave.init(project_name="quickstart-huggingface")
# Hugging Face Inference Client 초기화
huggingface_client = InferenceClient(
api_key=os.environ.get("HUGGINGFACE_TOKEN")
)
# Llama-3.2-11B-Vision-Instruct 모델을 사용해 Hugging Face Hub에 Chat Completion 추론 호출 수행
image_url = "https://cdn.britannica.com/61/93061-050-99147DCE/Statue-of-Liberty-Island-New-York-Bay.jpg"
response = huggingface_client.chat_completion(
model="meta-llama/Llama-3.2-11B-Vision-Instruct",
messages=[
{
"role": "user",
"content": [
{"type": "image_url", "image_url": {"url": image_url}},
{"type": "text", "text": "Describe this image in one sentence."},
],
}
],
max_tokens=500,
seed=42,
)
```
앞의 코드를 실행하면 Weave는 Hugging Face Inference Client로 수행한 모든 LLM Call을 추적하고 로깅합니다. 이러한 트레이스는 Weave 웹 인터페이스에서 확인할 수 있습니다.
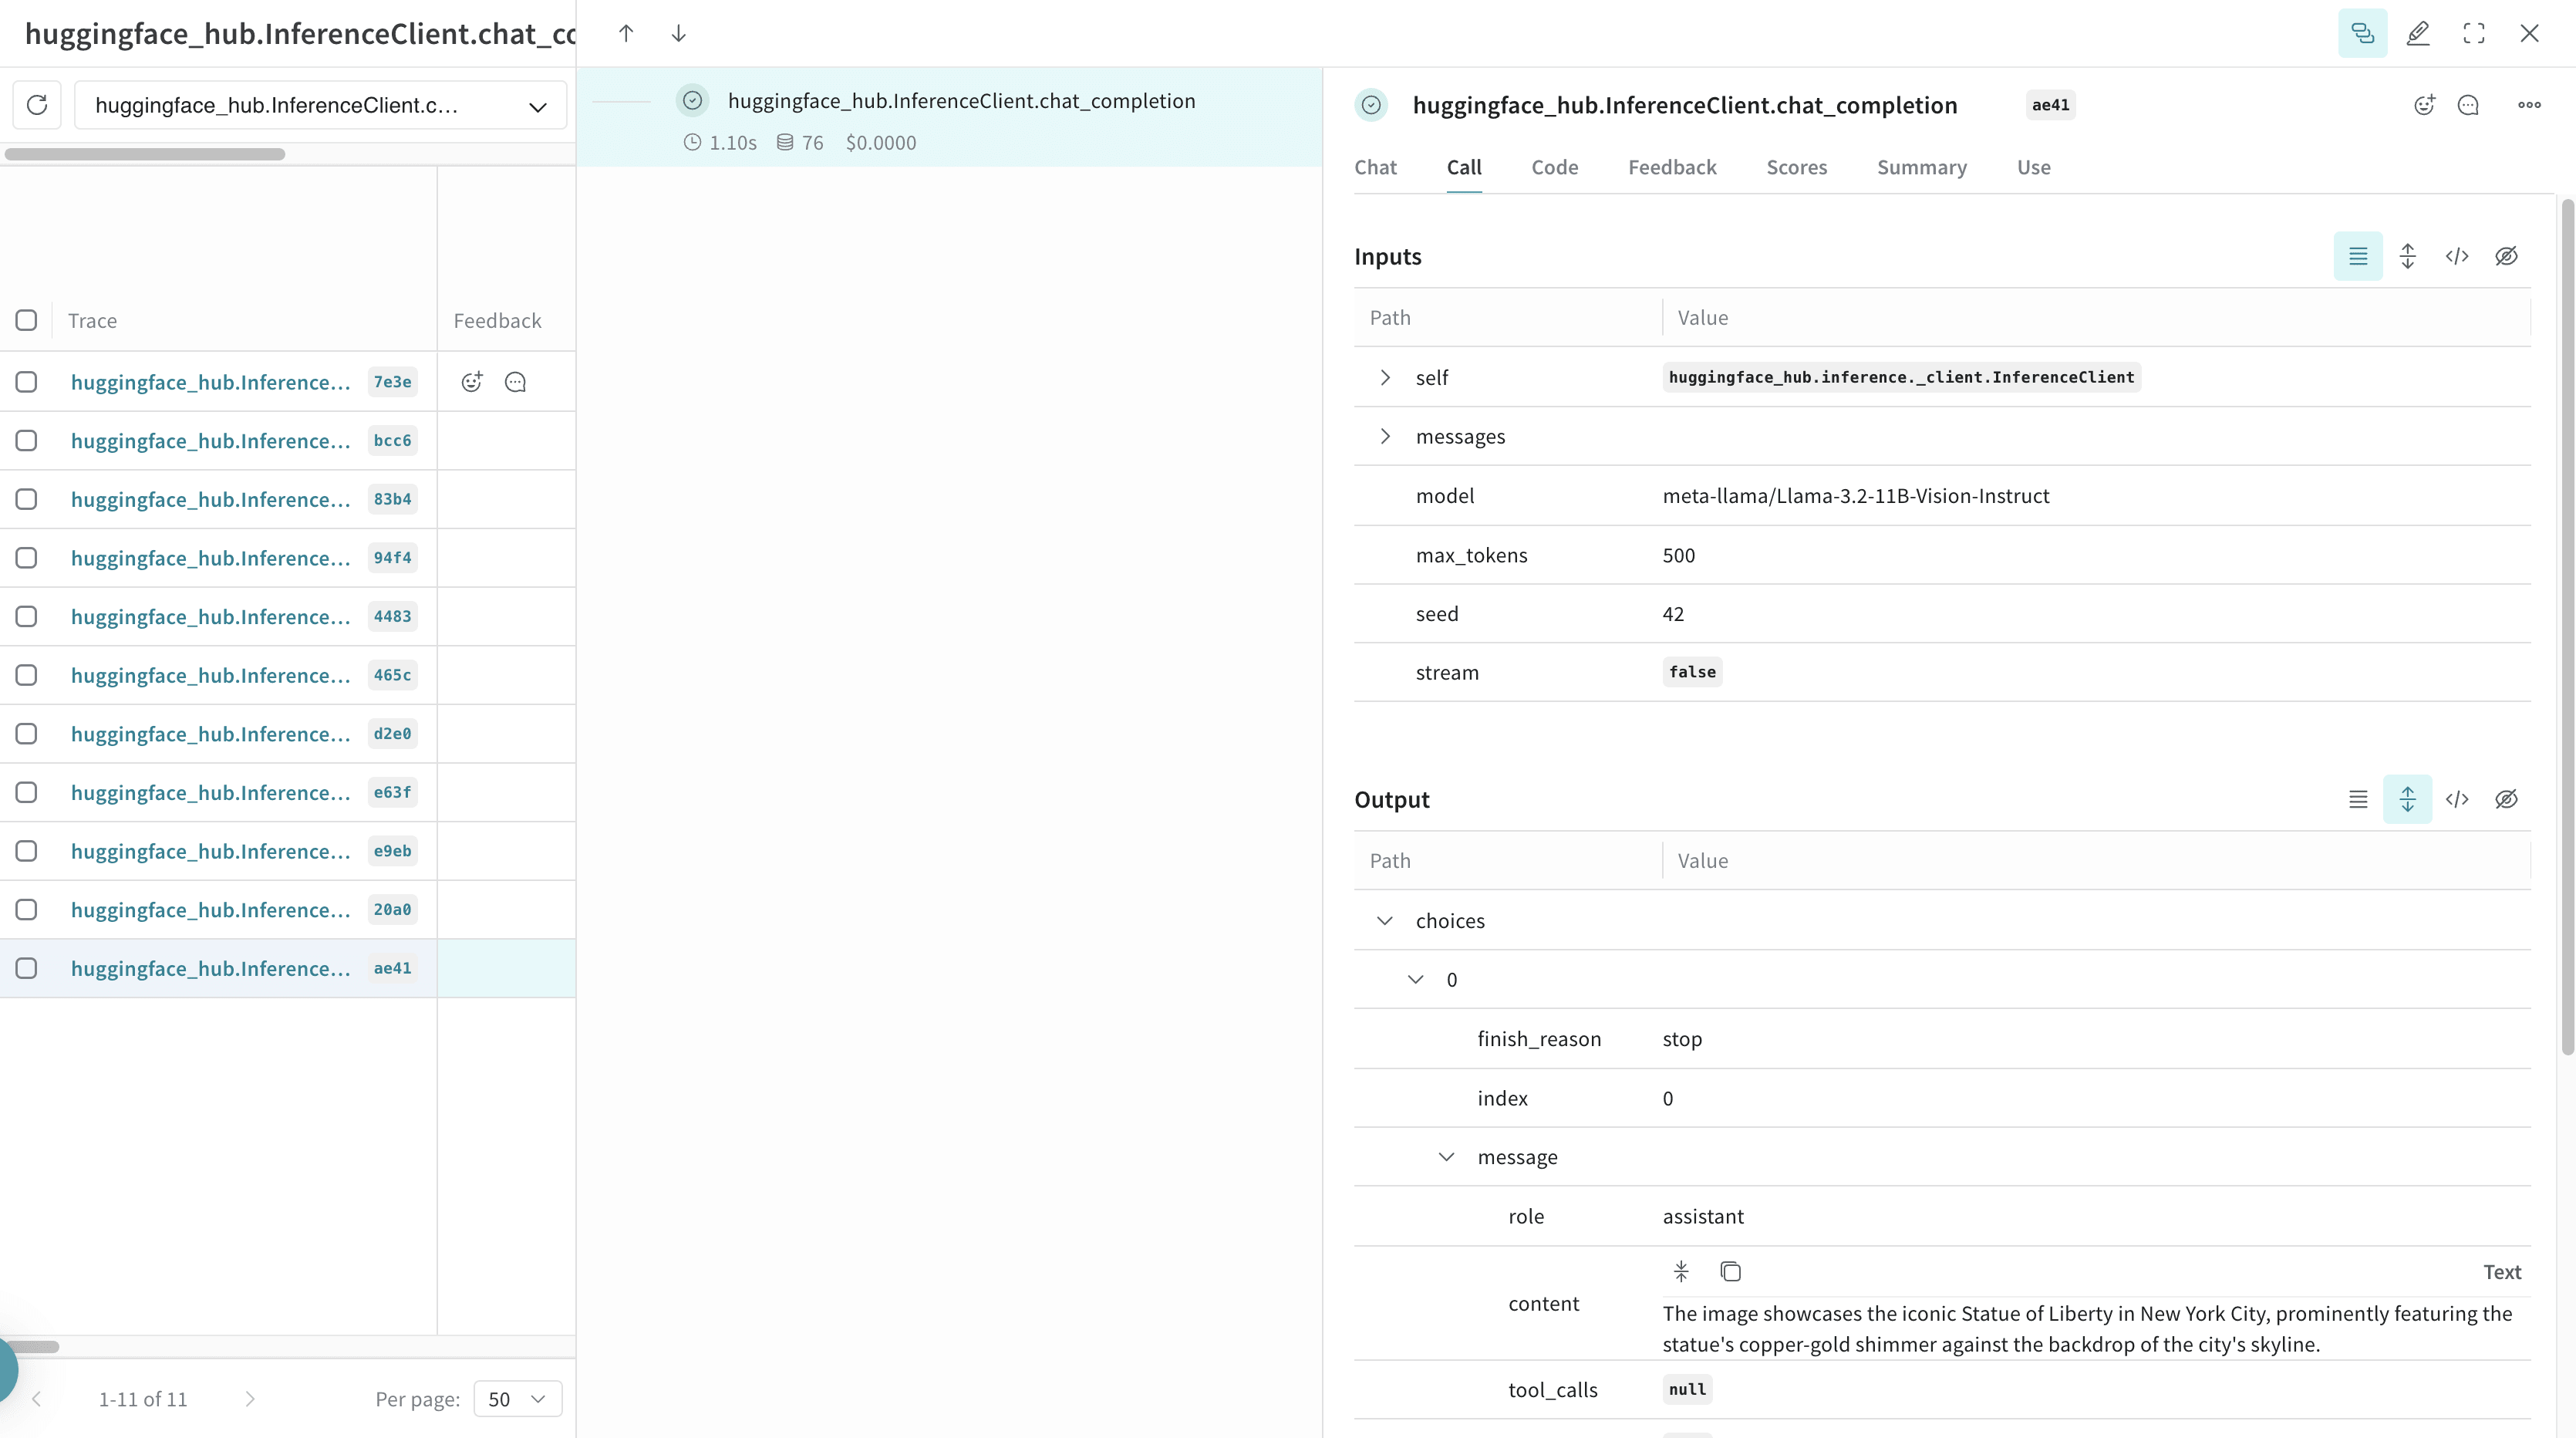 Weave는 각 추론 Call을 로깅하고 입력, 출력, 메타데이터에 대한 세부 정보를 제공합니다.
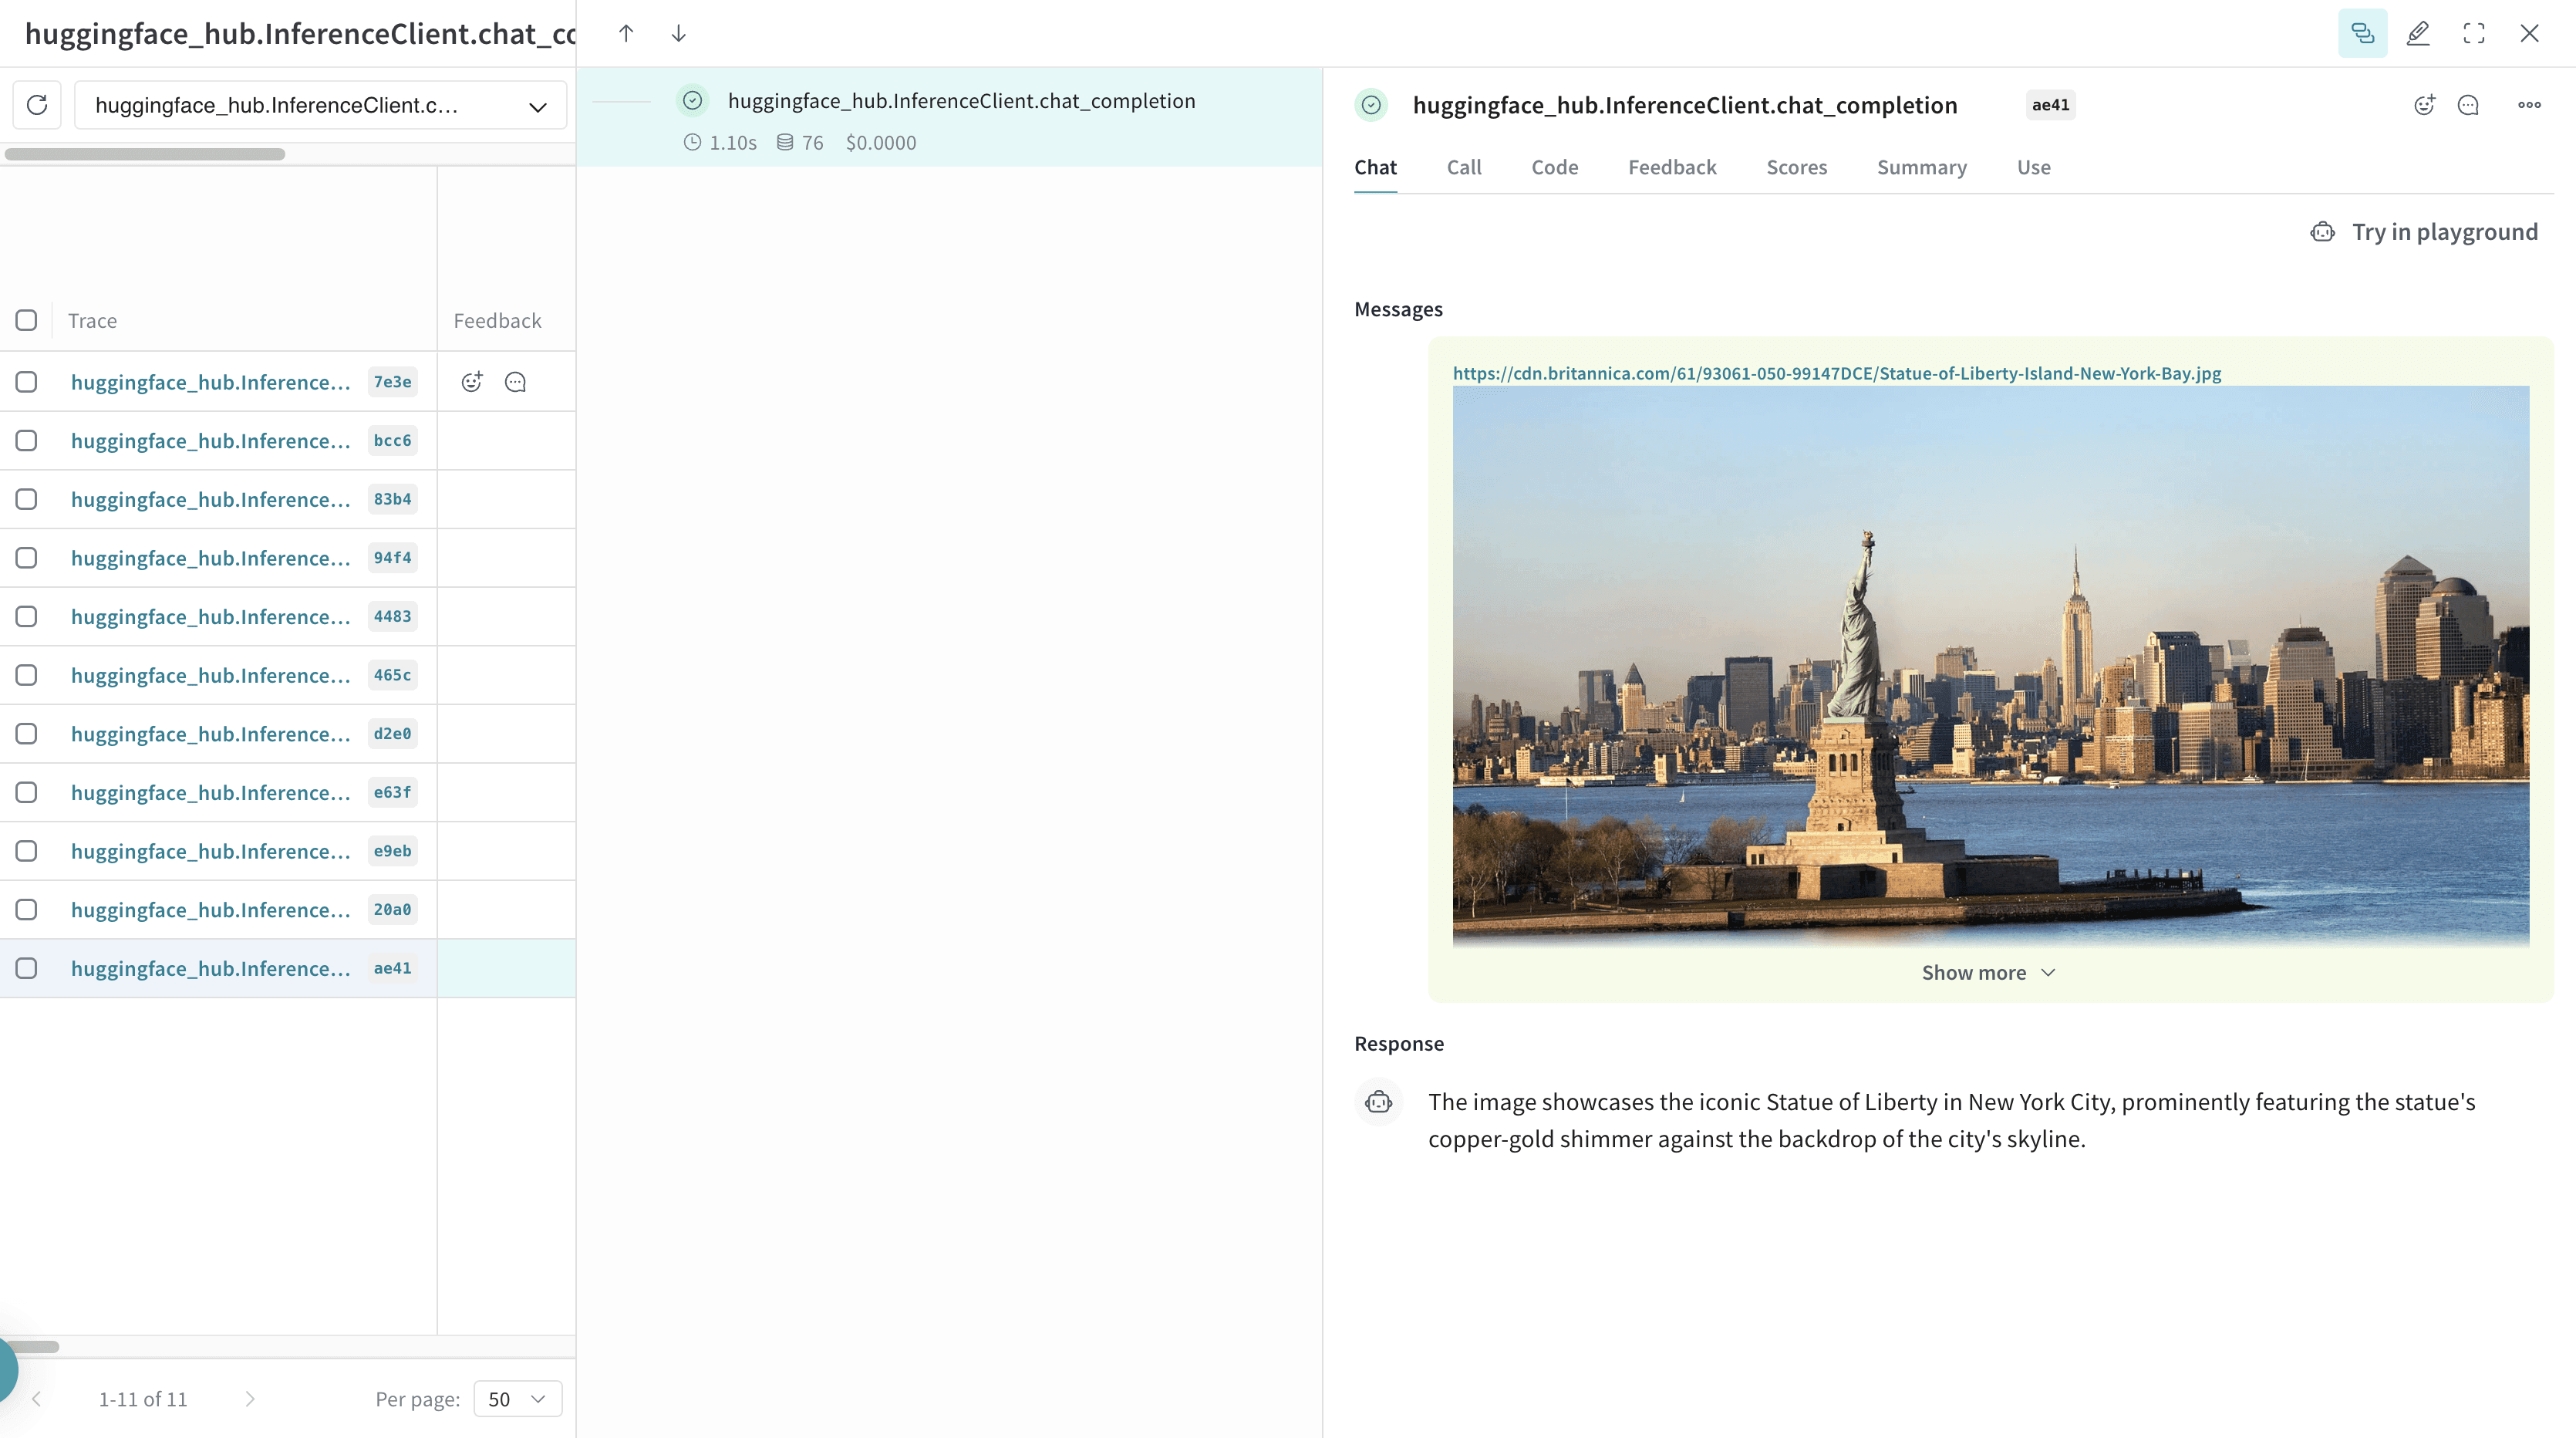 또한 Weave는 UI에서 Call을 채팅 뷰로 렌더링하여 모델과 주고받은 전체 채팅 이력을 보여 줍니다.
함수 트레이스하기
애플리케이션에서 데이터가 어떻게 흐르는지 더 깊이 파악하려면 `@weave.op`를 사용해 함수 Call을 추적하세요. 입력, 출력, 실행 로직이 캡처되므로 디버깅과 성능 분석에 도움이 됩니다.
여러 Op를 중첩하면 추적 대상 함수들로 이루어진 구조화된 트리를 구축할 수 있습니다. 또한 Weave는 코드 버전을 자동으로 관리하므로, Git에 변경 사항을 커밋하기 전이라도 실험 중의 중간 상태가 보존됩니다.
추적을 시작하려면 추적할 함수에 `@weave.op` 데코레이터를 추가하세요.
다음 예시에서 Weave는 `generate_image`, `check_image_correctness`, `generate_image_and_check_correctness`의 세 함수를 추적합니다. 이 함수들은 이미지를 생성한 뒤, 해당 이미지가 주어진 프롬프트와 일치하는지 검증합니다.
```python lines theme={"system"}
import base64
from PIL import Image
def encode_image(pil_image):
import io
buffer = io.BytesIO()
pil_image.save(buffer, format="JPEG")
buffer.seek(0)
encoded_image = base64.b64encode(buffer.read()).decode("utf-8")
return f"data:image/jpeg;base64,{encoded_image}"
@weave.op
def generate_image(prompt: str):
return huggingface_client.text_to_image(
prompt=prompt,
model="black-forest-labs/FLUX.1-schnell",
num_inference_steps=4,
)
@weave.op
def check_image_correctness(image: Image.Image, image_generation_prompt: str):
return huggingface_client.chat_completion(
model="meta-llama/Llama-3.2-11B-Vision-Instruct",
messages=[
{
"role": "user",
"content": [
{"type": "image_url", "image_url": {"url": encode_image(image)}},
{
"type": "text",
"text": f"Is this image correct for the prompt: {image_generation_prompt}? Answer with only one word: yes or no",
},
],
}
],
max_tokens=500,
seed=42,
).choices[0].message.content
@weave.op
def generate_image_and_check_correctness(prompt: str):
image = generate_image(prompt)
return {
"image": image,
"is_correct": check_image_correctness(image, prompt),
}
response = generate_image_and_check_correctness("A cute puppy")
```
이제 Weave는 `@weave.op`으로 래핑된 모든 함수 Call을 로깅하므로, Weights & Biases UI에서 실행 세부 정보를 분석할 수 있습니다.
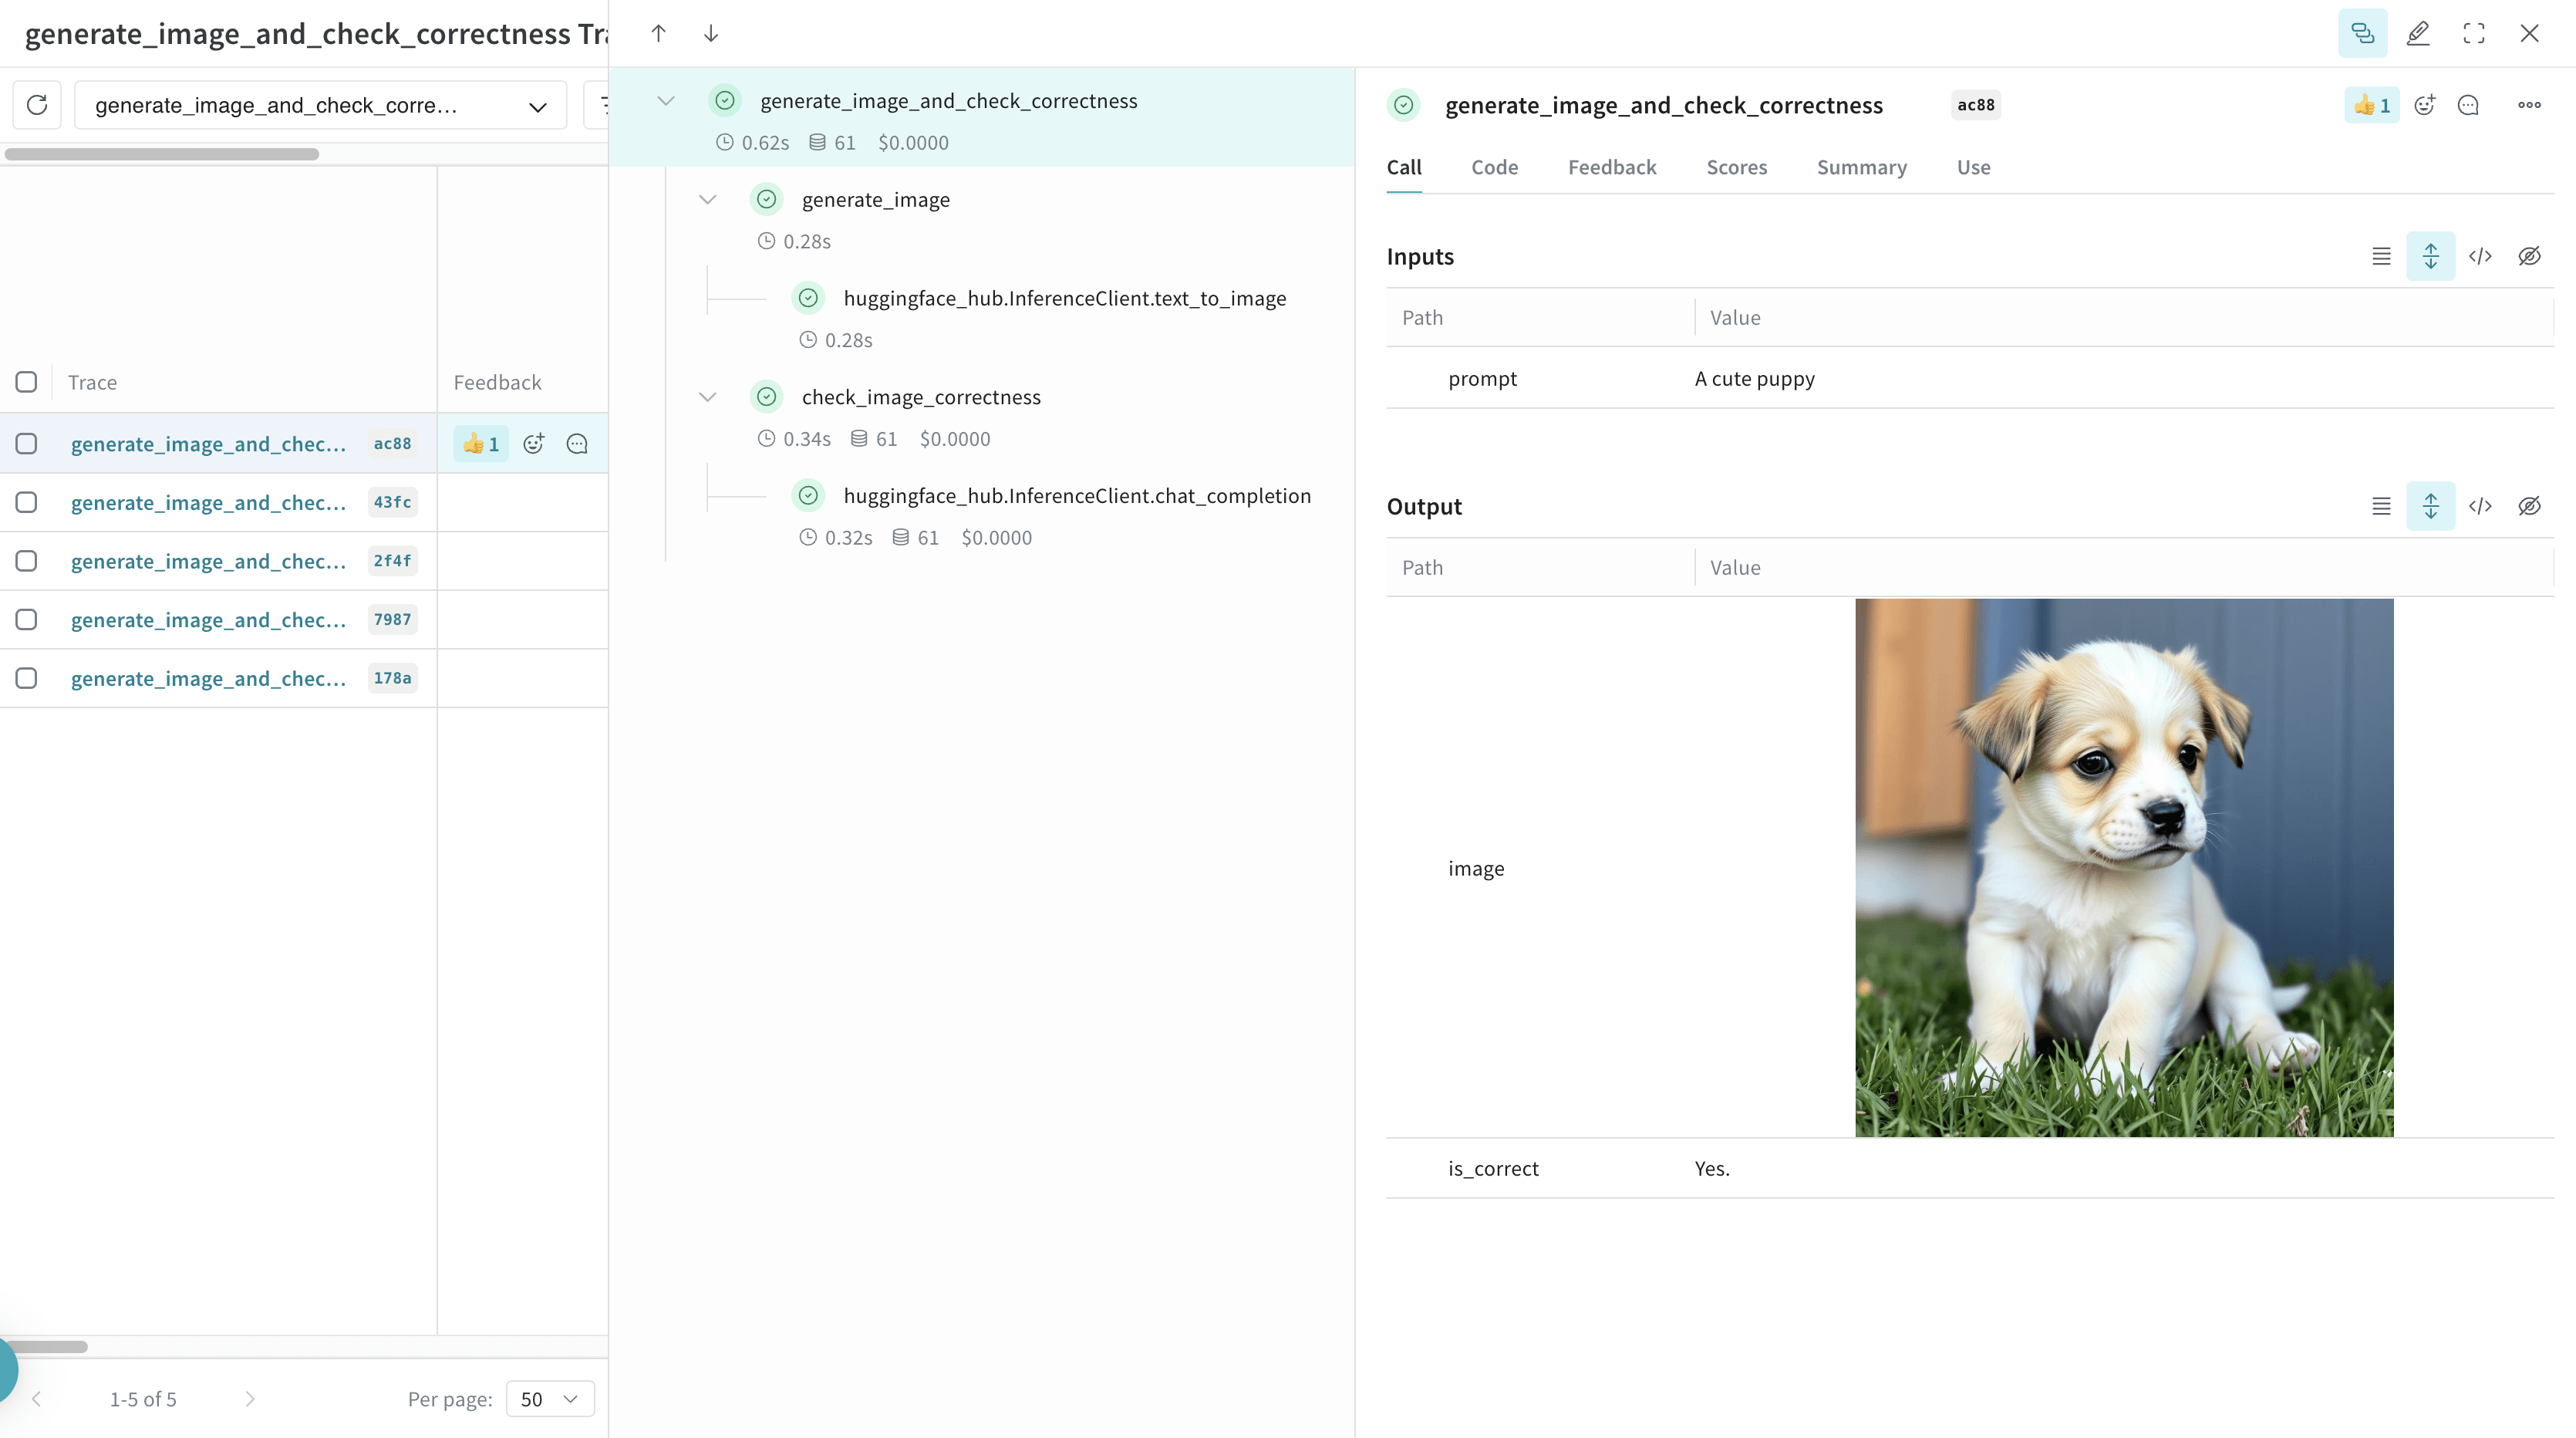 또한 Weave는 함수 실행을 캡처하고 시각화하므로 애플리케이션 내의 데이터 흐름과 로직을 쉽게 파악할 수 있습니다.
실험에 `Model` 사용하기
여러 컴포넌트가 얽힌 LLM 실험은 관리하기가 까다로울 수 있습니다. Weave [`Model`](/ko/products/wandb/weave/guides/core-types/models) 클래스를 사용하면 system 프롬프트나 모델 설정 같은 실험 세부 정보를 캡처하고 정리할 수 있어, 여러 반복 버전을 비교할 수 있습니다.
`Model`은 코드 버전 관리와 입력 및 출력 캡처 외에도 애플리케이션 동작을 제어하는 구조화된 매개변수를 저장합니다. 덕분에 어떤 설정이 가장 좋은 결과를 냈는지 추적할 수 있습니다. 또한 Weave `Model`을 Weave [Serve](/ko/products/wandb/weave/guides/tools/serve) 및 [Evaluations](/ko/products/wandb/weave/guides/evaluation/scorers)와 통합하면 더 깊은 인사이트를 얻을 수 있습니다.
다음 예시는 여행지를 추천하는 `CityVisitRecommender` 모델을 정의합니다. 매개변수를 수정할 때마다 새 버전이 생성되므로 반복적으로 실험할 수 있습니다.
```python lines theme={"system"}
import rich
class CityVisitRecommender(weave.Model):
model: str
temperature: float = 0.7
max_tokens: int = 500
seed: int = 42
@weave.op()
def predict(self, city: str) -> str:
return huggingface_client.chat_completion(
model=self.model,
messages=[
{
"role": "system",
"content": "You are a helpful assistant meant to suggest places to visit in a city",
},
{"role": "user", "content": city},
],
max_tokens=self.max_tokens,
temperature=self.temperature,
seed=self.seed,
).choices[0].message.content
city_visit_recommender = CityVisitRecommender(
model="meta-llama/Llama-3.2-11B-Vision-Instruct",
temperature=0.7,
max_tokens=500,
seed=42,
)
rich.print(city_visit_recommender.predict("New York City"))
rich.print(city_visit_recommender.predict("Paris"))
```
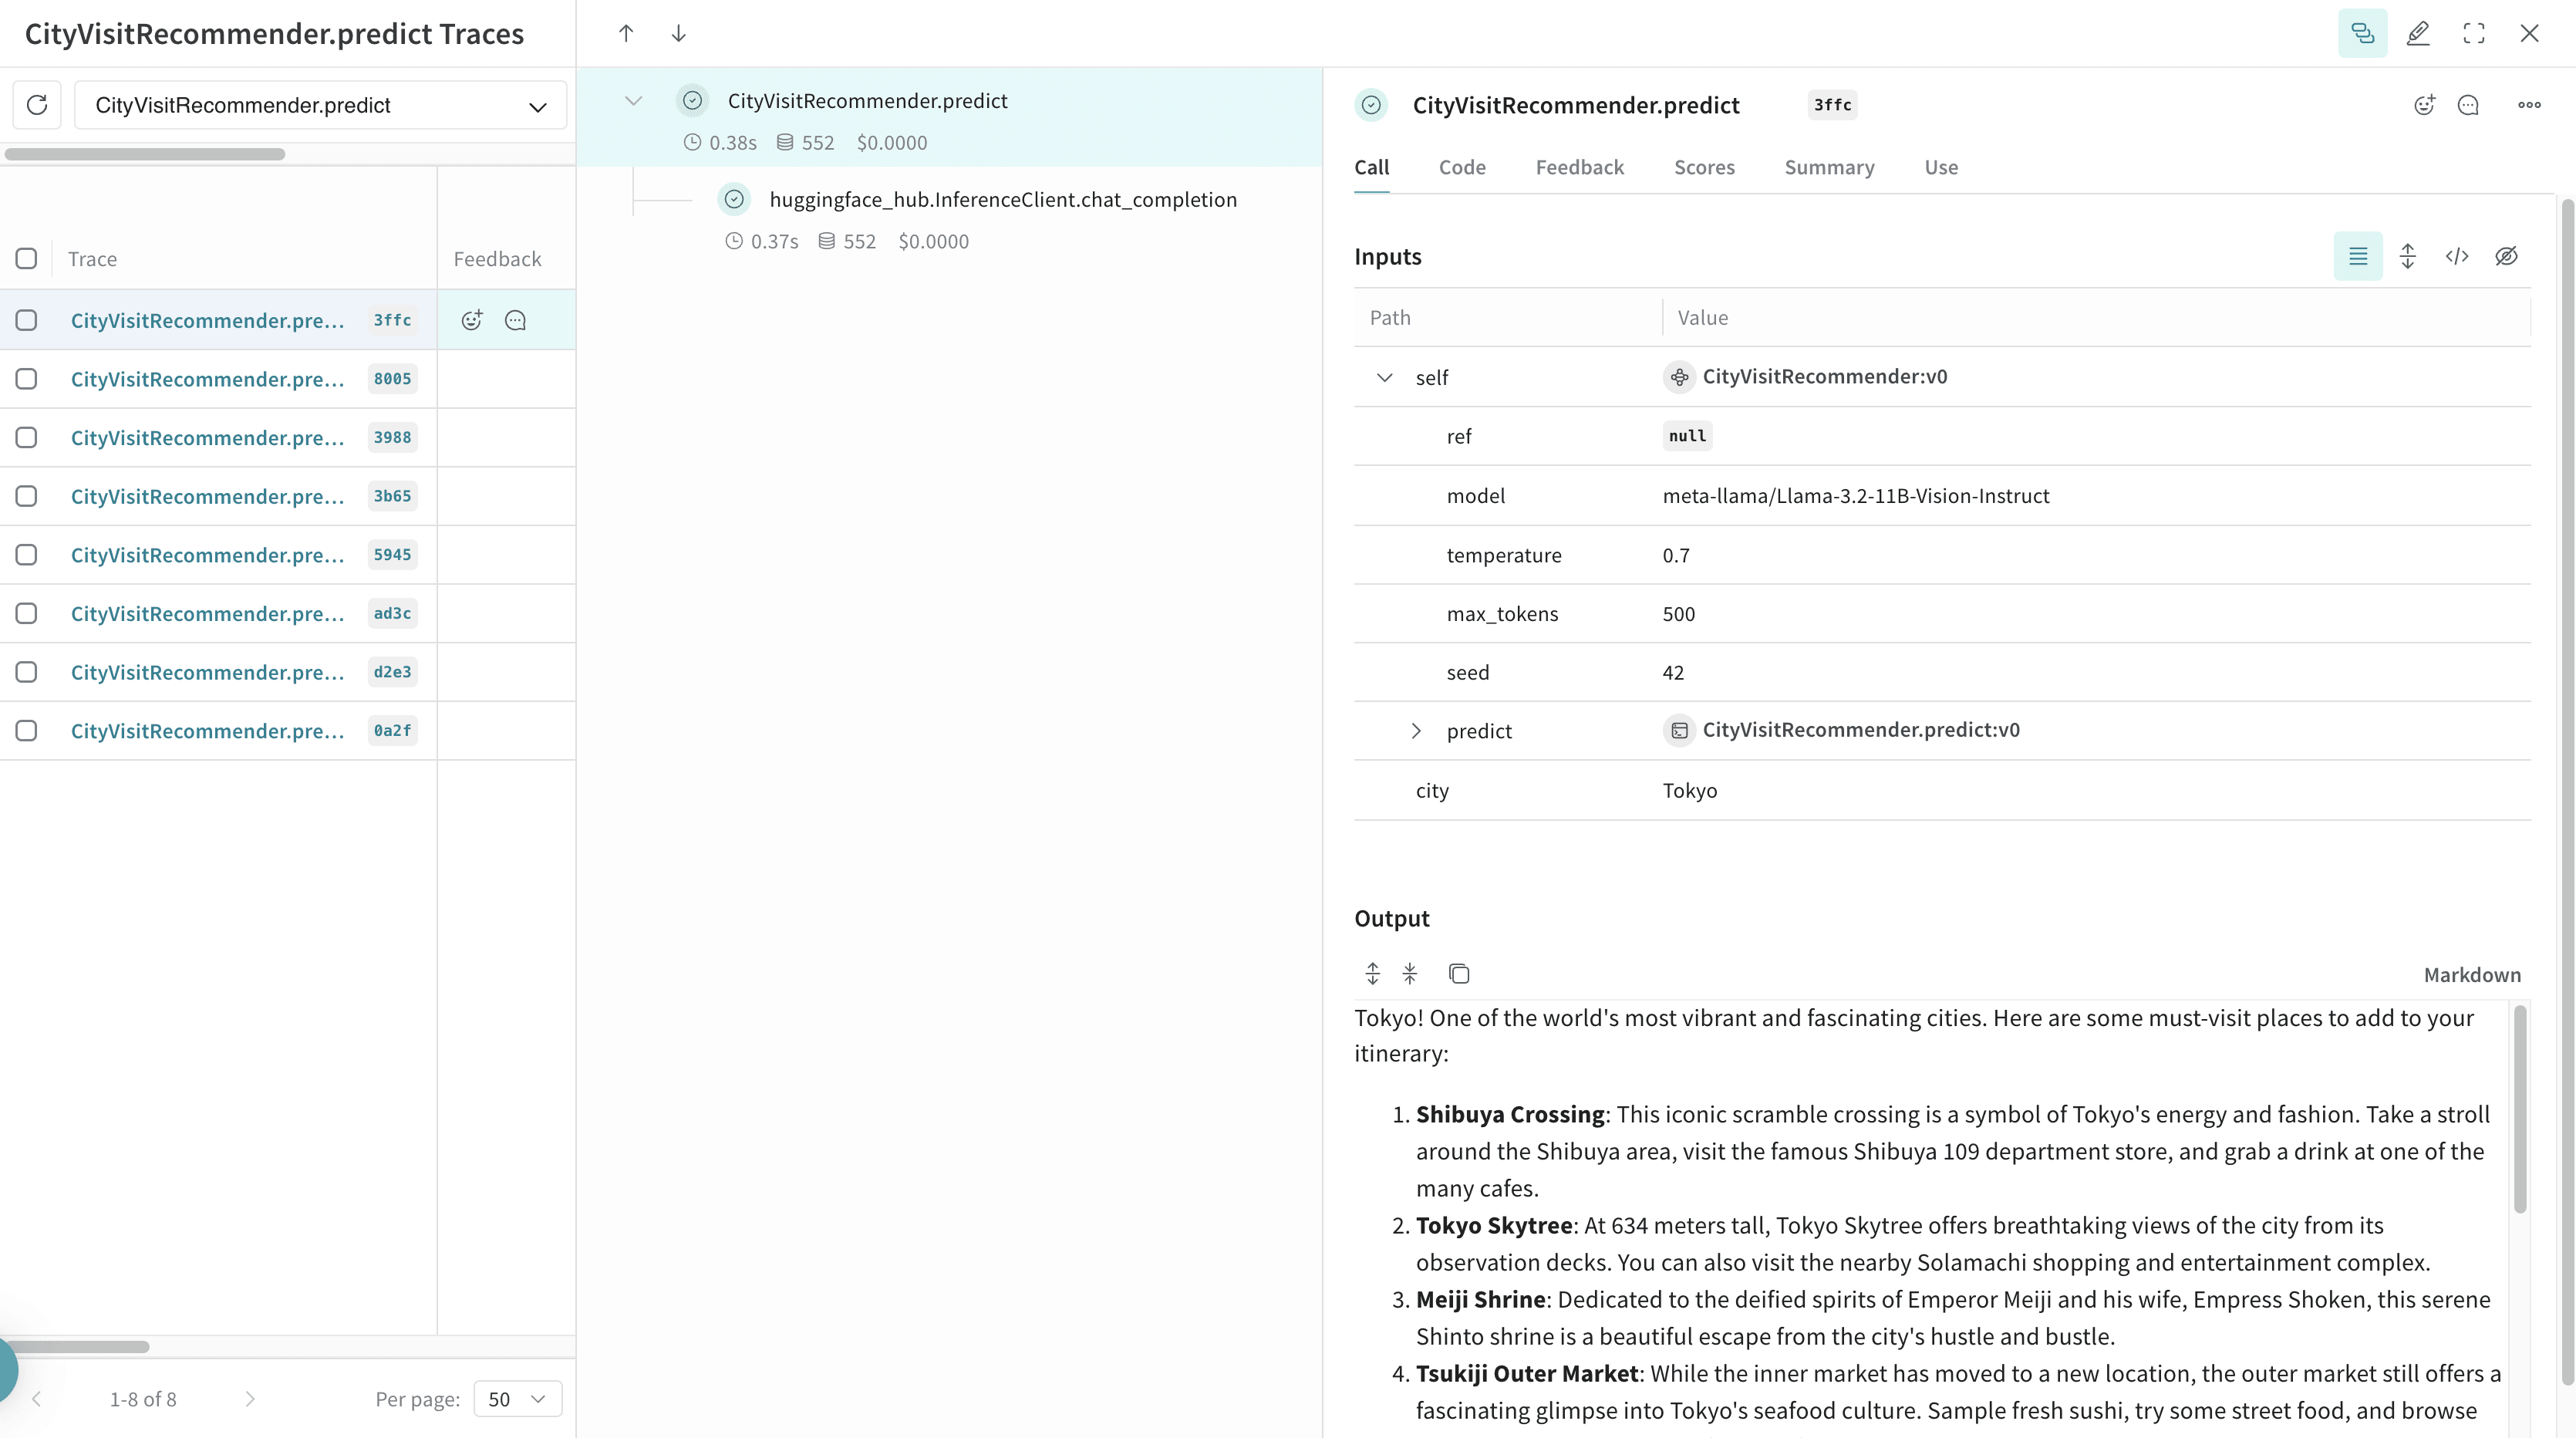
Weave는 모델을 자동으로 로깅하고 버전별로 추적하므로 성능과 실험 이력을 분석할 수 있습니다.
 ## Related topics
- [예시 코드 및 노트북](/ko/products/wandb/examples.md)