> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
# 코드 생성
> W&B Weave로 코드 생성 파이프라인을 구축하고 평가하며, 프롬프트, 출력, 품질 메트릭을 트레이스하세요.
이 문서는 대화형 노트북입니다. 로컬에서 실행하거나 다음 링크를 이용하세요.
* [Google Colab에서 열기](https://colab.research.google.com/github/wandb/docs/blob/main/weave/cookbooks/source/codegen.ipynb)
* [GitHub에서 소스 보기](https://github.com/wandb/docs/blob/main/weave/cookbooks/source/codegen.ipynb)
적절한 구조와 문서, 테스트를 갖춘 고품질 코드를 생성하기란 쉽지 않습니다. 이 가이드는 LLM 기반 코드 생성 워크플로를 구축하고 그 품질을 체계적으로 측정하려는 개발자를 대상으로 합니다. 이 노트북에서는 Python 함수를 생성하고 이를 HumanEval 테스트 스위트로 평가하는 코드 생성 파이프라인을 만드는 방법을 알아봅니다. 이 파이프라인은 평가 비교와 추적에는 Weave를, 구조화된 출력 기반의 코드 생성에는 OpenAI의 GPT 모델을 사용합니다.
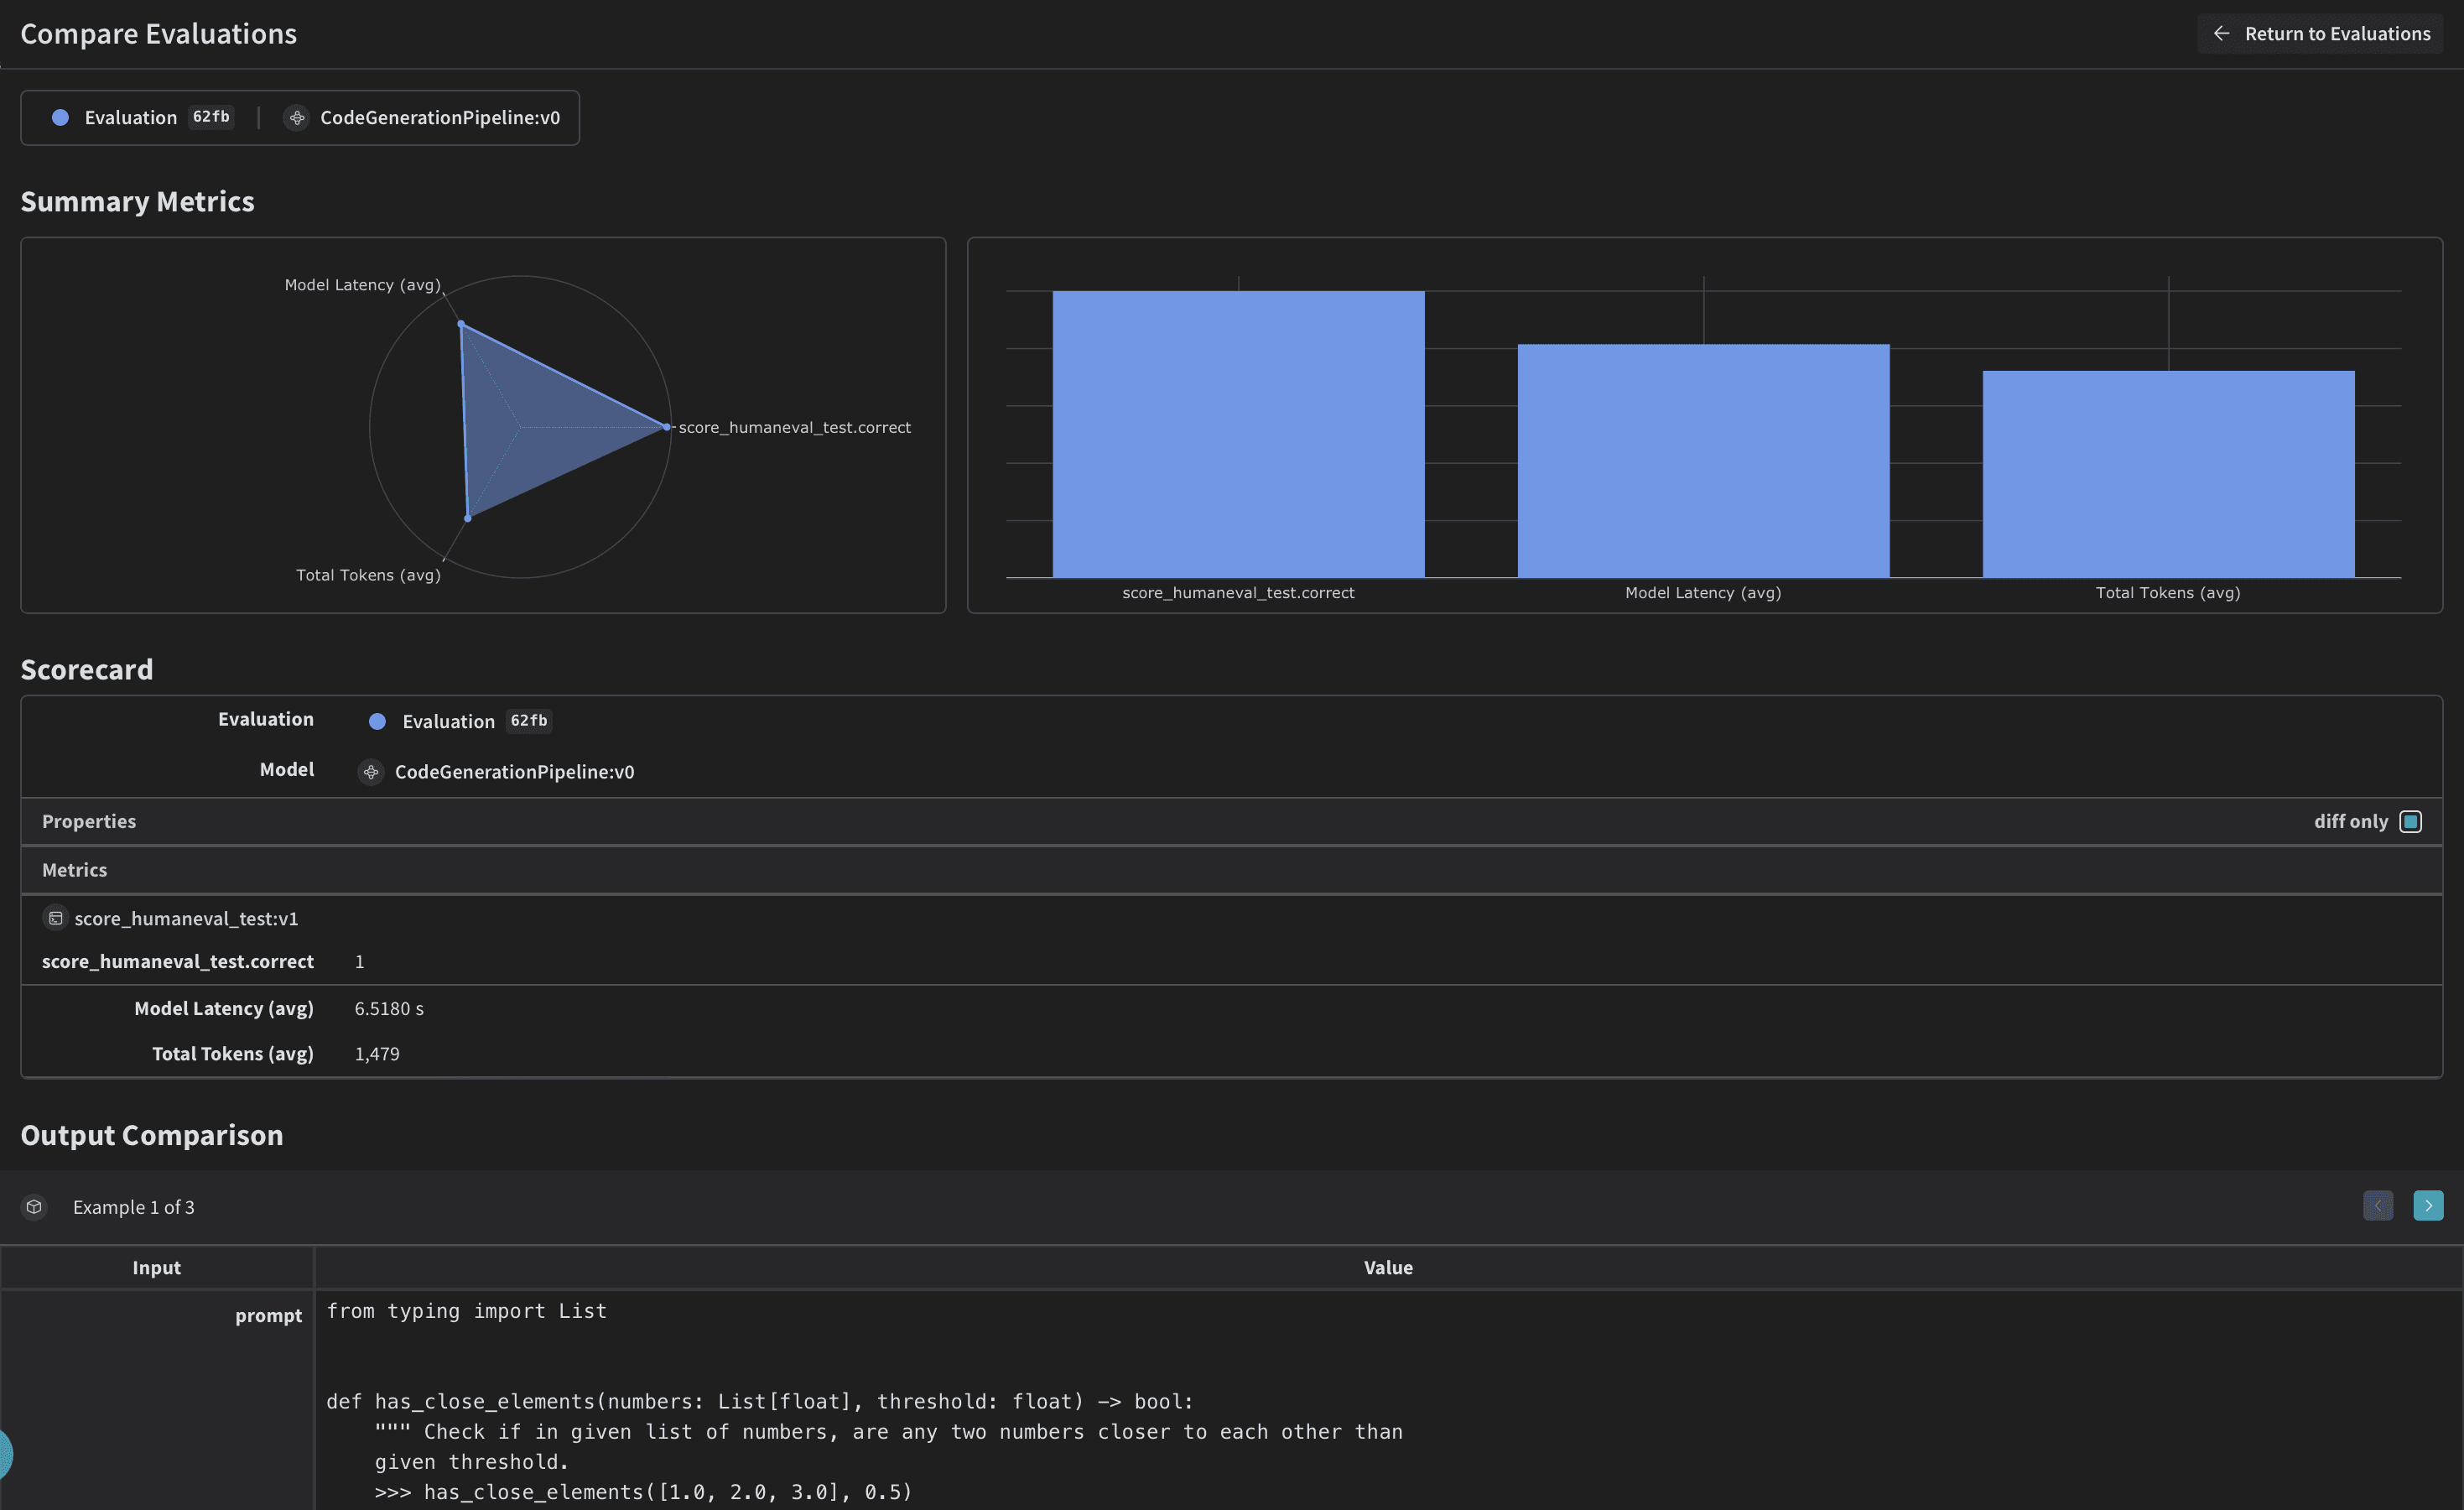
Weave를 사용하는 이유
이 튜토리얼에서는 Weave를 사용하여 코드 생성 파이프라인을 구현하고 평가합니다. 이 튜토리얼에서 배울 내용은 다음과 같습니다.
* **LLM 파이프라인 추적**: 코드 생성 프로세스의 입력, 출력, 중간 단계를 로깅합니다.
* **LLM 출력 평가**: 디버깅 도구와 시각화를 활용해 생성된 코드에 대한 평가를 만들고 비교합니다.
환경 설정
환경을 설정하고 필요한 라이브러리를 임포트하세요. 이러한 의존성은 파이프라인 전반에서 사용되는 서식 지정 도구, 데이터셋 로더, OpenAI 및 Weave 클라이언트를 제공합니다.
```python lines theme={"system"}
!pip install -qU autopep8 autoflake weave isort openai set-env-colab-kaggle-dotenv datasets
python
%%capture
# openai 버그를 해결하기 위한 임시 조치:
# TypeError: Client.__init__() got an unexpected keyword argument 'proxies'
# 참고: https://community.openai.com/t/error-with-openai-1-56-0-client-init-got-an-unexpected-keyword-argument-proxies/1040332/15
!pip install "httpx<0.28"
python
import ast
import os
import re
import subprocess
import tempfile
import traceback
import autopep8
import isort
from autoflake import fix_code
from datasets import load_dataset
from openai import OpenAI
from pydantic import BaseModel
from set_env import set_env
import weave
from weave import Dataset, Evaluation
set_env("WANDB_API_KEY")
set_env("OPENAI_API_KEY")
python
WEAVE_PROJECT = "codegen-cookbook-example"
weave.init(WEAVE_PROJECT)
python
client = OpenAI()
python
human_eval = load_dataset("openai_humaneval")
selected_examples = human_eval["test"][:3]
```
Weave는 입력, 출력, 메타데이터를 포함한 OpenAI API 호출을 자동으로 추적합니다. OpenAI와의 상호작용을 로깅하기 위해 별도의 코드를 추가할 필요가 없습니다. Weave가 백그라운드에서 모두 처리합니다.
구조화된 출력과 Pydantic 모델
이 코드 생성 파이프라인은 OpenAI의 [구조화된 출력 모드](https://platform.openai.com/docs/guides/structured-outputs)와 Pydantic 모델을 사용하여 언어 모델에서 일관되고 형식이 잘 갖춰진 응답을 생성합니다. 이 방식에는 다음과 같은 이점이 있습니다.
* **유형 안전성**: 예상 출력에 맞는 Pydantic 모델을 정의하면 생성된 코드, 프로그램 러너, 단위 테스트에 엄격한 구조가 강제 적용됩니다.
* **간편한 파싱**: 구조화된 출력 모드는 모델의 응답을 사전 정의된 Pydantic 모델로 바로 파싱하므로 복잡한 후처리 작업이 줄어듭니다.
* **안정성 향상**: 원하는 형식을 정확히 지정하면 언어 모델이 예기치 않은 출력이나 잘못된 형식의 출력을 생성할 가능성이 줄어듭니다.
다음 예시에서는 Pydantic 모델을 정의하고 이를 OpenAI의 구조화된 출력과 함께 사용합니다.
```python lines theme={"system"}
class GeneratedCode(BaseModel):
function_signature: str
function_args_with_docstring_within_triple_quotes: str
code_logic: str
class FormattedGeneratedCode(BaseModel):
full_code: str
```
일관되고 깔끔한 코드를 출력하려면 Weave 오퍼레이션을 사용해 `CodeFormatter` 클래스를 구현하세요. 이 포매터는 생성된 코드, 프로그램 러너, 단위 테스트에 린팅 및 스타일 규칙을 적용합니다.
```python lines theme={"system"}
class CodeFormatter(BaseModel):
@weave.op()
def lint_code(self, code: str) -> str:
# 이스케이프된 줄바꿈 문자를 실제 줄바꿈으로 바꿉니다
code = code.replace("\\n", "\n")
# 사용하지 않는 임포트와 변수를 제거합니다
code = fix_code(
code, remove_all_unused_imports=True, remove_unused_variables=True
)
# 임포트를 정렬합니다
code = isort.code(code)
# PEP 8 포매팅을 적용합니다
code = autopep8.fix_code(code, options={"aggressive": 2})
return code
@weave.op()
def add_imports(self, code: str) -> str:
tree = ast.parse(code)
from_imports = {}
global_names = set()
for node in ast.walk(tree):
if isinstance(node, ast.Name) and node.id not in dir(__builtins__):
global_names.add(node.id)
# 실제로 사용되는 typing 임포트만 추가합니다
typing_imports = global_names.intersection(
{"List", "Dict", "Tuple", "Set", "Optional", "Union"}
)
if typing_imports:
from_imports["typing"] = typing_imports
# 함수 내부에서 정의된 이름은 제외합니다
function_def = next(
node for node in tree.body if isinstance(node, ast.FunctionDef)
)
local_names = {arg.arg for arg in function_def.args.args}
local_names.update(
node.id
for node in ast.walk(function_def)
if isinstance(node, ast.Name) and isinstance(node.ctx, ast.Store)
)
global_names -= local_names
global_names -= {"sorted"} # 내장 함수는 제외합니다
# import 문을 생성합니다
import_statements = []
for module, names in from_imports.items():
names_str = ", ".join(sorted(names))
import_statements.append(f"from {module} import {names_str}")
return (
"\n".join(import_statements) + ("\n\n" if import_statements else "") + code
)
@weave.op()
def format_generated_code(
self, generated_code: GeneratedCode
) -> FormattedGeneratedCode:
# 코드 조각을 하나로 합칩니다
full_code = f"{generated_code.function_signature}\n{generated_code.function_args_with_docstring_within_triple_quotes}\n{generated_code.code_logic}"
# 들여쓰기를 올바르게 맞춥니다
lines = full_code.split("\n")
indented_lines = []
for i, line in enumerate(lines):
if i == 0: # 함수 시그니처
indented_lines.append(line)
elif i == 1: # 함수 인수(docstring)
indented_lines.append(" " + line)
else: # 함수 본문
indented_lines.append(" " + line)
full_code = "\n".join(indented_lines)
# 코드에 린트를 적용합니다
full_code = self.lint_code(full_code)
# 임포트를 추가합니다
cleaned_code = self.add_imports(full_code)
return FormattedGeneratedCode(full_code=cleaned_code)
```
이 `CodeFormatter` 클래스는 생성된 코드를 정리하고 포맷팅하는 여러 Weave 오퍼레이션을 제공합니다.
* 이스케이프된 줄바꿈 문자를 실제 줄바꿈으로 바꿉니다.
* 사용하지 않는 임포트와 변수를 제거합니다.
* 임포트를 정렬합니다.
* PEP 8 포맷팅을 적용합니다.
* 누락된 임포트를 추가합니다.
`CodeGenerationPipeline` 정의하기
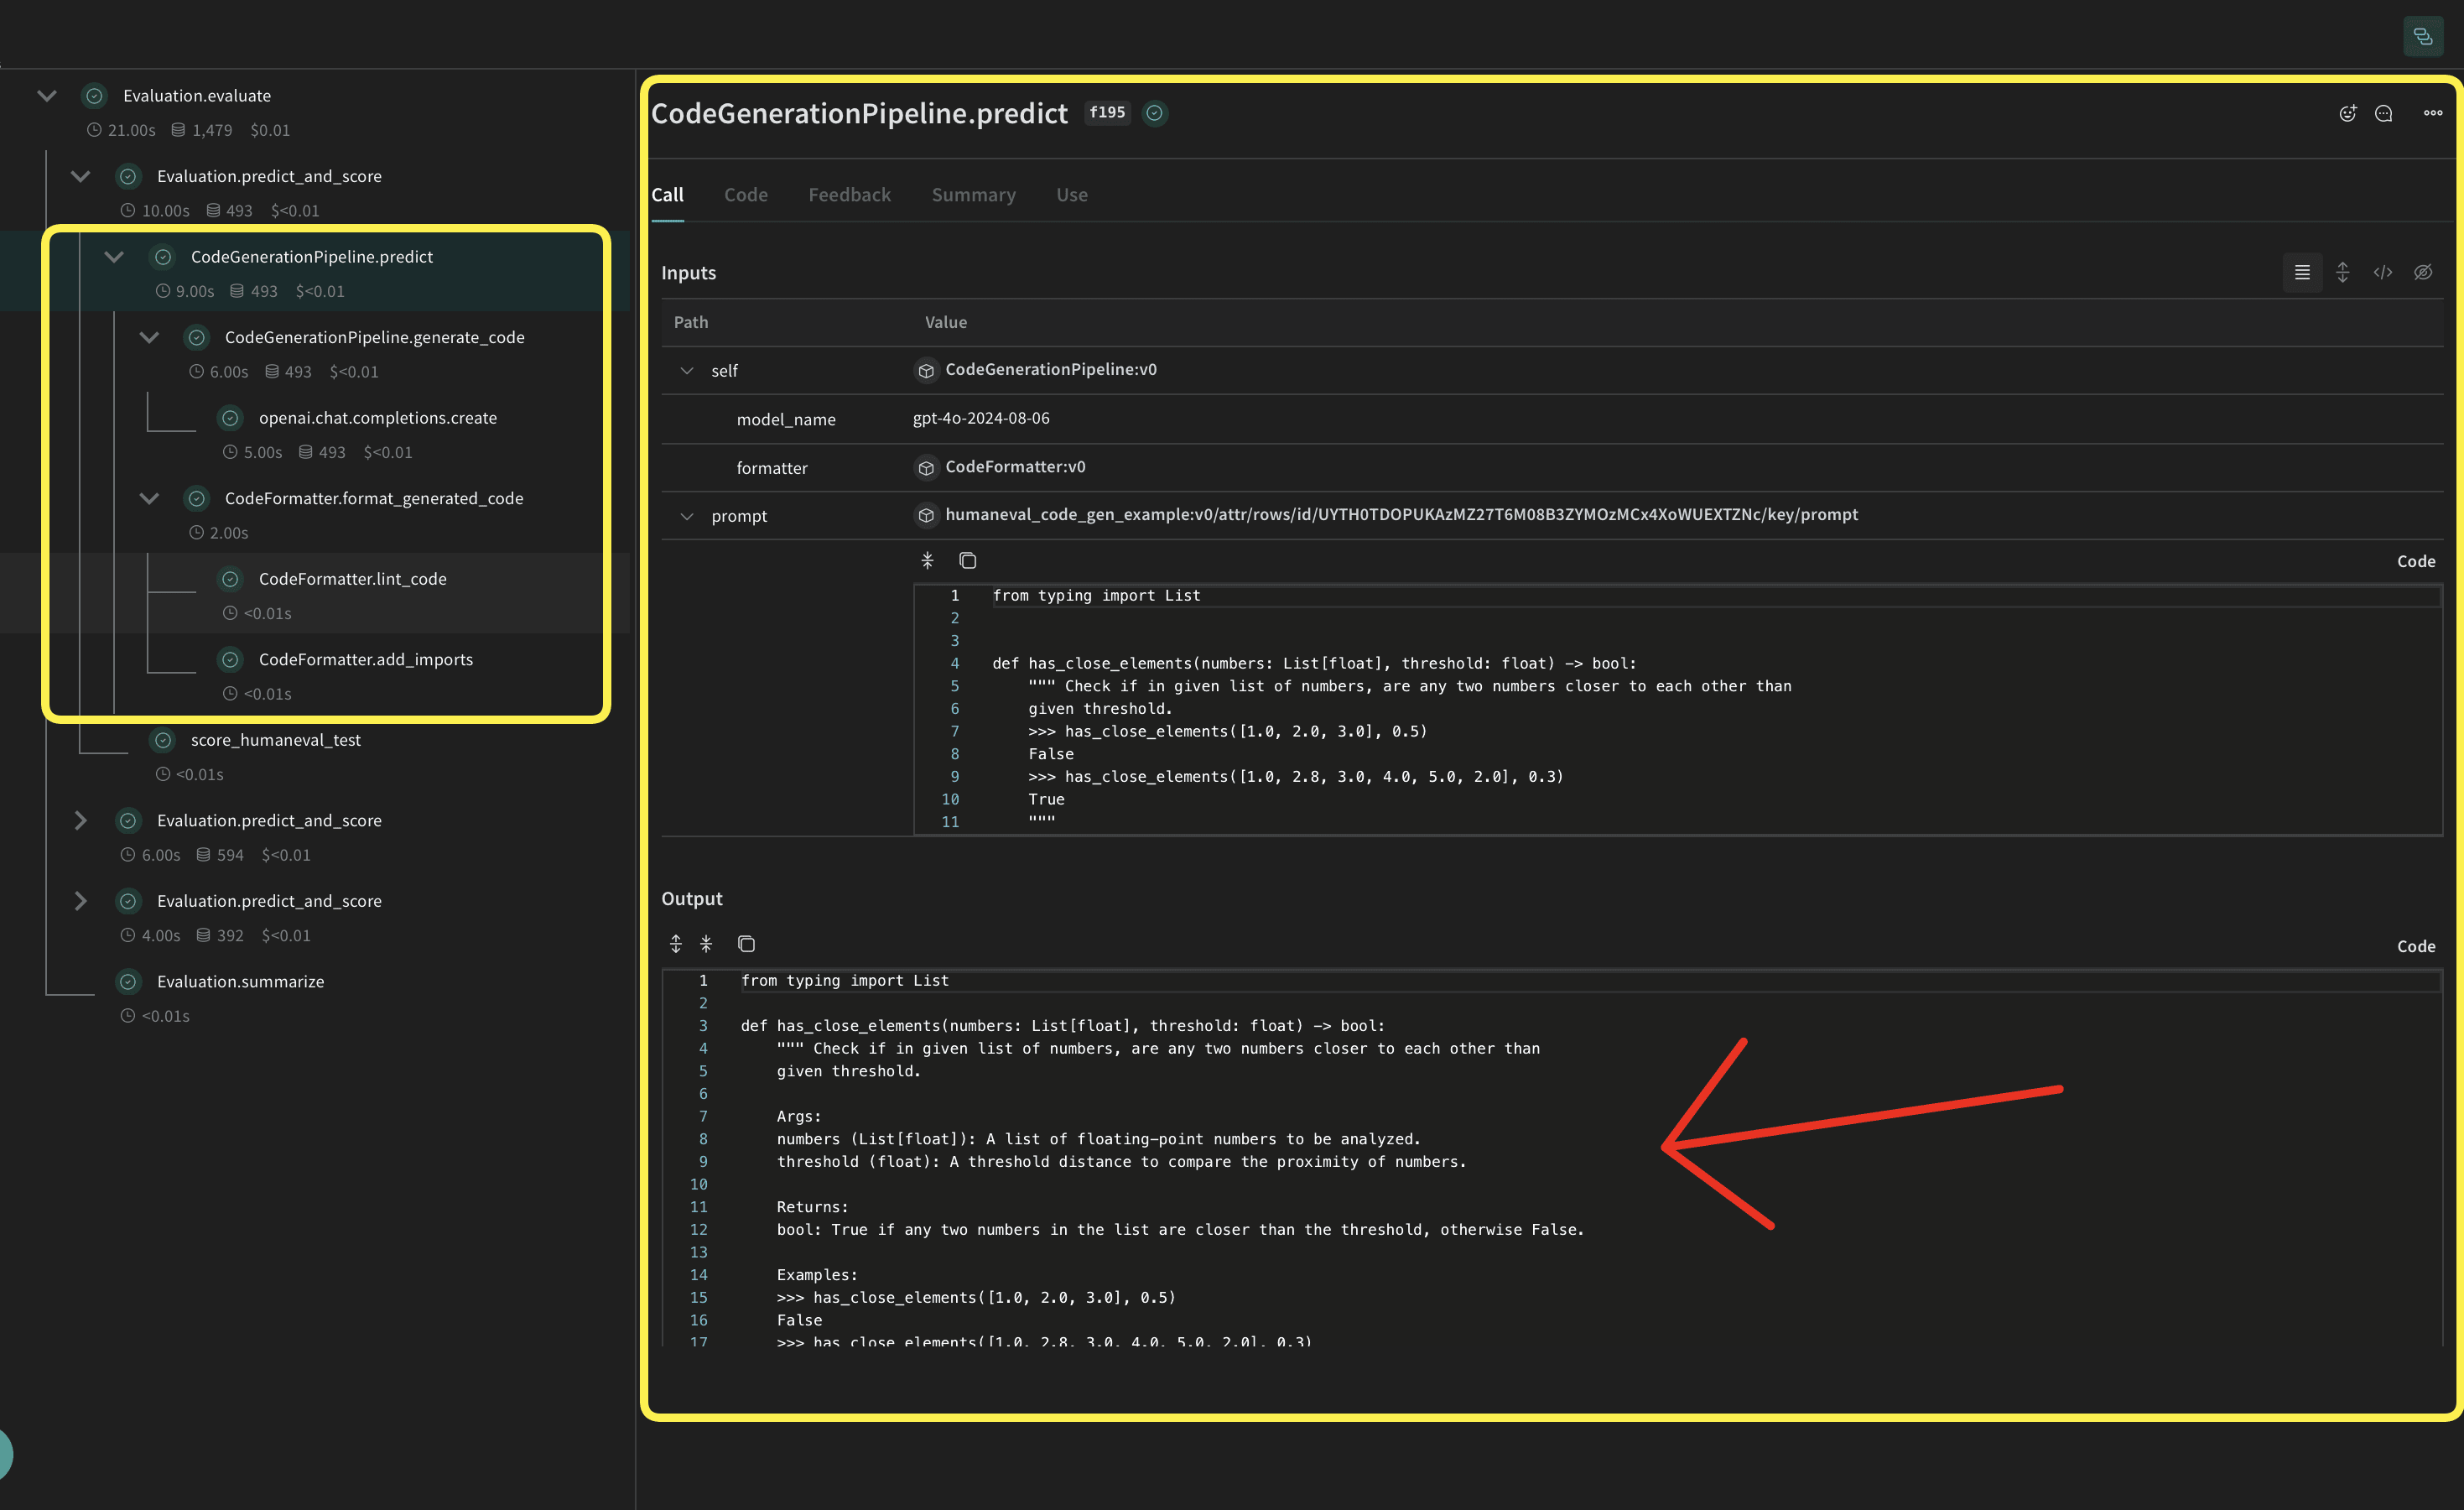 포매터가 준비되었으니, 이제 프롬프트, LLM Call, 포매터를 하나로 연결하는 핵심 코드 생성 로직을 구현합니다.
이 예제에서는 `weave.Model`을 사용하므로 모델이 변경될 때마다 버전이 자동으로 관리됩니다. `model_name`을 속성으로 두면 값을 바꿔 가며 실험하고 Weave에서 차이를 확인하고 비교할 수 있습니다. 함수 호출은 `@weave.op`으로 추적되며, 입력과 출력이 로깅되므로 오류 추적과 디버깅에 유용합니다.
```python lines theme={"system"}
class CodeGenerationPipeline(weave.Model):
model_name: str
formatter: CodeFormatter
def __init__(
self, model_name: str = "gpt-4o", formatter: CodeFormatter | None = None
):
if formatter is None:
formatter = CodeFormatter()
super().__init__(model_name=model_name, formatter=formatter)
self.model_name = model_name
self.formatter = formatter
@weave.op()
async def predict(self, prompt: str):
generated_code = self.generate_code(prompt)
formatted_generated_code = self.formatter.format_generated_code(generated_code)
return formatted_generated_code.full_code
@weave.op()
def generate_code(self, prompt: str) -> GeneratedCode:
completion = client.beta.chat.completions.parse(
model=self.model_name,
messages=[
{
"role": "system",
"content": "You are an expert Python code generator.",
},
{"role": "user", "content": prompt},
],
response_format=GeneratedCode,
)
message = completion.choices[0].message
if message.parsed:
return message.parsed
else:
raise ValueError(message.refusal)
```
이 `CodeGenerationPipeline` 클래스는 코드 생성 로직을 Weave Model로 캡슐화하며, 다음과 같은 이점을 제공합니다.
* 자동 실험 추적: Weave는 모델의 각 run마다 입력, 출력, 매개변수를 캡처합니다.
* 버전 관리: 모델의 속성이나 코드가 변경되면 자동으로 버전이 관리되므로, 코드 생성 파이프라인이 시간이 지남에 따라 어떻게 발전해 왔는지 이력으로 남습니다.
* 재현성: 버전 관리와 추적 기능 덕분에 코드 생성 파이프라인의 이전 결과나 설정을 언제든지 재현할 수 있습니다.
* 하이퍼파라미터 관리: 모델 속성(예: `model_name`)이 정의되고 여러 run에 걸쳐 추적되므로 실험을 더 쉽게 진행할 수 있습니다.
* Weave 생태계와의 인테그레이션: `weave.Model`을 사용하면 파이프라인을 평가, 서빙 기능 등 다른 Weave 도구와 연결할 수 있습니다.
평가 메트릭 구현하기
생성된 코드의 품질을 평가하려면 `weave.Scorer` 서브클래스로 평가 메트릭을 구현하세요. 이 서브클래스는 데이터셋의 모든 `model_output`에 대해 `score`를 실행합니다. `model_output`은 `weave.Model`의 `predict` 함수가 반환한 출력이고, `prompt`는 `human-eval` 데이터셋에서 가져옵니다.
```python lines theme={"system"}
CODE_TEMPLATE = """
{model_output}
{test}
if __name__ == "__main__":
check({entry_point})
"""
python
@weave.op()
async def score_humaneval_test(test: str, entry_point: str, output: str):
generated_code = output
# 테스트 문자열에서 테스트 케이스 추출
test_cases = re.findall(r"assert.*", test)
test_cases_str = "\n ".join(test_cases)
# 전체 소스 코드 생성
full_code = CODE_TEMPLATE.format(
model_output=generated_code,
test=test,
test_cases=test_cases_str,
entry_point=entry_point,
)
# 코드를 저장할 임시 파일 생성
with tempfile.NamedTemporaryFile(delete=False, suffix=".py") as tmp_file:
# 생성된 코드를 임시 파일에 기록
tmp_file.write(full_code.encode())
tmp_file_path = tmp_file.name
try:
# timeout을 설정하고 임시 Python 파일을 하위 프로세스로 실행
result = subprocess.run(
["python", tmp_file_path],
capture_output=True,
text=True,
timeout=10, # timeout 10초
)
print(result)
if result.returncode == 0:
return {"correct": True}
else:
return {"correct": False, "error": result.stderr, "output": result.stdout}
except subprocess.TimeoutExpired:
return {"correct": False, "error": "TimeoutExpired"}
except Exception as e:
return {"correct": False, "error": traceback.format_exc()}
finally:
# 실행이 끝나면 임시 파일을 반드시 삭제
os.remove(tmp_file_path)
```
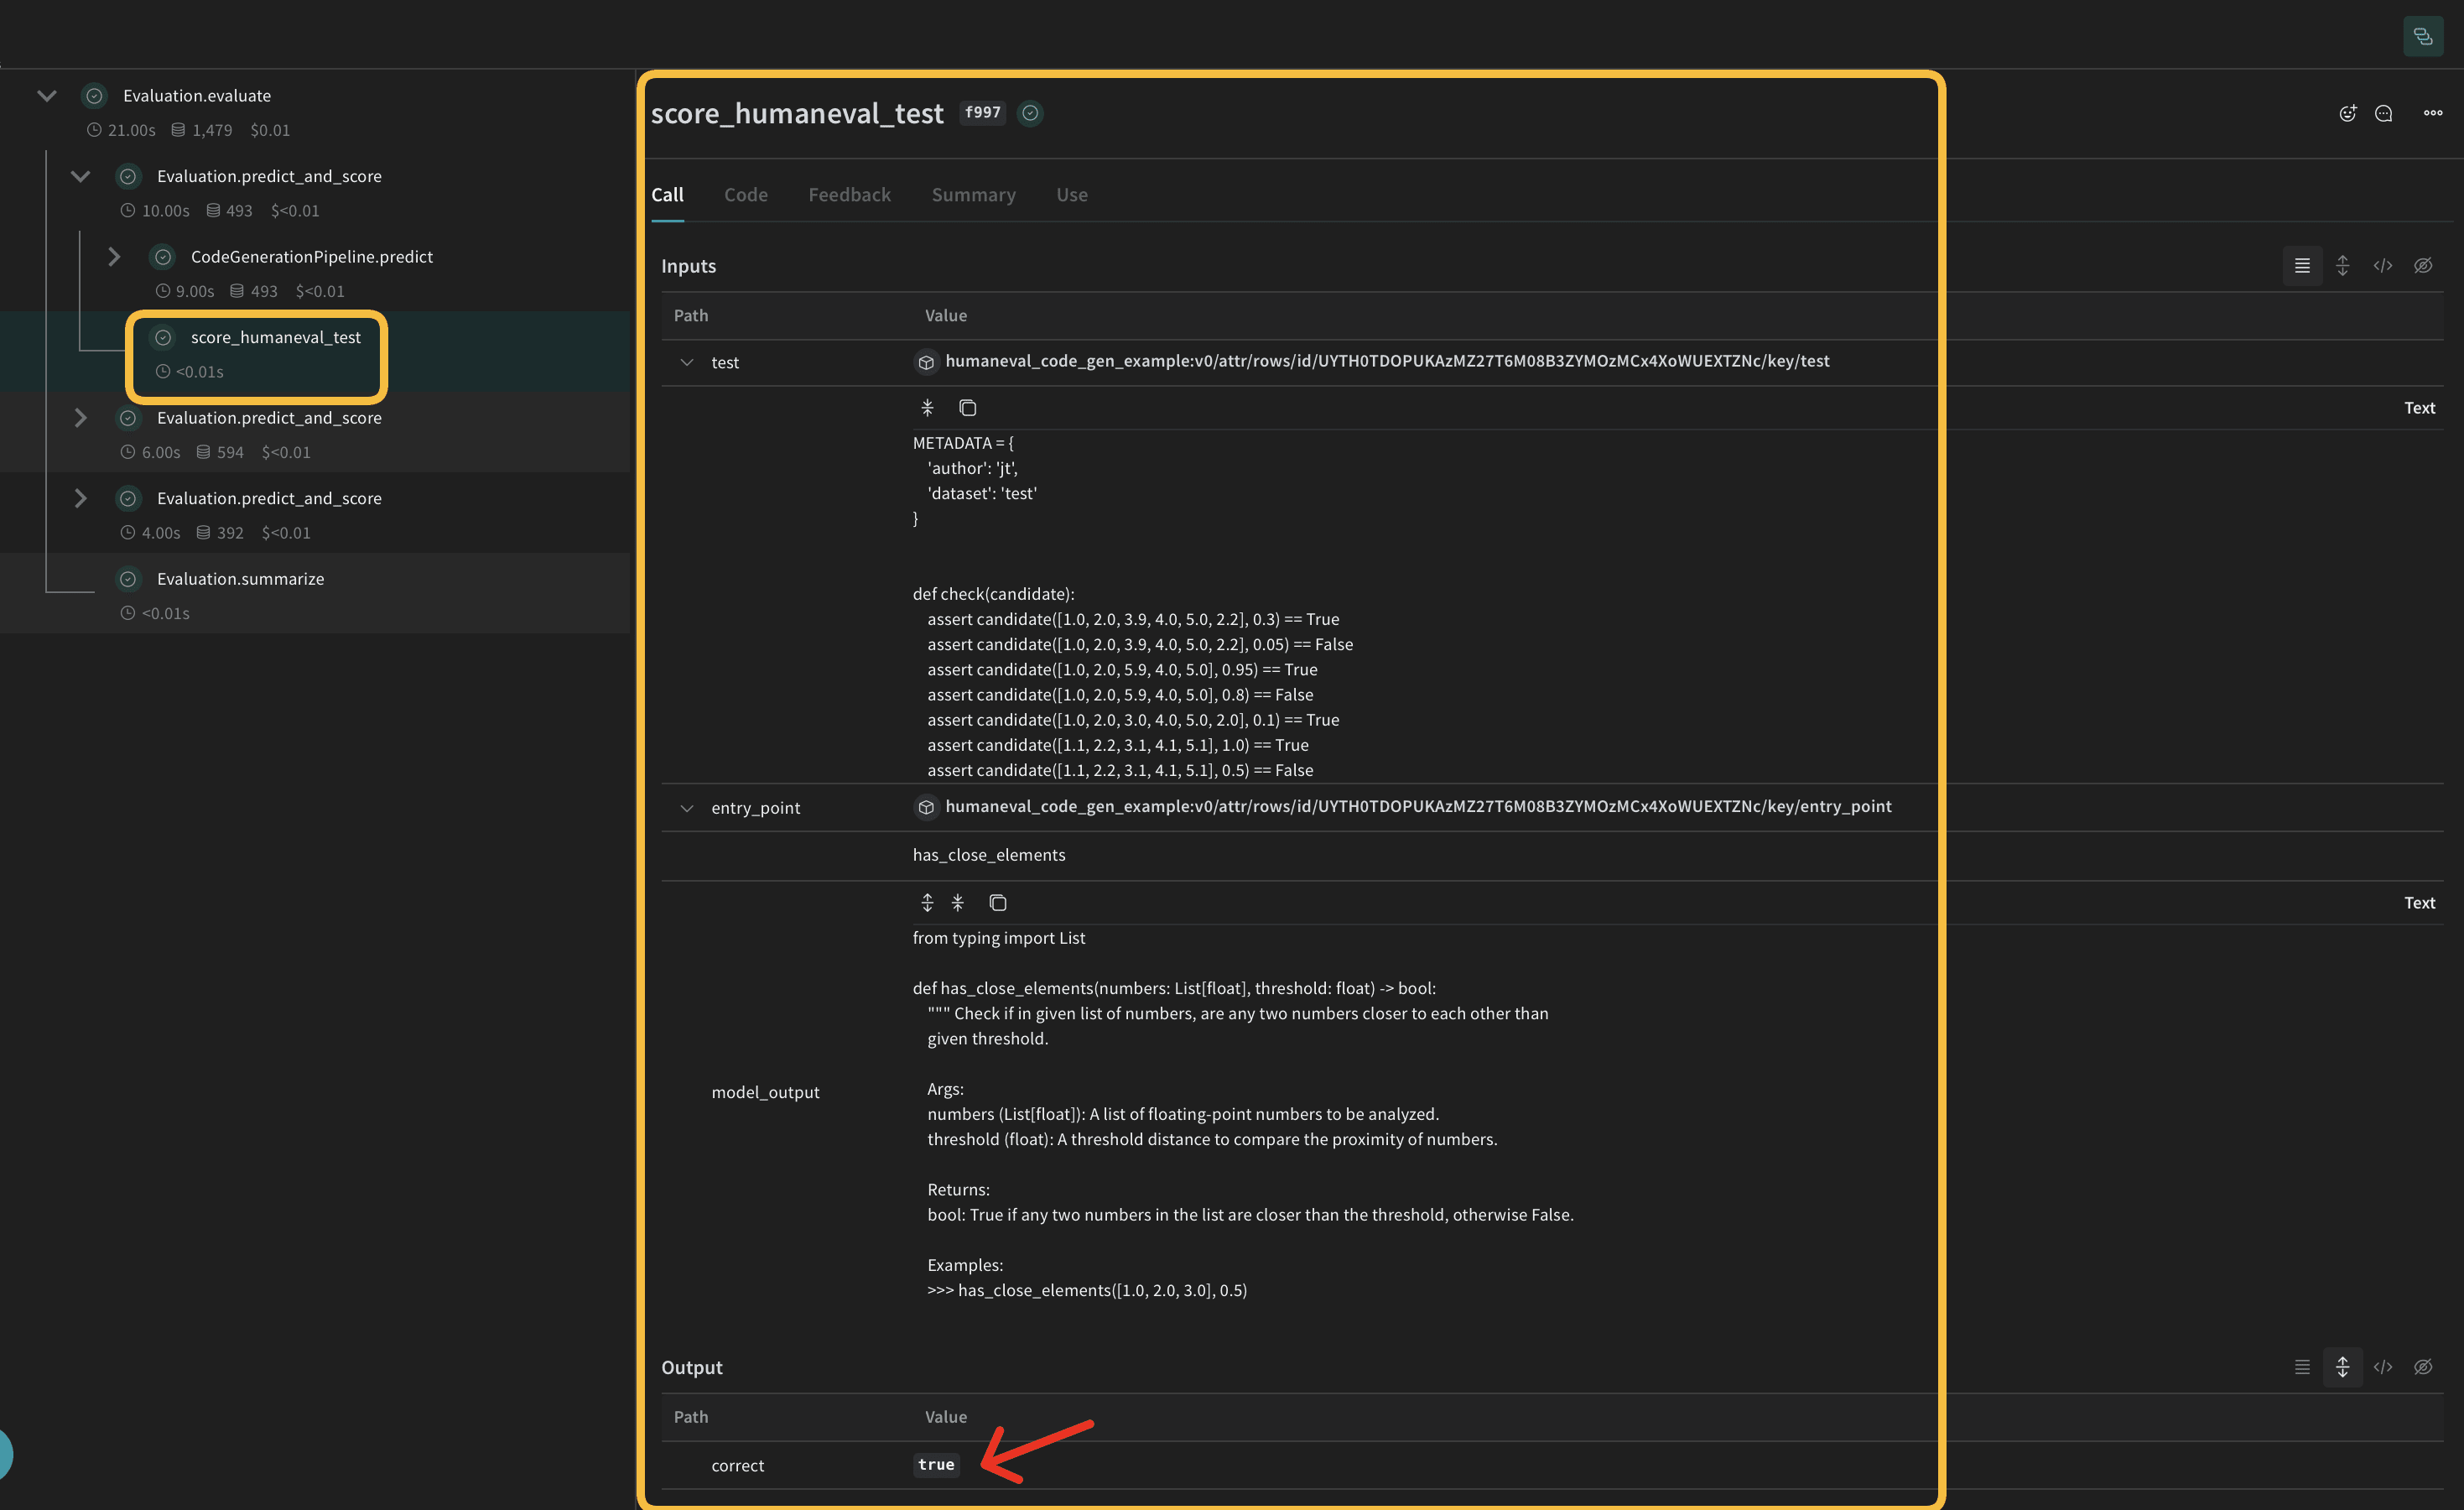
이 평가 함수들은 생성된 코드를 실행한 뒤, 코드가 데이터셋에서 제공한 테스트를 통과했는지를 나타내는 불리언 값을 반환합니다.
Weave 데이터셋 생성 및 평가 실행
파이프라인과 Scorer를 정의했으니, 마지막 단계로 평가 데이터셋을 구성하고 전체 과정을 엔드 투 엔드로 실행합니다. 파이프라인을 평가하려면 다음과 같이 Weave 데이터셋을 생성하고 평가를 실행하세요.
```python lines theme={"system"}
formatted_selected_examples = [
{
"task_id": task_id,
"prompt": prompt,
"canonical_solution": solution,
"test": test,
"entry_point": entry_point,
}
for task_id, prompt, solution, test, entry_point in zip(
selected_examples["task_id"],
selected_examples["prompt"],
selected_examples["canonical_solution"],
selected_examples["test"],
selected_examples["entry_point"],
)
]
python
prompt_dataset = Dataset(
name="humaneval_code_gen_example",
rows=[
{
"prompt": example["prompt"],
"test": example["test"],
"entry_point": example["entry_point"],
}
for example in formatted_selected_examples
],
)
weave.publish(prompt_dataset)
python
EVAL_RUN = True
python
for model_name in ["gpt-4o-2024-08-06"]:
pipeline = CodeGenerationPipeline(model_name=model_name)
if not EVAL_RUN:
dataset = prompt_dataset.rows[2]
result = await pipeline.predict(dataset["prompt"])
score_result = await score_humaneval_test(
dataset["test"], dataset["entry_point"], result["generated_code"].full_code
)
else:
evaluation = Evaluation(
name="minimal_code_gen_evaluation",
dataset=prompt_dataset,
scorers=[score_humaneval_test],
)
results = await evaluation.evaluate(pipeline)
```
이 코드는 샘플 프롬프트로 데이터셋을 생성하고, HumanEval 테스트 Scorer를 정의한 다음, 코드 생성 파이프라인을 평가합니다. 평가가 완료되면 Weights & Biases UI에서 결과를 확인하고 여러 run의 결과를 비교할 수 있습니다.
결론
이 예제에서는 Weave와 OpenAI의 언어 모델을 사용하여 코드 생성 파이프라인을 구현하는 방법을 살펴보았습니다. 이 예제를 통해 다음 방법을 배웠습니다.
* 코드 생성 프로세스의 각 단계에 대한 Weave 오퍼레이션을 생성합니다.
* 파이프라인을 Weave Model로 래핑하여 추적과 평가를 간소화합니다.
* Weave 오퍼레이션을 사용하여 맞춤형 평가 메트릭을 구현합니다.
* 데이터셋을 생성하고 파이프라인 평가를 실행합니다.
Weave는 코드 생성 프로세스 전반에 걸쳐 입력, 출력, 중간 단계를 추적하므로 LLM 애플리케이션을 더 쉽게 디버그하고 최적화하고 평가할 수 있습니다.
Weave와 Weave의 기능에 대한 자세한 내용은 [Weave 문서](/ko/products/wandb/weave)를 참조하세요. 이 예제를 확장하여 더 큰 데이터셋을 처리하거나, 더 정교한 평가 메트릭을 구현하거나, 다른 LLM 워크플로와 통합할 수도 있습니다.