> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
> CSV 파일을 W&B에 Tables 및 Artifacts로 임포트하여 대시보드에서 시각화, 비교, 분석하세요.
# 실험과 함께 CSV 파일 추적하기
W\&B Python 라이브러리로 CSV 파일을 로깅하고 [W\&B 대시보드](/ko/products/wandb/track/workspaces)에서 시각화하세요. W\&B 대시보드에서는 머신러닝 모델의 결과를 한곳에서 정리하고 시각화할 수 있습니다. 이 방법은 W\&B에 로깅하지 않은 [이전 머신러닝 실험 정보가 담긴 CSV 파일](#import-and-log-your-csv-of-experiments)이나 [데이터셋이 담긴 CSV 파일](#import-and-log-your-dataset-csv-file)이 있을 때 특히 유용합니다.
데이터셋 CSV 파일 임포트 및 로깅
CSV 파일의 내용을 더 쉽게 재사용하려면 W\&B Artifacts를 사용하는 것이 좋습니다.
1. 먼저 CSV 파일을 임포트하세요. 다음 코드 스니펫에서 `iris.csv` 파일 이름을 사용할 CSV 파일 이름으로 바꾸세요.
```python theme={"system"}
import wandb
import pandas as pd
# CSV 파일을 읽어 새 데이터프레임에 저장
new_iris_dataframe = pd.read_csv("iris.csv")
```
2. [W\&B 대시보드](/ko/products/wandb/track/workspaces)를 활용하려면 CSV 파일을 W\&B Table로 변환하세요.
```python theme={"system"}
# 데이터프레임을 W&B Table로 변환
iris_table = wandb.Table(dataframe=new_iris_dataframe)
```
3. 다음으로 W\&B 아티팩트를 생성하고 table을 아티팩트에 추가하세요.
```python theme={"system"}
# table을 아티팩트에 추가하면 행 제한이 200000으로
# 늘어나고 재사용하기도 쉬워집니다
iris_table_artifact = wandb.Artifact("iris_artifact", type="dataset")
iris_table_artifact.add(iris_table, "iris_table")
# 데이터를 보존하기 위해 원본 csv 파일을 아티팩트에 함께 로깅합니다
iris_table_artifact.add_file("iris.csv")
```
W\&B Artifacts에 대한 자세한 내용은 [Artifacts 챕터](/ko/products/wandb/artifacts)를 참조하세요.
4. 마지막으로 `wandb.init()`으로 새 W\&B run을 시작하여 W\&B에서 추적하고 로깅하세요.
```python theme={"system"}
# 데이터를 로깅할 W&B run 시작
with wandb.init(project="tables-walkthrough") as run:
# run에서 시각화할 수 있도록 table을 로깅하고...
run.log({"iris": iris_table})
# 아티팩트로도 로깅해 사용 가능한 행 수 제한을 늘립니다!
run.log_artifact(iris_table_artifact)
```
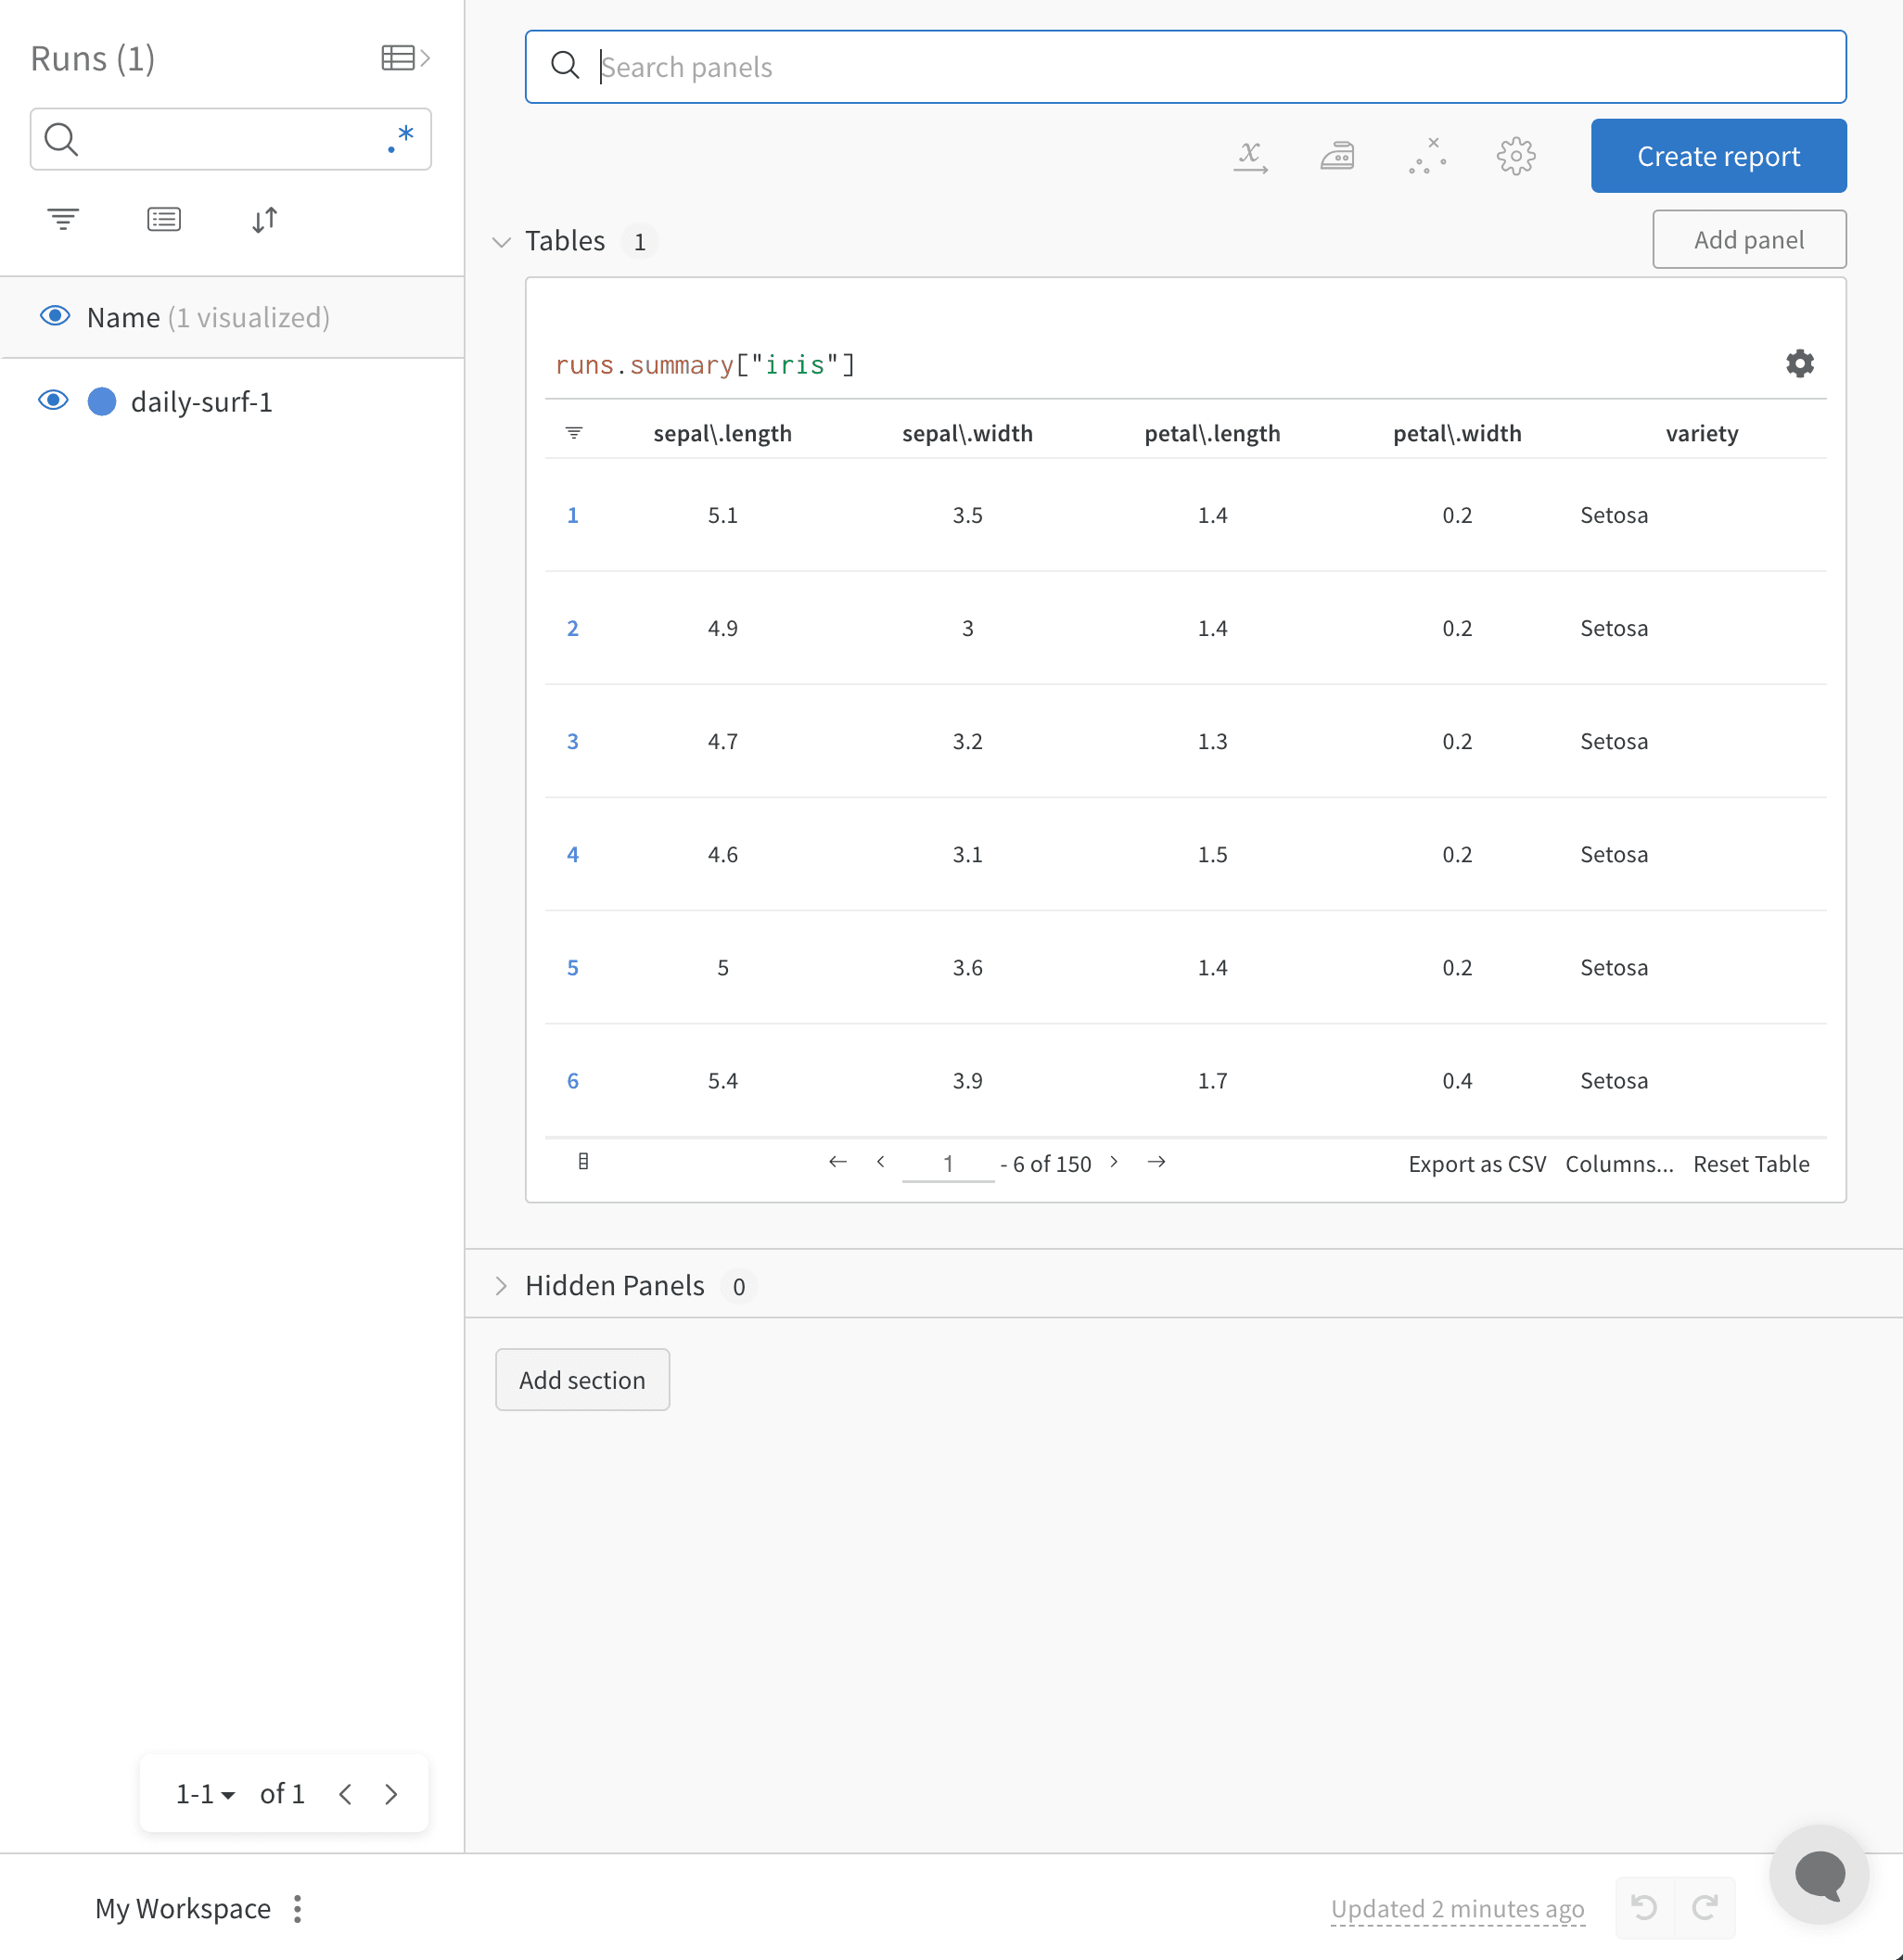
`wandb.init()` API는 run에 데이터를 로깅하는 새 백그라운드 프로세스를 생성하고, 기본적으로 데이터를 wandb.ai에 동기화합니다. W\&B Workspace 대시보드에서 실시간 시각화를 확인하세요. 다음 이미지는 코드 스니펫 예시를 실행한 출력을 보여줍니다.
 앞의 코드 스니펫을 모두 포함한 전체 스크립트는 다음과 같습니다.
```python theme={"system"}
import wandb
import pandas as pd
# CSV를 읽어 새 DataFrame으로 불러옵니다
new_iris_dataframe = pd.read_csv("iris.csv")
# DataFrame을 W&B Table로 변환합니다
iris_table = wandb.Table(dataframe=new_iris_dataframe)
# table을 아티팩트에 추가해 행 제한을 200000으로
# 늘리고 재사용하기 쉽게 만듭니다
iris_table_artifact = wandb.Artifact("iris_artifact", type="dataset")
iris_table_artifact.add(iris_table, "iris_table")
# 데이터를 보존할 수 있도록 원본 csv 파일도 아티팩트에 함께 로깅합니다
iris_table_artifact.add_file("iris.csv")
# 데이터를 로깅할 W&B run을 시작합니다
with wandb.init(project="tables-walkthrough") as run:
# table을 로깅해 run에서 시각화하고...
run.log({"iris": iris_table})
# 아티팩트로도 로깅해 사용 가능한 행 제한을 늘립니다!
run.log_artifact(iris_table_artifact)
```
Experiments CSV 파일 임포트 및 로깅하기
실험 세부 정보가 CSV 파일에 저장되어 있는 경우도 있습니다. 이러한 CSV 파일에는 일반적으로 다음과 같은 세부 정보가 포함됩니다.
* 실험 run의 이름
* 초기 [노트](/ko/products/wandb/runs#add-a-note-to-a-run)
* 실험을 구분하기 위한 [태그](/ko/products/wandb/runs/tags)
* 실험에 필요한 설정([Sweeps 하이퍼파라미터 튜닝](/ko/products/wandb/sweeps)도 함께 활용할 수 있습니다)
| 실험 | 모델 이름 | 노트 | 태그 | 레이어 수 | 최종 트레이닝 정확도 | 최종 검증 정확도 | 트레이닝 손실 |
| - | - | - | - | - | - | - | - |
| 실험 1 | mnist-300-layers | 트레이닝 데이터에 심하게 과적합됨 | \[latest] | 300 | 0.99 | 0.90 | \[0.55, 0.45, 0.44, 0.42, 0.40, 0.39] |
| 실험 2 | mnist-250-layers | 현재 최고 성능 모델 | \[prod, best] | 250 | 0.95 | 0.96 | \[0.55, 0.45, 0.44, 0.42, 0.40, 0.39] |
| 실험 3 | mnist-200-layers | 기준선 모델보다 성능이 낮음. 디버깅 필요 | \[debug] | 200 | 0.76 | 0.70 | \[0.55, 0.45, 0.44, 0.42, 0.40, 0.39] |
| ... | ... | ... | ... | ... | ... | ... | |
| 실험 N | mnist-X-layers | NOTES | ... | ... | ... | ... | \[..., ...] |
W\&B는 실험 CSV 파일을 W\&B Experiment Run으로 변환할 수 있습니다. 다음 코드 스니펫과 스크립트에서는 실험 CSV 파일을 임포트하고 로깅하는 방법을 보여줍니다.
1. 먼저 CSV 파일을 읽어 Pandas 데이터프레임으로 변환하세요. `"experiments.csv"`는 실제 CSV 파일 이름으로 바꾸세요.
```python theme={"system"}
import wandb
import pandas as pd
FILENAME = "experiments.csv"
loaded_experiment_df = pd.read_csv(FILENAME)
PROJECT_NAME = "Converted Experiments"
EXPERIMENT_NAME_COL = "Experiment"
NOTES_COL = "Notes"
TAGS_COL = "Tags"
CONFIG_COLS = ["Num Layers"]
SUMMARY_COLS = ["Final Train Acc", "Final Val Acc"]
METRIC_COLS = ["Training Losses"]
# 다루기 쉽도록 Pandas 데이터프레임을 정리합니다
for i, row in loaded_experiment_df.iterrows():
run_name = row[EXPERIMENT_NAME_COL]
notes = row[NOTES_COL]
tags = row[TAGS_COL]
config = {}
for config_col in CONFIG_COLS:
config[config_col] = row[config_col]
metrics = {}
for metric_col in METRIC_COLS:
metrics[metric_col] = row[metric_col]
summaries = {}
for summary_col in SUMMARY_COLS:
summaries[summary_col] = row[summary_col]
```
2. 다음으로, [`wandb.init()`](/ko/products/wandb/ref/python/functions/init)으로 새 W\&B run을 시작하여 W\&B에 추적하고 로깅하세요:
```python theme={"system"}
with wandb.init(
project=PROJECT_NAME, name=run_name, tags=tags, notes=notes, config=config
) as run:
```
실험이 진행되는 동안 메트릭의 모든 인스턴스를 로깅해 두면 W\&B에서 확인하고, 쿼리하고, 분석할 수 있습니다. 이렇게 하려면 [`run.log()`](/ko/products/wandb/ref/python/experiments/run#method-runlog) 명령을 사용하세요:
```python theme={"system"}
run.log({key: val})
```
필요하면 [`define_metric`](/ko/products/wandb/ref/python/experiments/run#define_metric) API를 사용해 최종 summary 메트릭을 로깅하여 run의 결과를 정의할 수 있습니다. 이 예제에서는 `run.summary.update()`를 사용해 run에 summary 메트릭을 추가합니다.
```python theme={"system"}
run.summary.update(summaries)
```
summary 메트릭에 대한 자세한 내용은 [summary 메트릭 로깅하기](/ko/products/wandb/track/log/log-summary)를 참조하세요.
다음은 위의 샘플 table을 [W\&B 대시보드](/ko/products/wandb/track/workspaces)로 변환하는 전체 예시 스크립트입니다.
```python theme={"system"}
FILENAME = "experiments.csv"
loaded_experiment_df = pd.read_csv(FILENAME)
PROJECT_NAME = "Converted Experiments"
EXPERIMENT_NAME_COL = "Experiment"
NOTES_COL = "Notes"
TAGS_COL = "Tags"
CONFIG_COLS = ["Num Layers"]
SUMMARY_COLS = ["Final Train Acc", "Final Val Acc"]
METRIC_COLS = ["Training Losses"]
for i, row in loaded_experiment_df.iterrows():
run_name = row[EXPERIMENT_NAME_COL]
notes = row[NOTES_COL]
tags = row[TAGS_COL]
config = {}
for config_col in CONFIG_COLS:
config[config_col] = row[config_col]
metrics = {}
for metric_col in METRIC_COLS:
metrics[metric_col] = row[metric_col]
summaries = {}
for summary_col in SUMMARY_COLS:
summaries[summary_col] = row[summary_col]
with wandb.init(
project=PROJECT_NAME, name=run_name, tags=tags, notes=notes, config=config
) as run:
for key, val in metrics.items():
if isinstance(val, list):
for _val in val:
run.log({key: _val})
else:
run.log({key: val})
run.summary.update(summaries)
```