> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
> W&B를 사용하여 여러 GPU로 수행하는 분산 트레이닝 실험을 로깅하세요.
# 분산 트레이닝 실험 로깅하기
분산 트레이닝 실험에서는 여러 머신 또는 클라이언트를 병렬로 사용하여 모델을 트레이닝합니다. W\&B를 사용하면 분산 트레이닝 실험을 추적할 수 있습니다. 사용 사례에 따라 다음 방법 중 하나로 분산 트레이닝 실험을 추적하세요.
* **단일 프로세스 추적**: W\&B로 rank 0 프로세스("리더" 또는 "코디네이터"라고도 함)를 추적합니다. [PyTorch Distributed Data Parallel](https://pytorch.org/docs/stable/generated/torch.nn.parallel.DistributedDataParallel.html#torch.nn.parallel.DistributedDataParallel)(DDP) 클래스로 분산 트레이닝 실험을 로깅할 때 흔히 사용하는 방법입니다.
* **여러 프로세스 추적**: 여러 프로세스를 추적할 때는 다음 중 한 가지 방법을 선택할 수 있습니다.
* 프로세스당 하나의 run을 사용하여 각 프로세스를 개별적으로 추적합니다. 필요하면 W\&B App UI에서 이 run을 그룹으로 묶을 수 있습니다.
* 모든 프로세스를 하나의 run으로 추적합니다.
**동시 연결**
동시 연결은 각각 컴퓨팅, 메모리, 네트워크 리소스를 사용합니다. 메트릭을 로깅하지 않는 빈 클라이언트 연결도 시스템 메트릭 업데이트를 주기적으로 푸시하므로 차트 로드 성능이 저하될 수 있습니다.
W\&B는 워크로드에 맞게 최대 동시 클라이언트 연결 수를 제한하고 시간 경과에 따른 리소스 사용량을 모니터링할 것을 권장합니다. W\&B는 **Dedicated Cloud**에서 동시 클라이언트 연결 수를 최대 300개로 엄격히 제한한 상태로 테스트했습니다.
**Multi-tenant Cloud** 조직에서는 분산 트레이닝용 클라이언트 연결에도 일반 트레이닝 run과 동일한 [요청 속도 제한](/ko/products/wandb/track/limits#rate-limits)이 적용됩니다. [Teams 및 Enterprise 플랜](https://coreweave.com/forge-pricing) 사용자에게는 Free 플랜 사용자보다 더 높은 요청 속도 제한이 적용됩니다.
단일 프로세스 추적
이 섹션에서는 rank 0 프로세스에서 사용할 수 있는 값과 메트릭을 추적하는 방법을 설명합니다. 이 방식은 단일 프로세스에서 얻을 수 있는 메트릭만 추적할 때 사용하세요. 대표적인 메트릭으로는 GPU/CPU 사용량, 공유 검증 세트에서의 동작, 그라디언트와 매개변수, 대표 데이터 예시에 대한 손실 값 등이 있습니다.
rank 0 프로세스 내에서 [`wandb.init()`](/ko/products/wandb/ref/python/functions/init)으로 W\&B run을 초기화하고, 해당 run에 실험을 로깅하세요([`wandb.Run.log()`](/ko/products/wandb/ref/python/experiments/run#method-runlog)).
다음 [샘플 Python 스크립트(`log-ddp.py`)](https://github.com/wandb/examples/blob/master/examples/pytorch/pytorch-ddp/log-ddp.py)는 PyTorch DDP를 사용하여 단일 머신의 GPU 두 개에서 메트릭을 추적하는 한 가지 방법을 보여줍니다. [PyTorch DDP](https://pytorch.org/tutorials/intermediate/ddp_tutorial.html)(`torch.nn`의 `DistributedDataParallel`)는 분산 트레이닝에 널리 사용되는 라이브러리입니다. 기본 원칙은 어떤 분산 트레이닝 환경에도 적용되지만, 구현 방식은 다를 수 있습니다.
이 Python 스크립트는 다음을 수행합니다.
1. `torch.distributed.launch`로 여러 프로세스를 시작합니다.
2. `--local_rank` 명령줄 인수로 rank를 확인합니다.
3. rank가 0이면 [`train()`](https://github.com/wandb/examples/blob/master/examples/pytorch/pytorch-ddp/log-ddp.py#L24) 함수에서 조건부로 `wandb` 로깅을 설정합니다.
```python theme={"system"}
if __name__ == "__main__":
# 인수 가져오기
args = parse_args()
if args.local_rank == 0: # 메인 프로세스에서만 실행
# wandb run 초기화
run = wandb.init(
entity=args.entity,
project=args.project,
)
# DDP로 모델 학습
train(args, run)
else:
train(args)
```
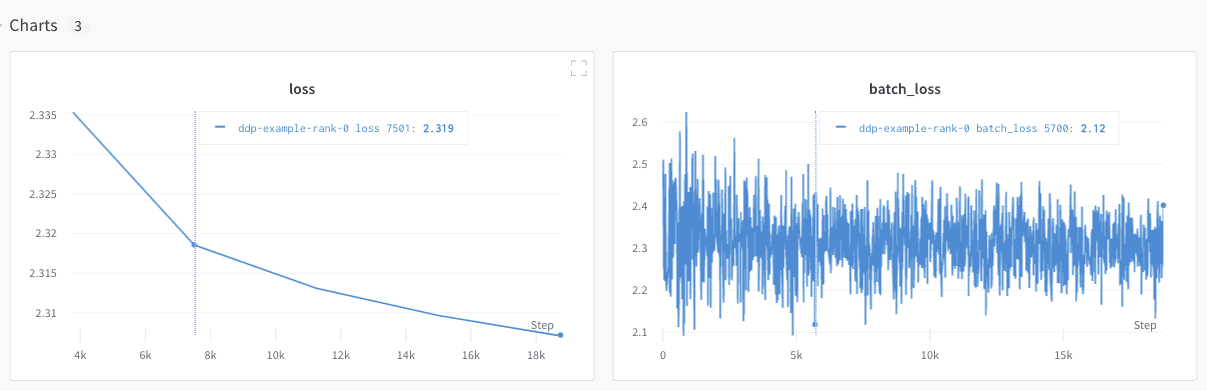
[단일 프로세스에서 추적한 메트릭을 보여 주는 예시 대시보드](https://forge.coreweave.com/wandb/ayush-thakur/DDP/runs/1s56u3hc/system)를 살펴보세요.
이 대시보드에는 두 GPU의 온도, 사용량 등 시스템 메트릭이 표시됩니다.
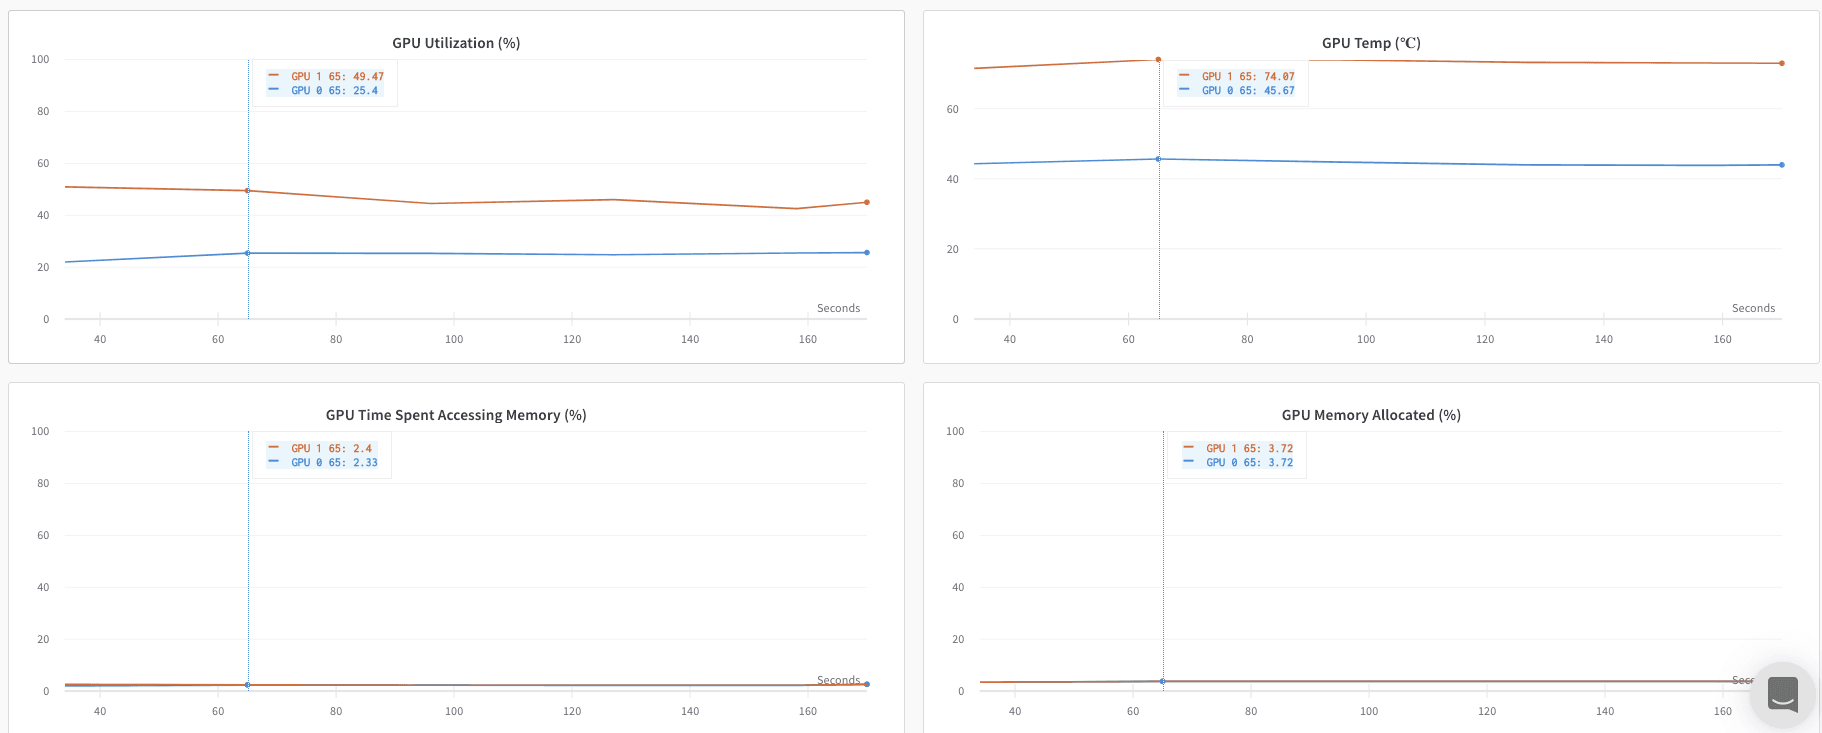 하지만 에포크와 배치 크기에 따른 손실 값은 하나의 GPU에서만 로깅되었습니다.
여러 프로세스 추적하기
W\&B에서 여러 프로세스를 추적하려면 다음 방법 중 하나를 사용하세요.
* 프로세스마다 run을 생성하여 [각 프로세스를 개별적으로 추적](/ko/products/wandb/track/log/distributed-training#track-each-process-separately)합니다.
* [모든 프로세스를 단일 run으로 추적](/ko/products/wandb/track/log/distributed-training#track-all-processes-to-a-single-run)합니다.
각 프로세스를 개별적으로 추적하기
이 섹션에서는 프로세스마다 run을 생성하여 각 프로세스를 개별적으로 추적하는 방법을 설명합니다. 각 run에서는 메트릭, 아티팩트 등을 해당 run에 로깅합니다. 트레이닝이 끝나면 `wandb.Run.finish()`를 호출하여 run이 완료되었음을 표시하고 모든 프로세스가 정상적으로 종료되도록 하세요.
여러 실험에 걸쳐 run을 추적하기가 어려울 수 있습니다. 이 문제를 줄이려면 W\&B를 초기화할 때 `group` 매개변수에 값을 지정하여(`wandb.init(group='group-name')`) 각 run이 어떤 실험에 속하는지 추적하세요. 실험에서 트레이닝 및 평가 W\&B run을 추적하는 방법에 대한 자세한 내용은 [Group Runs](/ko/products/wandb/runs/grouping)를 참조하세요.
**개별 프로세스의 메트릭을 추적하려면 이 방법을 사용하세요**. 대표적인 예로는 각 노드의 데이터와 예측(데이터 분포 디버깅용), 메인 노드 이외의 개별 배치에 대한 메트릭이 있습니다. 모든 노드의 시스템 메트릭을 조회하거나 메인 노드에서 사용 가능한 요약 통계를 조회할 때는 이 방법을 사용하지 않아도 됩니다.
다음 Python 코드 스니펫은 W\&B를 초기화할 때 group 매개변수를 설정하는 방법을 보여줍니다.
```python theme={"system"}
if __name__ == "__main__":
# 인수 가져오기
args = parse_args()
# run 초기화
run = wandb.init(
entity=args.entity,
project=args.project,
group="DDP", # 실험의 모든 run을 하나의 그룹으로 묶음
)
# DDP로 모델 학습
train(args, run)
run.finish() # run을 완료 상태로 표시
```
W\&B App UI에서 여러 프로세스의 메트릭을 추적한 [예시 대시보드](https://wandb.ai/ayush-thakur/DDP?workspace=user-noahluna)를 살펴보세요. 왼쪽 사이드바에서 두 개의 W\&B run이 하나로 그룹화되어 있는 것을 확인할 수 있습니다. 그룹을 클릭하면 해당 실험의 전용 그룹 페이지로 이동합니다. 전용 그룹 페이지에서는 각 프로세스의 메트릭을 개별적으로 보여줍니다.
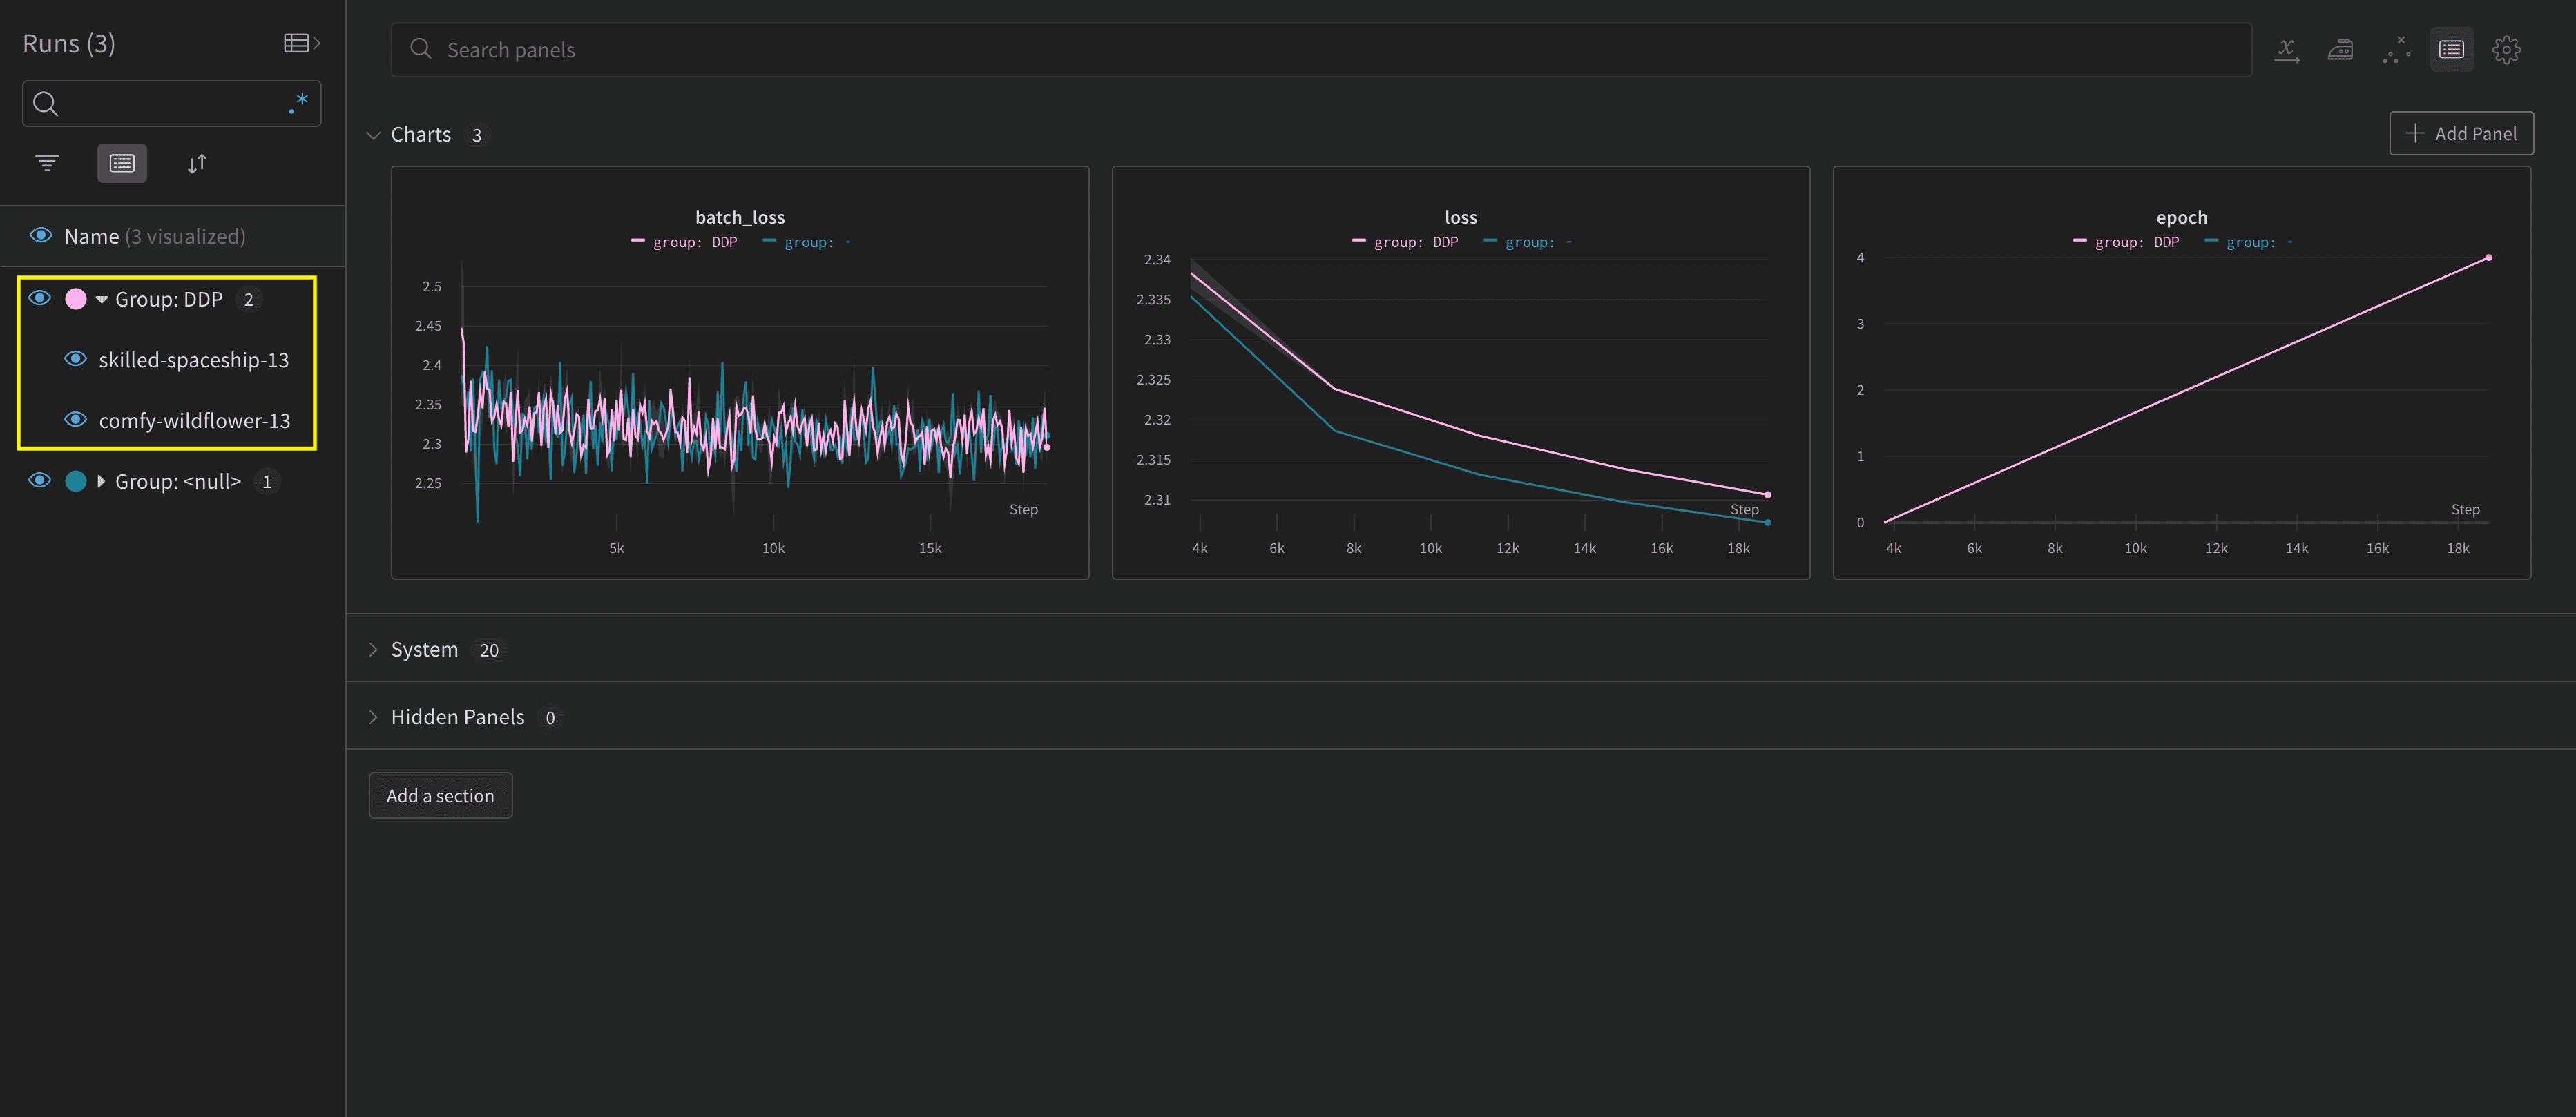 위 이미지는 W\&B App UI 대시보드입니다. 사이드바에 두 개의 실험이 있습니다. 하나는 'null'이라는 레이블이 붙어 있고, 다른 하나(노란색 박스로 표시)는 'DPP'라는 이름입니다. 그룹을 펼치면(Group 드롭다운 선택) 해당 실험에 연결된 W\&B run을 확인할 수 있습니다.
분산 run 구성하기
W\&B를 초기화할 때(`wandb.init(job_type='type-name')`) `job_type` 매개변수를 설정하면 노드를 역할별로 분류할 수 있습니다. 예를 들어 전체 작업을 조율하는 메인 노드 하나와 결과를 보고하는 워커 노드 여러 개로 구성할 수 있습니다. 이 경우 메인 조율 노드의 `job_type`은 `main`으로, 보고용 워커 노드의 `job_type`은 `worker`로 설정하면 됩니다.
```python theme={"system"}
# 메인 코디네이터 노드
with wandb.init(project="", job_type="main", group="experiment_1") as run:
# 트레이닝 코드
# 결과를 보고하는 워커 노드
with wandb.init(project="", job_type="worker", group="experiment_1") as run:
# 트레이닝 코드
```
노드의 `job_type`을 설정한 후에는 워크스페이스에서 [저장된 뷰](/ko/products/wandb/track/workspaces#create-a-new-saved-workspace-view)를 만들어 run을 정리할 수 있습니다. 오른쪽 상단의 **액션 ()** 메뉴를 클릭한 다음 **Save as new view**를 클릭하세요.
예를 들어 다음과 같은 저장된 뷰를 만들 수 있습니다.
* **Default view**: 워커 노드를 필터링으로 제외하여 불필요한 정보를 줄입니다
* **Filter**를 클릭한 다음 **Job Type**을 `worker`로 설정하세요.
* 리포팅 노드만 표시됩니다
* **Debug view**: 문제 해결을 위해 워커 노드만 집중적으로 살펴봅니다
* **Filter**를 클릭한 다음 **Job Type**을 `==` `worker`로 설정하고 **State**를 `IN` `crashed`로 설정하세요.
* 크래시가 발생했거나 오류 상태인 워커 노드만 표시됩니다
* **All nodes view**: 모든 노드를 한눈에 확인합니다
* 필터 없음
* 전체 모니터링에 유용합니다
저장된 뷰를 열려면 프로젝트 사이드바에서 **Workspaces**를 클릭한 다음 메뉴를 클릭하세요. 목록 상단에는 워크스페이스가, 하단에는 저장된 뷰가 표시됩니다.
모든 프로세스를 단일 run으로 추적하기
`x_`로 시작하는 매개변수(예: `x_label`)는 공개 프리뷰 상태입니다. 피드백은 [W\&B 저장소에 GitHub 이슈](https://github.com/wandb/wandb)를 생성하여 제출하세요.
**요구 사항**
여러 프로세스를 단일 run으로 추적하려면 다음이 필요합니다.
* W\&B Python SDK 버전 `v0.19.9` 이상
* W\&B Server v0.68 이상
이 방식에서는 기본 노드 하나와 하나 이상의 워커 노드를 사용합니다. 분산 작업을 시작하기 전에 고유한 run ID를 생성하고, 모든 프로세스가 해당 run ID를 사용하도록 설정하세요. 트레이닝 중에는 각 워커 노드가 기본 노드와 동일한 run ID로 로깅합니다. W\&B는 모든 노드의 메트릭을 집계하여 W\&B App UI에 표시합니다.
기본 노드에서 [`wandb.init()`](/ko/products/wandb/ref/python/functions/init)으로 W\&B run을 초기화하세요. 이때 `settings` 매개변수에 다음 항목을 포함한 `wandb.Settings` 객체를 전달합니다(`wandb.init(settings=wandb.Settings()`).
1. 공유 모드를 활성화하려면 `mode` 매개변수를 `"shared"`로 설정합니다.
2. [`x_label`](https://github.com/wandb/wandb/blob/main/wandb/sdk/wandb_settings.py#L638)에 고유한 레이블을 지정합니다. `x_label`에 지정한 값을 사용하면 W\&B App UI의 로그와 시스템 메트릭에서 데이터가 어느 노드에서 왔는지 파악할 수 있습니다. 지정하지 않으면 W\&B가 호스트 이름과 임의의 해시를 사용하여 레이블을 생성합니다.
3. 이 노드가 기본 노드임을 나타내려면 [`x_primary`](https://github.com/wandb/wandb/blob/main/wandb/sdk/wandb_settings.py#L660) 매개변수를 `True`로 설정합니다.
4. 필요한 경우 `x_stats_gpu_device_ids`에 GPU 인덱스 목록(\[0,1,2])을 전달하여 W\&B가 메트릭을 추적할 GPU를 지정할 수 있습니다. 목록을 전달하지 않으면 W\&B는 머신의 모든 GPU에 대한 메트릭을 추적합니다.
각 프로세스가 시작되기 전에 `WANDB_RUN_ID` 환경 변수를 생성한 run ID로 설정하세요. 프로세스가 `wandb.init()`을 호출하면 W\&B가 `WANDB_RUN_ID`를 자동으로 읽습니다.
`x_primary=True`는 기본 노드와 워커 노드를 구분합니다. 설정 파일, telemetry 등 노드 간에 공유되는 파일은 기본 노드만 업로드하며, 워커 노드는 이러한 파일을 업로드하지 않습니다.
각 워커 노드에서 [`wandb.init()`](/ko/products/wandb/ref/python/functions/init)으로 W\&B run을 초기화하고 다음을 지정하세요.
1. `settings` 매개변수에 다음 항목을 포함한 `wandb.Settings` 객체(`wandb.init(settings=wandb.Settings()`)를 전달합니다.
* 공유 모드를 활성화하려면 `mode` 매개변수를 `"shared"`로 설정합니다.
* `x_label`에 고유한 레이블을 지정합니다. `x_label`에 지정한 값을 사용하면 W\&B App UI의 로그와 시스템 메트릭에서 데이터가 어느 노드에서 왔는지 파악할 수 있습니다. 지정하지 않으면 W\&B가 호스트 이름과 임의의 해시를 사용하여 레이블을 생성합니다.
* 이 노드가 워커 노드임을 나타내려면 `x_primary` 매개변수를 `False`로 설정합니다.
2. 워커 프로세스가 시작되기 전에 `WANDB_RUN_ID`를 기본 노드와 동일한 run ID로 설정합니다.
3. 필요한 경우 [`x_update_finish_state`](https://github.com/wandb/wandb/blob/main/wandb/sdk/wandb_settings.py#L772)를 `False`로 설정합니다. 이렇게 하면 기본 노드가 아닌 노드가 [run 상태](/ko/products/wandb/runs/run-states#run-states)를 너무 일찍 `finished`로 업데이트하는 것을 막을 수 있어, run 상태가 일관되게 유지되고 기본 노드에서 관리됩니다.
* 모든 노드에서 동일한 entity와 프로젝트를 사용하세요. 그래야 올바른 run ID를 찾을 수 있습니다.
* 분산 작업을 시작하기 전에 run ID를 생성하세요. 런처, 스케줄러 또는 오케스트레이션 프레임워크를 사용하여 각 프로세스에 `WANDB_RUN_ID`를 설정하세요.
* 각 프로세스가 시작되기 전에 W\&B 환경 변수를 설정하세요. 런타임에 `os.environ`을 변경하면 W\&B SDK가 변경 사항을 감지하지 못할 수 있으므로 피하세요.
run ID를 생성하고 배포하는 방법은 노드 오케스트레이션에 사용하는 프레임워크에 따라 다릅니다. 이 가이드에서는 범용 런처 예시를 다루지 않습니다. 다음 스니펫은 오케스트레이션 계층에서 `WANDB_RUN_ID`를 설정한 후 각 프로세스 내에서 W\&B를 설정하는 방법을 보여 줍니다.
다음 예시는 기본 노드에서 run을 초기화합니다.
```python theme={"system"}
import wandb
entity = "your-entity"
project = "your-project"
# 기본 노드에서 run을 초기화합니다
with wandb.init(
entity=entity,
project=project,
settings=wandb.Settings(
x_label="rank_0",
mode="shared",
x_primary=True,
x_stats_gpu_device_ids=[0, 1], # (선택) GPU 0과 1의 메트릭만 추적합니다
)
) as run:
# 여기에 기본 노드 로직을 작성하세요
```
다음 예시는 워커 노드에 해당하는 설정을 보여 줍니다. 사용 중인 오케스트레이션 프레임워크에 맞게 rank를 각 워커의 고유 식별자로 설정하세요.
```python theme={"system"}
import wandb
entity = "your-entity"
project = "your-project"
rank = 1
# 워커 노드에서 run을 초기화합니다.
# W&B는 워커 프로세스 환경에서 WANDB_RUN_ID를 자동으로 읽어 옵니다.
with wandb.init(
entity=entity, # 프라이머리 노드와 동일한 entity를 사용하세요
project=project, # 프라이머리 노드와 동일한 프로젝트를 사용하세요
settings=wandb.Settings(
x_label=f"rank_{rank}",
mode="shared",
x_primary=False,
x_update_finish_state=False,
),
) as run:
# 여기에 워커 노드 로직을 작성하세요
```
분산 배포에서는 워커 노드가 서로 다른 머신에서 실행될 수 있습니다.
GKE의 멀티 노드 및 멀티 GPU Kubernetes 클러스터에서 모델을 트레이닝하는 전체 예시는 [Distributed Training with Shared Mode](https://forge.coreweave.com/wandb/dimaduev/simple-cnn-ddp/reports/Distributed-Training-with-Shared-Mode--VmlldzoxMTI0NTE1NA) 리포트를 참조하세요.
멀티 노드 프로세스의 콘솔 로그는 run이 로깅되는 프로젝트에서 확인할 수 있습니다.
1. run이 포함된 프로젝트로 이동하세요.
2. 프로젝트 사이드바에서 **Runs** 탭을 클릭하세요.
3. 확인하려는 run을 클릭하세요.
4. 프로젝트 사이드바에서 **Logs** 탭을 클릭하세요.
콘솔 로그 페이지 상단의 UI 검색 창에서 `x_label`에 지정한 레이블을 기준으로 콘솔 로그를 필터링할 수 있습니다. 예를 들어, 다음 이미지는 `x_label`에 `rank0`, `rank1`, `rank2`, `rank3`, `rank4`, `rank5`, `rank6` 값을 지정했을 때 콘솔 로그 필터링에 사용할 수 있는 옵션을 보여줍니다.\`
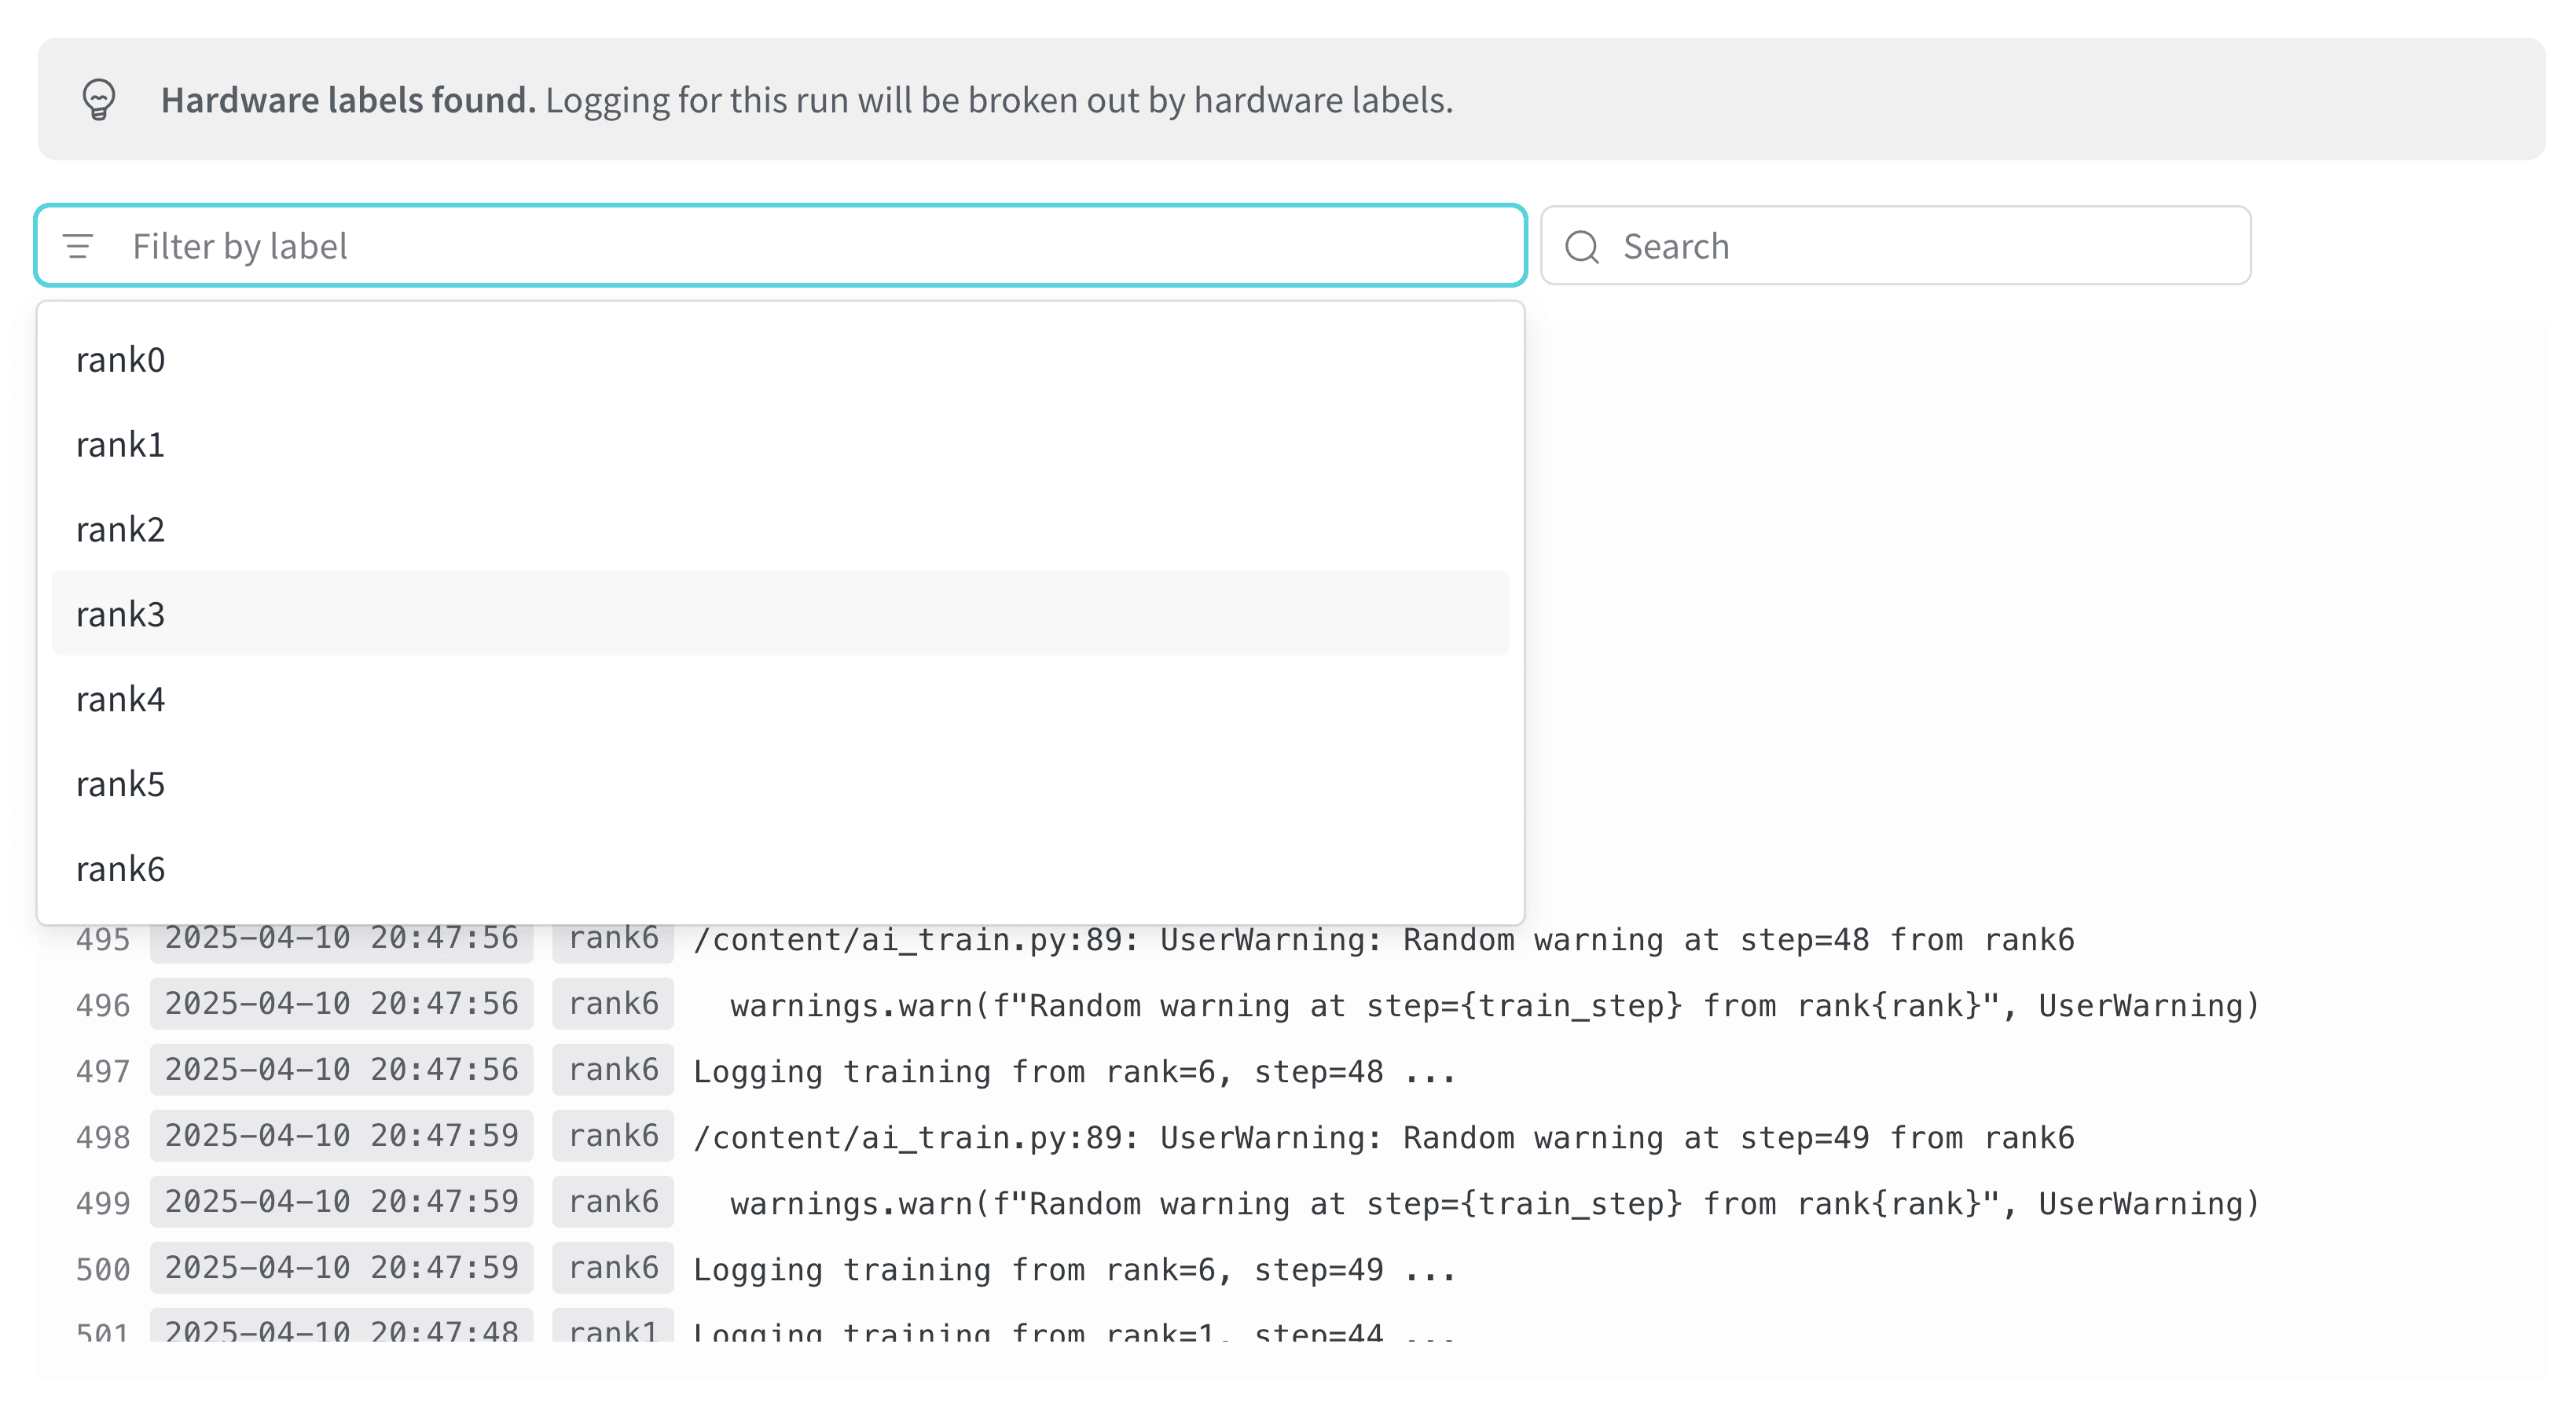 자세한 내용은 [콘솔 로그](/ko/products/wandb/app/console-logs)를 참조하세요.
W\&B는 모든 노드의 시스템 메트릭을 집계하여 W\&B App UI에 표시합니다. 예를 들어, 다음 이미지는 여러 노드의 시스템 메트릭을 보여주는 샘플 대시보드입니다. 각 노드에는 `x_label` 매개변수에 지정한 고유 레이블(`rank_0`, `rank_1`, `rank_2`)이 붙습니다.
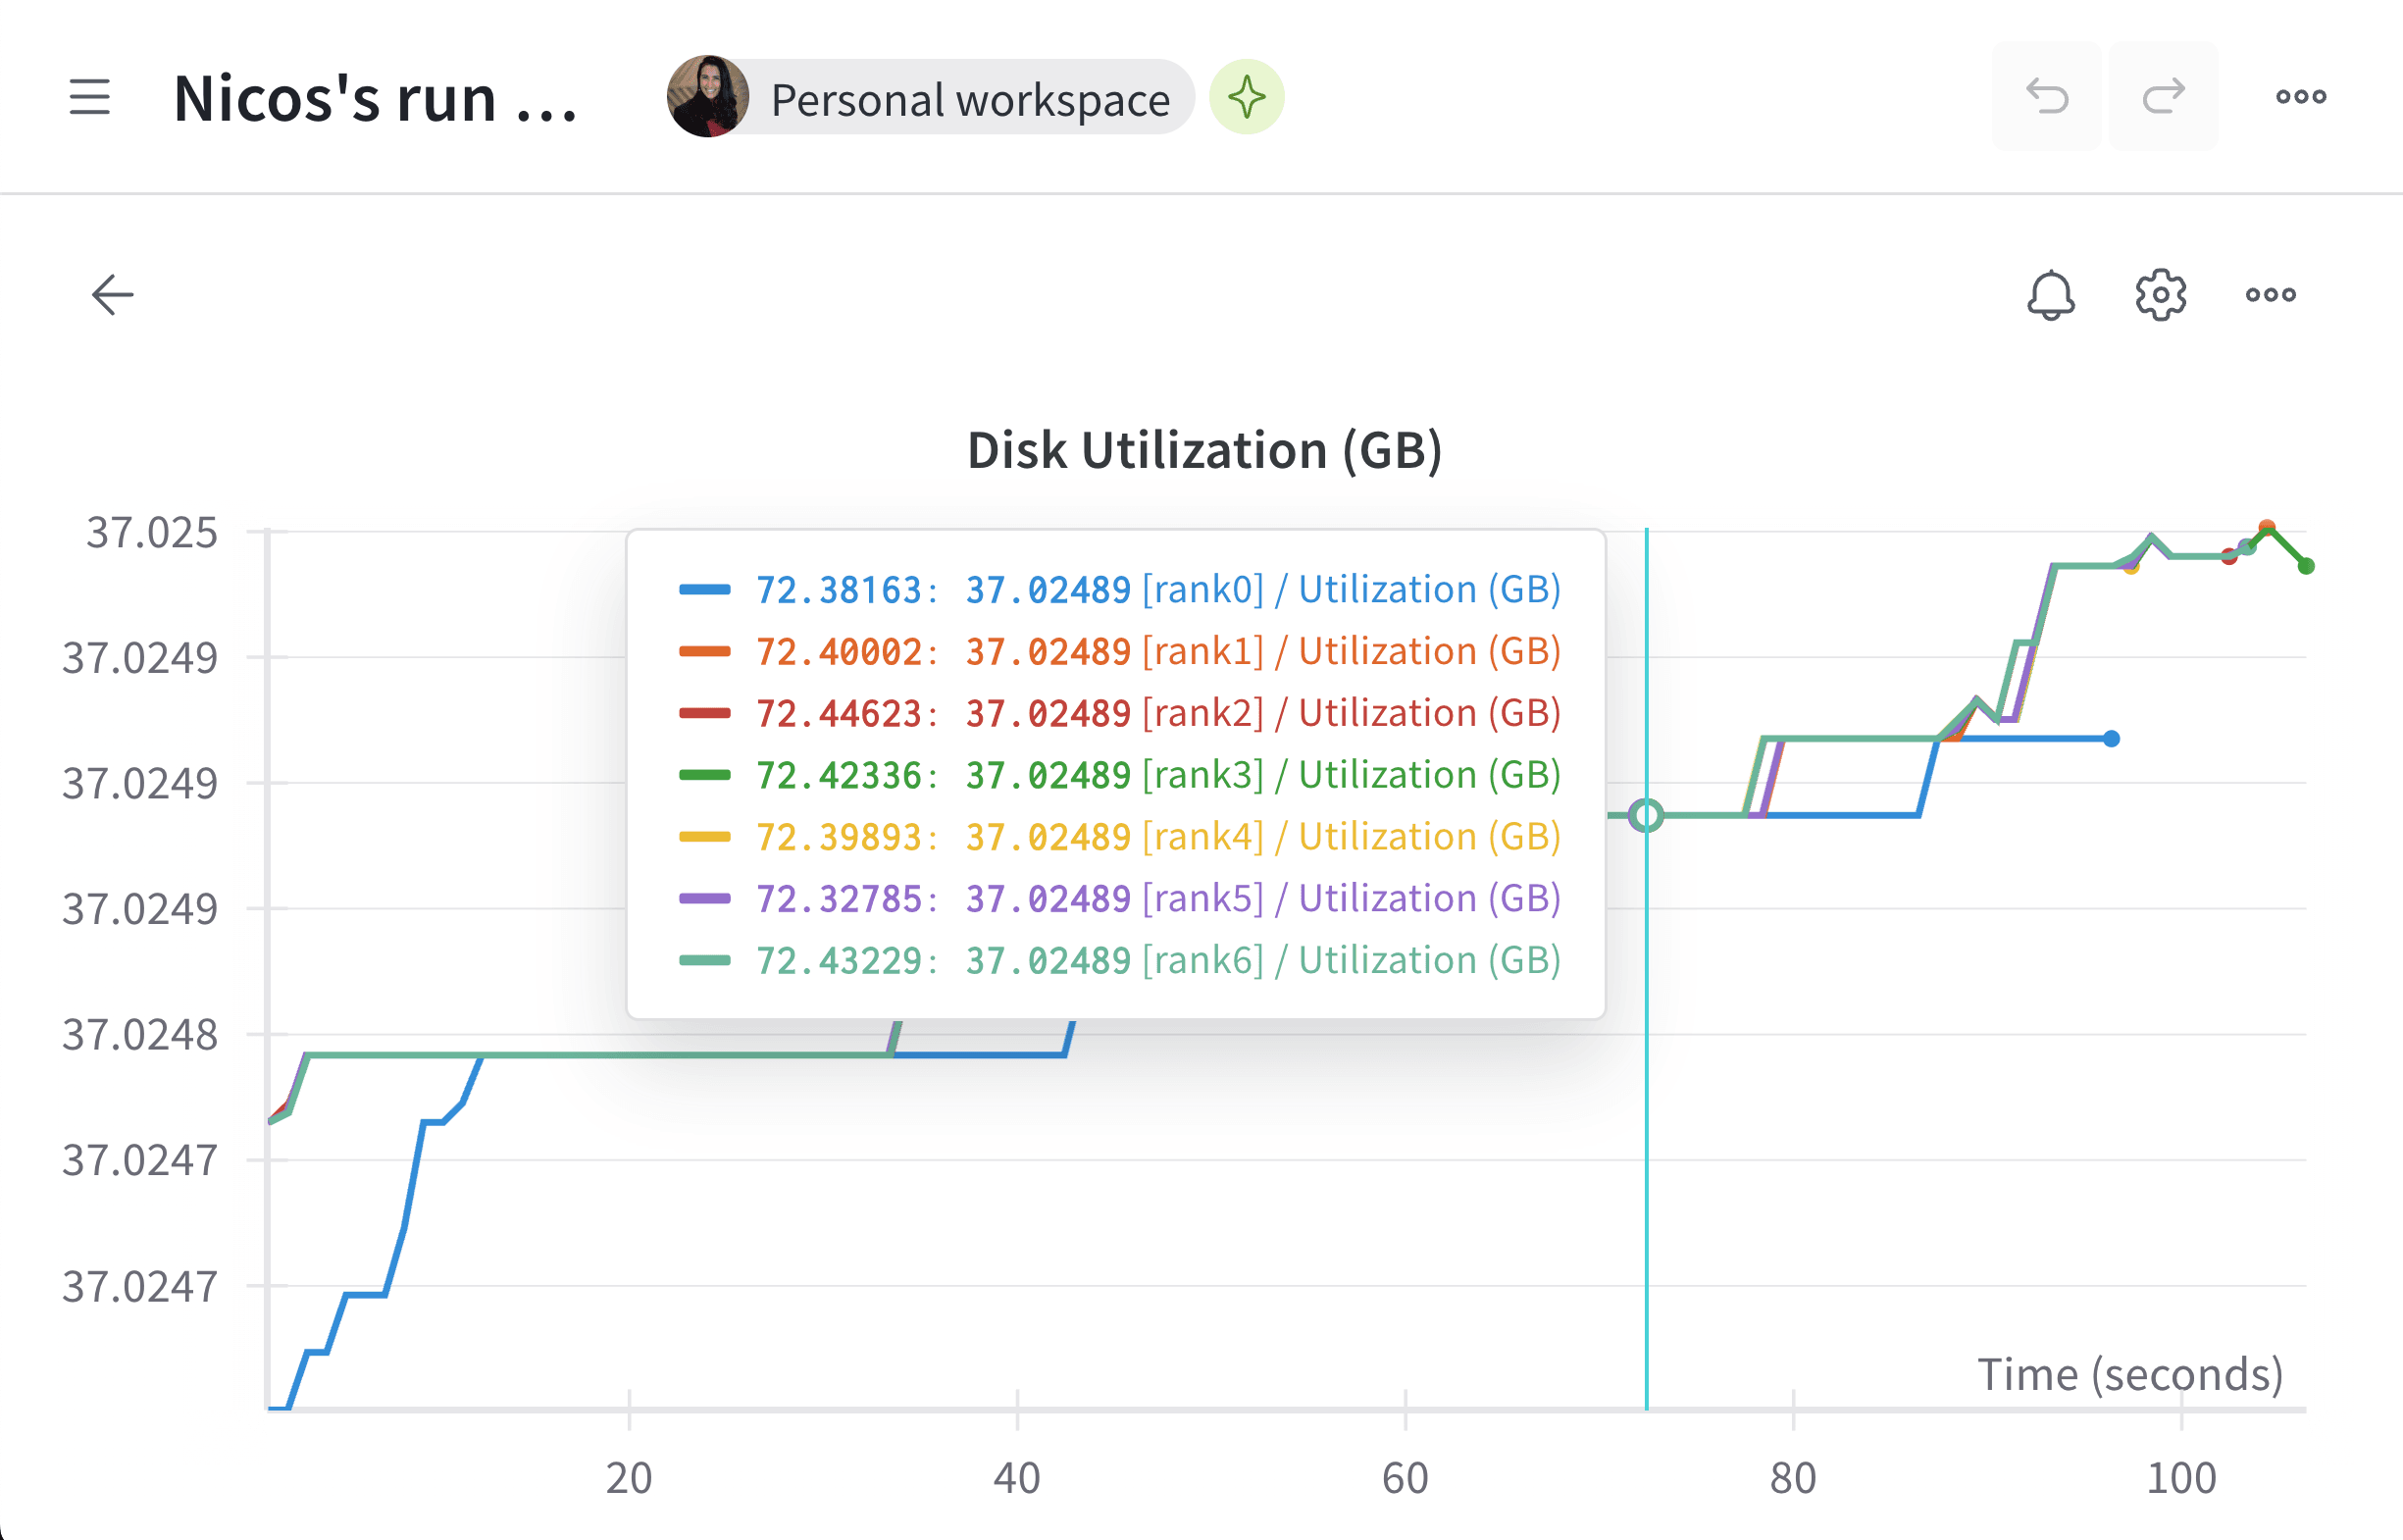 선형 플롯 패널을 사용자 지정하는 방법은 [선형 플롯](/ko/products/wandb/app/features/panels/line-plot)을 참조하세요.
사용 사례 예시
다음 코드 스니펫은 고급 분산 환경에서 자주 사용되는 시나리오를 보여줍니다.
Spawn 프로세스
spawn된 프로세스에서 run을 시작하는 경우 main 함수에서 `wandb.setup()` 메서드를 사용하세요:
```python theme={"system"}
import multiprocessing as mp
def do_work(n):
with wandb.init(config=dict(n=n)) as run:
run.log(dict(this=n * n))
def main():
wandb.setup()
pool = mp.Pool(processes=4)
pool.map(do_work, range(4))
if __name__ == "__main__":
main()
```
run 공유하기
프로세스 간에 run을 공유하려면 run 객체를 인수로 전달하세요.
```python theme={"system"}
def do_work(run):
with wandb.init() as run:
run.log(dict(this=1))
def main():
run = wandb.init()
p = mp.Process(target=do_work, kwargs=dict(run=run))
p.start()
p.join()
run.finish() # run을 완료 상태로 표시
if __name__ == "__main__":
main()
```
W\&B는 로깅 순서를 보장할 수 없습니다. 동기화는 스크립트 작성자가 직접 처리해야 합니다.
문제 해결
W\&B와 분산 트레이닝을 함께 사용할 때 흔히 발생하는 문제는 두 가지입니다.
1. **트레이닝 시작 시 멈춤** - `wandb`의 멀티프로세싱이 분산 트레이닝의 멀티프로세싱과 충돌하면 `wandb` 프로세스가 멈출 수 있습니다.
2. **트레이닝 종료 시 멈춤** - `wandb` 프로세스가 언제 종료해야 하는지 알지 못하면 트레이닝 작업이 멈출 수 있습니다. Python 스크립트 끝에서 `wandb.Run.finish()` API를 호출해 run이 완료되었음을 W\&B에 알리세요. `wandb.Run.finish()` API를 호출하면 데이터 업로드가 마무리되고 W\&B가 종료됩니다.
분산 작업의 안정성을 높이려면 `wandb service` 명령을 사용하는 것이 좋습니다. 앞서 설명한 두 가지 트레이닝 문제는 모두 wandb service를 사용할 수 없는 W\&B SDK 버전에서 주로 발생합니다.
W\&B Service 활성화
사용 중인 W\&B SDK 버전에 따라 W\&B Service가 이미 기본적으로 활성화되어 있을 수 있습니다.
W\&B SDK 0.13.0 이상
W\&B SDK `0.13.0` 이상 버전에서는 W\&B Service가 기본적으로 활성화되어 있습니다.
W\&B SDK 0.12.5 이상
W\&B SDK 버전 0.12.5 이상에서 W\&B Service를 활성화하려면 Python 스크립트를 수정하세요. main 함수 안에서 `wandb.require()` 메서드를 호출하고 문자열 `"service"`를 전달하세요.
```python theme={"system"}
if __name__ == "__main__":
main()
def main():
wandb.require("service")
# 여기에 나머지 스크립트를 작성하세요
```
최적의 사용 환경을 위해 최신 버전으로 업그레이드하는 것을 권장합니다.
**W\&B SDK 0.12.4 이하**
W\&B SDK 0.12.4 이하 버전을 사용하는 경우, `WANDB_START_METHOD` 환경 변수를 `"thread"`로 설정하여 멀티스레딩을 대신 사용하세요.