> ## Documentation Index
> Fetch the complete documentation index at: https://docs.coreweave.com/llms.txt
> Use this file to discover all available pages before exploring further.
> W&B의 Embedding Projector를 사용하면 PCA, UMAP, t-SNE와 같은 일반적인 차원 축소 알고리즘을 통해 다차원 Embedding을 2D 평면에 플롯할 수 있습니다.
# 객체 임베드
 [Embedding](https://developers.google.com/machine-learning/crash-course/embeddings/video-lecture)은 사람, 이미지, 게시물, 단어와 같은 객체를 숫자 목록(\_vector\_라고도 함)으로 표현합니다. 머신 러닝 및 데이터 사이언스 분야에서는 다양한 애플리케이션에서 여러 가지 방식으로 Embedding을 생성할 수 있습니다. 이 페이지는 Embedding에 익숙하고 W\&B 내에서 이를 시각적으로 분석하려는 사용자를 대상으로 합니다.
이 가이드에서는 Embedding을 W\&B에 로깅하고, Embedding Projector를 사용하여 PCA, UMAP, t-SNE와 같은 차원 축소 알고리즘으로 2D 평면에 플롯하는 방법을 설명합니다. 이렇게 Embedding을 시각화하면 클러스터를 탐색하고, 데이터 포인트 간의 관계를 살펴보며, Embedding이 예상한 구조를 제대로 캡처하는지 검증할 수 있습니다.
Embedding 예시
직접 사용해 보기 전에 Embedding Projector가 실제로 작동하는 모습을 보여주는 다음 리소스를 확인하세요:
* [Live 대화형 demo report](https://forge.coreweave.com/wandb/timssweeney/toy_datasets/reports/Feature-Report-W-B-Embeddings-Projector--VmlldzoxMjg2MjY4?accessToken=bo36zrgl0gref1th5nj59nrft9rc4r71s53zr2qvqlz68jwn8d8yyjdz73cqfyhq)
* [예시 Colab](https://colab.research.google.com/drive/1DaKL4lZVh3ETyYEM1oJ46ffjpGs8glXA#scrollTo=D--9i6-gXBm_)
첫 예제
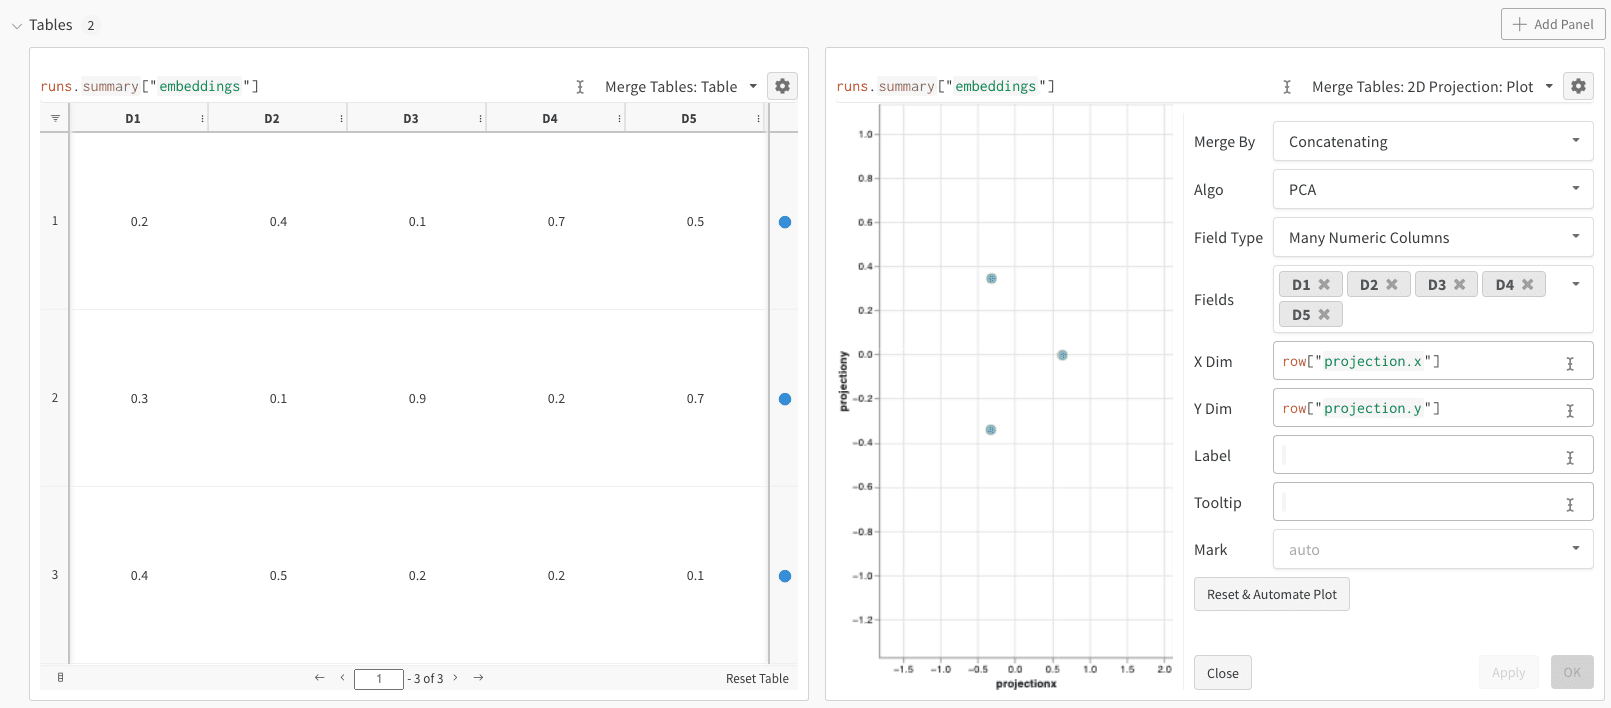
이 최소 예시는 Embedding을 로깅하고 프로젝터에서 확인하는 데 필요한 최소한의 코드를 보여줍니다. W\&B에서는 `wandb.Table` 클래스를 사용하여 Embedding을 로깅할 수 있습니다. 각각 5개 차원으로 구성된 Embedding 3개의 다음 예시를 살펴보세요:
```python theme={"system"}
import wandb
with wandb.init(project="embedding_tutorial") as run:
embeddings = [
# D1 D2 D3 D4 D5
[0.2, 0.4, 0.1, 0.7, 0.5], # 임베딩 1
[0.3, 0.1, 0.9, 0.2, 0.7], # 임베딩 2
[0.4, 0.5, 0.2, 0.2, 0.1], # 임베딩 3
]
run.log(
{"embeddings": wandb.Table(columns=["D1", "D2", "D3", "D4", "D5"], data=embeddings)}
)
run.finish()
```
앞의 코드를 실행하면 W\&B 대시보드에 데이터가 담긴 새 Table이 생성됩니다. 오른쪽 상단의 패널 선택기에서 **2D 투영**을 선택하면 Embedding을 2차원으로 시각화할 수 있습니다. W\&B는 적절한 기본값을 자동으로 선택하며, 톱니바퀴 아이콘을 클릭하여 설정 메뉴에서 이를 재정의할 수 있습니다. 이 예제에서 W\&B는 사용 가능한 숫자 차원 5개를 모두 사용합니다.
Digits MNIST
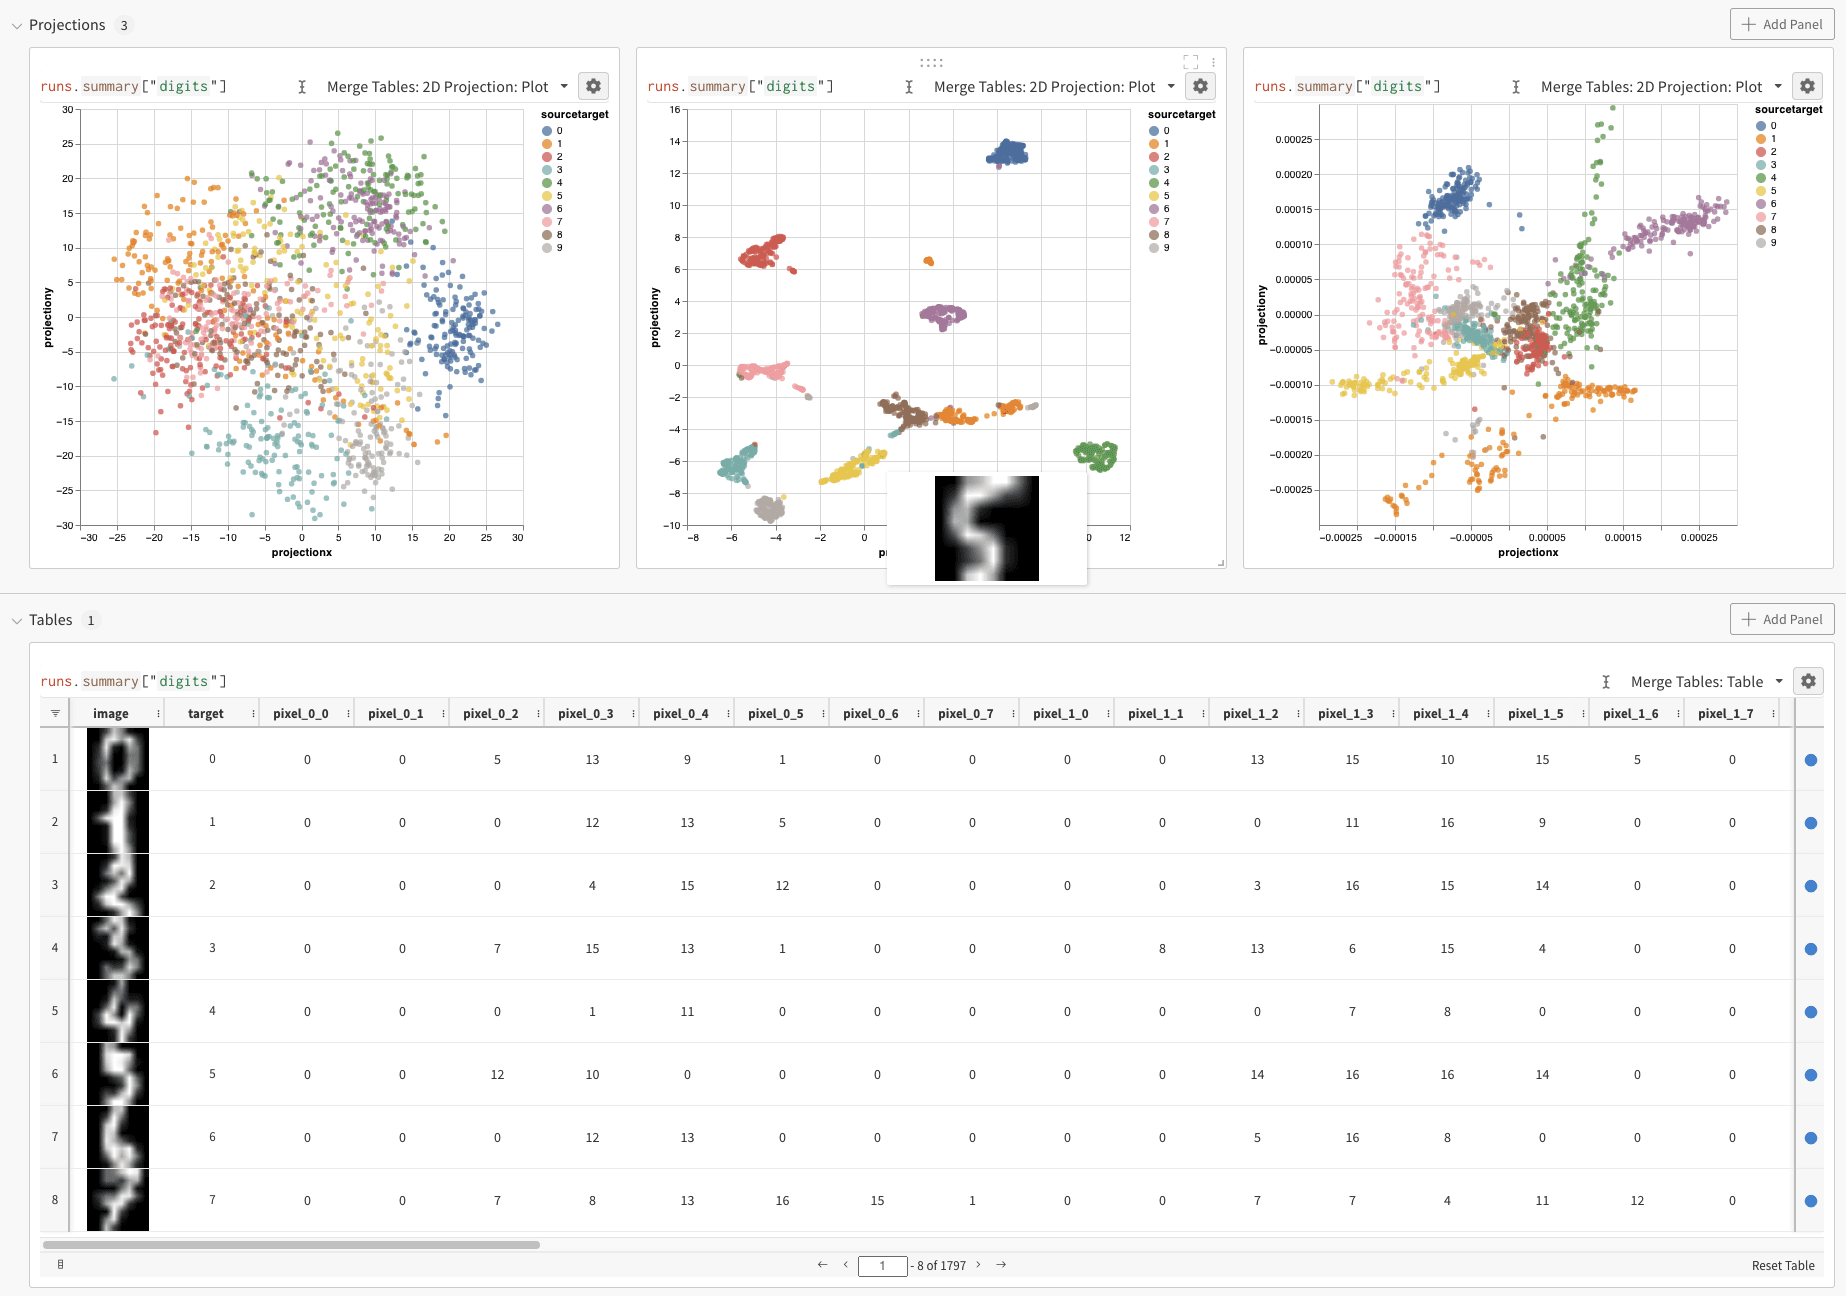
다음 예시는 더 높은 차원의 데이터와 더 풍부한 오버레이를 사용하는 현실적인 워크플로를 보여줍니다. 앞선 예시에서는 Embedding을 로깅하는 기본 원리를 보여주었지만, 일반적으로는 훨씬 더 많은 차원과 샘플을 다룹니다. [SciKit-Learn](https://scikit-learn.org/stable/modules/generated/sklearn.datasets.load_digits.html)을 통해 사용할 수 있는 MNIST Digits 데이터셋([UCI ML 손글씨 숫자 데이터셋](https://archive.ics.uci.edu/ml/datasets/Optical+Recognition+of+Handwritten+Digits))을 살펴보겠습니다. 이 데이터셋에는 각각 64차원으로 이루어진 레코드 1,797개가 있습니다. 이 문제는 10개 클래스로 분류하는 사용 사례입니다. 시각화를 위해 입력 데이터를 이미지로 변환할 수도 있습니다.
```python theme={"system"}
import wandb
from sklearn.datasets import load_digits
with wandb.init(project="embedding_tutorial") as run:
# 데이터셋을 불러옵니다
ds = load_digits(as_frame=True)
df = ds.data
# "target" 열을 생성합니다
df["target"] = ds.target.astype(str)
cols = df.columns.tolist()
df = df[cols[-1:] + cols[:-1]]
# "image" 열을 생성합니다
df["image"] = df.apply(
lambda row: wandb.Image(row[1:].values.reshape(8, 8) / 16.0), axis=1
)
cols = df.columns.tolist()
df = df[cols[-1:] + cols[:-1]]
run.log({"digits": df})
```
앞의 코드를 실행하면 UI에 다시 table이 표시됩니다. **2D Projection**을 선택하여 Embedding 정의, 색상, 알고리즘(PCA, UMAP, t-SNE), 알고리즘 매개변수 및 오버레이를 설정하세요. 이 경우 W\&B는 점에 마우스를 올리면 이미지를 표시합니다. 모두 적절한 기본값으로 설정되어 있으므로 **2D Projection**을 한 번 클릭하면 비슷한 결과를 확인할 수 있습니다. [이 Embedding 튜토리얼 예시를 직접 살펴보세요](https://forge.coreweave.com/wandb/timssweeney/embedding_tutorial/runs/k6guxhum?workspace=user-timssweeney).
로깅 옵션
다음 섹션에서는 Embedding 데이터를 W\&B에 로깅할 때 지원되는 데이터 구성 방식을 설명합니다. Embedding은 여러 형식으로 로깅할 수 있습니다.
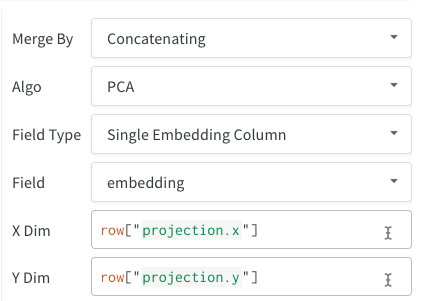
* **단일 Embedding 열:** 데이터가 이미 행렬과 유사한 형식인 경우가 많습니다. 이 경우 단일 Embedding 열을 만들 수 있으며, 셀 값의 데이터 유형은 `list[int]`, `list[float]` 또는 `np.ndarray`일 수 있습니다.
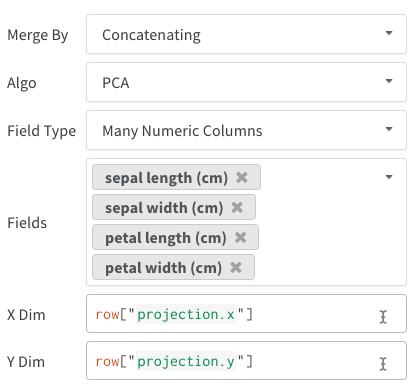
* **여러 숫자 열:** 앞의 두 예시는 이 방식을 사용하여 각 차원마다 열을 만듭니다. W\&B는 셀 값으로 Python `int` 또는 `float`를 허용합니다.
 다른 모든 table과 마찬가지로 table을 구성하는 방법에는 여러 가지가 있습니다.
* `wandb.Table(dataframe=df)`를 사용하여 **데이터프레임**에서 직접 구성합니다.
* `wandb.Table(data=[...], columns=[...])`를 사용하여 **데이터 목록**에서 직접 구성합니다.
* table을 **한 행씩 점진적으로** 구축합니다(코드에 루프가 있는 경우에 적합). `table.add_data(...)`를 사용하여 table에 행을 추가하세요.
* table에 **Embedding 열**을 추가합니다(Embedding 형태의 예측 목록이 있는 경우에 적합): `table.add_col("col_name", ...)`.
* **계산된 열**을 추가합니다(table에 매핑하려는 함수나 모델이 있는 경우에 적합): `table.add_computed_columns(lambda row, ndx: {"embedding": model.predict(row)})`.
Plotting options
Embedding을 로깅한 후, 투영 및 렌더링 방식을 조정할 수 있습니다. **2D Projection**을 선택한 후, 톱니바퀴 아이콘을 클릭하여 렌더링 설정을 편집하세요. 원하는 열을 선택하는 것(이전 섹션 참조) 외에도, 관심 있는 알고리즘과 원하는 매개변수를 선택할 수 있습니다. 다음 이미지는 UMAP과 t-SNE의 매개변수를 보여줍니다.
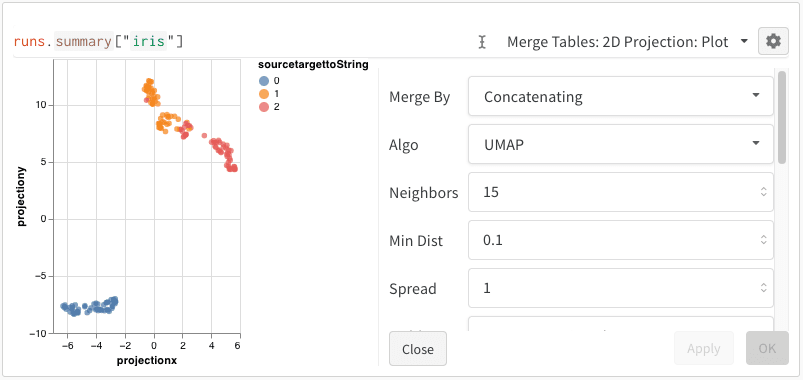
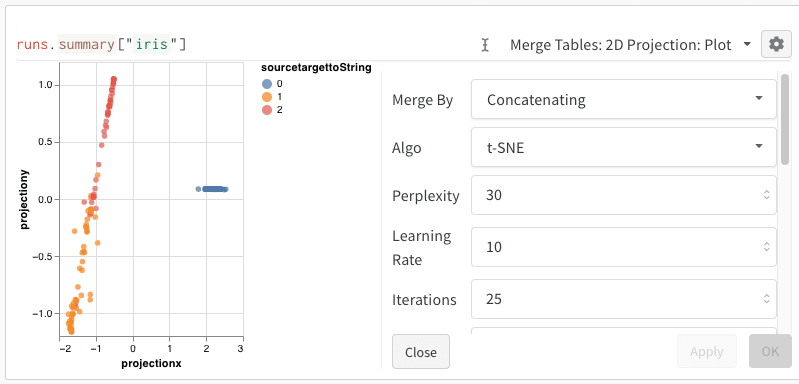 W\&B는 세 가지 알고리즘 모두에 대해 1,000행과 50차원으로 구성된 무작위 부분집합으로 다운샘플링합니다.
## Related topics
- [리포트 임베드](/ko/products/wandb/reports/embed-reports.md)